
2026/11/02
今更聞けないAI知識
マルチモーダルAIとは?文字と画像を一緒に扱える意味
「この画像も見てください」が通じるAI
会議資料のグラフを見ながら、「売上が落ちている箇所を文章で説明してください」と尋ねたい場面があります。文章だけを入力するAIでは、グラフの形や凡例を別途説明しなければなりません。画像入力にも対応していれば、質問文とグラフを同じ依頼の材料として渡せる可能性があります。
マルチモーダルAIを一言で表すと、「文字・画像・音声など、複数の種類の情報を扱えるAI」です。ここでいうモーダルとは、情報の種類や伝わり方を指します。文章、写真、音声、動画、コードなどが、それぞれ異なるモーダルに当たります。Google Cloudの解説でも、マルチモーダルAIはテキスト、画像、動画、コード、音声などの多様な情報源を統合する能力として紹介されています(出典: Google Cloud)。
身近なたとえなら、文章と図が載った資料を読む場面が近いでしょう。人は本文だけでなく、図の位置や色分けも見ながら内容を捉えます。マルチモーダルAIも、対応する情報を別々に受け取るだけでなく、その組み合わせを回答の手掛かりにします。ただし、人と同じように資料の意味を理解したり、意識を持って考えたりしているという説明ではありません。学習したパターンを基に、入力同士の関係を計算していると捉えるほうが適切です。
この言葉を知るときの中心は、「たくさんのことができるAI」と覚えることではありません。「どの種類の情報を入力でき、どの組み合わせを回答に使えるのか」という見方が大切です。この視点があれば、画像を受け付けるだけの機能と、文章と画像の関係まで扱う機能を混同しにくくなります。
異なる情報を一つの回答へつなぐ仕組み
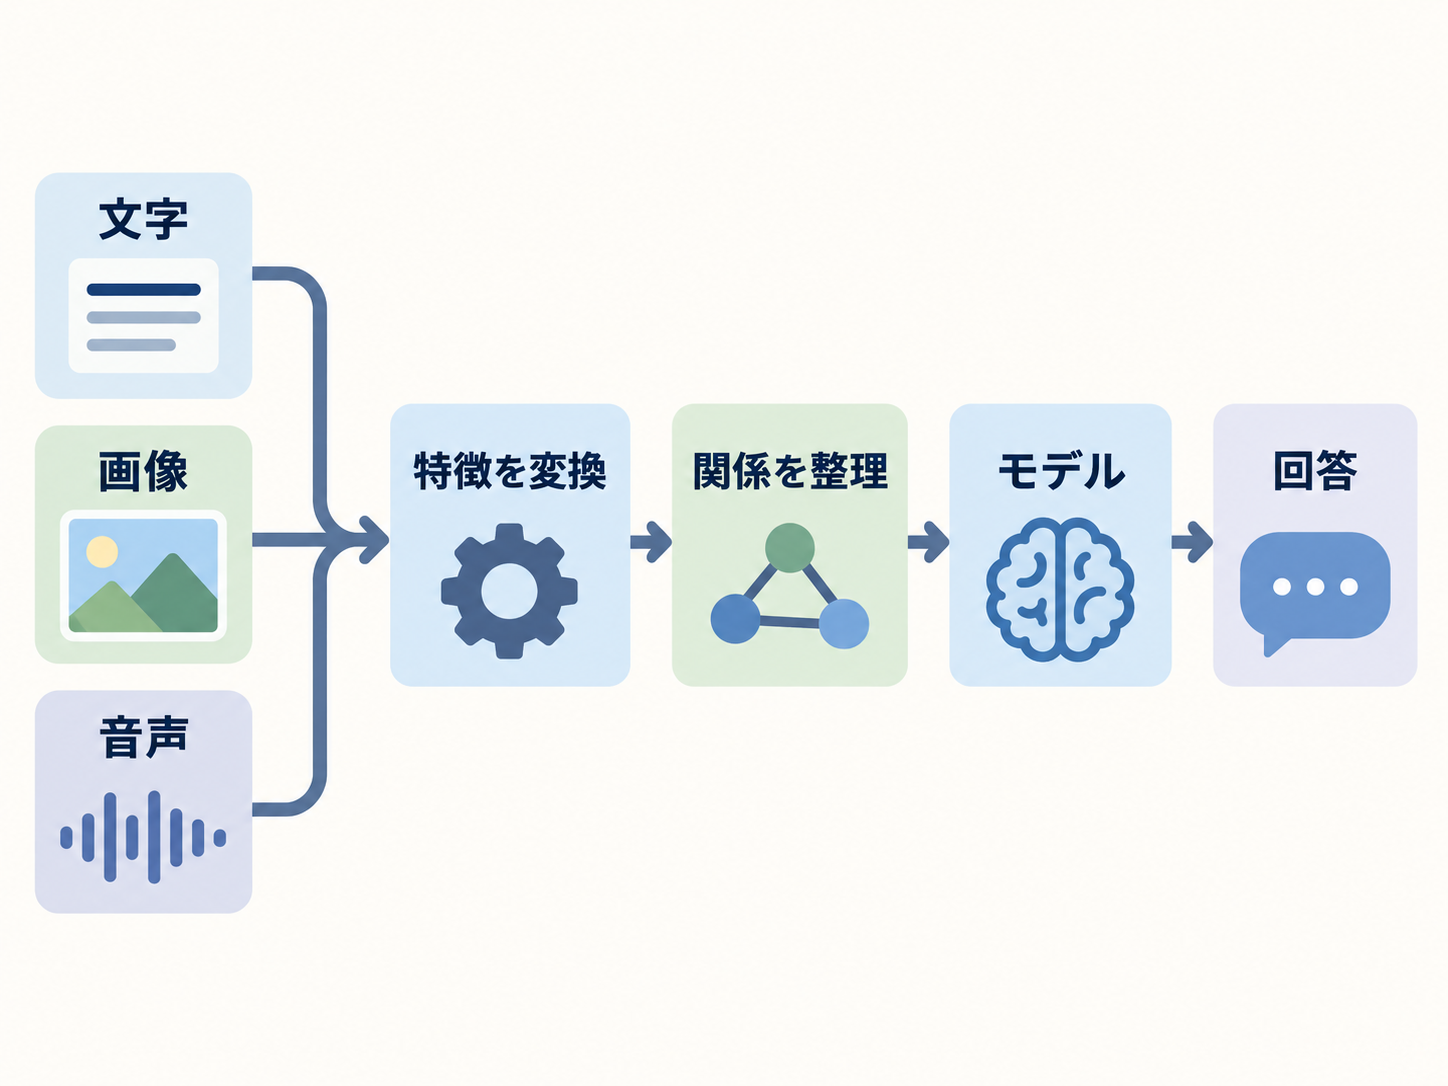
マルチモーダルAIの内部には、入力された文章や画像を、そのまま人間の感覚で読む仕組みがあるわけではありません。初心者向けの見取り図としては、「種類を見分ける」「特徴を数値的な表現に変える」「情報同士の関係を捉える」「回答を組み立てる」という流れで考えると分かりやすくなります。実際の構造や処理順はモデルごとに異なるため、これは共通点をつかむための簡略化した説明です。
たとえば、画像からは形、配置、色、画像内の文字などが手掛かりとして抽出されます。質問文からは、何を確かめたいのか、どの部分に注目するのかといった手掛かりが得られます。両方を関連付けられるモデルなら、「右上の青い棒について説明してください」のように、文章が画像内の対象を指している関係を処理できます。ただし、小さな文字や曖昧な指示を常に正しく認識できるという意味ではありません。
ここでいうモデルとは、学習データから得たパターンや関係を使って、入力に応じた出力を計算する仕組みです。IBMは、生成AIを利用者のプロンプトに応じて文章や画像などを作る深層学習モデルと説明し、基盤モデルには文章用、画像用、音声用のほか、複数のコンテンツを支えるマルチモーダルなものがあるとしています(出典: IBM)。
「学習」と「今の質問への回答」も分けて考える必要があります。IBMの解説では、生成AIの流れを学習、特定用途への調整、生成・評価といった段階に整理しています(出典: IBM)。あらかじめ行われるモデルの学習と、利用者が資料を渡して回答を求める処理は、概念上は別の段階です。会話の中で画像を一枚渡したことを、直ちにモデル全体がその画像を再学習したことと同一視しないほうがよいでしょう。入力データがサービス上でどう扱われるかについては、利用するサービスの規約や設定を別途確認する必要があります。
文章と画像を組み合わせると増える手掛かり
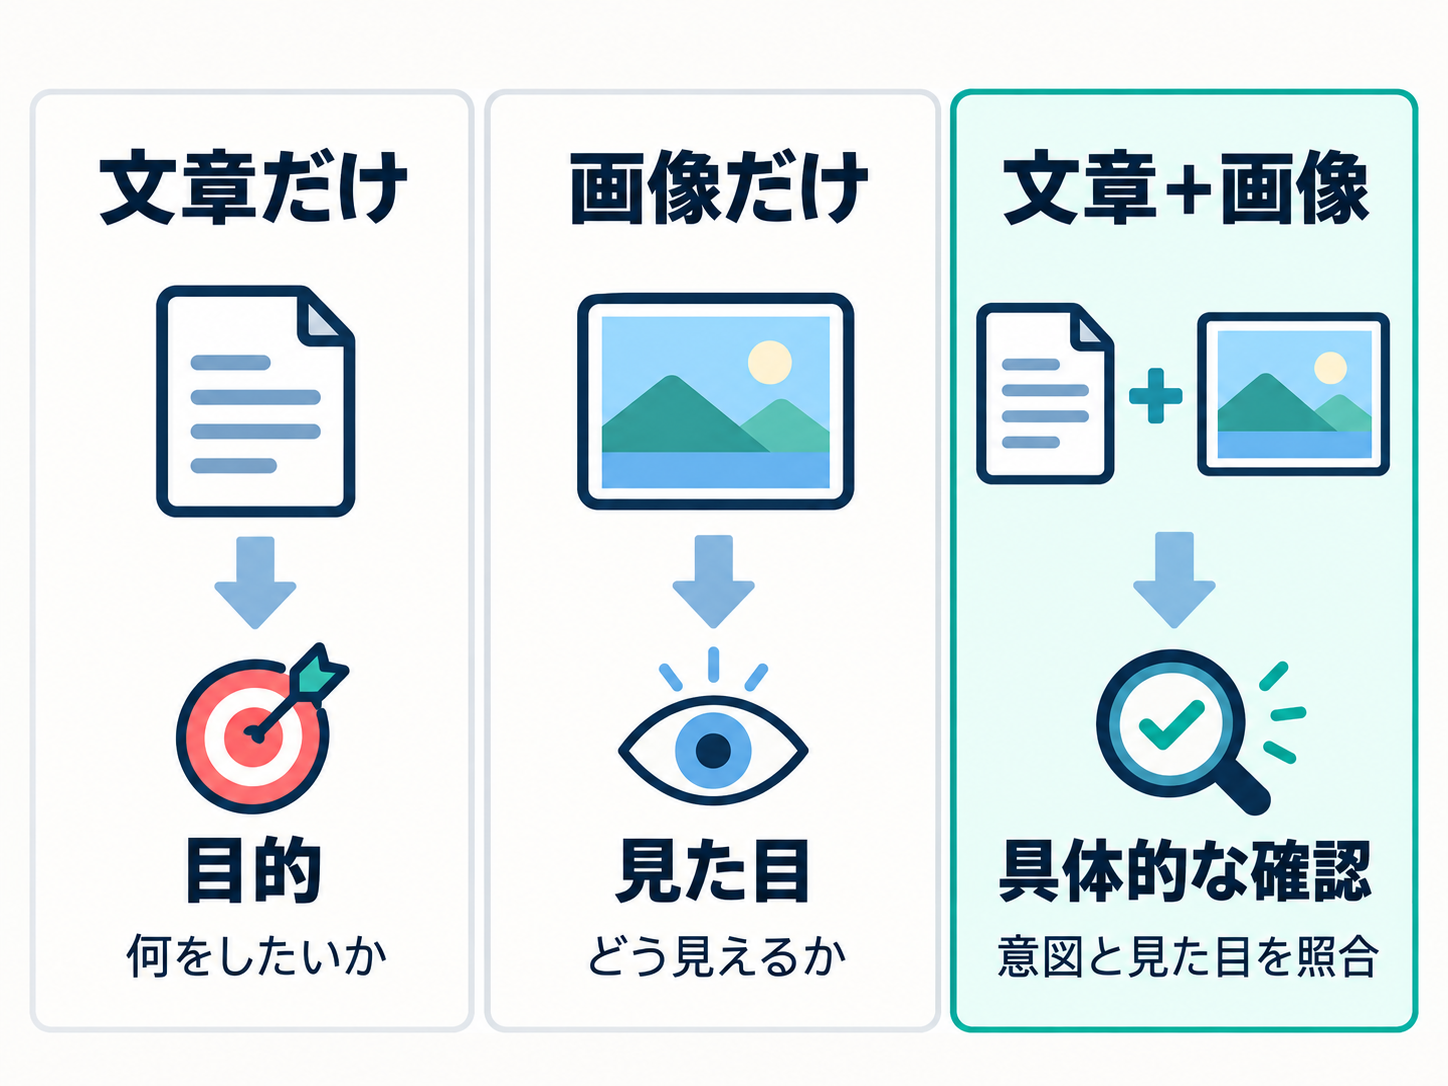
複数の情報を渡す意味は、単純に入力の量を増やすことではありません。一方だけでは足りない手掛かりを、もう一方で補える点にあります。文章は目的や条件を伝えやすく、画像は配置や見た目を示しやすいため、役割を分けると依頼が具体的になります。
次の例は、実際の製品動作を保証するものではなく、使い方を理解するための架空の提案です。社内イベントの告知画像を作ったものの、初めて見る人に日時や場所が伝わるか不安だとします。画像だけを渡すと、AIは何を確認すべきか判断しにくいかもしれません。そこで、「開催日、場所、申込方法の見つけやすさを確認してください」と文章で目的を添えます。
| 入力の組み合わせ | 架空の依頼 | 組み合わせる意味 |
| --- | --- | --- |
| 文章のみ | 告知画像の確認項目を挙げてください | 一般的な確認項目を整理する |
| 画像のみ | この画像を説明してください | 見えている内容の説明を求める |
| 文章と画像 | 日時と場所の見つけやすさを確認してください | 画像内の特定要素へ注目点を与える |
同じ考え方は、公開済みのチラシから必要事項を整理する、手書きの配置案について改善候補を出してもらう、家具の写真を見せて収納方法の案を求める、といった場面にも応用できます。いずれも提案段階の例であり、画像内の文字が正確に読み取られることや、提案が現実の条件に合うことを保証するものではありません。
大切なのは、AIへ判断を丸ごと任せることではなく、入力ごとの役割を決めることです。「画像には現状を示す」「文章では確認したい点を指定する」と分ければ、回答を確かめる基準も作れます。画像に存在しない情報まで推測させたくない場合は、「画像から確認できないことは、確認できないと明記してください」と条件を添える方法もあります。これは正しさを保証する魔法の言葉ではありませんが、期待する回答範囲を伝える提案例にはなります。
マルチモーダルなら何でも扱えるという誤解
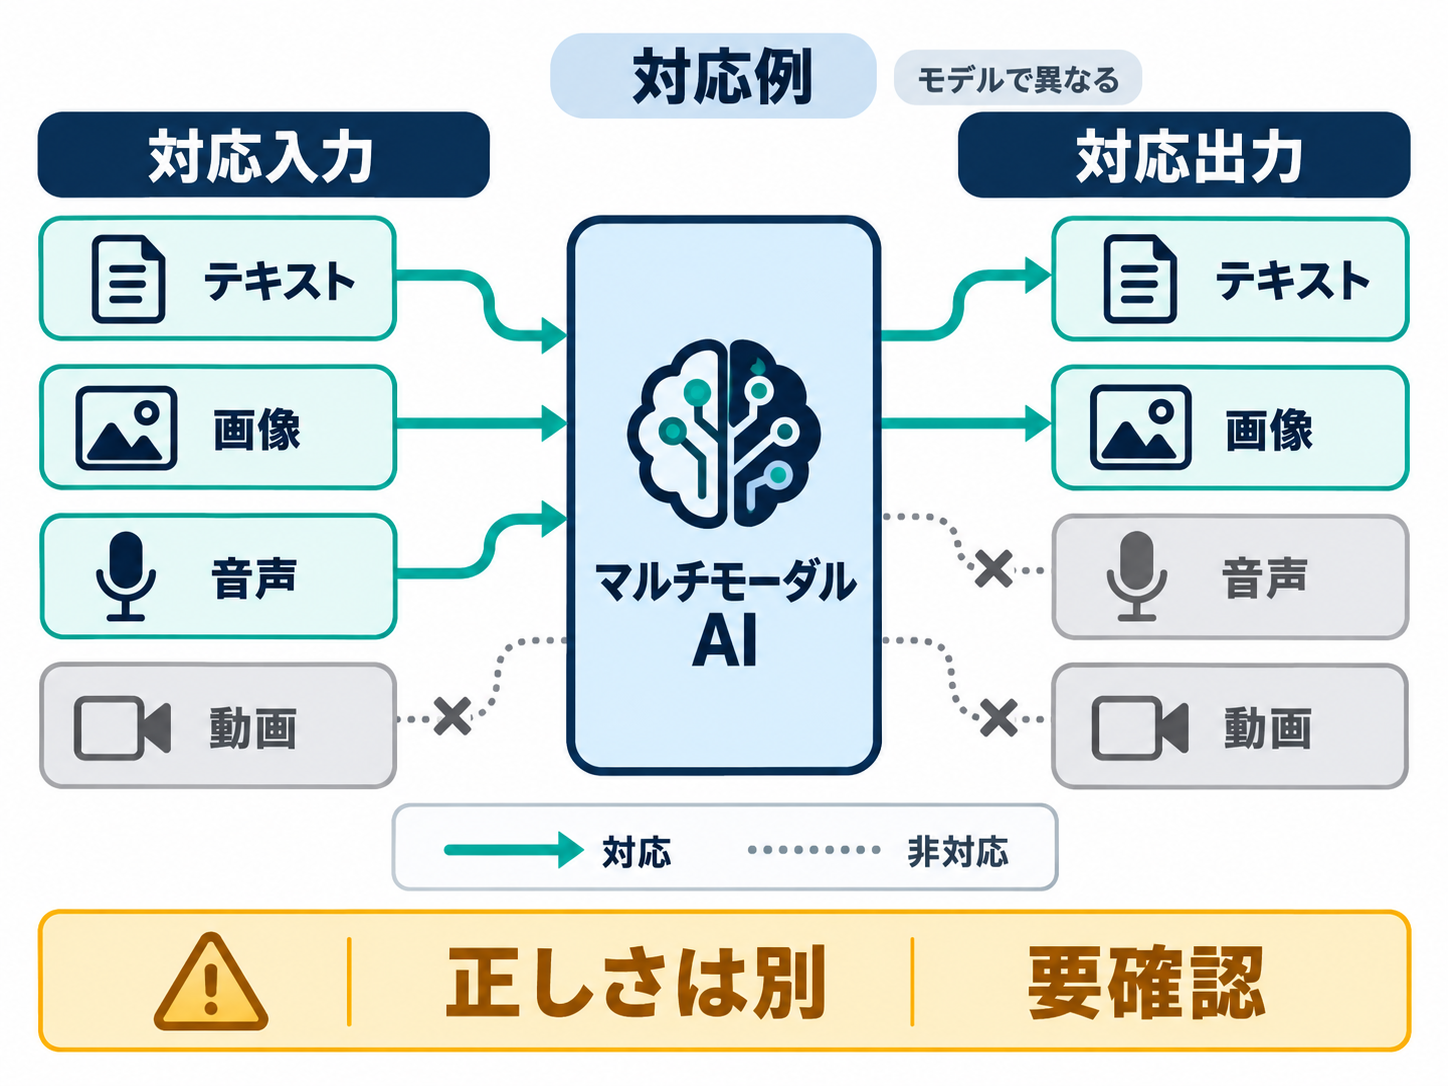
マルチモーダルという名前から、「文字も画像も音声も、すべて自由に入力・出力できる」と受け取ることがあります。しかし、扱える情報の種類と組み合わせはAIごとに異なります。文章と画像を入力できても音声には対応していない場合や、複数種類を入力できても回答は文章に限られる場合を想定し、利用前に対象サービスの案内を確認する必要があります。
「入力できる」と「内容を正しく扱える」も別です。画像を受け付けたとしても、細かな文字、紛らわしい記号、画像外の事情まで正確に判断できるとは限りません。複数の手掛かりがあることで質問を具体化しやすくなる一方、生成された回答が事実である保証は生まれません。重要な日付、金額、固有名詞、規則などは、元の資料へ戻って照合する必要があります。
もう一つ混同しやすいのが、マルチモーダルAIとAIエージェントです。マルチモーダルは主に「どの種類の情報を扱えるか」という見方です。AIエージェントは、目標に応じて手順を組み立て、利用可能な道具や外部サービスを使いながらタスクを進めるソフトウェアとして説明されています(出典: IBM)。画像を理解できることと、予約や送信などの行動を自律的に進めることは同じ能力ではありません。
利用場面で確かめたいのは、「マルチモーダルかどうか」という看板だけではなく、入力、出力、確認方法の三点です。何を渡せるのか、どの形式で回答されるのか、その回答を何と照合できるのかを見ます。ここを曖昧にしたまま使うと、画像を添えただけで精度が上がると思い込んだり、対応していない処理まで期待したりしやすくなります。機能名よりも、今回の目的に必要な情報の組み合わせを扱えるかどうかで判断するのが現実的です。
検索と生成を分けて考える使い方
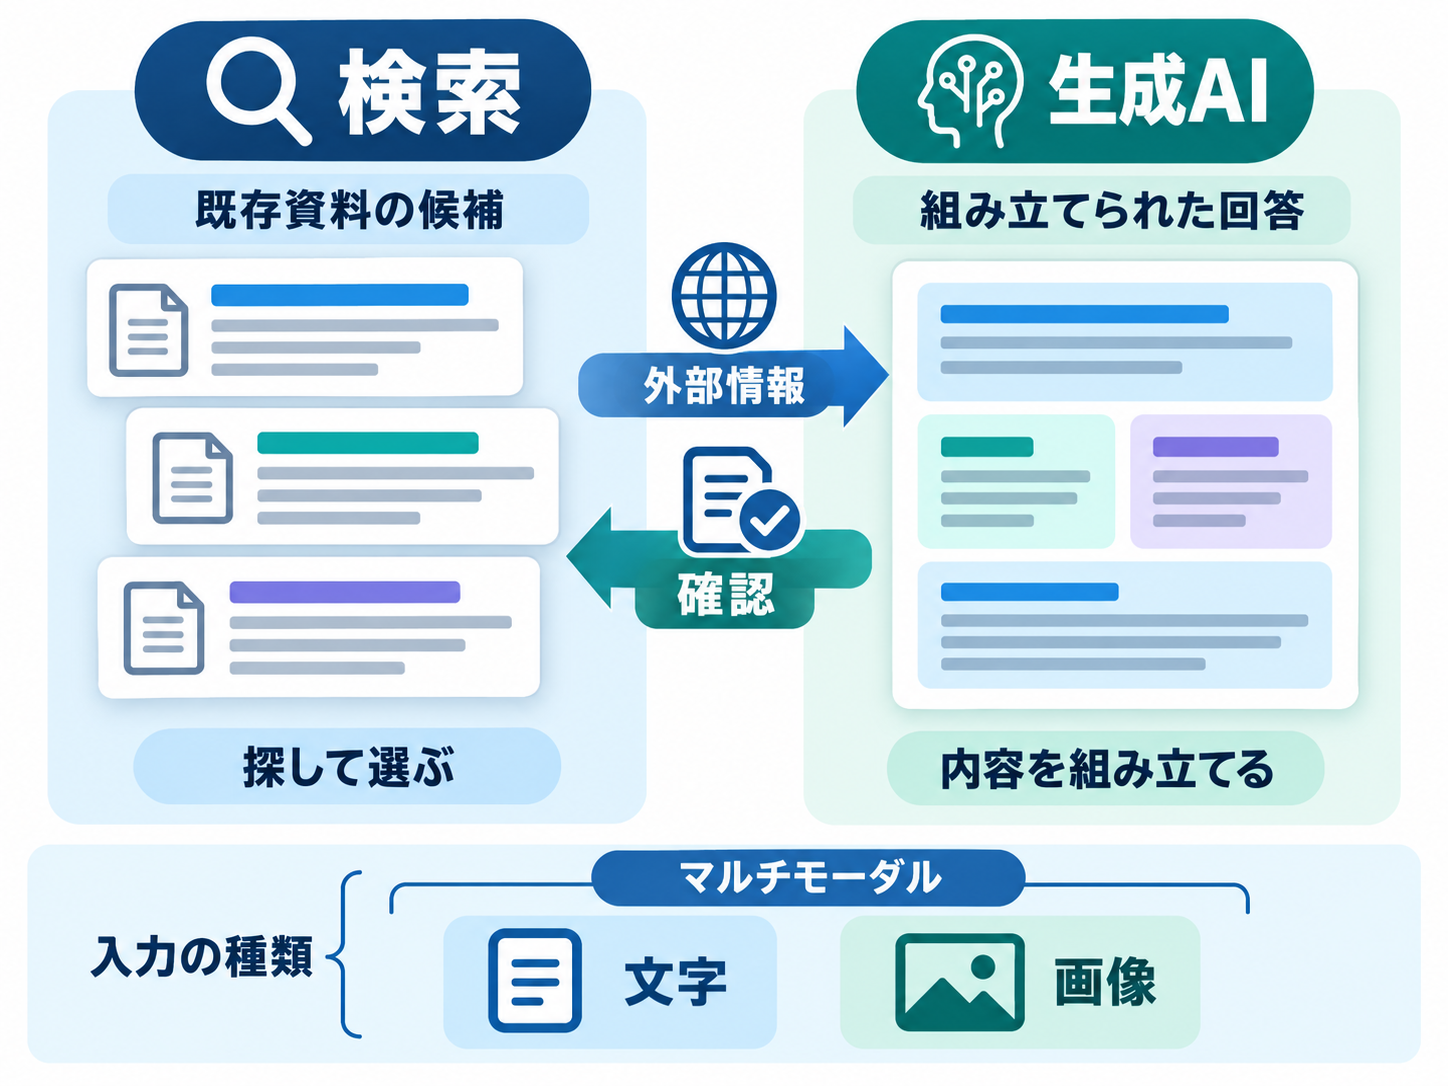
画像と文章を同時に扱えるAIを見ると、「画像検索の高機能版」と感じるかもしれません。検索と生成AIには重なるサービスもありますが、基本の役割は分けて考えられます。検索は、入力した語句や画像などを手掛かりに既存の情報源を探すために使います。生成AIは、学習したデータのパターンを基に、依頼に応じた文章や画像などの出力を組み立てます。IBMは、生成モデルが学習データの簡略化された表現を作り、元データと同一ではない新しい出力を生成すると説明しています(出典: IBM)。
マルチモーダルであることは、入力方法が増えることを示しますが、最新のウェブ情報を自動的に調べたことまでは意味しません。写真について説明できたとしても、その回答が現在の製品仕様や今日の出来事を参照しているとは限らないためです。反対に、検索機能には文章と音声など、複数種類の入力を組み合わせる例もあります。Google Cloudも、マルチモーダルAIの例として、テキストと音声を組み合わせた情報検索を挙げています(出典: Google Cloud)。つまり、「マルチモーダル」と「生成」、「検索」は同じ分類軸ではありません。
生成AIが外部情報を利用する仕組みとして、RAGがあります。RAGは検索拡張生成と呼ばれ、モデルの学習データ外にある関連情報を利用し、回答の正確さや関連性を高めるための手法としてIBMが紹介しています(出典: IBM)。ただし、外部情報を使う仕組みがある場合でも、参照先の内容や日付が適切かどうかを人が確認する工程は残ります。
使い分けに迷ったら、目的を問い直すと整理できます。既存の記事や公式資料そのものを見つけたいなら検索が中心です。手元の画像と文章を合わせて要点や案を整理したいなら、対応するマルチモーダル生成AIが候補になります。最新情報や正確な仕様が必要な場面では、回答だけで判断せず、出典を求めて原文を開き、公開日と更新日も確認する流れが欠かせません。
伝わりやすい依頼を作る三つの要素
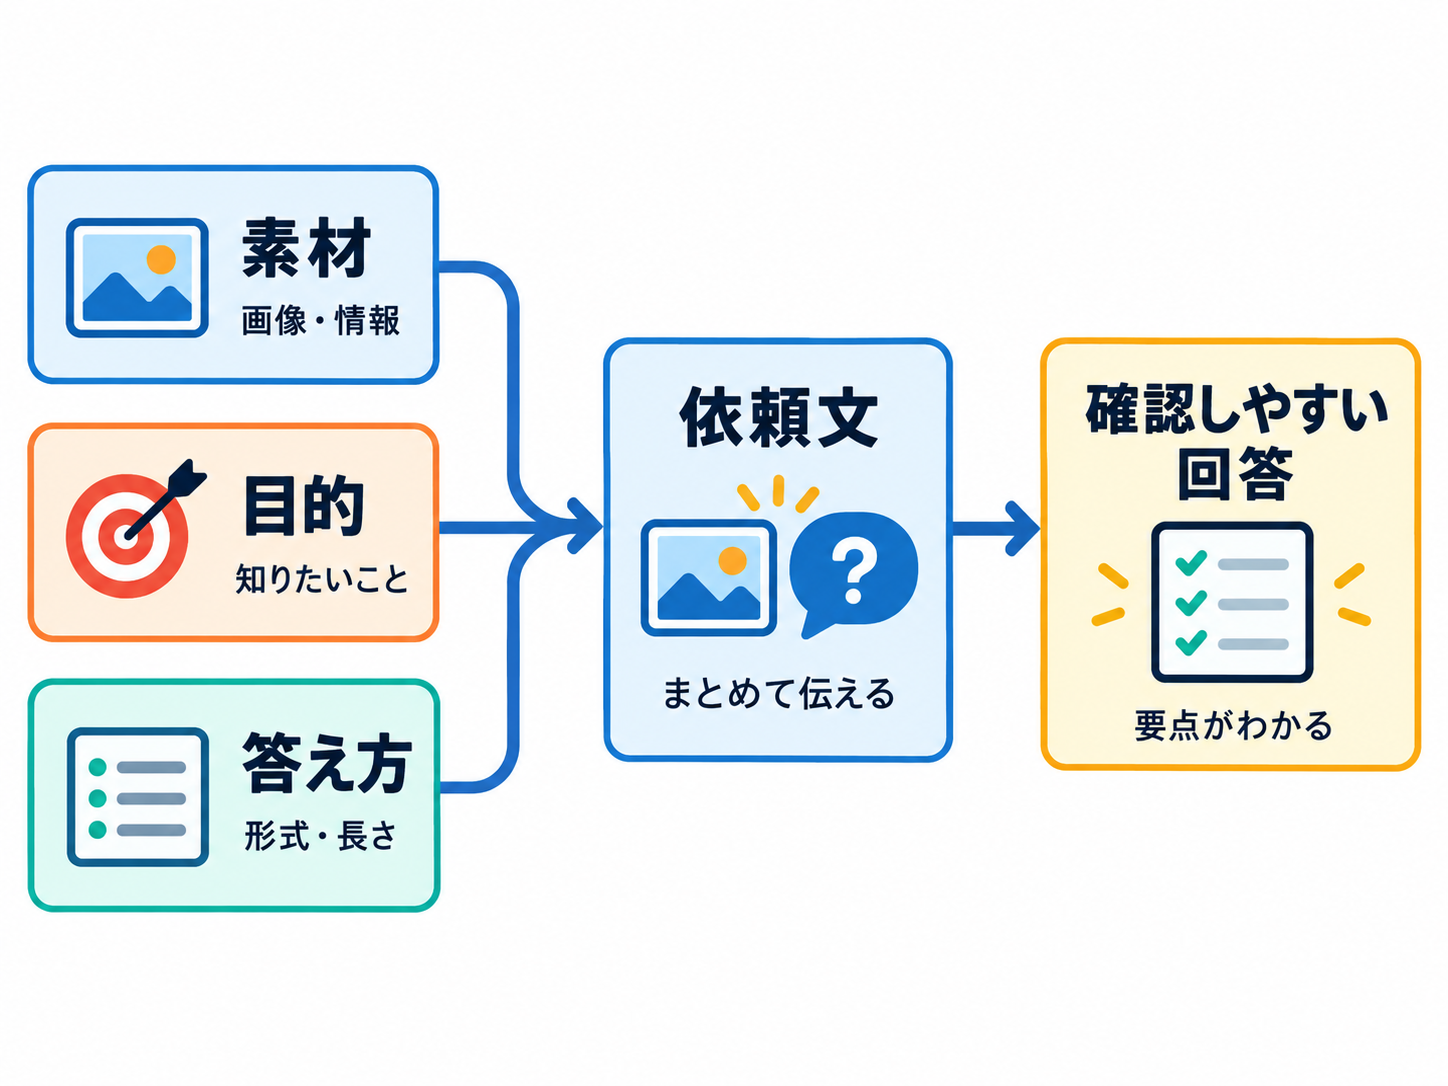
マルチモーダルAIへの依頼では、画像を添付するだけで意図まで伝わるとは限りません。プロンプトとは、AIへ渡す質問や指示などの入力です。画像入力に対応するAIを使う場合も、文章で「どの素材を」「何のために」「どのような答え方で」扱ってほしいのかを示すと、回答を評価しやすくなります。
一つ目の要素は素材です。「添付したイベント告知画像」「画像内のグラフ」「写真の左側にある棚」など、対象を指定します。二つ目は目的で、「必要事項の抜けを確認したい」「初めて見る人が迷いそうな点を知りたい」と伝えます。三つ目は答え方です。項目数、並べ方、推測を避ける条件などを示します。この三つは、特定製品の操作手順ではなく、依頼内容を整理するための考え方です。
提案用の架空例として、次のような依頼が考えられます。
> 添付した架空のイベント告知画像を確認し、「開催日」「場所」「申込方法」が見つけやすいか整理してください。画像から確認できない内容は推測せず、「確認できません」と書いてください。回答は「見つけやすい点」「迷いそうな点」「修正案」の三項目に分けてください。
この依頼では、単に「画像を見てください」と頼むのではなく、注目点と回答範囲を限定しています。返ってきた指摘が画像のどこに対応しているのかも確認しやすくなるでしょう。ただし、「推測しないでください」と書けば誤りがなくなるわけではありません。日付や申込先などは、必ず元画像や正式な案内と見比べます。
最初から長い指示を作る必要もありません。「画像から読み取れる項目を挙げてください」と頼み、回答を見てから「その中で日時に関する項目だけを整理してください」と絞る方法があります。素材に個人情報や社外秘情報が含まれる場合は、入力前に所属先のルールと利用サービスのデータ取扱条件を確認してください。便利な入力方法が増えても、渡してよい情報の範囲まで自動的に広がるわけではありません。
明日から試せる一枚の画像での確認
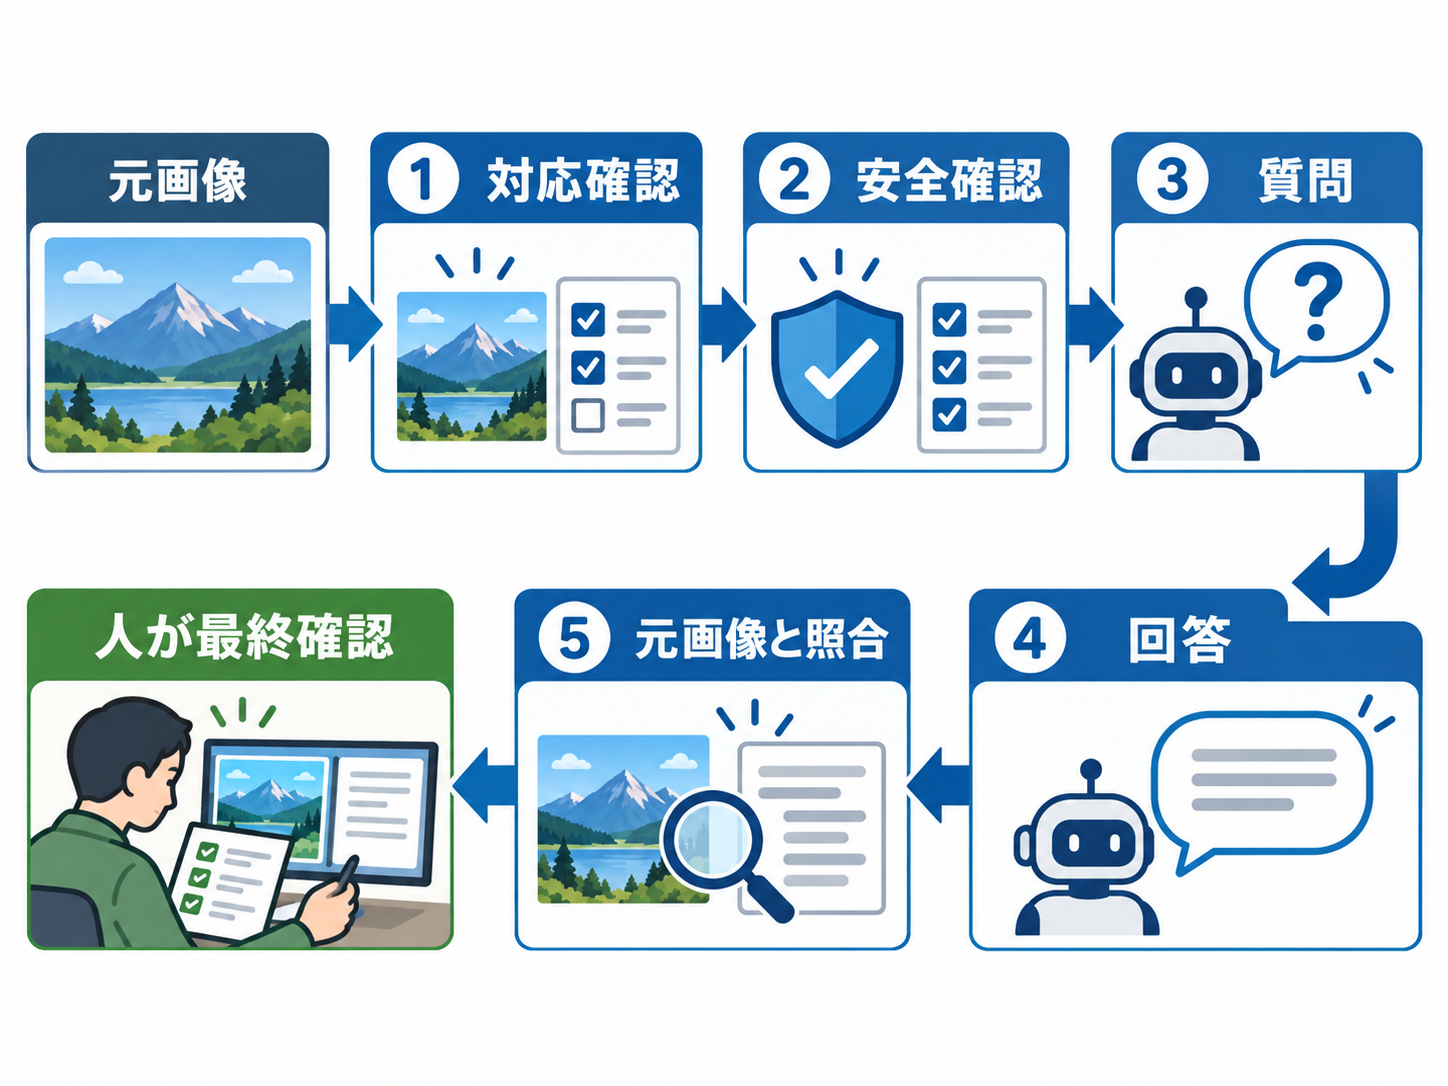
マルチモーダルAIを理解するために、複雑な機能や有料の仕組みから始める必要はありません。画像入力に対応するAIを利用できる場合は、自分で作った架空の案内画像や、公開して問題のない資料を一枚用意します。目的は回答の優劣を競うことではなく、文章だけの依頼と、文章に画像を組み合わせた依頼で、手掛かりの与え方がどう変わるかを観察することです。
試すときは、次の順で確認すると迷いにくくなります。
- 利用するAIが、その画像形式と文章の組み合わせに対応しているか確認します。
- 個人情報、機密情報、第三者の権利に関わる素材を避けます。
- 画像の何を知りたいのか、一文で目的を書きます。
- 確認できない内容は推測しないよう、回答範囲を指定します。
- 回答を元画像と見比べ、事実と提案を分けます。
たとえば、自作した架空の営業時間案内を画像にし、「曜日ごとの営業時間を表にしてください」と依頼できます。回答が返ったら、曜日や数字を一つずつ元画像と照合します。続けて「初めて見る人が休業日を見落としそうな箇所を、提案として挙げてください」と頼めば、情報抽出と改善提案の違いも観察できます。ここで得られるのは実測された効率ではなく、自分の用途に合うかを判断する材料です。
マルチモーダルAIを知る前は、「画像も使える便利なAI」という印象だけで選びがちです。知った後は、「必要な入力の組み合わせに対応しているか」「回答形式は目的に合うか」「元資料で確かめられるか」という三つの質問を持てます。次にAIを使う機会があれば、機能名を眺めるだけで終わらせず、公開して問題のない画像一枚と具体的な質問を用意してください。回答を照合するところまでを一回の作業に含めることが、安全で実用的な第一歩になります。
参考情報
- What Is Artificial Intelligence (AI)? | IBM(公開日: 2024年8月9日、更新日: 2026年10月2日、取得日: 2026年11月2日)
- AI vs. Machine Learning: How Do They Differ? | Google Cloud(取得日: 2026年11月2日。取得資料内に公開日の記載はありません)