
2026/11/01
AIニュース
画像編集AIは「生成力」より検証力へ AdobeのEditAgentが示す専門ツール併用の設計
画像編集AIの課題は「作ること」から「選んで確かめること」へ
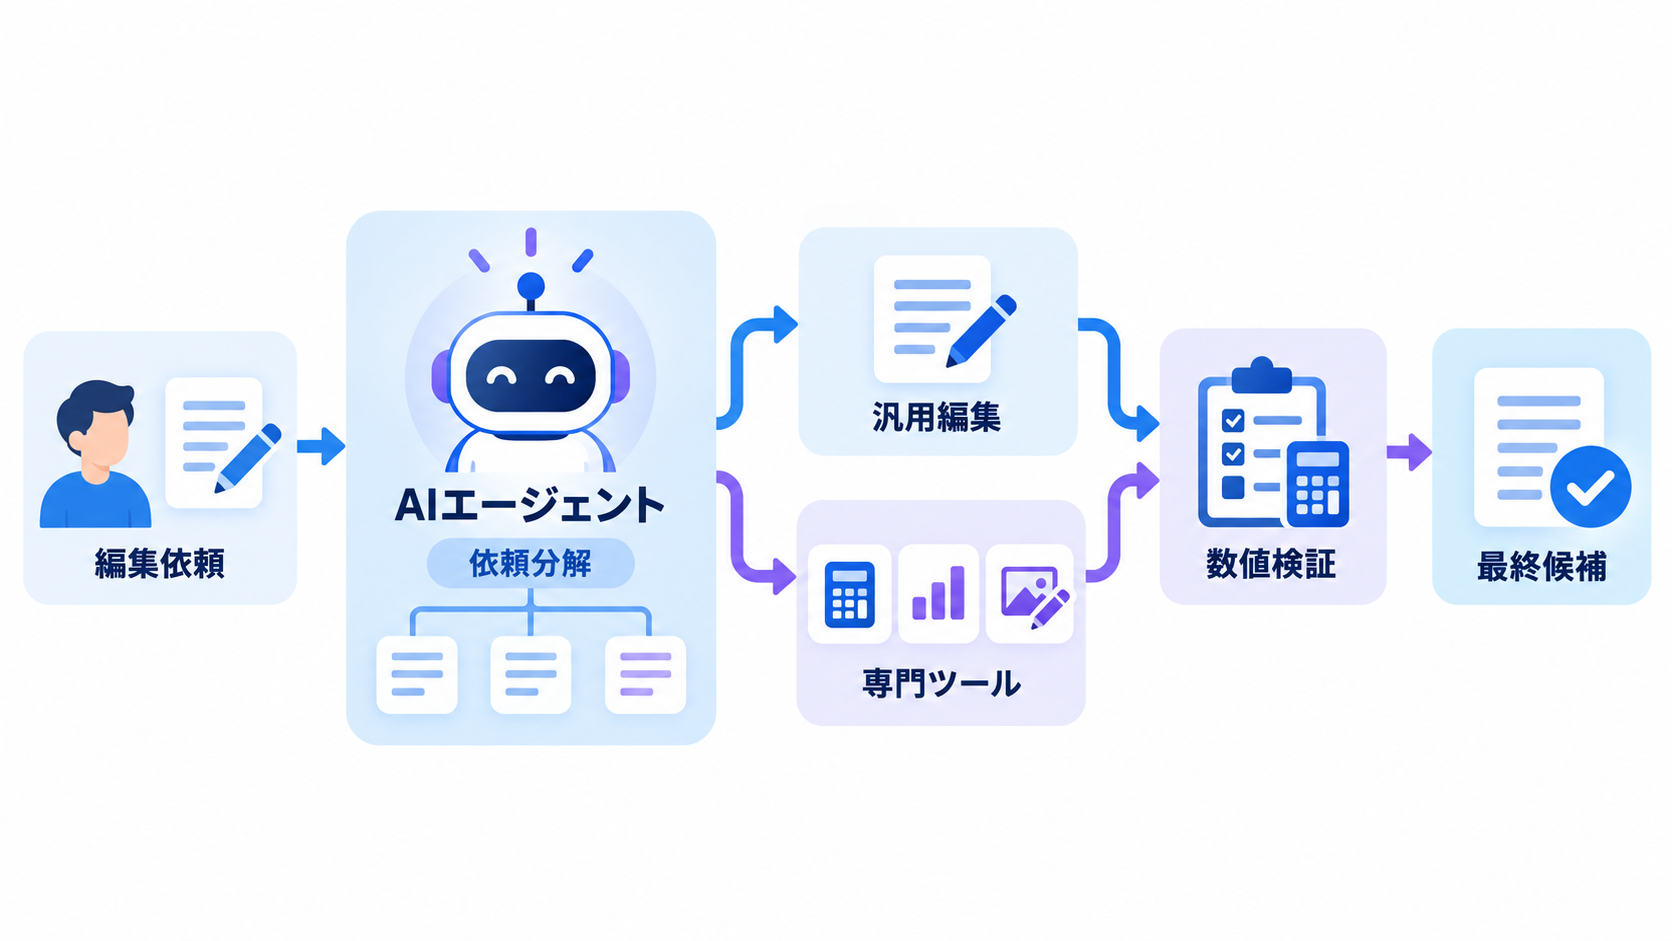
「窓を曇りガラスに変えたうえで、室内を少し明るくしてください」。人が画像編集ソフトで対応するなら、依頼を複数の作業に分け、加工内容に合った機能を選び、前の修正が崩れていないかを確認します。ところがAIエージェントは、ひとつの汎用編集モデルに作業を任せ、失敗した場合も同じ手段でやり直すことが少なくありません。完成画像を別のモデルが見た目だけで評価する方式では、わずかな色ずれや局所的な破綻を見逃す可能性もあります。
Adobe Researchとカリフォルニア大学サンディエゴ校の研究者が開発したEditAgentは、この問題をツール選択と検証の設計から見直しています。依頼を依存関係のある工程に分解し、汎用モデルと用途別の専門ツールを並行して動かします。そのうえで、複数の候補を数値データとともに言語モデルへ渡し、最も条件に合う結果を選ばせる仕組みです。
注目すべき点は、単に強力な画像生成モデルへ置き換えた研究ではないことです。EditAgentが示しているのは、企業が生成AIを業務へ組み込む際、モデル単体の性能だけでなく、適切な道具を選ぶ制御層と、結果を確かめる観測データが成否を左右するという考え方です。画像編集に限らず、複数の手段から候補を作り、測定可能な根拠で選別する構成は、AIエージェント全般を設計するうえで参考になるでしょう。
汎用モデルだけでは埋まらなかった42.7%の失敗
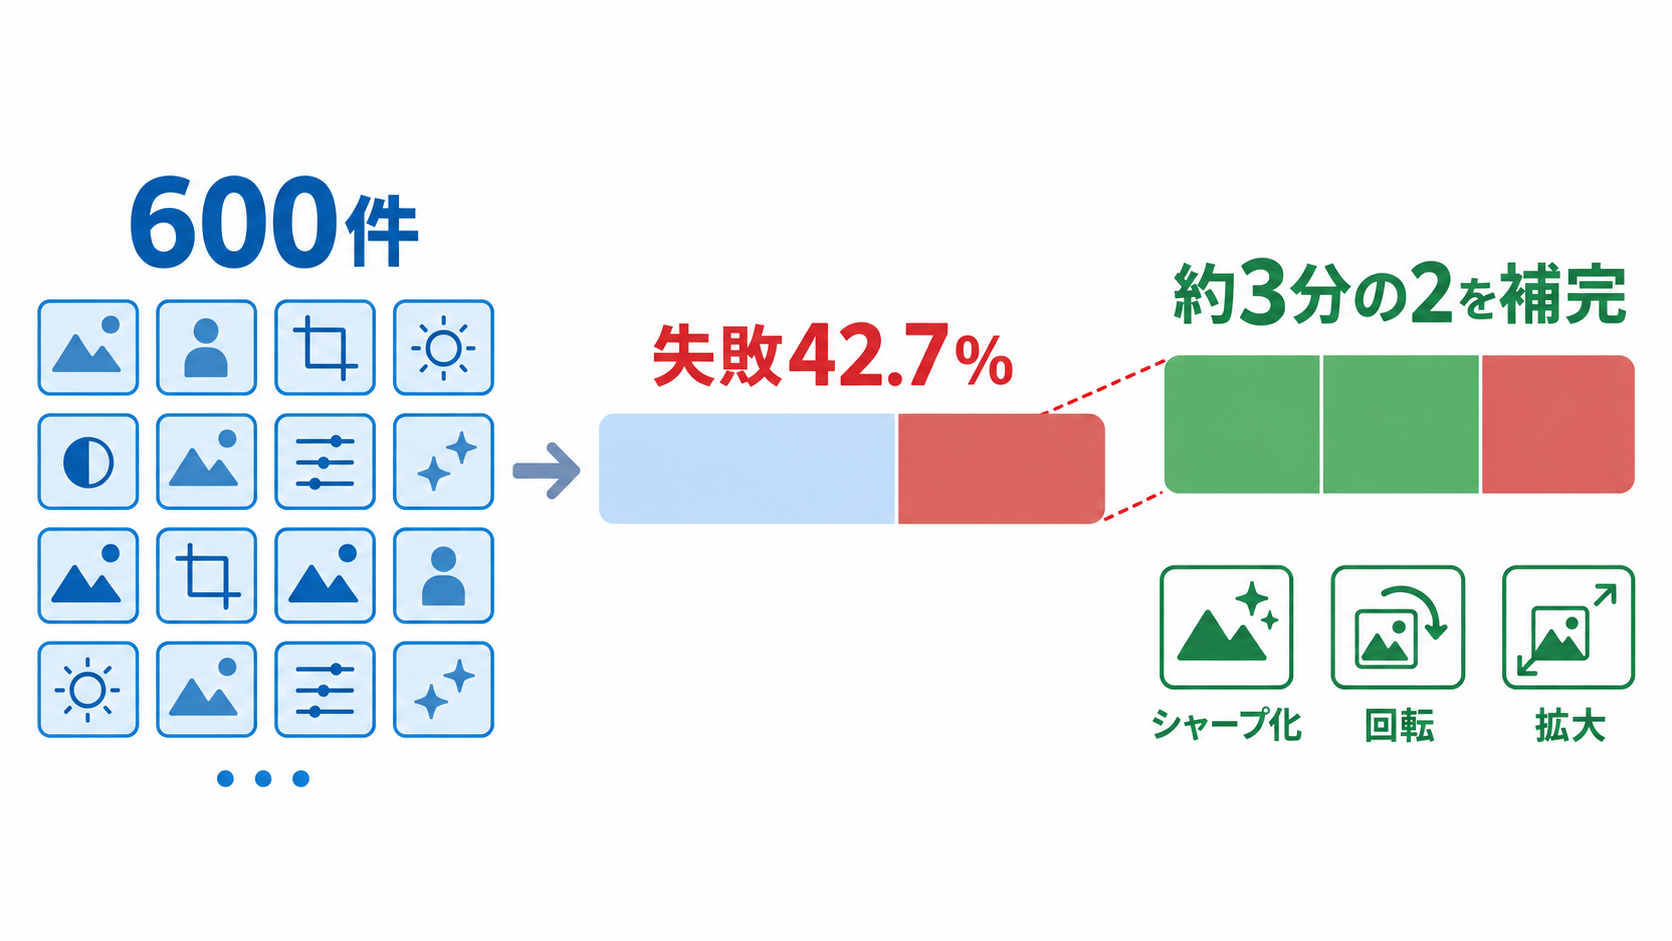
研究チームは、600件の画像編集を対象に、5人の専門家が編集方法を知らされない状態で結果を評価するベンチマークを実施しました。汎用画像編集モデルのFlux-2-Klein-9Bは、42.7%の依頼で利用可能な結果を生成できませんでした。ここでいう失敗は、単に好みと合わないという意味ではなく、専門家が実務に使える水準ではないと判断した結果です。
失敗例に用途別の専門ツールを適用すると、およそ3分の2を解決できました。特に効果が表れたのは、シャープ化、回転、拡大といった処理です。これらは指示内容が比較的明確で、専用の画像処理機能なら変更量を制御しやすい一方、汎用モデルには画像全体を再解釈してしまう余地があります。同じ汎用モデルで試行回数を増やしても、改善はわずかでした。
この結果は、あらゆる編集をひとつの生成モデルへ集約する設計の限界を示しています。Photoshopのような編集ソフトに切り抜き、回転、色調整などの機能が分かれているのは、作業ごとに求められる制御方法が異なるためです。AIエージェントにも同様の役割分担を持たせれば、創造的な変更は汎用モデル、幾何学的または定量的な変更は専門ツールという使い分けができます。
企業システムに置き換えて考えると、「最も高性能なモデルを選べば解決する」という調達方針だけでは不十分です。対象業務を工程単位で観察し、決まった処理で確実に実行できる部分と、生成モデルの柔軟性が必要な部分を分ける必要があります。EditAgentの成果は、モデルの再試行よりもツール構成の多様性が有効な場面を、具体的な評価結果で示しています。
やり直しを重ねるより、元画像から複数案を作る理由
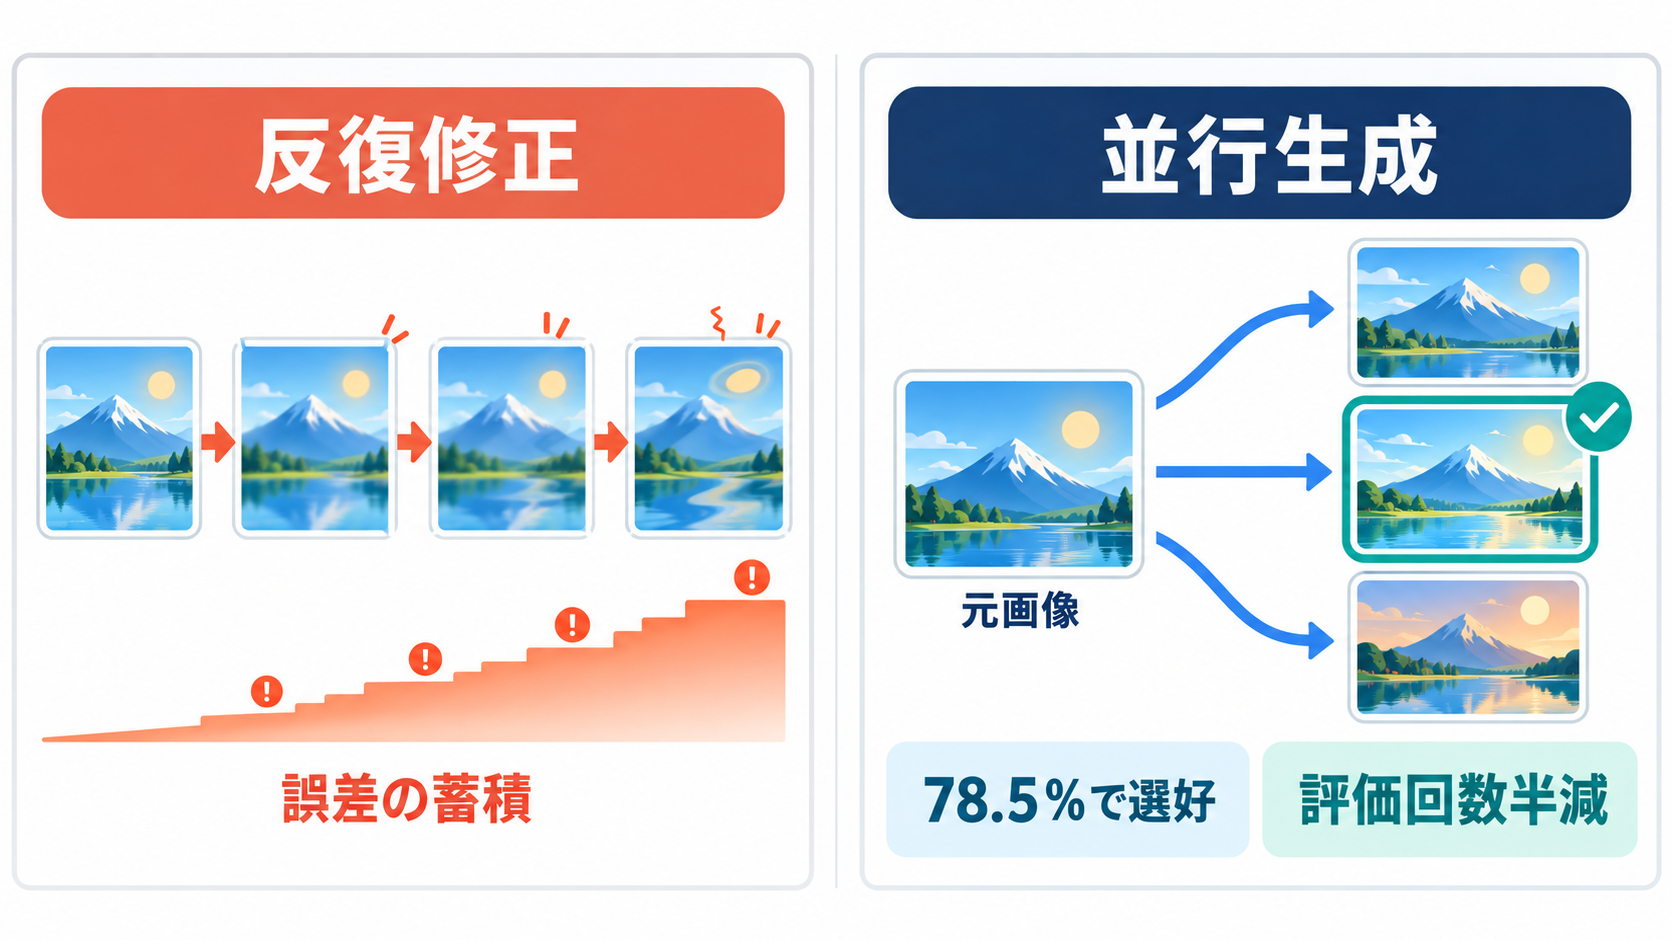
AIによる画像編集では、ひとつの結果を生成し、不足を指摘して修正を重ねる反復型の処理がよく使われます。対話的で分かりやすい方法ですが、各回の入力には前回までの変更が含まれます。小さな色ずれや輪郭の崩れが発生すると、それを抱えた画像を土台に次の編集が進むため、誤差が積み重なりかねません。
研究チームは、同じ結果を段階的に修正する方式と、元画像から異なる手法で複数の候補を並行生成する方式を比較しました。専門家がどちらかを明確に選んだ比較では、78.5%で並行生成された候補が好まれています。しかも、エージェントが必要とした評価処理の回数は半分でした。候補数を増やすことが、そのまま無駄な計算の増加を意味するわけではありません。
並行方式では、汎用モデルと複数の専門ツールが、変更されていない同じ画像を出発点にできます。候補同士の条件がそろうため、どの手法が指示を適切に満たしたかも比較しやすくなります。失敗した候補を次工程へ引き継がずに済む点も、品質を安定させる理由のひとつです。
ただし、並行生成は何通りも出力すればよいという話ではありません。候補を公平に評価する基準がなければ、エージェントは見栄えの派手な画像や、変更量の大きな画像を選ぶ可能性があります。EditAgentでは、候補を作る戦略と、数値を使って選ぶ仕組みを組み合わせています。複数案の生成と検証をひとつの設計として扱った点に、この研究の実務的な意味があります。
言語モデルの判断を変えた「検証レコード」
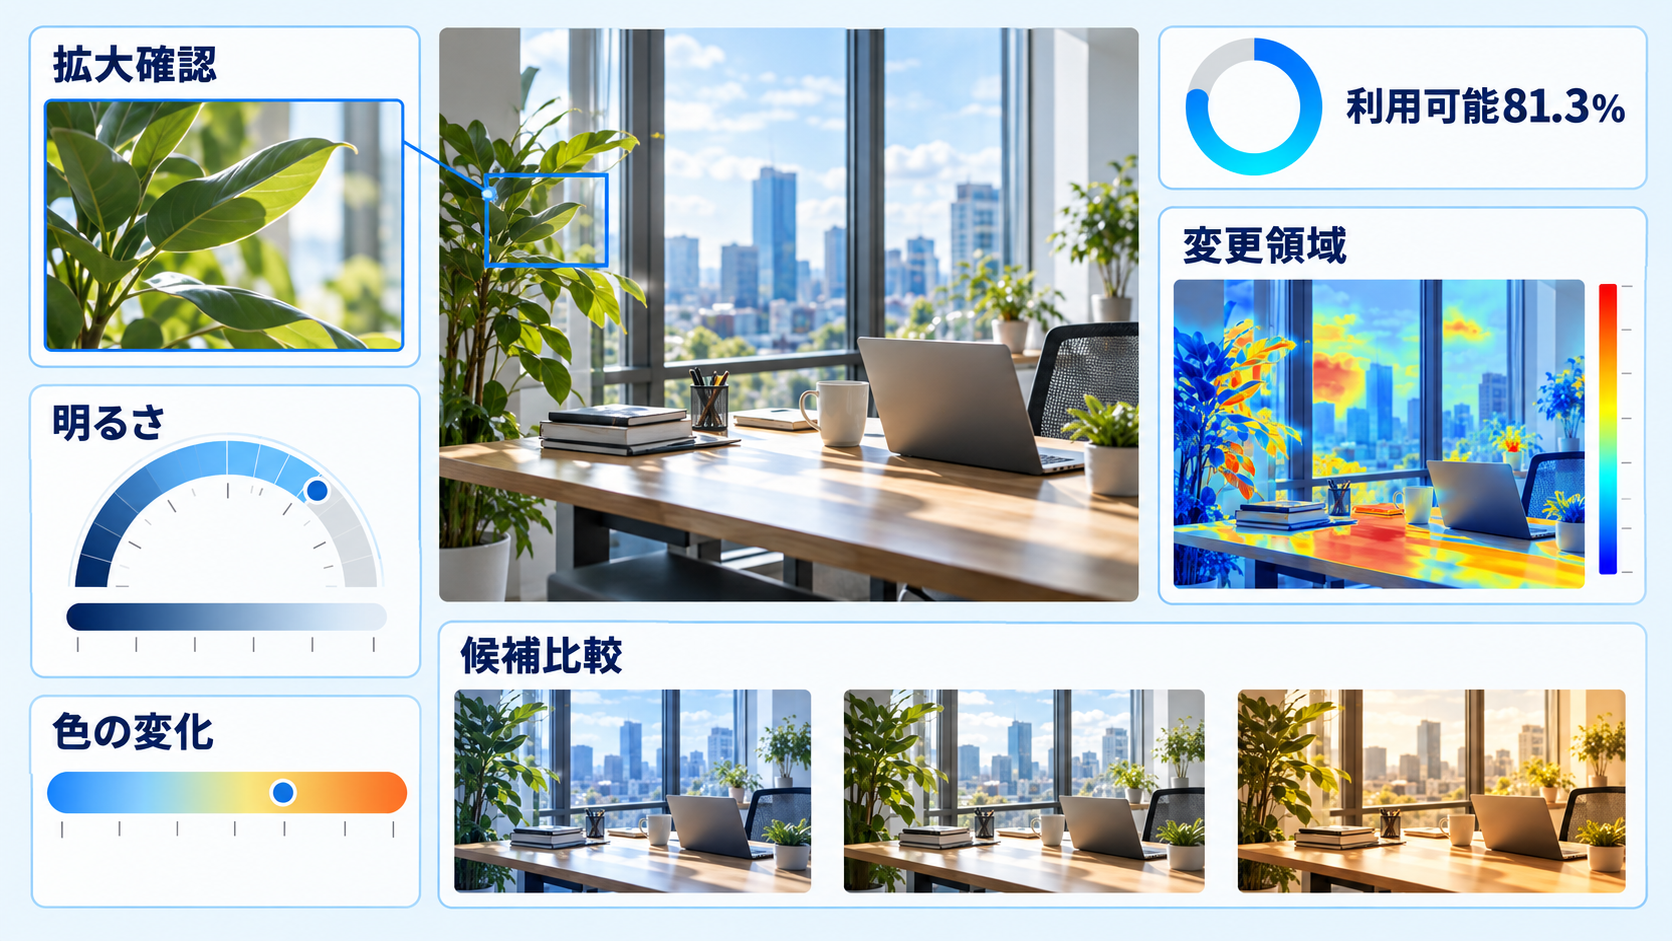
EditAgentは、候補画像の全体だけを言語モデルに見せるのではなく、検証レコードを添えています。レコードに含まれるのは、編集箇所の拡大画像、変更された領域を示す差分マップ、明るさや色に関する測定値です。人が画像を目視するときに見落としやすい変化を、局所表示と数値で観察できるようにしています。
研究で紹介された明るさ調整の例では、汎用編集モデルが画像を過度に明るくし、色も暖色側へ動かしていました。全体画像だけを見ると自然に感じられる可能性がありますが、測定値を確認すれば、求められた「穏やかな明るさの調整」から外れていることが分かります。専門ツールの候補は指定に近い範囲へ収まり、言語モデルはその差を根拠に選択できました。
600件のベンチマークでは、7種類の標準的な言語モデルに複数候補を評価させ、専門家が利用可能と判定した画像を選べるかが測定されました。検証レコードがない場合、7モデルのいずれも、人間の画像編集評価で追加学習された最良の専用モデルに届きませんでした。ところが検証データを与えると、全7モデルがその専用モデルを上回っています。
具体的には、Qwen3.8-27Bが利用可能な候補を選んだ割合は81.3%で、専用評価モデルEditScore-72Bの74.8%を超えました。ここから研究チームは、評価モデルをどう訓練したかだけでなく、判断時に何を見せるかが大きく影響すると捉えています。企業にとっても示唆は明確です。高度な専用モデルを新たに訓練できなくても、業務システム側で比較材料を整備すれば、既存モデルの判断精度を引き上げられる可能性があります。
後の編集が前の成果を壊す「手戻り」の検出
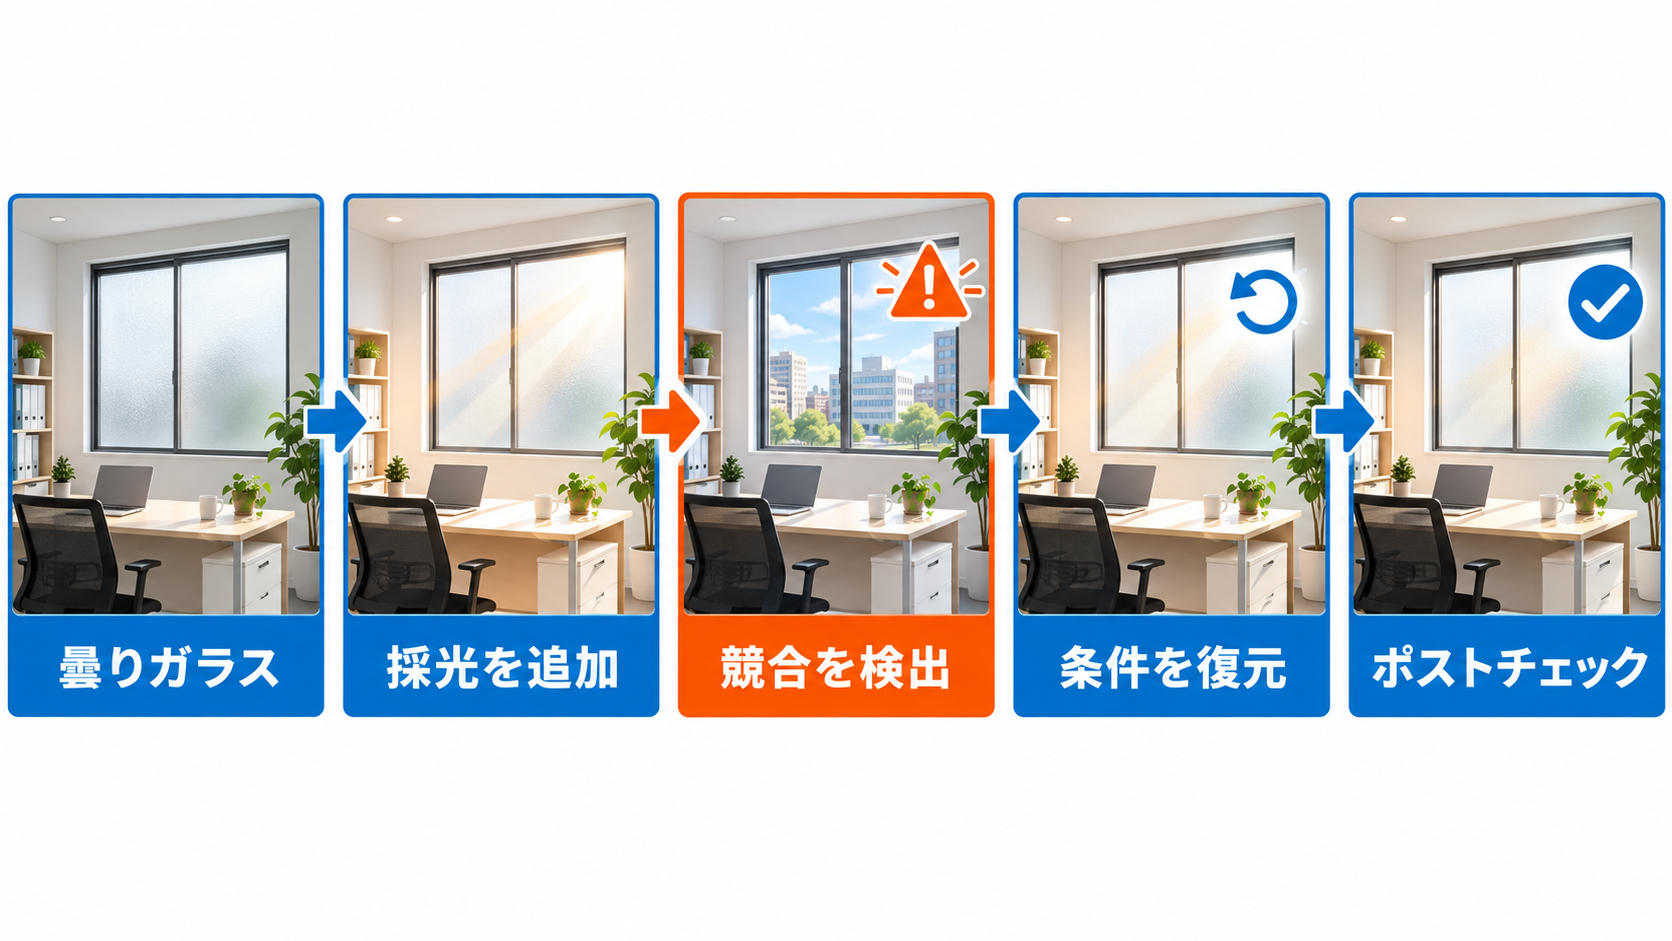
複数の編集指示には、工程間の依存関係があります。たとえば窓を曇りガラスにした後で、「室内へもっと日光を入れる」と指示すると、明るさを調整する処理が窓を透明な状態へ戻してしまうかもしれません。個々の工程だけを見れば指示に沿っていても、依頼全体としては先に達成した条件が失われています。
EditAgentは各ラウンドの後に、それまでの編集が維持されているかを再確認します。研究で示された例でも、採光を増やす変更によって曇りガラスが透明へ戻ったことを検出し、競合を修正しました。単純に最新の指示だけを評価するのではなく、完了済みの条件を含めて整合性を点検する仕組みです。
この問題は、画像編集に固有のものではありません。文章を段階的に修正するAIが、後から加えた表現によって先に確定した数値を変えてしまう場合や、業務エージェントが新しい入力を処理する過程で承認済みの設定を上書きする場合にも、同じ構造が現れます。工程ごとの成功判定だけでは、最終成果物の一貫性を保証できません。
業務への導入時には、各ステップの評価基準に加え、保持すべき条件を明示する必要があります。変更してよい領域、維持すべき属性、前工程の完了条件を記録し、処理後に再検証する構成が求められるでしょう。EditAgentのポストチェックは、AIエージェントを一連の自動操作としてではなく、状態を引き継ぐワークフローとして管理する必要性を示しています。
ベンチマーク向上と約10倍の計算コスト
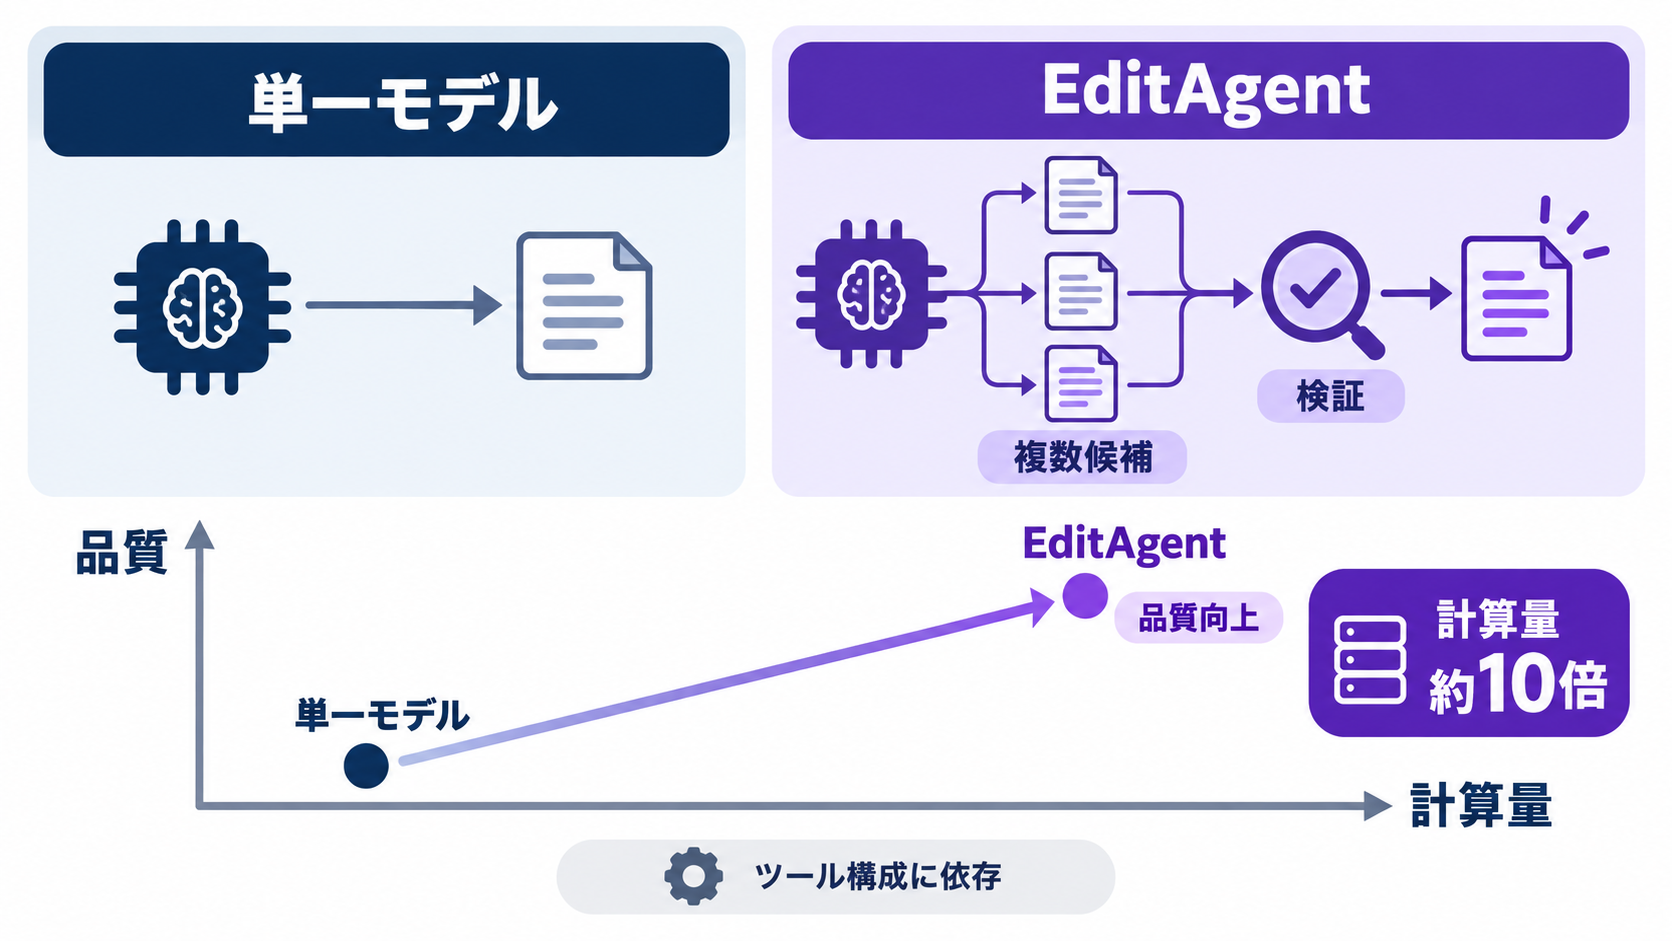
EditAgentは、オープンソースの画像編集モデルQwen-Image-Edit-2511とFlux-2-Klein-9Bを基盤として評価されました。3種類のベンチマークで両モデルの性能を改善し、比較対象となった7つのAIエージェントを上回っています。EdiValでは、Qwenを使った構成の3回目の編集ラウンドが、商用モデルのSeedream 4.0とGPT-Image-1.5をわずかに超えました。
ただし、品質向上には相応の代価があります。EditAgentが必要とする計算量は、単一の編集モデルを一度使う場合のおよそ10倍です。複数ツールによる候補生成、検証データの作成、言語モデルによる比較、工程後の再確認を実行するためです。接続する専門ツールの種類や性能によって、エージェント全体の成果が変わる制約もあります。
企業がこの方式を採用する場合、すべての編集へ一律に適用するのは効率的ではないでしょう。失敗した場合の修正コストが高い作業、ブランド表現を厳密に守る必要がある素材、人の確認件数を減らしたい大量処理など、検証へ計算資源を投じる価値がある場面を選ぶ考え方が必要です。試作用の画像や低リスクの社内素材であれば、単一モデルの高速な処理が適する可能性もあります。
なお、論文の実験で使われた汎用モデルは、開発元のBlack Forest Labsによってすでに新世代のFlux 3 Image Kleinへ置き換えられています。同社によると、新モデルは56億パラメーターでFlux 2 Kleinより小型ながら、社内評価では他のオープンモデルや商用のFlux 2 Proを上回りました。基盤モデルが進歩しても、専門ツールの選択や検証が不要になるとは限りません。EditAgentの価値を判断する際は、最新モデルを組み込んだ場合の品質とコストを改めて測定する必要があります。
検証済みの結果を2万6,000件の学習データへ
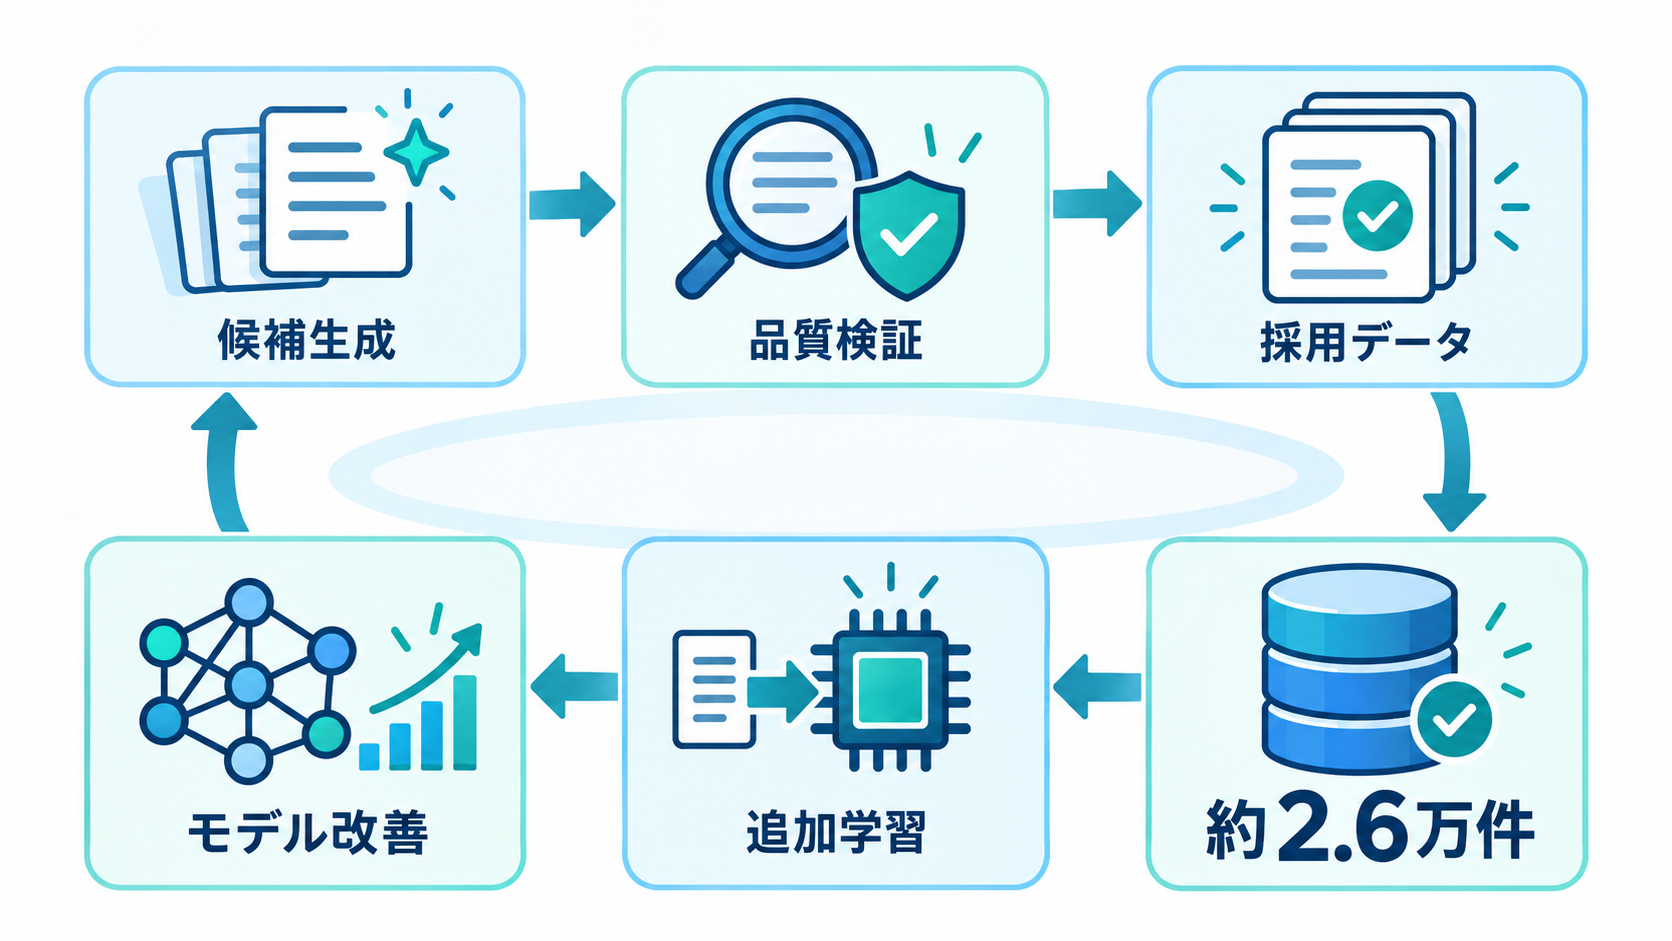
EditAgentの高い計算コストを長期的に回収する方法として、研究チームは検証済みデータの再利用を試しています。エージェントが作成した候補のうち、評価工程を通過した結果だけを残すことで、約2万6,000件の学習例を生成しました。このデータを使って画像編集モデルを追加学習すると、3種類すべてのベンチマークで性能が向上しています。
対照的に、FLUXが直接生成したデータでFLUXを訓練した場合は、性能が悪化しました。生成量だけを増やしても、誤りや不適切な編集が混ざれば、その傾向まで学習される可能性があります。EditAgentは候補生成の段階で多くの計算資源を使いますが、検証を通過した例を蓄積できるため、品質管理された教師データの生産装置としても機能します。
この仕組みでは、高コストなエージェントが優れた作業例を集め、そのデータで軽量な編集モデルを改善する循環が生まれます。改善後のモデルが多くの通常処理を担えるようになれば、複数候補の生成と評価を毎回行う必要が減るかもしれません。ただし、どの程度コストを削減できるかや、実運用で同じ改善が続くかは、今回確認できた情報だけでは明らかになっていません。
企業内の生成AI活用でも、出力を保存するだけでは有用な学習資産になりません。依頼内容、使用したツール、測定値、採用・不採用の判断を関連付けて残すことが重要です。人が承認した結果や自動検証を通過した結果を区別できれば、将来のモデル改善やルール調整に利用しやすくなります。計算コストを単発処理の費用として見るのではなく、再利用可能な品質データを生む投資として評価する視点が必要でしょう。
日本企業が導入前に決めておきたい評価設計
AdobeはPhotoshop、PremiereなどのCreative Cloud製品へAIエージェントを追加し、利用者が希望を文章で伝えると個別の工程を処理する機能を公開ベータとして提供しています。実製品で問われるのは、編集そのものの巧さだけではありません。エージェントが依頼に適した機能を選べるか、結果を自分で点検できるか、先に完了した変更を壊していないかが、継続利用の信頼性に直結します。
日本企業が画像制作や販促物の編集へ同様の仕組みを導入するなら、モデル比較より先に「利用可能な結果」の条件を定める必要があります。たとえば、指定領域以外を変えないこと、明るさや色の変更幅を測れること、ブランド上保持すべき要素を確認できることなどです。具体的な基準は用途によって異なりますが、担当者の感覚だけに依存すると、自動評価の設計も曖昧になります。
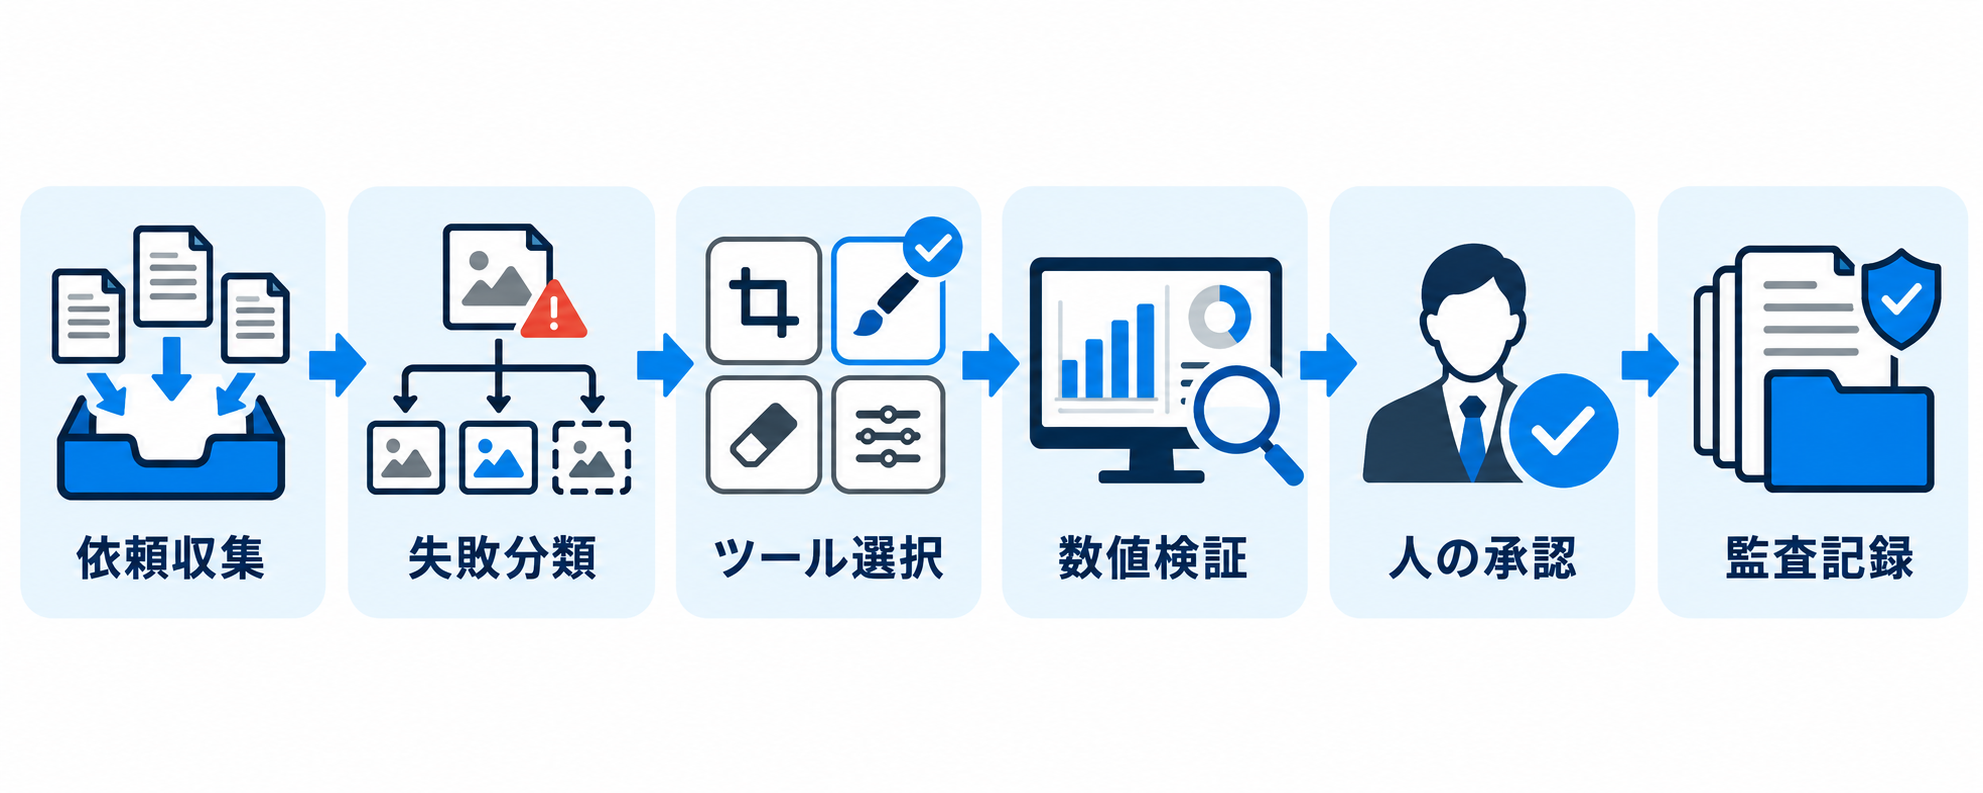
運用開始時には、汎用モデルだけで完結させず、確実な既存処理を専門ツールとして残す構成が現実的です。候補を並行生成する対象は失敗しやすい工程へ絞り、数値で確認できる属性には検証レコードを用意します。前工程の条件を保持するポストチェックと、判断が難しいケースを人へ戻す経路も欠かせません。これらを監査可能な記録として残せば、どのツールがどの条件で失敗したかを追跡できます。
EditAgentが示した中心的な教訓は、AIエージェントの品質をモデルの知能だけに任せないことです。最初の実証実験では、業務で頻出する編集依頼を小規模に集め、汎用モデルの失敗を分類するとよいでしょう。その失敗を専門ツールで補えるか、どの測定値なら良否を区別できるかを確認すれば、自社に必要なエージェント構成と、約10倍の計算コストを負担する範囲を具体的に判断できます。