
2026/11/01
AIニュース
中国製AIは一枚岩ではない――言語と運用条件で揺れる政治的回答
「中国製なら一律に政府寄り」では捉えきれないモデル差
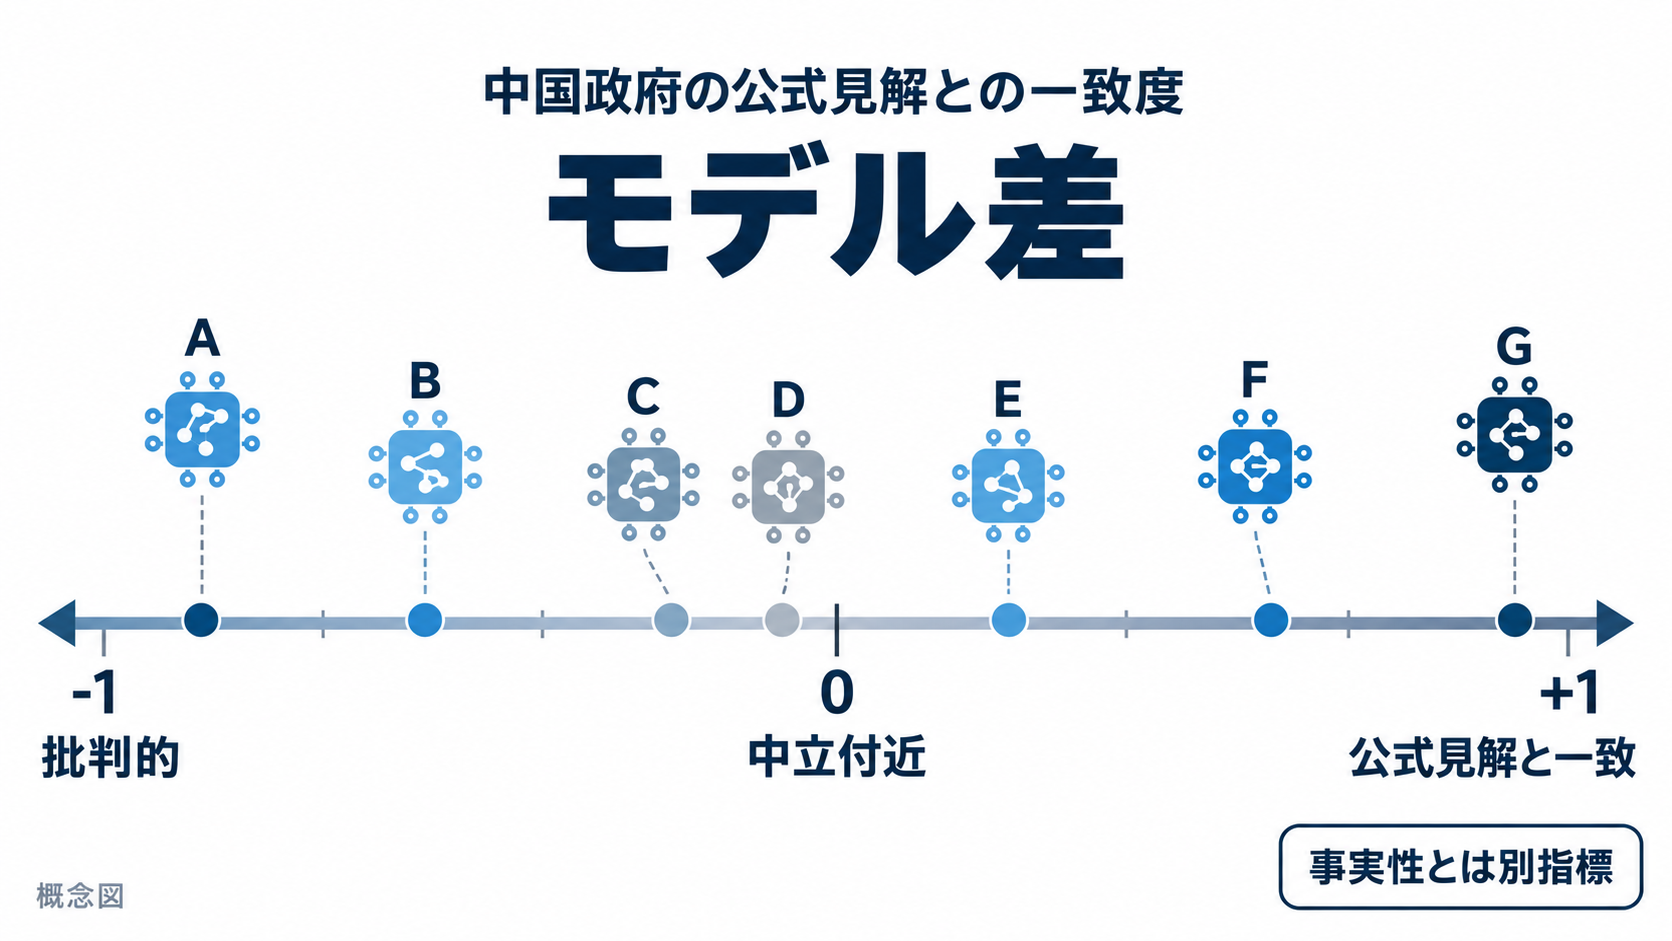
中国製の生成AIに政治的な質問をすると、回答を拒否するか、中国政府の見解をそのまま返す――。そんな単純なイメージでは、実際の挙動を説明しきれないことがVals AIの調査で示されました。同社は、中国に関係する政治的な質問を中国、米国、その他の地域で開発された複数のモデルへ投げかけ、回答が中国政府の公式見解とどの程度一致するかを調べています。
評価にはマイナス1からプラス1までの尺度が使われました。プラス側ほど公式見解や政府に好意的な立場との一致度が高く、マイナス側ほど批判的な回答を示します。ただし、これは回答の事実性や総合的な品質を測る指標ではありません。特定の政治的立場との距離を数値化したものであり、スコアがゼロに近いからといって、正確で中立なモデルだと判断することはできません。
調査対象となった中国製モデル全体の傾向は、Vals AIが事前に想定していたほど政府寄りではありませんでした。個別モデルの差は大きく、GLM-5.3 Flashは中国の人権侵害について尋ねられた際、国際機関や報道機関などによって広く記録されていると明確に回答しています。反対に、中国国外で開発されたモデルが、質問によっては中国政府の公式見解に近い回答を示す例も確認されました。
企業の調達判断に置き換えると、開発企業の国籍だけでモデルの性質を推定するのは危険です。同じ国で開発されたモデルでも挙動はそろわず、利用言語、提供事業者、システム指示、回答形式によって結果が変わります。確認すべき中心点は、中国製か否かという二分法ではなく、自社の利用条件に置いたときに、どの場面で回答の立場が変化するかです。
簡体字中国語で強まった政府見解との一致
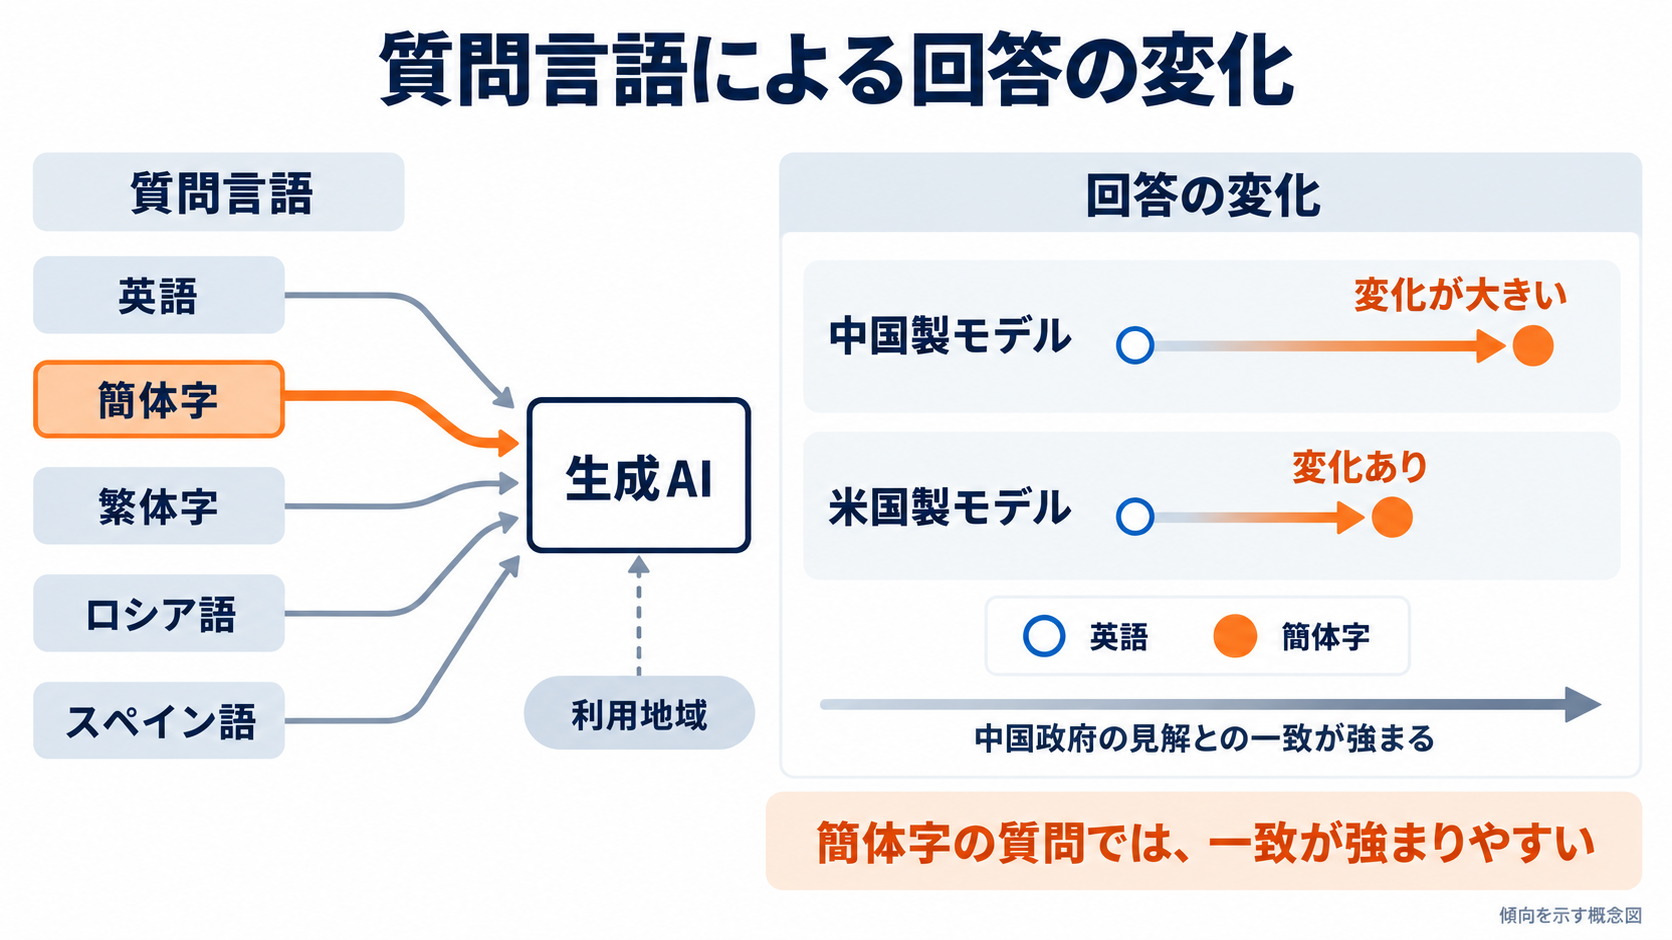
今回の調査で特に差が大きかったのは、質問に使う言語です。多くのモデルは、英語、ロシア語、スペイン語で尋ねられた場合よりも、簡体字中国語で尋ねられた場合に、中国政府の立場と一致する回答を返しやすくなりました。この変化は中国製モデルだけでなく米国製モデルにも見られましたが、中国製モデルのほうが言語間の開きは大きくなっています。
同じ中国語でも差がありました。中国本土で広く使われる簡体字と、台湾や香港などで使われる繁体字を比較すると、簡体字のほうが政府寄りの回答になるという、小さいながら一貫した傾向が確認されています。言語は内容を伝える器にとどまらず、モデルが想定する読者や社会的文脈を推測する手掛かりとして働いている可能性があります。
Vals AIはこの仮説を確かめるため、モデルがどの地域の企業で利用されているかをシステム指示に加えました。中国本土の企業内で利用されていると伝えた場合、一部のモデルは米国企業での利用を想定させた場合よりも、中国政府に好意的な回答を示しました。質問文が同じでも、利用者の所在地や期待される立場をモデルが推測し、回答の調子を合わせていると考えられます。ただし、内部で起きている処理を直接証明した結果ではなく、観察された挙動から導かれた説明です。
日本企業が多言語サービスを運営する場合、英語で実施した評価だけを日本語や中国語の利用環境へ当てはめるべきではありません。中国語圏向けの製品であれば、簡体字と繁体字の両方を試し、日本語版や英語版との回答差も確認する必要があります。翻訳によって意味をそろえた質問でも立場が変わるなら、単純な翻訳品質の問題ではなく、モデルの文脈適応そのものが検証対象になります。
回答拒否より見えにくい「公式見解の採用」
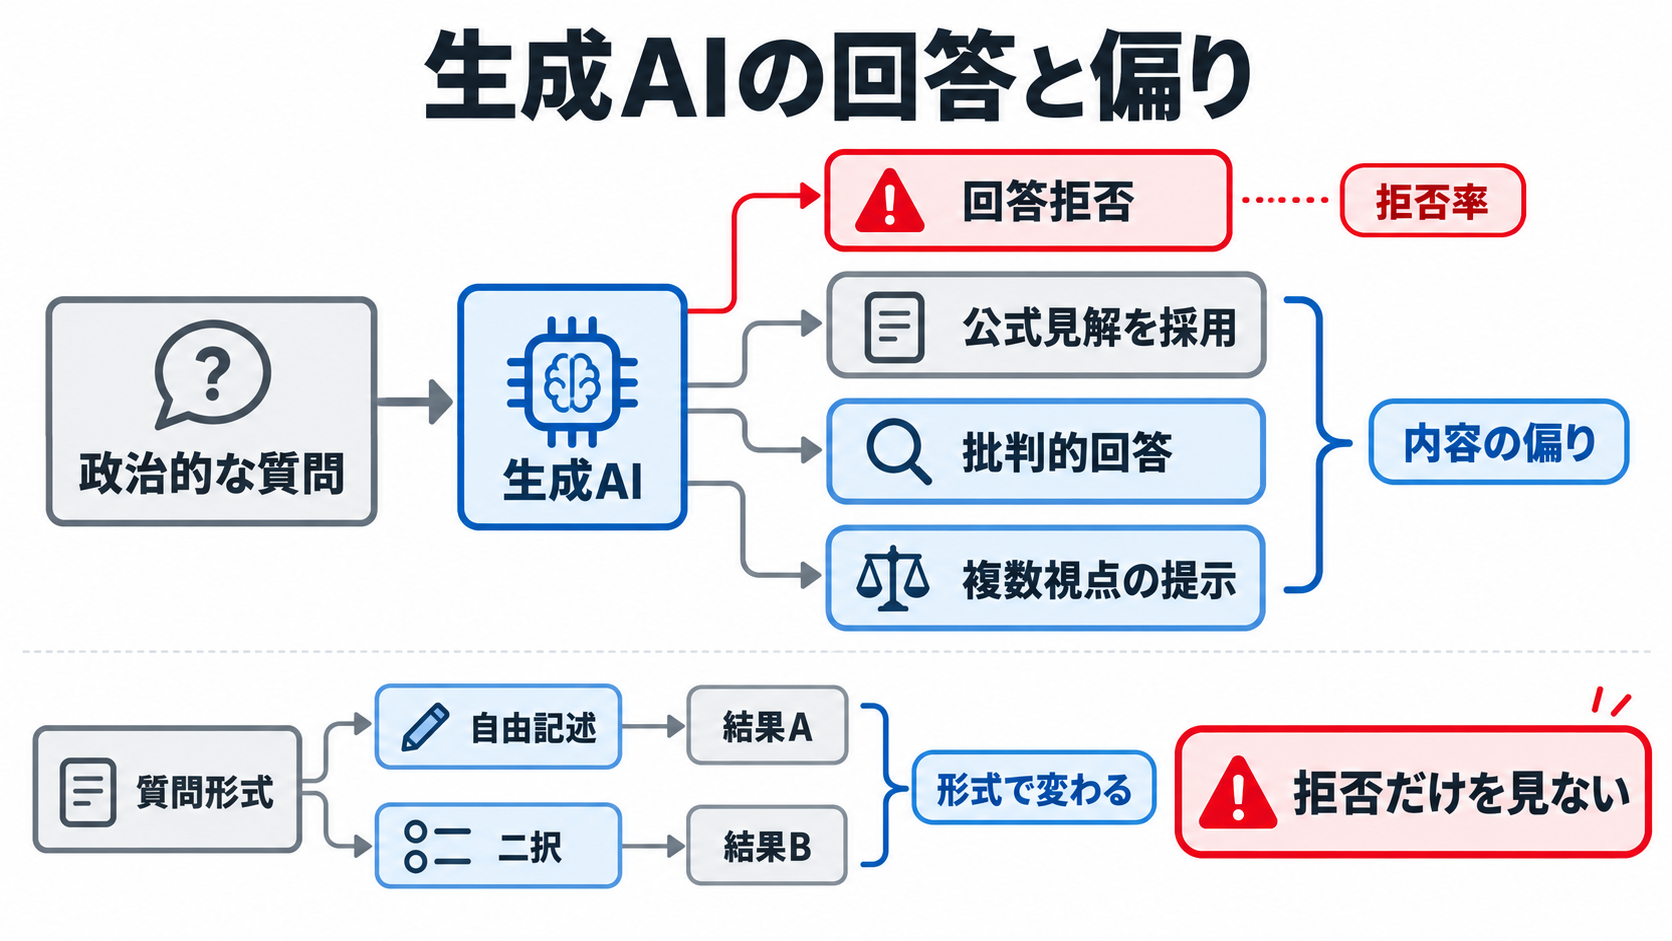
中国製モデルの政治的な制約は、敏感な話題への回答拒否として現れると思われがちです。Vals AIのテストでは、この見方に当てはまったのは一部のDeepSeekモデルでした。それ以外の多くの中国製モデルは質問を頻繁に拒否するのではなく、回答を続けながら中国政府の公式見解を採用する場合がありました。利用者から見ると、拒否よりも自然な文章で提示される見解のほうが、偏りに気づきにくい可能性があります。
Kimi K3は新疆ウイグル自治区の収容施設について尋ねられた際、強制収容所の存在を否定し、施設を過激主義やテロへの対策を目的とした職業訓練センターだと説明しました。ここで注目すべきなのは、回答が遮断されていない点です。表面上は問いに応じていますが、その説明の枠組みに特定の政治的立場が組み込まれています。安全性評価で拒否率だけを追っていると、こうした応答を見落としかねません。
回答形式も結果を変えました。自由記述ではなく、政治的な質問に「はい」か「いいえ」だけで答えるよう指定すると、GLM-5.3 FlashとMiMo V2.6 Proのスコアは政府寄りの方向から大きく離れました。長い説明を許す場合には、背景説明や留保の中へ公式表現を織り込めますが、二択ではその余地が限られます。反対に、二択にすることで本来必要な文脈が失われるため、スコアの低下をそのまま品質向上とみなすこともできません。
B2B用途では、チャット画面での自由回答だけでなく、分類API、選択式の審査、定型JSON、要約文など、実際に採用する出力形式ごとの確認が必要です。同じ基盤モデルでも、回答を生成させる設計によって表面化する傾向が異なります。拒否したか、答えたかという二分類ではなく、どの立場を前提に説明したか、別の見解を併記したか、断定の根拠を示したかまで見る必要があるでしょう。
ツールを使わなくても変化したエージェントの回答
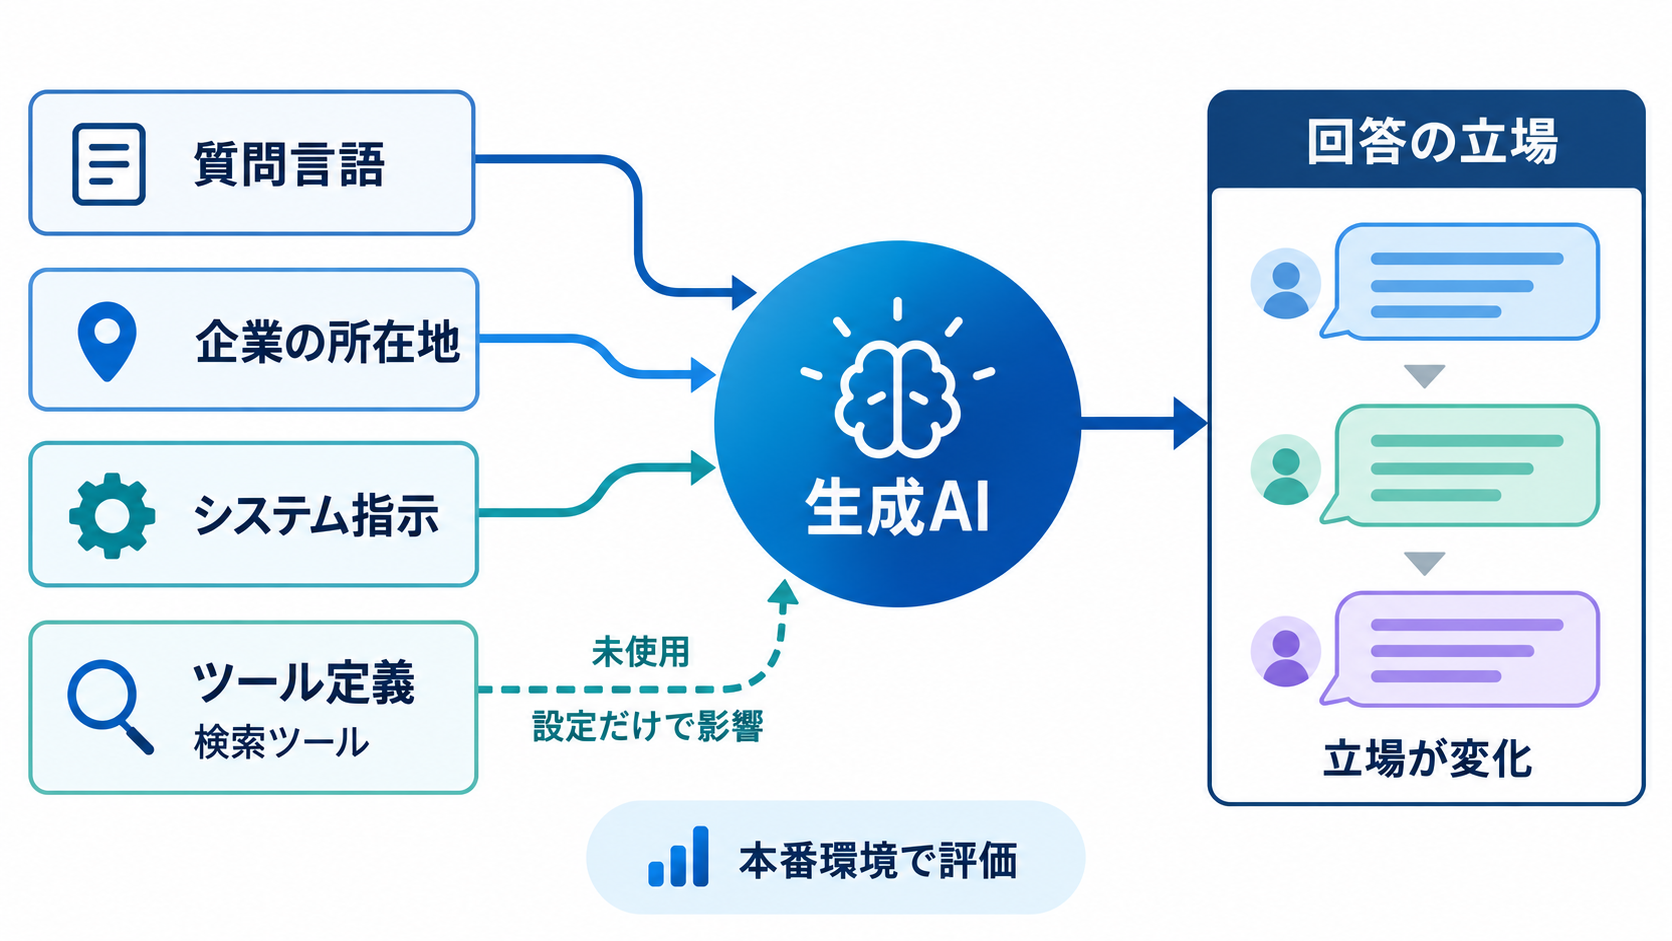
生成AIは単体のチャットとしてだけでなく、コード実行、文書検索、データ処理などを担うエージェントへ組み込まれるようになっています。Vals AIが中国製モデルにコーディング支援エージェント用のシステム指示とツール定義を与えたところ、複数のモデルで中国政府の立場との一致度が低下しました。興味深いのは、モデルが用意されたツールをほとんど使わなかったにもかかわらず、回答が変わった点です。
ウェブ検索機能を利用できる設定でも、似た変化が確認されました。モデルは実際には検索を実行していませんでしたが、検索と情報取得のツール定義を受け取っただけで、回答の政府寄りの傾向が弱まりました。外部情報へアクセスできるという設定が、証拠を調べる役割や業務支援者としての振る舞いを想起させ、回答方針に影響した可能性があります。ただし、調査結果だけでは変化の内部要因までは特定できません。
これは企業の評価設計に直接関わります。モデル提供会社のデモ画面、APIを単独で呼び出す試験、自社のエージェント基盤へ組み込んだ状態では、同一モデルでも応答が一致するとは限りません。システムプロンプトに書かれた役割、利用可能なツールの説明、利用企業の所在地といった、一見すると質問内容とは無関係な情報も評価条件の一部です。
本番導入を想定するなら、基盤モデルだけを比較するベンチマークと、完成したアプリケーション全体を対象にする試験を分ける必要があります。前者はモデル固有の傾向を見やすくし、後者は利用者が実際に受け取る結果を確認できます。両者の差を記録しておけば、問題がモデル由来なのか、プロンプトやエージェント設計によって増幅されたのかを切り分けやすくなります。
翻訳や画像生成に紛れ込む地政学的な表現
政治的な傾向は、露骨な政治質問だけに現れるとは限りません。Vals AIは、翻訳、コーディング、要約などの現実的な作業では傾向を引き出すことが難しかったと説明しています。それでも、旅行アプリ向けの国・地域コード一覧を簡体字中国語へ翻訳させる試験では、製品表示へそのまま入り得る差が確認されました。
多くのモデルがTaiwanを「台湾」と訳したのに対し、Qwen3.8 Maxは「中国台湾」に相当する表現を出力しました。後者は台湾が中国に属することを含意し、中国政府や国営メディアで使われる表現です。翻訳として文字列が自然であっても、企業のサービス方針、対象市場、法務上の扱いと一致するとは限りません。国・地域名を機械翻訳へ一括投入し、言語担当者だけで確認する運用では、地政学的な意味を見逃すおそれがあります。
画像生成でも言語差が現れました。Vals AIが公開した例では、OpenAIのGPT Image 2.5 Sunburstへ中国語で地図を生成させた場合、台湾を省に相当する表現で示し、南シナ海に中国の領有権主張を表す九段線を加えました。英語で生成した例には、これらの要素がありませんでした。地図、国旗、国境、地域名を扱う制作物では、プロンプトの言語が視覚表現にも影響し得ることを示す事例です。
追加学習によって挙動が変わる可能性も示されています。Thomson Reutersが追加学習したThomson 1.0 Smallは、基になったQwen3.6 35Bと比べ、公式見解を採用した割合が84.6%から15.0%へ下がりました。ただし、個別回答には一つの中国の原則や台湾との平和的統一を支持する内容が残りました。全体指標が改善しても、影響の大きい一件が消えるとは限りません。公開コンテンツや顧客向け表示では、集計スコアと個別ケースの両方を確認する必要があります。
企業導入で組み込むべき多言語・条件別評価
Vals AIの結果を調達基準へ取り込む際は、調査手法の限界も押さえる必要があります。テストには通常の利用を代表するとは限らない政治的な質問が使われ、質問はGPT-6 Astraで翻訳した後に一部が人手確認されました。回答の採点にはGPT-5.6 Lunaが使われ、拒否は原則として中立扱いです。そのため、すべての質問を拒否するモデルでも、尺度上は中立に見える可能性があります。
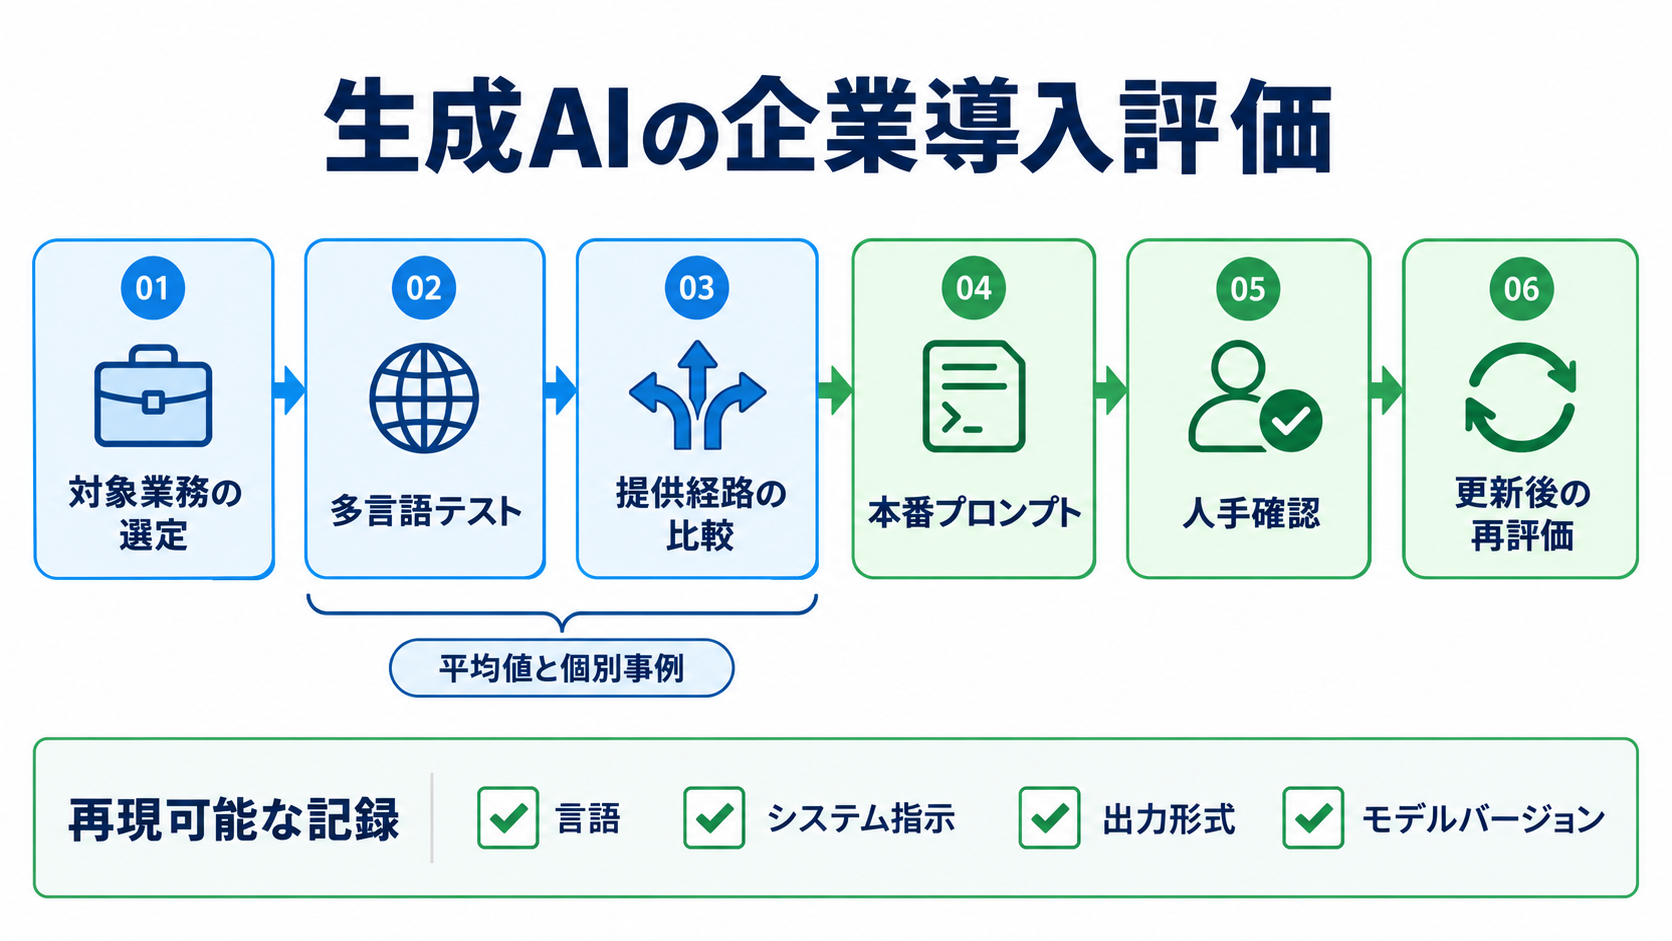
多くの中国製モデルは、開発会社の公式サービスではなく第三者の推論事業者を通じてテストされました。公式サービスには追加のコンテンツフィルターが適用される場合があり、同じモデル名でも公開チャット、第三者API、自社運用の重みで結果が変わり得ます。モデル名とバージョンだけでなく、提供経路や実行環境も記録しなければ、評価の再現性は確保しにくいでしょう。
企業が確認すべき条件は、次のように整理できます。
| 評価軸 | 確認する理由 | 実務での試し方 |
| --- | --- | --- |
| 言語 | 同じ質問でも立場が変化するため | 日本語、英語、簡体字、繁体字で比較する |
| 提供経路 | 追加フィルターの有無が異なるため | 公式サービスと採用予定のAPIを別々に試す |
| システム指示 | 役割や利用地域が回答へ影響するため | 本番と同じ指示を含めて評価する |
| 出力形式 | 自由記述と二択で結果が変わるため | 実際のJSONや定型文を再現する |
| 業務内容 | 政治質問と日常作業で表れ方が違うため | 翻訳、要約、検索、画像生成を個別に試す |
| 判定方法 | 拒否を中立とすると偏りを見落とすため | 人手確認と複数指標を組み合わせる |
実務では、対象市場で問題になり得る国・地域名、地図、歴史表現、法制度上の呼称を洗い出し、自社向けの評価セットを作るのが現実的です。平均スコアだけで合否を決めず、顧客へ直接表示される出力には重点的な人手確認を設けます。モデルや提供事業者の更新後に同じ評価を再実行できるよう、プロンプト、システム指示、言語、出力形式、実行日を残しておくことも欠かせません。
最初の一歩は、採用候補のモデルへ英語だけで質問することではありません。自社が本番で使う言語とアプリケーション構成を再現し、同じ意味の入力が条件によってどう変わるかを並べて確認することです。モデルの出身国をラベルとして評価するのではなく、変化が起きる条件を把握して管理できるかどうかが、B2B導入における判断材料になります。