
2026/10/27
企業AIの競争軸は「賢いエージェント」から「どこでも動かせる基盤」へ――Clouderaが描く可搬性戦略
AIの能力だけでは決められない導入先
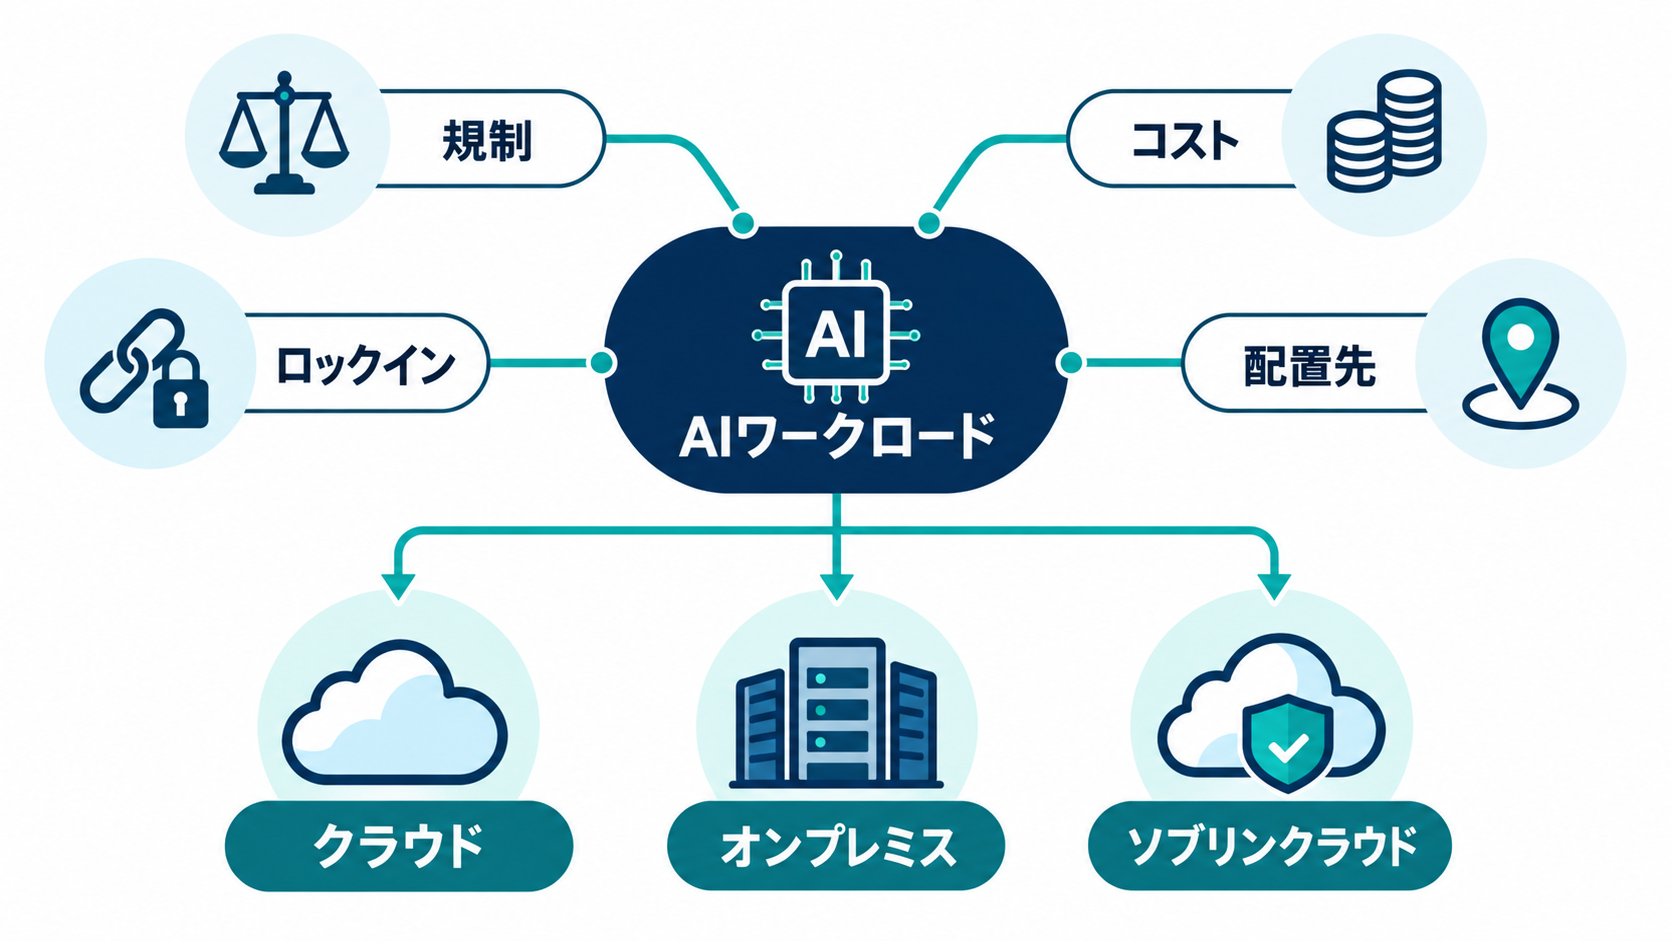
生成AIを業務に組み込む企業が最初に注目しがちなのは、モデルの精度やエージェントが実行できる作業です。しかし、本番運用の段階では「モデルとデータをどこで動かすか」が同じ重さを持ちます。クラウドだけで処理するのか、自社設備に置くのか、規制や案件に応じて移動できるようにするのかによって、コスト、管理方法、選択できるモデルが変わるためです。企業が配置場所を慎重に選ぶ背景には、規制への対応、トークン利用料の上昇、特定のクラウド事業者から離れにくくなるロックインへの懸念があります。機密データを外部環境へ送れない業務では、優れたモデルが利用できても採用できません。反対に、すべてを自社設備で処理すれば、計算資源の確保や保守の負担が増える可能性があります。どちらか一方に固定するのではなく、用途ごとに配置先を選び直せることが現実的な要求になります。
SiliconANGLE Mediaのエンタープライズ編集者であるPaul Gillin氏は、大企業が単一のクラウド事業者に依存したくないという方針を以前から持っており、その考え方はすでに企業ITの前提に組み込まれていると説明しています。AI自動化によって新しく生まれた要求というより、複数環境を使い分ける既存の方針が、モデル、データ、エージェントにも広がったと見るほうが適切です。今回の発信で中心にあるのは、エージェントの数ではなく、AIワークロードを企業の判断で配置し、必要に応じて移せるかという論点です。
Hadoop企業から「どこでも動くAI基盤」への転換
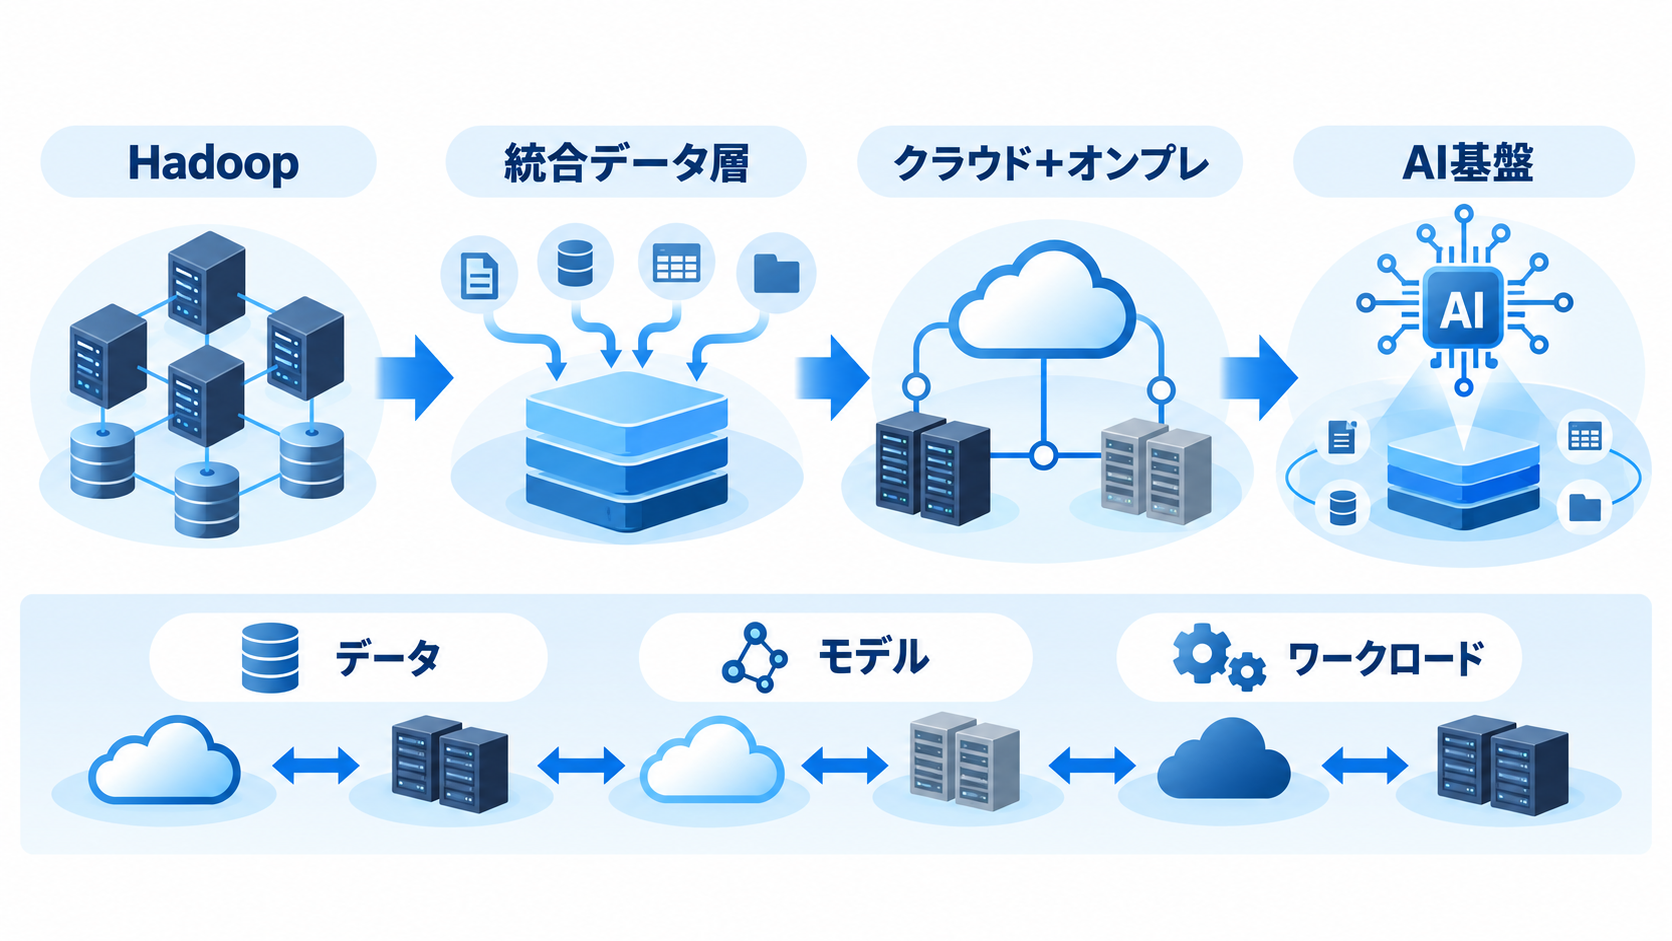
Clouderaは、大量データを複数のコンピューターに分散して保存・処理するHadoop市場から出発した企業です。Hadoopは、企業が自社管理のサーバー群で大規模データを扱う流れを支えた技術群として知られています。その後、Clouderaはクラウドとオンプレミス、つまり企業が自ら管理する設備をまたいでデータを扱う統合データ層へと事業領域を広げました。Gillin氏によると、同社は現在、自らをAIのための「エニウェアクラウド」と位置付けています。特徴として挙げられたのは、オンプレミス基盤やソブリンクラウドを支持し、企業が希望する場所でワークロードを実行できるようにする姿勢です。ソブリンクラウドとは、データの保存場所や運用主体などを一定の管轄・管理条件に合わせやすくしたクラウド環境を指します。単に複数のクラウドへ接続するだけでなく、自社設備を含む選択肢を残す点が、この戦略の要になります。
この方向性は、同社が歩んできたデータ基盤事業の延長として理解できます。AIが利用するデータとモデルだけを別々に動かせても、認証、処理基盤、監視、運用手順が特定環境に固定されていれば、実際の移行は容易ではありません。データ管理の仕組みとAIワークロードを一体で扱える基盤を目指すことで、Clouderaは従来のマルチプラットフォーム戦略をAIへ拡張しようとしています。競争上の主張は「どの環境でもまったく同じ条件になる」というものではなく、企業が配置先を選び、移行を検討できる余地を確保することにあります。
ソブリンAIを後押しする規制とオープンウェイトモデル
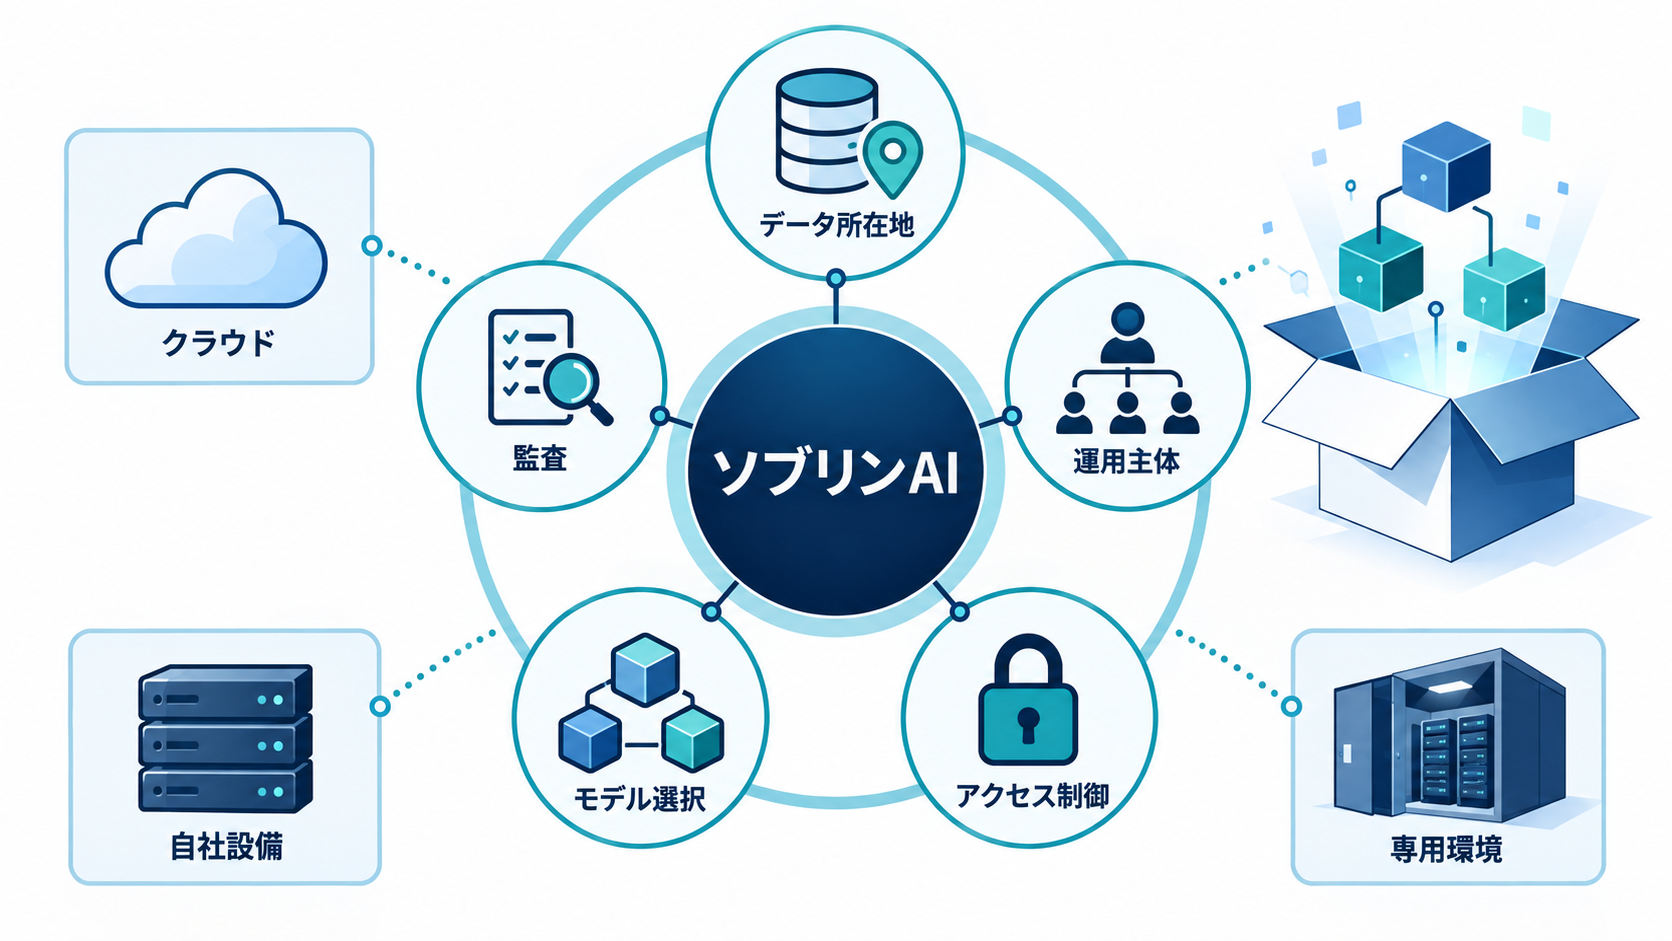
EVOLVE26の基調講演では、ソブリンAIとプライベートAIが繰り返し取り上げられました。ソブリンAIは、AIに使うデータや計算環境などを、国・地域・組織が求める管理条件の下に置く考え方です。プライベートAIは、企業がアクセス範囲や処理環境を限定し、機密性を保ちながら利用する形態を広く指します。両者は完全に同じ概念ではありませんが、外部サービスへ無条件に処理を委ねず、統制権を保持する点で重なります。Gillin氏は、調査では規制が企業内にAIをとどめたい主な理由として示されていると説明しています。その選択を支える手段の一つが、モデルの重みを入手して自社の環境などで動かせるオープンウェイトモデルです。同氏によれば、オープンウェイトモデルがトークン利用に占める比率は、2年前の約20%から現在は80%以上に増えています。ただし、紹介された範囲では、この数値の調査母集団や集計方法までは示されていません。市場全体の確定値として扱うのではなく、企業による選択肢が急速に広がっていることを示す指標として読む必要があります。
オープンウェイトであることは、配置の自由度を高めますが、統制上の課題を自動的に解消するわけではありません。利用条件はモデルごとに異なり、アクセス制御、更新、脆弱性への対応、入出力データの管理も利用企業側に残ります。クラウドAPIを使わないことだけを「主権の確保」と見なすのでは不十分でしょう。どのデータをどの環境で処理し、誰がモデルを変更でき、どの記録を保存するかまで設計して初めて、ソブリンAIやプライベートAIが実務上の意味を持ちます。
汎用アシスタントとは異なるデータ運用エージェント
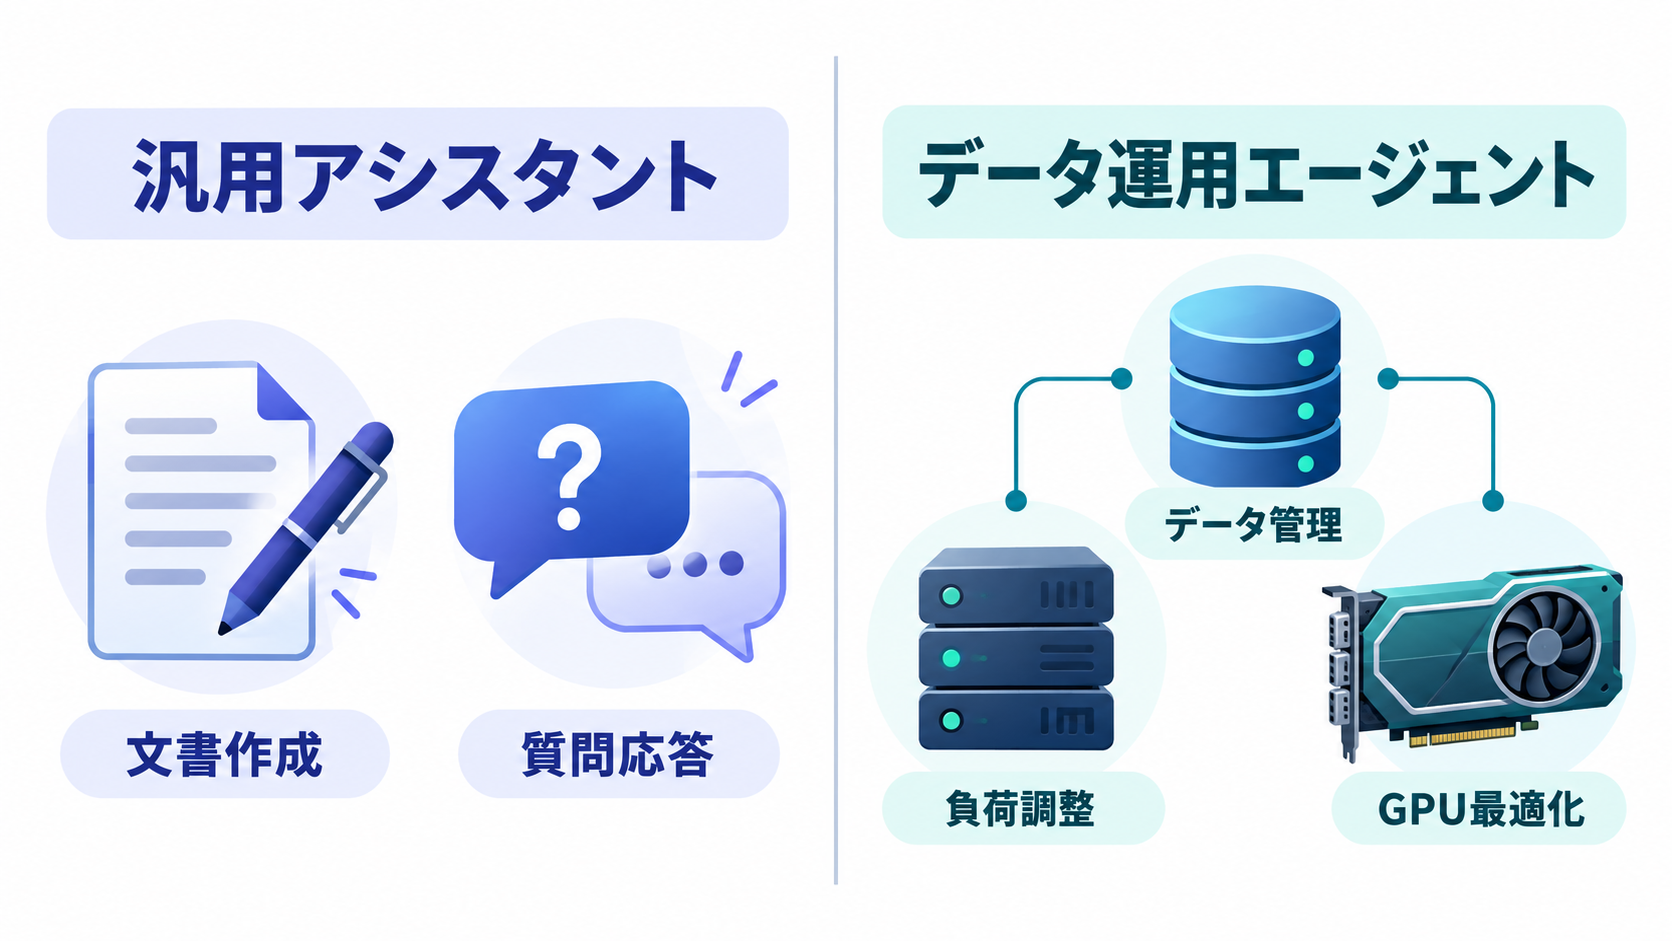
Clouderaは、同社のデータサービス全体にエージェント型のワークフローを追加しています。エージェント型AIとは、利用者からの質問に回答するだけでなく、目標や指示に基づいて複数の処理を選び、外部ツールやシステムを使いながら作業を進める仕組みです。もっとも、「エージェントを備えている」という説明だけでは、多くのAI製品との差を示しにくくなっています。Gillin氏は、一般用途のエージェントを主に消費者やオフィスワーカー向けのツールと捉える一方、Clouderaのエージェントはデータ管理に合わせて調整されていると説明しています。想定される役割として挙げられたのは、データやワークロードの管理、GPU容量の最適化です。これらは派手な対話機能ではありませんが、高額な学習コストを負担し、計算資源の利用効率に責任を持つCIOに直結する業務です。
企業向けエージェントを評価する際には、会話の自然さよりも、どの運用作業を任せられるかを見る必要があります。たとえば、GPUが不足している状況を検知することと、エージェントが自ら割り当てを変更することでは、権限とリスクが大きく異なります。提案だけを行うのか、承認後に実行するのか、限定された範囲で自動実行するのかを分けなければなりません。Clouderaが打ち出す用途特化型の方向性は、万能なデジタル従業員を目指すよりも、データ基盤の管理という境界の明確な領域で自動化を進める考え方です。ただし、その価値は自動化率だけでなく、運用担当者が介入できる設計と組み合わせて判断すべきでしょう。
CIOが確認すべき監査証跡と意思決定の説明性
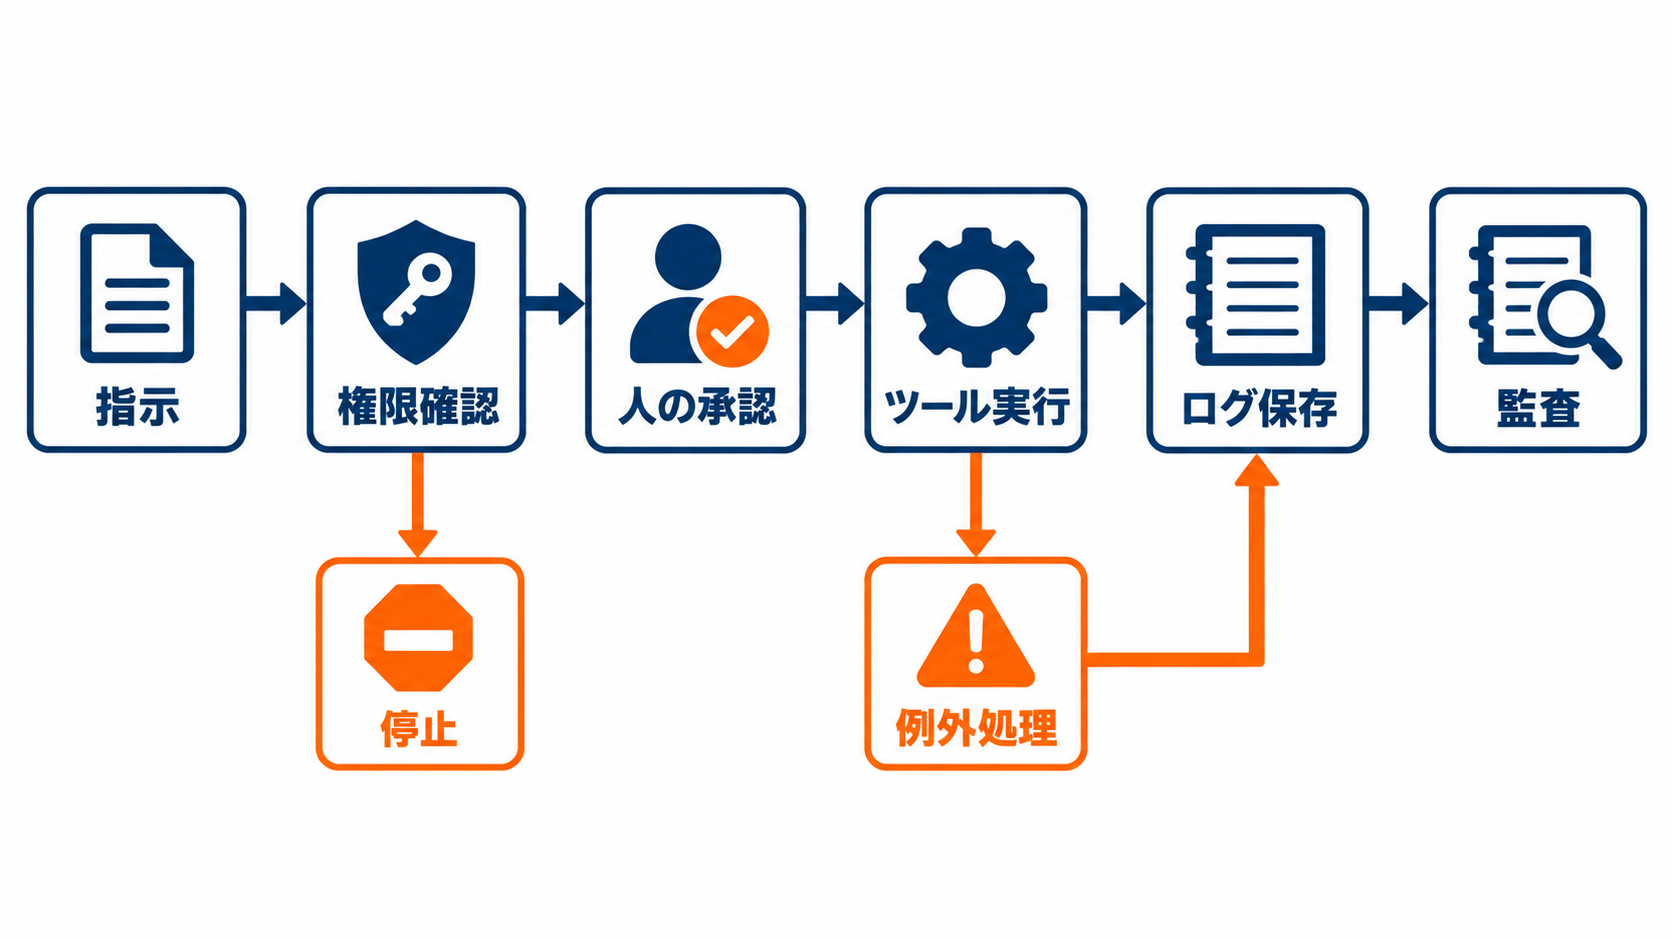
AIエージェントが業務システムに触れるほど、制御と監査の問題は避けられません。Gillin氏は、CIOがAI自動化を信頼する前に、エージェントがどのように制御され、どのような監査証跡を残し、規制当局に向けて判断を文書化できるのかを確認したいはずだと指摘しています。同氏がエージェントをめぐる状況を「西部開拓時代」と表現したのは、各社の実装や統制方法がまだ十分に定まっていないという認識を示すものです。監査証跡では、最終的な処理結果だけを保存しても判断を再現できない場合があります。実務では、誰が何を指示したのか、どのモデルと設定が使われたのか、エージェントがどのツールを呼び出したのか、どの時点で人が承認したのかを追跡できる形が望まれます。機密情報を含むログを無期限に残せば別のリスクが生まれるため、記録する項目、閲覧権限、保持期間も併せて決める必要があります。これは特定製品だけの問題ではなく、エージェントを企業システムへ接続する際の共通課題です。
説明性についても、モデル内部の全計算を説明することと、業務上の意思決定過程を説明することは分けて考えられます。後者では、利用した情報、適用したルール、実行した操作、例外処理を記録するだけでも、検証可能性を高められます。重要な変更には人の承認を必須とし、異常時には停止できる権限を用意する設計も欠かせません。製品比較では「エージェント機能あり」という欄だけを見るのではなく、権限の細分化、ログの取得範囲、承認フロー、再現性を具体的に確認する必要があります。
可搬性を製品メッセージではなく実装条件で測る方法
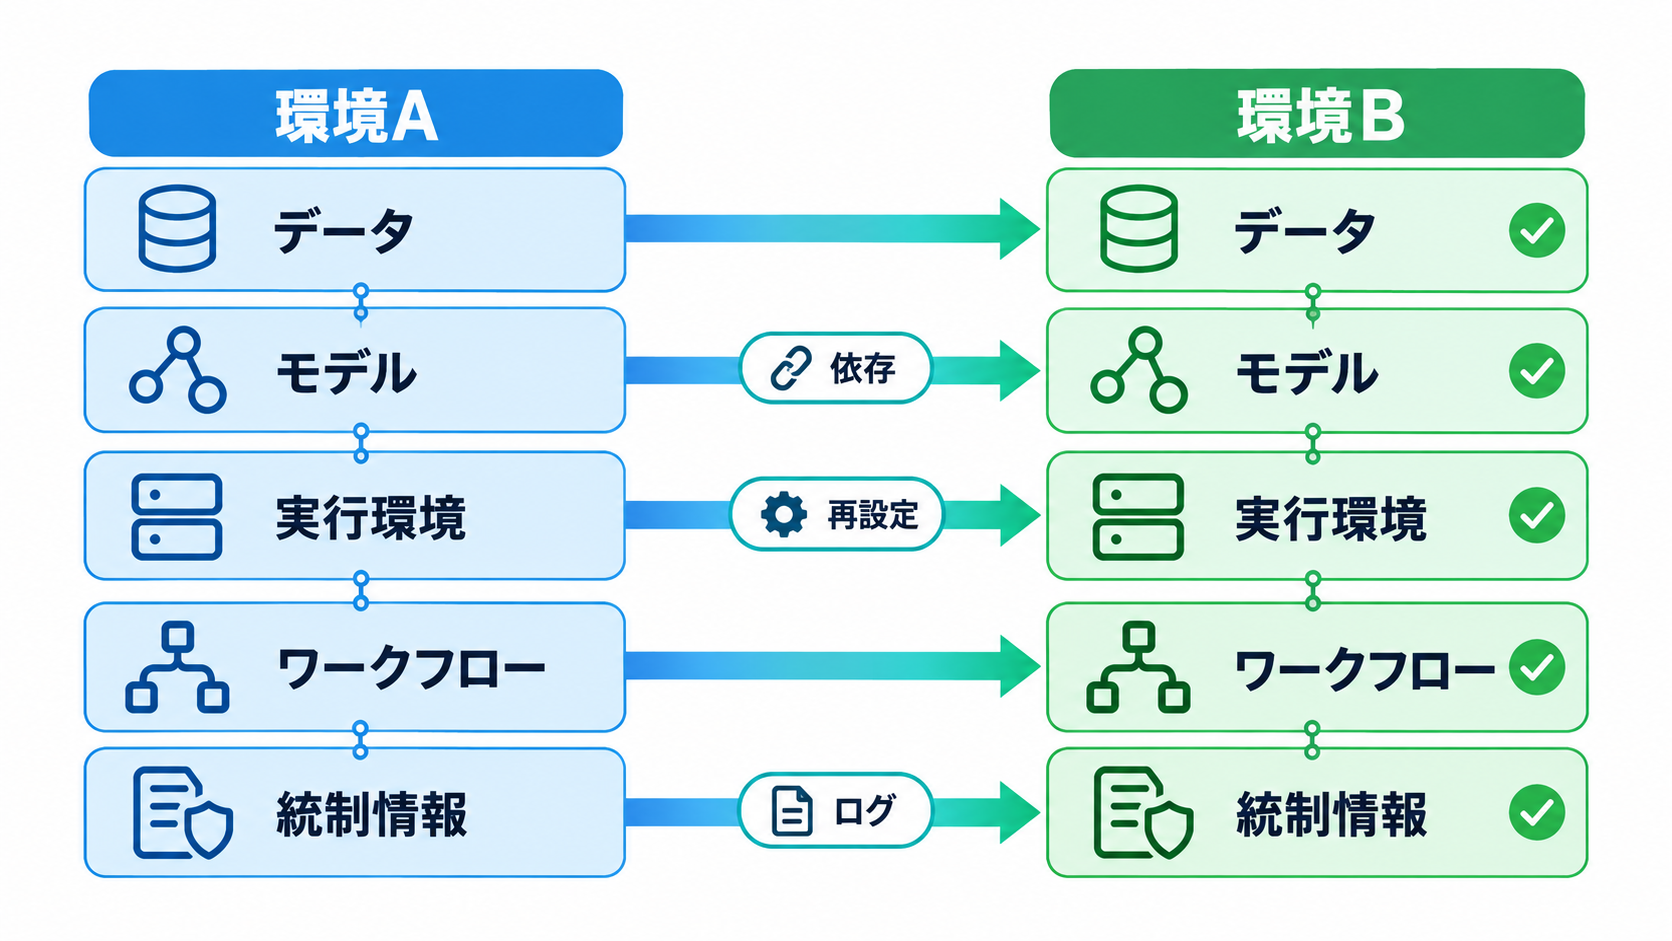
Clouderaの主張を評価するうえで注意したいのは、「複数環境に対応すること」と「容易に移動できること」が同じではない点です。二つのクラウドとオンプレミスに製品を導入できても、環境ごとに設定、データ形式、運用ツールが大きく異なれば、移行には相応の作業が必要になります。可搬性は対応先の数だけでなく、移動時に何を作り直す必要があるかによって測るべきです。確認対象は、データ、モデル、実行環境、エージェントのワークフロー、統制情報という複数の層に分けられます。データを標準的な形式で書き出せても、モデルの配備手順やアクセス権限を再現できなければ、移行後すぐには稼働できません。モデルを持ち出せても、特定クラウド専用の機能をエージェントが多用していれば、その処理を置き換える必要があります。監査ログやポリシーが移行対象から外れれば、技術的には動いても社内統制上は利用できない状態になりかねません。
導入候補を比較する企業は、小規模なワークロードを実際に別環境へ移す試験を行うと判断しやすくなります。移行に要した時間だけでなく、変更したコード、再設定した権限、失われたログ、性能や費用の差を記録します。障害時に元の環境へ戻せるかも確認対象です。すべての機能を完全に共通化する必要はありませんが、どの部分が移動でき、どこから先が特定基盤に依存するのかを契約前に把握しておくことが肝要です。可搬性を抽象的な安心材料ではなく、復旧、規制対応、価格交渉に使える具体的な能力として捉えると、投資判断の基準が明確になります。
日本企業が始める配置ルールと小規模な移行試験
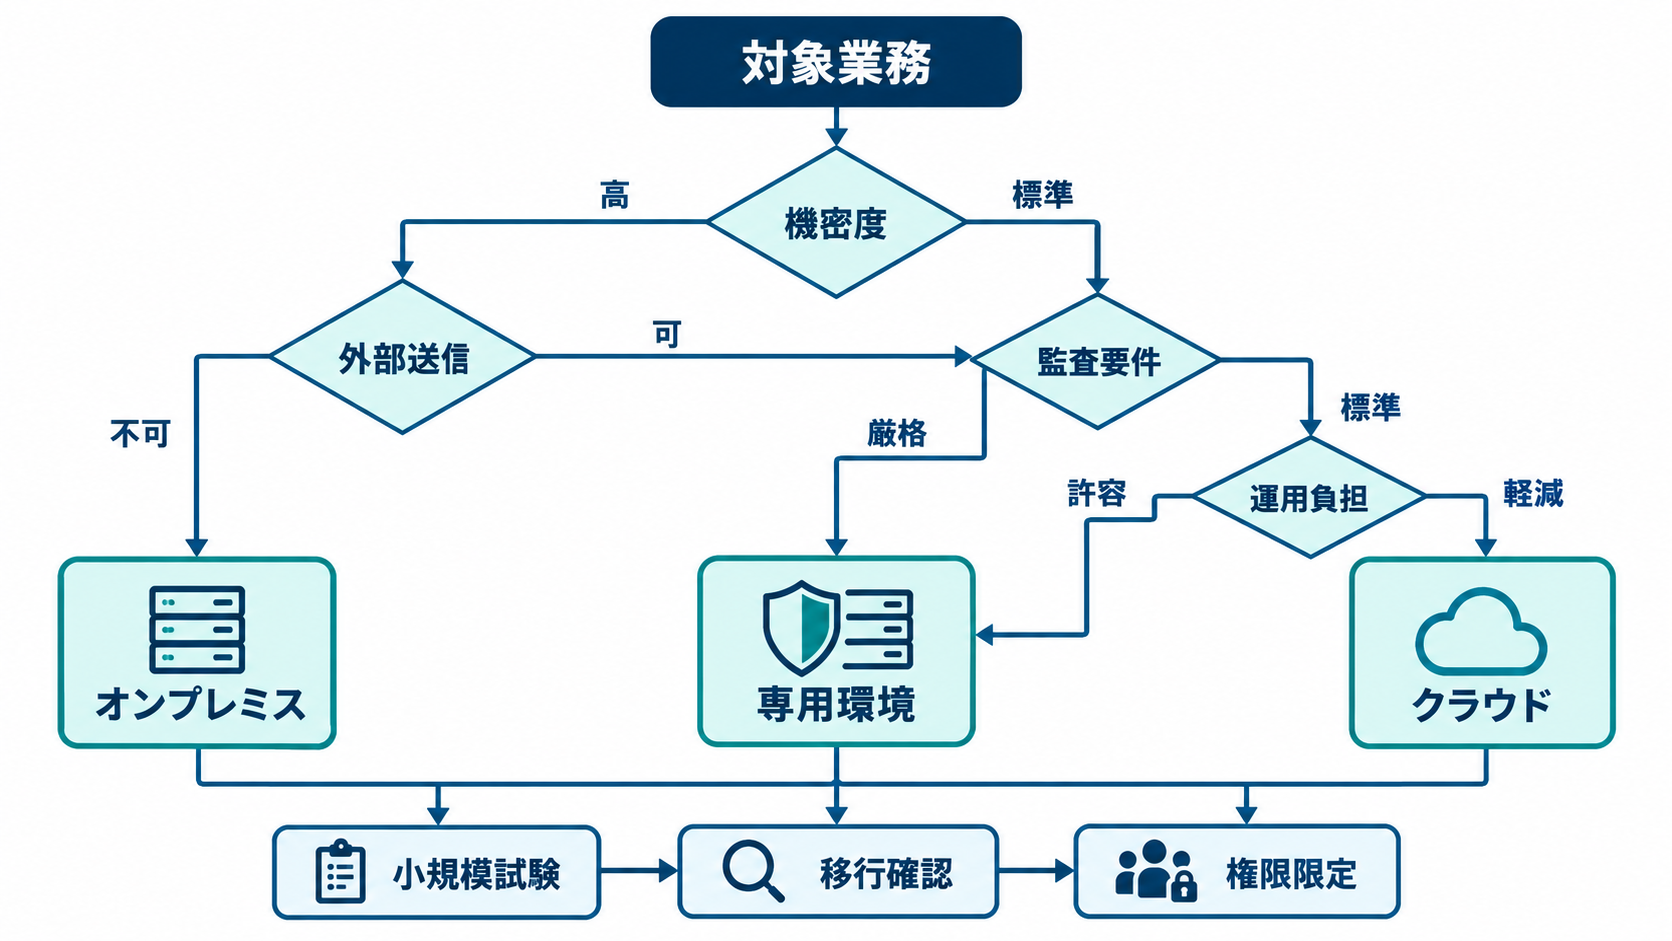
日本企業にとって、今回の論点は「クラウドかオンプレミスか」という二者択一ではありません。顧客情報を扱う処理、社内文書を検索する処理、公開情報から文章を作る処理では、必要な管理水準が異なります。全用途を同じ環境へ置くと、機密性の高い業務に合わせて全体が過剰に重くなるか、反対に重要なデータへの統制が不足するおそれがあります。業務とデータの性質に応じて、配置先を決めるルールを作ることが出発点になります。検討チームには、AI開発者だけでなく、データ基盤、セキュリティ、法務・コンプライアンス、業務部門、調達の担当者を含めるのが適切です。それぞれが求める条件を「クラウド禁止」のような一律の制約にせず、扱うデータ、許容できる外部送信、必要な記録、エージェントへ渡す権限として言語化します。そのうえで、クラウド、プライベート環境、オンプレミスを組み合わせ、案件ごとの選択肢を残します。オープンウェイトモデルを採用する場合も、モデルを自社環境で動かせるという理由だけで決めず、更新作業や監視を誰が担うかまで費用に含めるべきでしょう。
最初の実証では、機密性が管理可能で、処理結果を人が検証できる業務を一つ選びます。同じワークロードを二つの環境で動かし、品質、費用、移行作業、監査記録を比較すれば、ベンダーの説明を自社の条件で確かめられます。エージェントには閲覧や提案から始めさせ、承認なしにデータ削除や構成変更を行える権限は与えません。次の一歩は、導入製品を先に決めることではなく、自社の代表的なAI処理を一つ選び、「どこで動かす必要があるか」「移したときに何が失われるか」「誰が判断を追跡できるか」を表にすることです。その結果が、可搬性を本当に必要とする範囲と、許容できる基盤依存を見分ける材料になります。