
AI LAB
2026/10/22
欧州金融の生成AIが実運用へ――オープンウェイトモデルと自社データで築く「制御可能な知能」
欧州金融が選び始めた「自社で制御できるAI」
金融機関が生成AIを導入するとき、精度の高いモデルを選ぶだけでは済みません。顧客データをどこで処理するのか、規制対象の情報を誰が管理するのか、推論コストを予測できるか、既存の業務システムへどう組み込むかまで同時に問われます。NVIDIAがGTC Berlinで紹介した欧州企業の事例からは、こうした条件を満たすため、オープンウェイトモデルを自社または管理可能なインフラ上で運用する流れが見えてきます。オープンウェイトモデルとは、学習済みの重みが利用可能で、組織が自ら配備したり、用途に合わせて調整したりできるモデルを指します。ソースコードや学習データまで全面的に公開される「オープンソース」とは必ずしも同じではありません。それでも、外部サービスの仕様だけに依存せず、配置場所や処理方法を設計しやすい点は、データ管理に厳しい金融業界と相性があります。
今回の中心にあるのは、会話型AIを試験導入する段階から、取引処理、決済、不正検知、市場分析といった中核業務で使える知能基盤へ移行する動きです。モデル、GPU、データ処理ソフトウェアを一体として設計し、性能だけでなく統制可能性と費用も管理することが重視されています。欧州各社の取り組みは、生成AIを単体製品として購入するのではなく、自社データから再利用可能な知能を作る技術基盤として捉え直す動きと考えられます。
RevolutがPRAGMAで狙う全社共通の基盤モデル
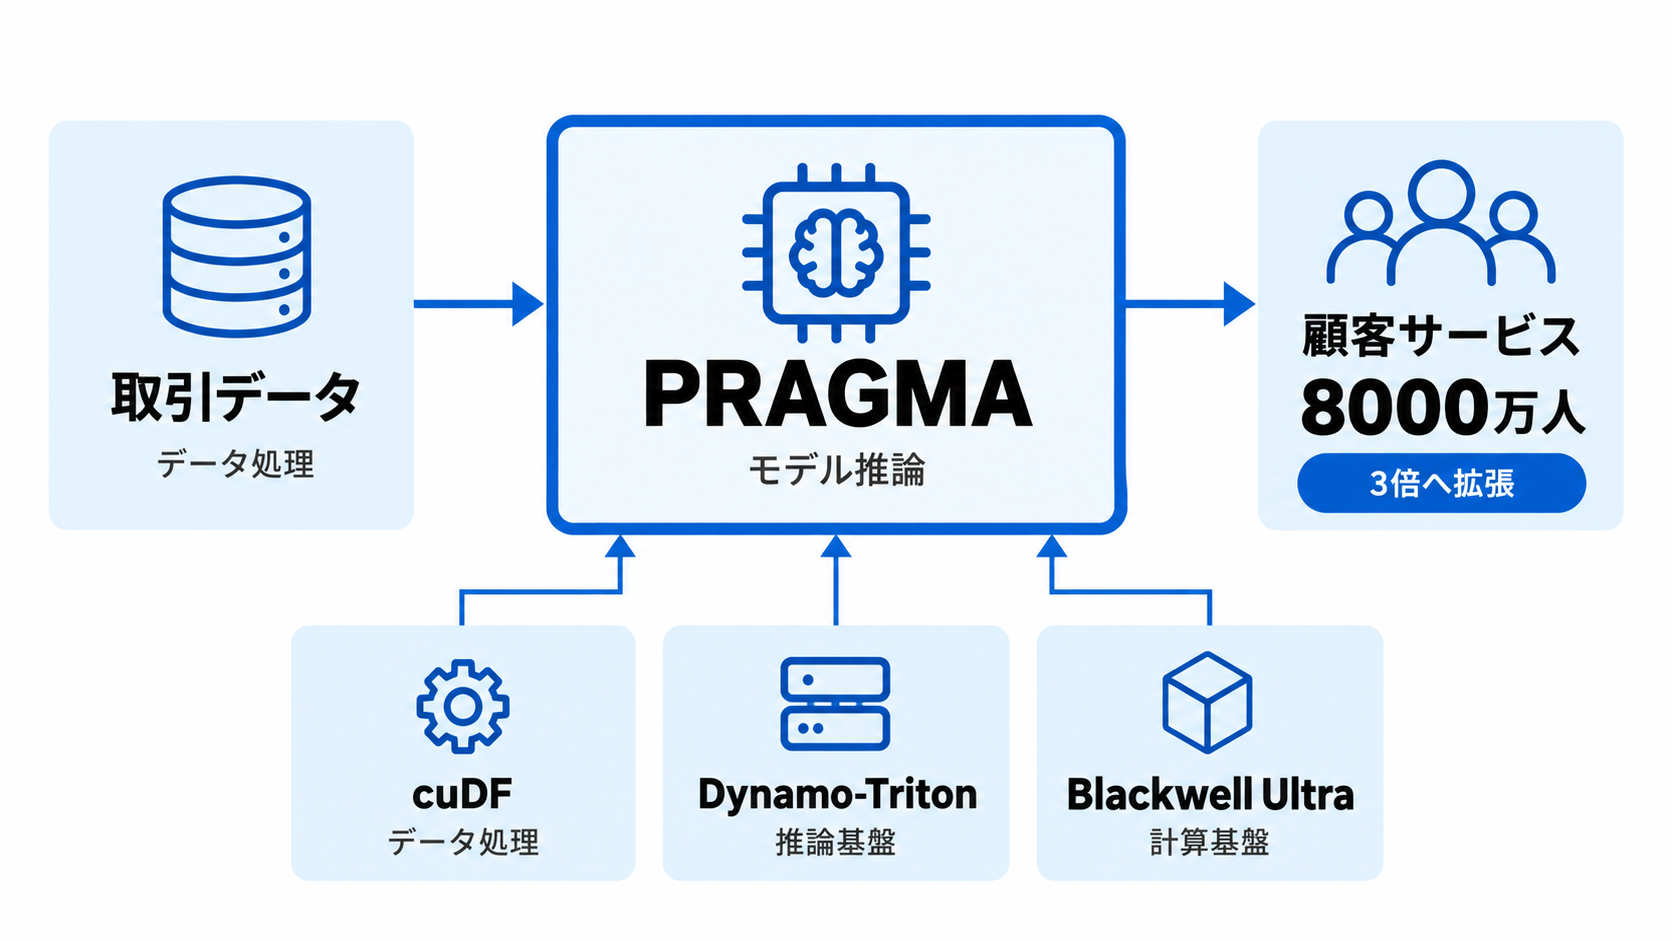
デジタル金融サービスを展開するRevolutは、技術スタックを単一の基盤モデル「PRAGMA」を中心に再構築しています。個別業務ごとに別々のモデルや処理系を増やすのではなく、複数領域で利用できる共通の知能層を設ける構想です。NVIDIAによると、PRAGMAは当初8000万人の顧客にサービスを提供し、さらに3倍の規模まで拡張できるよう設計されています。基盤を支えるのが、NVIDIA Blackwell Ultra GPUと、データ処理用のcuDF、推論運用に使われるDynamo-Tritonです。cuDFは表形式データの処理をGPUで高速化するためのツール群であり、Dynamo-Tritonは大規模なモデル推論を効率よく提供する役割を担います。銀行業務では、モデルが回答を生成する速度だけでなく、その前段で大量の取引データを読み込み、整形し、必要な情報を渡す処理もボトルネックになり得ます。そのため、モデルとデータパイプラインを切り離さずに設計している点が重要です。
RevolutのAI責任者であるPavel Nesterov氏は、同社が数十億件の取引を処理しており、基盤モデルがその規模と複数の業務領域に対応できるかが課題だったと説明しています。PRAGMAは、研究段階の成果と本番稼働する銀行システムとの隔たりを埋められることを示す取り組みと位置付けられています。企業側から見れば、モデルのベンチマークだけではなく、ピーク時の処理量、応答時間、障害時の切り分け、利用部門の増加に耐えられるかまで含めて評価する必要があるでしょう。
主権クラウドと自社データが形づくる金融AI
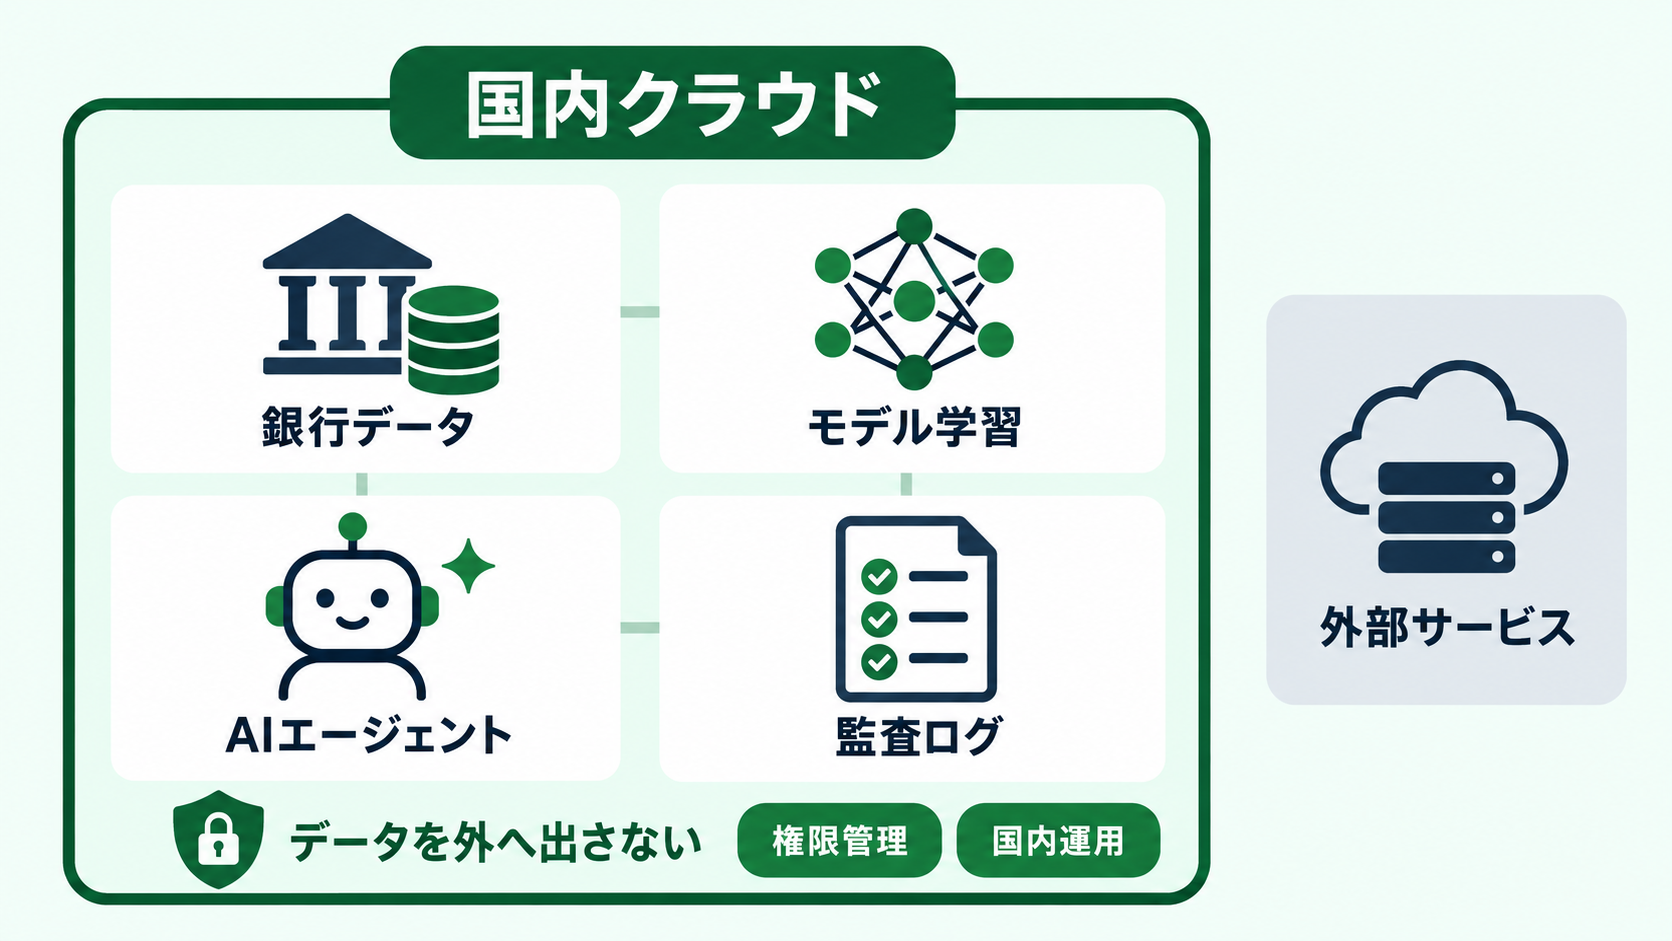
英国のデジタル銀行Starling Bankは、自行の取引データを使い、AI機能を支える知能層「Starling Intelligence」を開発しました。稼働基盤には、英国のクラウド事業者Civoが提供する国内クラウドを採用しています。NVIDIAは、英国の主権クラウド基盤上でエージェント型モデルを学習した初の銀行と説明しています。ここでいう主権クラウドは、データの保存場所や運用主体、適用される法制度などを管理しやすくするクラウドの考え方です。Lloyds Banking Groupも、数十億件の銀行取引を再利用可能な知能へ変換する取引基盤モデル「ATUM」を構築しました。NVIDIA RTX PRO 6000 Blackwell GPUで処理を高速化し、銀行内の幅広い用途で効率向上を目指しています。業務ごとに同じ取引履歴を別々に加工する構成ではなく、共通モデルを介して知見を再利用できれば、開発の重複を抑えられる可能性があります。ただし、利用目的ごとのアクセス制御や評価基準まで共通化できるとは限らず、技術基盤とガバナンスの両面が必要です。
金融ソフトウェア企業SBSは、生成モデルやエージェント型モデルを銀行の管理領域からデータを出さずに動かせる、銀行向けの主権知能プラットフォームを提供しています。エージェント型AIは、質問へ回答するだけでなく、複数の処理を選択し、外部ツールやデータを使って作業を進める仕組みです。便利になる半面、実行権限や記録、停止条件の設計が欠かせません。自社環境で動かす価値は、単なるデータ保管場所ではなく、AIが何を参照し、どこまで実行できるかを組織側が制御しやすい点にあります。
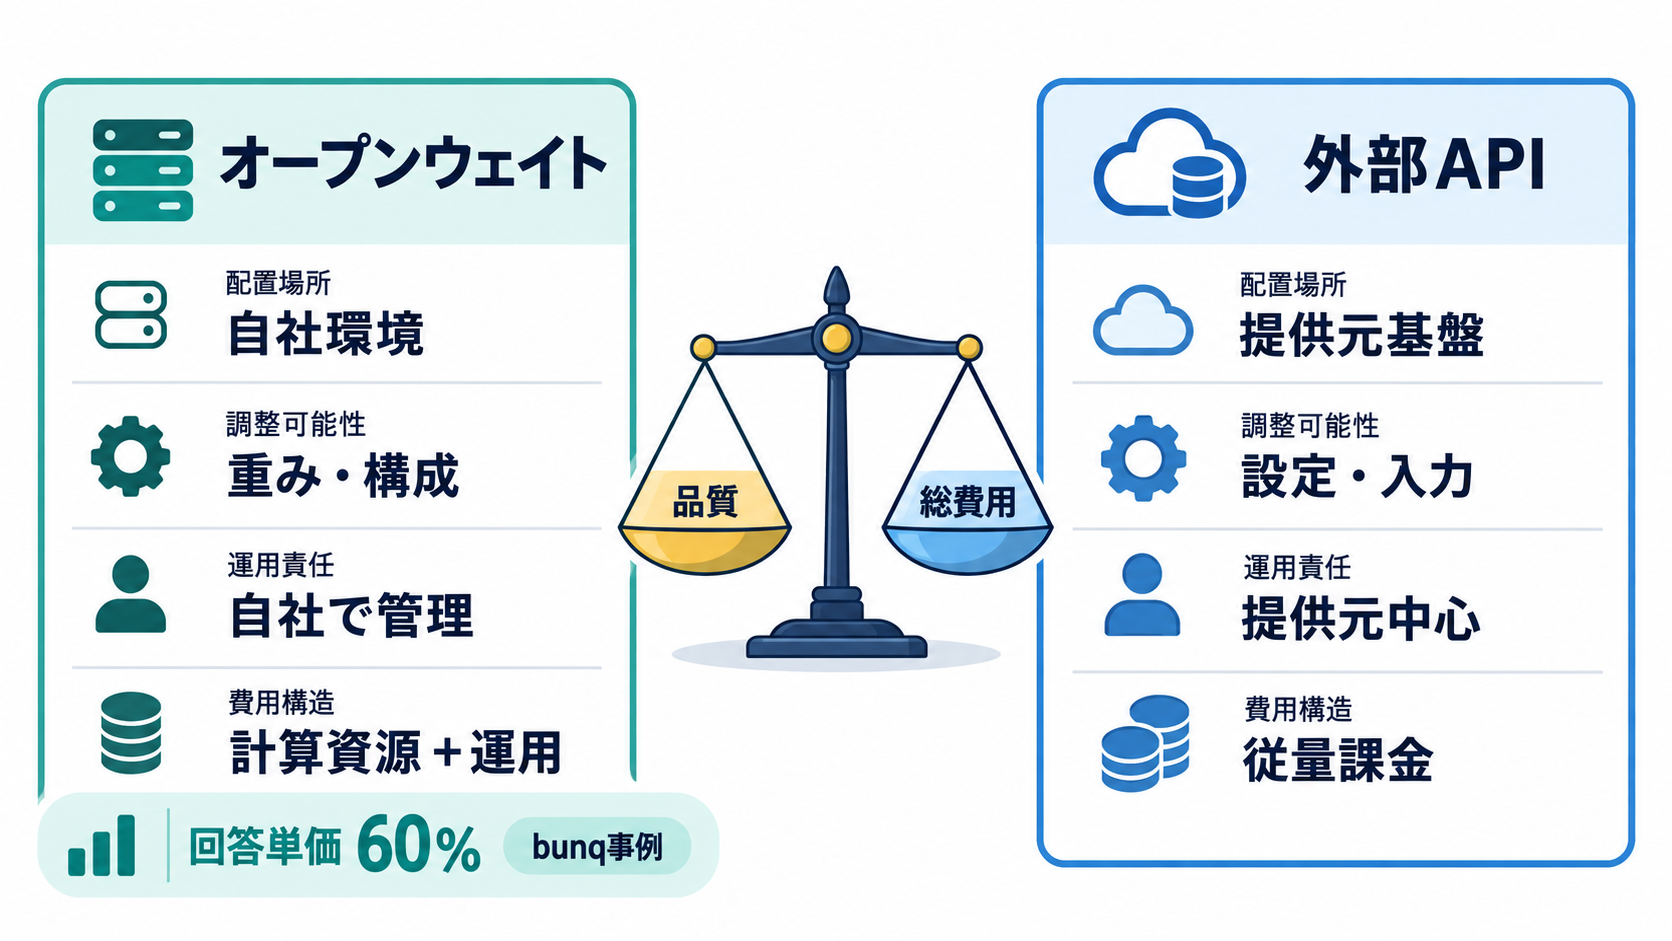
オープンウェイトモデルが変える費用と選択権
オープンウェイトモデルを採用する理由は、機密データの管理だけではありません。モデルの実行環境、推論の最適化方法、更新時期を組織側で選べるため、品質と費用のバランスを業務単位で調整できます。外部APIの従量課金だけに依存しない構成を選べることは、問い合わせ件数や取引量が大きい金融サービスにとって、予算の見通しを立てる材料になります。オランダ発のネオバンクbunqは、エージェント型アシスタント「Finn」をオープンウェイトモデル上で稼働させています。クラウド事業者Nebiusの環境とNVIDIAの高速化技術を組み合わせた結果、主要な非公開モデルに匹敵する品質を、回答1件当たり60%の費用で実現したとNVIDIAは説明しています。この数字が示しているのは、モデルの利用料だけではなく、配備方法や演算資源の使い方まで最適化する余地です。
ただし、60%という結果をすべての企業へそのまま当てはめることはできません。自社運用では、GPUの調達または利用料に加え、監視、セキュリティ、モデル更新、障害対応を担う人材も必要です。比較すべきなのはAPI単価とGPU価格だけではなく、一定の品質を満たす回答1件当たりの総費用でしょう。処理量が少ない業務では外部サービスが合理的な場合もあり、量が多く要件が安定した業務では専用環境が有利になる可能性があります。オープンウェイトの価値は常に安いことではなく、品質、配置、費用を自社の条件に沿って調整できる選択権にあります。
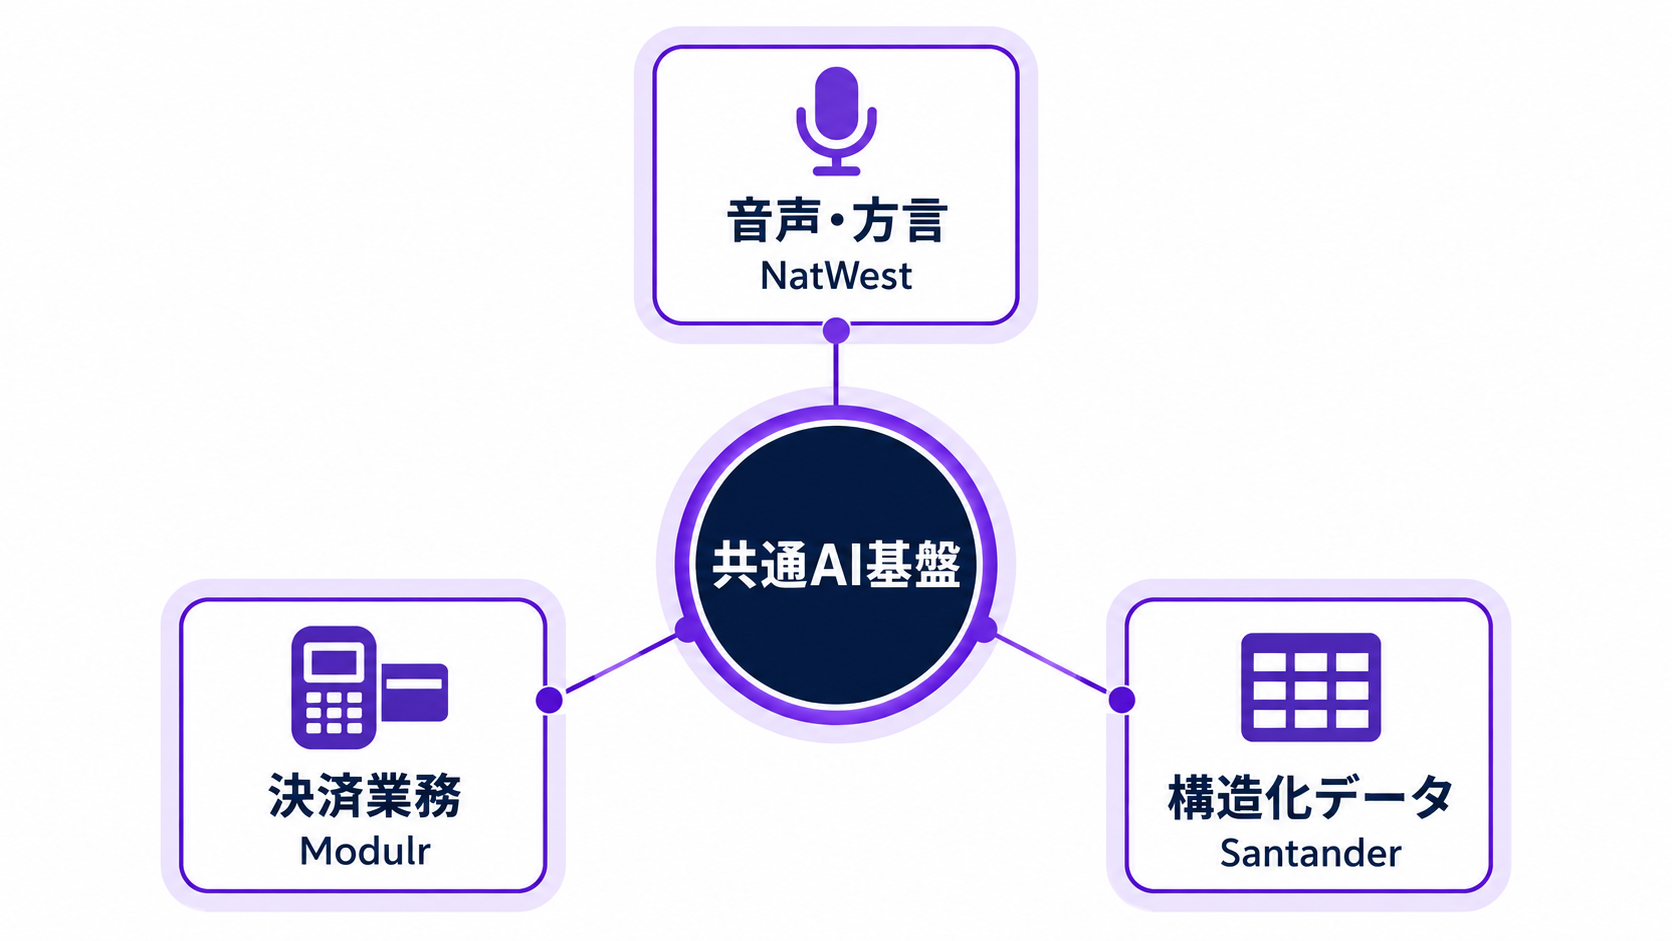
汎用モデルから金融業務別の専門モデルへ
金融サービスには、一般的な文章生成だけでは解きにくい課題があります。地域ごとの話し方を理解する音声認識、決済処理の異常を扱うモデル、表形式の取引データを解釈するモデルでは、必要なデータ構造も評価方法も異なります。欧州企業の動きからは、一つの巨大モデルですべてを処理するより、共通基盤の上に専門モデルを配置する方向性が読み取れます。英国のNatWestは、英国各地のアクセントや方言、金融用語を幅広く認識する技術を開発しています。利用しているのは、Nemotron 3.5 ASRを含むNVIDIAの音声モデルです。ASRは「Automatic Speech Recognition」の略で、音声をテキストへ変換する技術を指します。顧客対応で音声AIを使う場合、標準的な発音だけに精度を合わせると、特定地域の利用者や専門用語を含む会話で認識率が落ちかねません。現場の言語特性に合わせた評価が、サービス品質を左右します。
決済基盤を提供するModulrは、NVIDIA Nemotron-3-Ultra-550Bを基に、決済業務の異なる領域に向けた専門モデルを構築しています。Santanderは、構造化された金融データ向けのオープンウェイト基盤モデル群「NVIDIA Kumo」を早期に採用し、中核銀行業務向けの知能開発を進めています。表や時系列として保存された金融データは、自然言語の文書とは性質が違います。業務に適したモデルを選び、誤りの影響に合わせて評価指標を設けることが、汎用チャットAIをそのまま転用するより現実的な進め方になるでしょう。
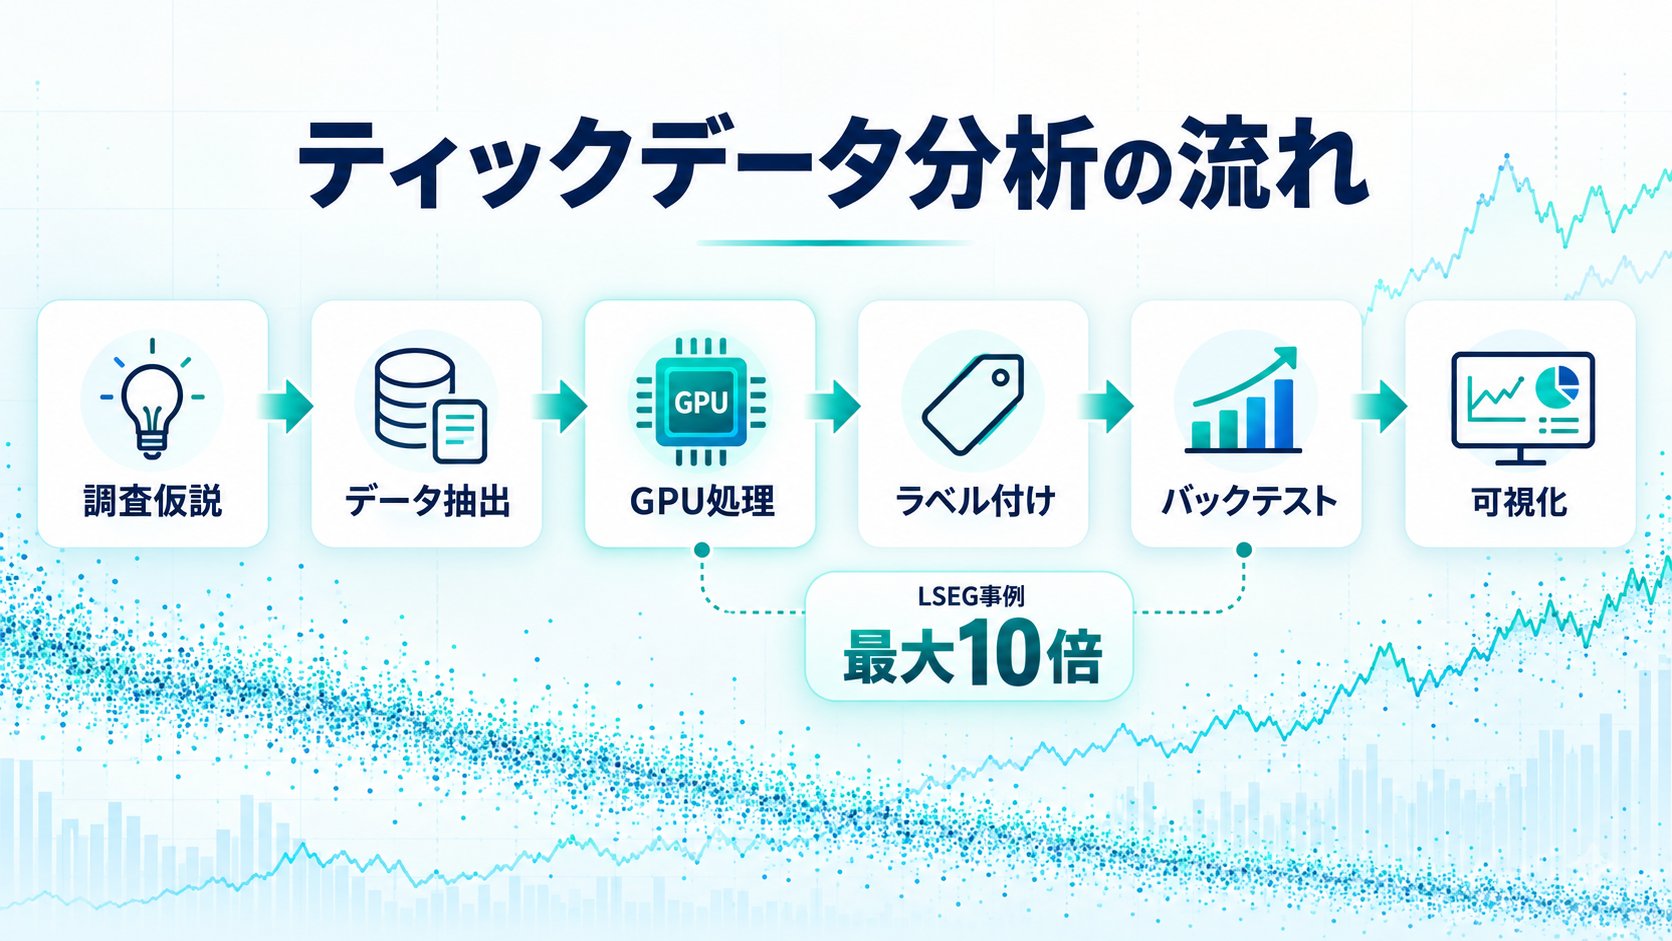
市場調査を高速化するGPUデータ処理
金融AIの性能を決めるのはモデルだけではありません。市場分析では、価格が変化するたびに記録されるティックデータなど、膨大な履歴を読み込み、条件に合うデータを抽出する作業に多くの時間がかかります。モデルへ入力する前の処理が遅ければ、高性能な生成AIを導入しても分析全体の待ち時間は短くなりません。金融市場データを提供するLSEGは、Polars GPUエンジンを使い、金融機関による大量の過去ティックデータ分析を最大10倍高速化する取り組みをNVIDIAと進めています。処理にはNVIDIA cuDFとRTX PRO 6000 Blackwell GPUが利用されます。Polarsは表形式データを扱う処理基盤であり、GPUによる並列処理と組み合わせることで、大規模な集計や変換の待ち時間を縮める構成です。分析担当者にとっては、同じ時間内に試せる仮説や条件の数を増やせる可能性があります。
金融情報分析を手がけるRavenPackは、自然言語で記述した調査仮説から、ラベル付け済みでバックテストに利用できるデータセットを返す生成パイプラインをBigdata.com上に構築しました。バックテストとは、投資や分析のルールを過去データへ適用し、どのような結果になったかを検証する手法です。このパイプラインは調整済みのNVIDIA Nemotronモデルで動作し、投資家は生成されたデータを市場動向の特定、分析、可視化に利用できます。ただし、データセットの生成が速くなっても、仮説の妥当性や将来の成果が保証されるわけではありません。データの出所、ラベルの定義、検証期間を人が確認する工程は残ります。
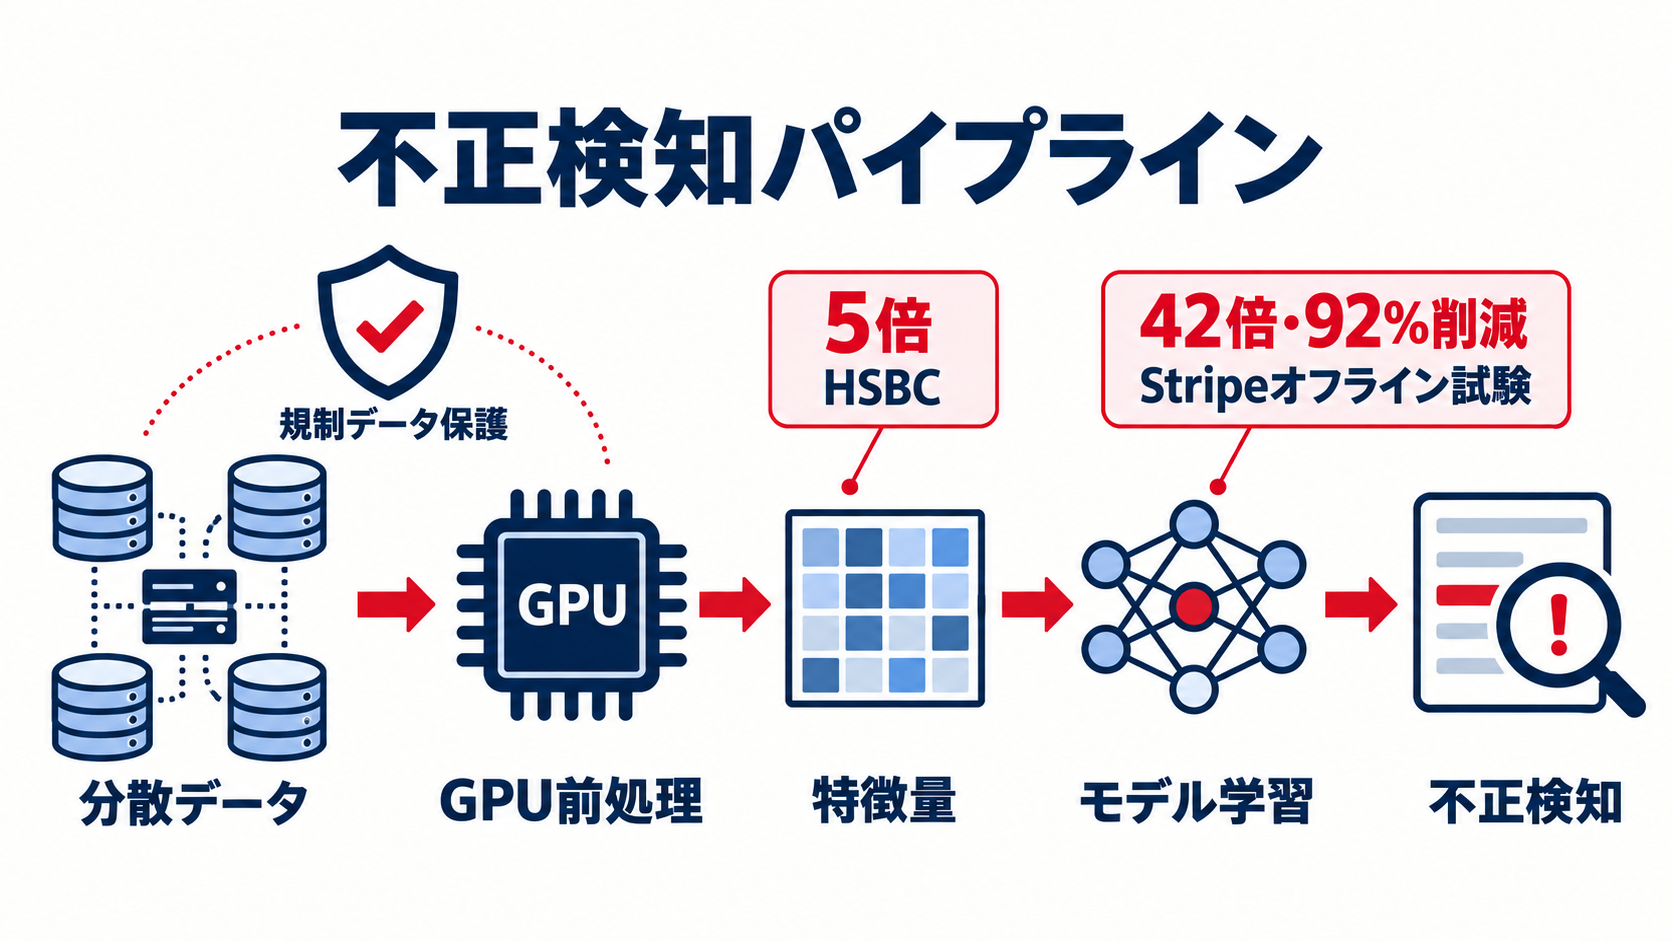
不正検知の成否を左右するデータパイプライン
不正検知では、モデルの推論時間だけを短くしても十分ではありません。複数のシステムに分散した取引情報を集め、形式をそろえ、特徴量へ変換し、判断に使える状態にするまでの時間が長ければ、対応は遅れます。金融データは規制の対象となり、容量も数テラバイト規模に達し得るため、処理速度と統制を両立させる設計が求められます。NVIDIAは、RTX PRO 6000 Blackwell Server Edition GPUとcuDFを利用することで、分断された大規模データソースの処理を高速化し、データ取得から判断までの時間を圧縮できるとしています。HSBCでは、Starburst EnterpriseのGPU Engineによってデータ処理を5倍高速化し、リスクや不正を抑えながら、顧客対応や必要時の意思決定を支える準リアルタイムの情報提供に活用しています。
決済サービス企業Stripeは、不正検知プラットフォーム「Stripe Radar」の機械学習パイプラインに、GPUで高速化したRay Dataを利用しています。オフライン試験では、データパイプラインが42倍高速になり、費用を92%削減したと報告されています。ここで注意したいのは、本番環境全体の成果ではなくオフライン試験の数値である点です。それでも、学習用データの準備が速くなれば、モデルの再学習や改善サイクルを短縮できる可能性があります。不正の手口が変化する環境では、モデル単体の精度だけでなく、新しいデータを継続的に取り込み、検証済みモデルを安全に更新できる仕組みが競争力を左右すると考えられます。
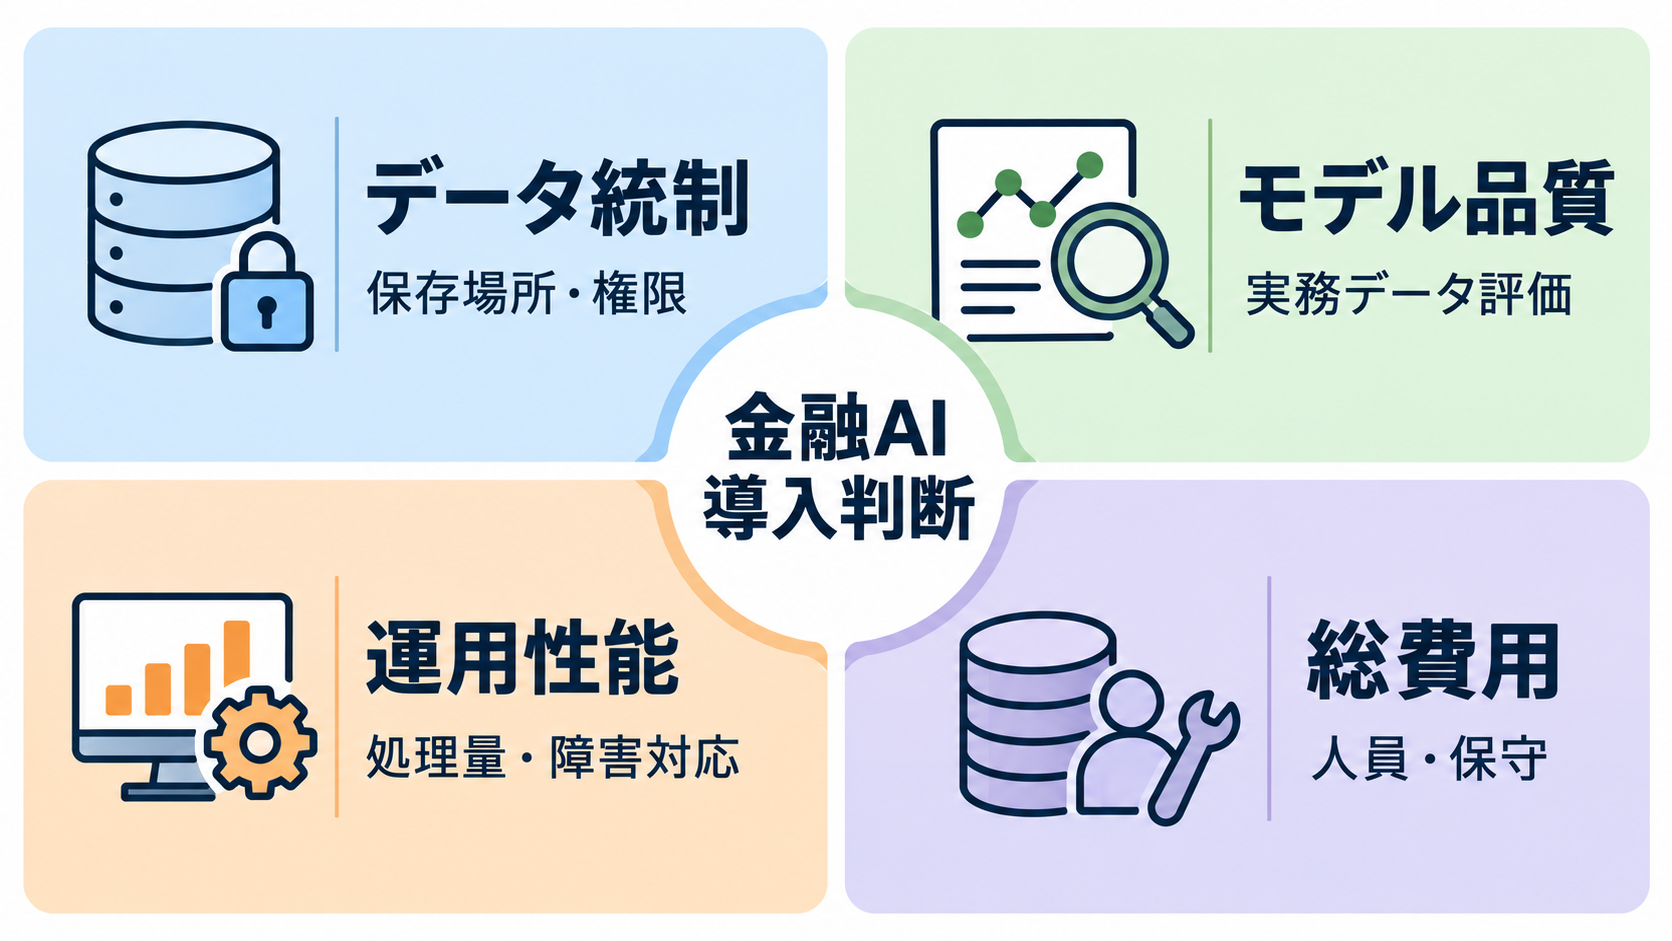
日本企業が導入判断で確認したい四つの設計軸
日本の金融機関や決済事業者が同様の仕組みを検討する場合、最初から全社共通の巨大基盤を目指す必要はありません。候補業務を一つ選び、データの機密性、処理量、求める応答時間、誤りが生じた場合の影響を整理することが出発点になります。顧客向け回答、社内調査、音声認識、不正検知では許容できるリスクが異なるため、同じモデル評価表をそのまま使うべきではないでしょう。確認軸は、データ統制、モデル品質、運用性能、総費用の四つに分けると整理しやすくなります。データ統制では保存場所、アクセス権、利用履歴、外部送信の範囲を確認します。モデル品質では正答率だけでなく、金融用語、社内データ、地域差を含む実務データで評価しなければなりません。運用性能では平均速度に加え、繁忙時の処理量、障害時の切り替え、更新手順も対象になります。総費用には計算資源だけでなく、監視やセキュリティを担う人員、評価作業、保守を含める必要があります。
オープンウェイトモデルと自社管理インフラの組み合わせは、これらの条件を調整する余地を広げますが、運用責任まで外部へ委ねられる仕組みではありません。試験導入では、閉鎖型サービスと自社配備型を同じ業務データ、同じ品質基準、同じ処理量で比較することが有効です。そのうえで、データ準備から回答または判断までの時間と費用を測れば、自社に合う構成を選びやすくなります。モデル名から検討を始めるのではなく、制御したいデータと改善したい業務指標を一つずつ定めることが、実運用へ進むための具体的な一歩です。