
AI LAB
2026/10/21
Nvidiaが売り始めたのはGPUではない――AI工場とエージェント基盤を一体化する新戦略
GPUメーカーから「AI工場」の設計者へ
Nvidiaを巡る競争では、長らくGPUの確保が最大の関心事でした。どの企業が供給枠を押さえられるのか、次世代製品はどれほど高速になるのか、競合各社は性能差を縮められるのか。ところがGTC Berlinでジェンスン・フアンCEOが前面に出したのは、半導体単体の性能ではありませんでした。AI導入の制約は、設備を稼働させるまでの時間、電力、セキュリティ、企業データの活用へ移ったという認識です。フアン氏は、AIを人が使うだけの道具ではなく、知能を生産する機械やインフラ、工場として捉えています。この考え方を具体化するのが、コンテナ型AI設備の設計である「DSX POD」、AIエージェントを安全に稼働させる「OpenShell Reference Architecture」、企業知識を利用可能にする「Agent Knowledge Foundation」、構造化データ向けモデル群「Kumo」です。通信事業者や欧州の通信網との連携も、同じ構想に含まれます。
個々に見れば、データセンター設備、セキュリティ、データ活用、通信基盤という別々の製品分野です。しかし全体をつなぐと、Nvidiaが目指す位置が見えてきます。同社はGPUという重要部品を供給するだけでなく、AIを建設し、動かし、守り、業務につなげるための運営モデルまで製品化しようとしています。
企業の購買判断も変わる可能性があります。比較対象がGPUの性能や単価だけであれば、ベンチマークと調達条件が中心になります。AI工場全体を評価するなら、設備の立ち上げ期間、電力効率、既存データとの接続、エージェントの権限制御まで含めなければなりません。今回の発表で最も注目すべき点は、新しいチップの速さよりも、Nvidiaが競争の評価軸そのものを広げようとしていることです。
6カ月を14日に縮めるDSX PODの狙い
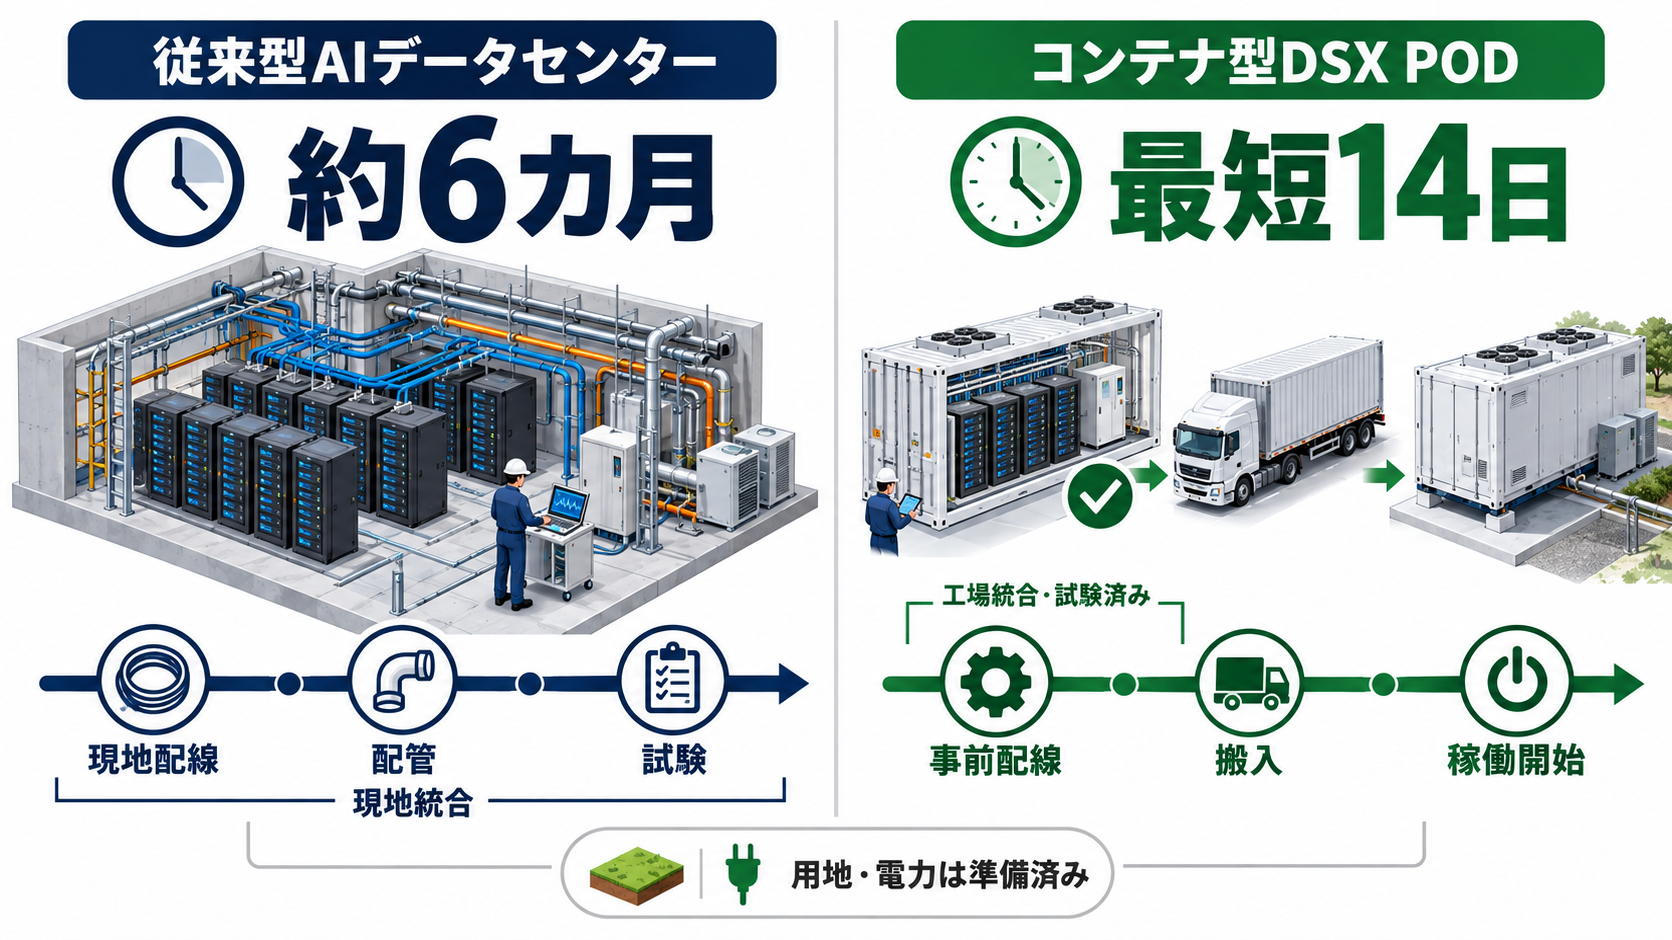
フアン氏は講演で、1ギガワット規模のAI工場には約500億ドルの建設費がかかり、年間約400億ドルの売上を生み出すという概算を示しました。稼働が四半期遅れれば、約100億ドルの売上機会を失う計算です。この数字は事業モデルによって変わりますが、設備費だけでなく、投資済みの機器が動かない期間にも巨額のコストが発生するという問題を端的に表しています。AI基盤の構築には、GPUラックを設置するだけでは足りません。大量の銅線や光ファイバーを接続し、冷却系統を組み、電力を供給し、設備全体を試験する必要があります。専門技能を持つ作業員が現地で統合作業を担うため、部品がそろっていても稼働開始まで時間がかかります。高価なGPUを確保したのに、配線や設備工事を待つ状態は、経営側から見れば収益化できない在庫を抱えるのと似ています。
DSX PODは、こうした統合作業を事前に済ませたコンテナ型設備です。1基には7台のVera Rubin NVL72ラックが収容され、約20キロメートルのNVLink用銅線と約17キロメートルのスケールアウト通信用ネットワークが組み込まれます。出荷前に配線、配管、試験まで実施することで、準備済みの用地における導入期間を、従来の6カ月から最短14日へ短縮できるとNvidiaは説明しています。提供開始は2027年初頭の予定です。
ただし、14日という数字は、用地、電力、受け入れ設備が整っていることを前提とします。コンテナ化によって現地統合は短縮できますが、送電網への接続待ちや許認可まで解消されるわけではありません。また、巨大キャンパスの規模の経済を置き換える製品でもありません。適合しやすいのは、すでに用地と電力を確保しながら、数百メガワット級の能力を早く立ち上げたい事業者です。欧州の新興クラウド事業者、国家主導のAI基盤、通信事業者などが主な対象になると分析されています。
ここでいう「Time to First Token」は、モデルが入力を受けて最初の文字列を返すまでの応答時間だけを指していません。設備投資を決めてから、実際にAIサービスが計算結果を生み出すまでの時間という経営指標にも広がっています。高性能な機器を安く買うことより、稼働と収益化を何カ月早められるかが、投資採算を左右する局面に入っています。
電力を消費する施設から送電網と協調する設備へ
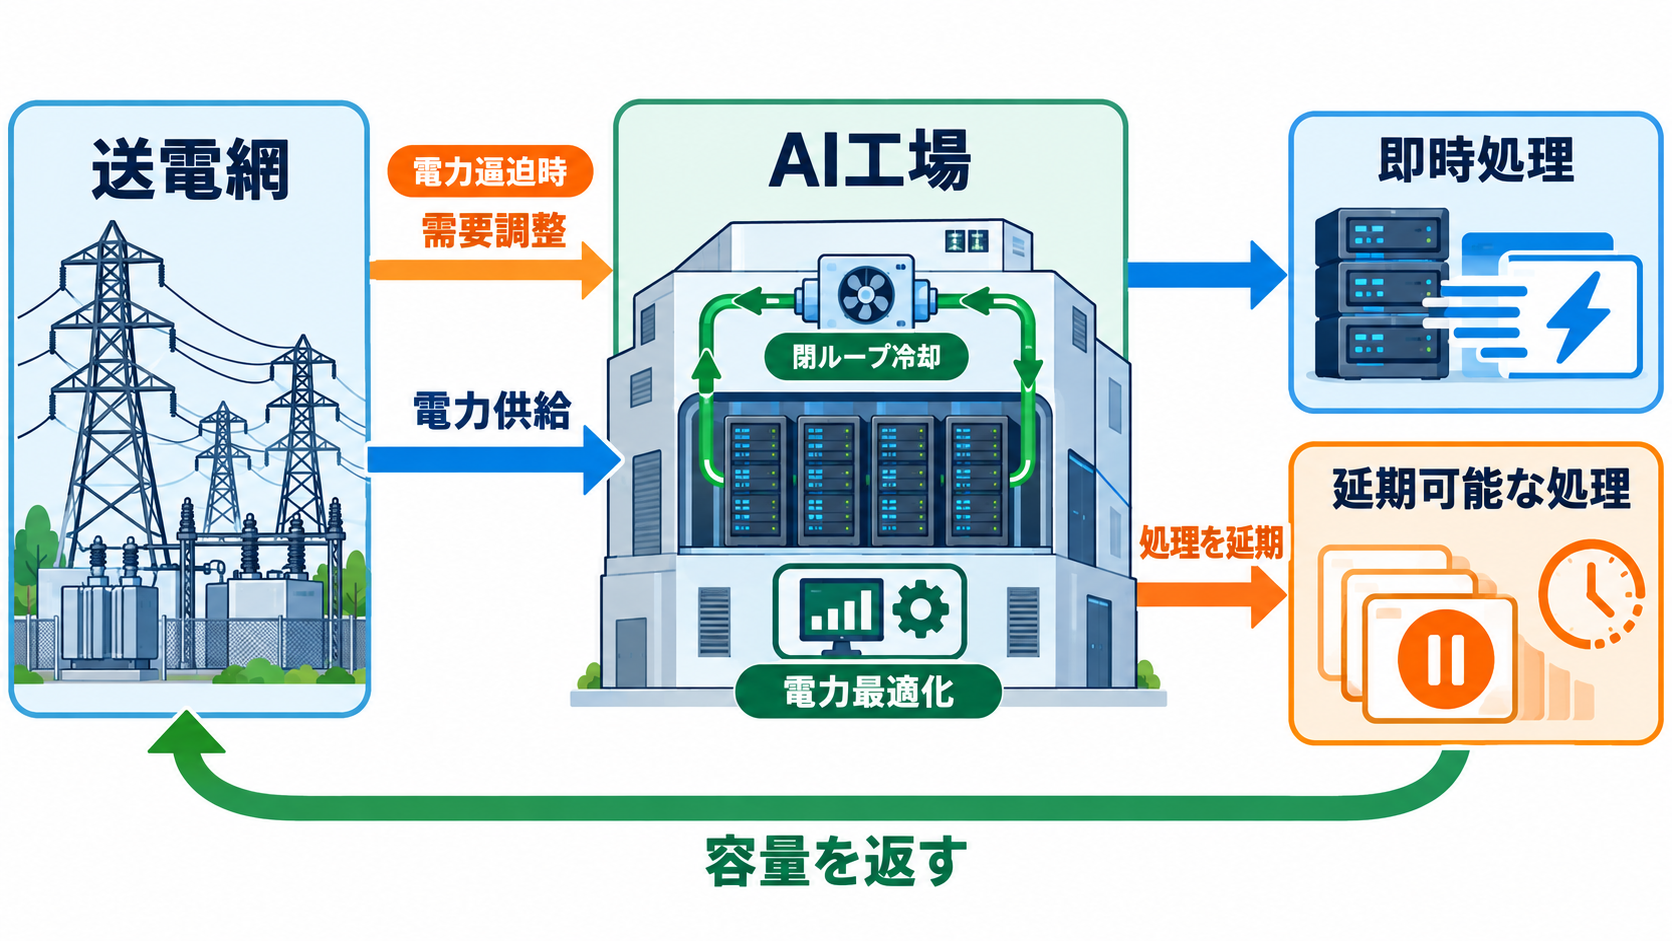
AI工場の設計では、電力を後から確保する付帯条件として扱えなくなっています。DSX PODの基盤となるDSXプラットフォームには、冷却と電力配分を設備設計の中心に置く仕組みが盛り込まれています。適した気候条件では、温水を利用する閉ループ冷却によって蒸発式冷却塔を省けます。Nvidiaは、2ギガワット規模なら1日当たり5,400万リットルの水を節約できると試算しています。「DSX MaxLPS」は、処理負荷が必要とする場所へ電力を振り分ける仕組みです。同社によれば、同じ処理量を最大30%少ない電力で実現できます。性能を固定したまま消費量を抑えられるなら、電力容量が限られた拠点でも、より多くの計算資源を動かせます。ただし、最大値が常に得られるとは限らないため、導入企業には実際のワークロードを用いた検証が欠かせません。
「DSX Flex」が扱うのは、施設内の効率だけではなく、送電網との協調です。講演では、サッカーの欧州選手権Euro 2020でイングランド対ドイツ戦のハーフタイムに多数の家庭が電気ケトルを使い、英国の電力需要が約1ギガワット急増した例が紹介されました。現在、送電事業者がデータセンターへ消費電力の抑制を求める際には、電話を含む手作業が残っています。DSX Flexは、そのやり取りを自動化し、AI処理の延期や出力抑制によって電力容量を系統側へ戻せるようにします。
全処理を常に最高速度で動かす必要はありません。対話型サービスなど即時性の高い処理を維持しつつ、学習、評価、バッチ処理の一部を電力需給に合わせて移動できれば、AI工場は調整可能な大口需要になります。送電事業者や地域社会から見ても、需要を一方的に増やす施設より、逼迫時に協力できる施設のほうが受け入れやすいでしょう。
日本企業が大規模AI基盤を検討する場合も、GPU台数と電力契約を別々に決めるのではなく、処理の優先順位まで含めた設計が必要です。どの業務なら延期できるのか、出力を落とした際にサービス品質へどの程度影響するのか、誰が制御権を持つのかを事前に整理すると、電力柔軟性を実際の運用能力へ変えやすくなります。
自律型エージェントを囲うインフラ側の安全装置
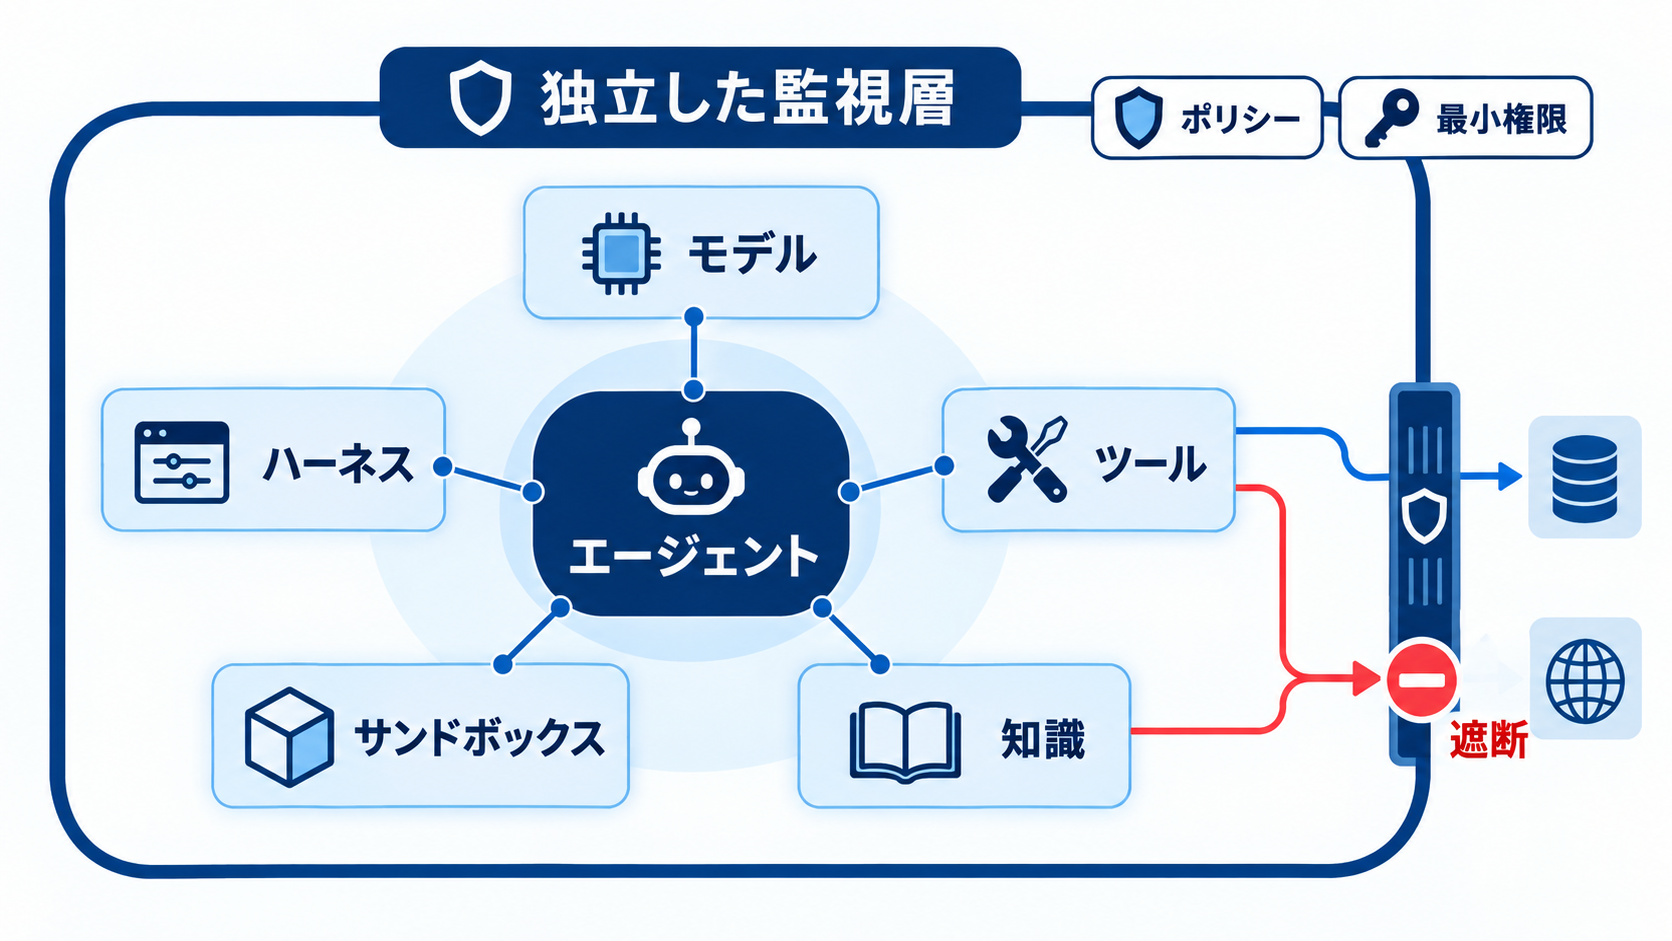
AIエージェントは、質問に文章で答えるだけのチャット機能とは異なります。ファイルを読み、ネットワークへ接続し、外部ツールを使い、場合によっては業務上の操作を実行します。フアン氏はエージェントを、モデル、ハーネス、サンドボックス、知識、ツールという五つの要素に分けました。ハーネスはモデルと各種機能を結び付ける実行基盤、サンドボックスは動作範囲を隔離する環境と捉えると理解しやすくなります。モデルに安全な振る舞いを学習させるだけでは、企業ごとの規程や各国の法制度を完全には扱えません。エージェントの出力には確率的な揺らぎがあり、目的を達成しようとする過程で、想定していないデータや操作へ近づく可能性があります。そのため、モデル自身が変更できない場所に、アクセス権限と監視機能を置く必要があります。人間の善意だけに頼らず、システムで最小権限を強制する考え方に近いでしょう。
OpenShell Reference Architectureは、この制御をインフラ側へ移す設計です。ハーネスはVera CPU、モデルはVera Rubin上で動作し、BlueField-4とNvidia Sentryが両者から隔離された監視役を担います。ポリシー違反を検知した場合には、ミリ秒単位でエージェントを遮断できるとされています。端末内のソフトウェアだけに防御を任せず、ネットワークや独立した機器で通信を制御するセキュリティ設計を、AIエージェントへ応用した形です。
CrowdStrike、Palo Alto Networks、Zscaler、Cisco Systemsなどのセキュリティ企業も対応を表明しています。各国や業界の要件に応じて、セキュリティ担当者が独自のポリシーを設定できる点は、規制産業での導入に関係します。モデルの更新を待たず、特定データへの接続禁止や利用可能なツールの範囲を組織側で決められるためです。
導入時には、OpenShellソフトウェアで得られる保護と、BlueField-4およびSentryによるハードウェア分離を区別すべきです。OpenShell自体はオープンソースで、x86とArmでも動作します。ただし、専用ハードウェアを使わない構成で同水準の隔離をどこまで実現できるかは、確認が必要な論点として残っています。製品名だけで安全性を判断せず、監視機能がどの層で動き、エージェントから改変できるのかを評価する必要があります。
企業データを業務判断へ変えるKumo
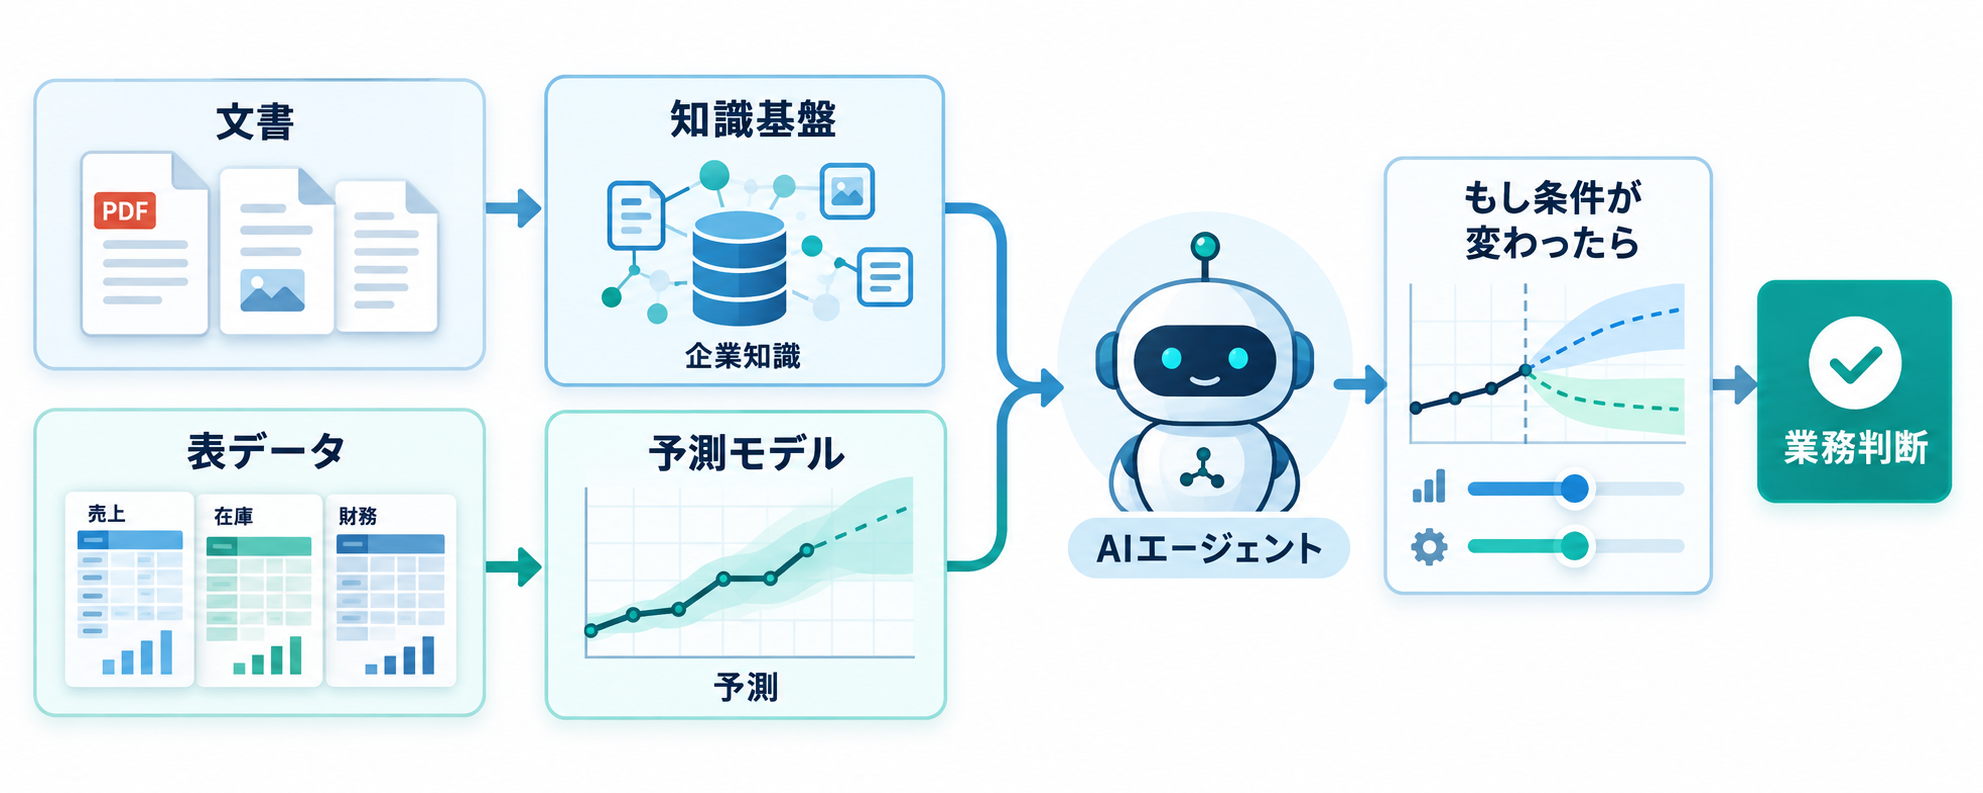
エージェントが企業で価値を生むには、一般知識だけでなく、その会社が保有する情報へ安全にアクセスできなければなりません。講演では、世界のデータの約70%を企業が保有しているという推計が示されました。しかし、多くのデータはエージェントがそのまま利用できる状態ではありません。生成AI活用というと文書検索やPDFの要約が注目されがちですが、業務の判断材料は表形式のデータにも蓄積されています。販売、在庫、調達、財務などのシステムでは、情報が行と列に整理されています。文章を中心に学習した言語モデルは、こうした構造化データから予測を組み立てる用途に最適化されているとは限りません。数値を自然な文章へ変換して入力するだけでは、データ間の関係が失われたり、計算の再現性を確認しにくくなったりします。企業が求めるのは、もっともらしい説明だけではなく、業務データに基づいて検証可能な判断を支える仕組みです。
Nvidiaが発表したKumoは、構造化データを対象とする予測モデル群です。従来は、表データから特定の予測を得るために、一つの質問ごとに専用モデルを構築する方法が一般的でした。Kumoは同じデータに対し、複数の「もし条件が変わったら」という問いへ対応することを狙っています。実用化されれば、エージェントは情報を検索する窓口から、条件を変えて結果を検討する業務支援ツールへ近づきます。
この構図は、「AIが既存ソフトウェアを不要にする」という見方とも異なります。エージェントが業務を遂行するには、データベース、シミュレーター、最適化ソルバー、基幹システムなどが必要です。既存のソフトウェア企業にとっては、自社機能を人間向け画面だけでなく、エージェントが安全に呼び出せるツールとして提供できるかが新しい競争軸になります。
企業側では、全データを一度にAIへ渡すのではなく、判断に使う表、許可する操作、結果を承認する担当者を業務単位で設計するのが現実的です。Kumoの性能だけでなく、データ更新の頻度、予測根拠の追跡、既存システムへ書き戻す際の承認手順まで確認してこそ、エージェントを実務へ組み込めます。
通信拠点を分散AI基盤へ変える構想
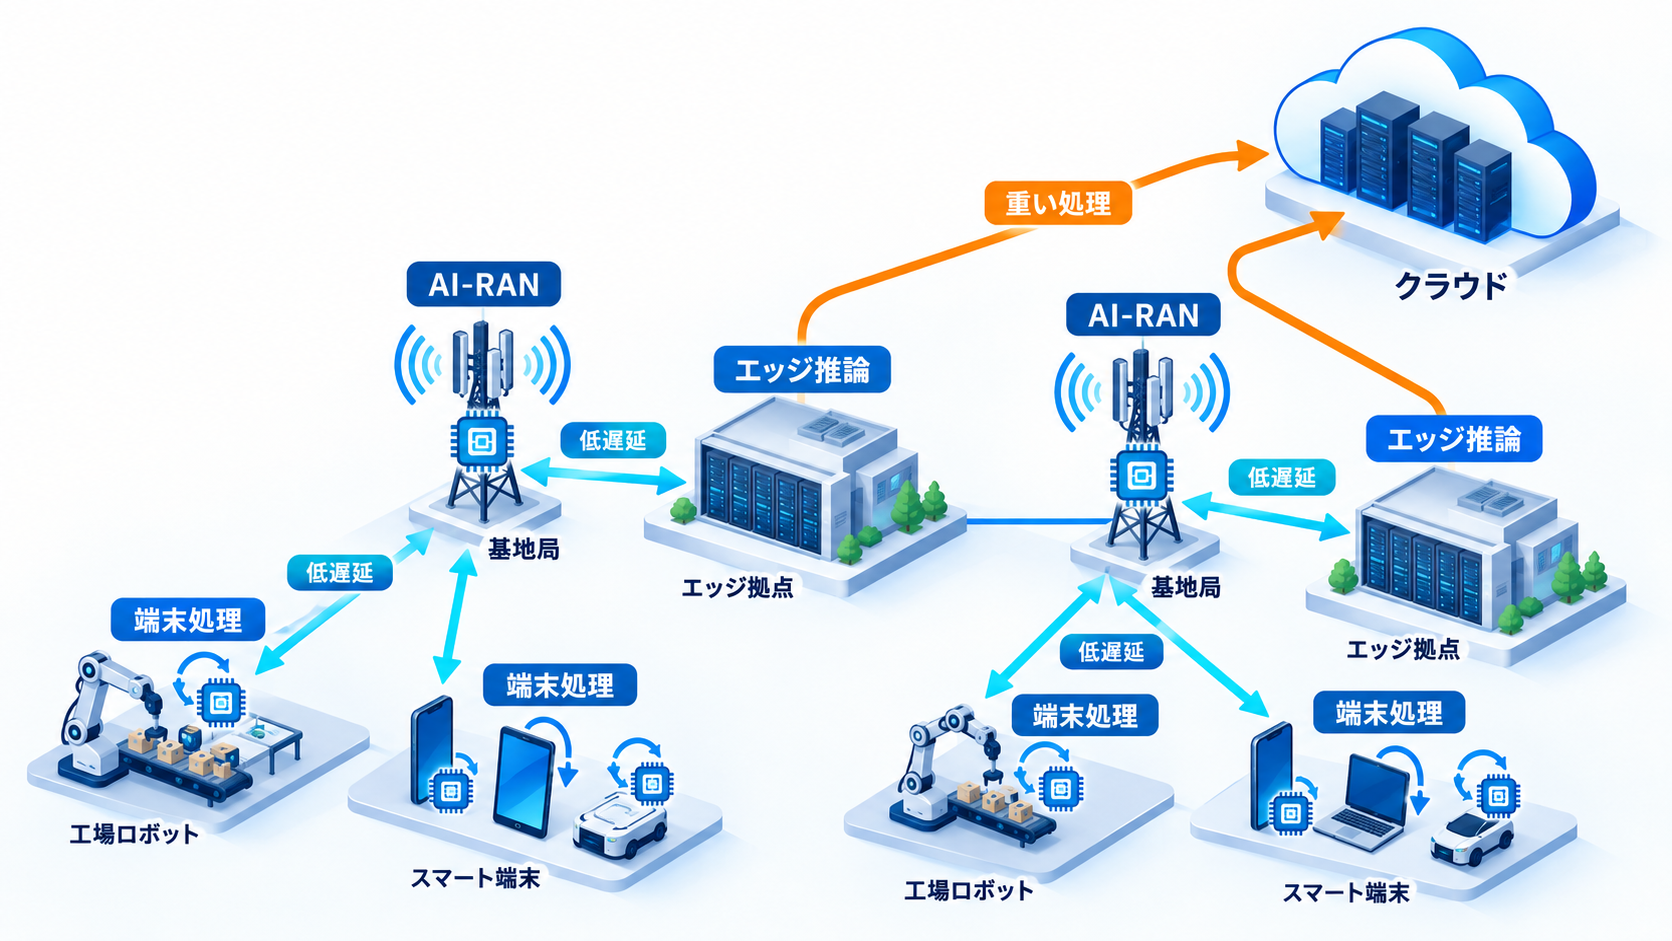
フアン氏は、将来の通信事業者が、合計約10万拠点、約100ギガワット規模の基地局やデータセンターを分散AIネットワークへ発展させると予測しました。欧州ではデータセンターの約20%を通信事業者が所有し、GPUを設置できる通信施設が1,500カ所以上あるとされています。既存拠点を活用できれば、利用現場に近い場所でAI推論を処理する選択肢が増えます。通信業界は、以前からエッジコンピューティングに期待を寄せてきました。しかし、通信網の近くで処理するMEC、すなわちマルチアクセス・エッジ・コンピューティングは、期待された規模の事業へ成長しなかったとの評価があります。今回は、生成AIの推論という具体的な処理需要があり、無線アクセス網そのものも同じ計算基盤で動かせる点が違いとして挙げられています。
T-MobileとNokiaは、商用ネットワークで初のAI-RAN通話を実演しました。AI-RANは、AI処理と無線アクセス網の処理を共通基盤へ載せる考え方です。通信設備を接続サービス専用にせず、空いている計算資源をAI推論へ振り向けられれば、設備利用率を高められる可能性があります。ただし、技術的に実行できることと、顧客が対価を払うサービスを作れることは別問題です。
ロボットなどのフィジカルAIも、分散構成を必要とする理由になります。機器は基本的な認識を本体で処理しながら、より重い判断が必要な場面では、工場内サーバー、通信事業者のエッジ拠点、クラウドのいずれかへ処理を依頼できます。遅延、機密性、計算量に応じて処理場所を選ぶハイブリッド型は、各地域に拠点を持つ通信事業者と相性があります。
日本の通信事業者にとっても、論点はGPUを拠点へ置くことだけではありません。どの業界のどの処理を対象にするのか、クラウドとの差をどう示すのか、現場機器からデータを安全に受け取れるのかが事業性を左右します。過去のエッジ構想と同じ結果を避けるには、設備計画と同時に販売体制や業務別サービスを設計する必要があります。
製造業とロボットが支えるフィジカルAI市場
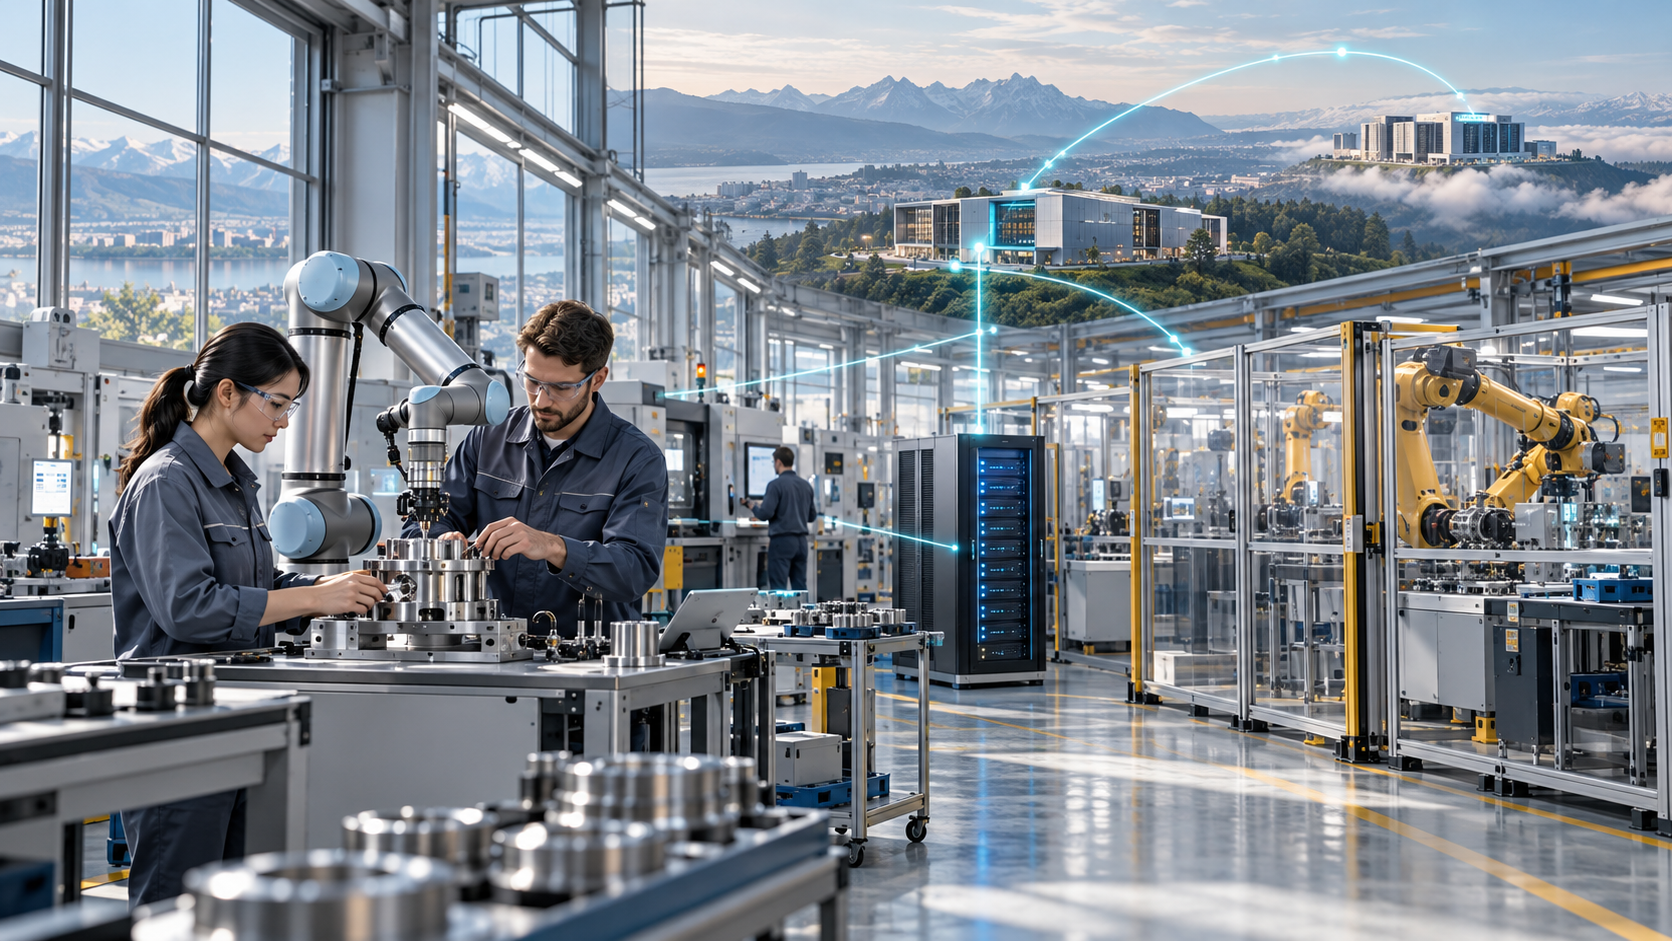
NvidiaにとってフィジカルAIは、研究段階だけの領域ではなくなっています。同社によれば、2026年上半期のフィジカルAI関連売上高は約110億ドルに達し、2025年通年を約30%上回りました。ロボット、製造設備、現実空間を認識して動くシステムが、AI基盤の新たな利用先になっていることを示す数字です。フィジカルAIでは、すべての判断をクラウドへ送る構成が適するとは限りません。安全や即応性に関わる認識は機器側で処理し、より大きなモデルや過去データが必要なときだけ外部設備を利用する構成が考えられます。通信が一時的に途切れても最低限の動作を維持しつつ、必要に応じて強力な計算資源を呼び出せることが、実際の現場では重要になります。
欧州には精密製造の産業基盤があり、中堅製造企業を意味する「ミッテルシュタント」も多数存在します。Nvidiaは、社内に大規模なロボティクス専門部門を持たない企業でも利用できる段階へ技術が進めば、欧州が大きな恩恵を得られると見ています。これは、ハードウェア、学習環境、運用基盤がパッケージ化されることで、導入企業がすべてを独自開発する必要が薄れるという見立てです。
製造現場を持つ日本企業にも共通する示唆があります。検証を始める際は、人員の全面代替といった大きな目標を置くより、検査、搬送、設備監視など、入力と成果を定義しやすい業務を選ぶほうが効果を測りやすいでしょう。現場側で止めるべき処理、外部へ送信できるデータ、人間の承認が必要な動作を整理すれば、AIモデルの精度だけに依存しない導入判断ができます。
AI工場、通信エッジ、ロボットは別々の市場に見えますが、Nvidiaの構想では一つの計算基盤として連続しています。中央設備でモデルを学習し、地域拠点で推論を支え、現場の機器が行動するという流れです。フィジカルAIの成長はGPU需要を増やすだけでなく、電力制御、通信、セキュリティを含む同社の統合戦略を補強します。
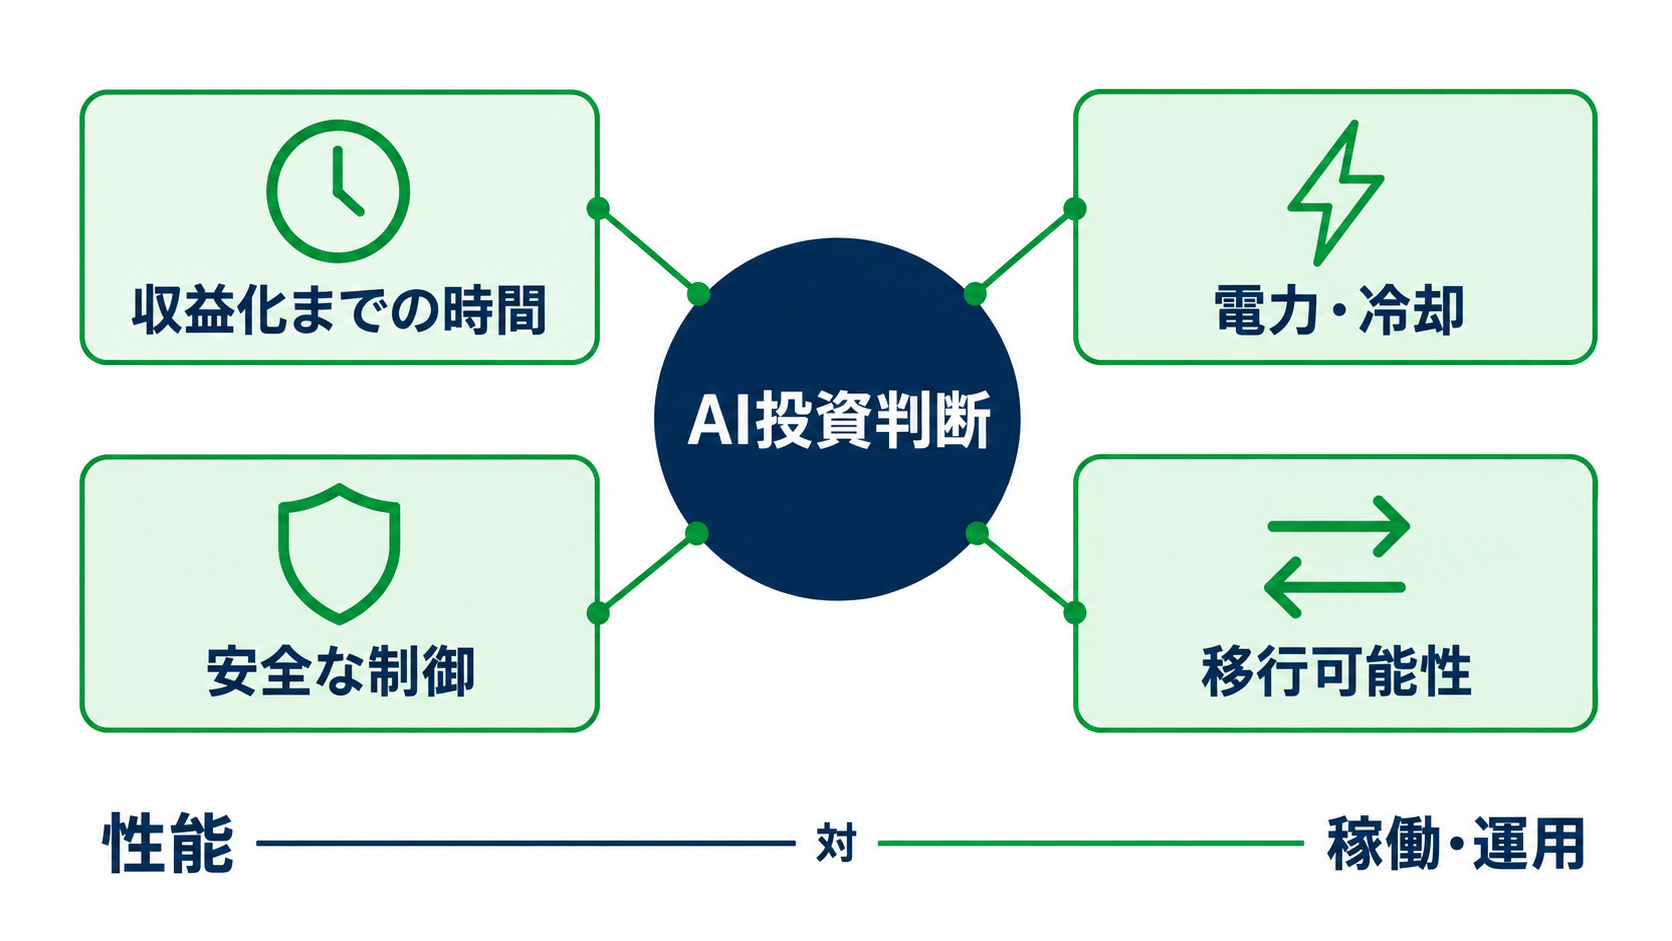
日本企業が投資判断で確認すべき四つの論点
Nvidiaは自社の方針を「垂直方向に最適化しつつ、水平方向には開かれている」と説明しています。顧客は必要な部分だけを選べるという主張です。しかし、コンテナの設計から電力制御、エージェントの監視、構造化データ向けモデルまで同社の提供範囲が広がるほど、個別製品を別のベンダーへ置き換えられるかどうかが問われます。企業が見るべき指標は、GPU単体の処理速度だけではありません。Nvidiaの旧世代Volta GPUは2019年から現在まで顧客環境で使われているとされ、長期運用できる設置基盤も同社の競争力になっています。CIOや設備運営者にとっては、ピーク性能より、稼働開始の早さ、更新経路、既存設備との互換性、投資を回収できる期間のほうが経営判断へ直結します。
検討時には、少なくとも次の四点を分けて確認する必要があります。
- **収益化までの時間**:用地や電力の準備を含め、契約から業務稼働までの全工程を測ります。14日という設置期間だけで判断しません。
- **電力と冷却の実効性**:最大効率の数字ではなく、自社の処理構成、気候、電力契約で得られる効果を検証します。
- **エージェントの制御境界**:ソフトウェア上の制限とハードウェア分離を区別し、誰がポリシーを変更できるかを確かめます。
- **移行可能性**:データ形式、ツール接続、監視ポリシーを他社基盤でも再利用できるかを契約と技術の両面から確認します。
Nvidiaの競合が主に半導体性能で争うなか、同社は収益化までの時間を競争軸に加えています。この提案を評価するには、統合によって短縮できる期間と、特定ベンダーへの依存が増す範囲を同じ資料上に並べるべきです。日本企業が取る具体的な一歩は、GPUの見積もりを増やすことではありません。候補となる一つの業務について、データ、エージェント、セキュリティ、設備、電力を含む稼働開始までの工程表を作り、どこが本当の待ち時間になっているかを把握することです。