
2026/11/03
AIニュース
DellとAMDが描くラックスケールAI――性能競争の軸は「部品」から「検証済み基盤」へ
単体性能だけでは決まらないAIインフラ競争
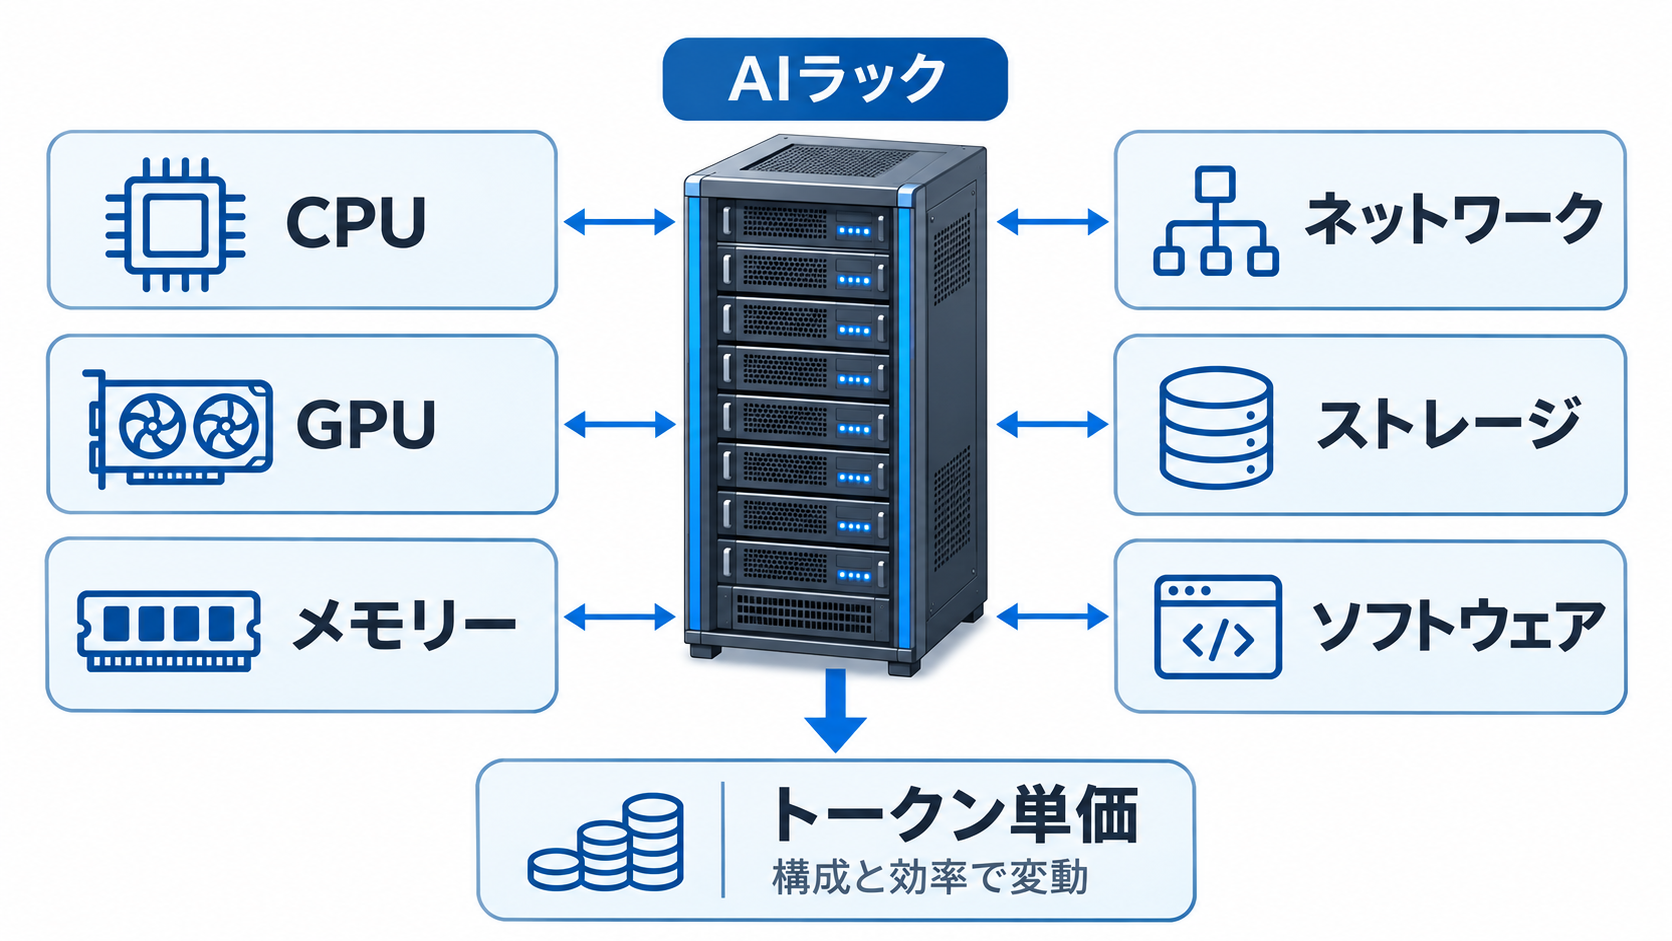
企業向けAI基盤の評価軸は、GPUの演算性能だけでは捉えにくくなっています。CPU、GPU、メモリー容量、ネットワーク帯域、ラック全体の処理能力に加え、投入コスト当たりで生成できるトークン数まで含めて判断する必要があるためです。どれか一つが高速でも、データ転送やモデルの読み込み、推論前後の処理が詰まれば、利用者が感じる応答速度や運用効率は伸びません。
Dell TechnologiesとAMDが重視しているのも、個別部品の優劣ではなく、ラック全体を継続的に改善できる開発体制です。theCUBE Researchは、この能力を「Engineering Velocity」と表現しています。発表時点のベンチマークで首位に立つことよりも、変化するワークロードに合わせて設計、検証、改良を素早く回せる企業が優位になるという見方です。両社は2026年5月のDell Technologies World以降も、サーバー、アクセラレーター、ソフトウェアを横断した協業を進めています。
この考え方が企業利用で意味を持つのは、生成AIが導入後も変化し続けるからです。モデルの更新、利用者の増加、エージェント機能の追加によって、必要なメモリーやCPU処理、ネットワーク通信の比率は変わります。導入時の最大性能だけを基準にすると、別の処理がボトルネックになった際に基盤全体を組み直す事態にもなりかねません。DellとAMDの取り組みは、部品の組み合わせを事前に検証し、同じ設計思想のまま拡張できることを競争力にしようとするものです。AIインフラ調達では、製品仕様表だけでなく、構成全体を誰が検証し、更新時の互換性をどう維持するのかまで確認する必要があるでしょう。
エージェント型AIが促すサーバー集約
エージェント型AIは、GPUだけで処理が完結する仕組みではありません。利用者の指示を解釈し、外部ツールを呼び出し、検索結果を整形して次の処理を決める過程では、汎用CPUも継続的に使われます。GPUを多数設置したデータセンターでCPU需要まで増えると、新しいサーバーを置く床面積、電力、冷却能力の確保が難しくなります。そこでDellとAMDが打ち出しているのが、世代更新によるサーバー集約です。
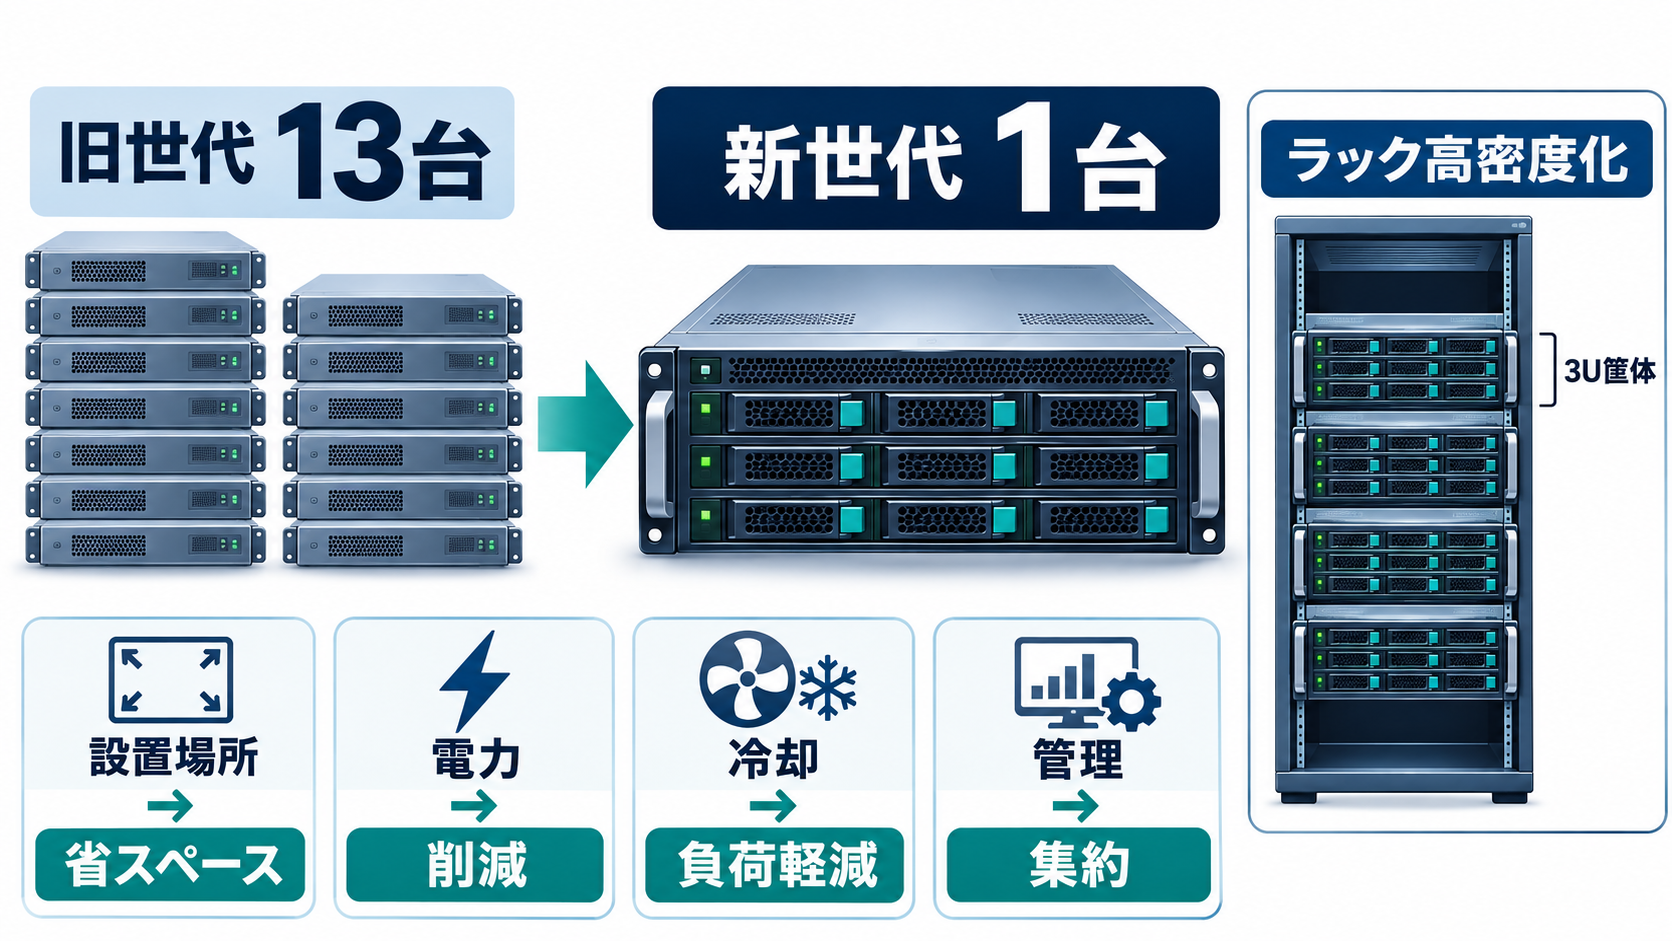
Dellの製品担当者Pradyumna Narendra氏によると、AMDプロセッサを搭載するシステムは世代間で70%の性能向上を実現し、Dellの第14世代PowerEdgeサーバー13台分を1台へ集約できる構成があります。10台から13台を1台に置き換えられれば、空いた設置場所だけでなく、管理対象となる機器、電源接続、保守作業も減らせる可能性があります。ただし、この数値はあらゆる業務に一律で当てはまる集約率ではありません。実際の効果は、既存サーバーの稼働率、アプリケーションの特性、メモリー使用量などを基に確かめる必要があります。
筐体サイズに関する説明も興味深いものです。Dellは、3ラックユニットのサーバーが同等の2ラックユニット製品より少ない冷却電力で動作し、結果としてラック単位では多くの計算能力を収容できると説明しています。薄い機器を詰め込めば必ず高密度になるとは限らず、筐体内の空気の流れや冷却効率まで含めて設計する必要があるということです。エージェント型AIと推論処理が広がれば、GPU以外の計算需要も増えると考えられます。企業はサーバー台数だけを見るのではなく、ラック当たりの処理量、消費電力、冷却負荷、運用工数をまとめて比較したほうが実態に近い判断を下せます。
小さく始めて拡張できる検証済み基盤
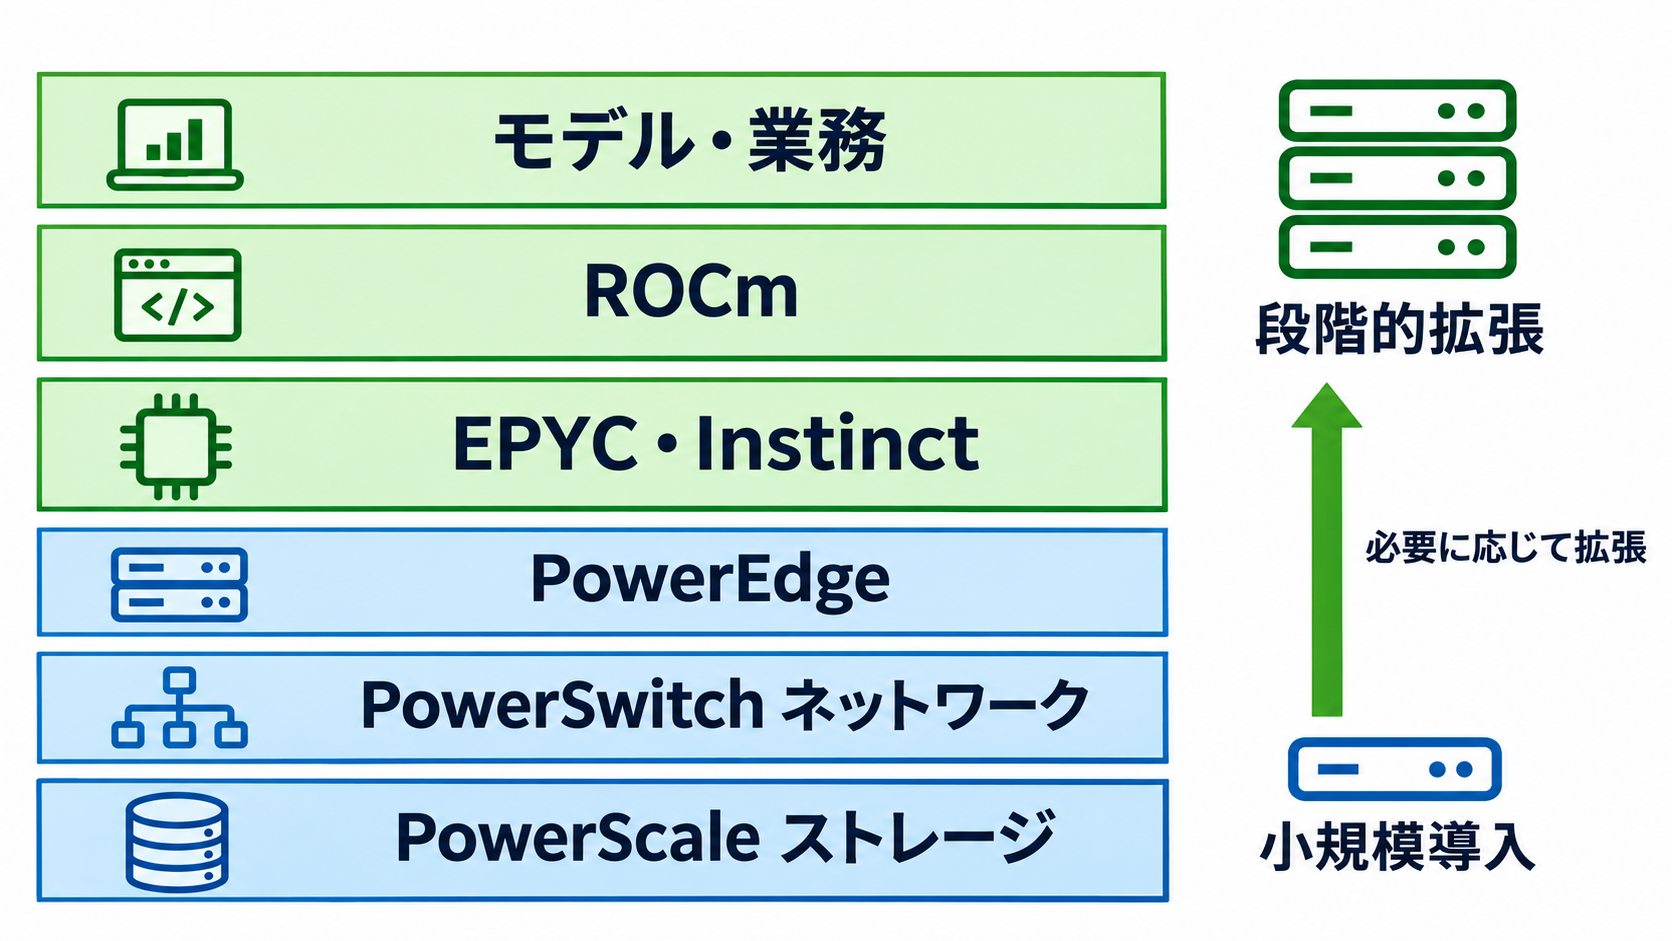
Dell AI Platform with AMDは、AMD InstinctアクセラレーターとEPYCプロセッサを、Dell PowerEdgeサーバー、PowerSwitchネットワーク、PowerScaleストレージと組み合わせたオンプレミス向けAI基盤です。モデルの学習やファインチューニング、高スループットの推論を対象とし、現在のワークロードに合う規模から導入して、必要に応じて計算能力やGPU密度を増やせる設計になっています。
企業が求めているのは、部品を個別に購入できることだけではありません。DellのVarun Chhabra氏は、コンピュート、ストレージ、ネットワーク、GPU、その上で動くソフトウェアフレームワークやモデルまで、相互にテストされているかが問われていると説明しています。AI基盤では、各製品が仕様上は接続可能でも、ドライバーやライブラリーの組み合わせによって性能や安定性が変わることがあります。検証済みの構成を用意する狙いは、こうした統合作業を導入企業だけに負わせないことにあります。
ソフトウェア面では、AMDのGPU向け基盤であるROCmが統合されています。利用企業は、ストレージ、計算、ネットワークを構成単位として導入し、Instinct、EPYC、ROCmとオープンなソフトウェア環境を同じ枠組みで拡張できます。初期投資を抑えやすいだけでなく、概念実証から本番環境へ進む際に全面的な再設計を避けやすい点が特徴です。
もっとも、「検証済み」という言葉だけで導入判断を終えるべきではありません。自社が使うモデル、推論エンジン、データ形式、監視ツールまで検証範囲に含まれるかを確認する必要があります。障害時の責任分界や更新手順も欠かせません。モジュール型基盤の価値は、機器を追加できることではなく、追加後も同じ運用方法とソフトウェア環境を維持できるかどうかで決まるでしょう。
PCIe GPUと空冷が広げる導入経路
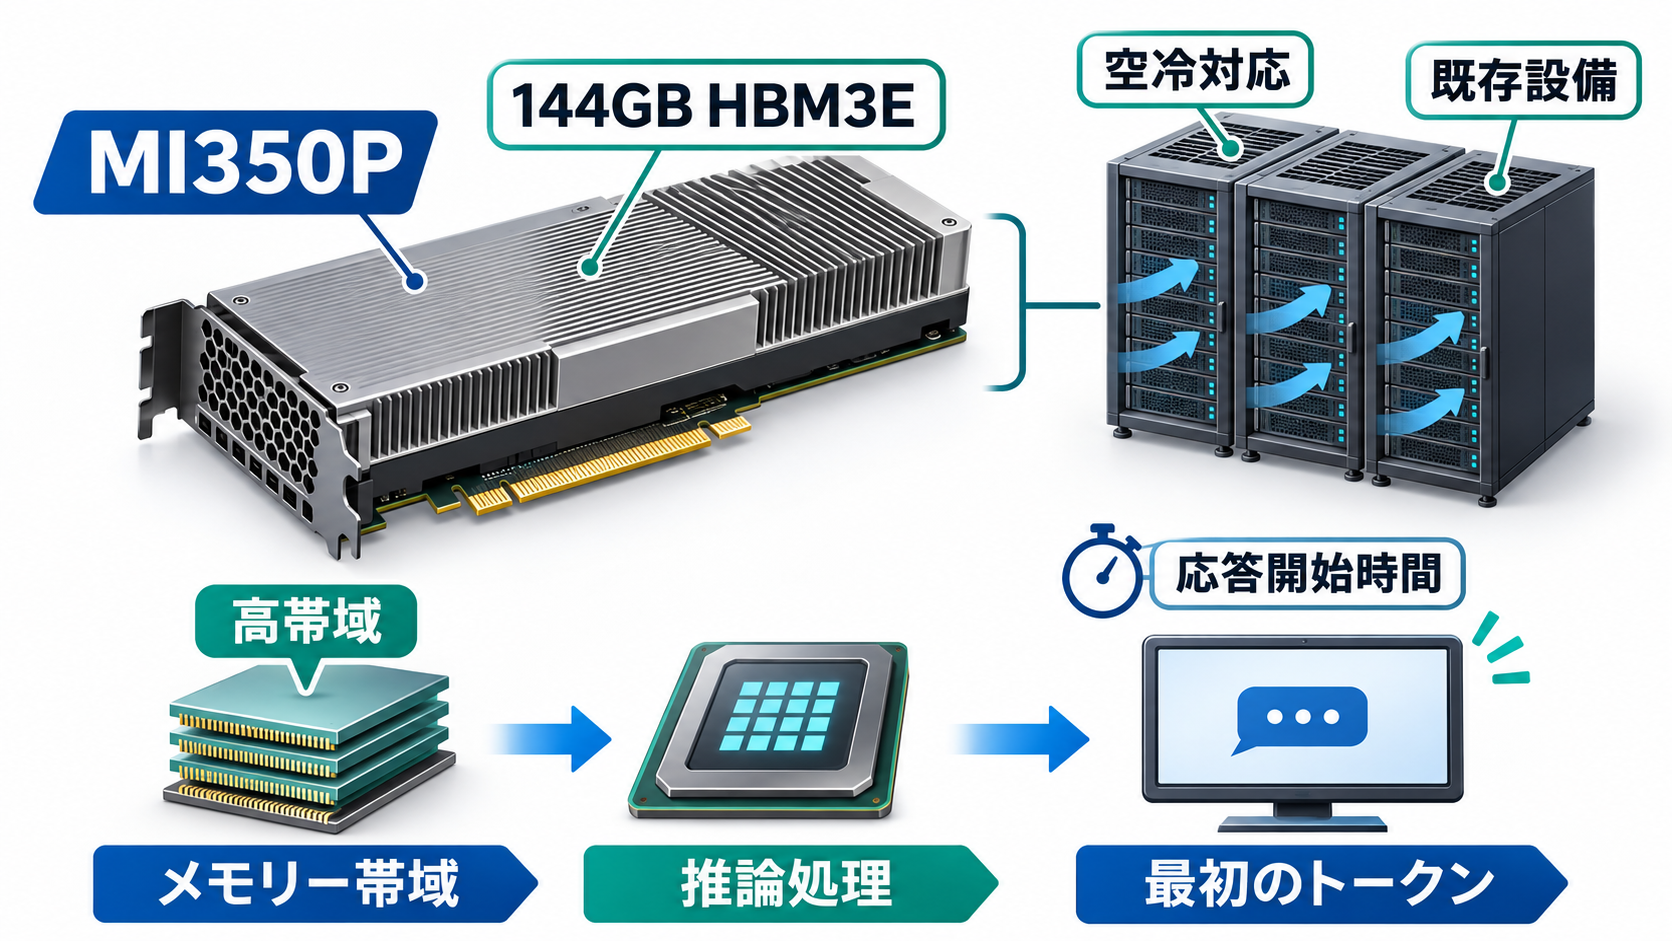
Dellは2026年7月から、PowerEdge XE7745およびR7725でAMD Instinct MI350P PCI Express GPUをサポートしています。MI350Pは144GBのHBM3Eメモリーを搭載しており、大規模モデルの推論で重要になるメモリー容量と帯域を確保しています。HBM3EはGPUが大量のデータへ高速にアクセスするための高帯域メモリーで、モデルの重みや推論途中のデータを扱う性能に関わります。
AMDのMike Darby氏が特に挙げている指標は、利用者が要求を送ってから最初の生成結果が表示されるまでの「Time to First Token」です。文章全体を生成し終える速度が同じでも、最初の応答が遅ければ、利用者はサービスを重く感じます。社内アシスタントや顧客対応など対話性が求められる用途では、平均処理件数に加えて、この応答開始時間を測定することが欠かせません。大容量かつ高帯域のメモリーは、その改善を支える要素になります。
PCIe形式のMI350Pには、既存のデータセンターへ導入しやすいという別の狙いもあります。AMDとDellは、空冷可能なPCIeカードをPowerEdgeの幅広い製品で使えるようにしました。大規模なAI設備では液冷が有力な選択肢になるものの、Dellが次世代PowerEdgeを展開する中では、液冷を受け入れる準備が整っていない企業も確認されています。米国では大型データセンターの建設を巡り、環境への影響や水冷設備の水使用量も懸念されています。
空冷対応は、液冷より常に優れているという意味ではありません。設置場所の温度、電力密度、騒音、将来のGPU増設計画によって適切な方式は変わります。ただ、既存設備を大幅に改修できない企業にとって、PCIeと空冷の組み合わせは現実的な移行経路になり得ます。導入可否を検討する際はGPU単体の消費電力だけでなく、ラック全体の発熱量と空調余力を測り、想定する連続負荷で性能が維持されるかを確かめるべきです。
研究機関と通信事業者で進む実装
DellとAMDの協業は、製品構成の提供にとどまりません。両社は2026年6月、英国のケンブリッジ大学とSovereign AI Innovation Lab、通称SAILを設立する計画を発表しました。ソブリンAIとは、データ、計算資源、モデルなどを自国や組織の管理方針に沿って扱う考え方です。SAILは、AIインフラの研究とAIを利用した科学的成果の創出を支援することを目的としています。
この取り組みは、ケンブリッジ大学が拡充しているAI研究基盤の延長にあります。Zenith AIスーパーコンピューターには、第5世代AMD EPYCプロセッサとAMD Instinct MI355X GPUアクセラレーターが採用され、Dellのインフラへ統合されています。研究環境では扱うモデルやデータの種類が変わりやすいため、計算、保存、ネットワークを一体で拡張できる設計との相性が注目されます。
通信分野では、DellとAMDがAT&Tの取り組みにも関わっています。通信ネットワーク由来のデータは量が多く、AT&Tはモデル学習で1兆トークンを超えるデータを処理しています。AMDは、Open Telco AIイニシアチブで開発されたOTel 2.0モデルの学習と推論に向けて、高性能なハードウェア基盤を提供しました。Dellは通信環境向けに最適化したサーバーへ技術を統合し、OTel 2.0の学習基盤にはMI355X GPUを8基搭載したPowerEdge XE9785が使われています。
大学と通信事業者では目的が異なりますが、共通するのは実データを扱う本番級の基盤が必要な点です。公開ベンチマークの結果だけでは、研究ワークフローや通信網固有の負荷に耐えられるかは分かりません。こうした導入事例は、AMDがCPUやGPUの供給者にとどまらず、Dellや利用組織とともにシステム全体で選択肢を示そうとしていることを表しています。企業側も、採用候補を単一のアクセラレーターベンダーに絞る前に、自社負荷を再現した検証環境で比較する余地がありそうです。
日本企業が調達前に確かめたい四つの条件
DellとAMDの提案から読み取れるのは、AI基盤の調達単位がサーバーやGPUから、検証済みのラックと運用環境へ移りつつあることです。日本企業が同様の基盤を検討する場合も、最高性能の構成を先に選ぶのではなく、業務で待ち時間や費用を生んでいる場所を特定する必要があります。推論中心の環境と、モデル学習を繰り返す環境では、重視すべきメモリー容量やネットワーク帯域が異なります。
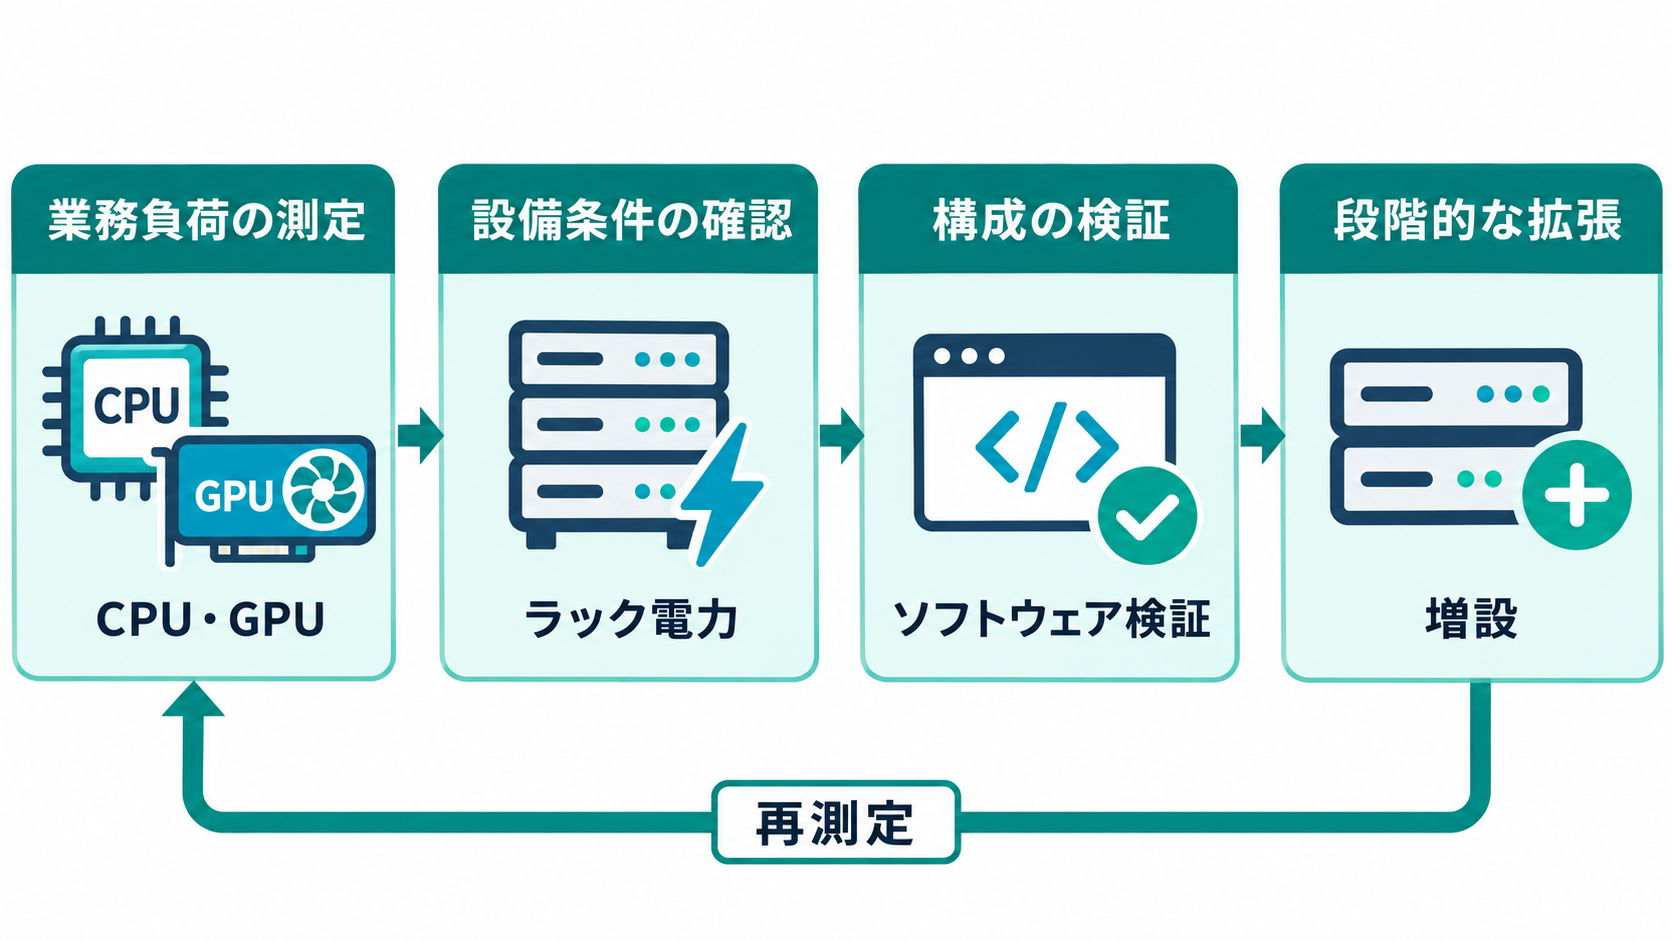
確認項目は、大きく四つに整理できます。
- 業務負荷では、モデルの大きさ、同時利用者数、要求される応答開始時間、CPUを使う前後処理を測定します。
- 設備条件では、ラックの空き、供給電力、空調能力、液冷設備を導入できる時期を洗い出します。
- 検証範囲では、自社のモデル、ROCmを含むソフトウェア、監視基盤、ストレージまで動作確認の対象かを確かめます。
- 拡張計画では、GPU追加時にネットワークや保存領域も同じ単位で増設できるか、運用手順を維持できるかを確認します。
コスト評価にも注意が必要です。サーバーの購入額だけでは、旧世代機を集約して得られる電力、設置場所、管理工数の削減効果を捉えられません。その一方で、高密度化によって電源や冷却設備の改修費が発生する場合もあります。「トークン当たりのコスト」は有用な指標ですが、利用するモデル、精度設定、入力の長さによって結果が変わるため、自社条件で測ることが前提です。
実務上の出発点は、既存環境の棚卸しです。ピーク時のCPUとGPU使用率、モデルが必要とするメモリー、最初のトークンが返るまでの時間、ラック単位の電力と温度を記録すれば、集約すべき場所と増強すべき場所を分けられます。そのデータを使って小規模な構成を検証し、同じ設計のまま一段階拡張して性能と運用負荷を再測定するとよいでしょう。ラックスケールAIの価値は、導入初日の最大性能ではなく、利用拡大後も予測可能な形で増設と更新を続けられるかどうかに表れます。
参考情報
Rack-scale AI: How Dell and AMD are building infrastructure
SiliconANGLEは、theCUBEがDell AI Data Platform Eventの有料メディアパートナーであり、Dellを含むスポンサーは掲載内容を編集できないと開示しています。