
2026/10/27
AIニュース
AIエージェントの権限をどう守るか――Dellが示すサプライチェーン起点の多層防御
自ら動くAIが変える企業のリスク境界
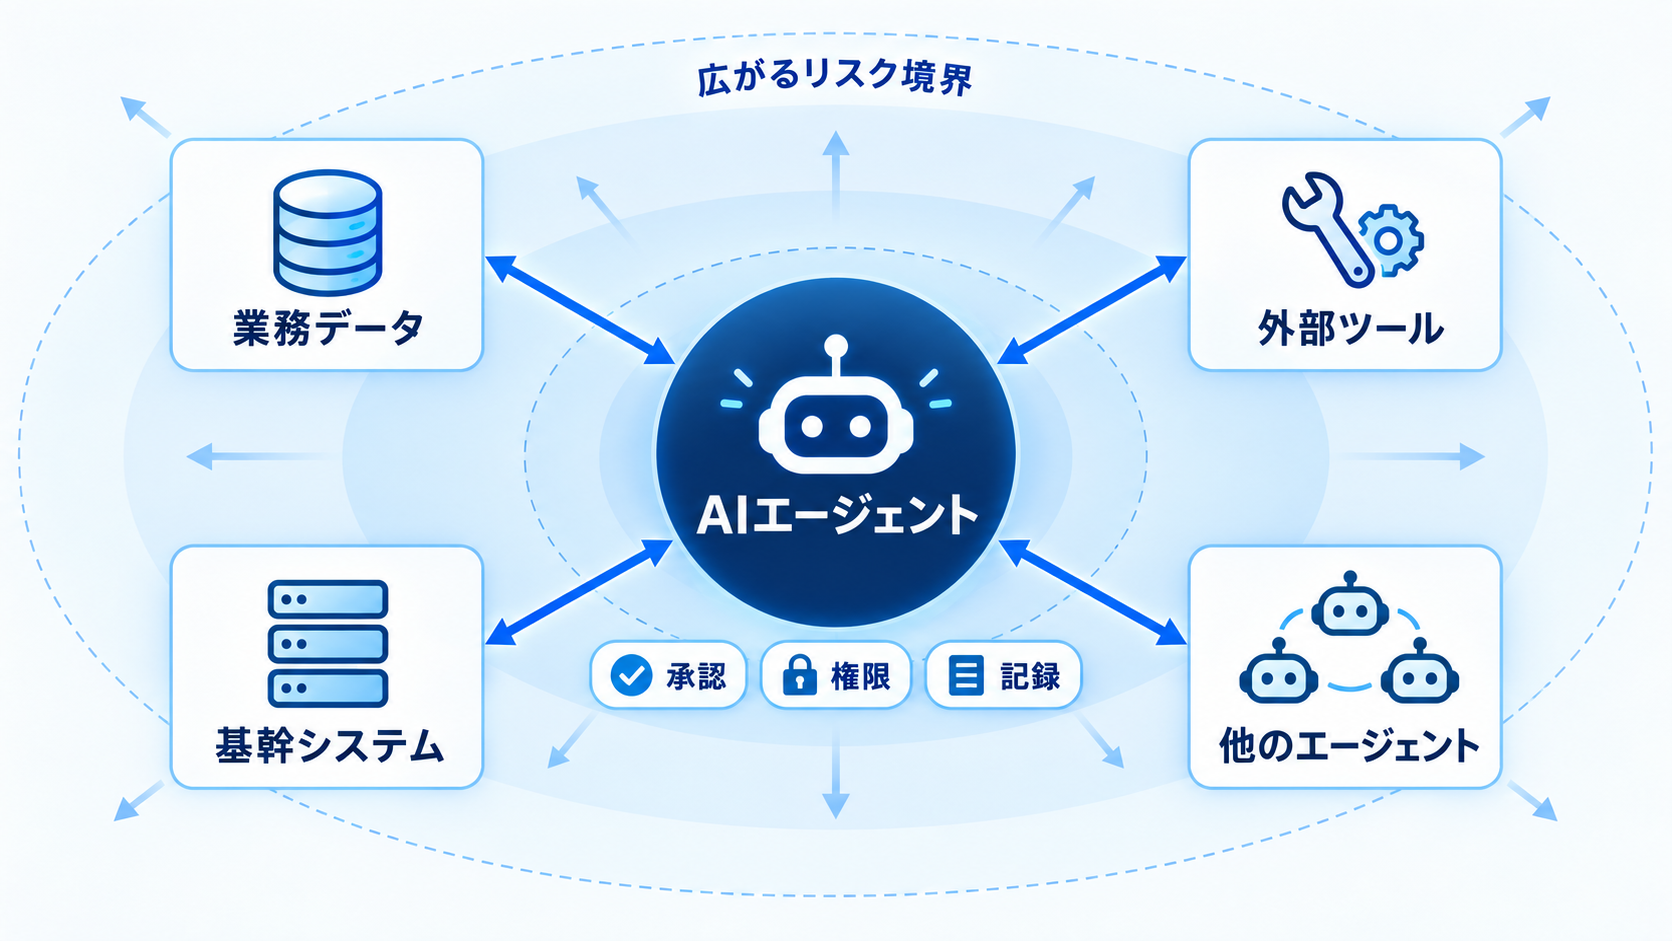
従来のチャットボットは、利用者の質問に答えることが主な役割でした。これに対してAIエージェントは、与えられた目標を達成するために複数の手順を組み立て、外部ツールを選び、業務システムへアクセスし、別のエージェントと連携することがあります。生成AIを基幹業務へ組み込む企業にとって、守る対象はモデルや入力データだけではありません。AIがどの権限で、どのシステムに、どのタイミングで働きかけたのかまで管理する必要があります。Dell TechnologiesでAI Factory Solutionsの製品管理を担当するKamlesh Shah氏は、AIシステムが拡大する速度と規模に合わせて、企業側も対処できる体制を整える必要があると説明しています。ただし、技術を導入しただけで一夜にして実現できるものではありません。インフラ、データ、アプリケーション、運用手順をまたいで、管理可能な境界を設計し直す作業が伴います。
ここで中心となる論点は、AIエージェントを単なるソフトウェア機能として扱わず、行動する主体として捉えることです。人間の利用者には本人確認や職務に応じたアクセス制御があり、従来型の機械処理にもサービスアカウントなどが使われてきました。ところが、自律的に計画を変更しながら複数の処理を実行するエージェントには、既存の管理方法だけでは追跡しにくい場面があります。誰が処理を承認し、どのエージェントが実行し、結果として何が変更されたのかを説明できる仕組みが、実運用の前提になるでしょう。
なお、今回の発言はSiliconANGLE Mediaの配信スタジオ「theCUBE」で行われたインタビューによるものです。この番組枠はDell Technologiesがスポンサーを務めていますが、開示情報では、スポンサーはtheCUBEおよびSiliconANGLEの編集内容を管理していないとされています。製品提供企業の見解である点を踏まえつつ、企業のAI統制に共通する課題として読み解く必要があります。
サプライチェーンを防御の出発点にする理由
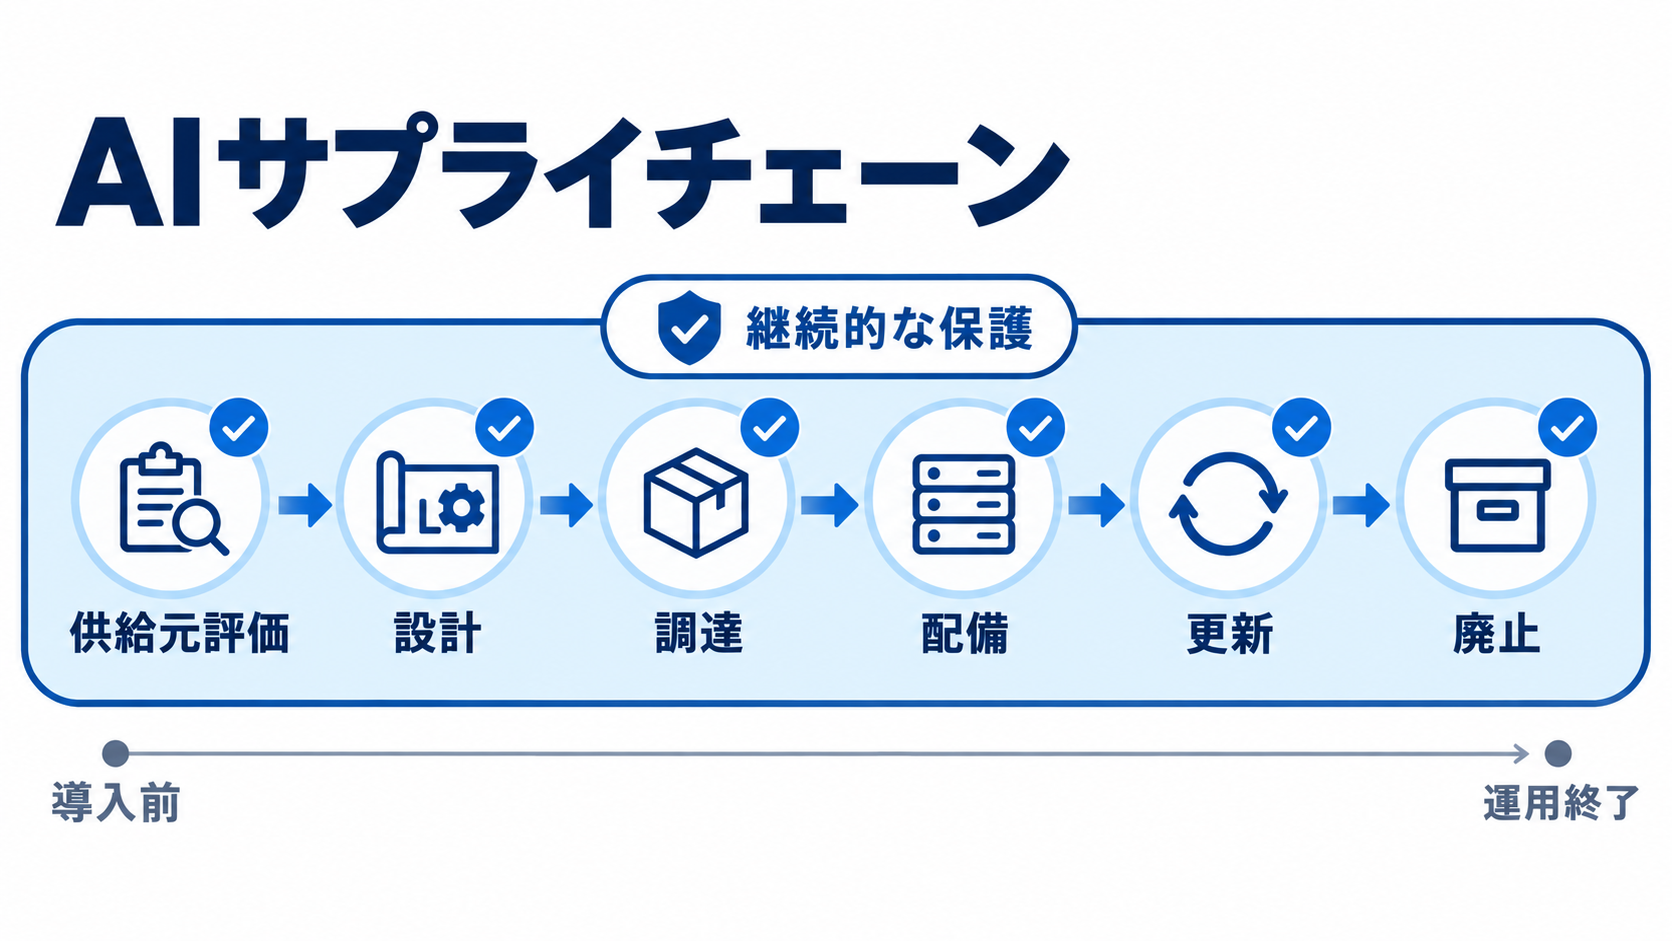
Dellが多層防御の起点に据えているのは、AIモデルそのものではなくサプライチェーンです。ここでいうサプライチェーンには、完成した機器の調達先だけでなく、構成部品、ソフトウェア、提供事業者、更新経路、保守運用など、システムが企業へ届き、利用され続けるまでの一連のつながりが含まれます。導入後の設定だけを点検しても、構成要素の由来や更新の信頼性に問題があれば、防御には空白が残りかねません。Shah氏によると、Dellの考え方では、製品が具体化される前の段階から供給事業者を評価し、配備後もライフサイクル全体を通じて保護を続けます。同社はこうした機能をDell AI Factoryを通じて提供するとともに、自社の大規模なIT運用でも利用していると説明しています。Dell AI Factoryは、企業がAIを構築・運用するためのインフラや関連サービスを組み合わせた同社の枠組みです。
この考え方がAIエージェントと結び付くのは、エージェントが多くの外部要素に依存するためです。モデルが安全でも、呼び出すツール、接続先のAPI、データ基盤、実行環境のいずれかに問題があれば、不適切な処理につながる可能性があります。導入時点で一度だけ検査するのではなく、更新や構成変更を含めて信頼性を確認し続ける必要があるのです。
企業が参考にできるのは、特定製品の採用そのものより、導入経験を再利用可能な統制パターンへ変える発想でしょう。案件ごとにゼロからルールを作ると、担当組織や委託先によって管理水準がばらつきます。供給元の確認、承認済み構成の記録、更新時の検証、廃止時のデータ処理といった項目を共通化できれば、個別のAI案件を同じ基準で評価しやすくなります。サプライチェーン防御は調達部門だけの仕事ではなく、IT、セキュリティ、法務、事業部門を結ぶ統制の土台として扱うことが求められます。
エージェント固有のIDと期限付き権限
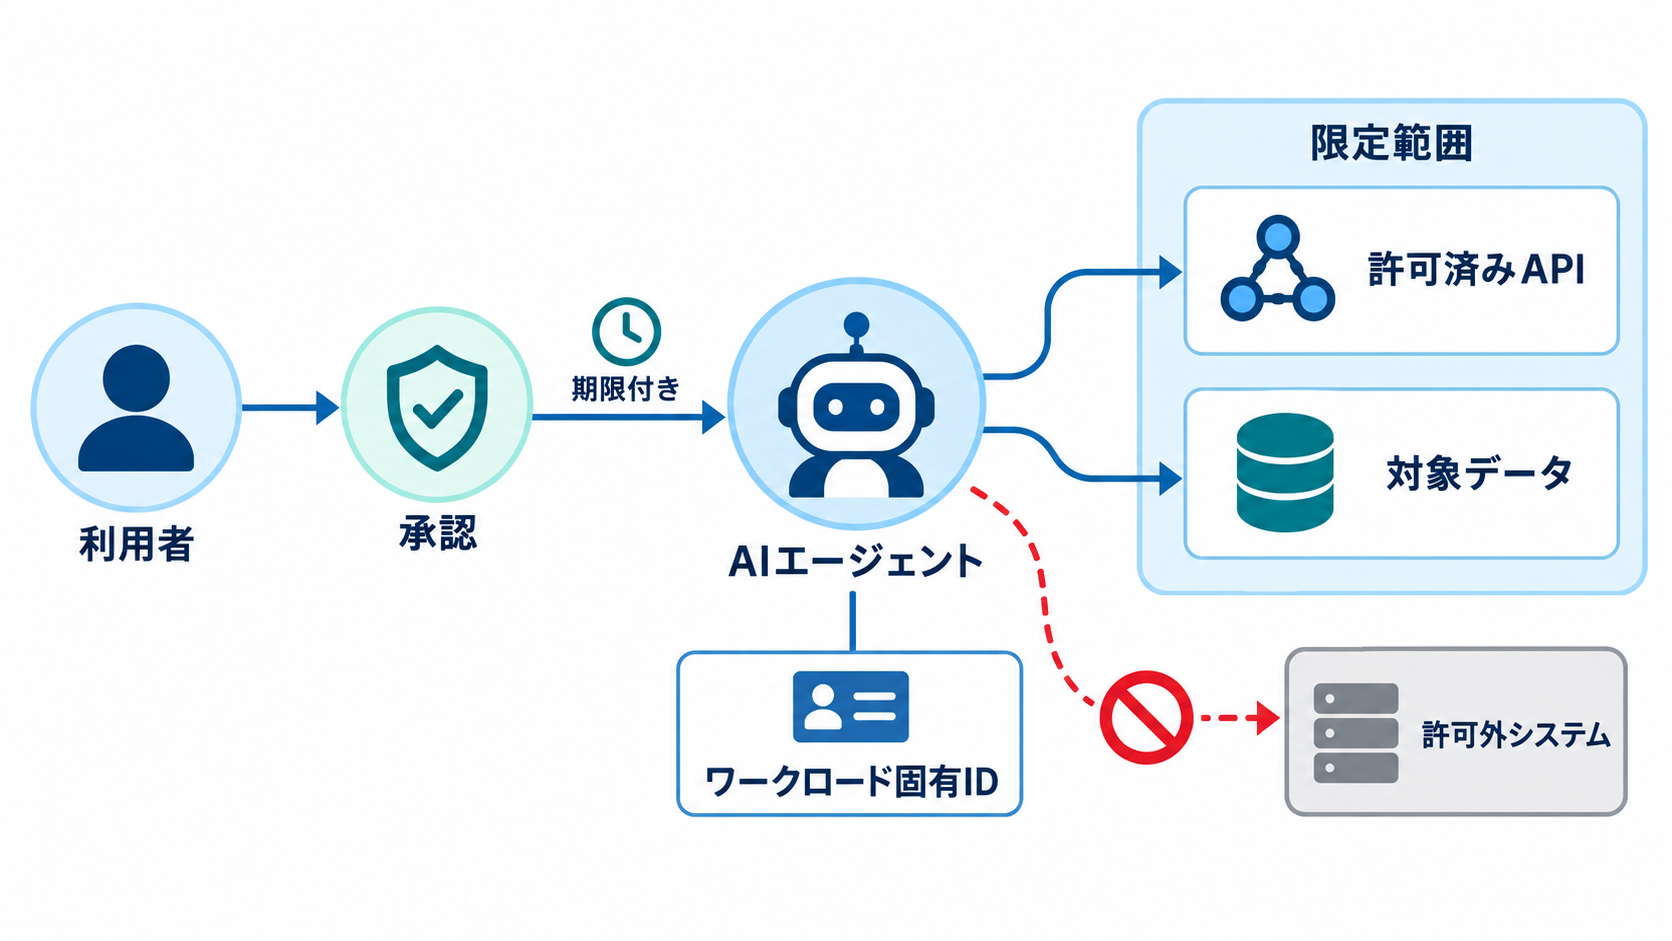
AIエージェントが業務システムを操作するなら、そのエージェント自身を識別できなければなりません。人間の担当者がログインした後、その権限をエージェントが広範囲に引き継ぐ設計では、意図しない処理が起きた際に責任の所在や影響範囲を確認しにくくなります。共有アカウントを使わせたり、複数の用途に共通する強い権限を付与したりする構成も、攻撃者に悪用された場合の被害を広げます。Shah氏は、エージェントのIDを特定のワークロードにひも付け、すべてのアプリケーションで使える包括的な権限を与えないことを提案しています。権限は委任された範囲に限定し、必要な期間だけ有効にする考え方です。たとえば、請求内容を照合するエージェントには、対象データの参照と確認結果の登録だけを許可し、利用者情報の一括取得や別システムの設定変更までは認めない、といった設計が考えられます。これは一般的な考え方を示す例であり、実際の権限は業務とリスクに応じて決める必要があります。
時間制限も重要です。常に有効な認証情報をエージェントへ持たせると、本来の処理が終わった後もアクセス経路が残ります。タスクの開始時に短期間だけ資格情報を発行し、完了時や異常検知時に失効させれば、権限が悪用され得る時間を狭められます。実行環境を隔離するランタイムサンドボックスや、許可された操作だけを通すポリシーチェックと組み合わせることで、IDだけに依存しない防御になります。
管理者には、個々のエージェントを登録する台帳も必要になるでしょう。所有部門、用途、接続先、利用モデル、許可されたツール、権限の有効期間、停止責任者などを記録しておけば、構成変更やインシデント対応時の確認が容易になります。AIエージェントのID管理は、人間向けのID管理を単純に流用する作業ではありません。目標に応じて一連の行動を選ぶという特性を踏まえ、行動の範囲と承認経路を同時に設計する必要があります。
ハードウェアからアプリまでを貫く四層の統制
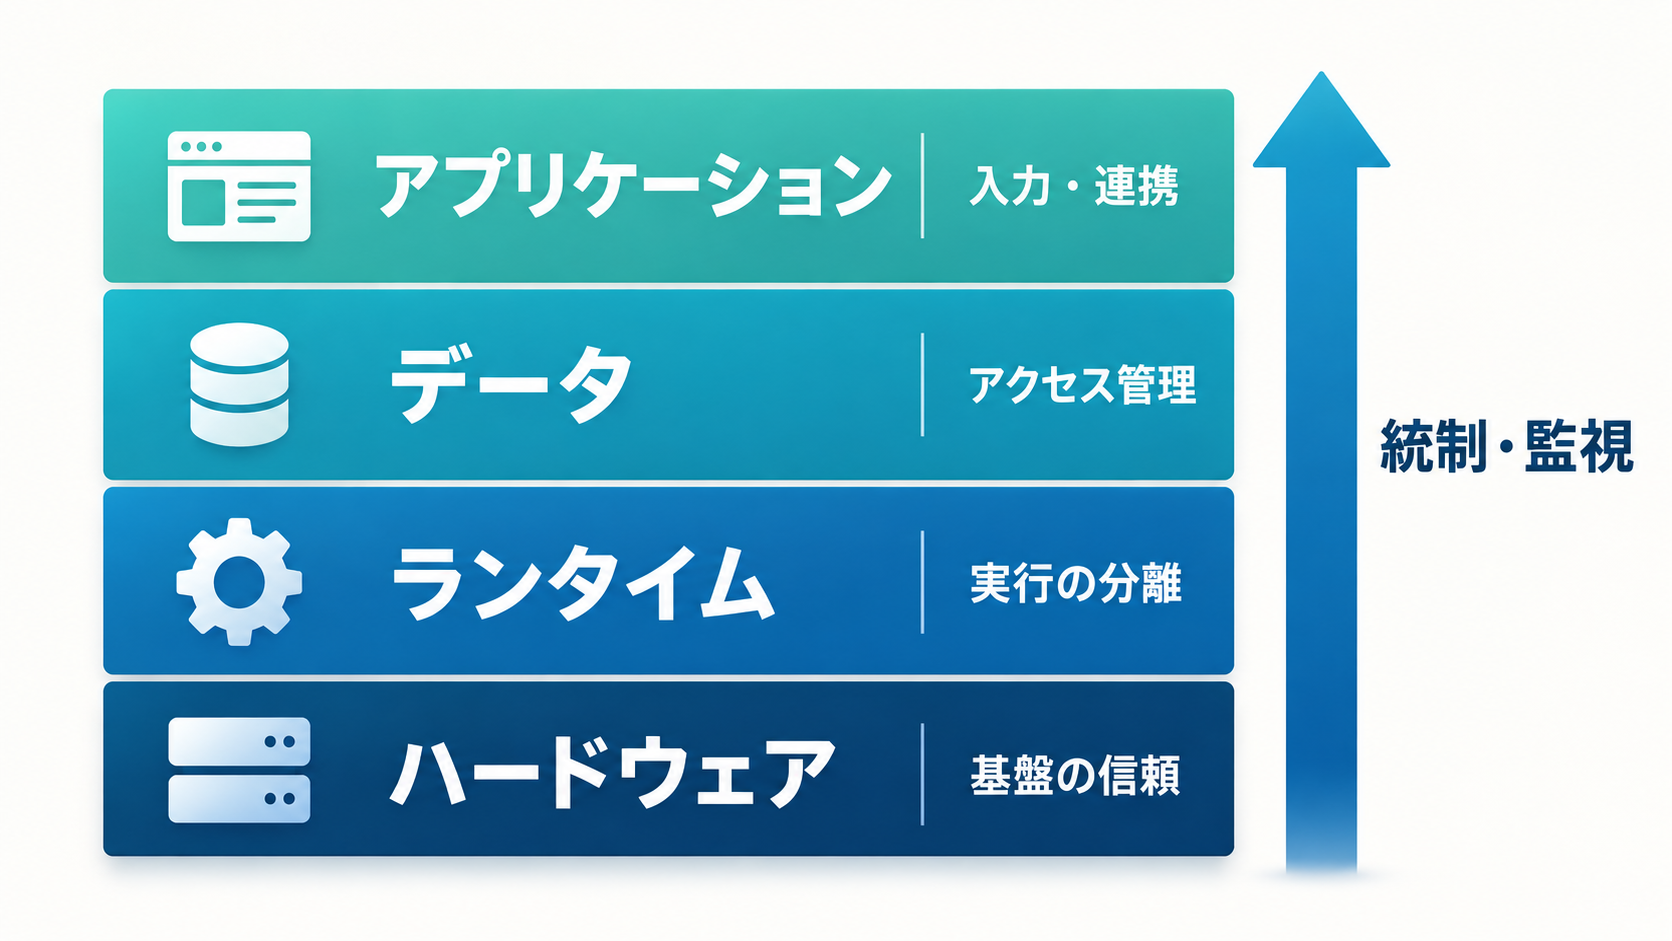
Dell Servicesで製品管理を担当するAsh Lakshmanan氏は、顧客が選んだAIアーキテクチャを、継続的に運用・統制・改善できる環境へ移す支援について説明しています。その対象は、ハードウェア、ランタイム、データ、アプリケーションという四つの層です。AIの安全性をアプリケーションの入力制御だけで確保しようとすると、下位層で起きる設定変更や不正なアクセスを見落とす可能性があります。ハードウェア層では、機器やファームウェアを含む基盤の信頼性が問われます。ランタイム層は、モデルやエージェントが実際に動く環境であり、処理の分離、実行制限、更新管理などが関係します。データ層では、参照できる情報の範囲、機密性、完全性、利用目的との整合を確認しなければなりません。アプリケーション層は利用者との接点であり、入力、出力、外部ツールの呼び出し、承認フローが統制の対象になります。
四層は独立していません。アプリケーション上では許可された処理に見えても、想定外のデータへアクセスしていれば問題になります。データの権限が適切でも、ランタイムが隔離されていなければ、別のワークロードへ影響が及ぶかもしれません。そのため、各層に担当者を置くだけでは足りず、層をまたぐ変更や異常を関連付けて確認できる運用が必要です。
企業が設計を始める際は、一つのユースケースを四層に分解すると整理しやすくなります。利用する機器とソフトウェア、エージェントの実行場所、参照データ、外部連携、利用者への提示方法を一枚の構成図にまとめ、それぞれの管理責任者と承認条件を割り当てます。技術部門だけで完結させず、データの所有部門や業務責任者を含めることが欠かせません。AIの統制を単一のセキュリティ製品へ任せるのではなく、層ごとの対策を連動させることが、多層防御の実務的な意味になります。
従来の監視では見えにくい「エージェントの行動」
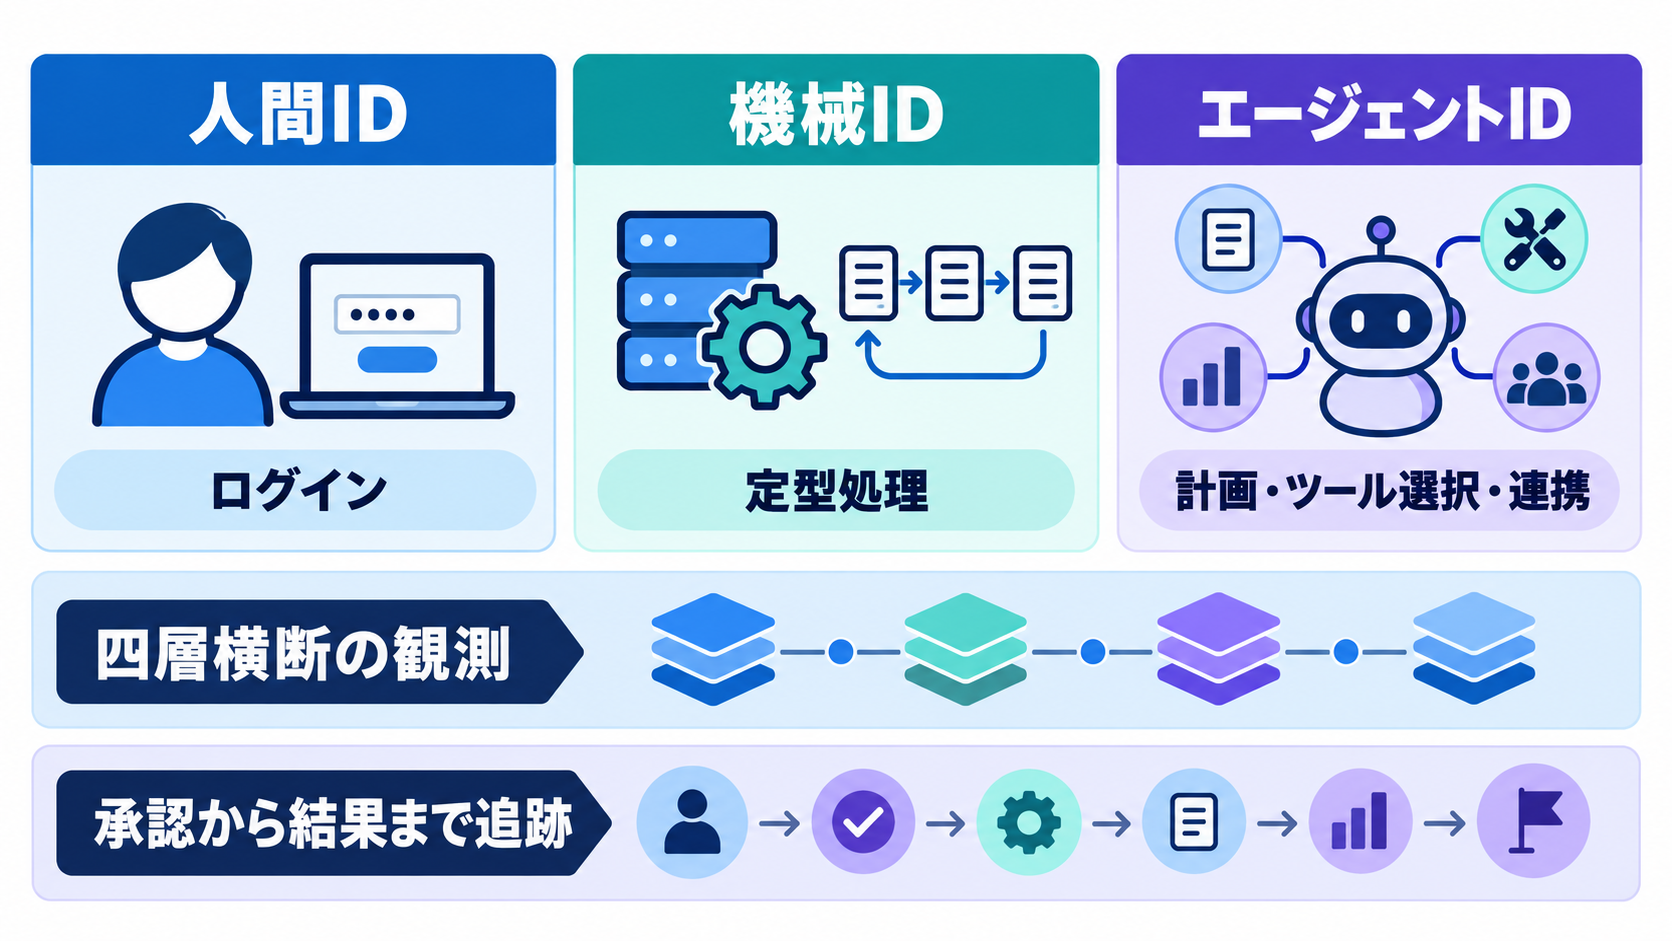
Lakshmanan氏が顧客の過小評価しやすい領域として挙げたのが、四層を横断するオブザーバビリティです。オブザーバビリティとは、ログ、メトリクス、処理の追跡情報などを使い、システム内部で何が起きているのかを外部から把握できる状態を指します。単に稼働中かどうかを監視するだけではなく、異常の原因や影響範囲をたどれることが重要です。従来のセキュリティツールは、人間のIDや一定の手順を繰り返す機械IDを中心に設計されてきました。Lakshmanan氏は、そうした既存ツールではAIワークロードやエージェントIDを確認できないと指摘しています。エージェントは一つの要求から複数の操作を派生させるため、個別のAPI呼び出しだけを見ても、全体として何を達成しようとしていたのかを理解しにくいからです。
必要になるのは、利用者の依頼からエージェントの判断、ツールの選択、データ参照、外部システムの変更までを一つの処理として関連付ける記録です。「誰が、何を、いつ実行したか」に加えて、「誰の承認に基づき、どの目的で、どの権限を使ったか」まで追跡できれば、調査や監査に利用しやすくなります。エージェント同士が連携する場合には、処理を引き渡した経路も残す必要があるでしょう。
ただし、すべての推論過程を無制限に保存すればよいわけではありません。ログ自体に個人情報や機密情報が含まれる可能性があり、保存期間や閲覧権限にも統制が必要です。観測項目は、業務上の説明責任、セキュリティ調査、システム改善に必要な範囲から設計するのが現実的です。既存の監視基盤を直ちに全面更新するのではなく、エージェント固有のID、ツール呼び出し、承認情報など、現在取得できていない記録を洗い出すことが出発点になります。
公開前テストと侵害を前提にした継続運用
AIアプリケーションは、期待どおりに回答できるだけでは公開準備が整ったとは限りません。Lakshmanan氏によると、Dellの侵入テストサービスを利用した一部の顧客は、公開予定のチャットボットが攻撃者に悪用される可能性を確認し、提供できる段階に達していないと判断しました。通常の機能テストでは成功する入力を中心に確認しがちですが、セキュリティ評価では、意図的に境界を越えさせようとする入力や外部連携の悪用も想定します。エージェントでは、テスト範囲が回答内容だけにとどまりません。不正な指示によって許可外のツールを呼び出さないか、機密データを取得しないか、別のエージェントへ危険な依頼を引き渡さないかを確認する必要があります。失敗した際に処理を安全に停止できるか、重要な変更の前に人間の承認を求められるかも検証対象です。モデルや接続先が更新されれば挙動が変わり得るため、公開前の一度きりの試験ではなく、変更に合わせた再評価が求められます。
DellはNvidiaと協力し、デスクサイドからデータセンターまでエージェント型AIを展開する取り組みも進めています。実行場所が広がるほど、端末、ネットワーク、集中管理基盤をまたいだ一貫性が課題になります。どこで動いても同じポリシーを適用できるのか、端末側で発生した操作を中央から追跡できるのかといった点を、アーキテクチャの選定時に確認する必要があるでしょう。
Lakshmanan氏は、新しいツール、プラットフォーム、スキルが必要になる一方、攻撃対象を狭め、24時間継続して観測し、侵害が起こり得る前提で備えるという基本は変わらないと述べています。これは、AI専用の対策だけに投資すればよいという話ではありません。既存のインシデント対応手順へAIシステムを組み込み、停止判断、権限失効、影響調査、復旧の責任者を決めておくことが、実際の耐障害性につながります。
日本企業が着手すべき小規模な統制設計
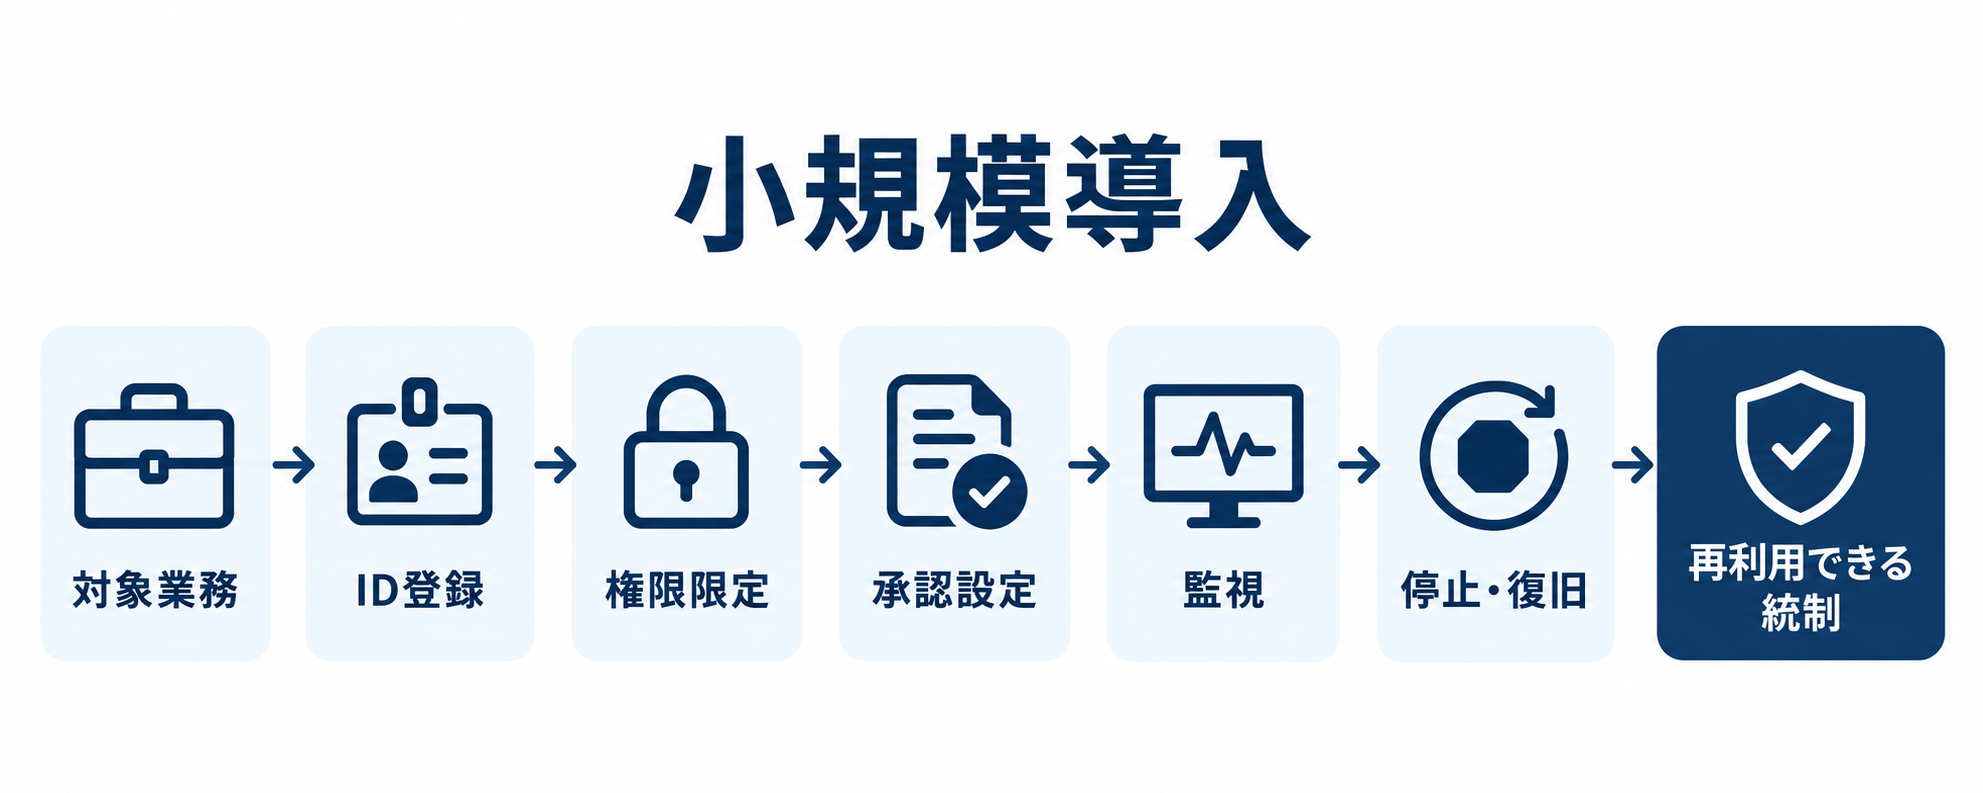
日本企業がAIエージェントを導入する際、最初から全社共通の大規模基盤を完成させようとすると、検討項目が増え、現場での検証が進まないことがあります。実務では、影響範囲を限定できる一つの業務を選び、サプライチェーン、ID、権限、四層の構成、観測項目、緊急停止の流れを一通り設計する方法が考えられます。小さく始める目的は統制を省くことではなく、再利用できる型を具体的な運用から作ることです。候補となる業務を選ぶ際は、処理を誤った場合の影響と、人間が確認できる余地を見ます。社内情報の検索と、顧客口座や製造設備を直接変更する処理では、求められる権限や承認の厳しさが異なります。実証段階でも本番データを扱うなら、データ管理者の承認や記録方法を曖昧にしてはいけません。「試験利用」という名称だけでリスクが小さくなるわけではないためです。
導入前には、エージェントの所有者、利用目的、接続先、許可する操作、権限の有効時間、監視担当、停止権限を明文化します。公開判定では、通常の品質評価に加えて、想定外の入力、権限外の操作、外部ツールの異常、ログ欠損などを試します。運用開始後は、モデル、データ、プロンプト、ツール、インフラの変更を記録し、どの変更が再テストを必要とするかを決めておくとよいでしょう。
経営層が確認すべきなのは、AIを何件導入したかだけではありません。高い権限を持つエージェントがいくつ存在し、誰が責任を負い、異常時にどの程度の時間で停止できるのかという運用能力も把握する必要があります。セキュリティ部門には、AI案件を一律に止める役割ではなく、安全に実装するための共通パターンを事業部門へ提供する役割が期待されます。
最初の一歩として、現在試験中または稼働中のAI機能を一つ選び、その処理を依頼者から最終的なシステム変更まで図にしてみてください。途中に登場するエージェントのID、委任された権限、参照データ、承認者、ログを記入すると、見えていない境界が明らかになります。その空白を埋める作業が、AIエージェントを業務へ安全に組み込むための具体的な出発点になります。