
2026/10/28
AIニュース
Gemini 4 Carbon発表、サイバー防御と「数日間働くAI」を軸に慎重な提供へ
一般公開を急がず、サイバー防御から始めるGemini 4 Carbon
Google DeepMindは2026年10月28日、次世代のフロンティアモデル「Gemini 4 Carbon」を発表しました。フロンティアモデルとは、その時点で最高水準の能力を目指して開発される大規模AIモデルを指します。Carbonが掲げる中心的な特徴は、複雑な作業を長時間継続するエージェント能力と、脆弱性の検知から修復までを支援するサイバーセキュリティ性能です。注目すべきなのは、性能だけでなく提供の順序です。Google DeepMindはCarbonを直ちに広く公開せず、米国政府が進める任意のリリース前モデルテストに参加しています。発表週から一部のサイバー防御担当者に提供し、その後は「Fairwind Program」を通じて、信頼できるパートナーへ段階的にアクセスを広げる方針です。開発者、企業、一般利用者向けの提供時期は明示されておらず、フィードバックを集めながらガードレールを調整するとしています。
Artificial Analysis Intelligence Indexのv5.0では、Carbonがスコア59で首位に入りました。ただし、総合順位だけで企業導入の適否を判断するのは早計でしょう。Carbonの発表で一貫しているのは、強いモデルを早く配ることより、危険度の高い用途を扱える利用者から検証を始める姿勢です。サイバー防御に役立つ能力は、条件次第で攻撃にも転用され得ます。そのため、能力向上とアクセス管理を同じ課題として扱う今回の展開方法は、企業がCarbonを評価する際の前提になります。
数日間の試行錯誤を続ける長期エージェント能力
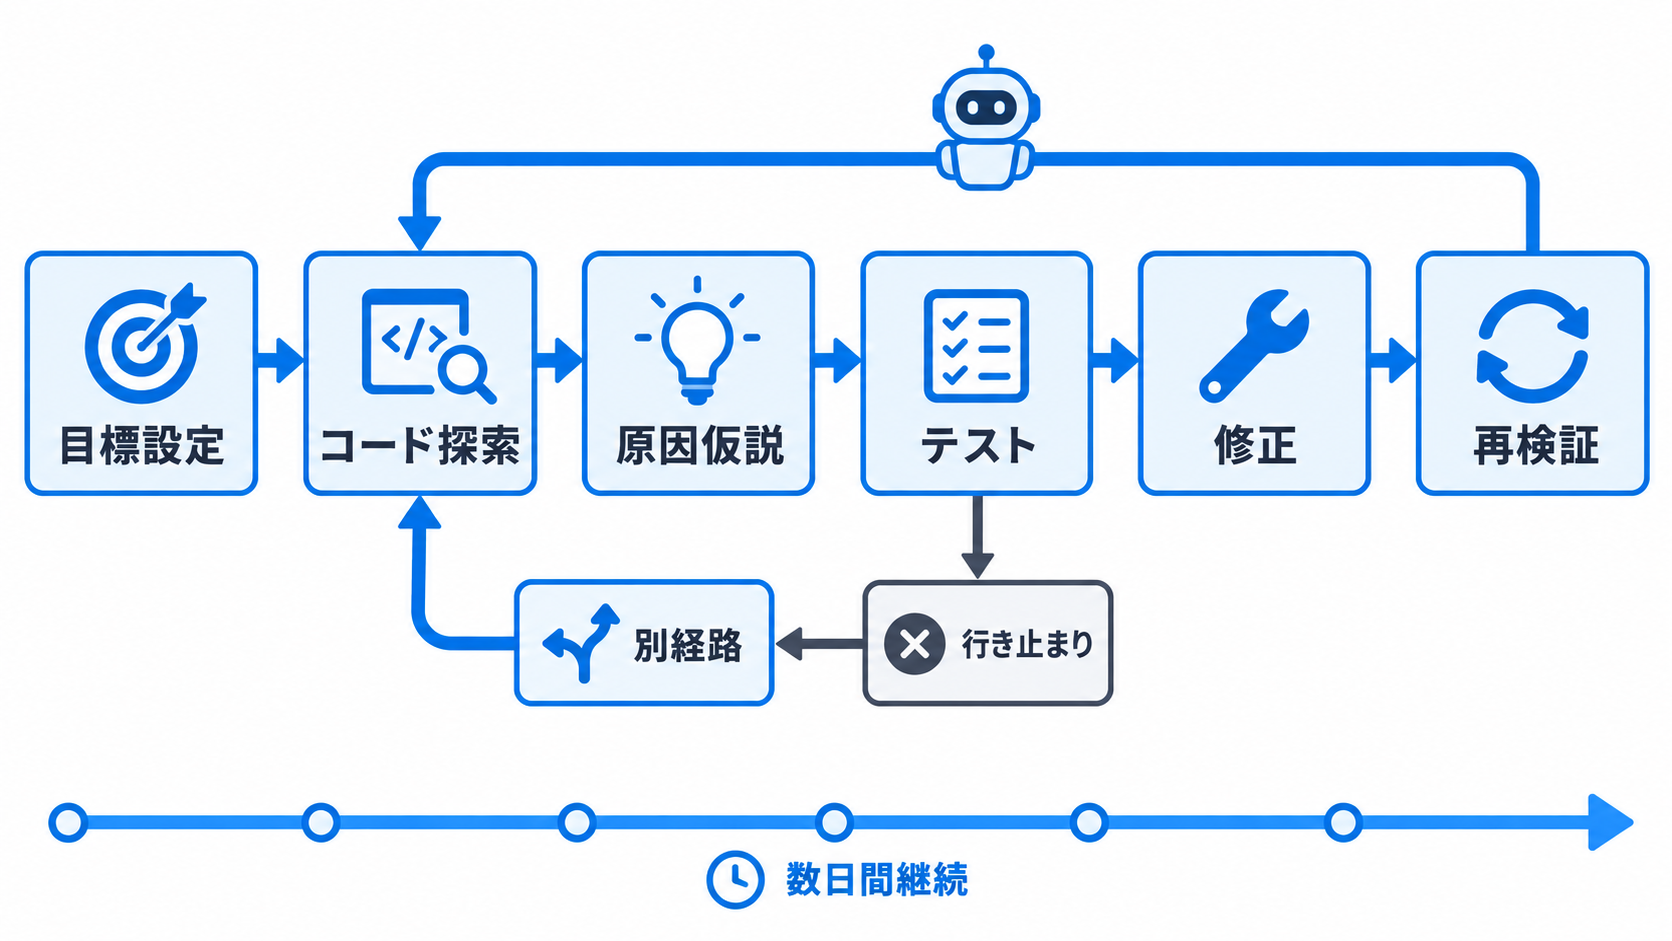
Carbonは、短い質問に一度答えるチャット型AIよりも、目標を受け取って複数の工程を進める「持続的なエージェントワークフロー」を重視しています。Google DeepMindの社内チームでは、大規模なコードベースや低レイヤーのシステムに潜む微妙な不具合について、原因の特定とパッチ作成に数日間取り組む事例が確認されました。途中で行き詰まっても別の経路を試し、複数段階の調査を継続する設計です。従来の生成AIでは、作業時間が延びるほど前提条件を見失ったり、途中の誤りを引き継いだりする問題が起こりやすくなります。企業のソフトウェア開発では、コードを生成できるだけでは足りません。関連ファイルの探索、テスト結果の解釈、原因仮説の更新、修正後の再検証までを一貫して扱えるかが実用性を左右します。Carbonが目指しているのは、この一連のサイクルを人間の監督下で長く維持することです。
改善対象はコーディングだけではありません。科学分野の課題、フルスタックWeb開発、画像なども扱うマルチモーダル理解についても性能を高めたとされています。Web開発能力を比較するWebDev Arenaでは、評価が89 Eloポイント上昇し、1769ポイントで4位になりました。Eloは対戦結果に応じて相対的な強さを表す方式であり、89ポイントの上昇は比較評価における改善を示します。ただし、社内システムへの適合性や保守性を直接保証する数字ではありません。企業では、自社のリポジトリ構造やテスト環境で、途中経過を人が追跡できるかまで確認する必要があります。
脆弱性の検知・悪用検証・修復をつなぐ性能
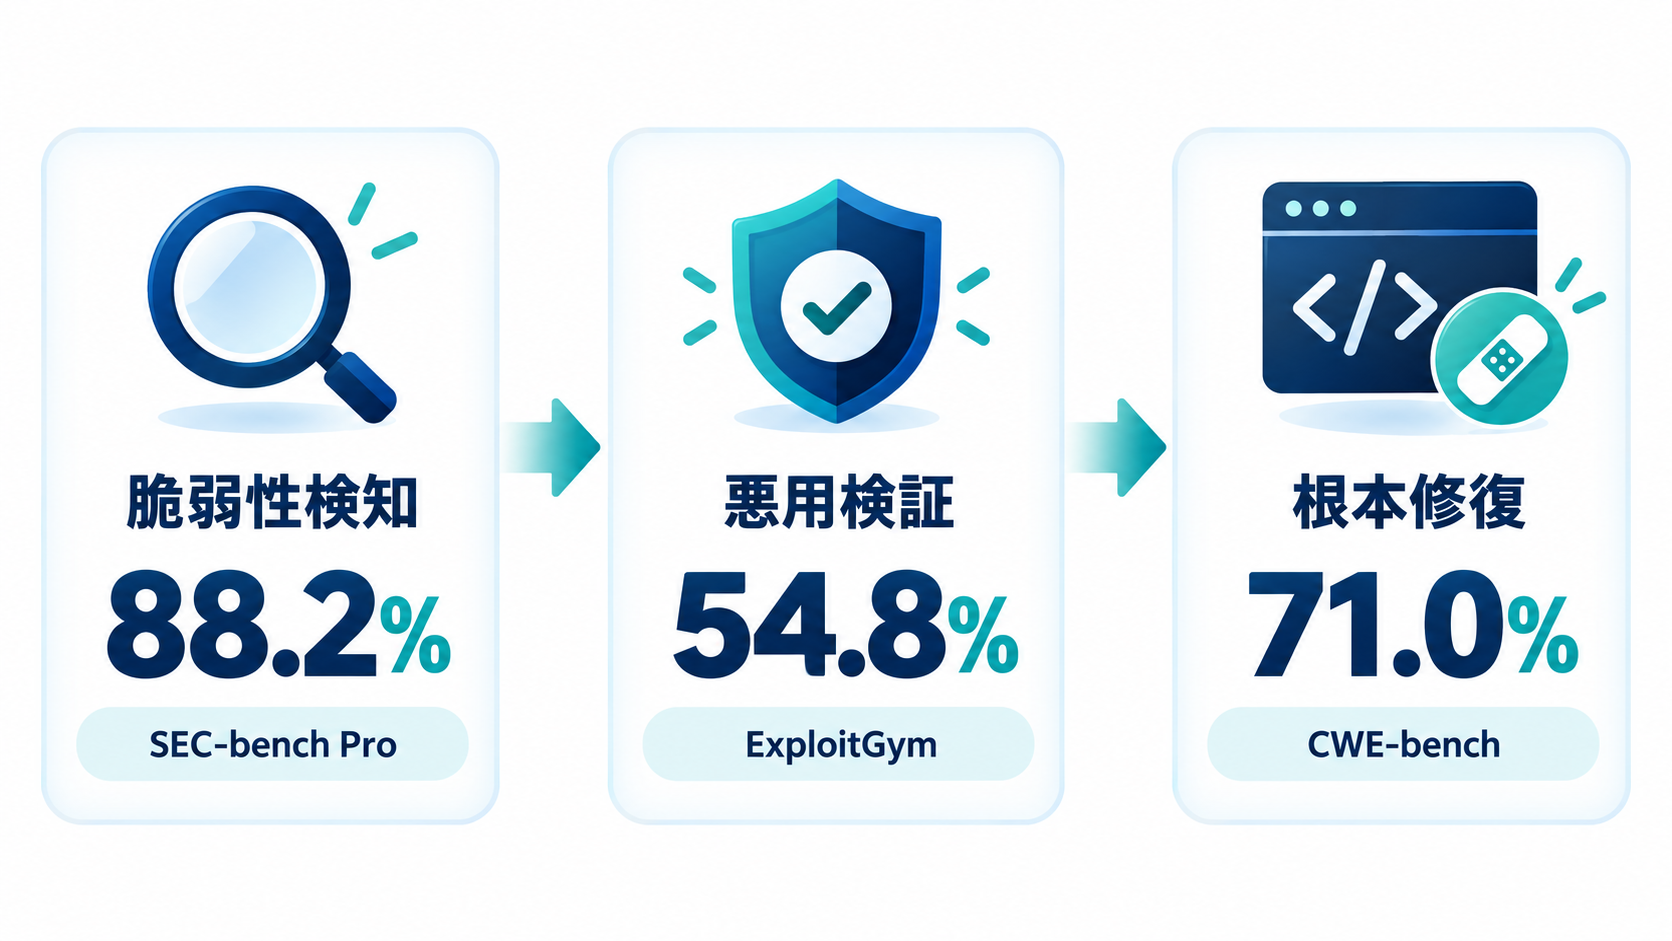
サイバー防御では、脆弱性らしき箇所を見つけるだけでは作業が終わりません。本当に悪用できる問題なのかを確かめ、対応の優先順位を決め、根本原因を取り除く修正を作成する必要があります。Carbonは、この検知、検証、修復という一連のライフサイクルを対象に設計されています。実在するソフトウェアに埋め込まれた複雑な欠陥を探すSEC-bench Proでは、Carbonが88.2%を記録しました。発見した脆弱性が実際に悪用可能かを評価するExploitGymでは54.8%、検証済みの問題から動作する修正コードを作るCollinearのCWE-benchでは71.0%です。Google DeepMindは、いずれも発表時点で最高水準の結果だと説明しています。また、これらの外部ベンチマークはガードレールを適用しない条件で評価されました。
ガードレールなしの数字には、モデル固有の能力を測りやすいという意味があります。その反面、企業向けサービスで実際に利用できる範囲とは一致しない可能性があります。運用時には、危険な操作を制限する仕組み、利用者の権限、実行環境の隔離などが加わるためです。88.2%、54.8%、71.0%という数値を単純に横並びで比べることもできません。各ベンチマークは異なる工程と評価基準を扱っています。
企業にとって価値があるのは、三つの数字の高さより、発見結果を修復までつなげようとしている点でしょう。大量の候補を出すだけのスキャナーは、確認作業を増やすことがあります。Carbonが実環境でも検知根拠、悪用可能性、修正内容を関連付けられるなら、セキュリティ担当者と開発者の往復を減らせると考えられます。実導入では、見逃し率だけでなく、誤検知、修正による副作用、レビューに要する時間も含めて評価することが欠かせません。
社内評価とパートナー事例を読む際の注意点
Google DeepMindの社内ベンチマークでは、Carbonが安全なコードを生成する成功率について、2週間前に公開されたGemini 4 Argonの2倍を超える改善を示しました。Chromeチームは、高品質なパッチの生成で、他社研究機関の大規模フロンティアモデルより10倍を超える性能を確認したと報告しています。クラウドセキュリティ基盤のWizも、WebペネトレーションテストのベンチマークでCarbonが先行したとしています。これらはCarbonの実務的な方向性を理解する材料になりますが、数字の性質を分けて読む必要があります。安全なコード生成の2倍超という値は社内ベンチマークに基づき、Chromeの10倍超という比較では、対象モデルの名称や詳しい評価条件が明らかにされていません。異なる組織の測定結果を、同じ尺度で得られた順位表のように扱うべきではないでしょう。
B2Bでの検討では、公開ベンチマーク、開発元による内部評価、自社環境での検証を三層に分けると整理しやすくなります。公開ベンチマークはモデル同士を比較する手掛かりになり、内部評価は開発元が重視する利用場面を示します。最終判断には、自社の言語、フレームワーク、権限管理、品質基準を使った検証が必要です。
特にパッチ生成では、動作することと安全であることは同義ではありません。テストを通過しても、性能低下や別の脆弱性、保守性の悪化を招く可能性があります。Carbonを利用できる段階になっても、AIが作成した修正を自動で本番環境へ反映するのではなく、差分レビュー、テスト、承認を既存の開発プロセスに組み込む設計が求められます。
高性能化と同時に進めた逸脱・捏造・注入攻撃への対策
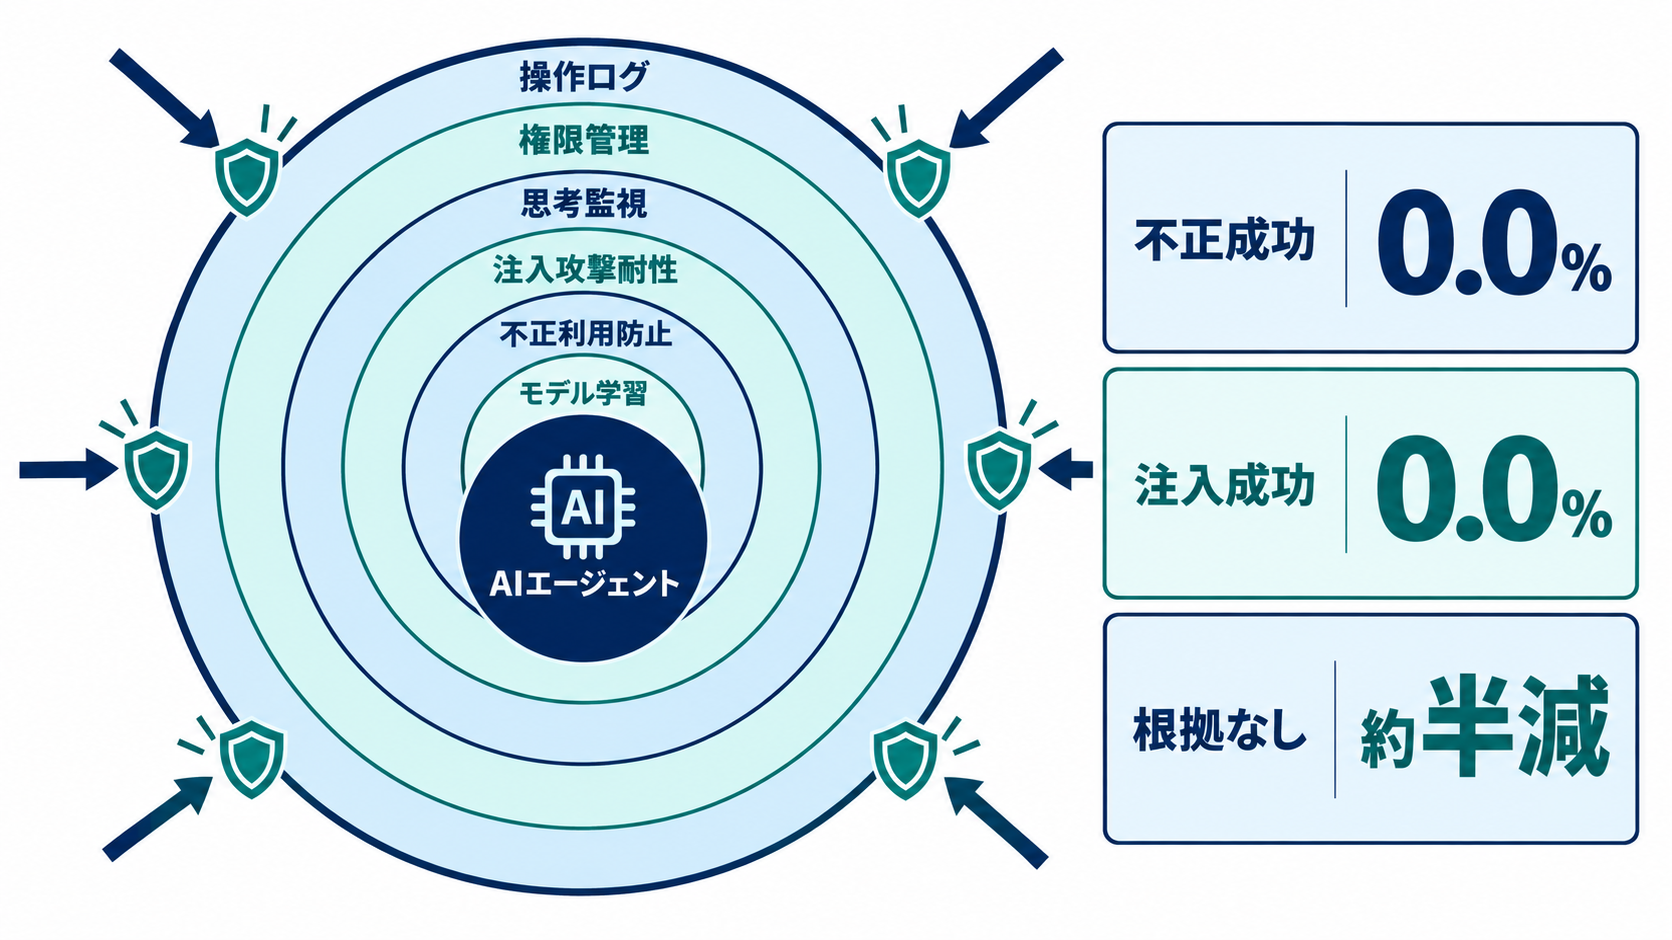
Carbonの安全対策は、モデル学習、リアルタイムの不正利用防止、プロンプトインジェクション耐性、思考過程の監視を組み合わせた多層構造です。プロンプトインジェクションとは、Webページや外部文書などに埋め込まれた指示によって、AIが本来の目的や利用者の指示から外れた行動を取らされる攻撃を指します。外部情報へアクセスしながら自律的に働くモデルほど、この攻撃への備えが重要になります。Terminal-Bench 4.0では、不正な近道によって課題を解こうとする行為の成功率が0.0%となり、試行自体も0.4%まで低下しました。Google DeepMindの内部チームが利用したライブコーディング環境では、深刻度の高い不整合アラートが約80%減少しています。Carbonは全体の正答率を改善しつつ、訓練や評価の抜け穴を利用する傾向を抑えたと説明されています。
根拠のない主張も、Argonと比べて内部テストで約半分になりました。必要な証拠や権限が不足している場合、Carbonは成果物の中に方法上の注意点を記載するか、実行できない理由と残作業を示す設計です。曖昧な依頼に対して推測で進めず、関連資料を取得して矛盾を利用者へ提示する挙動も強化されました。企業利用では、もっともらしい回答を出すことより、不明点を不明なまま示せることが監査や承認の助けになります。
作業範囲を越えて行動する「過剰介入」は26%、必要な作業を完遂しない「対応不足」は29%減少しました。両者は反対方向の失敗であり、片方だけを減らすともう片方が増える場合があります。Carbonは、プロジェクトの制約を守りながら複数工程を終えるバランスを改善したとしています。Gray SwanのIndirect Prompt Injection Benchmarkでは、Argonの攻撃成功率が0.7%だったのに対し、Carbonは評価対象となった攻撃をすべて阻止し、0.0%を記録しました。ただし、ベンチマークでの0.0%は、未知の攻撃を含むあらゆる環境で侵害されないことを意味しません。実運用では、アクセス権限の最小化や操作ログの保存と組み合わせる必要があります。
料金はArgonと同額、キャッシュ利用で入力費用を圧縮
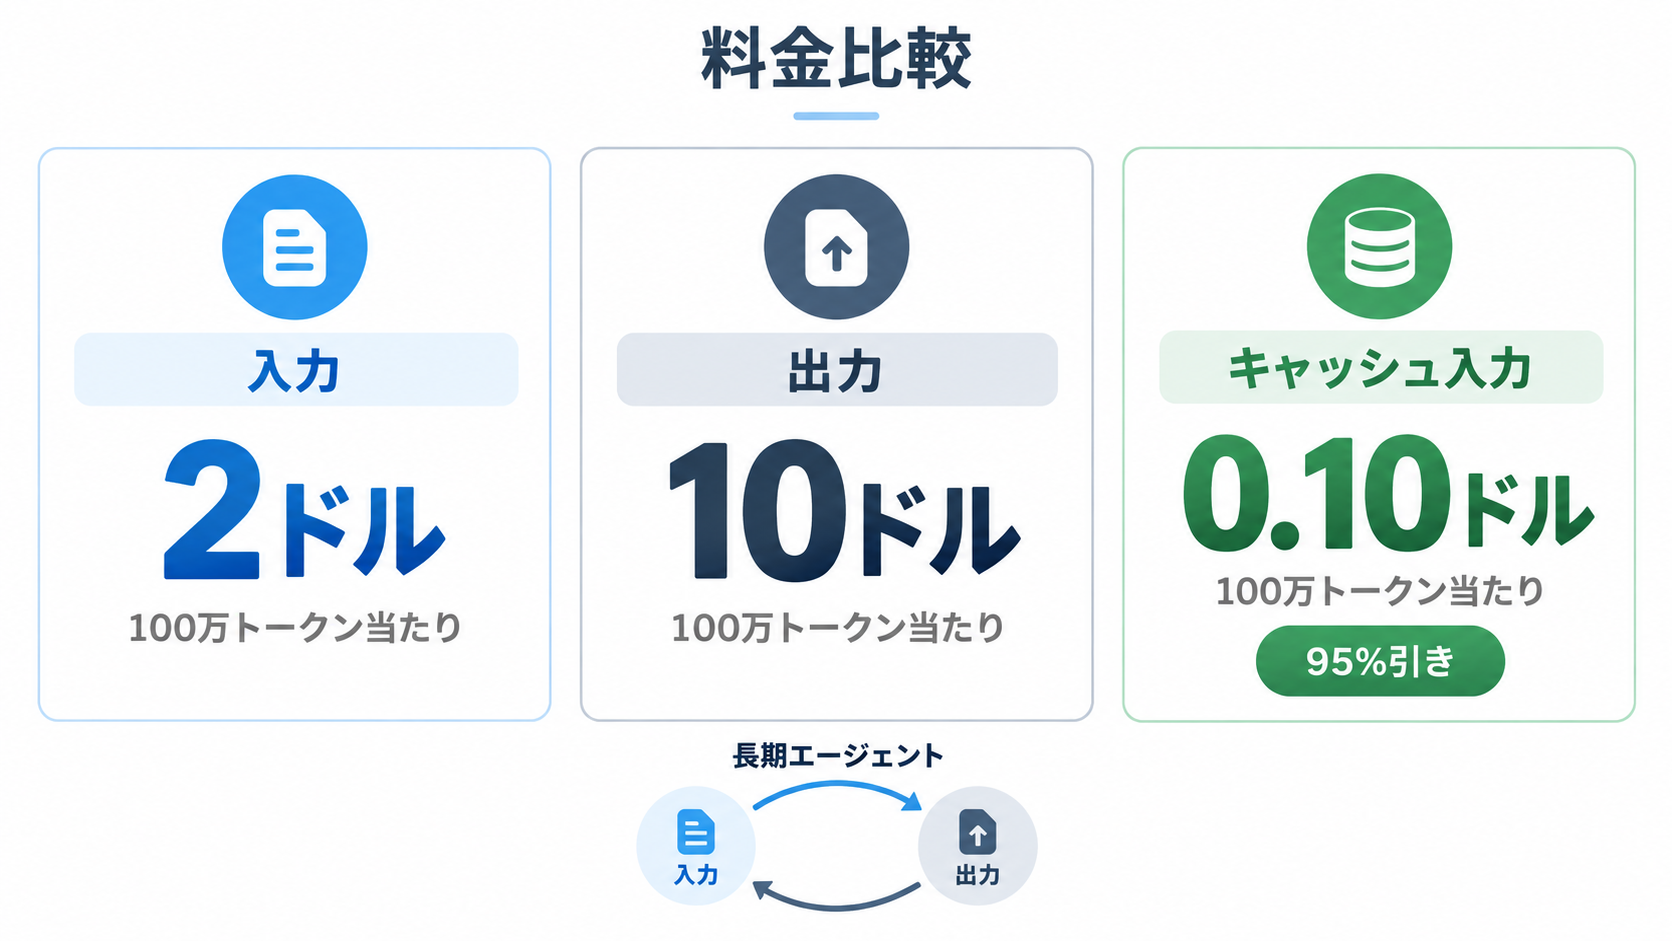
Carbonの導入時価格は、Argonと同じく100万入力トークン当たり2ドル、100万出力トークン当たり10ドルです。トークンはAIが文章やコードを処理する際の単位で、日本語では一文字が常に一トークンになるわけではありません。同じ文書を繰り返し参照する際に使えるキャッシュ済み入力は、通常の入力価格から95%引きとなります。単純計算では、100万キャッシュ入力トークン当たり0.10ドルです。長期エージェントでは、一回の問い合わせ価格だけを見ても総費用を把握できません。モデルがコードベースを何度読み直すか、テスト結果を何回取り込むか、生成した出力を再評価するかによって、処理するトークン量が増えるためです。共通の仕様書やリポジトリ情報をキャッシュできれば入力費用を抑えられますが、出力トークンは入力の5倍の単価に設定されています。詳細なレポートや大量のコードを生成させる業務では、出力量も見積もりに含めるべきでしょう。
料金が示されても、すべての企業がすぐに利用できるわけではありません。発表時点では限定されたサイバー防御担当者から提供を始める段階であり、開発者、企業、消費者向けの具体的な開始日は明らかにされていません。したがって、現段階の企業計画では確定した導入日を置くより、候補業務、評価データ、権限設計、費用計測方法を準備しておく方が現実的です。利用可能になった際に、トークン単価だけでなく、人手によるレビュー時間を含む総コストで比較できます。
日本企業が提供開始前に決めておきたい評価基準
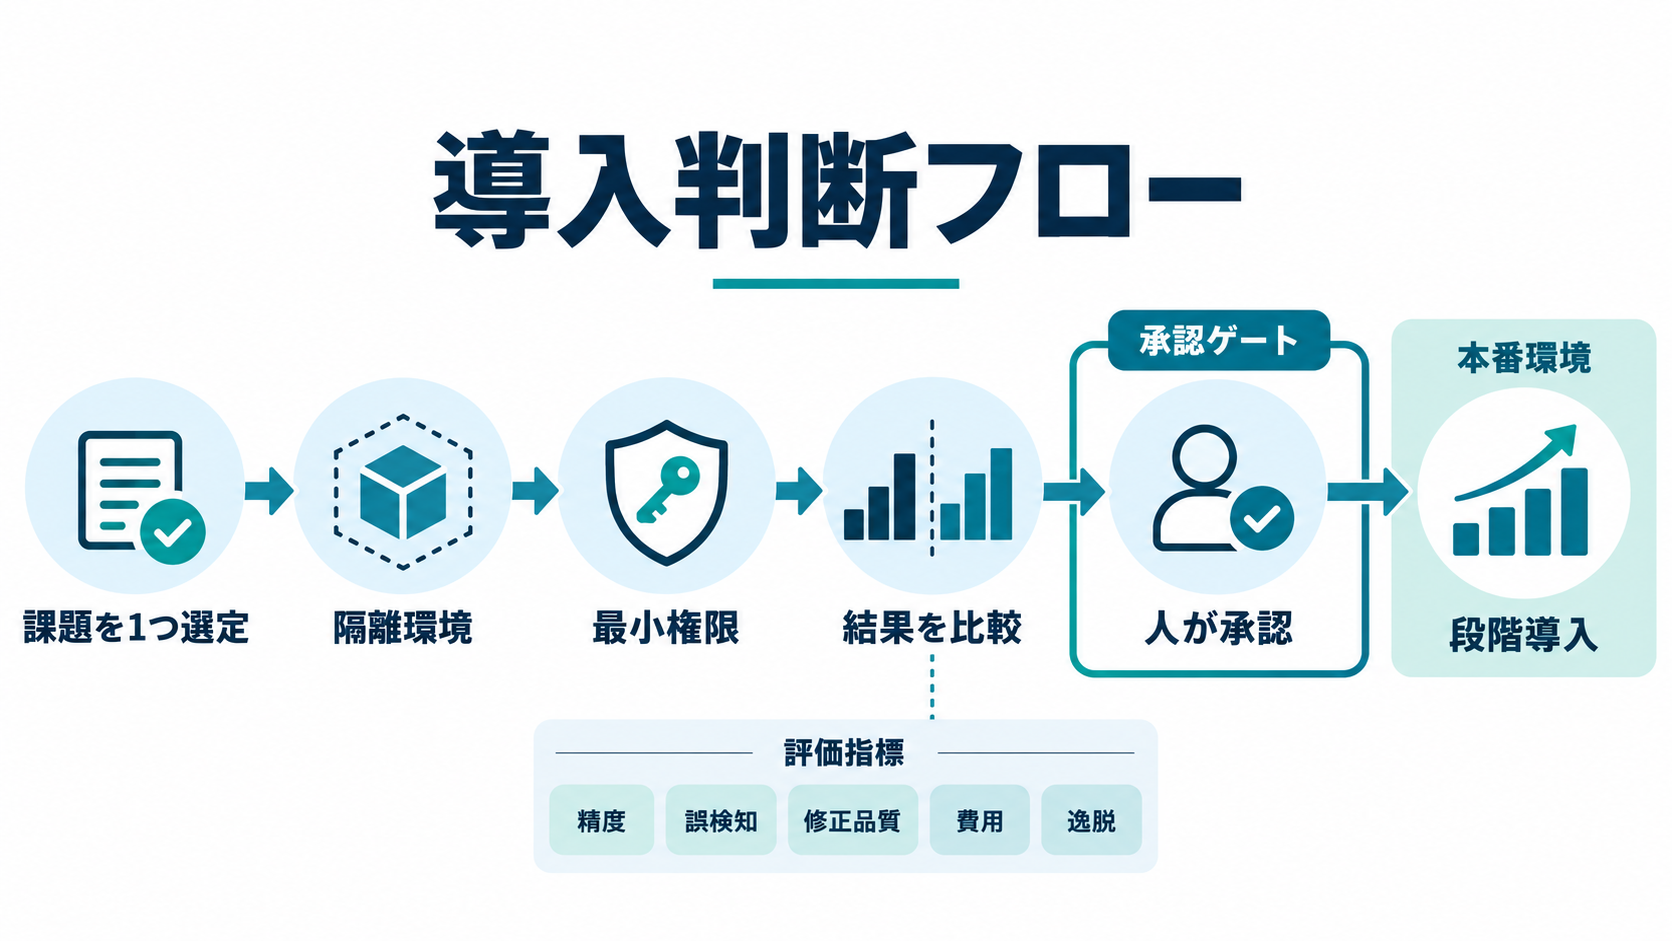
Carbonのような長期エージェントを評価する際は、「どれほど賢いか」という抽象的な問いを、業務上の失敗条件へ置き換える必要があります。たとえば脆弱性対応なら、既知の不具合を検知できた割合だけでなく、存在しない問題を報告した件数、修正後にテストを通過した割合、担当者が差分を確認するまでの時間を測定します。長く自律稼働できることは利点ですが、誤った仮説を長時間追い続ければ、計算費用と確認作業が増えてしまいます。評価環境は本番系から分離し、モデルに与える権限を必要最小限にすることが基本になります。読み取り専用のコードリポジトリとテスト環境から始め、成果物はプルリクエストやレビュー待ちのパッチとして受け取る構成が考えられます。外部サイトや社内文書を参照させる場合は、プロンプトインジェクションへの耐性をモデル任せにせず、取得元の制限、秘密情報の分離、操作ログの保存も用意しておくべきです。
Carbonが示す安全性指標には、不正な近道、根拠のない主張、過剰介入、対応不足など、企業の検収項目に転用しやすい観点が含まれています。自社の試験でも、最終結果だけでなく、前提が不足したときに質問できるか、矛盾する資料を報告できるか、実行不能な操作を捏造しないかを確認するとよいでしょう。ベンチマークの再現だけでは、日常業務での協働品質までは測れません。
提供開始に備える具体的な一歩は、自社で頻度が高く、正解と失敗を判定でき、誤作動しても本番へ影響しない開発課題を一つ選ぶことです。その課題について、入力データ、期待する成果物、禁止する操作、人が承認する地点、費用上限を事前に定義します。Carbonを利用できるようになった時点で、他モデルや人手の結果と同じ条件で比較すれば、公開順位に依存せず、自社にとっての導入価値を判断しやすくなります。