
2026/10/28
AIニュース
生成AIを実証止まりにしないClouderaの一手――NVIDIA製ブループリントと主権AIで本番運用を支援
Clouderaが狙う「データを動かさず、AIを届ける」企業基盤
生成AIの試験導入には成功しても、顧客情報や取引履歴を扱う本番環境へ移そうとすると、状況は一変します。機密データをどこで処理するのか、モデルの出力を誰が管理するのか、利用量の増加に伴う計算費用をどう抑えるのかといった問題が一度に表面化するためです。米国のデータ基盤企業Clouderaは、ニューヨークで開かれた自社イベント「Evolve26」で、こうした実証実験と本番運用の隔たりを埋める施策を発表しました。発表の中心にある考え方は、企業データを外部の集約型クラウドへ移すのではなく、データが保管されている場所へAI処理を持ち込むことです。Clouderaで製品マーケティング担当シニアディレクターを務めるウィム・ストープ氏は、AIをデータの存在する場所へ届ける方針を示しています。これはクラウドを否定するものではありません。パブリッククラウド、プライベートクラウド、オンプレミス、エッジ環境を選択肢として残し、データの性質や処理内容に合う場所を企業が決められるようにする構想です。
企業向けAIでは、モデルの性能だけを高めても十分ではありません。既存データとの接続、アクセス制御、処理履歴の追跡、運用監視、費用管理まで含めて初めて業務システムとして成立します。ClouderaはNVIDIA、Neo4j、Mistral AI、Vast Dataとの連携を広げ、再利用可能なアプリケーション、モデルの選択肢、データの関係性を理解する技術、複数環境にまたがるガバナンスを組み合わせようとしています。今回の発表で注目すべき点は、新しいAIモデルそのものよりも、企業が制御権を保ったままAIを稼働させるための部品を一つの運用基盤へまとめようとしていることです。
導入作業を短縮するCloudera Blueprintsの設計
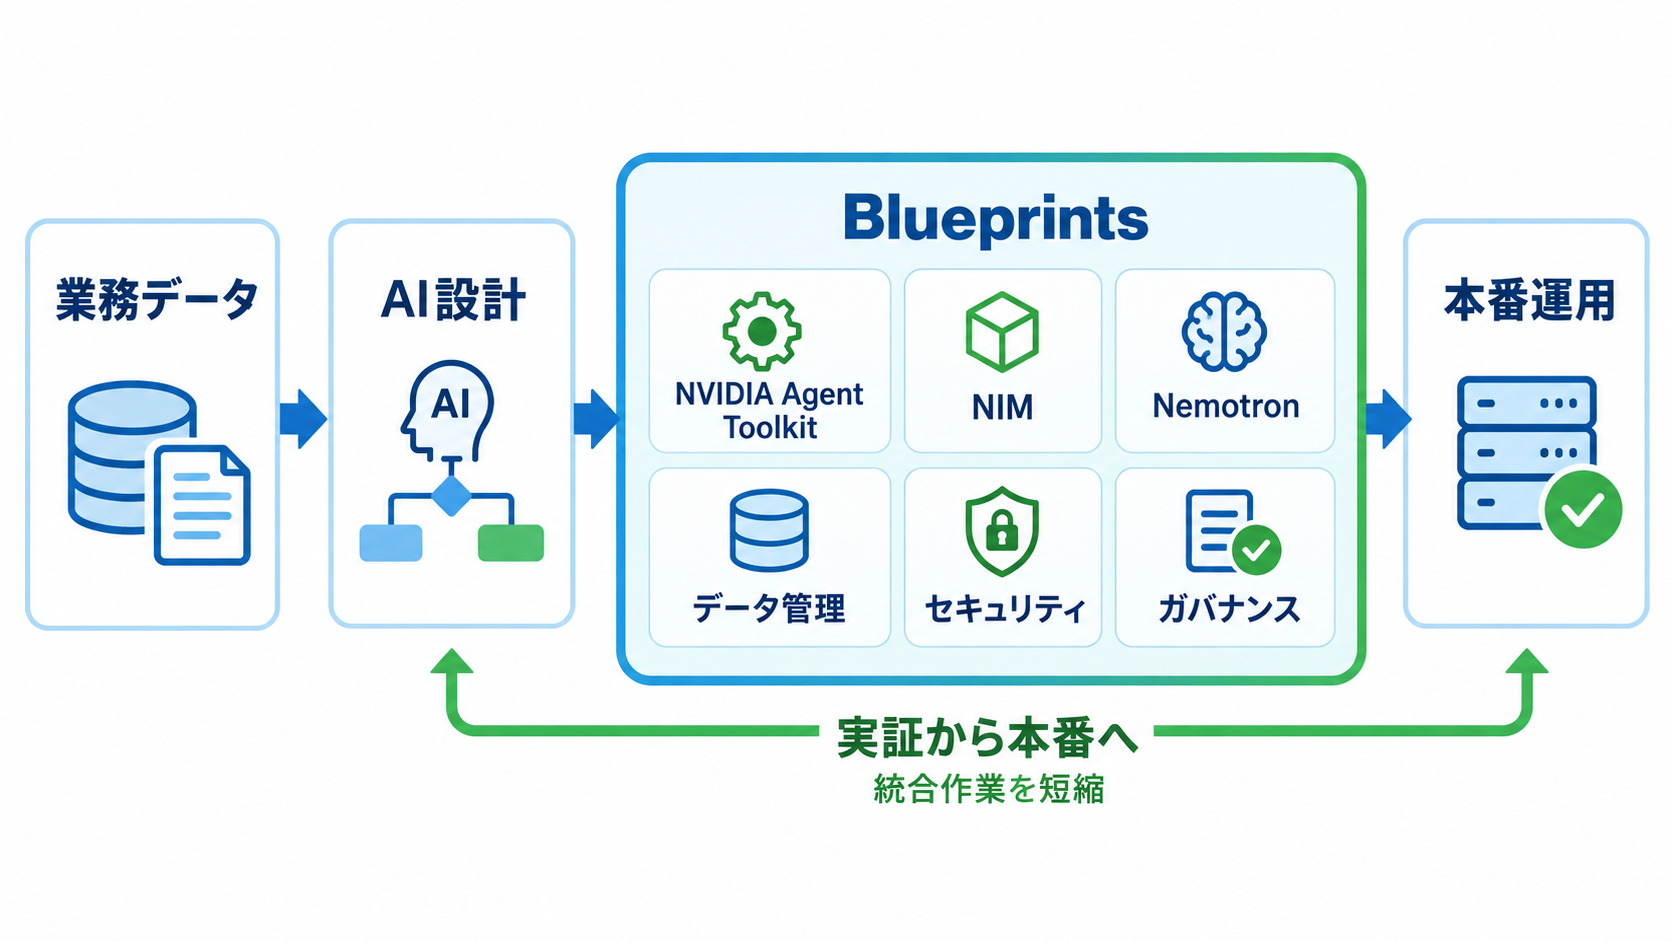
「Cloudera Blueprints」は、NVIDIAのAI向けリファレンスワークフローと、Clouderaが提供するデータ管理、セキュリティ、ガバナンス機能を組み合わせた導入用パッケージです。個別の技術を単に同梱するのではなく、一定の用途に沿って事前構成し、企業がAIアプリケーションを展開できる状態へ近づけています。実証環境で動くプログラムを作った後、認証方式やデータ接続、監視、計算資源の割り当てを一から設計し直す負担を減らす狙いがあります。ブループリントは「NVIDIA Agent Toolkit」を利用して構築され、ClouderaのAI開発プラットフォームを通じて展開されます。構成要素には、AI機能をサービスとして組み込みやすくするNVIDIA NIMマイクロサービス、NVIDIAのNemotronモデル、GPUで高速化されたデータ処理技術などが含まれます。企業側は完成品を無条件に受け入れるのではなく、管理対象のデータや既存ルールに合わせて構成を調整し、業務環境へ組み込むことになります。
パッケージ化の価値は、開発工程を完全に不要にすることではありません。検証済みの構成を出発点にできるため、担当者が接続方式や依存関係の確認だけに時間を費やす状況を減らせる点にあります。業務要件の整理、データ品質の確認、出力精度の評価、責任分界の設定は、引き続き導入企業が担わなければなりません。それでも、共通部分を再利用できれば、技術検証から運用設計へ人員を振り向けやすくなるでしょう。Clouderaが解こうとしているのはAI機能の不足ではなく、複数の製品を安全かつ継続的に動かすための統合作業の重さなのです。
4つの業務用途が示すブループリントの実践性
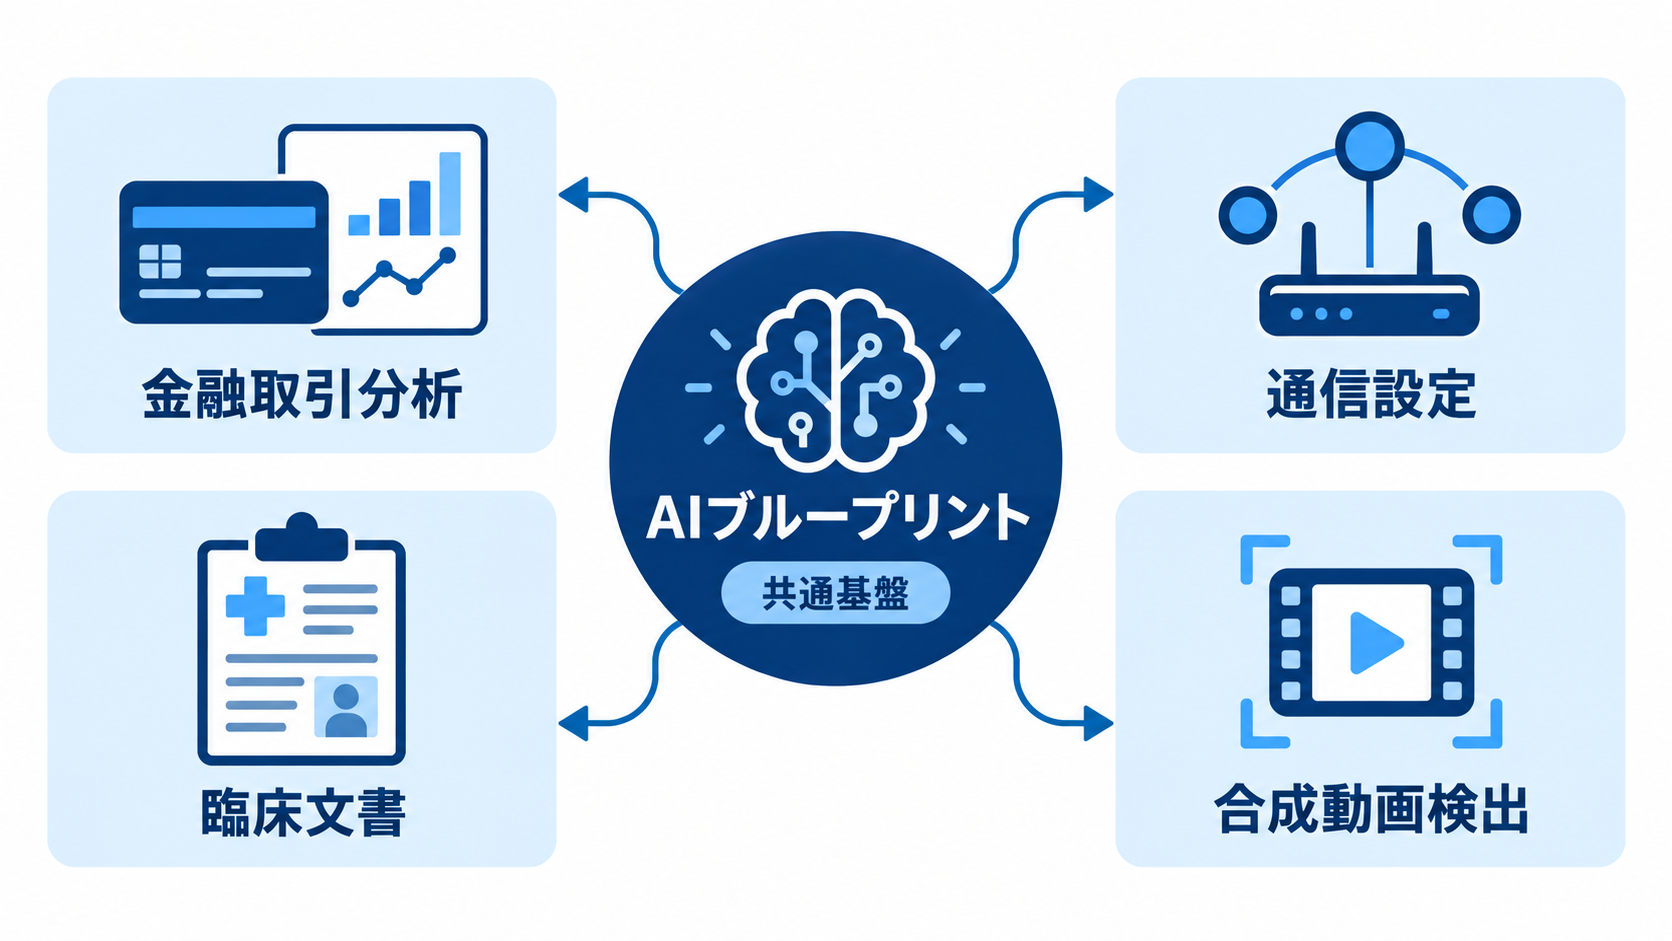
初期のCloudera Blueprintsには、金融取引分析、臨床文書の自動作成、通信ネットワーク設定、合成動画の検出という4種類のアプリケーションが含まれます。いずれも大量のデータ処理や専門的な判断補助が必要で、機密性や正確性にも配慮を要する分野です。単純な文章生成ではなく、既存の企業データや業務手順に接続して初めて効果を発揮する用途が選ばれています。金融取引分析では、取引データを処理し、確認対象を見つけるための仕組みが想定されます。臨床文書の自動作成は医療従事者の記録業務を支える用途ですが、患者情報を扱うため、アクセス権限や処理場所の管理が欠かせません。通信ネットワーク設定では、複雑な機器や構成情報を踏まえた支援が求められます。合成動画の検出は、生成AIによって作られた可能性のある映像を識別する用途であり、AIの普及によって生じた課題へAI技術で対応する例でもあります。
ただし、ブループリントが用意されていることと、各企業で期待どおりの成果が得られることは同義ではありません。金融機関ごとに取引形式は異なり、医療機関にも独自の記録手順があります。通信設備の構成や動画判定の基準も一様ではないため、データの対応付けや評価基準の設定が必要です。4つの用途は完成済みの業務サービスというより、本番システムを組み立てる際の土台として捉えるのが適切でしょう。企業にとっては、導入前に「どの工程までがパッケージに含まれ、どこからが自社固有の実装なのか」を確認することが、工数と費用を見積もるうえで重要になります。
Neo4jの知識グラフがAIエージェントに与える業務文脈
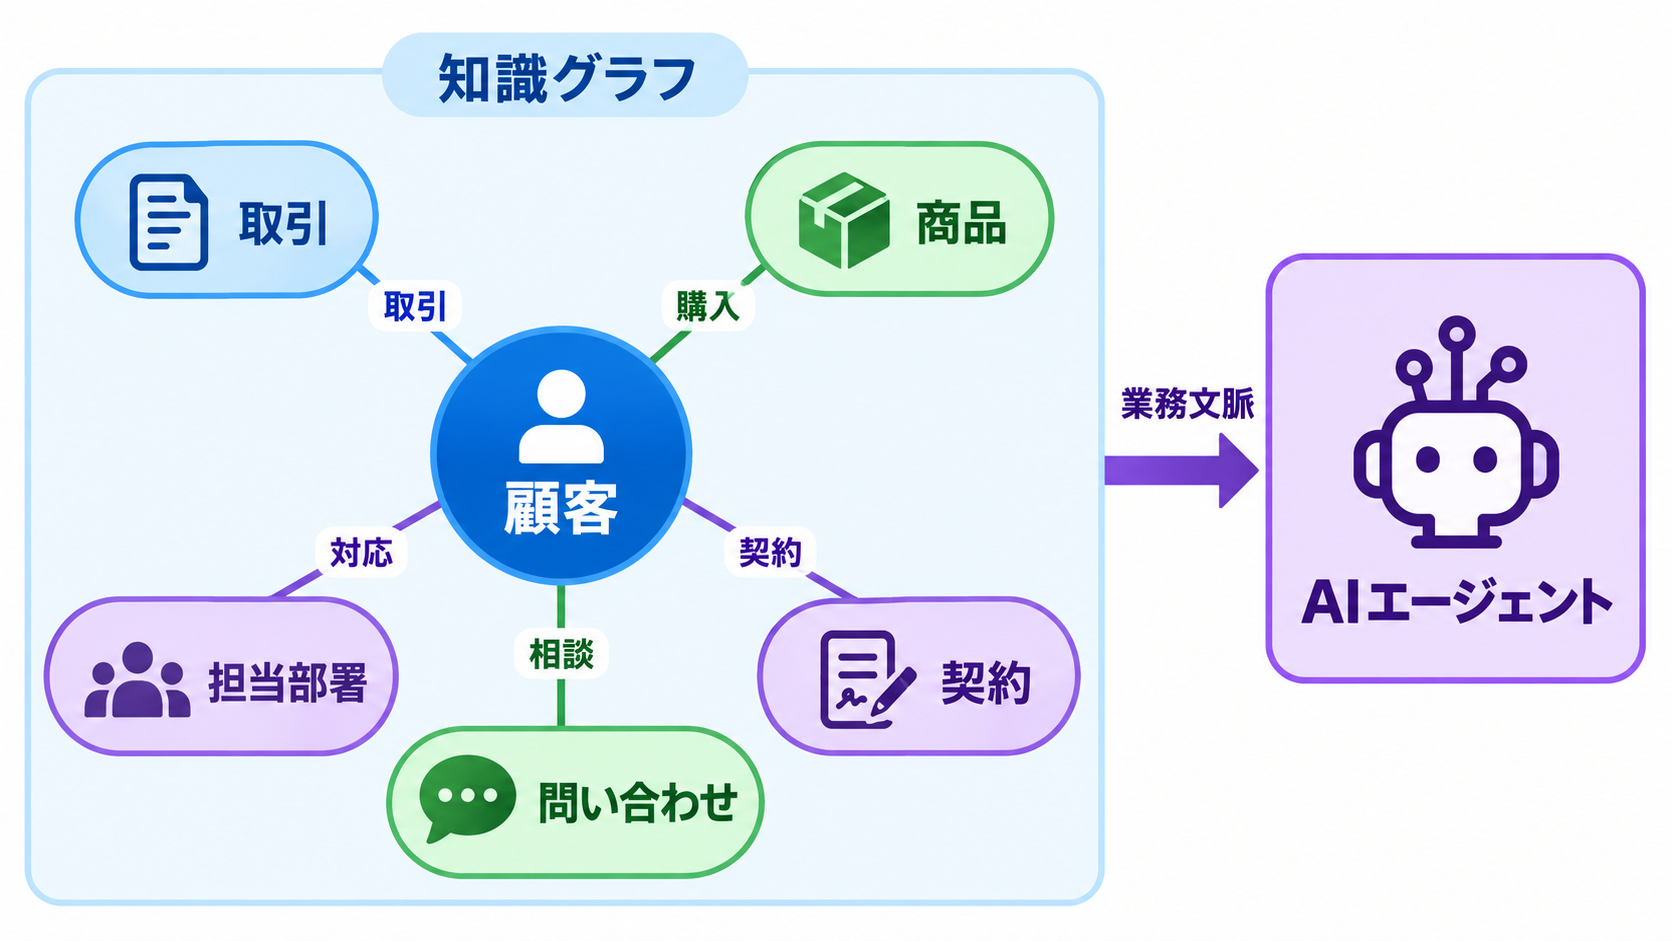
Clouderaは企業向けAIエコシステムを拡張し、グラフデータベースを手がけるNeo4jの技術を追加しました。グラフ技術は、顧客、取引、商品、契約、担当部署といったデータを個別の表として見るだけでなく、それらがどのようにつながっているかを表現するために使われます。AIエージェントが企業内の情報を調べ、判断を補助し、許可された処理を実行するには、この関係性の理解が欠かせません。たとえば、同姓同名の顧客レコードが存在する場合、氏名だけでは適切な情報を選べません。契約先、購入商品、問い合わせ履歴、取引時期などのつながりを参照できれば、AIはどの情報が質問の対象なのかを絞り込みやすくなります。Neo4jの知識グラフは、こうした関係へ意味上の文脈を与え、Clouderaが管理するデータ基盤と組み合わせることで、AIエージェントによる情報の関連付けや処理を支援します。
知識グラフを接続すれば、自動的に正しい推論が保証されるわけではありません。関係の定義が不正確だったり、古い情報が残っていたりすれば、AIが参照する文脈も誤ります。誰が関係を登録・更新するのか、どの情報をエージェントへ見せるのか、実行可能な操作をどこまで許可するのかという管理設計が必要です。Clouderaのガバナンス基盤とNeo4jの関係表現を組み合わせる意味は、AIに多くのデータを与えることではなく、管理された範囲で「何と何がどう結び付くのか」を参照させる点にあります。社内AIを検索から業務実行へ進めたい企業ほど、モデル選定と同じ水準でデータ関係の整備を検討する必要があるでしょう。
Mistral AIとの連携で具体化する主権AI
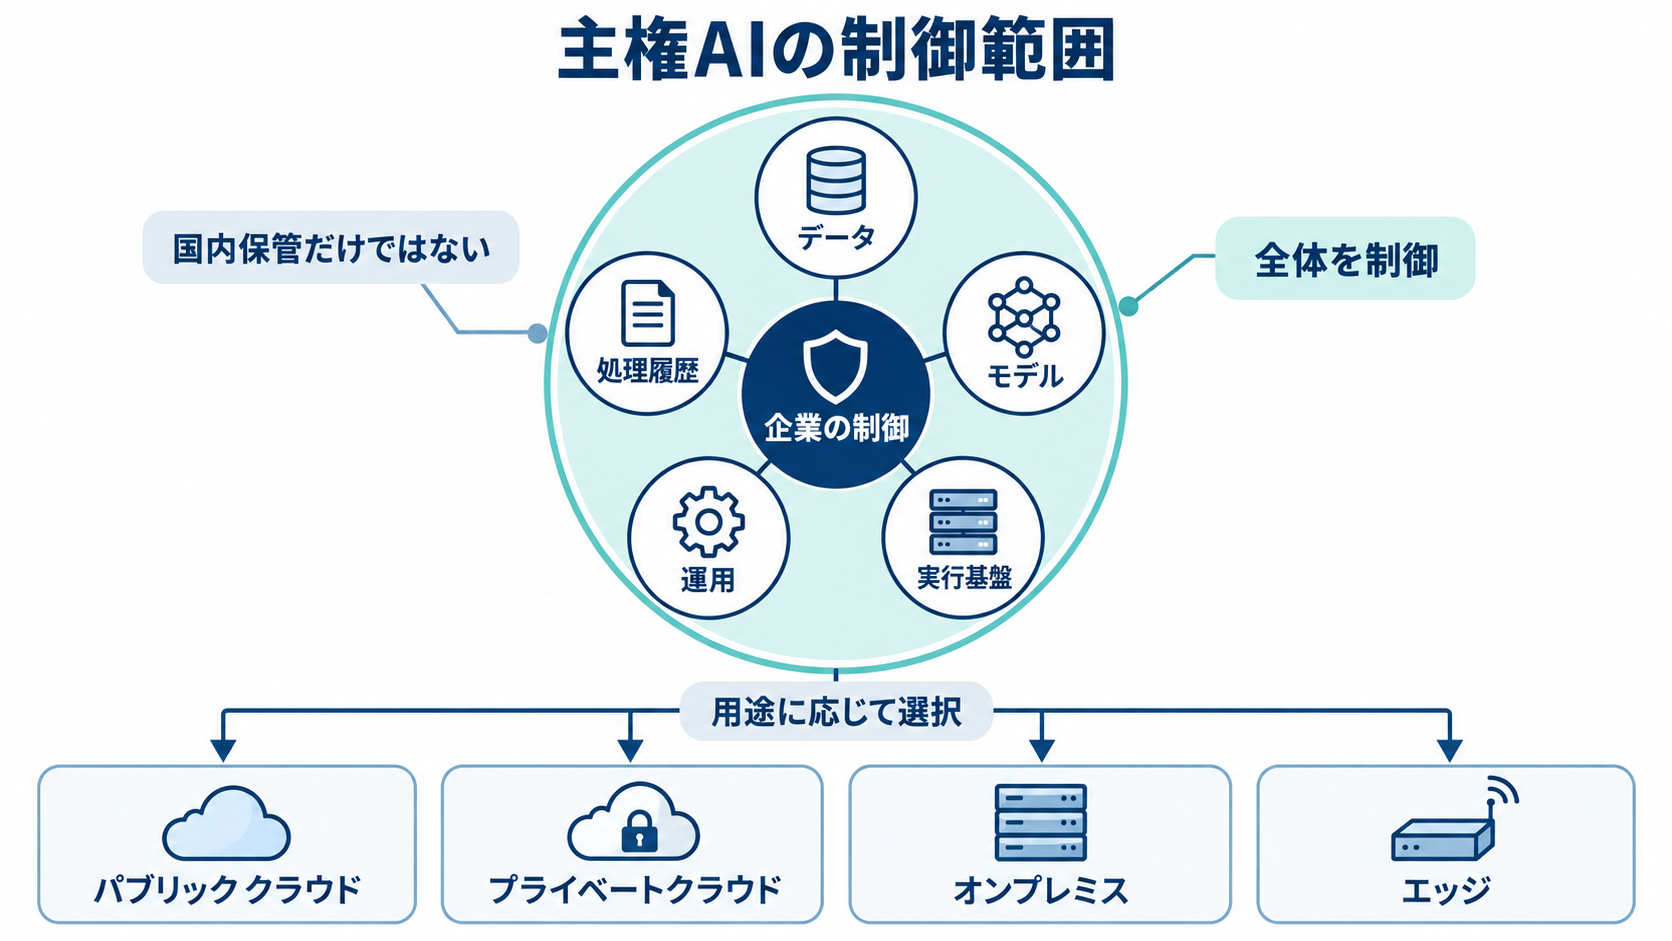
ClouderaはMistral AIおよびVast Dataとの協業も拡大し、利用できるAIモデルとインフラの選択肢を増やしました。なかでも、フランス発のAI企業Mistral AIとの関係は、Clouderaが掲げる「主権AI」の戦略で重視されています。企業がオープンウェイトのモデルを自社環境へ配置し、保有する情報に合わせて調整できれば、外部事業者が運用する独自モデルだけに依存せずに済むためです。主権AIは、データを国内に置くだけの考え方ではありません。ストープ氏は、モデルをどこで実行するか、データの生成元や加工履歴を追跡できるか、どのインフラを使うか、運用手順を誰が管理するかまで制御する必要があると説明しています。特に欧州では、データプライバシーへの要求、地政学上の懸念、規制対応を背景に、AI処理の場所と管理主体を確認する動きがあります。所在地だけを条件にすると、モデルの更新や外部接続、運用権限といった別の依存関係を見落としかねません。
Clouderaの構想では、パブリッククラウド、プライベートクラウド、オンプレミス、エッジの間で配置を選べます。すべての処理を閉じた環境へ集約するのではなく、機密性の高いデータを扱う処理は自社環境に置き、別の用途ではクラウドの拡張性を利用するといった判断が可能になります。日本企業が主権AIを検討する場合も、「国内か海外か」という二択だけでは足りません。データ、モデル、実行基盤、運用担当、外部サービスとの通信を分けて整理し、どの領域の制御権が必要なのかを業務ごとに定めることが現実的な出発点になります。
推論コストを左右する配置の柔軟性
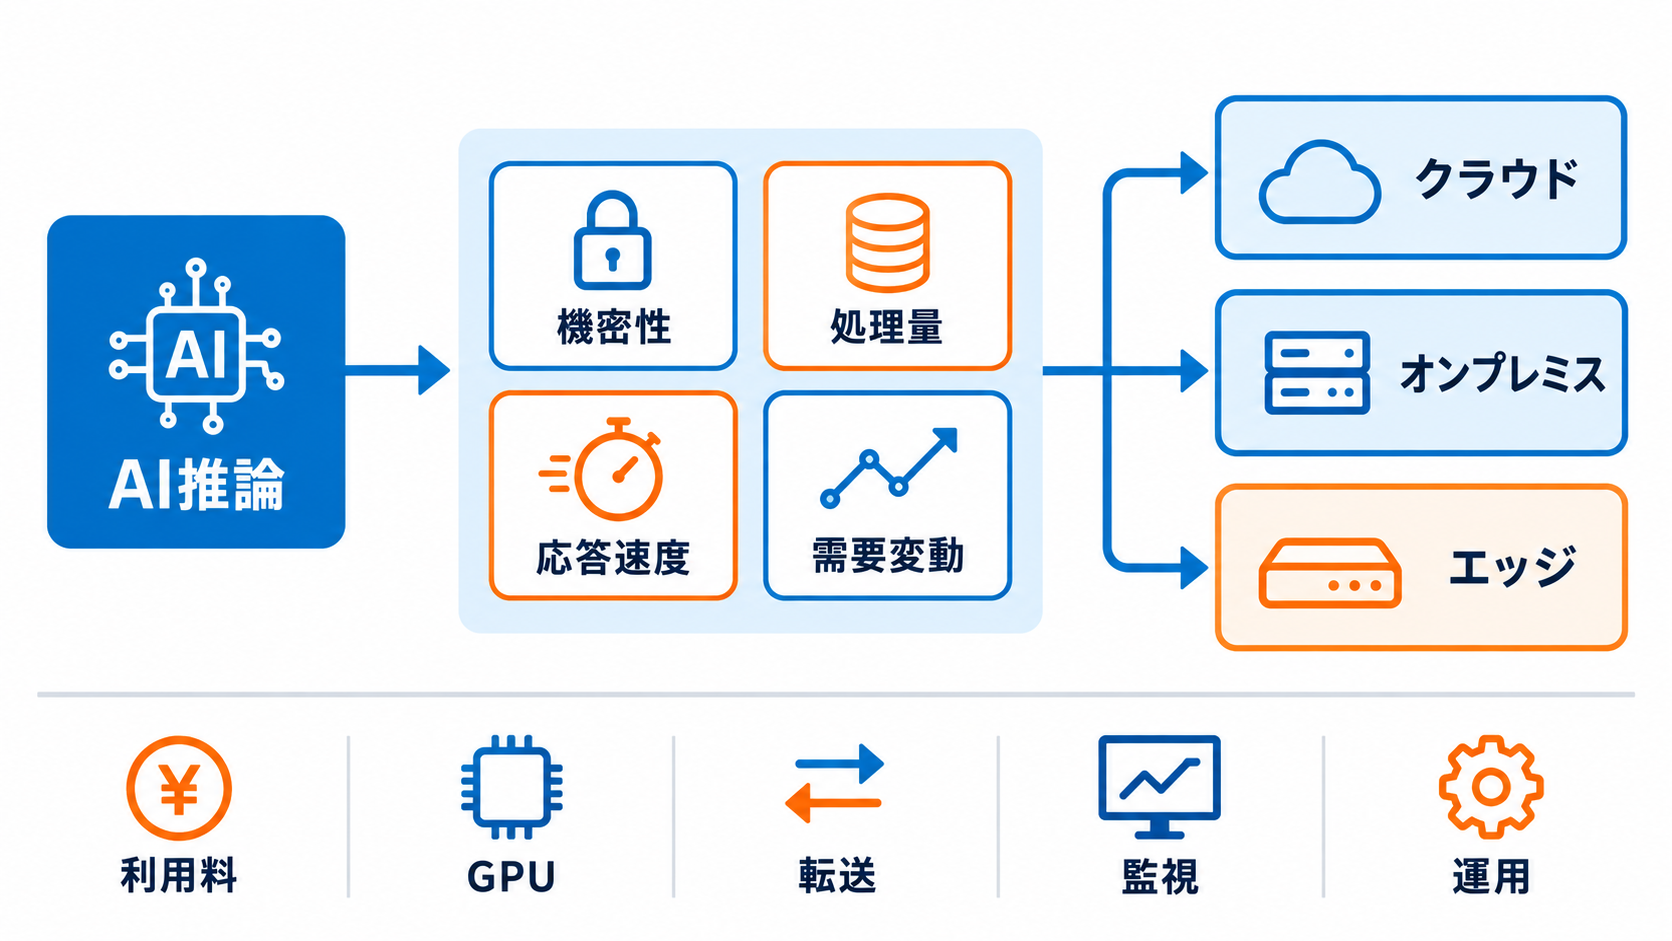
生成AIは試験利用の段階では処理件数が限られるため、費用を把握しやすい傾向があります。しかし、従業員や顧客が日常的に利用し始めると、モデルが回答を生成する「推論」の回数が増え、必要な計算資源も膨らみます。ストープ氏は、多くの企業にとっての大きな課題が、過大な費用を負わずに試験運用から本番稼働へ移ることだと指摘しています。AIの価値を理解していても、運用面と財務面の見通しが立たなければ展開範囲を広げられません。配置の柔軟性は、セキュリティだけでなく費用管理にも関係します。一定量の処理を継続する業務と、短期間に利用が急増する業務では、適したインフラが同じとは限りません。低遅延が必要な現場処理、機密情報を扱う社内処理、需要変動の大きいサービスなど、用途の条件を分けたうえで実行場所を選ぶ必要があります。Clouderaは、すべての処理を主権環境へ移すのではなく、仕事に適したインフラを企業が選択できることを目標にしています。
費用を比較する際は、モデル利用料やGPUの価格だけに注目すると判断を誤る可能性があります。データ転送、保管、監視、障害対応、セキュリティ運用、専門人材の確保まで含めて評価しなければなりません。パッケージ化された構成は統合作業を減らす助けになりますが、実際の処理量や応答時間に基づく試算は企業ごとに必要です。本番移行前には、利用者数ではなく処理件数やデータ量を基準に負荷を測り、通常時と繁忙時の双方で費用を確認するべきでしょう。配置を変更できる基盤は、それ自体がコストを下げるのではなく、条件の変化に応じて構成を見直せる余地を企業へ残します。
日本企業が本番導入前に確認したい設計項目
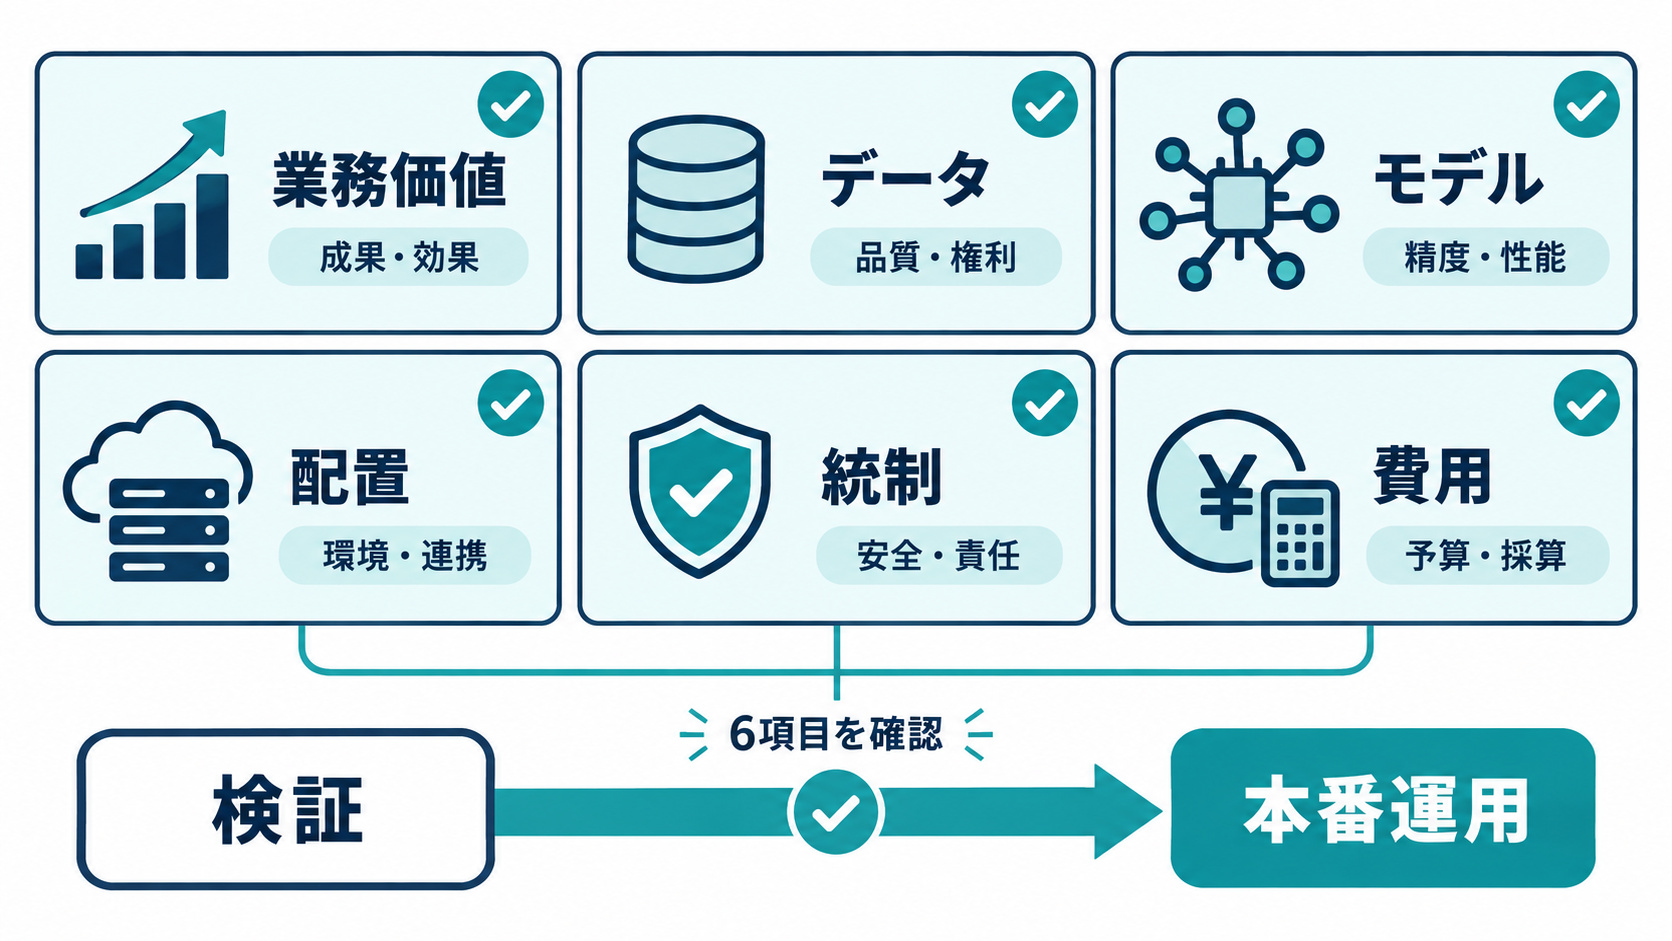
Clouderaの発表から読み取れるのは、企業向け生成AIの競争軸がモデル性能だけではなくなっていることです。再利用できるアプリケーション、データの関係性を扱う技術、選択可能なモデル、複数環境を横断するガバナンスが、本番運用の成否を左右します。日本企業が同様の基盤を評価する際も、デモで回答精度を確かめるだけでは、運用開始後のリスクと費用を判断できません。確認項目は、業務価値、データ、モデル、配置、統制、費用の六つに整理できます。対象業務では、AIが提案まで行うのか、承認後に処理を実行するのかを定めます。データについては、参照範囲、品質、更新頻度、機密区分を確認します。モデルは精度だけでなく、自社環境への配置可否や変更時の影響も評価対象です。配置設計ではクラウド、オンプレミス、エッジを用途別に比較し、統制面ではアクセス権限、処理記録、人による承認、停止手順を用意します。費用は小規模な検証値をそのまま使わず、利用拡大後の推論量を想定して試算する必要があります。
ブループリントを採用する場合は、これらの項目のうち、製品側が担保する範囲と自社で設計する範囲を契約・技術の両面から切り分けるべきです。特に、モデルや連携製品が更新された際の検証責任、障害発生時の担当、データ処理の追跡方法は、本番移行前に明確にしておく必要があります。最初の一歩として、候補となる業務を一つ選び、データの保管場所からAIの出力を利用する担当者までの流れを書き出すとよいでしょう。その流れに配置、権限、費用、承認の情報を重ねれば、自社に必要な基盤と、パッケージへ期待できる範囲を具体的に判断しやすくなります。