
2026/11/02
今更聞けないAI知識
深層学習の「深い」は何の深さ? 写真のフィルターでわかる多層構造
「深い」の正体は、考えの深さではなく処理の段数
スマートフォンが写真の中から犬や猫らしきものを見分ける場面を想像してみてください。その仕組みを調べて「深層学習が使われています」と説明されても、何が深いのかは名前だけでは分かりません。知識が深いのでしょうか。それとも、人間のように深く考えているという意味なのでしょうか。
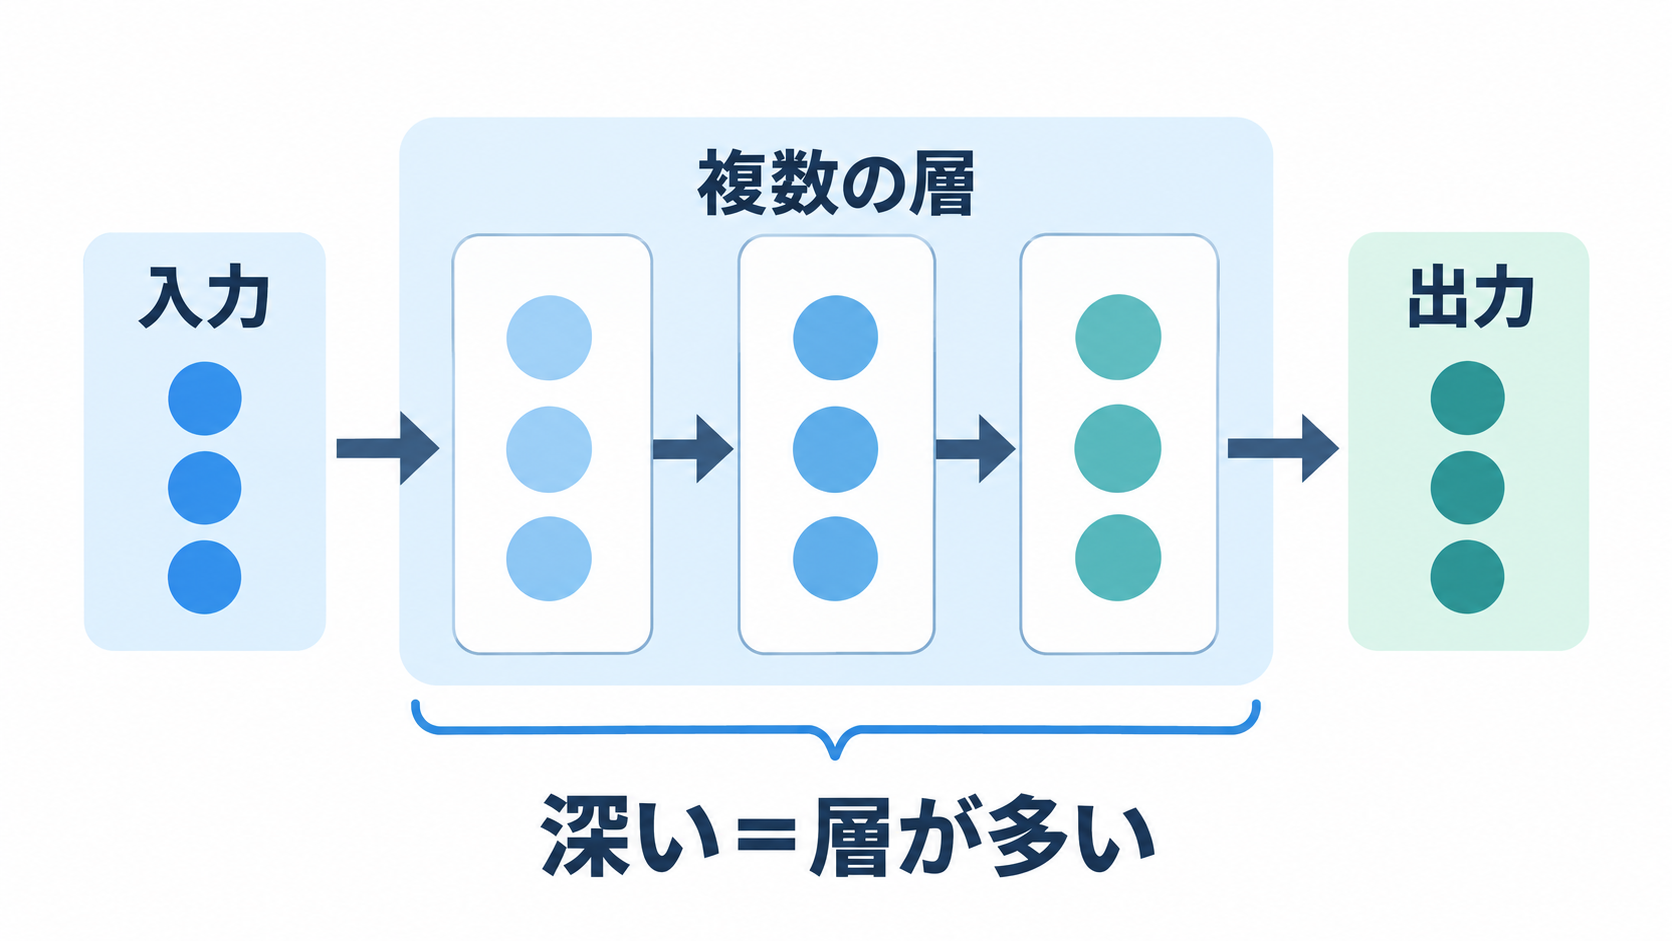
一言で答えるなら、深層学習とは「情報を処理する層を何段も重ねたニューラルネットワークを使う機械学習」です。ここでいう深さは、理解力や意識の深さではなく、入力された情報が出力に至るまでに通る処理の層が多いことを指します。IBMは、深層学習を多層のニューラルネットワークを使う機械学習の一種として説明しています(出典: IBM)。
ニューラルネットワークは、情報を受け取る入力層、途中の処理を担う隠れ層、結果を出す出力層で捉えられます。IBMの解説では、深いニューラルネットワークには少なくとも3層、通常は数百の隠れ層が含まれるとされています(出典: IBM)。ただし、この数字はすべての製品が同じ構造を持つという意味ではありません。「途中の処理が一段だけではなく、何段も連なっている」という関係を理解するための説明です。
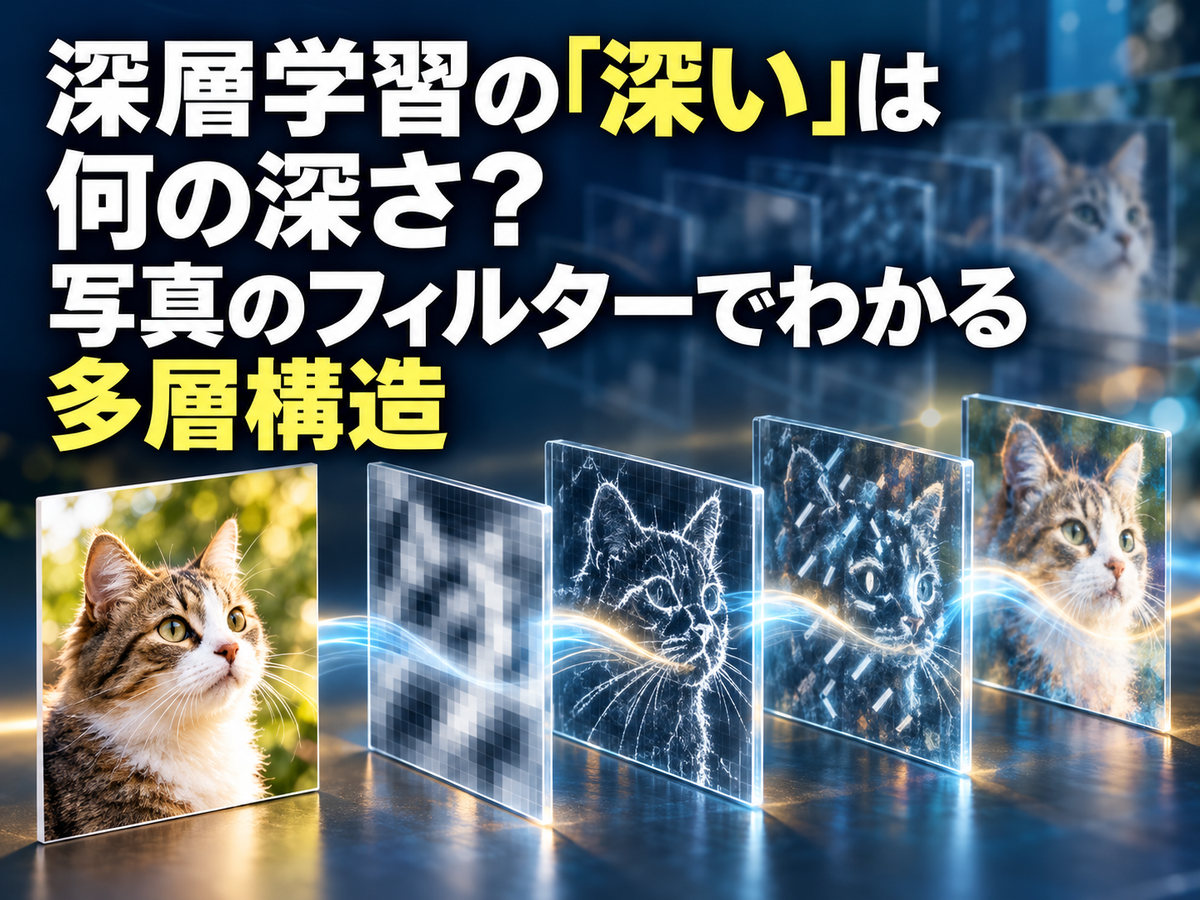
身近なたとえなら、写真を複数のフィルターに順番に通す作業が近いでしょう。最初のフィルターが明暗や輪郭らしき手掛かりを拾い、後のフィルターが前段の結果を受け取って、よりまとまりのある特徴を扱うというイメージです。これは理解のために単純化したたとえであり、実際の各層が必ず「輪郭担当」「耳担当」のように明確な名前を持つわけではありません。それでも、「深いとは処理の段数が多いこと」と押さえれば、用語から必要以上に難しいものを想像せずに済むでしょう。
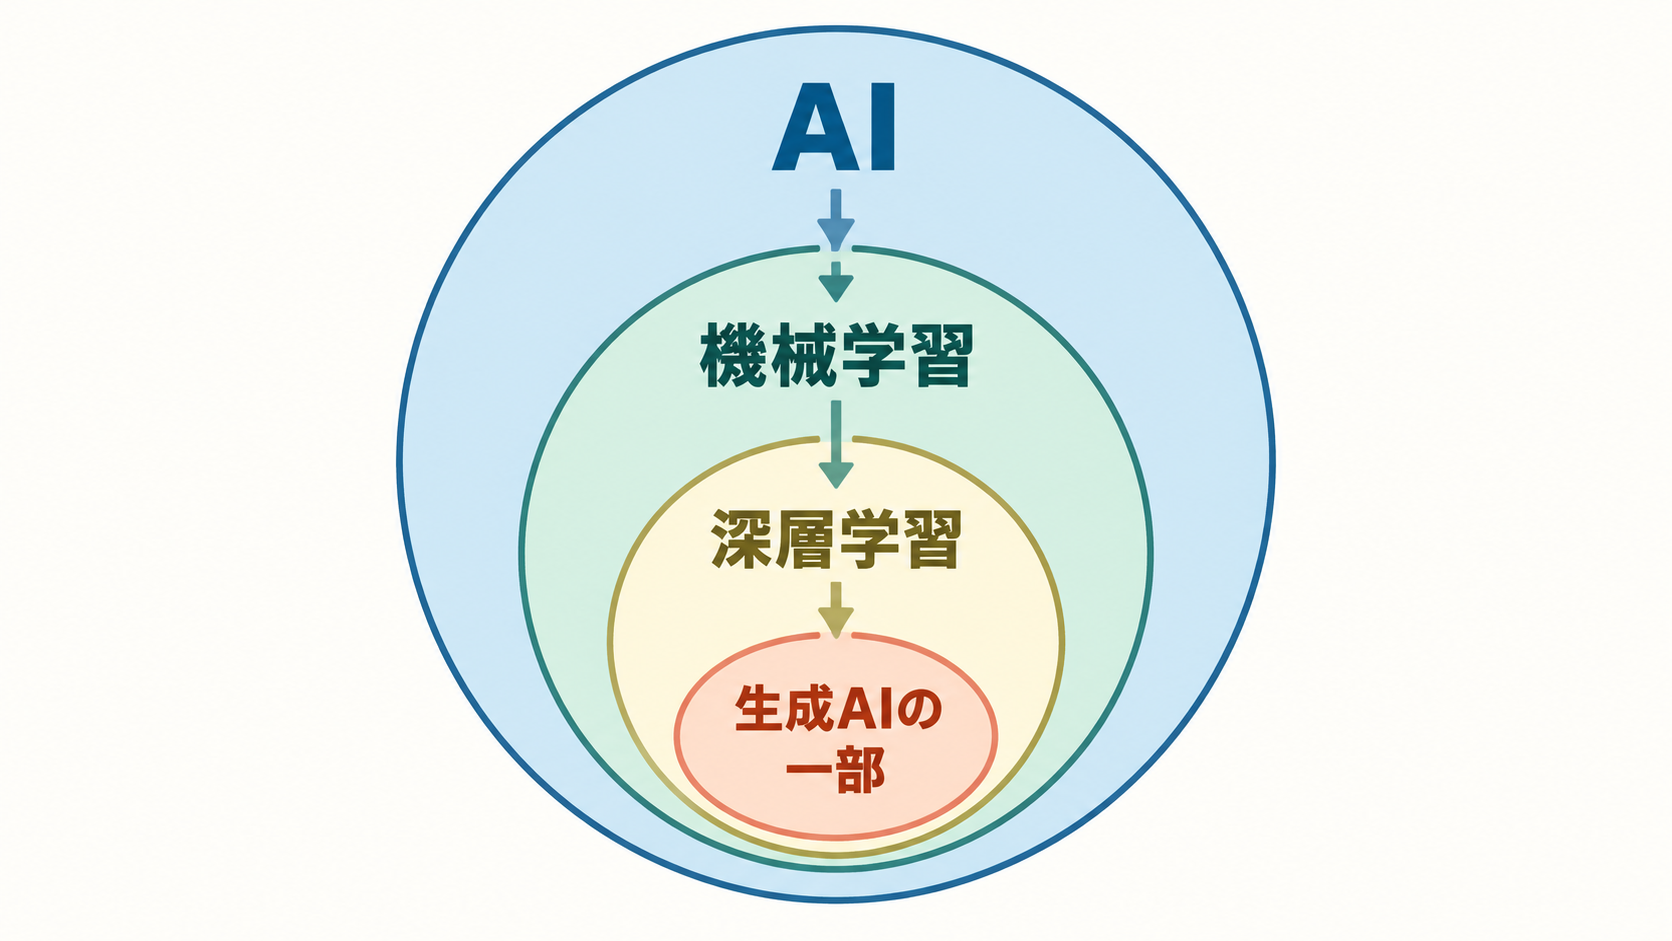
AI・機械学習・深層学習を入れ子で捉える位置関係
深層学習を単独の製品名として覚えると、AIや機械学習との違いが曖昧になりがちです。関係は、別々の技術を横一列に並べるより、大きな箱の中に小さな箱が入っている形で考えると整理できます。最も広い箱がAI、その内側に機械学習があり、機械学習の中に深層学習があります。
| 用語 | 短い意味 | この関係での位置 |
| --- | --- | --- |
| AI | コンピューターや機械に学習・認識・問題解決などを行わせる広い技術分野 | 最も広い枠 |
| 機械学習 | データから規則や関係を学び、予測や判断に使う方法 | AIの一部 |
| 深層学習 | 多層ニューラルネットワークを使う機械学習 | 機械学習の一部 |
| 生成AI | 指示に応じて文章や画像などを作る深層学習モデル | 深層学習を使う領域 |
IBMは、AIを人間の学習、理解、問題解決、意思決定などをコンピューターや機械で模倣できるようにする技術と説明しています。その下に、データを使って予測や判断のためのモデルを作る機械学習が位置し、深層学習は多層ニューラルネットワークを使う機械学習の一部です(出典: IBM)。Google Cloudも、AIを広い概念、機械学習をデータから知識を取り出して学ぶAIの応用として区別しています(出典: Google Cloud)。
生成AIは、この並びの外にある万能な別技術ではありません。IBMの資料では、利用者のプロンプト、つまり入力する指示や依頼に応じて文章、画像、映像、音声などを作る深層学習モデルとされています(出典: IBM)。ただし、深層学習の用途がすべて生成AIというわけでもありません。文章を作る用途のほか、画像内の複雑なパターンを見分ける用途や、言語を処理する用途にも使われます。
この入れ子を知っておくと、「AIを使っています」という説明を見たときに、それだけで深層学習や生成AIだとは決めつけなくなります。AIは広い看板であり、その中でデータから学ぶ方法が機械学習、その一方式が深層学習です。サービスを見分ける際は、看板の言葉よりも、何を入力し、どんな方法で結果を出す仕組みなのかを見るほうが理解しやすいでしょう。
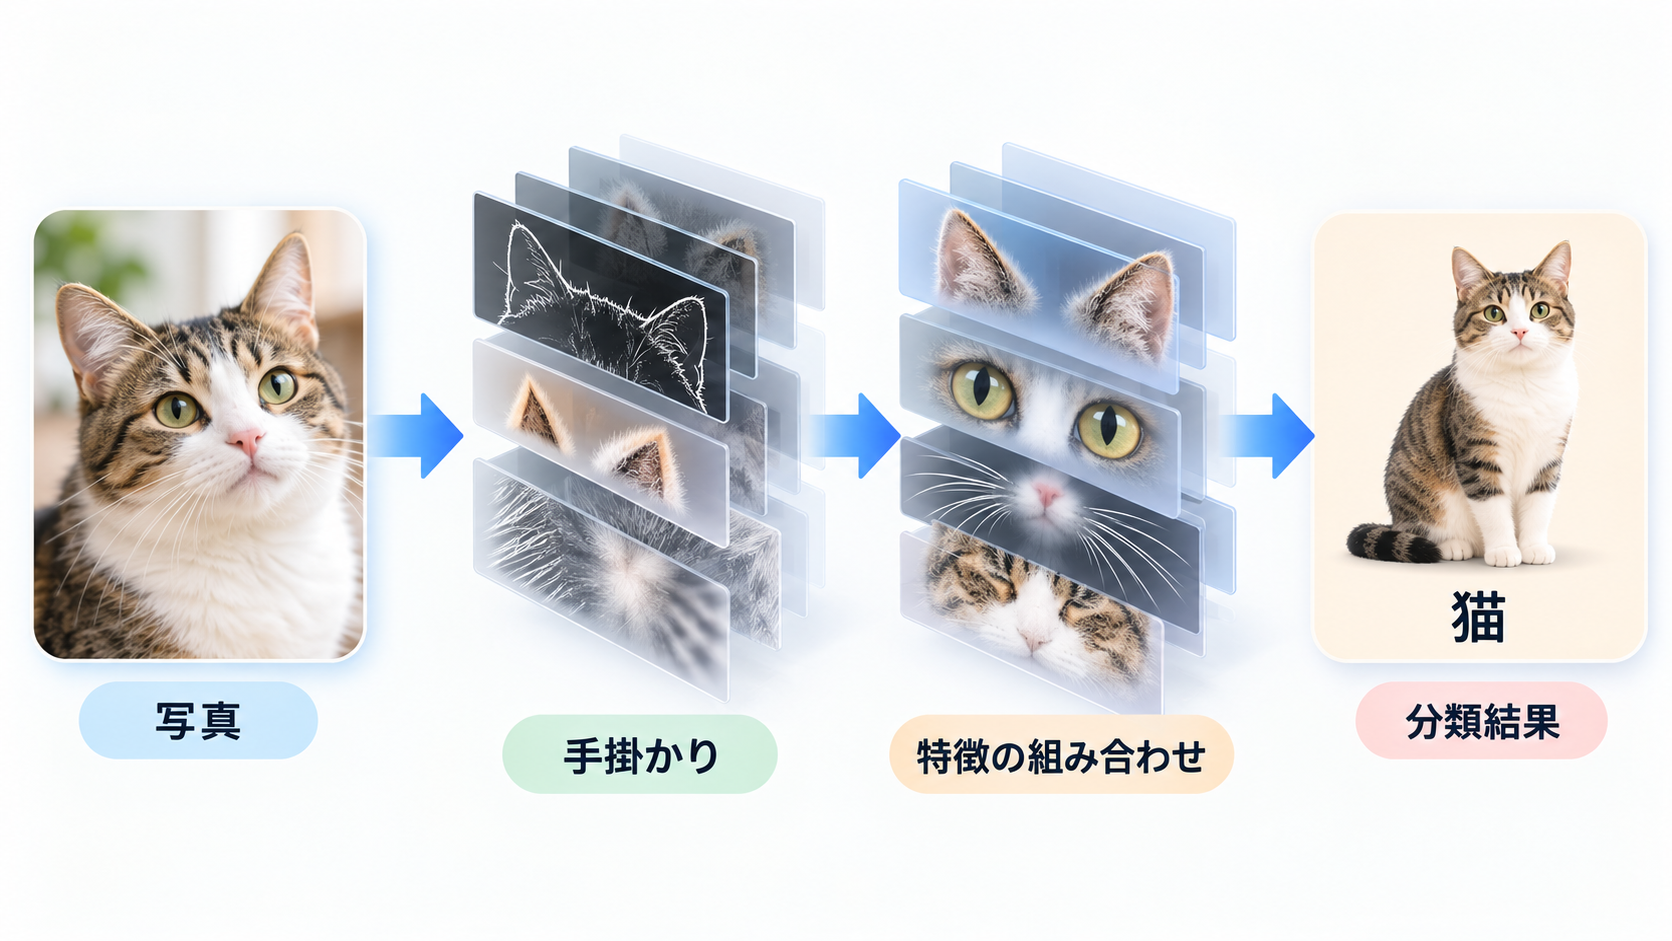
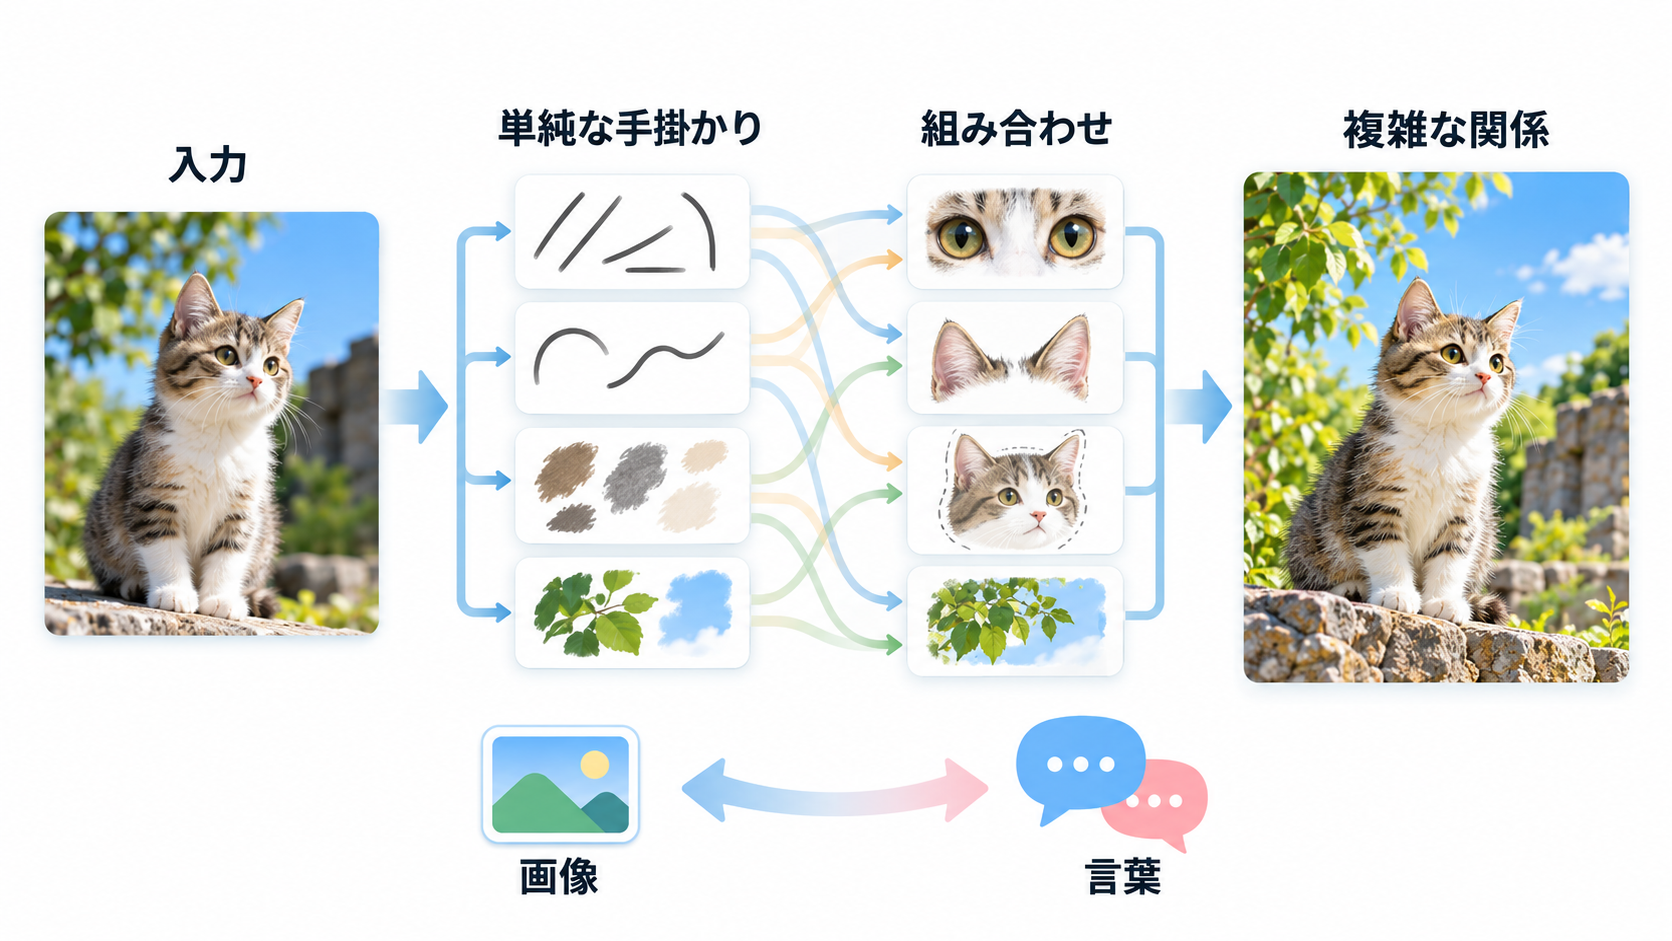
写真を何枚ものフィルターに通す処理のイメージ
架空の例として、写真に写っているものを分類する仕組みを考えます。入力層には写真の情報が入り、複数の隠れ層で処理された後、出力層から分類結果が出るとします。ニューラルネットワークでは、互いにつながった層のノードが情報を処理します。IBMは、この構造が大量のデータに含まれる複雑なパターンや関係を扱う課題に適していると説明しています(出典: IBM)。
初心者向けに、各層を透明なフィルターとして置き換えてみましょう。写真が一枚目のフィルターを通り、その処理結果が二枚目へ渡り、二枚目の結果が三枚目へ渡っていきます。後ろのフィルターは元の写真だけを見るのではなく、前段までに処理された情報を受け取ります。段階を重ねることで、単純な手掛かりから、より複雑な関係を扱えるという見方です。
ただし、「最初の層は必ず線を見つけ、次の層は必ず丸を見つける」と固定的に理解するのは避けたいところです。フィルターのたとえは情報が段階的に処理される構造を示すもので、実際の内部処理を人間向けの明確な担当表に置き換えたものではありません。層の働きは学習した内容や扱う課題によって異なるため、すべての層を一つずつ日常語で説明できるとは限らないでしょう。
深層学習の特徴には、特徴の抽出を自動化できることもあります。IBMの資料では、多数の層によって、大規模なラベルなし・非構造化データから特徴を取り出せると説明されています(出典: IBM)。ここでいう非構造化データとは、表の決まった欄に収まった数値だけではない文章や画像などを指します。この説明から分かるのは、人が写真ごとに確認規則を一つ残らず書き込む方式とは異なり、データを通じて扱うべき特徴の表現を作る点です。深層学習の「深さ」は、魔法のような理解を示す言葉ではなく、この段階的な情報処理を表した名称なのです。
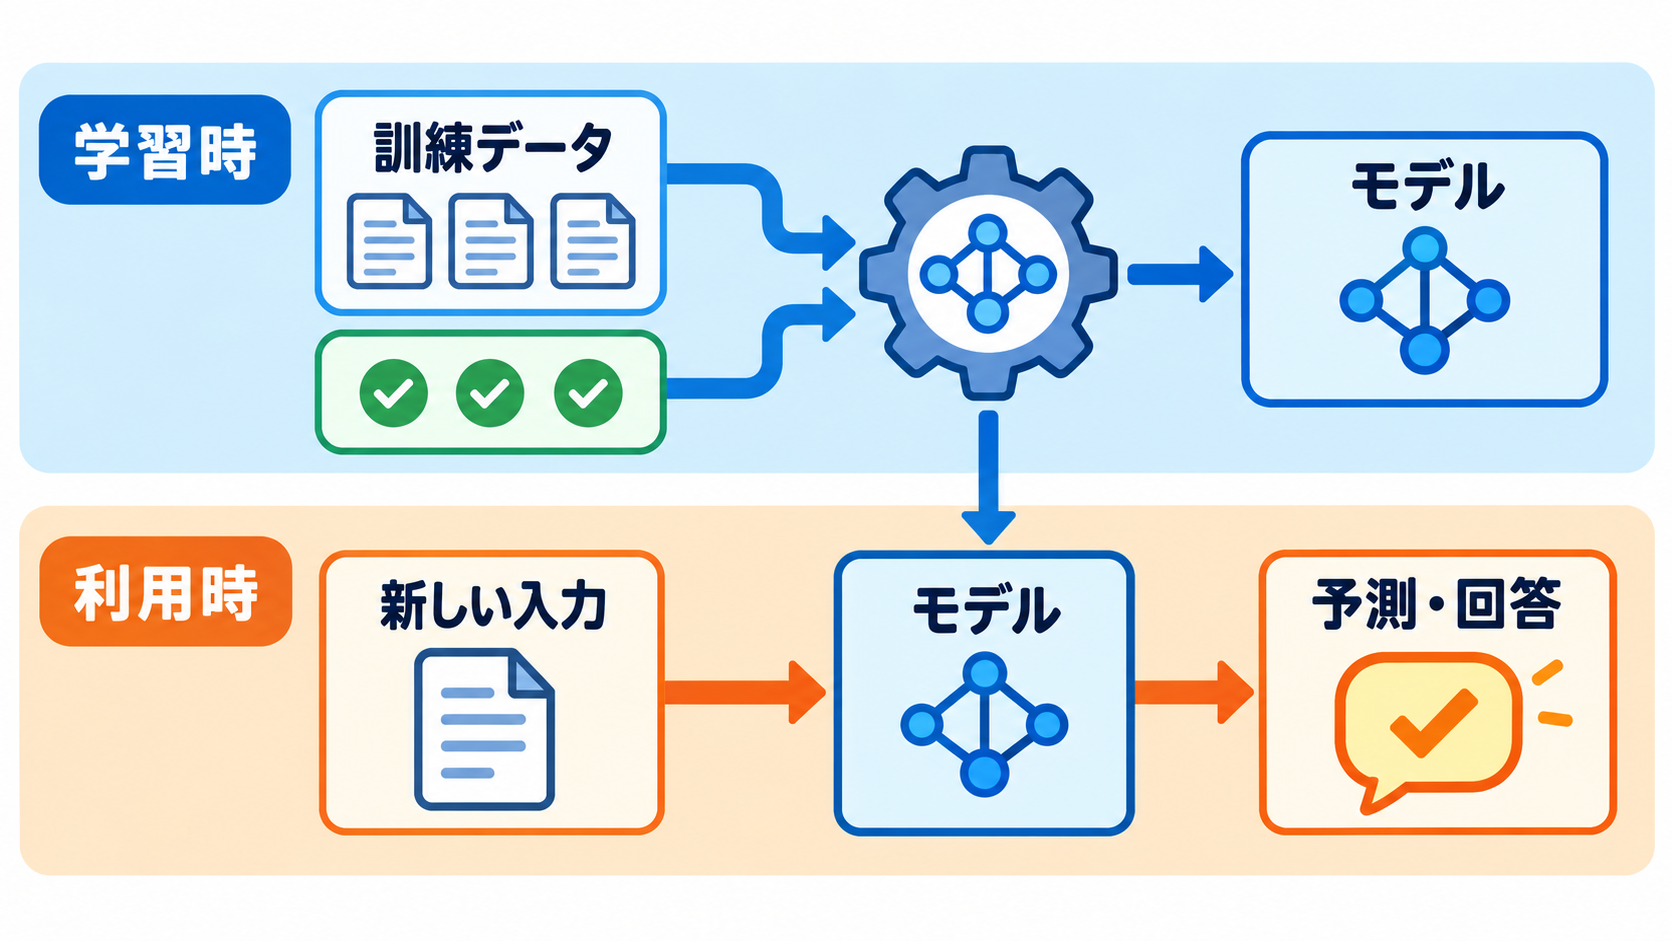
学習するときと回答するときに起きていること
「AIが学ぶ」と聞くと、質問するたびにその場で知識を覚え、次の瞬間には賢くなる様子を想像するかもしれません。しかし、仕組みを理解するには、学習してモデルを作る段階と、作られたモデルに新しい入力を渡して結果を得る段階を分ける必要があります。ここでいうモデルとは、学習を通じて得られ、未知の入力に対する予測や判断に使われる仕組みです。
教師あり学習という方法では、人が訓練用の例に正解を示すラベルを組み合わせます。たとえば架空の写真分類なら、複数の写真に「犬」「猫」といった正解を付け、入力と正解の対応関係を学ぶ材料にするイメージです。IBMは、教師あり学習の目的を、訓練データにおける入力と出力の対応を学び、まだ見ていない新しいデータのラベルを予測できるようにすることだと説明しています(出典: IBM)。
Google Cloudの解説では、機械学習モデルはアルゴリズムを訓練データ上で動かした結果、つまりプログラムが学んだものと位置付けられています(出典: Google Cloud)。写真を見分ける場面なら、利用時に新しい写真をモデルへ渡し、学習で得た関係をもとに結果を出させます。学習用の写真を最初から一枚ずつ探し直して答える、という単純な検索作業ではありません。
生成AIについても、IBMの資料は、基盤となるモデルを作る学習、用途に合わせる調整、生成と評価という段階を分けています(出典: IBM)。したがって、チャット画面で一度訂正を入力しただけで、基盤モデルそのものが直ちに再学習されたと決めつけることはできません。会話内容が後の返答に影響する仕組みと、モデルを訓練し直すことも同じではないため、利用するサービスの説明を個別に確かめる必要があります。「学習」と「回答」を別の場面として捉えるだけでも、AIが会話のたびに人間と同じように経験を蓄えているという誤解を避けやすくなるでしょう。
層を重ねる理由と得意な課題
一段の処理で十分な課題なら、何段もの層を通す意味は分かりにくいかもしれません。深層学習が対象にするのは、入力と答えの間に複雑なパターンや関係がある課題です。IBMは、深層学習が自然言語処理やコンピュータービジョンなど、大量のデータから複雑なパターンを速く正確に識別する必要がある課題に適していると説明しています(出典: IBM)。自然言語処理は文章や言葉を扱う技術、コンピュータービジョンは画像や映像を扱う技術という程度に捉えれば十分です。
写真のフィルターというたとえに戻ると、一枚のフィルターだけですべてを判断するより、前の処理結果を後ろへ渡すほうが、情報を段階的に組み合わせる構造を作れます。文章を扱う場合も、単語が一つあるかどうかだけでは意味が決まりません。同じ言葉でも、周囲の語や文の流れによって役割が変わります。ここで重要なのは、深層学習が人間と同じ意味理解や意識を持つと考えることではなく、多層構造によって複雑な関係を扱うモデルを作れると理解することです。
層を重ねる方式は、データから特徴を取り出す作業とも関係します。IBMによると、深層学習の複数の層は、大規模なラベルなしデータや形式の整っていないデータから特徴を抽出する処理を自動化できます(出典: IBM)。これは、人の作業が一切不要になるという説明ではありません。どの課題を解くのか、どんなデータを用意するのか、出力をどう評価するのかといった判断は別に残ります。
「複雑なデータを扱える」と「どんな質問にも正しく答えられる」も同じ意味ではありません。画像の分類に向くモデルと、文章を生成するモデルでは目的が異なります。深層学習という共通の土台があっても、用途や調整方法まで同じとは限らないのです。サービスの説明を読むときは、「深層学習を採用」という一文だけで能力を判断せず、何を入力として、どのような結果を出すための仕組みなのかを確認するとよいでしょう。
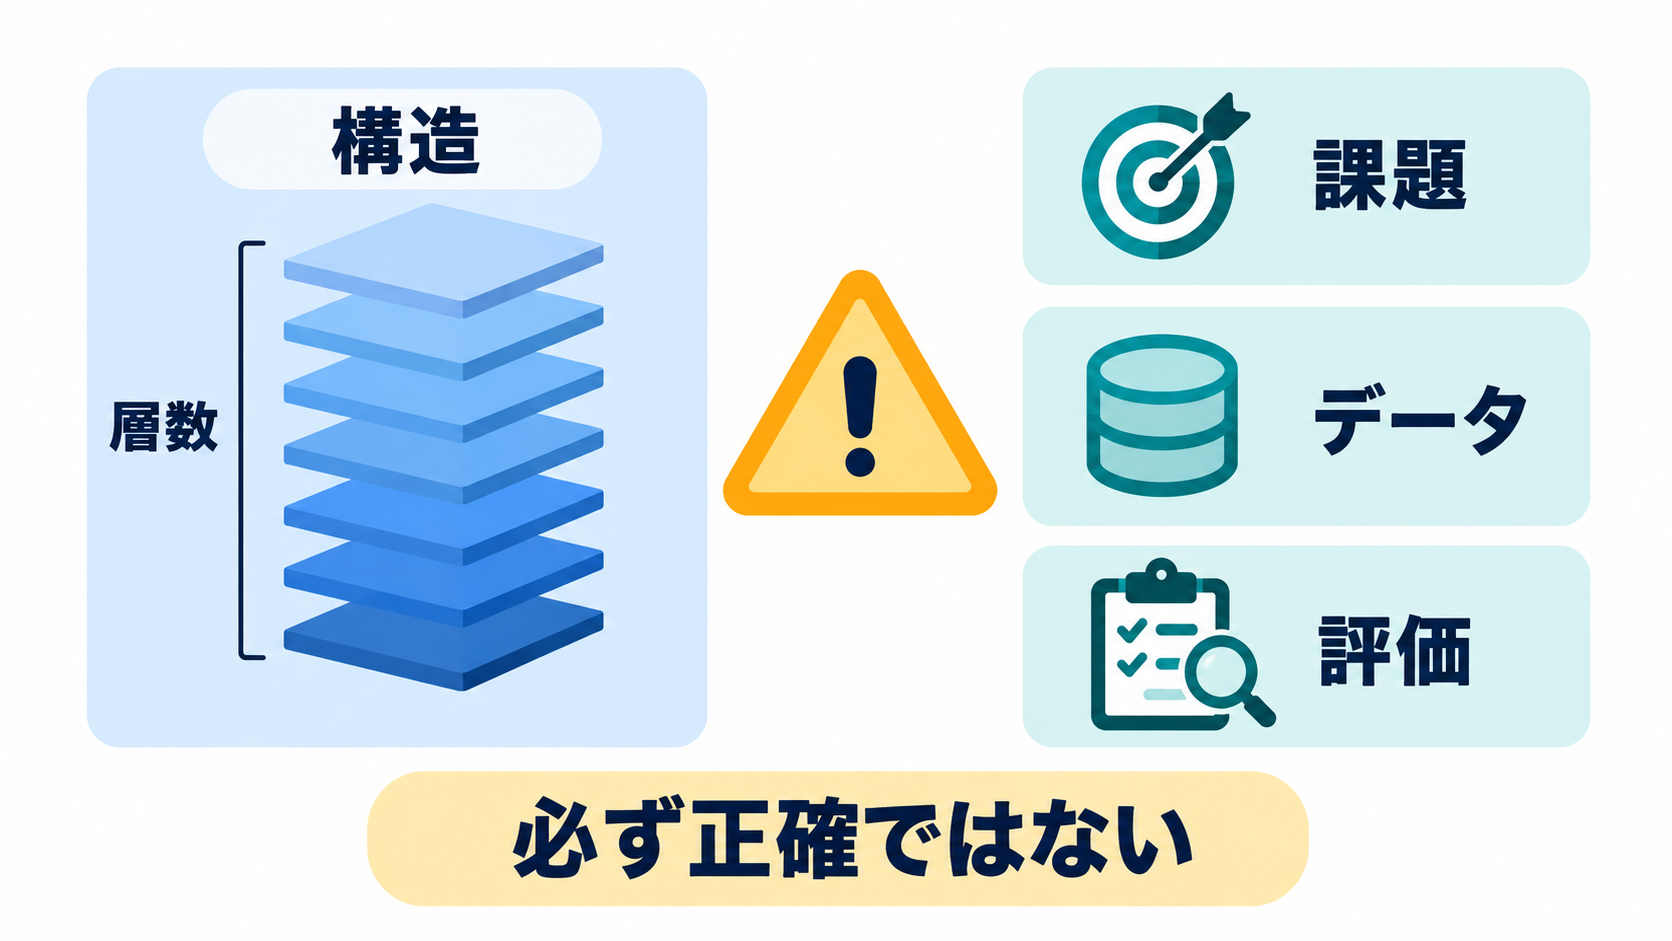
層が多ければ必ず正確になるという誤解
「深いほど高性能」と理解すると、層の数だけを比べてモデルの優劣を決めたくなります。しかし、層が多いという事実は構造の深さを示すだけで、あらゆる入力に対する正確さを保証しません。深層学習の定義と、特定のモデルが目的に対して十分な品質を持つかどうかは、別の問いだからです。
たとえば、架空の動物写真分類モデルに多くの層があったとしても、それだけでは実用性を判断できません。何を見分けるために学習したのか、訓練例と実際に使う写真がどの程度対応しているのか、まだ見せていない例で確認したのかを見る必要があります。教師あり学習では入力と正解ラベルの対応を学ぶため、ラベルが何を意味するかも結果の解釈に関わります(出典: IBM)。「犬」と「猫」だけを区別するためのモデルへ別の動物を入力したとき、層数の多さだけから適切な結果を期待することはできないでしょう。
品質は評価によって確かめます。Google for Developersの用語集では、評価をモデルの品質測定やモデル同士の比較を行う過程とし、教師あり機械学習では検証用データとテスト用データを使って判断するのが一般的だと説明しています(出典: Google for Developers)。ここで大切なのは、「深い」という名前を性能評価の言葉として読まないことです。深さは構造の特徴、正確さは目的に沿った方法で確かめる品質です。
説明を読む際には、層数そのものより、課題、入力データ、期待する出力、評価方法の四点を確認すると整理しやすくなります。数値が掲載されていても、それが構造の規模を表すのか、テスト結果を表すのかを区別してください。評価結果が示されている場合も、どんなデータと条件で測ったのかによって受け取り方が変わります。
深層学習は多層構造だからこそ複雑なパターンを扱えますが、「層を追加すれば自動的に正解へ近づく」という単純な足し算ではありません。製品や研究の説明で「より深いモデル」という表現を見かけたら、正確さの保証ではなく、構造に関する情報として受け取るのが安全です。
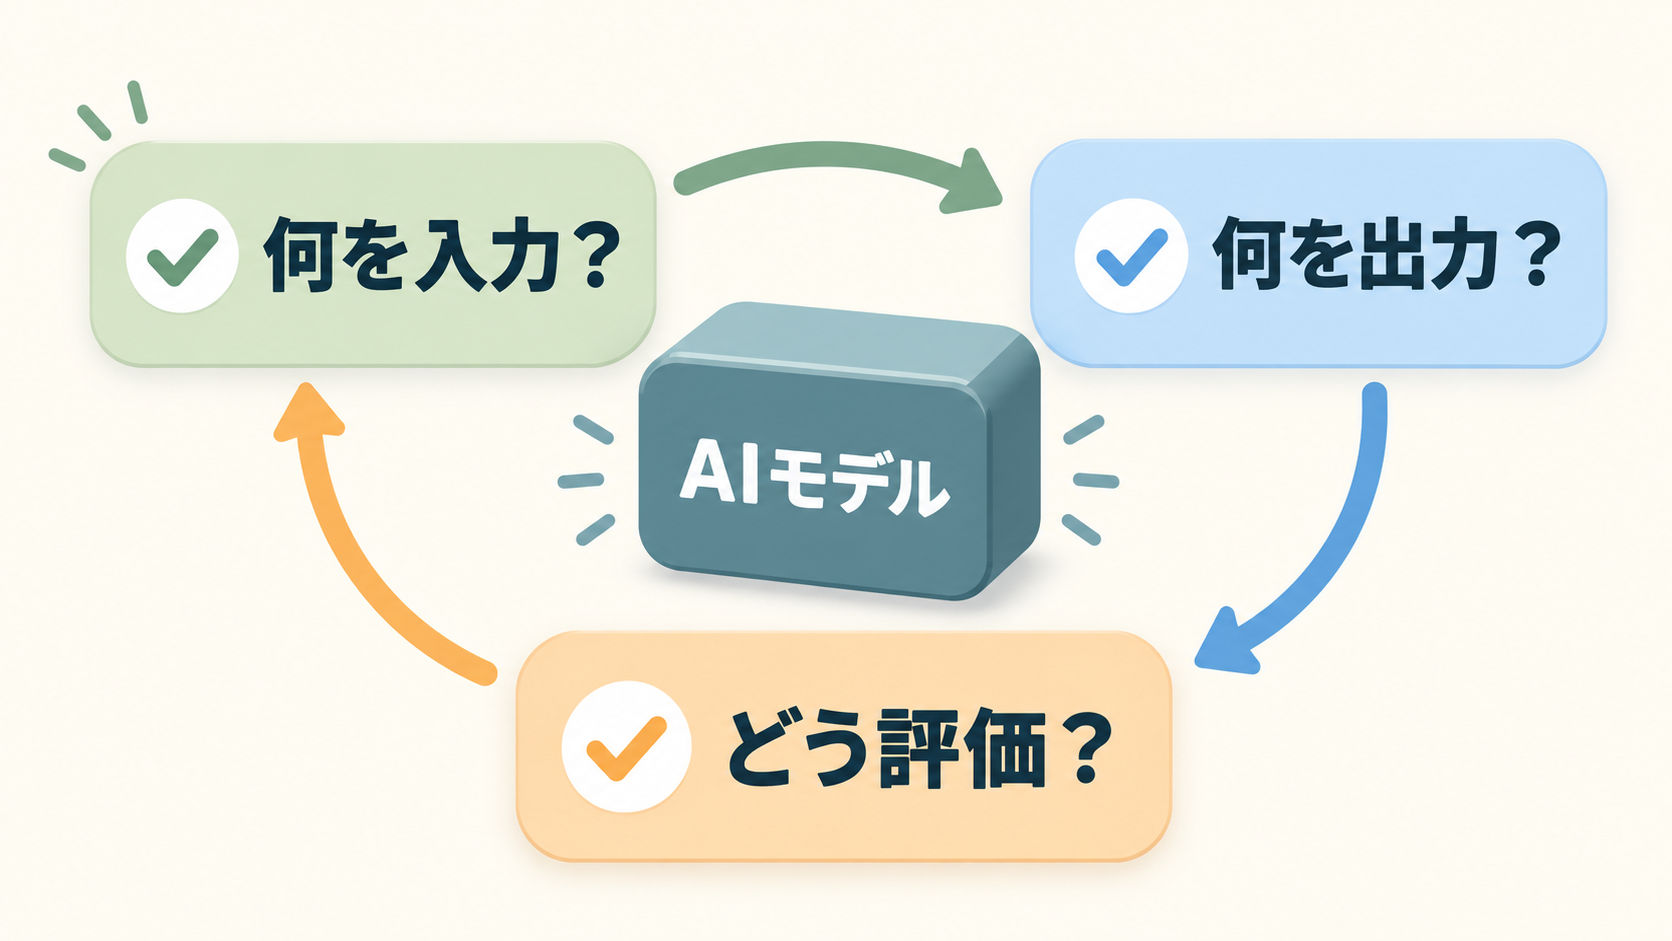
明日からAIの説明を読むための三つの問い
深層学習という言葉に出会ったら、専門的な層数を暗記する必要はありません。説明を理解するために役立つのは、「何が入力されるのか」「何を出力するのか」「結果をどう確かめたのか」という三つの問いです。この順番で見ると、AIという大きな看板だけに引っ張られず、実際の役割を具体的に考えられます。
架空のサービス紹介に「深層学習で写真を自動判定」と書かれていたとします。入力はどのような写真なのか、出力は対象物の名前なのか候補の一覧なのかを確認します。その後、どのような条件で品質を評価したのかを探してください。「深層学習だから正しい」ではなく、「目的に合うデータと評価が示されているか」という読み方へ変わります。
生成AIを見る場合も考え方は共通します。プロンプトはモデルへの指示や依頼であり、生成AIはその入力に応じて文章や画像などを作ります(出典: IBM)。出力が自然に見えても、深い層を持つこと自体が事実の正しさを保証するわけではありません。事実確認が必要な内容は、元資料や信頼できる情報源と照合するという判断が残ります。滑らかな文章と、検証済みの情報を分けて扱う姿勢が欠かせません。
AI、機械学習、深層学習の関係も、同じ三つの問いで見通しやすくなります。AIは広い技術分野で、機械学習はデータから学ぶ方法、深層学習は多層ニューラルネットワークを使う機械学習です。名称が狭くなるほど、仕組みの説明が具体的になりますが、利用目的や品質まで名称だけで決まるわけではありません。
明日、AIを使った製品や記事を目にしたら、最初に「深いとは処理層が多いこと」と一言で言い換えてみてください。そのうえで、入力、出力、評価の三点を一つずつ探します。三点が書かれていなければ、分からない部分を分からないまま残すのも適切な判断です。用語の響きで性能を想像するのではなく、確認できる仕組みと条件から理解することが、AIの説明に振り回されないための具体的な一歩になります。