
2026/11/02
今更聞けないAI知識
基盤モデルとは?生成AIの「共通の土台」を服づくりで理解する
文章も画像も作れるAIは、それぞれ別物なのか
文章を考えるAI、画像を作るAI、質問に答えるAIを見て、「一つひとつ別の仕組みを最初から作っているのだろうか」と疑問に思ったことはないでしょうか。実際の生成AIでは、さまざまな用途の出発点として、共通の大きなモデルを利用する考え方があります。その土台が「基盤モデル」です。
一言で表すなら、基盤モデルとは「さまざまな用途の土台になる、大量かつ多様なデータで事前学習したモデル」です。Googleの用語集では、非常に大きく多様なデータセットで事前学習され、幅広い依頼に対応できるとともに、追加調整の出発点にもなるモデルと説明されています(出典: Google for Developers)。IBMも、複数の生成AIアプリケーションの基礎として使われる深層学習モデルと位置づけています(出典: IBM)。
ここで大切なのは、「基盤」という言葉を「すべてを正しく知っている万能な知能」と読み替えないことです。建物の基礎が、そのまま住宅や店舗として使えないのと同じで、基盤モデルは完成したサービスそのものではありません。土台の上に、用途に応じた調整、画面、検索機能、評価の仕組みなどが組み合わさり、利用者が触れるAIサービスになります。
この違いが分かると、「同じようなAIなのに、サービスによって答え方が違うのはなぜか」という疑問も整理しやすくなります。共通性の高い土台を利用していても、その後の調整や機能の組み合わせが同じとは限らないからです。基盤モデルという言葉は、製品名を覚えるためではなく、生成AIの裏側を「共通の土台」と「用途別の仕上げ」に分けて見るための手がかりになります。
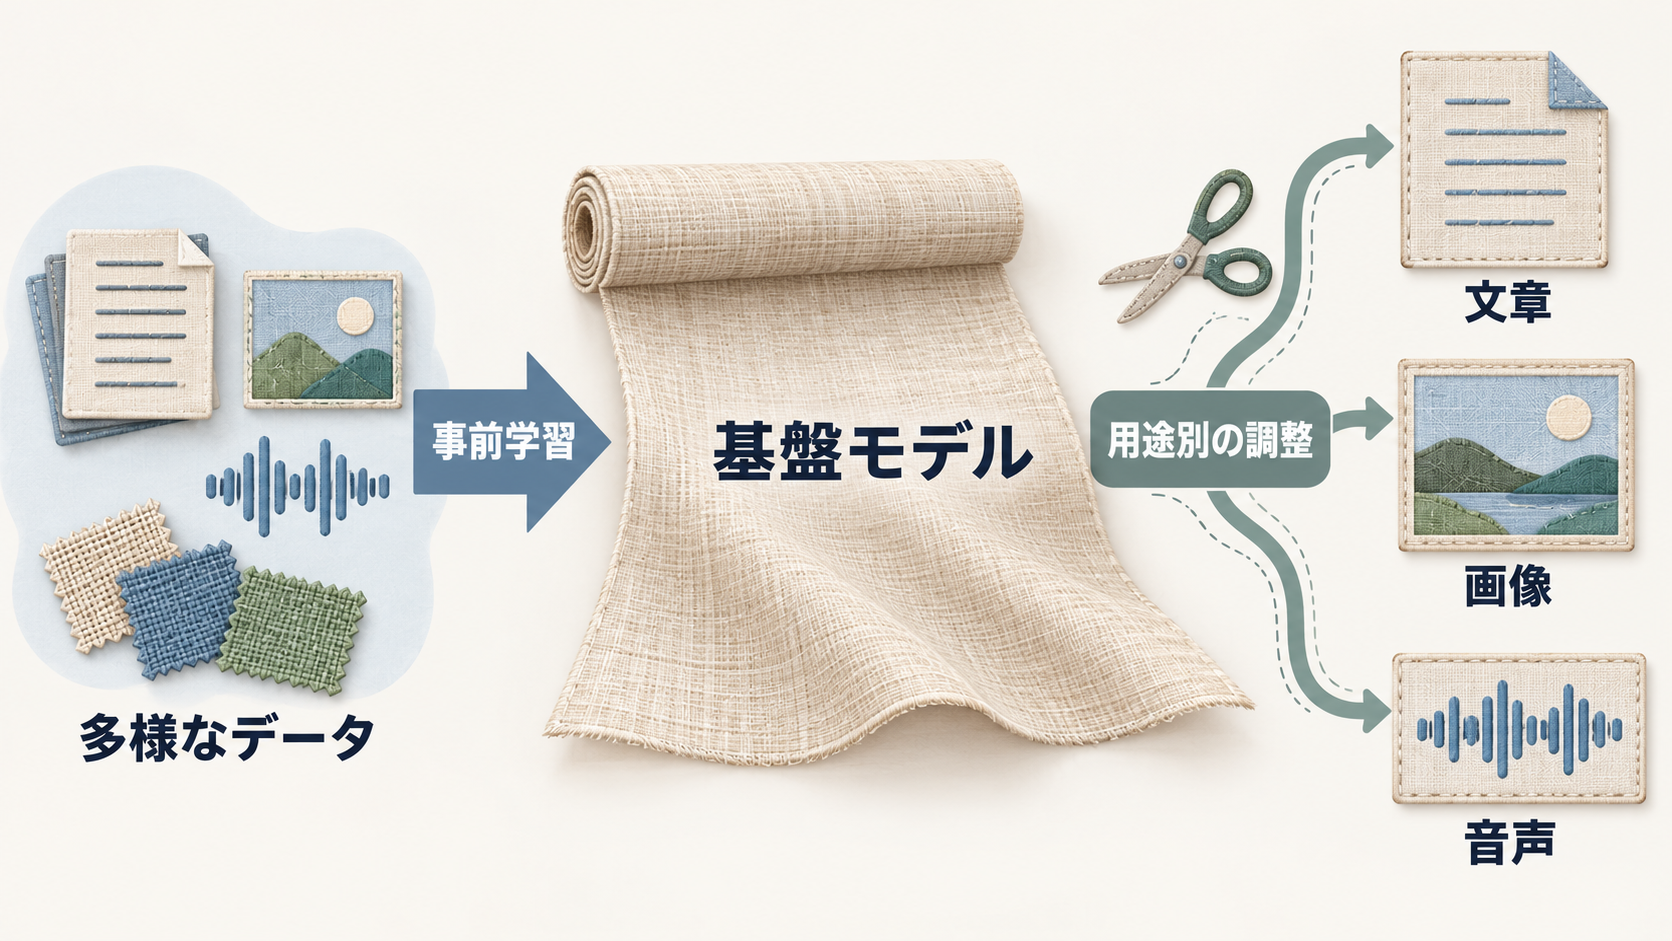
基本の生地から複数の服を仕立てるイメージ
基盤モデルの役割は、服づくりに置き換えると見通しがよくなります。大量かつ多様なデータを使った事前学習は、さまざまな服に使える大きな基本生地を用意する工程に似ています。その生地から、通勤用のシャツ、雨の日の上着、式典用の服などを目的に合わせて仕立てていくイメージです。
生地に当たる基盤モデルは、特定の一用途だけを想定したものではありません。Googleの用語集では、幅広い依頼に対応し、追加のファインチューニングやカスタマイズの基礎にもなることが特徴として挙げられています(出典: Google for Developers)。ファインチューニングとは、事前学習済みモデルに対して、特定の仕事に合わせた追加学習を行うことです。同じ土台から用途の異なる仕組みを作れるため、「foundation=基礎」という名前が使われています。
ただし、このたとえには注意も必要です。基盤モデルから文章、画像、音声のすべてが必ず作られるという意味ではありません。IBMの資料では、文章生成に使われる大規模言語モデルのほか、画像、映像、音声、音楽を対象とする基盤モデルや、複数種類の情報を扱うマルチモーダルな基盤モデルが紹介されています(出典: IBM)。扱える内容はモデルごとに異なります。
また、基本生地が上質でも、あらゆる場面に同じ服が適するわけではありません。求める用途、利用者、確認すべき事実、望ましい回答形式に合わせた仕立てが必要です。基盤モデルの価値は、一着で何もかも済ませられることではなく、複数の用途へ展開できる共通の出発点になることにあります。「大きいモデルだから完成品」と考えるより、「幅広く仕立てられる材料」と捉えるほうが実態に近いでしょう。
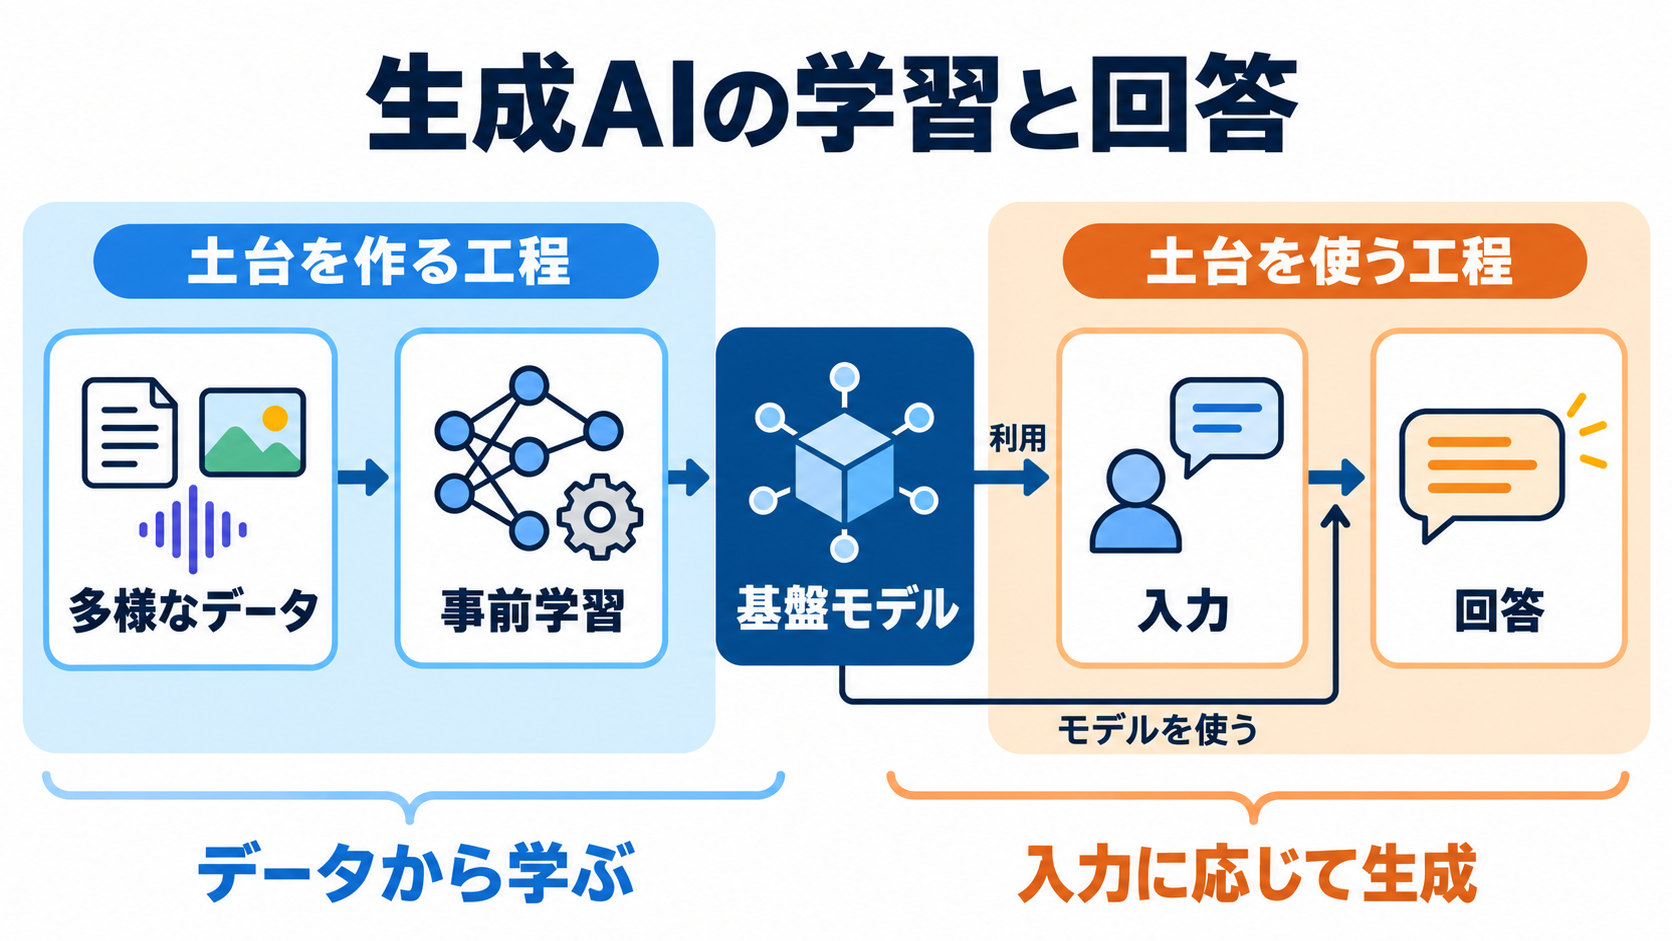
データから土台が作られ、入力から回答が作られる流れ
基盤モデルを理解するときは、「学習」と「回答」を同じ出来事として扱わないことが欠かせません。学習はモデルの土台を作る工程であり、回答は完成したモデルに入力を渡して出力を得る工程です。普段のチャット画面で質問を入力する場面は、原則として後者を見ていると考えると整理しやすくなります。
IBMの説明では、基盤モデルを作る際、大量の文章や画像などを使って深層学習のアルゴリズムを訓練します。その結果、データ中の対象、パターン、関係性を表す多数のパラメーターを持つニューラルネットワークが作られます(出典: IBM)。パラメーターとは、学習によって調整される内部の値です。初心者向けに大まかに言い換えるなら、入力をどのように処理して出力につなげるかを左右する、非常に多くの調整値だと考えられます。
学習済みのモデルへ依頼文を渡すと、そのモデルは学習で形成された表現やパターンを利用して出力を作ります。IBMは生成モデルについて、学習データの単純化された表現を内部に持ち、元のデータと似ていても同一ではない新しい内容を生成すると説明しています(出典: IBM)。これは、資料棚から該当する一文を毎回そのまま取り出す動きとは異なります。
たとえば、架空の依頼として「町内会のお知らせを、初参加の人にも分かる文章にしてください」と入力したとします。モデルは依頼に応じた文章を生成できますが、その回答だけを見て、どの資料を学習したのか、特定の事実が正しいのかまで判断することはできません。回答が自然であることと、根拠が確認できることは別の条件です。
この区別を覚えておくと、「質問するたびに基盤モデル全体が作り直されている」「過去に読んだ文章をそのまま検索して返している」といった誤解を避けやすくなります。学習は土台づくり、回答はその土台を使った出力づくりです。似た言葉が並ぶ生成AIの説明でも、この二段階を分けるだけで理解しやすくなります。
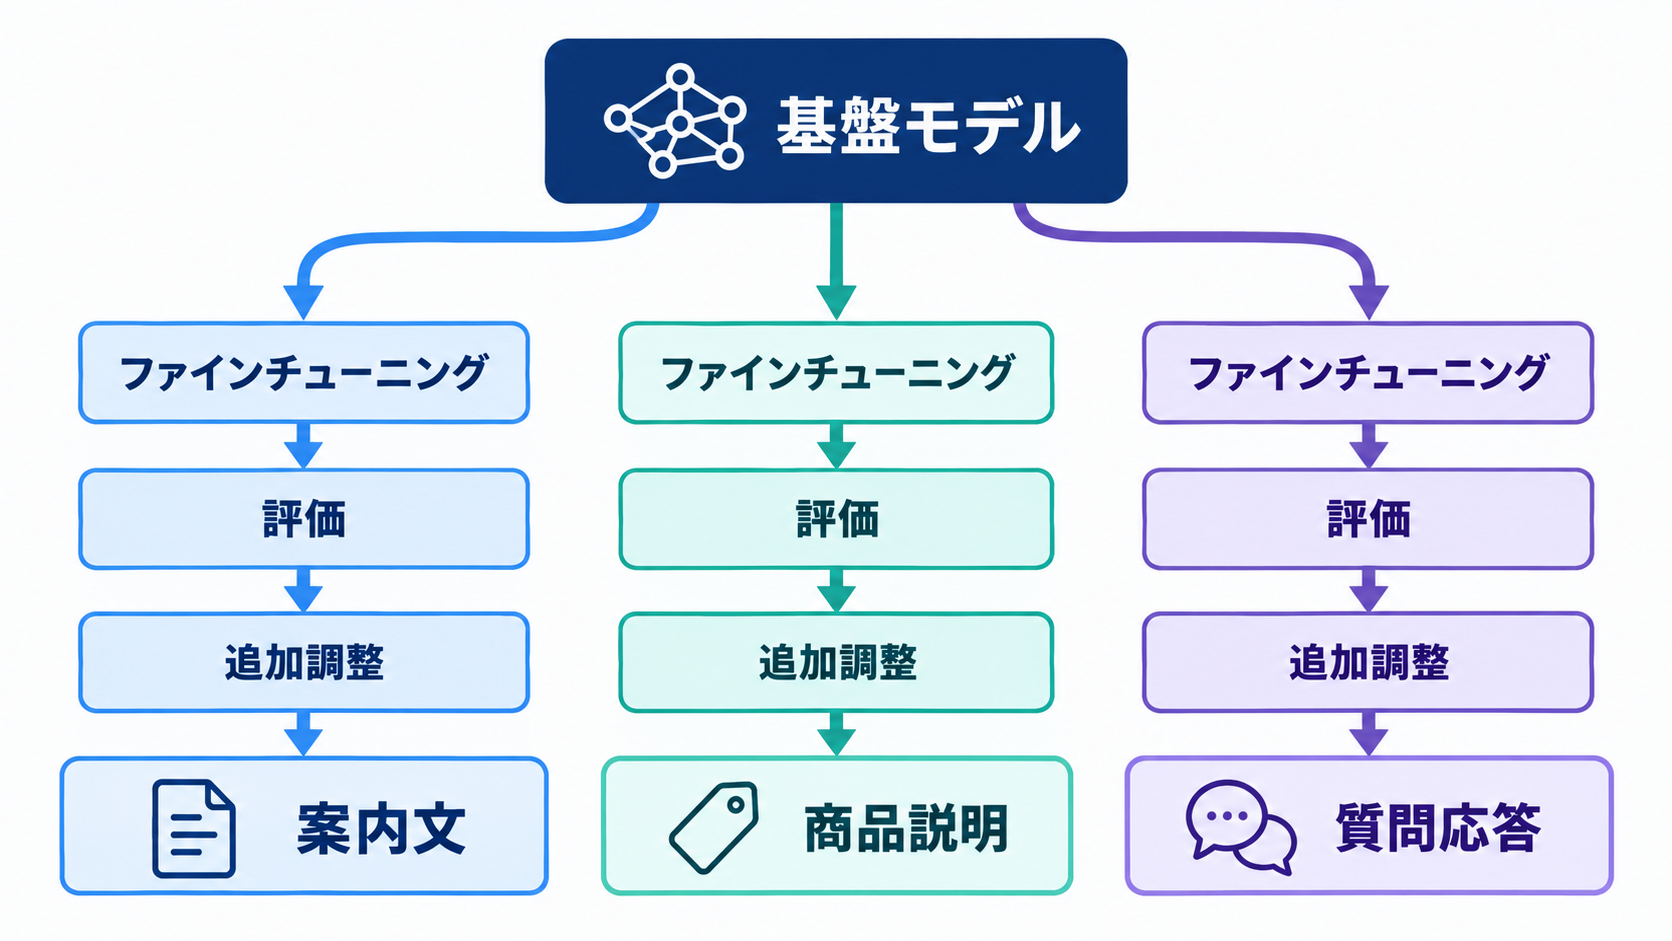
共通の土台が用途別のAIになるまで
基盤モデルが作られた後には、利用目的に合うように整える工程があります。IBMは生成AIの大まかな流れを、基盤モデルを作る学習、特定用途へ適応させる調整、生成結果の評価と追加調整という段階で説明しています(出典: IBM)。利用者が目にするサービスは、この流れの先にあるものです。
代表的な調整方法の一つがファインチューニングです。Googleの用語集では、事前学習済みモデルに対して行う、特定用途向けの二回目の学習工程と説明されています(出典: Google for Developers)。IBMの資料では、用途に合った質問や指示、それに対応する望ましい回答などを与える方法が示されています(出典: IBM)。服のたとえに戻せば、基本生地を切り、用途に合う形へ仕立てる段階です。
架空の例として、同じ土台を利用しながら、「社内文書を読みやすく整える仕組み」と「商品説明の下書きを作る仕組み」を別々に設計する場面を考えてみましょう。前者では用語の統一や簡潔さ、後者では記載項目や表現上の注意が重視されるかもしれません。これは応用の考え方を示す例であり、特定の製品が実際にその方法を採用していると断定するものではありません。
日常的に入力するプロンプトと、ファインチューニングも区別が必要です。プロンプトは、生成AIへ渡す依頼や入力です。ファインチューニングは、モデルを特定用途に適応させる追加学習を指します(出典: Google for Developers、IBM)。利用者が回答の長さや対象読者を依頼文に書く行為と、開発側がモデルの内部パラメーターを調整する工程は、同じ「調整」に見えても意味が異なります。
基盤モデルという言葉を見かけたら、完成品の機能だけでなく、「どのような用途向けに仕上げられているのか」と考えてみてください。土台の広さだけでは、実際の使いやすさや出力の適切さは決まりません。目的に合う仕立てと、その結果を確かめる評価まで含めて、利用者が触れるAIの性格が形づくられます。
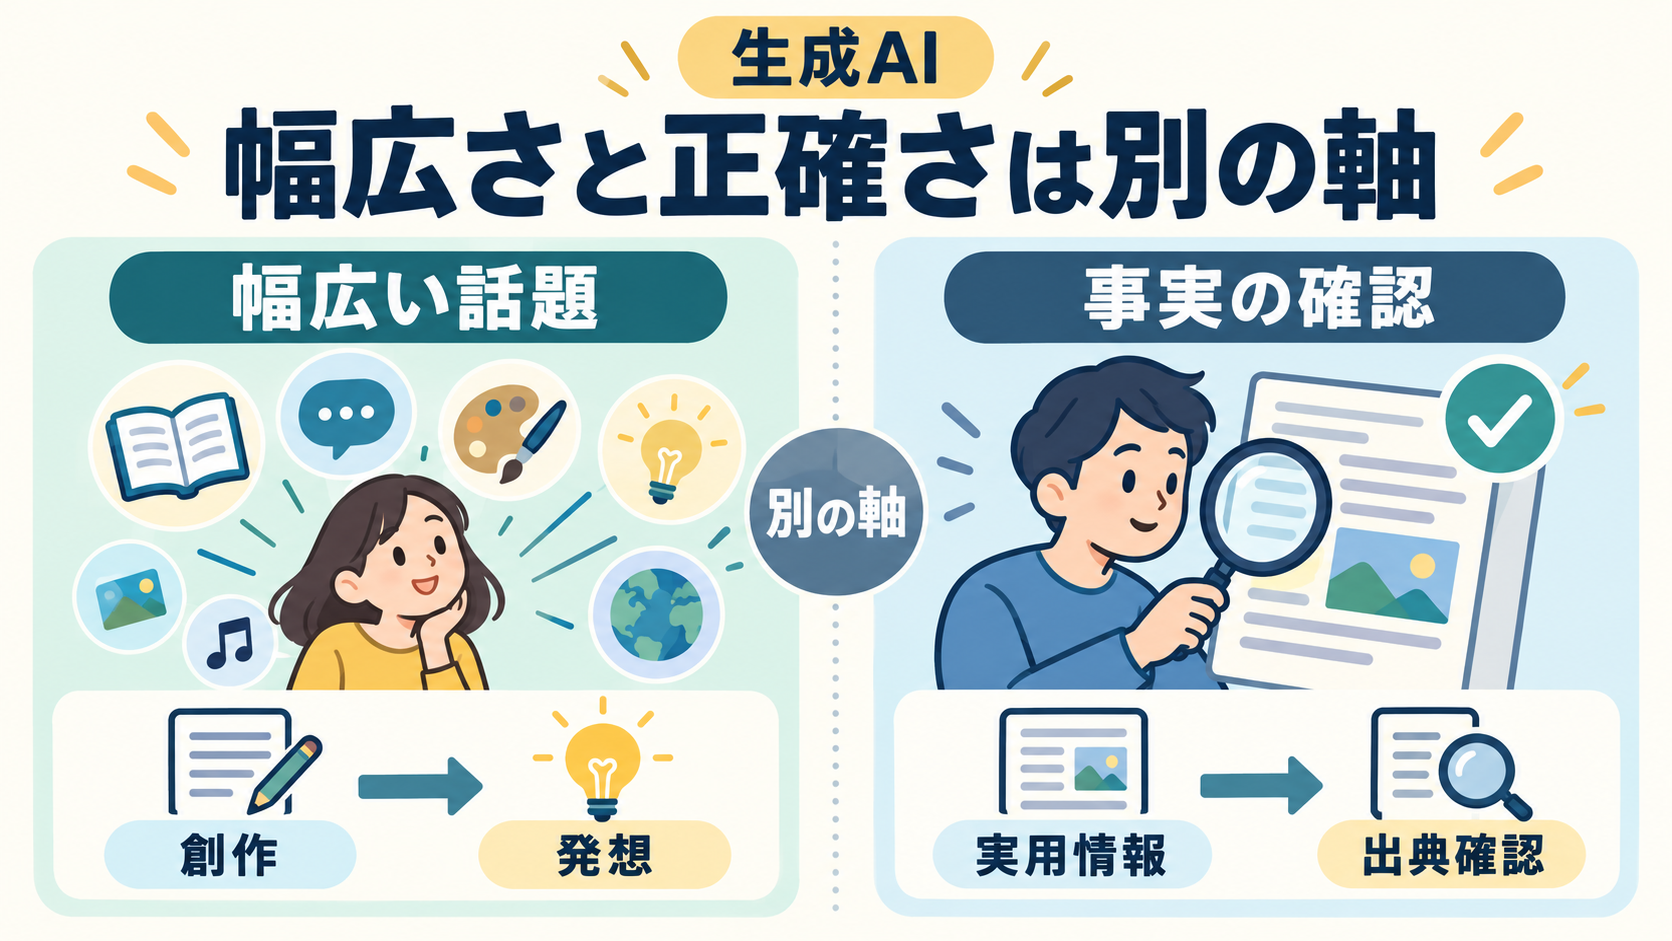
幅広く答えられることと、正しく答えられることの違い
基盤モデルは多様なデータで事前学習されるため、幅広い依頼に対応できます。しかし、「話題を幅広く扱える」と「事実を必ず正しく答えられる」は同じ意味ではありません。ここを混同すると、文章が滑らかであるだけで内容まで信用してしまうおそれがあります。
Googleの用語集には「事実性」という考え方があり、出力が現実の事実に基づいている性質として説明されています。同じ資料では、食塩の化学式を尋ねる依頼では事実性が求められる一方、架空の詩を作る依頼では創造性が重視される例が示されています(出典: Google for Developers)。つまり、望ましい出力の条件は依頼によって変わります。
たとえば、架空の旅行物語を作ってもらうなら、現実に存在しないカフェが登場しても作品上の演出として扱えます。ところが、実際に訪問する店の住所や営業時間を尋ねた場合、存在しない情報は困ります。どちらも自然な文章として生成される可能性があるため、文体の自信強さだけでは見分けられません。正確さが必要な依頼では、公式資料や信頼できる情報源に戻って確認する姿勢が必要です。
基盤モデルの外にある情報を参照して回答を改善する方法として、IBMは検索拡張生成、略してRAGも紹介しています。これは関連する外部情報源を利用し、生成AIアプリケーションの正確さや関連性を高めるための技術です(出典: IBM)。ただし、外部情報を参照する仕組みがあること自体は、すべての回答の正しさを保証しません。どの情報源を参照したのか、情報が古くないか、回答が資料の内容を正しく反映しているかという確認は残ります。
「基盤モデルは広い範囲の下地を持つが、個々の回答には確認が必要」と覚えておくと、過信にも過度な警戒にも偏りにくくなります。創作では発想を広げる相手として使い、事実確認では出典を求めるなど、依頼の性質に合わせて確認の強さを変えるのが現実的です。
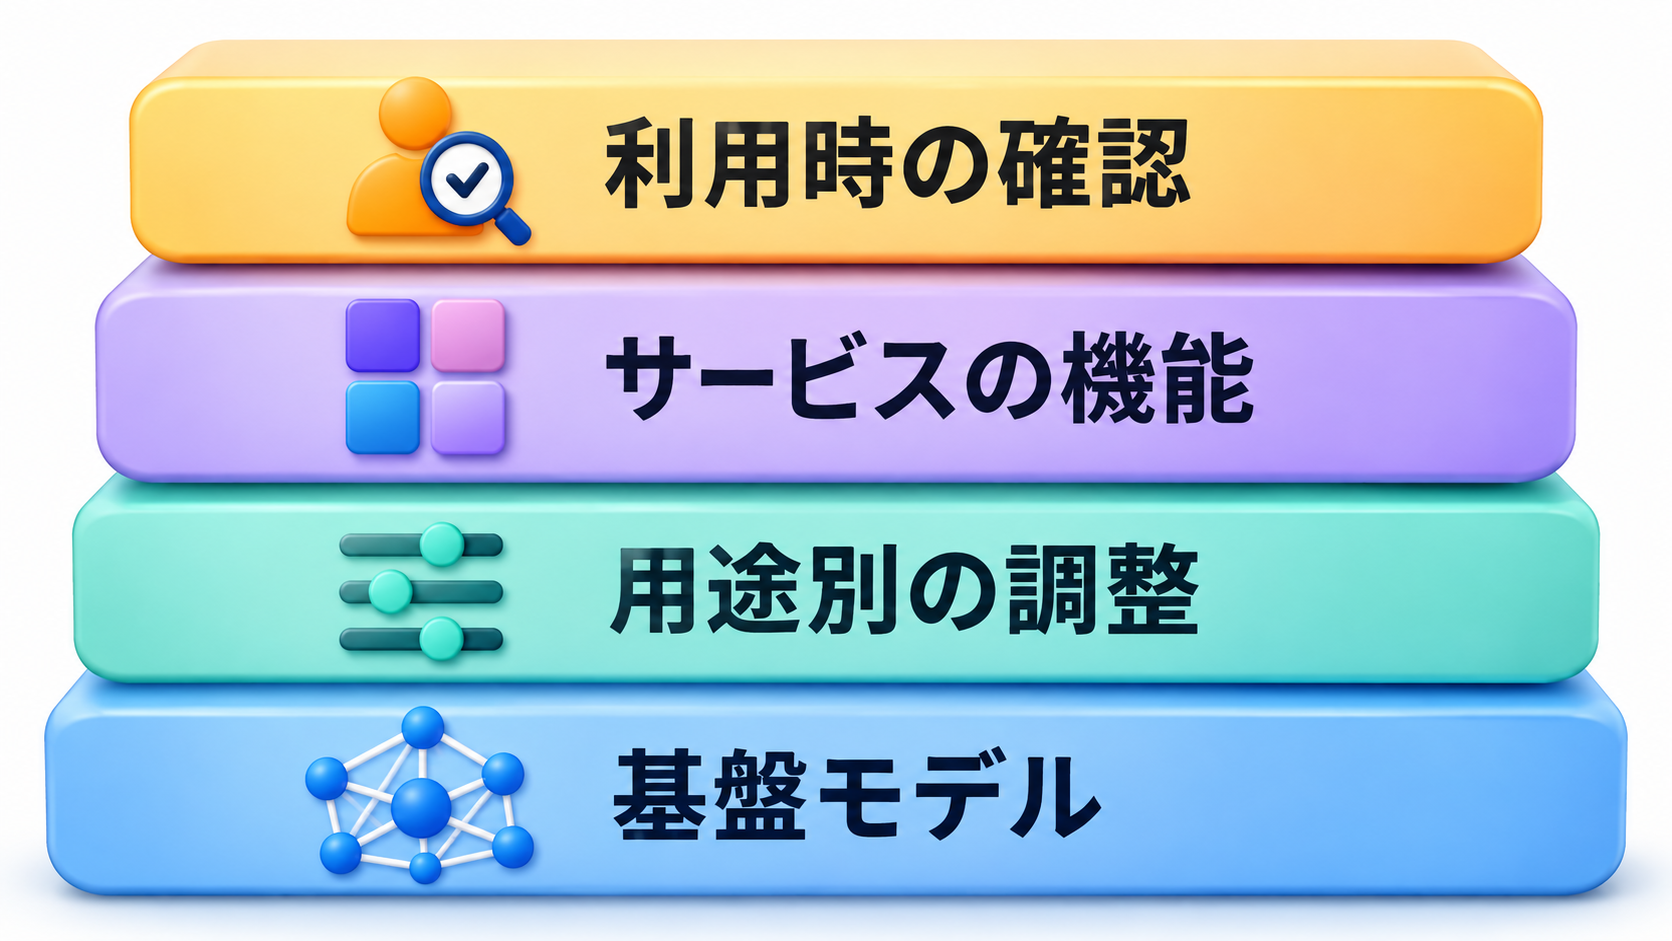
基盤モデルとAIサービスを分けて見る視点
ニュースや製品説明では、モデル名とサービス名が並んで登場することがあります。そこで両者を同じものとして覚えると、「モデルが同じなら使い勝手も答えも同じはずだ」と考えがちです。基盤モデルは共通の土台であり、AIサービスはその土台を利用して特定の体験や機能を提供する仕組みです。
IBMは、基盤モデルを複数の生成AIアプリケーションの基礎になる深層学習モデルと説明しています。また、生成結果の評価や追加調整、外部情報源を使う検索拡張生成など、アプリケーションの性能を整える複数の工程や方法を挙げています(出典: IBM)。この説明からも、利用者が受け取る回答は、土台のモデルだけで決まるとは限らないことが分かります。
初心者がサービスを見る際は、次のように層を分けると理解しやすくなります。
| 見る対象 | 役割 | 確認したいこと |
| --- | --- | --- |
| 基盤モデル | 幅広い用途に使える事前学習済みの土台 | 扱える情報の種類や用途 |
| 用途別の調整 | 特定の仕事や回答傾向へ近づける工程 | 何を目的に整えられているか |
| AIサービス | 利用者が実際に操作する仕組み | 出典確認や入力方法などの提供機能 |
| 利用時の確認 | 出力を目的に照らして確かめる作業 | 誤りや不足を誰が確認するか |
たとえば、架空の二つの文章作成サービスが同じ基盤モデルを利用していたとしても、一方は短い案内文を作りやすい画面を持ち、もう一方は参照資料を確認しながら回答する設計かもしれません。これは構造を理解するための例示であり、具体的な製品仕様を示すものではありません。重要なのは、「土台が同じ」という一情報だけでサービス全体を判断しないことです。
サービスを比較するときも、モデルの規模や知名度だけを見る必要はありません。自分がしたいことに合うか、入力した情報をどう扱うか、回答の根拠を確認できるか、誤りが困る場面で人が点検できるかを確かめるほうが実用的です。基盤モデルは重要な構成要素ですが、利用体験のすべてを表す製品ラベルではありません。
明日から使える「土台・仕立て・確認」の三つの問い
基盤モデルという用語を覚える目的は、専門家のようにモデルを開発することではありません。AIの説明や出力に触れたとき、何が土台で、何が用途別に加えられ、どこを自分で確認するのかを切り分けられれば、日常や仕事での判断が変わります。
明日からは、AIサービスを使う前に「土台・仕立て・確認」の三つを問いかけてみてください。土台については、「このAIはどの種類の内容を扱うモデルなのか」を見ます。仕立てについては、「どの用途を想定したサービスなのか」を考えます。確認については、「誤っていた場合に困る情報はどれか、その根拠をどこで確かめるか」を決めます。この三つなら、詳しい技術用語を知らなくても実践できます。
架空の仕事例として、会議案内の下書きを生成AIに頼む場面を考えてみましょう。文章を整えることはモデルが得意とする可能性がありますが、開催日時、会場、参加者、締切は社内の確定情報と照合する必要があります。「読みやすい案内文にしてください。日時や固有名詞は変更せず、不明な点は不明と示してください」という依頼文は、確認しやすい出力を求めるための提案例です。ただし、この依頼だけで誤りが完全になくなるとは限りません。
基盤モデルは、さまざまな用途へ展開できる大きな出発点です。その広さは便利さにつながりますが、個別の用途への適合や回答の事実性まで自動的に保証するものではありません。だからこそ、AIを「何でも知っている一人の専門家」と見なすより、「幅広い土台を用途別に仕立てて使う仕組み」と捉えるほうが、できることと注意点の両方を理解しやすくなります。
次に生成AIを開いたときは、回答内容だけでなく、その背後にある層を一度想像してみてください。「これは土台そのものの性質なのか、サービス側の仕立てなのか、最後に自分が確認すべきことなのか」と分けるだけでも、AIとの付き合い方は落ち着いたものになるでしょう。