
2026/10/31
今更聞けないAI知識
ファインチューニングは「会話で教えること」ではない――学習済みAIを仕立て直す意味
「毎回説明するなら、AIに覚えさせればよい?」への答え
仕事で生成AIを使っていると、「回答は便利だけれど、いつも同じ注意事項を伝えるのが面倒です」と感じる場面があります。文章を社内向けの表現にそろえたい、問い合わせを決められた区分に分けたい、指定した形式で回答してほしいといった要望です。そこで耳にするのが、ファインチューニングという言葉です。
一言で表すと、ファインチューニングとは、すでに学習済みのAIモデルを、特定の仕事や用途に合うよう追加で調整することです。Google Developersの用語集では、事前学習済みモデルに対して行う、特定タスク向けの第2段階の学習と説明されています。IBMも、生成AIの大まかな流れを「学習」「用途に合わせた調整」「生成・評価・再調整」に分け、調整方法の一つとしてファインチューニングを挙げています。(出典: Google Developers、IBM)
ここで押さえたいのは、ファインチューニングが普段の会話で行う指示や訂正とは別の工程だという点です。チャット欄で「もう少し短くしてください」「この言葉は使わないでください」と伝えることは、その会話の回答を整えるために役立ちます。しかし、それだけでモデル自体がその場で学習し直されたとは限りません。
ファインチューニングという言葉を知る目的は、自分で高度な開発を始めることではありません。「AIへの頼み方を変えれば済む問題」と「提供側がモデルを追加調整する問題」を区別できるようになることです。この区別がつけば、期待どおりの回答が出ないときに、すぐ「もっと学習させる必要があります」と考えず、指示の内容や見本の示し方から見直せます。
「既製服の仕立て直し」で考える追加調整
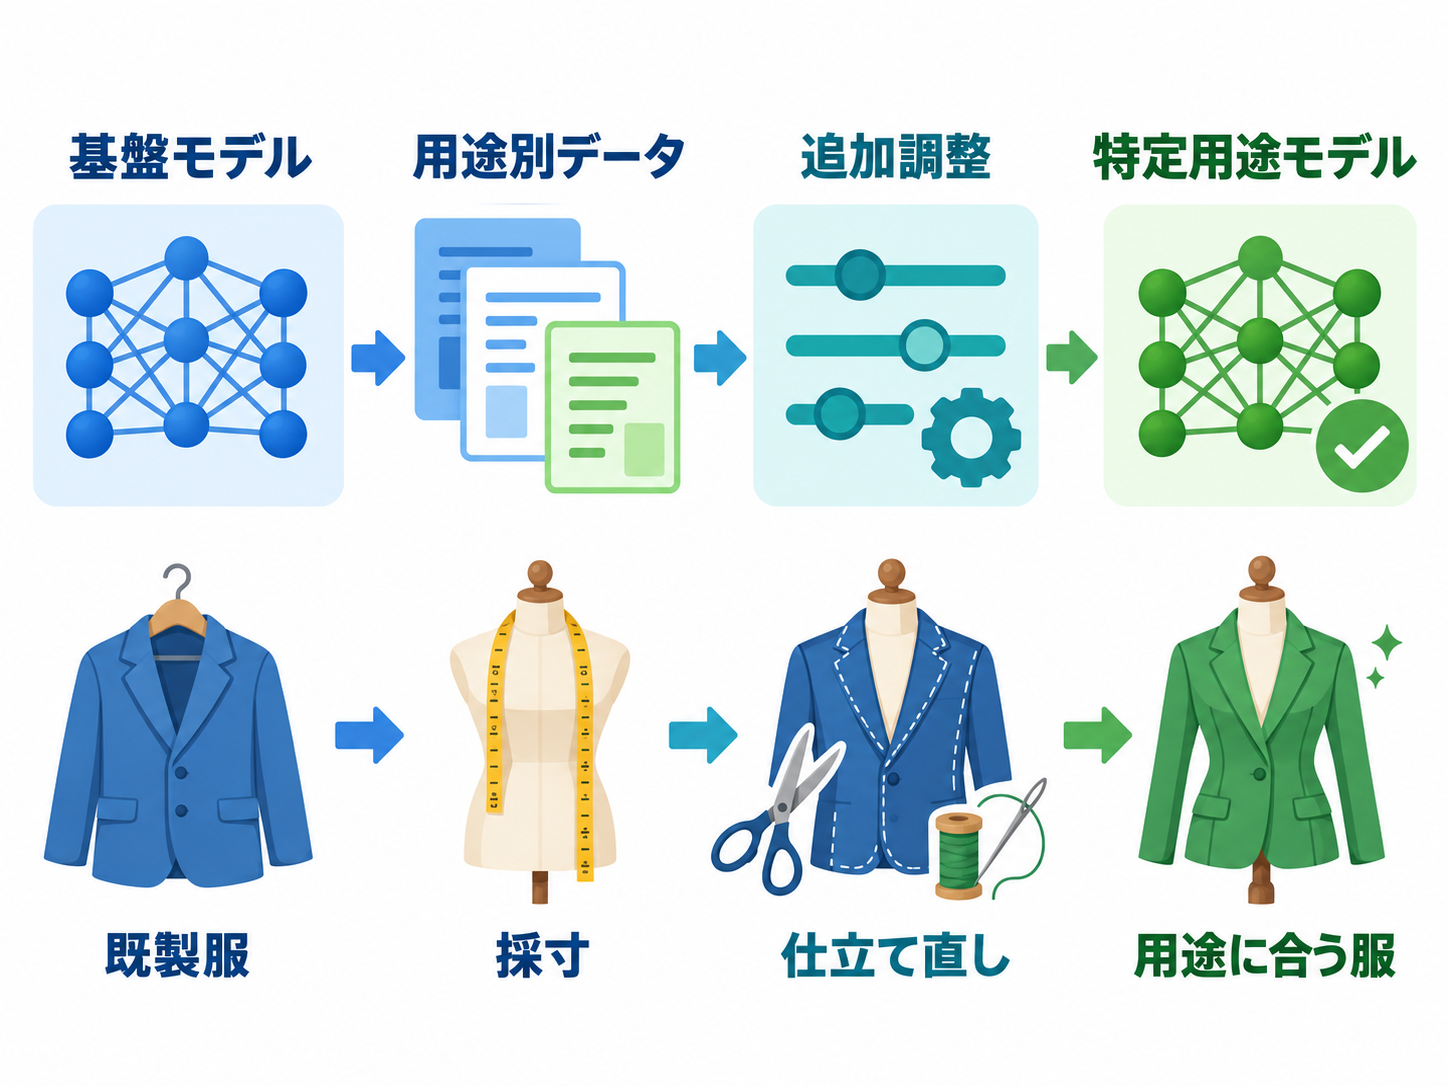
ファインチューニングは、既製服の仕立て直しにたとえると捉えやすくなります。店頭の既製服は、多くの人が使える形で作られています。そのまま着ることもできますが、袖丈や裾、胴回りを着る人に合わせて直せば、特定の用途に合いやすくなります。布を織るところから服を作り直すわけではありません。
このたとえで既製服に当たるのが、事前学習済みモデルや基盤モデルです。モデルとは、学習用データから得たパターンを使って、入力に対する出力を作る仕組みを指します。基盤モデルは大規模で多様なデータによってあらかじめ学習され、さまざまな依頼に対応する出発点になります。AIを一から作る代わりに、その土台を特定の仕事へ合わせて調整するのがファインチューニングです。(出典: IBM、Google Cloud、Google Developers)
仕立て直しに使う採寸値に相当するのが、用途に沿った学習例です。たとえば、問い合わせ文と正しい分類の組み合わせ、質問と望ましい回答の組み合わせ、入力文と指定形式に整えた出力の組み合わせなどが考えられます。これらは説明のための架空例ですが、何を入力したときに、どのような出力を望むのかを対で示す点が要所になります。
ただし、服のたとえには限界もあります。袖を数センチ短くする作業のように、AIの変化を目で正確に測れるわけではありません。ある種類の回答が改善しても、別の質問への答えまで良くなるとは限らず、調整後の出力を評価する必要があります。ファインチューニングは「何でも知っているAIへ成長させる魔法」ではなく、対象とする仕事を決め、例を用意し、その仕事への適合を確かめる工程だと考えるほうが実態に近いでしょう。
プロンプトとファインチューニングの境界
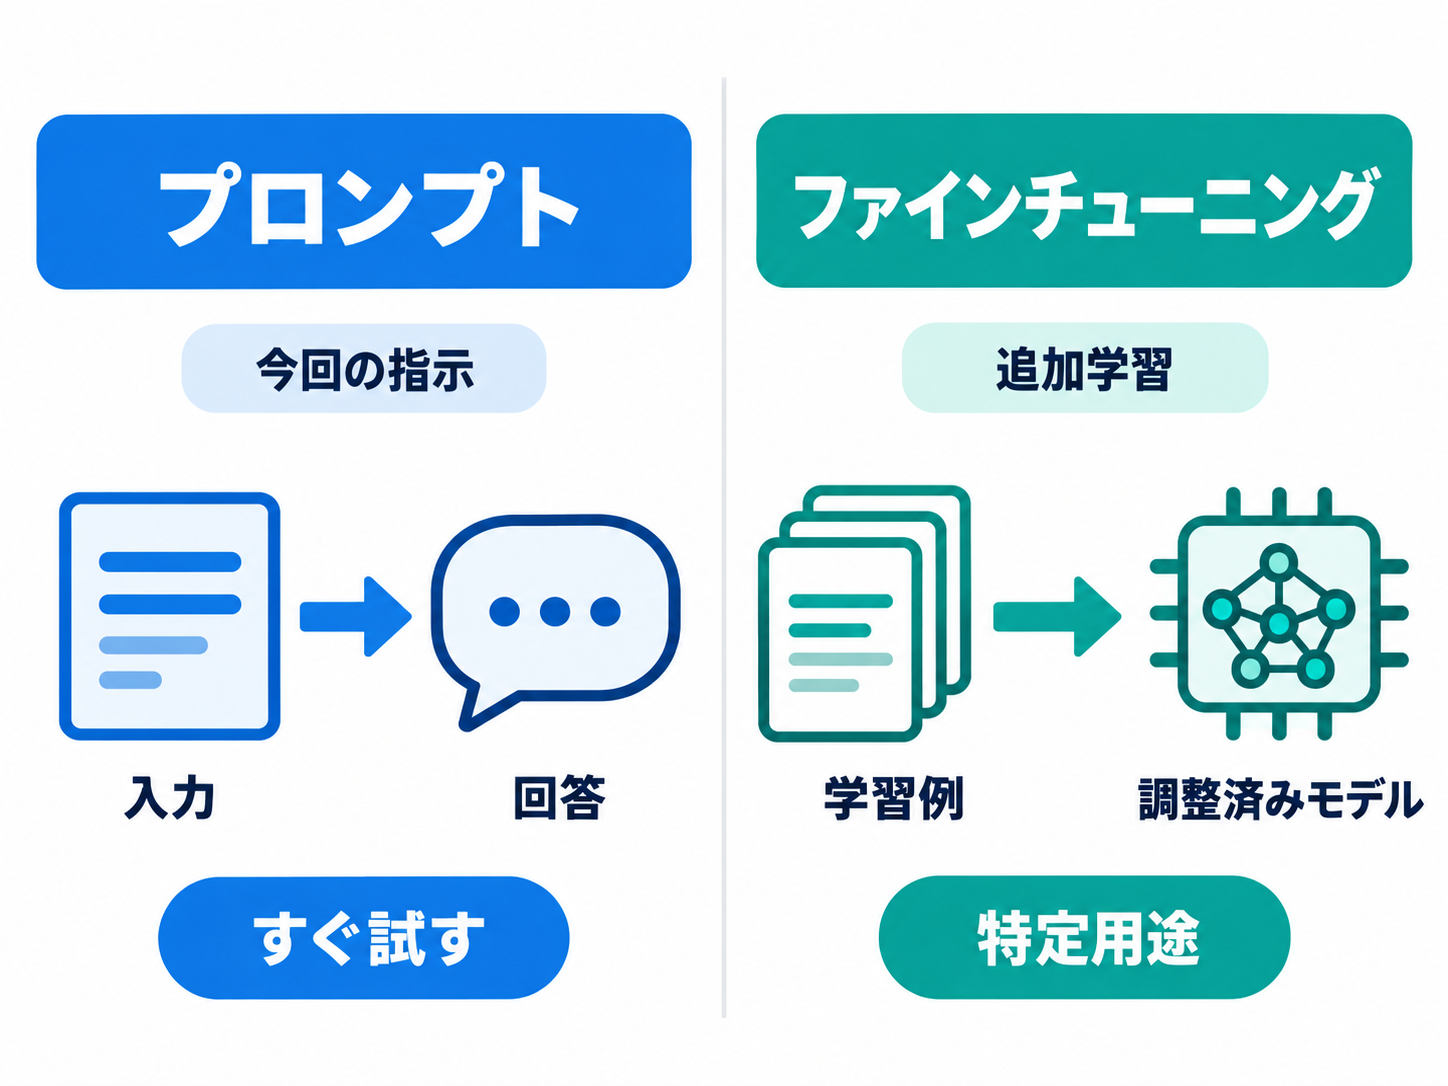
生成AIへ入力する依頼文や指示は、プロンプトと呼ばれます。プロンプトで「200字以内にしてください」「専門用語を避けてください」と指定する方法と、ファインチューニングでモデルを追加調整する方法は、どちらも出力を目的に近づけるために使われます。ただし、働きかける場所と準備の重さが異なります。
プロンプトは、その場でモデルに渡す入力です。指示のほか、背景情報や望ましい回答例を含めることもできます。Google Developersの用語集では、複数の例を含めたプロンプトを、少数例プロンプティングの一種として説明しています。モデル自体を追加学習させなくても、回答の型を例で示せるわけです。(出典: Google Developers)
| 観点 | プロンプトでの指示 | ファインチューニング |
| --- | --- | --- |
| 働きかける対象 | 今回の入力と会話の文脈 | 事前学習済みモデルの調整工程 |
| 主な材料 | 指示、背景、回答例 | 用途に沿った学習例と望ましい出力 |
| 向く場面 | 条件が毎回変わる依頼、試行段階 | 同じ種類のタスクを繰り返す用途 |
| 確認方法 | その場の回答を読み直す | 複数の評価例で調整後の品質を確かめる |
たとえば、会議メモを初めて要約するなら、「決定事項、保留事項、担当者の順に整理してください」と頼む方法が分かりやすいでしょう。出力が違えば、指示を具体化したり、短い見本を加えたりできます。これはファインチューニングではありません。
同じ形式の要約を大量かつ継続的に扱う仕組みを提供側が設計する場合は、追加調整が検討対象になる可能性があります。ただし、「繰り返す仕事なら必ずファインチューニング」という意味ではありません。プロンプトだけで安定する場合もあれば、参照資料を回答時に利用する別の仕組みが適する場合もあります。利用者としては、最初から難しい方法を選ぶより、「指示を明確にする」「見本を添える」「複数回試して崩れ方を見る」という順で切り分けると、問題の場所を見失いにくくなります。
追加調整では何を学習材料にするのか
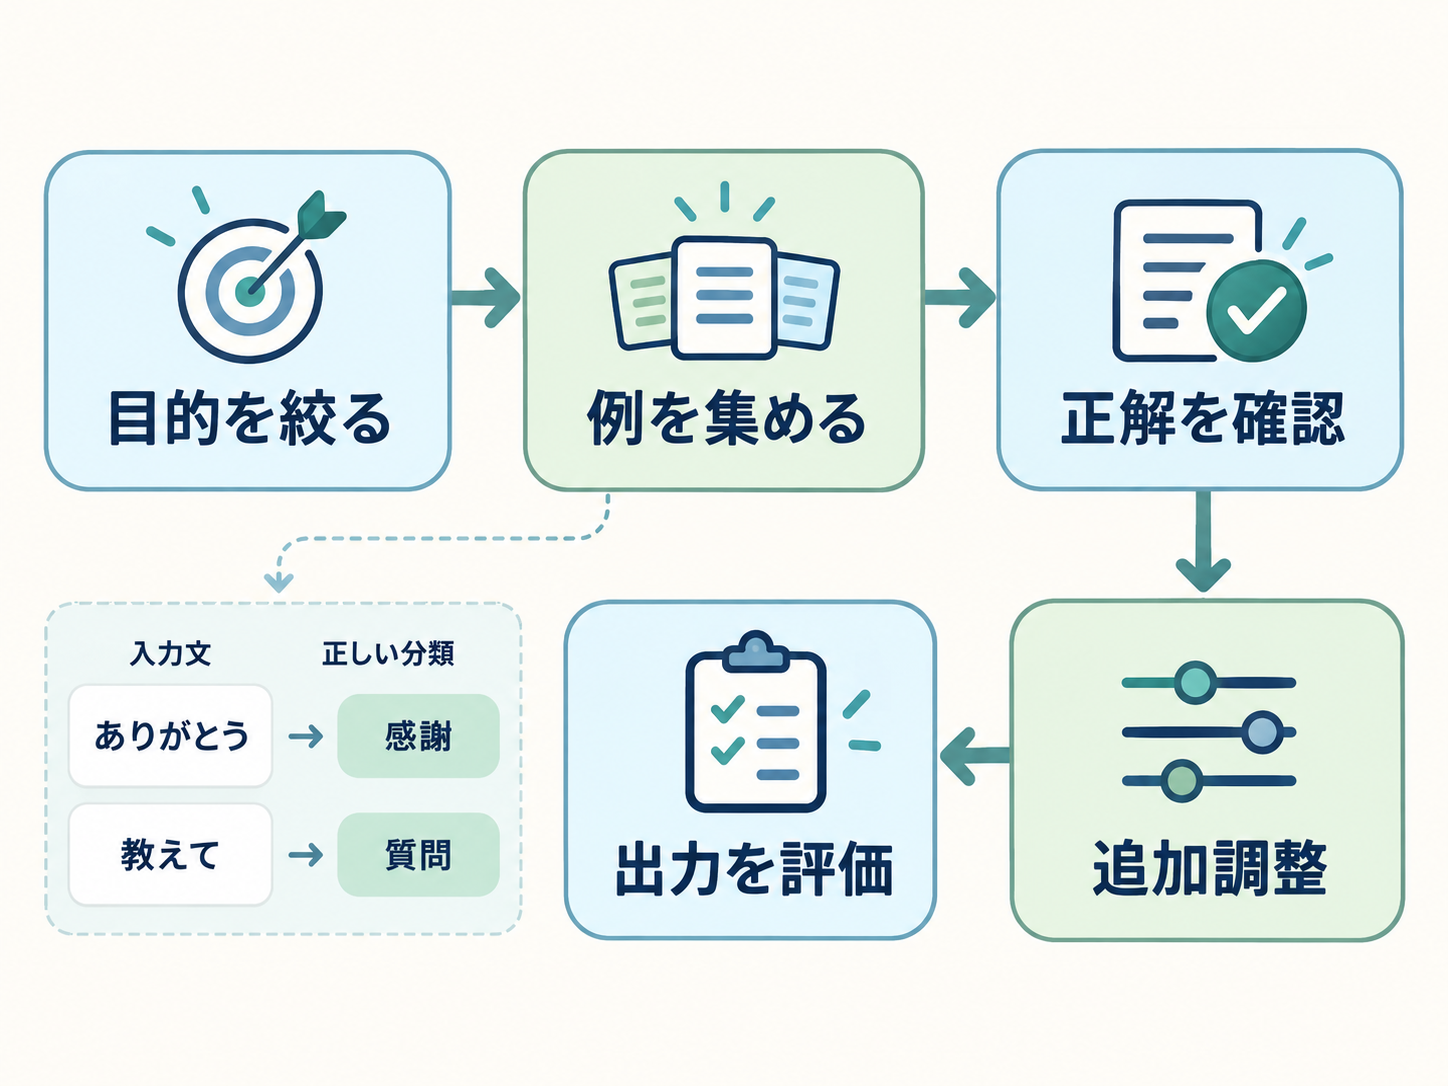
ファインチューニングでは、「どの仕事に合わせるのか」が曖昧なままでは、適切な学習例を選べません。「回答を良くしたい」では範囲が広すぎます。「問い合わせを決められた区分へ分類する」「文章を指定の形式に整える」のように、入力と期待する出力を確認できる単位まで目的を絞る必要があります。
Google Developersの用語集では、ファインチューニングは一般に、対象タスクへ焦点を合わせた数百から数千の例を使うと説明されています。ただし、これはすべての製品や用途に共通する必須件数ではありません。必要量や利用条件は、対象モデルや提供サービスによって確認すべき事項です。大切なのは件数だけでなく、それぞれの例が目的に合い、望ましい回答を一貫して示していることです。(出典: Google Developers)
説明用の架空例として、社内窓口に届く文章を「申請」「故障」「質問」の三つに分ける仕事を考えます。この場合は、過去の問い合わせ文と、人が確認した正しい区分の組み合わせが学習例の候補になります。「パソコンの画面が映りません」に対して「故障」、「手続きに必要な書類を教えてください」に対して「質問」という具合です。ただし、同じ内容を担当者ごとに別の区分へ入れていれば、モデルに示す基準も揺れてしまいます。
準備では、目的の定義、例の収集、正解や望ましい形式の確認、調整後の評価を分けて考えます。評価とは、モデルや出力の品質を測ったり、別のモデルと比較したりする工程です。生成文には唯一の正解がない場合もあるため、形式を守れているか、必要な内容が含まれているか、安全上の問題がないかなど、用途に沿った観点が必要になります。(出典: Google Developers)
つまり、ファインチューニングはAIへ資料をまとめて読ませる作業と同じではありません。用途と望ましい出力を、学習に使える例として設計する取り組みです。導入を検討するときは、モデルの選択より先に「誰が正しい例を判断するのか」を確認すると、準備の難しさが見えやすくなります。
変わりやすいことと、保証されないこと
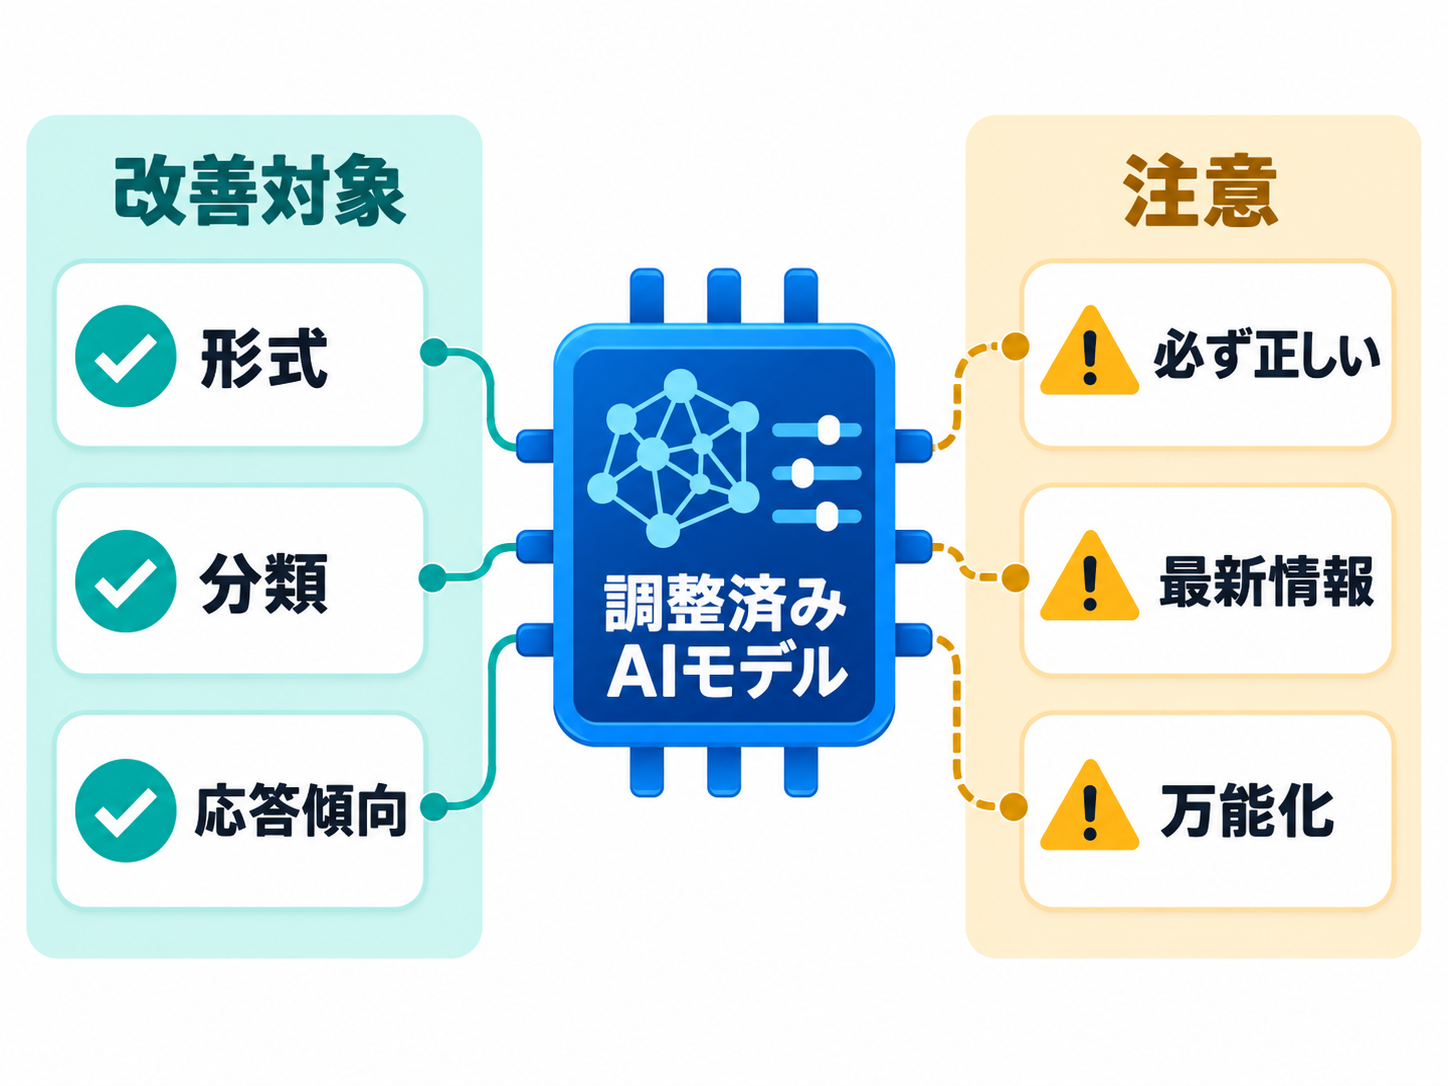
用途に合った例で追加調整すると、特定の質問への応答方法、分類の仕方、望ましい形式などを、その用途に合わせることが狙えます。IBMは、アプリケーション固有のラベル付きデータ、想定される質問やプロンプト、期待する形式の正しい回答をモデルへ与える方法としてファインチューニングを説明しています。(出典: IBM)
たとえば、説明用の提案として、商品の問い合わせを決められた項目へ整理する用途があるとします。出力項目や分類基準を学習例で一貫して示せれば、その仕事に沿った応答を目指せます。これは、AIへ新しい人格や意識を与えることではありません。学習例に含まれる入力と出力の関係に合わせて、モデルの出力傾向を調整する取り組みです。
調整後の回答が必ず正しいという保証もありません。Google Developersの用語集では、出力が現実に基づいている性質を「事実性」と説明する一方、創作を求める依頼では事実性より創造性が優先される場合も示されています。用途に合う文章形式を学んだことと、個々の回答が事実に基づくことは、同じ問題ではありません。(出典: Google Developers)
新しい出来事を自動的に知る仕組みとも限りません。ファインチューニングは、特定用途向けの第2段階の学習です。回答時に外部資料を探して利用する仕組みとは区別する必要があります。古い情報を含む例や誤った正解を使えば、それらが望ましくない影響を与えるおそれもあるため、学習材料と評価例の確認を省けません。
期待を整理するときは、「正答率が必ず上がるか」だけでなく、「どの種類の入力に対して、何を改善したいのか」を言葉にするとよいでしょう。出力形式をそろえたいのか、分類基準へ合わせたいのか、事実確認を強めたいのかで、必要な対策は変わります。ファインチューニングは、その中の一つの選択肢にすぎません。
会話で訂正しても、その場でモデルが学び直すとは限らない理由
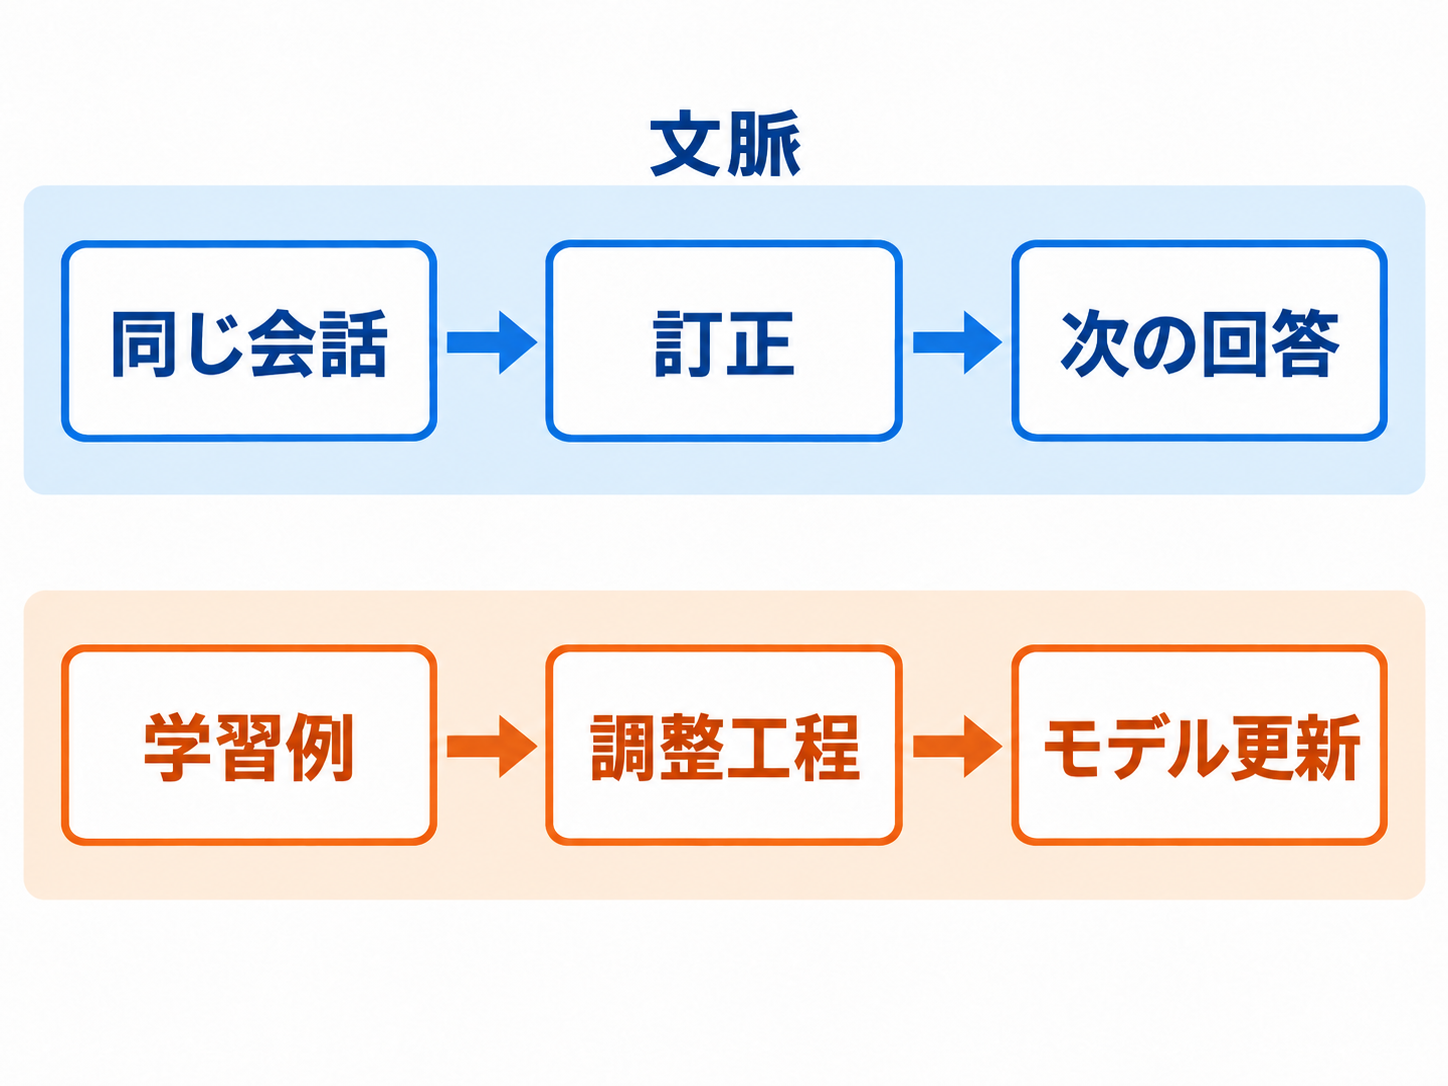
チャットで誤りを指摘したあと、次の回答でAIが修正内容を反映すると、「今の訂正を学習した」と感じるかもしれません。実際には、同じチャット内の過去のやり取りが、後続の回答に使われる文脈になった可能性があります。Google Developersの用語集でも、チャットの過去の入力と応答は、会話の後の部分に対する文脈になると説明されています。(出典: Google Developers)
文脈を使うことと、モデルのパラメータを更新することは別です。パラメータとは、学習を通じて調整され、出力に影響する内部の設定値を指します。会話中に「表ではなく文章で答えてください」と訂正し、その後の回答が文章になったとしても、それだけを見て、ほかの利用者や別の会話にも同じ変更が残ったとは判断できません。
IBMは、人間が出力の正確さや関連性を評価し、そのフィードバックを改善へ使う方法として、人間のフィードバックによる強化学習を挙げています。利用者の訂正が、提供側の定めた別の評価・調整工程で使われる可能性はありますが、訂正した瞬間に基盤モデルが書き換わるという説明ではありません。個別サービスが会話や評価をどのように扱うかは、そのサービスの案内や設定を確認する必要があります。(出典: IBM)
また、回答時に外部の関連資料を利用するRAG、つまり検索拡張生成も、ファインチューニングとは異なります。IBMはRAGを、学習データ外の関連情報源を使って生成AIアプリケーションの回答を改善する選択肢として説明しています。モデルを用途向けに追加調整する方法と、回答のたびに関連資料を参照する方法では、情報を取り込む時点が違います。(出典: IBM)
「覚えたように見える」という印象だけで仕組みを決めつけず、会話の文脈、追加学習、外部資料の参照を分けて考えると、AIの挙動を説明しやすくなります。別のチャットでも同じ指示が反映されるか、最新資料を根拠にしているかと問い直すだけでも、誤解を減らせるでしょう。
明日から使える「追加調整が必要か」の見分け方
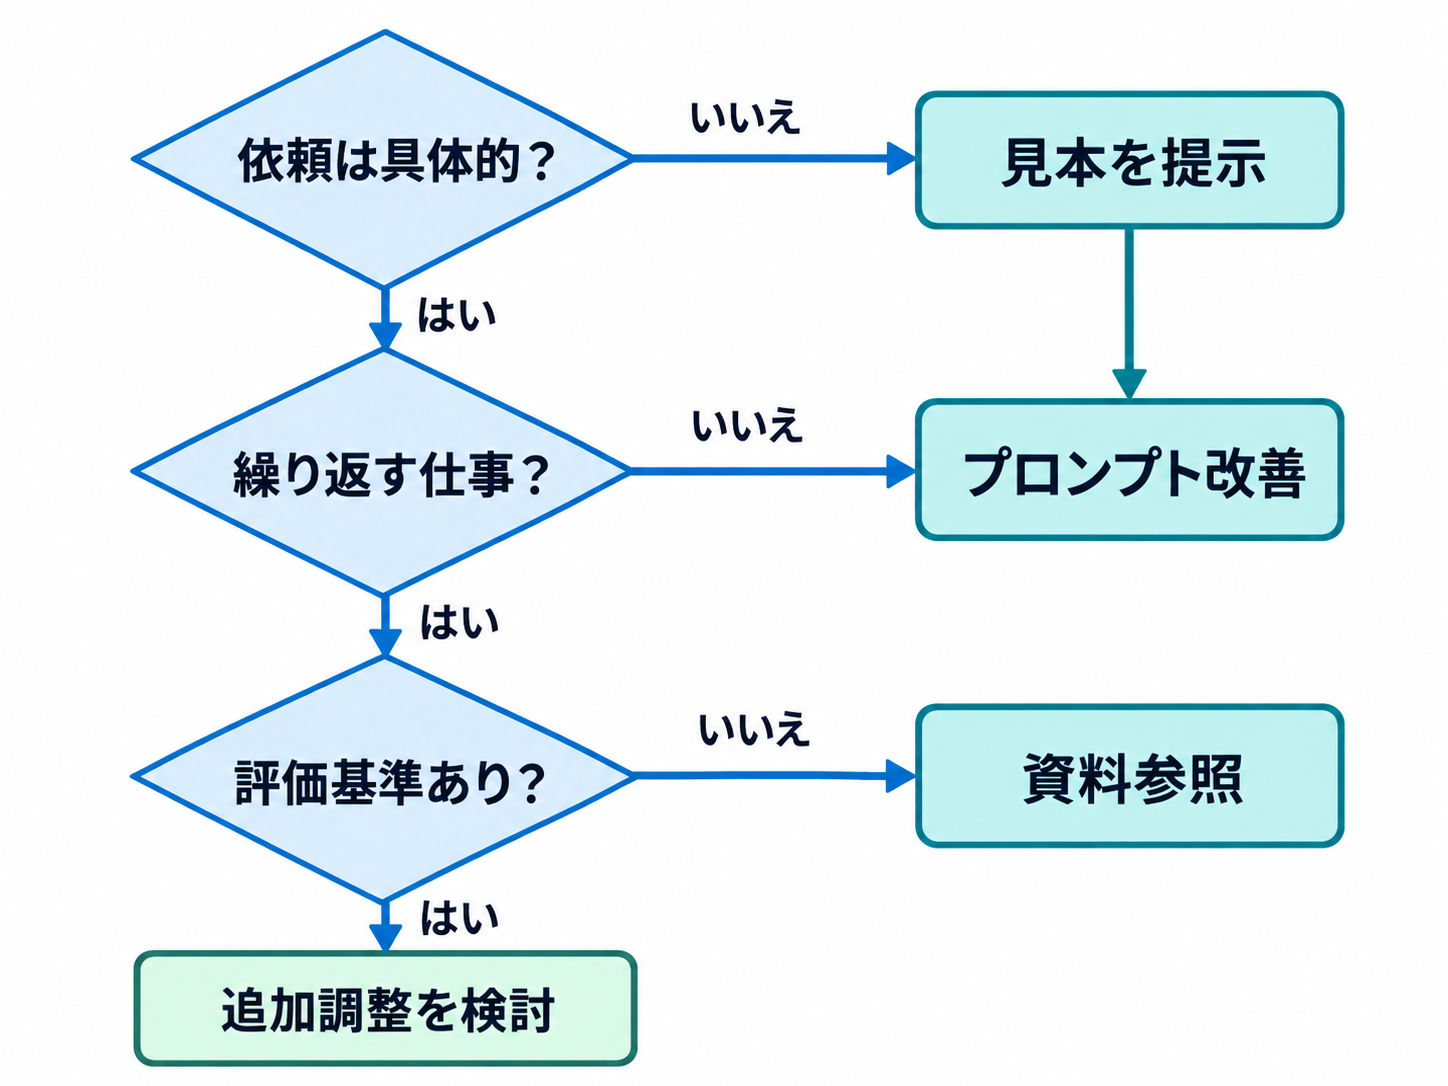
AIの回答が期待と違ったとき、最初に確認したいのは、依頼そのものが具体的かどうかです。「分かりやすくまとめてください」だけでは、長さ、読者、残す情報、出力形式が定まりません。次のように条件を補う方法は、ファインチューニングではなくプロンプトの改善例です。
> 新入社員向けに、専門用語へ短い説明を添えながら300字程度で要約してください。決定事項と未決事項を分け、本文にない事実は追加しないでください。
これは利用方法の提案であり、特定製品での効果を保証するものではありません。回答が合わなければ、望ましい出力例を一つ添えたり、何を直してほしいかを具体的に伝えたりできます。一度きりの依頼や、条件が頻繁に変わる仕事なら、この方法で十分な場合もあるでしょう。
同じ種類の入力を繰り返し扱い、毎回ほぼ同じ形式や判断基準が必要で、プロンプトだけでは崩れ方が安定しない場合は、提供者やシステム担当者へ追加調整の選択肢を確認する段階です。その際は、次の四点を言葉にしておくと相談しやすくなります。
- 対象にする仕事を一文で説明できるか
- 入力と望ましい出力の組み合わせを用意できるか
- 正しい例を判断する担当者が決まっているか
- 調整後の出力を評価する基準があるか
ここまで整理しても、ファインチューニングが最適とは限りません。更新される社内資料を根拠に答えさせたいなら、回答時に関連資料を参照する仕組みが検討対象になる可能性があります。書き方をその都度変えたいだけなら、プロンプトの工夫が扱いやすいでしょう。具体的な提供条件や利用可否はサービスによって異なるため、公式案内で確認する必要があります。
明日試せる一歩は、AIへ「覚えてほしい」と考えた内容を、指示、見本、知識のどれに当たるか分類することです。指示ならプロンプトへ書き、見本なら望ましい回答例として示し、更新される知識なら参照元の扱いを確認します。それでも同じ仕事で出力が安定しないときに、初めてファインチューニングという選択肢を検討すると、手段と目的を取り違えにくくなります。
参考情報
- What Is Artificial Intelligence (AI)?(IBM、2024年8月9日公開、2026年10月2日更新、2026年10月31日取得)
- AI vs. Machine Learning: How Do They Differ?(Google Cloud、2026年10月31日取得)
- Machine Learning Glossary: Generative AI(Google Developers、2026年10月31日取得)