
2026/10/31
AIニュース
Factory Droid 1.0が変えるAIコーディングエージェントの実行方式――1回のモデル要求で数百のツール操作へ
Droid 1.0の核心はモデルではなく「実行のさせ方」
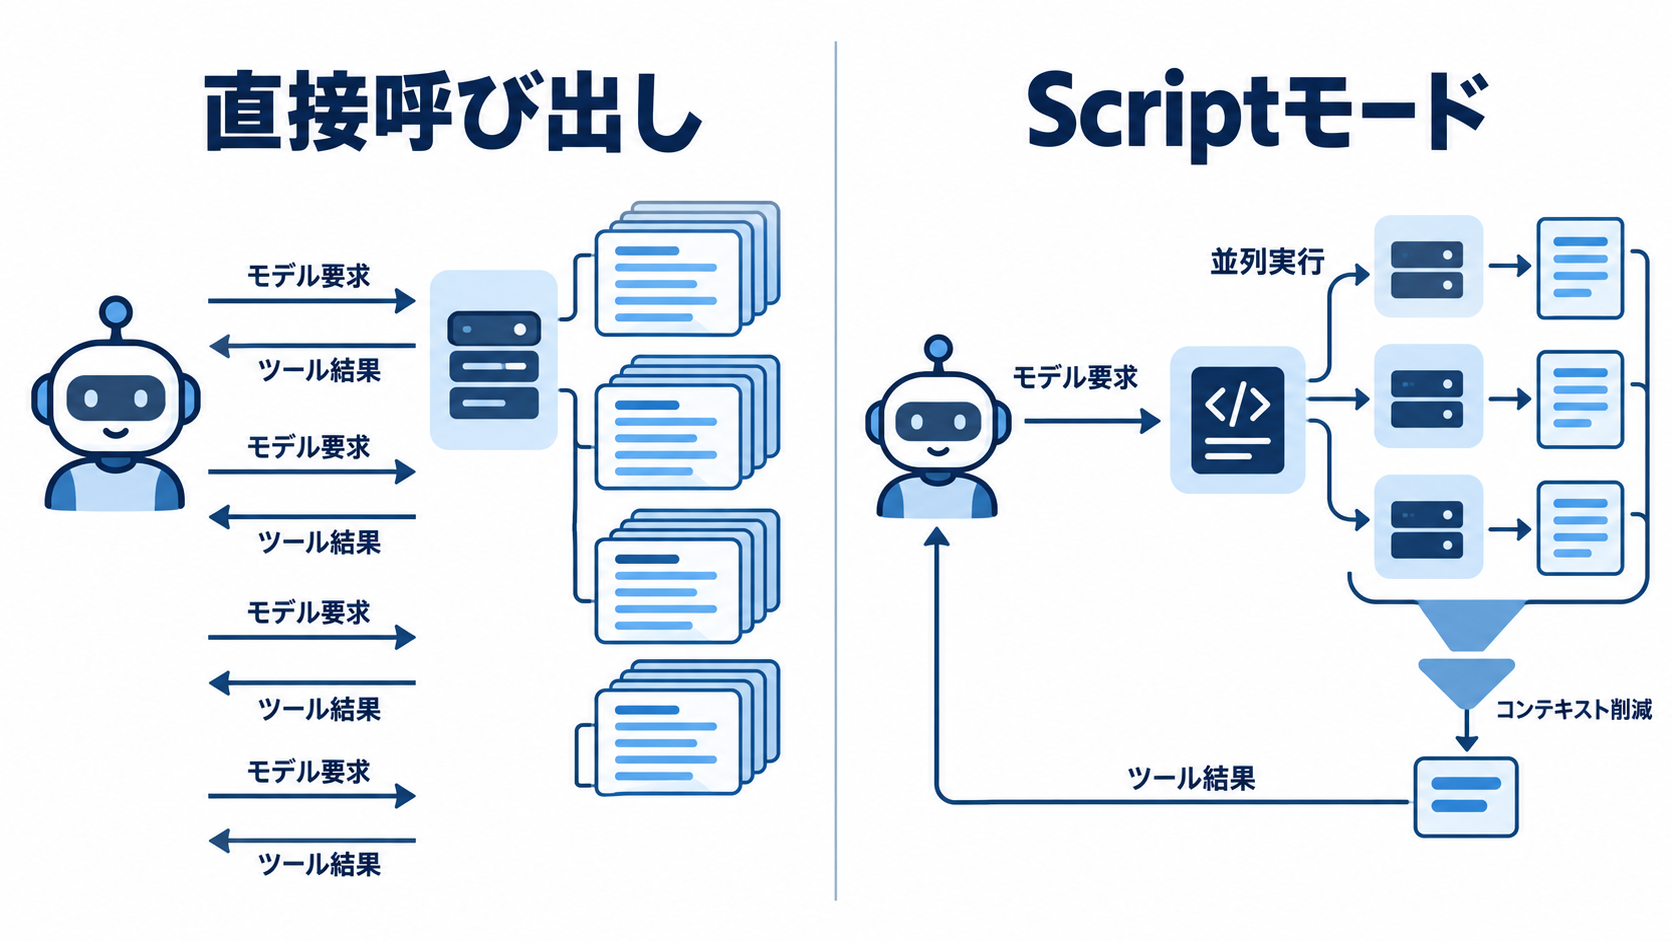
AIコーディングエージェントに複雑な作業を任せると、ファイル検索、ログ確認、テスト実行、課題管理ツールの更新といった操作が何度も発生します。従来型の仕組みでは、操作のたびに結果を言語モデルへ戻し、モデルが次の指示を考えるという往復が基本でした。作業が長くなるほどモデルへの要求回数と入力トークンが増え、時間と費用の両面で負担になりやすい構造です。
Factoryが公開したDroid 1.0は、この往復を減らす「プログラマティック・ツール・コーリング」を標準機能に据えました。モデルがツールを一つずつ呼び出すのではなく、複数の操作を実行するプログラムを書きます。1回のモデル要求から数百回のツール呼び出しを進められるため、今回の更新で注目すべき点は、特定の言語モデルの性能向上ではなく、モデルを取り巻く実行基盤の再設計にあります。
Factoryは、プロンプト、利用可能なツール、実行結果をモデルへ返す方法、処理を継続するループ全体を「ハーネス」と呼んでいます。Droidは特定モデル専用ではなく、対応モデルから利用者が選ぶことも、Factory Routerに費用対効果を考慮した選択を任せることもできます。自社のAPIキーを使える点も含め、モデルそのものと、モデルを業務として動かす仕組みを分離した設計です。
Droid 1.0の発表は、AIエージェントの比較軸がモデル単体の賢さだけでは足りないことを示しています。同じモデルを使っても、ツールの渡し方やコンテキストの管理方法によって、成功率、処理時間、費用が変わり得るからです。企業がコーディングエージェントを選ぶ際には、採用モデルだけでなく、実行基盤が長い作業をどのように制御するかまで確認する必要があるでしょう。
JavaScriptを介してツールを動かすScriptモードの仕組み
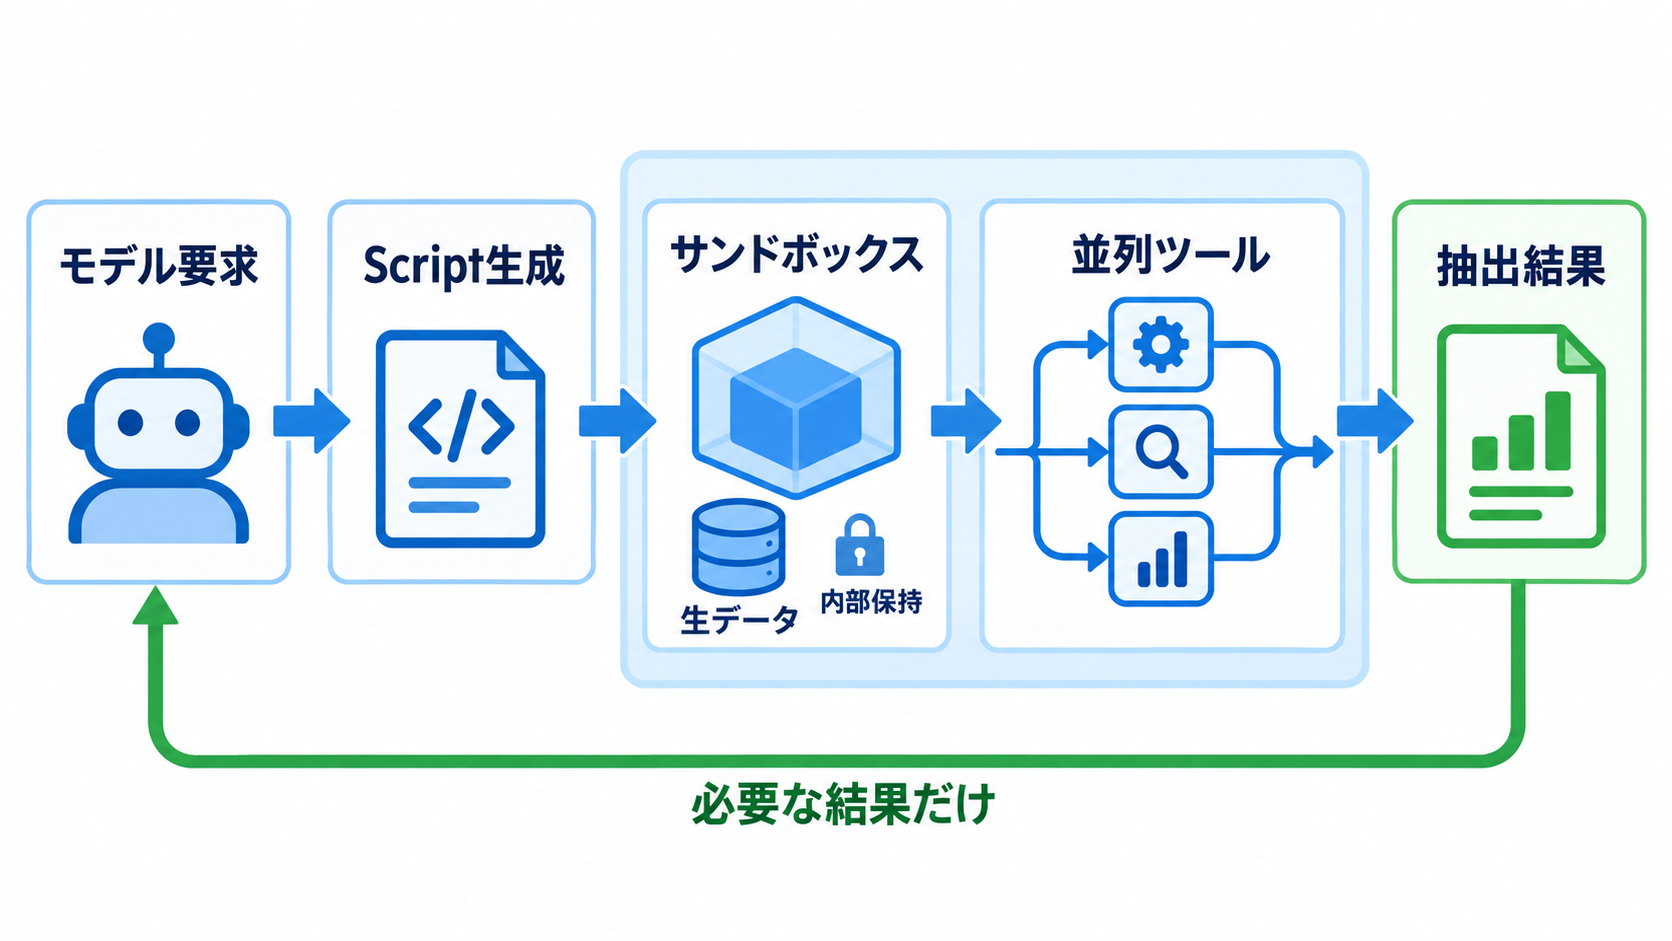
プログラマティック・ツール・コーリングを担うのが、DroidのScriptツールです。モデルは実行したい処理をJavaScriptとして記述し、そのコードがサンドボックス内で動作します。サンドボックス自体には、ファイル、ネットワーク、OSのシステム機能へ直接アクセスする権限がありません。必要な操作は、Droidが用意したツールをプログラムから呼び出す形で進められます。
通常のエージェントループでは、ファイルの中身、検索結果、長いログなどがツールの出力としてモデルのコンテキストへ入り込みます。Scriptモードでは、これらの生データをプログラム内に保持し、抽出や集計を終えた結果だけを出力できます。モデルへ戻るのはプログラムが明示的に表示した情報に限られるため、判断に不要な大量データでコンテキストを圧迫しにくくなります。互いに依存しないツール操作を並行実行できることも、待ち時間を抑える要素です。
この考え方は、言語モデルにコードを書かせ、その実行結果を観察しながら課題を解かせるCodeActの研究を踏まえています。ただし、任意のコードに端末全体へのアクセスを与える方式ではありません。プログラムを制限された環境で動かし、許可されたツールを窓口にすることで、まとめて実行できる柔軟性とアクセス制御の両立を図っています。
たとえば多数のCIジョブを調査する場合、モデルがジョブを一件ずつ読み、その都度次の操作を決める必要はありません。プログラム側で対象を列挙し、失敗状態を調べ、必要な項目だけをまとめて返せます。モデルは大量の取得処理ではなく、結果の解釈や次の方針決定に計算資源を使えるわけです。もっとも、どの情報を表示するかはモデルが書いたプログラムに左右されます。重要な例外を集計段階で落とさない設計や、実行履歴を監査できる仕組みは、企業利用で別途確認したいポイントです。
ツール呼び出しの集約がコストとコンテキストを削減
Factoryが公開した事例では、Scriptモードの効果はツールの呼び出し回数そのものより、モデルとの往復をどこまで減らせるかに表れています。単体テストの修正では、15回のツール操作に必要なモデル要求が10回から5回へ減り、完了時間は56.8秒から41.6秒になりました。課題管理サービスLinear上の整理作業では、151件の課題を移動して確認する312回の操作を、2回のモデル要求と約6万1,000トークンで処理したとしています。Factoryの試算では、直接呼び出す方式なら36回の要求と約310万トークンが必要でした。
CIの調査事例では、547回の実行に含まれる5,384件のジョブを2回の要求で処理し、ツール結果のうちモデルのコンテキストへ届いた割合は0.1%未満でした。これはモデルが確認すべき情報を減らせる利点を端的に示しています。ただし、掲載値はいずれもFactory自身のセッションに基づく結果です。実際の削減幅は、データ量、操作間の依存関係、モデルが生成するスクリプトの質によって変わると考えたほうがよいでしょう。
Claude Opus 5.5を使った比較では、Scriptモードによって直接ツールを呼び出す場合よりDroidの費用が15%下がったと報告されています。この機能はGPT-6.1 SolやKimi K3を含む10モデルで標準有効化されています。すべてのモデルで同じ効果が保証されているわけではありませんが、モデルの推論能力を高価なデータ取得の繰り返しに使わず、プログラムによる定型処理へ移す方針は合理的です。
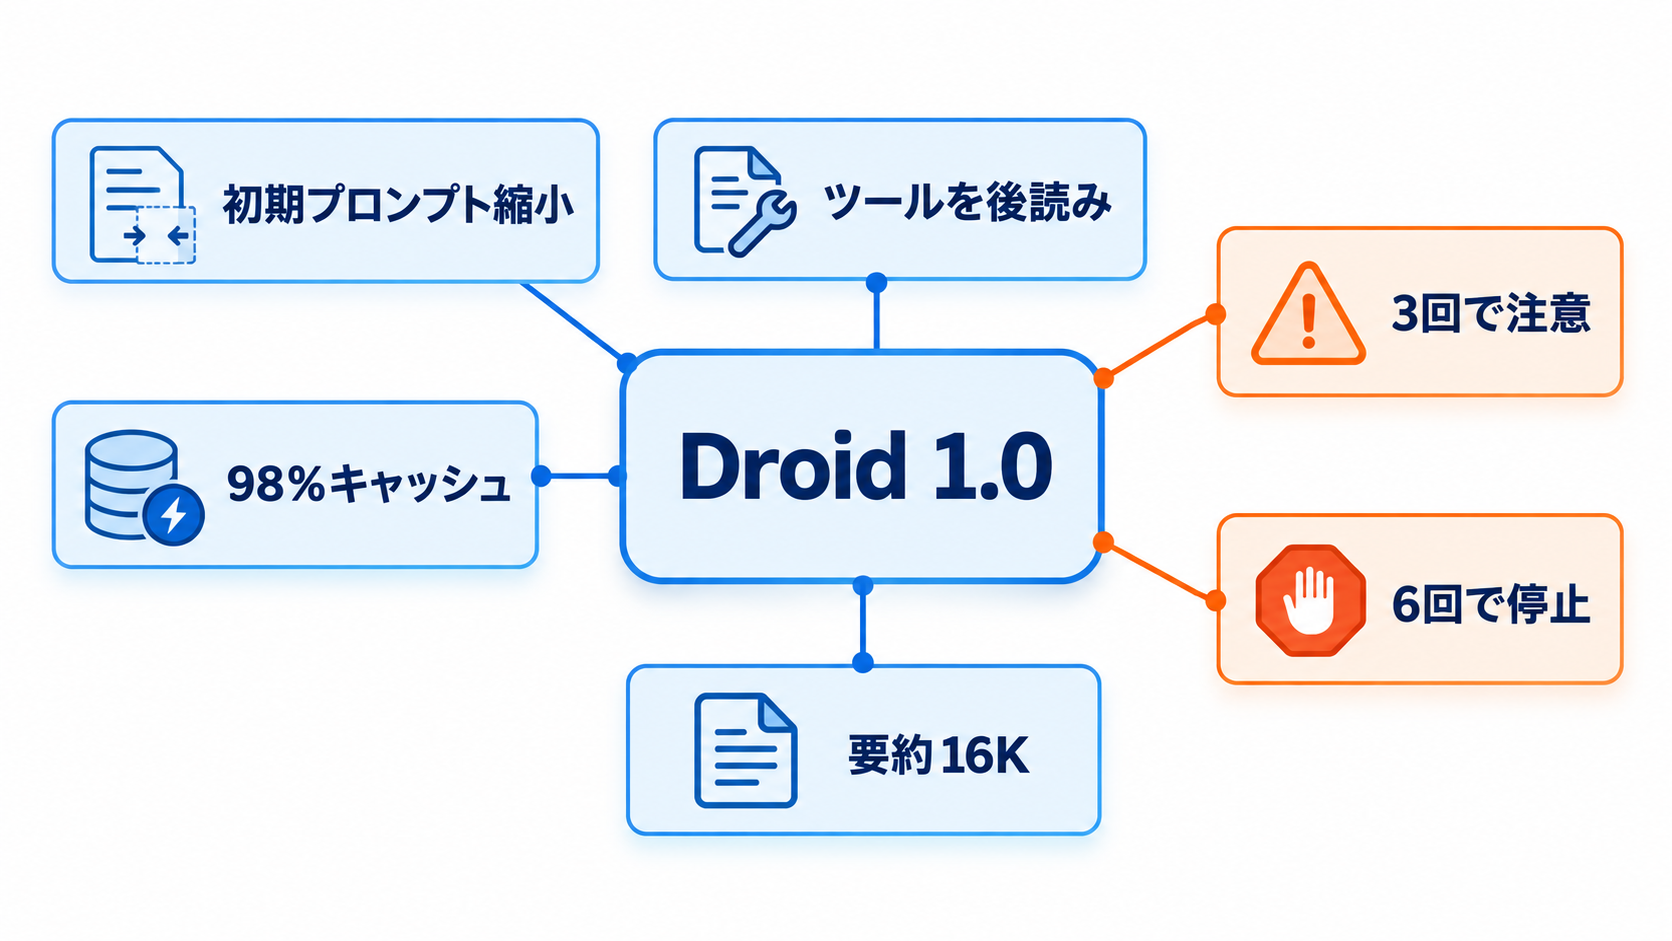
初期プロンプトも20,887トークンから13,055トークンへ37%縮小されました。最初から渡すツール定義は11個から2個になり、利用頻度の低いツールは必要になった時点で読み込まれます。長いプロンプトを単純に削ったのではなく、常時必要な情報とオンデマンドで取得できる情報を分けたことが、今回の効率化を支えています。
Terminal-Bench 4の結果をどう読むか
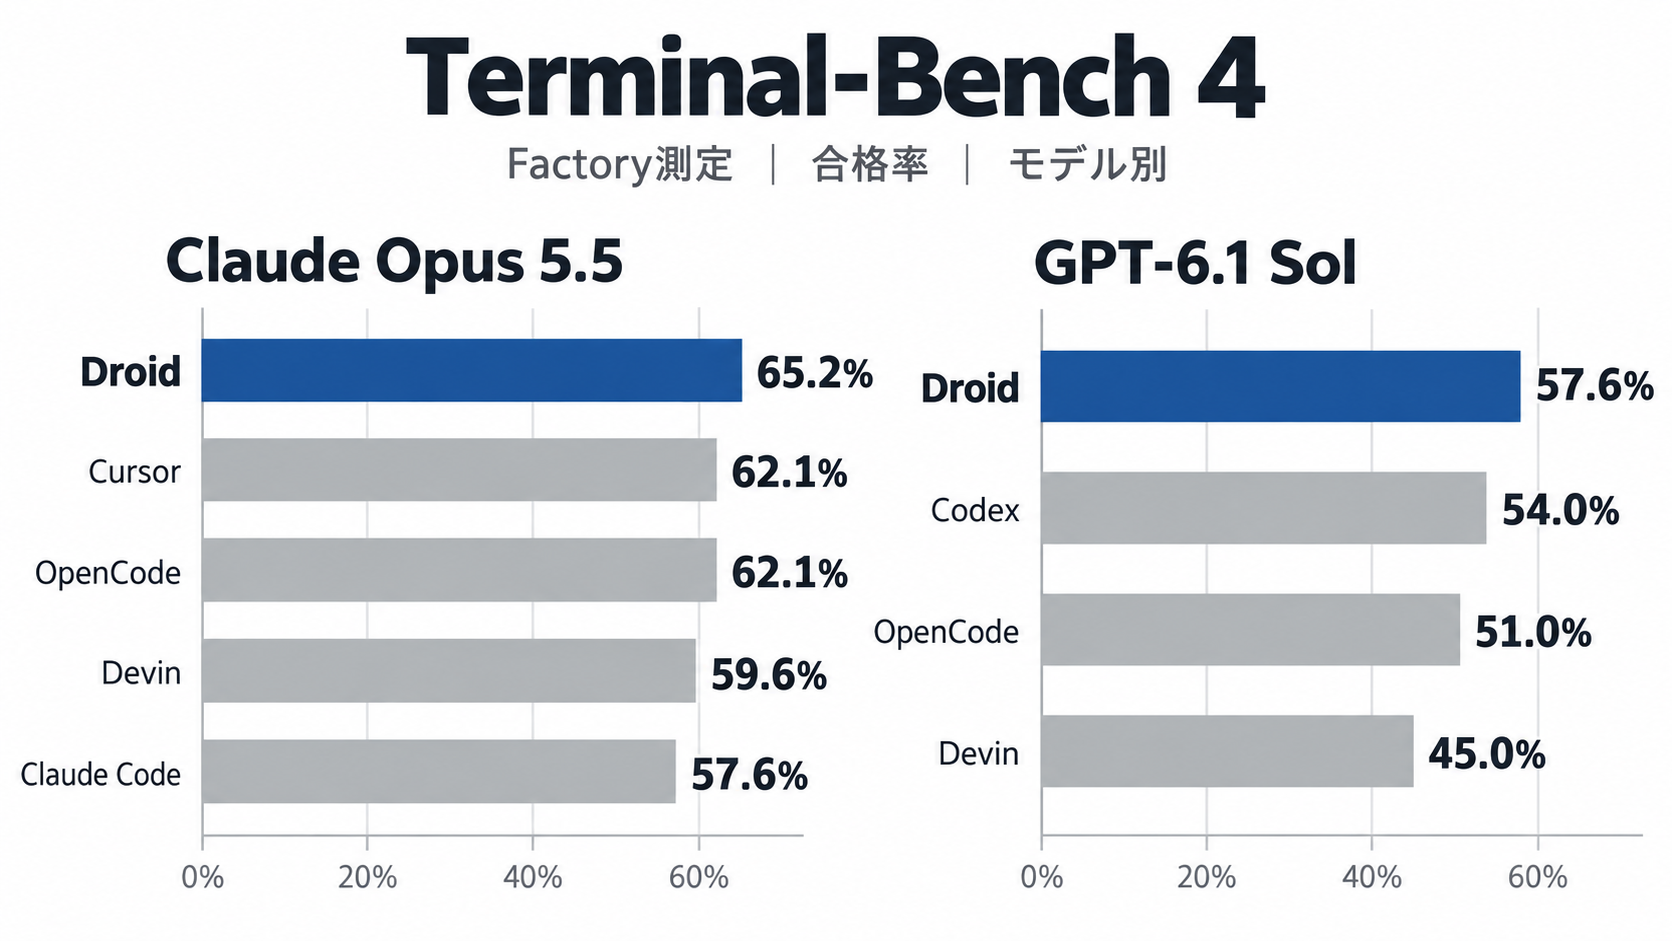
Factoryは、端末上で行う実務的な課題を評価するTerminal-Bench 4を使い、Droidと複数のコーディングエージェント用ハーネスを比較しました。2026年10月23日から28日にかけて、同じモデルを使い、各課題を3回ずつ試行しています。費用と所要時間の比較には、両方のハーネスが3回すべて成功した課題だけが含まれました。モデル条件をそろえているため、ハーネスの違いを見る材料にはなりますが、測定と公表の主体がFactoryである点は押さえておく必要があります。
| 使用モデル | ハーネス | 合格率 | 補足 |
| --- | --- | --- | --- |
| Claude Opus 5.5 | Droid | 65.2% | 1合格あたり4.73ドル |
| Claude Opus 5.5 | Cursor | 62.1% | Factoryによる測定 |
| Claude Opus 5.5 | OpenCode | 62.1% | Factoryによる測定 |
| Claude Opus 5.5 | Devin | 59.6% | Factoryによる測定 |
| Claude Opus 5.5 | Claude Code | 57.6% | Factoryによる測定 |
| GPT-6.1 Sol | Droid | 57.6% | 1合格あたり0.79ドル |
| GPT-6.1 Sol | Codex | 54.0% | Factoryによる測定 |
| GPT-6.1 Sol | OpenCode | 51.0% | Factoryによる測定 |
| GPT-6.1 Sol | Devin | 45.0% | Factoryによる測定 |
Claude Opus 5.5では、Droidの合格率は65.2%でした。比較対象に対して費用は最大24%低く、合格した課題あたりの時間も16%から26%短かったとされています。Claude Codeとの比較では、使用トークンも17%少ない結果でした。GPT-6.1 Solを使った場合、Droidは57.6%、Codexは54.0%となり、合格率ではDroidが上回っています。
ただし、速度はすべての組み合わせでDroidが優位だったわけではありません。GPT-6.1 Solでは、合格した課題あたりの所要時間がCodexより10%長くなりました。この差は、ハーネスの優劣を一つの順位だけで決められないことを示しています。成功率を重視するのか、完了までの時間を重視するのか、あるいは費用を抑えたいのかによって選択は変わるでしょう。自社評価では、公開ベンチマークだけでなく、実際のリポジトリやCI環境に近い課題を用意し、失敗時の再試行まで含めて測ることが欠かせません。
プロンプト圧縮だけではないハーネス全体の改良
Droid 1.0では、Scriptモード以外にも長時間のエージェント処理を支える変更が加えられました。Factoryは、エージェントが失敗例を読み、改善案を提案し、影響を受けるモデル群で検証する社内ループを利用したと説明しています。提案は自動的に製品へ反映されるのではなく、エンジニアが確認して統合する流れです。モデルを使ってハーネスを改善しながら、人間によるレビューを残す構成になっています。
プロンプトキャッシュでは、新しく読み込んだツールを要求の末尾へ追加するようになりました。通常の本番要求では、入力の98%がキャッシュから読み込まれるとFactoryは報告しています。先頭部分が頻繁に変わるとキャッシュを再利用しにくくなるため、変更の生じやすい定義を後ろへ配置する設計には、モデルへの入力費用を抑える狙いがあります。初回要求に含まれるツール定義も46%減り、使用頻度の低い機能は必要になるまで読み込まれません。
自律動作には上限が設けられました。同一のツール呼び出しが3回続くと軌道修正を促し、6回に達するとループを停止します。エージェントが誤った操作を繰り返し、費用や時間を消費し続ける事態を抑えるための仕組みです。長いセッションを圧縮して保持する要約の上限は、8,000トークンから16,000トークンへ拡大されました。情報量を削減しながらも、以前の判断や作業経緯を残せる余地が広がっています。
利用者が直接感じる改善として、アプリの初回描画時間は1,839ミリ秒から488ミリ秒へ短縮されました。追加セッションあたりのメモリ使用量も約350MBから約20MBになったとされています。複数の作業を並行して開く運用では、モデルの推論性能だけでなく、クライアント側の応答性とメモリ消費も生産性に影響します。今回の更新は、AIの回答品質、実行の安定性、アプリとしての使い勝手を一つのハーネス改善として扱っている点に特徴があります。
デスクトップ、端末、Node SDKで広がる利用形態
Droid 1.0は、macOSおよびWindows向けデスクトップアプリ、端末で操作するTUI、Node向けのDroid SDKとして提供されます。Droid SDKでは、デスクトップ版や端末版と同じハーネスを利用し、セッション管理、ストリーミング、MCPツールとの連携をアプリケーションへ組み込めます。開発者個人の対話的な作業だけでなく、社内ツールや自動化フローの一部として実行する選択肢も用意されている形です。
モデル非依存を掲げているため、利用者は対応モデルと自分のAPIキーを組み合わせられます。モデル選定を固定したくない組織にとっては、課題の難しさや費用に応じて構成を変えられる余地があります。Factory Routerへ選択を任せる方法もありますが、モデルごとのデータ取り扱い、契約条件、出力特性まで自動的に同一になるわけではありません。企業で使う場合は、ルーターが選べるモデルの範囲と、自社ポリシーに適合しないモデルを除外できるかを確認したいところです。
有料プランは月額20ドルからとされています。ライセンスについては、Droid SDKがApache 2.0である一方、ハーネス全体のライセンスは公開情報上で明示されていません。OpenAIのCodex CLIはApache 2.0、OpenCodeはMITライセンスとされており、単純な月額料金だけでは導入条件を比較できません。ソースコードの確認可能範囲、社内環境への組み込み方、サポート、利用するモデルのAPI費用を分けて検討する必要があります。
Droidが提供する複数の利用形態は、同じ実行基盤を個人作業とシステム連携の双方へ展開できることを意味します。ただし、SDKを導入する場合は、デスクトップアプリを試す場合よりも運用責任が広がります。認証情報の管理、実行ログの保存、ツール権限、失敗時の再実行条件をアプリケーション側でどう扱うかまで設計して初めて、業務フローとして安定した運用に近づくでしょう。
日本企業が検証時に見るべき三つの論点
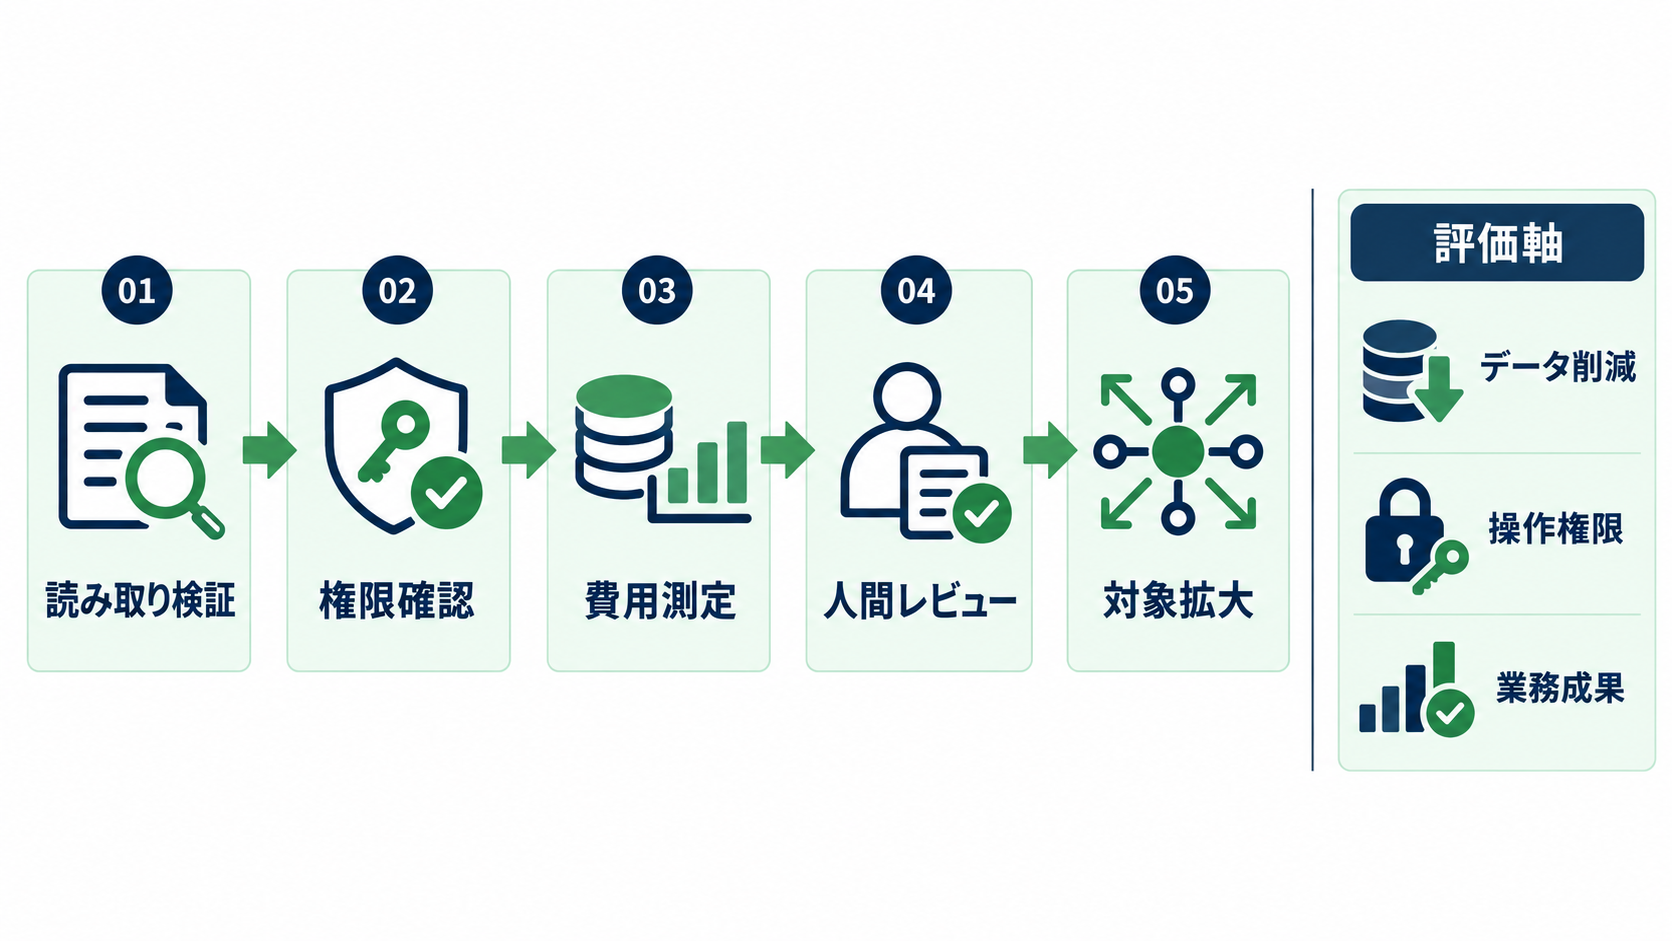
Droid 1.0を評価する際は、公開された合格率だけを導入判断に使わず、「データ削減」「操作権限」「業務上の成果」の三つに分けて検証すると整理しやすくなります。Scriptモードはモデルへ送るツール結果を大幅に減らせますが、コンテキストに入らなかったデータが不要だったかどうかは別の問題です。大量ログの中に重要な警告が一件だけ含まれる状況を想定し、要約や抽出後も問題を検出できるかを確かめる必要があります。
操作権限の確認では、JavaScriptがサンドボックス内で動くという説明に加え、各ツールがアクセスできる範囲を調べます。ファイル更新、課題管理サービス、CI、外部APIなどは、それぞれ最小限の権限に分けるのが基本です。同じ操作が6回続いた場合に停止する制御は暴走対策になりますが、異なる操作を繰り返すケースまで防げるとは限りません。書き込み操作の承認条件、1セッションあたりの費用上限、監査ログの保存方法も検証項目に含めたいところです。
業務上の成果は、成功率だけでなく、レビューに要した人間の時間を含めて測るべきでしょう。エージェントが課題を完了しても、変更内容の確認や修正に長時間かかれば、開発チーム全体の負担は減りません。小規模な試行では、自社で頻出するテスト修正、CI失敗の分類、複数ファイルをまたぐ調査などを対象にし、完了時間、API費用、成功率、人間による手直し時間を記録すると比較しやすくなります。
最初からリポジトリへの広い書き込み権限を与える必要はありません。読み取り中心のログ調査や、変更案の作成から始め、再現性と監査性を確認した後に対象を広げる方法が現実的です。Droid 1.0が示したのは、数百回のツール操作をまとめられるという能力だけではなく、その間に何をモデルへ見せ、何をプログラム内にとどめるかという設計の重要性です。導入候補を比較するときは、同じモデルと同じ社内課題を使い、ハーネスによる差を測るところから始めるとよいでしょう。