
AI LAB
2026/10/23
You.com、企業向けAI基盤「Inference Router」を投入 99.9%稼働保証とデータ非保持で導入障壁を狙う
オープンウェイトモデルを検証止まりにしないAPI基盤
高性能なオープンウェイトモデルを試験導入できても、本番環境へ移す段階で計画が止まることがあります。モデルの精度や料金だけでなく、障害時の切り替え、入力データの保存、処理地域、契約条件といった確認事項が一気に増えるためです。You.comが提供を開始した「Inference Router」は、この検証環境と本番運用の間にある溝を埋めることを狙ったマネージドAPIです。利用できるのは、Kimi K3、Qwen3.8 Max、GLM 5.3、DeepSeek V4 Pro、GPT-OSS 120Bなど12モデルです。APIはOpenAI互換およびAnthropic互換のルートを備え、既存のSDKコードではベースURLとAPIキーを変更することで移行できると説明されています。企業側がGPUを調達し、モデルごとの推論サーバーを管理する必要はありません。従量課金制で、プラットフォーム利用料も設定されていません。
ここでいうオープンウェイトとは、学習済みのモデル重みを利用できる形態を指します。ソースコードや学習データまで含めて自由に扱える「オープンソース」とは必ずしも同義ではなく、ライセンスや用途制限はモデルごとに確認が必要です。それでも、特定企業の非公開モデルだけに依存せず、性能、価格、応答速度などに応じて選択肢を持てる点は企業利用で注目されます。
Inference Routerの中心的な価値は、単に12モデルを一つの窓口に集めたことではありません。99.9%以上の稼働率を定めたSLA、ゼロデータ保持、米国内でのホスティング、サーバー側のウェブ検索を一つのサービス条件としてまとめています。トークン単価で最安を目指すというより、社内審査を通して継続運用するための条件を商品化したサービスと捉えるほうが実態に近いでしょう。
自社推論基盤を優先するルーティングと障害時の切り替え
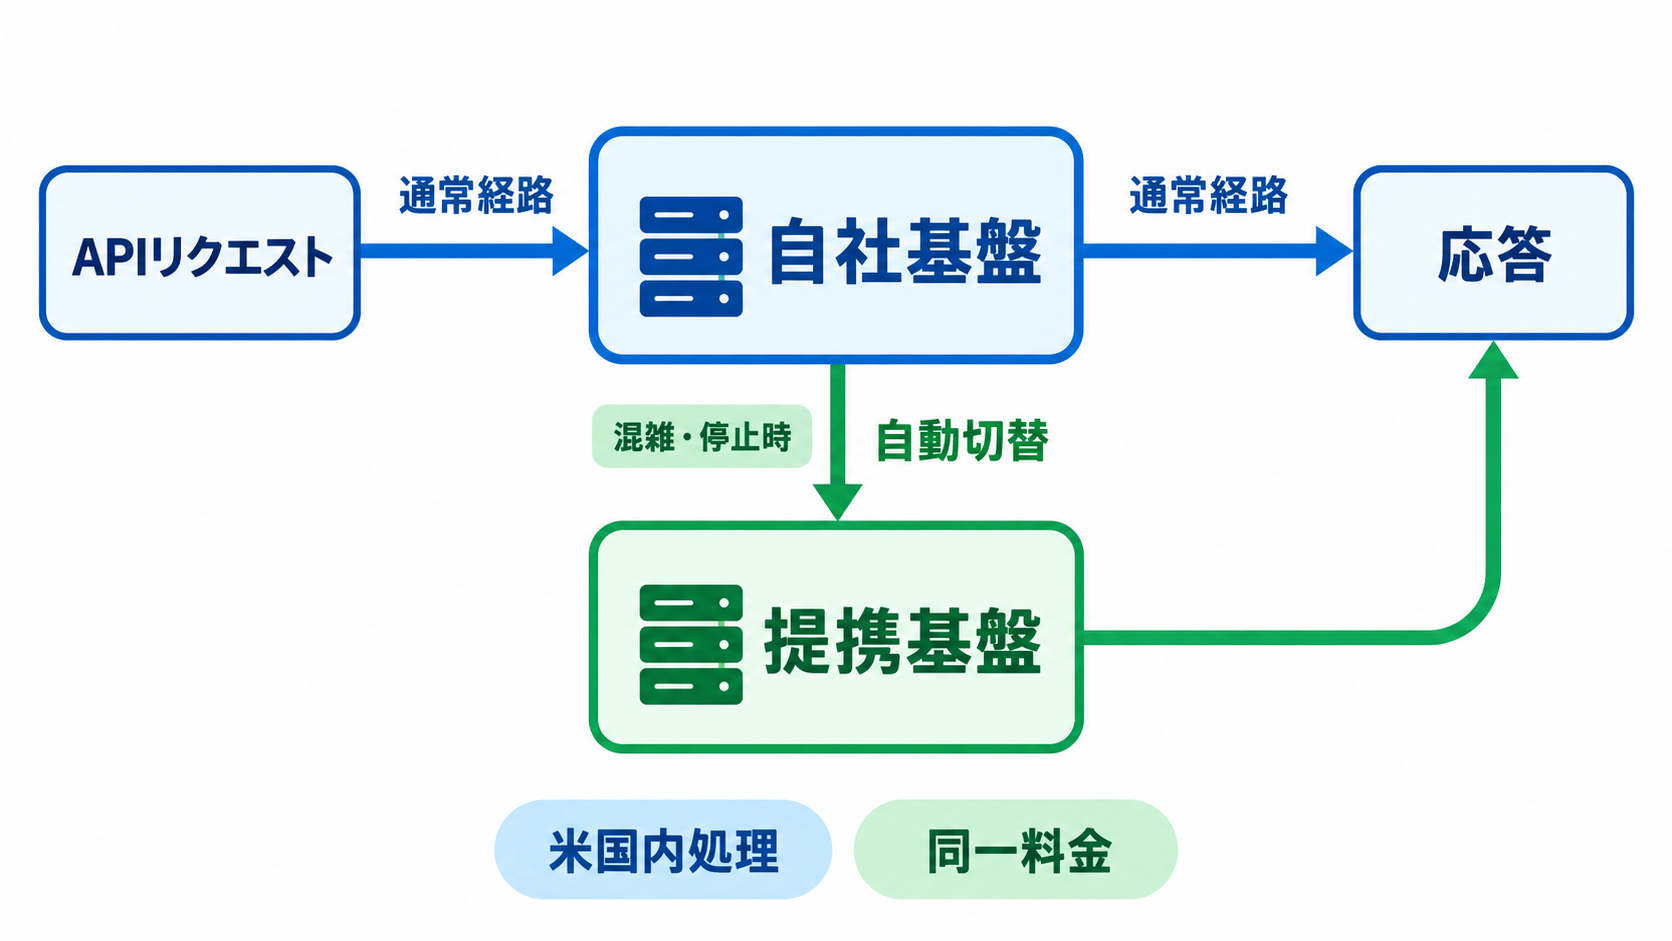
すべてのリクエストは、最初にYou.com自身の推論基盤「Inference Direct」へ送られます。その基盤が停止している場合や処理能力の上限に達している場合には、審査済みの提携事業者へ自動的に切り替わる設計です。提携先としてParasail、Wafer、Alibaba Cloud、Meta、Inceptionが挙げられており、Prime Intellectも追加予定とされています。この構造は、複数事業者を横断してリクエストを仲介する一般的なアグリゲーターとは少し異なります。通常時には自社設備を優先し、必要なときだけ外部設備へフェイルオーバーします。You.comによれば、切り替え先を含む全環境が米国内でホスティングされ、ゼロデータ保持の要件に従います。どの経路で処理されても、モデルごとに公開された一つのトークン単価が適用され、フェイルオーバーを理由に請求額が変わることもないとしています。
SLAでは最低99.9%の稼働率が示され、条件を満たさない場合のクレジットも用意されています。月額の大口契約や専用スループットを前提とせず、従量課金でこの保証を付けた点が特徴です。ただし、99.9%は停止が一切起きないことを意味しません。企業が採用を検討する際には、稼働率の測定単位、計画停止の扱い、クレジットの申請条件、自社アプリ側の再試行設計も確認したいところです。
運用管理では、APIキー単位の利用上限を設定でき、モデル、費用、プロバイダー別の日次利用状況も確認できます。複数部門や複数サービスで生成AIを使う企業にとっては、モデルの選択肢だけでなく、誰がどれだけ利用したかを追跡できることが予算統制につながります。ルーターが可用性を補っても、アプリケーション側のタイムアウトや出力品質まで自動的に保証されるわけではないため、技術面と業務面を分けて設計する必要があります。
ZDRが守る情報と企業が確認すべき境界
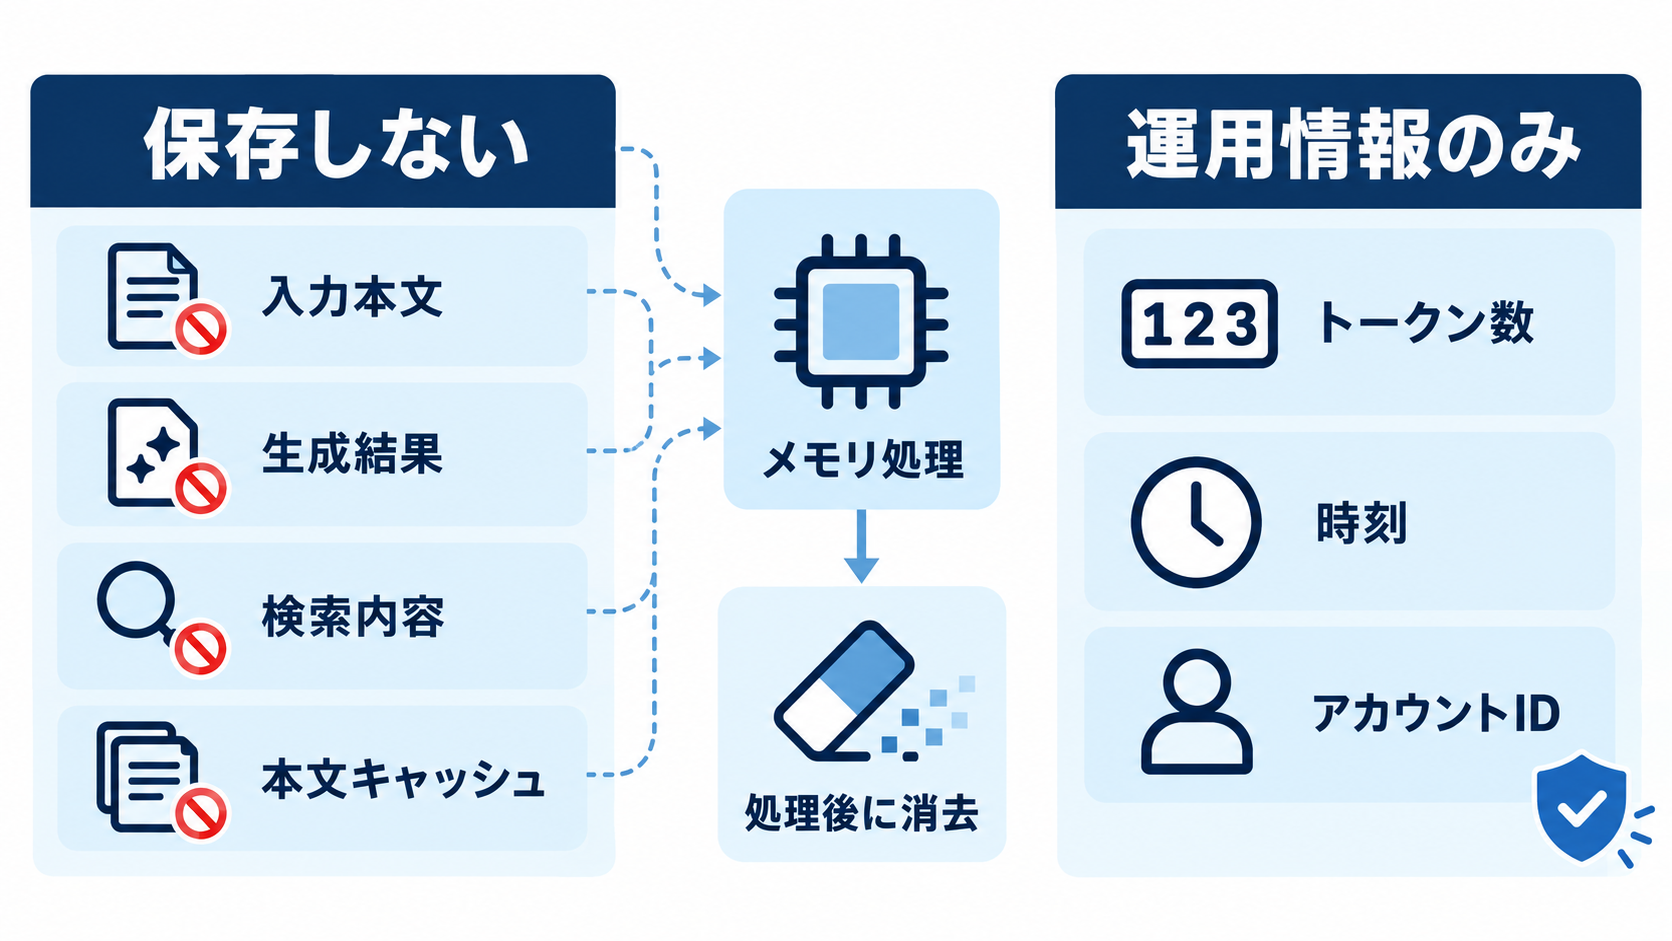
生成AIの社内審査では、入力した文章が保存されるのか、モデル改善に利用されるのか、バックアップやキャッシュに残るのかが問題になります。Inference Routerのゼロデータ保持、いわゆるZDRポリシーでは、プロンプトと出力をメモリ上で処理し、保存しないとされています。この扱いはモデルへの問い合わせだけでなく、組み込みのウェブ検索にも適用されます。You.comが保持するのは、トークン数、タイムスタンプ、アカウントIDなどの運用メタデータです。プロンプトのハッシュ値、匿名化した本文、ディスクを使うプロンプトキャッシュは、保持対象から明示的に除外されています。文章そのものを削除した後に識別用のハッシュだけ残したり、個人情報を取り除いたテキストを分析用に保存したりする方式も採らない、という説明です。検索クエリにも同じ方針が及ぶ点は、外部情報を参照するRAGや調査支援機能を構築する企業にとって見落とせません。
アカウントはSOC 2に準拠したインフラ上で運用され、要望に応じてDPAも提供されます。SOC 2は、セキュリティや可用性などに関する管理策を第三者が評価する米国発の保証報告制度です。DPAは、個人データの処理条件や当事者の責任を定める契約を指します。いずれも企業審査で有用な材料ですが、それだけで日本企業の法務・セキュリティ要件を自動的に満たすわけではありません。
導入時には、メタデータがどの程度の期間保持されるか、障害調査時に本文を提供する必要があるか、APIキーやアクセス権をどう管理できるかを個別に確認する必要があります。米国内ホスティングも、データの処理地域を明確にする条件であって、日本国内保存を求める組織には適合しない可能性があります。ZDRという短い表示だけで判断せず、入力禁止情報、監査ログ、インシデント対応、越境移転の社内規程と照合することが欠かせません。
12モデルの選択肢と価格から見えるサービスの立ち位置
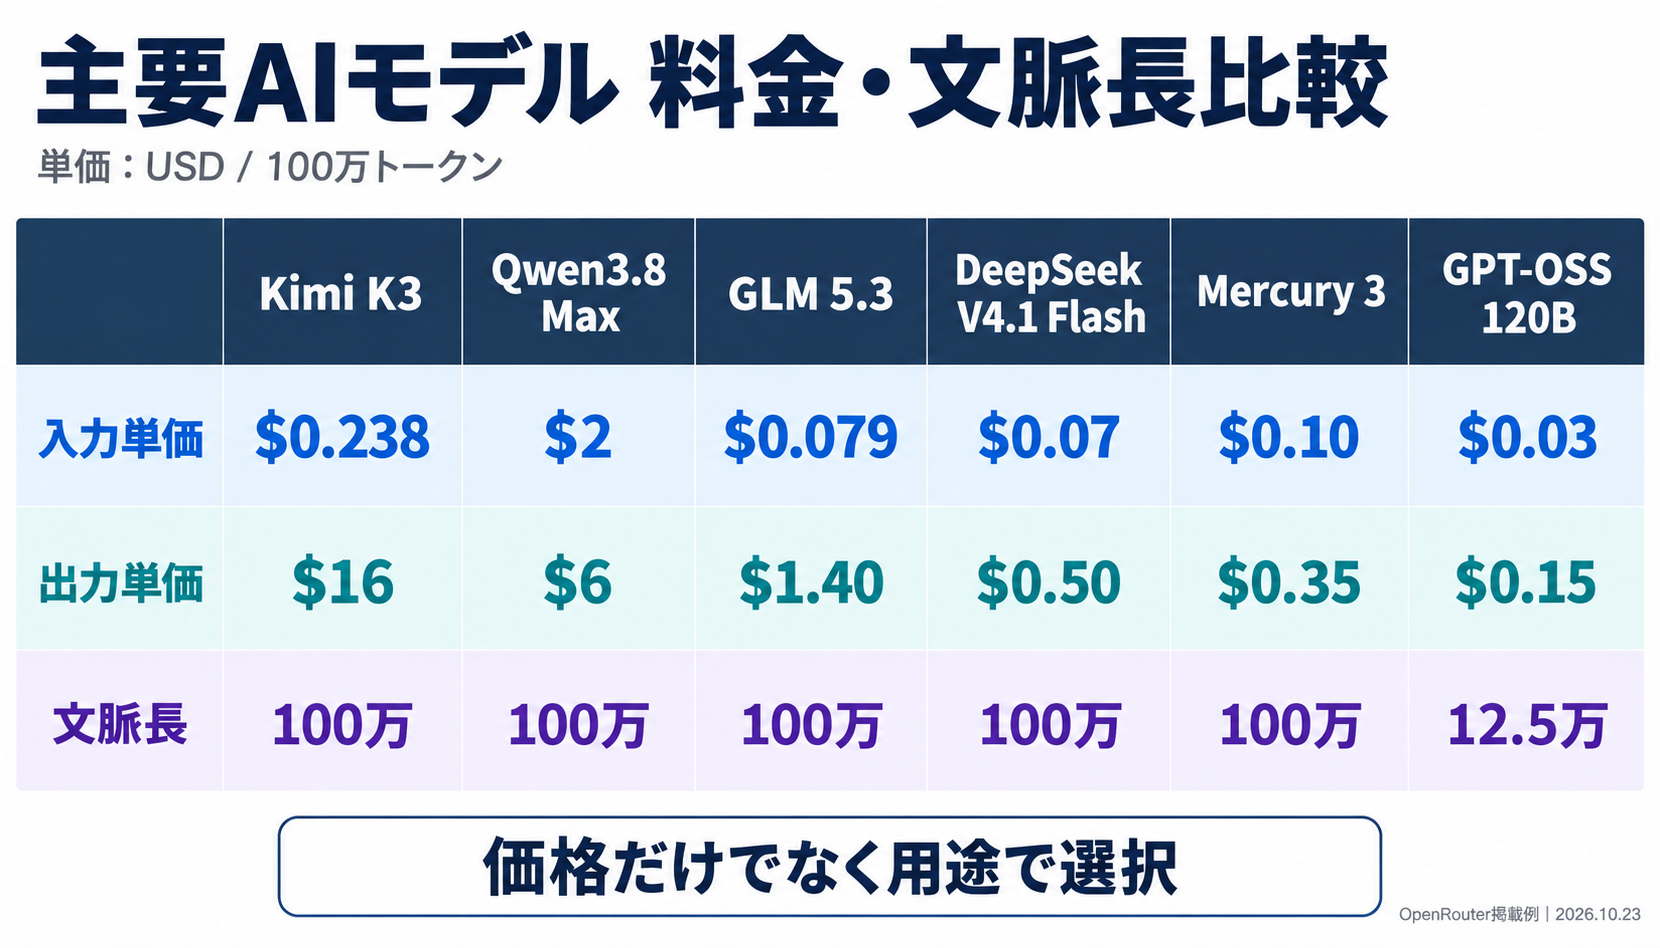
公開されている12モデルのうち、Kimi K3、Qwen3.8 Max、GLM 5.3、DeepSeek V4 Pro、DeepSeek V4.1 Flash、Mercury 3は最大100万トークンのコンテキストに対応します。長い文書や多数の検索結果を一度に扱いやすい仕様ですが、上限まで入力すれば費用と待ち時間も増えます。GPT-OSS 120Bのコンテキストは12万5,000トークンです。Kimi K3は2.8兆パラメーター、Qwen3.8 Maxは2.4兆パラメーターのMoEモデルと紹介されています。MoEは「Mixture of Experts」の略で、複数の専門的な部分ネットワークから、入力に応じて必要なものを選んで動かす構成です。総パラメーター数が大きくても、推論のたびに全パラメーターが使われるとは限りません。そのため、兆単位の数字だけを見て処理負荷や回答品質を比較するのは適切ではなく、対象業務での評価が必要です。
100万トークン当たりの入力/出力価格は、Kimi K3が2.85ドル/14.25ドル、Qwen3.8 Maxが1.85ドル/5.55ドル、GLM 5.3が1.35ドル/4.25ドルです。DeepSeek V4 Proは1.65ドル/3.65ドル、DeepSeek V4.1 Flashは0.30ドル/1.20ドル、Mercury 3は0.10ドル/0.35ドル、GPT-OSS 120Bは0.097ドル/0.73ドルとされています。このほか、Muse Wonder、Muse Spark 1.3、GLM 5.3 Flash、Qwen3.8 Flash、MiniMax M3がラインアップを構成します。
料金は入力より出力のほうが高いモデルが多いため、企業の費用管理ではリクエスト件数だけを見ても実態をつかめません。長文生成、短い分類、検索を伴う回答では、同じモデルでもコスト構造が変わります。Kimi K3の単価はTogether AIの2.85ドル/14.25ドルに対して約5%低い程度であり、価格差は限定的です。You.com自身も含め、ここでの訴求点は極端な安さではなく、可用性、保存方針、処理地域を含めた運用条件にあると考えられます。
モデルと同じ環境で動くウェブ検索と評価結果
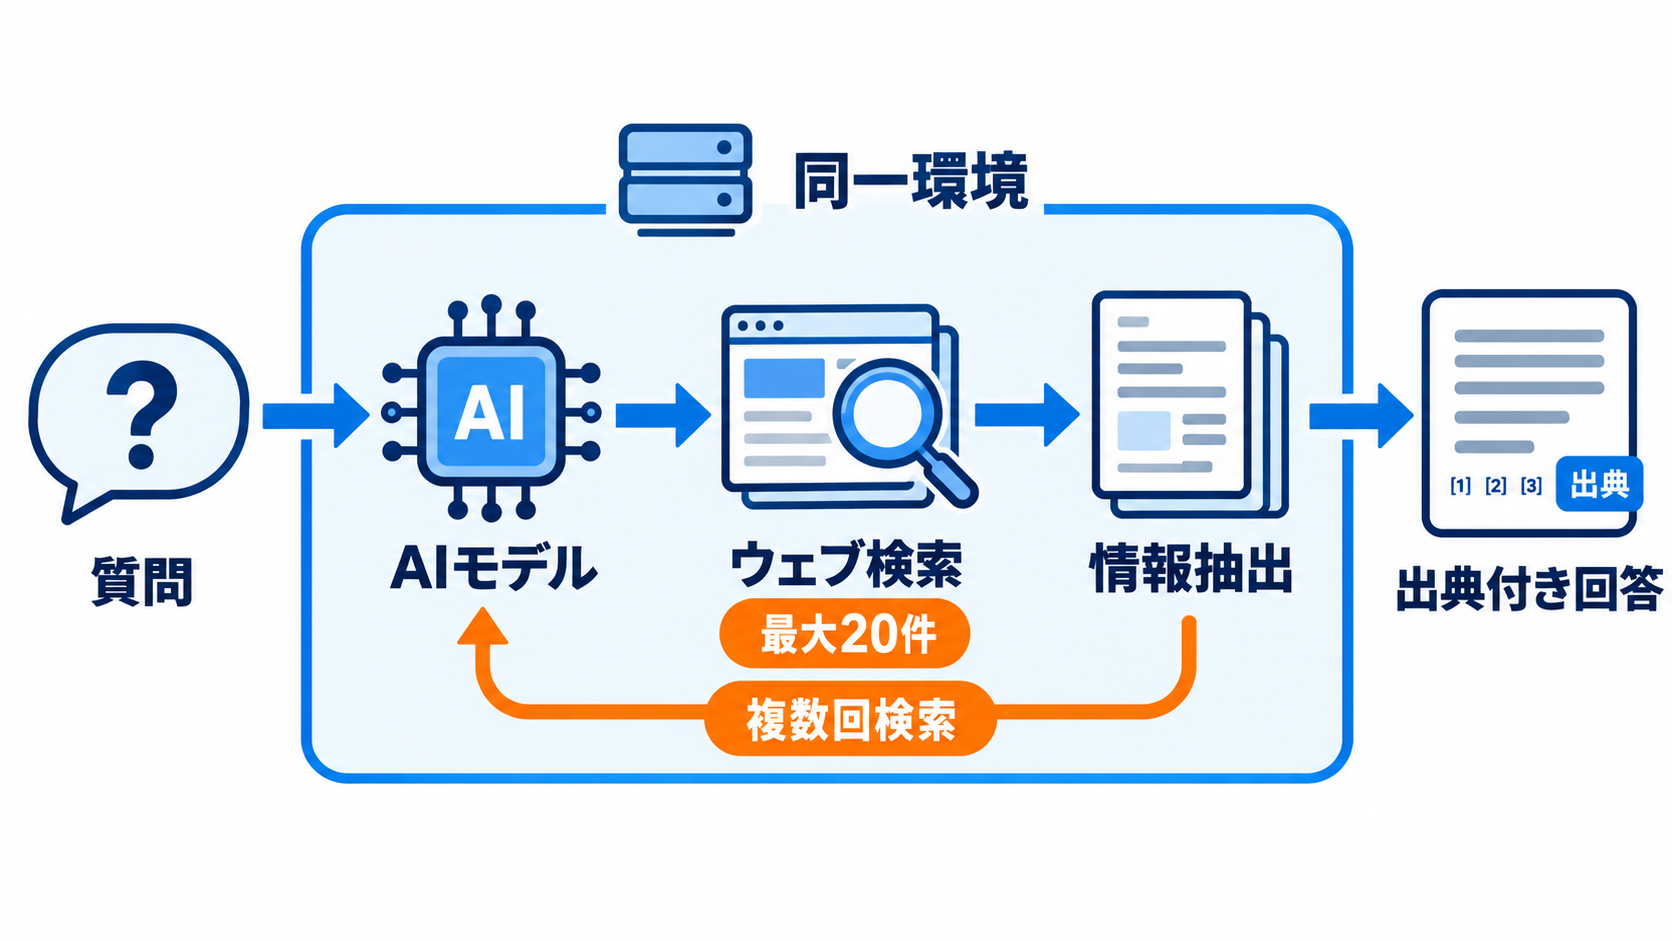
Inference Routerでは、開発者が「web_search」または「web_extract」をツールとして宣言すると、ルーターがモデルに代わって検索や情報抽出を実行します。ドキュメント上では、1回の検索で最大20件の結果を扱い、検索ラウンド数の初期設定は30回です。応答には出典を含む「web_results」オブジェクトが返るため、生成結果から参照先をたどれる構成になっています。検索処理はモデルと同じサーバー上で実行されます。You.comは社内テストで、検索を外部サービスとして呼び出す構成に比べ、遅延が最大15%低下したと説明しています。ネットワークをまたぐ処理を減らせることは、複数回の検索を繰り返すエージェント型アプリケーションで効きやすいと考えられます。ただし「最大」という数値は特定条件での結果であり、利用地域、選択モデル、検索回数、出力長によって実際の応答時間は変わるでしょう。
You.comが1,329問のLiveNewsBenchで実施した評価では、GLM-5.3とYou.com検索の組み合わせが正解率86.53%、1問当たり0.0485ドルでした。GPT-6.1 Solの組み込み検索も86.53%で0.0591ドル、Claude Sonnet 5.5は86.38%で0.0920ドルと報告されています。DeepSeek V4.1 FlashとYou.com検索は84.12%、0.0215ドルで、Claude Sonnet 5.5より正解率が2.26ポイント低い代わりに、1問当たりの費用は約77%低い計算です。
これらはYou.comによる自己申告値であり、公開情報の鮮度を測る特定のベンチマークに基づきます。社内文書の要約、コード生成、顧客対応など、別の業務でも同じ順位になるとは限りません。また、平均費用だけでは回答のばらつきや遅延を判断できません。導入企業は、自社の質問セットを使い、正確性、出典の妥当性、応答時間、1件当たりの総費用を一緒に測る必要があります。検索回数の上限も、品質向上と費用増加の両面から調整すべき項目です。
競合サービスとの違いは単価より保証条件
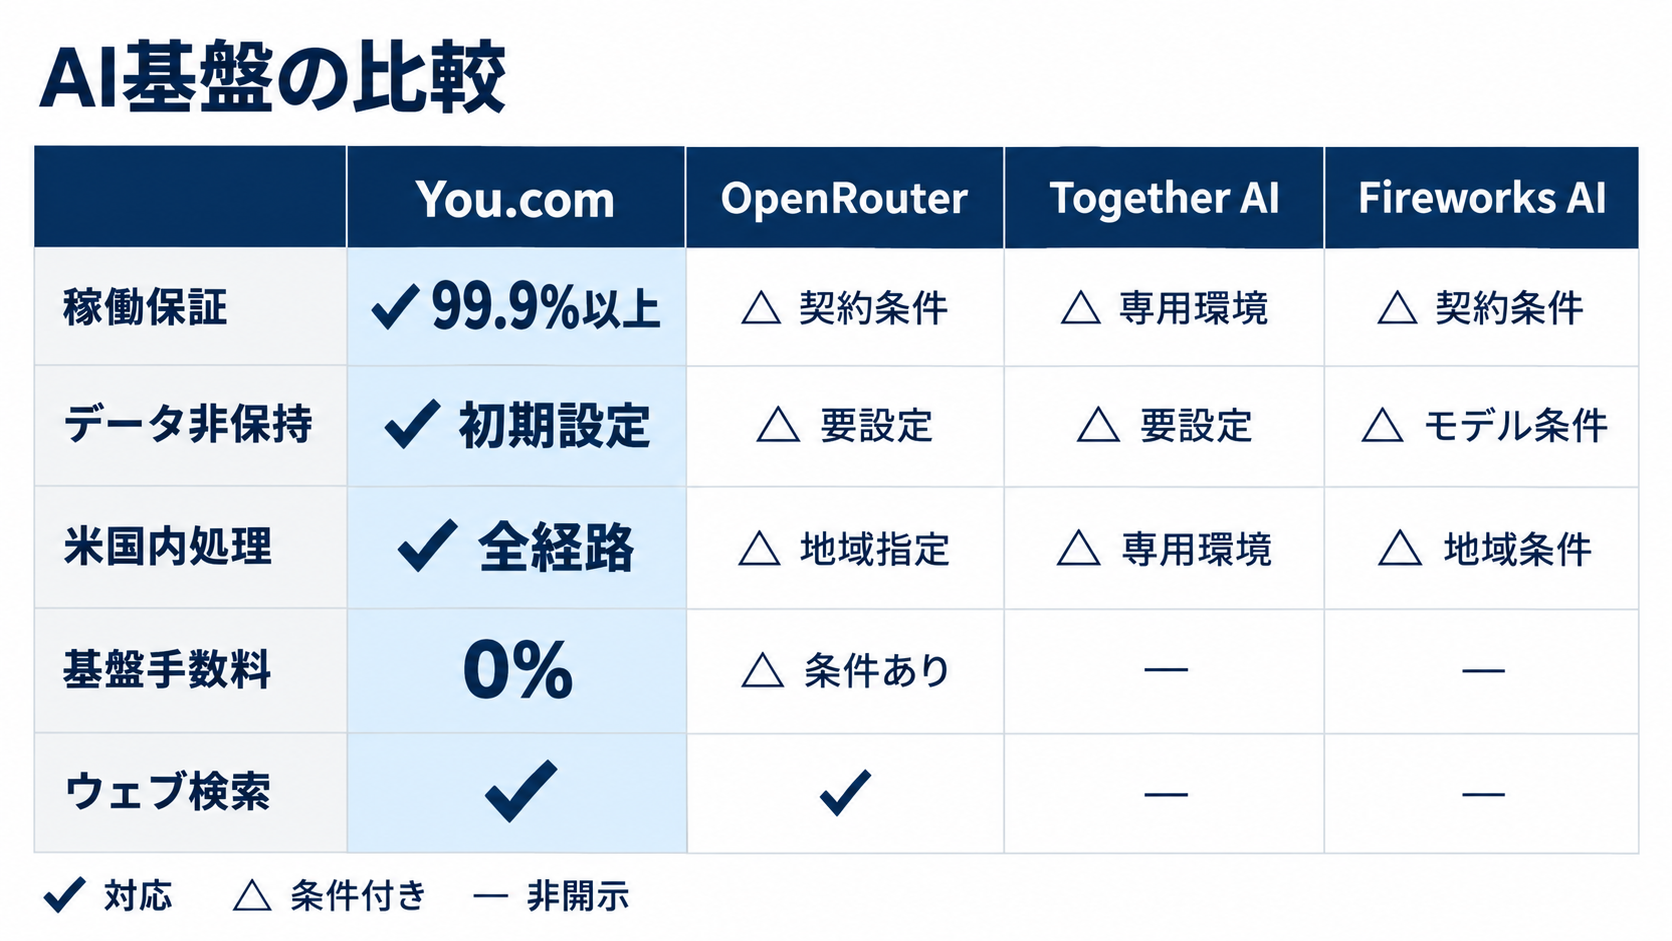
OpenRouter、Together AI、Fireworks AIと比べると、Inference Routerの差は料金表よりサービス条件に表れます。OpenRouterは複数の外部プロバイダーを束ね、自動フォールバックを提供する一方、公開情報上では稼働率SLAが示されておらず、ホスティング地域やデータ方針は接続先によって変わります。また、クレジット購入時には5.5%、最低0.80ドルのプラットフォーム料が設定されています。You.comはプラットフォーム料を0%としています。Together AIのサーバーレスサービスは自社推論クラウドを使い、通常の利用はベストエフォートです。99%のリクエストSLAは、最低1カ月の契約を伴うプロビジョンド・スループットで提供されます。ゼロデータ保持は初期状態で無効となっており、管理者が有効化する方式です。Fireworks AIも自社推論クラウドを運用し、オープンモデルではZDRを初期状態で有効にしていますが、米国内限定の処理は割増料金の別階層です。サーバーレス環境の稼働率SLAは、比較対象の公開情報では確認されていません。
Kimi K3の通常価格は、You.comが入力2.85ドル、出力14.25ドル、Together AIとFireworks AIが3ドル、15ドルです。Fireworks AIの米国内限定階層では4.50ドル、22.50ドルとなり、入力単価ではYou.comが約37%低くなります。DeepSeek V4.1 Flashの通常価格は3社とも0.30ドル/1.20ドルで、Fireworks AIの米国内限定階層は0.45ドル/1.80ドルです。単価が横並びのモデルでは、SLAや処理地域を含めた実質費用の差が判断材料になります。
ただし、表に「非開示」とある項目を、その機能が存在しないという意味で扱うべきではありません。契約プランや交渉条件によって提供内容が変わる可能性もあります。比較では、同じモデル名だけでなく、処理地域、保存設定、最低利用額、障害時の補償、検索費用まで条件をそろえることが必要です。Inference Routerは、最安のトークンを探す企業より、従量課金のまま一定の運用保証を得たい企業に適した選択肢といえます。
日本企業がPoCから本番運用へ進むための確認手順
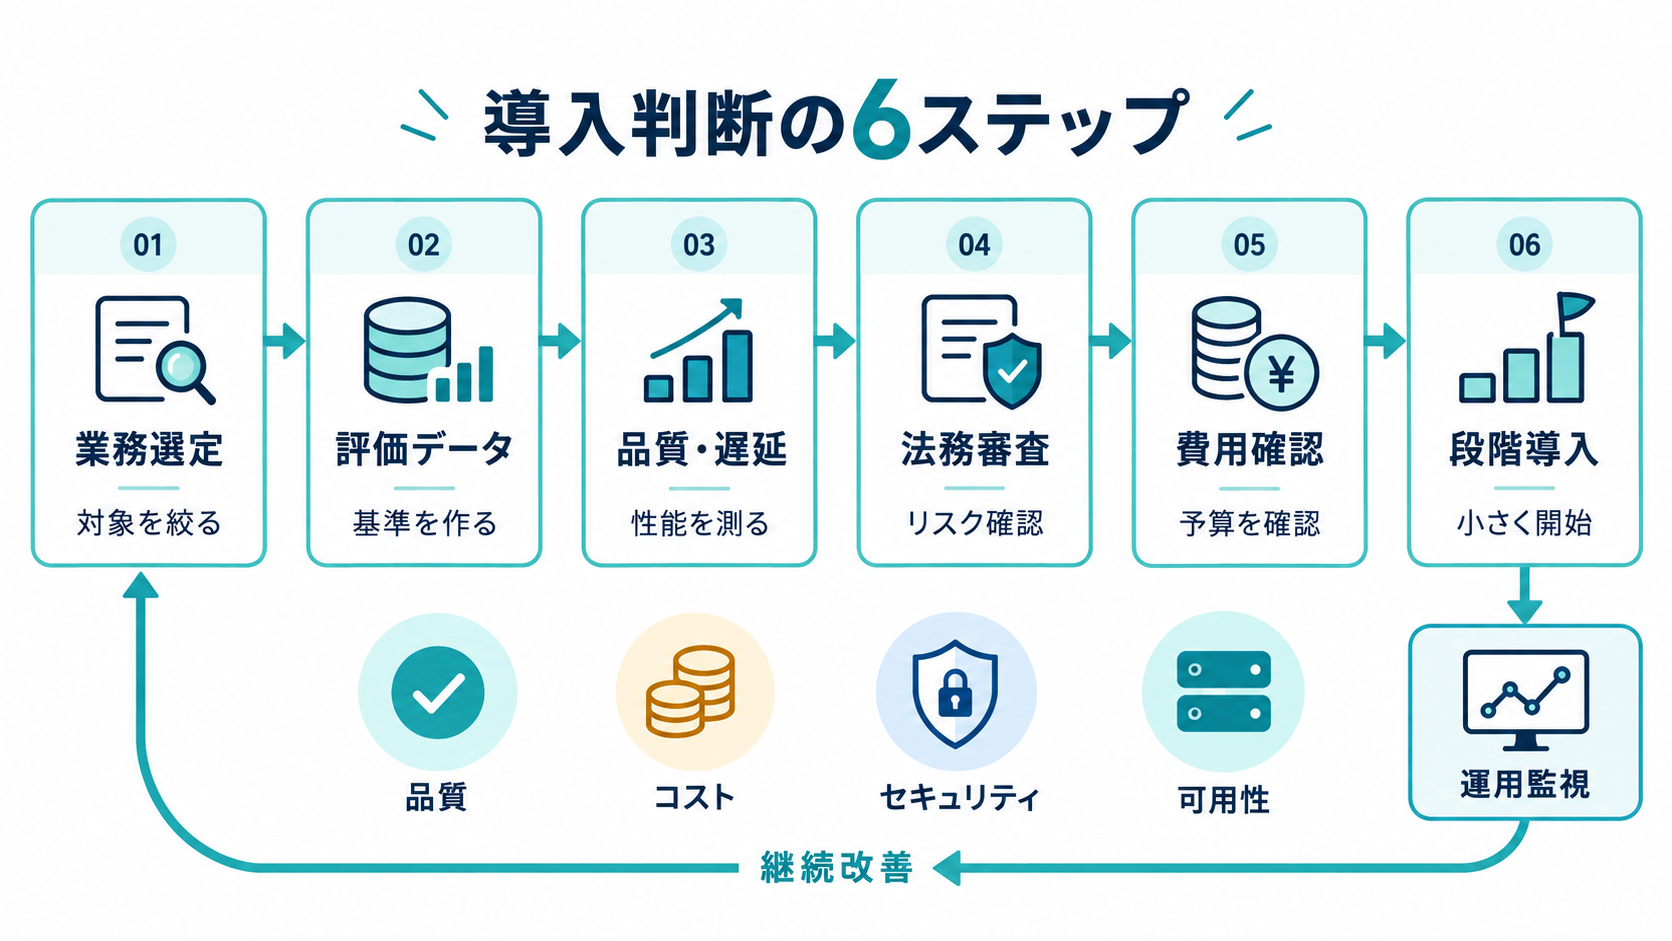
日本企業がInference Routerを評価するなら、12モデルを一斉に比べるより、実際の業務に近い少数のタスクから始めるほうが判断しやすくなります。問い合わせ回答、文書要約、情報検索など対象を一つに絞り、許容できる誤答率、応答時間、1処理当たりの費用を先に定めます。OpenAI互換APIをすでに使っている場合は、接続先を切り替えたうえで同一の評価データを流し、モデル変更による出力形式やツール呼び出しの差を確認できます。技術評価では、通常時の性能だけでなく、フェイルオーバー時にも応答形式や品質が要件を満たすかを検証したいところです。ルーターが提携先を切り替えてもモデル名と料金は変わらないとされていますが、ネットワーク状況や設備差による遅延の変化までは別途観測する必要があります。APIキーごとの支出上限を部門や用途に合わせて設定し、日次のモデル別・費用別・プロバイダー別データを社内の費用管理へどう取り込むかも決めておくべきでしょう。
法務とセキュリティの確認では、ZDRの対象、運用メタデータ、米国内処理、DPA、SOC 2関連資料を自社基準と照合します。個人情報や営業秘密を扱う用途なら、サービス側の非保持方針に加え、送信前のマスキング、権限分離、監査記録、緊急時のキー失効手順も必要です。ウェブ検索を使う場合は、取得した情報の出典確認や、不適切な外部コンテンツを回答へ混入させないための検証工程も設けなければなりません。
採用判断では、モデル単価の小さな差より、運用に必要な追加作業を含む総コストを見ることが重要です。専用GPUの管理、複数ベンダーとの契約、障害対応、データ審査を減らせるなら、ルーター利用料が市場水準でも合理性があります。反対に、国内処理が必須の組織や、特定モデルを一定量以上使い続ける組織では、別の専用基盤が適する可能性もあります。最初の一歩は、代表的な50〜100件程度の社内評価セットを用意し、品質・遅延・費用・監査要件を同じ表で比較することです。