
2026/11/02
今更聞けないAI知識
AIは「正解つきデータ」からどう学ぶ?答え合わせで理解する教師あり学習
迷惑メールを見分けるAIは、何を教わっているのか
受信箱に届いたメールが、自動で「通常のメール」と「迷惑メール」に振り分けられることがあります。その様子を見ると、AIが文章の意味を人間のように読み取り、自分で正解を考えているように感じるかもしれません。では、AIは何を手がかりに判断しているのでしょうか。
一言で答えると、教師あり学習では、入力と正解を組み合わせた多数の例を使って、両者の対応関係を学びます。メールの例なら、本文や件名などが入力に当たり、「通常」「迷惑」といった正解がラベルです。ラベルとは、学習用のデータに付ける答えや分類名を指します。IBMの資料でも、教師あり学習は、人が各訓練例と出力ラベルを組み合わせ、モデルが入力と出力の対応を学ぶ方法と説明されています(出典: IBM)。
学校の練習問題にたとえると、問題だけを何度も眺めるのではなく、解答欄と答えがそろった教材で練習する形です。ただし、AIが正解文をそのまま暗記して取り出すとは限りません。学習用の例に共通する特徴や傾向を捉え、まだ見ていない入力に対して答えを予測できるようにします。
ここで大切なのは、予測と確定を区別することです。迷惑メールらしい特徴が多くても、実際には必要な案内かもしれません。教師あり学習が出すのは、過去の例から学んだ対応関係に基づく判断です。正解つきの教材で学んだからといって、未知のケースまで必ず正しく答えられるわけではありません。この前提を知るだけでも、AIの判定を「機械が出した事実」ではなく、「学習した傾向に基づく予測」として扱いやすくなります。
AI、機械学習、教師あり学習の位置関係
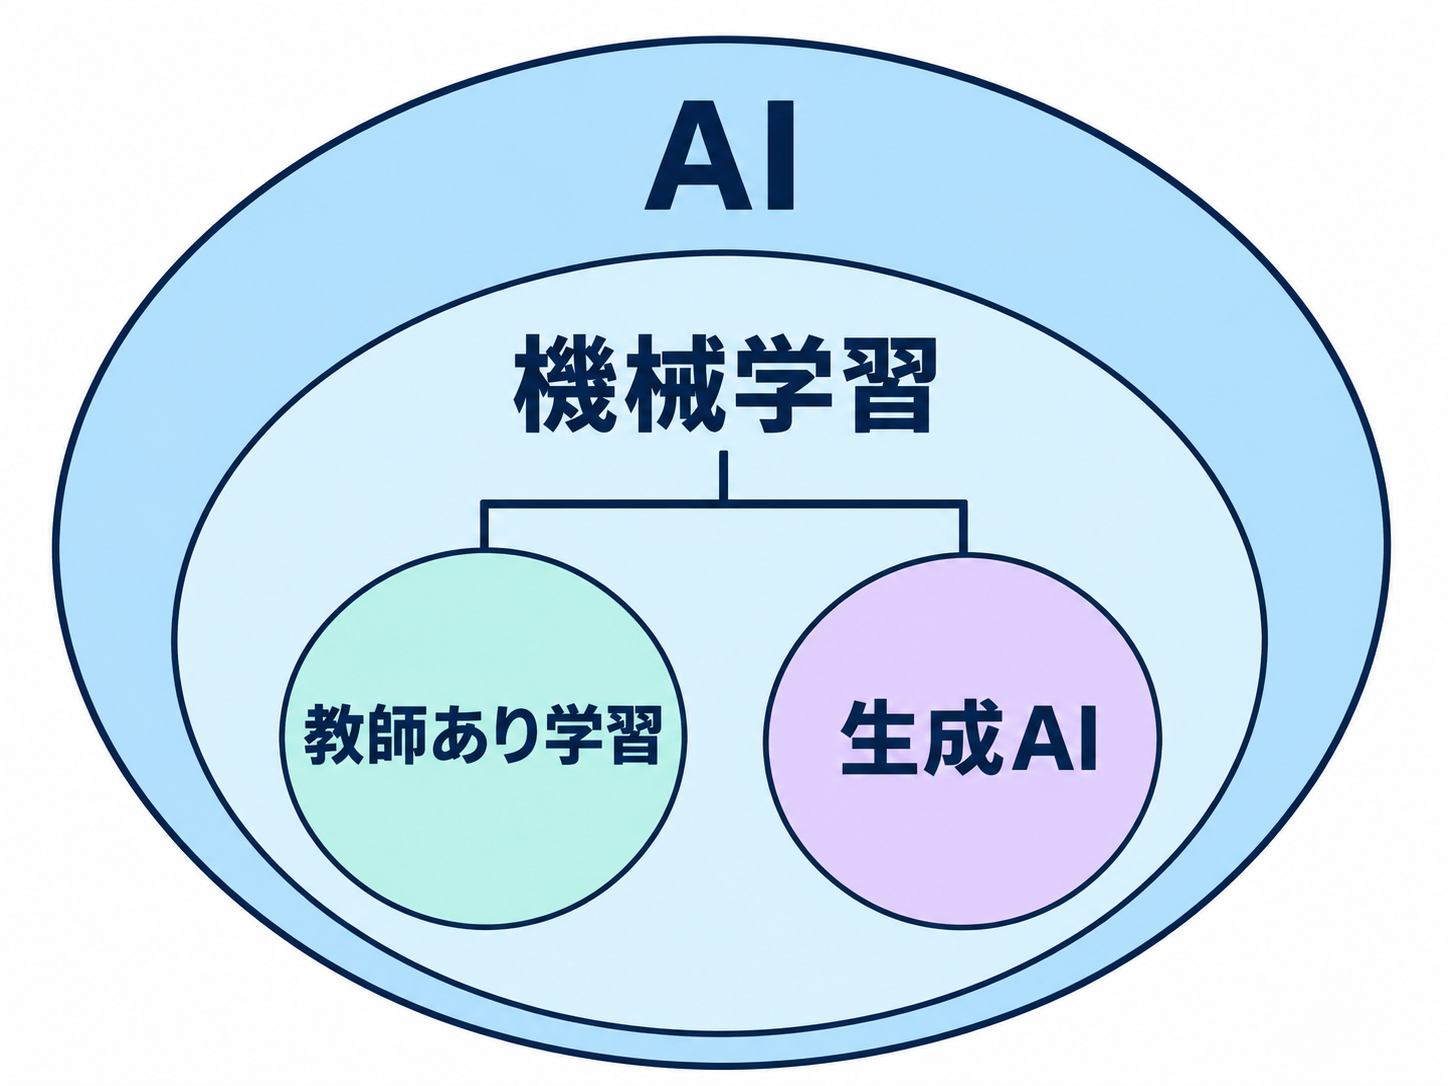
「AI」と「機械学習」は、同じ意味の言葉として使われることがありますが、指す範囲が異なります。AIは、人の学習、理解、問題解決、意思決定などに関係する働きを、コンピューターや機械で実現しようとする広い技術分野です。そのAIを実現する方法の一つが機械学習であり、教師あり学習は機械学習に含まれる学び方の一つです(出典: IBM、Google Cloud)。
関係を傘にたとえると、大きな「AI」という傘の下に機械学習があり、その内側に教師あり学習があります。生成AIもAIに含まれますが、文章や画像などを作ることに重点を置いた技術であり、教師あり学習と同じ言葉ではありません。IBMの資料では、生成AIの基盤となる技術を理解するには、機械学習や深層学習との関係を押さえる必要があると説明されています(出典: IBM)。
| 用語 | 短い意味 | 今回の記事での位置づけ |
| --- | --- | --- |
| AI | 人に関連する知的な働きを機械で実現する広い分野 | 最も広い範囲です |
| 機械学習 | データから傾向を学び、予測や判断に使う方法 | AIを支える方法の一つです |
| 教師あり学習 | 入力と正解ラベルの組から対応関係を学ぶ方法 | 今回の中心テーマです |
機械学習で作られる「モデル」とは、学習の結果として得られる、予測に使う仕組みです。Google Cloudの資料では、アルゴリズムを訓練データに適用した結果として、モデルが作られると説明されています(出典: Google Cloud)。アルゴリズムは学び方の手順、訓練データは練習教材、モデルは練習を終えて判断できるようになった成果物、と置き換えると整理しやすいでしょう。
そのため、「AIに正解を教える」という表現だけでは少し曖昧です。実際には、人が用意した入力と正解の組を、一定の手順でモデルに学習させています。AIという大きな言葉を見かけたら、どの方法で学んだ仕組みなのかを一段掘り下げると、できることと限界を見分けやすくなります。
答え合わせ付きの練習問題で考える学習の流れ
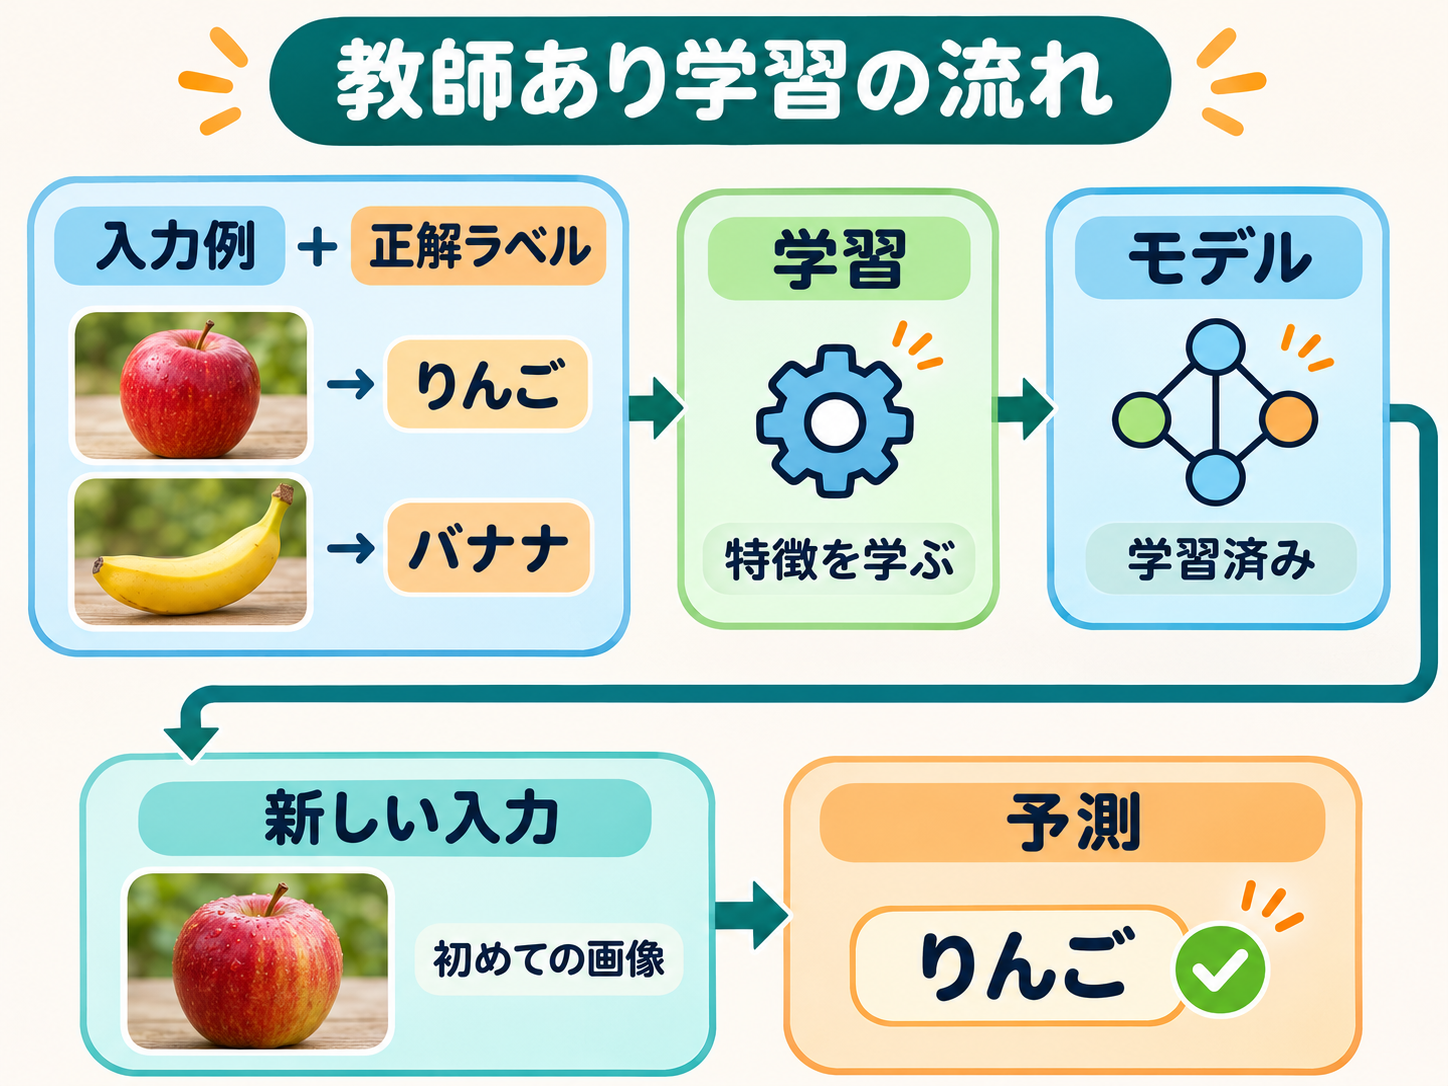
教師あり学習の流れは、「例を用意する」「正解を付ける」「対応関係を学ぶ」「初めて見る問題に答える」という順番で捉えられます。学習と実際の回答は同じ場面ではありません。教材を使ってモデルを作る時間が学習であり、完成したモデルに新しい入力を渡して予測を得る時間が利用時の回答です。
架空の例として、果物の写真を「りんご」と「みかん」に分ける仕組みを考えます。学習用の写真には、あらかじめ人が「りんご」「みかん」というラベルを付けておきます。モデルは、写真の色や形など、入力に含まれるさまざまな特徴とラベルの対応を学びます。その後、ラベルの付いていない新しい写真を受け取ると、学習した傾向を使って、どちらに近いかを予測します。この例は仕組みを理解するための単純化した説明であり、特定の製品を実際に検証した結果ではありません。
学校の答え合わせと違う点もあります。人は先生の解説を読み、「なぜ間違えたのか」を言葉で理解できます。機械学習では、予測と正解のずれが小さくなるようにモデル内部の調整を繰り返します。ここでいう「学ぶ」は、意識を持って内容を理解するという意味ではなく、データに現れた入力と出力の関係を予測へ使える形に整えることです。
IBMの資料では、教師あり学習の目標は訓練データにある入力と出力の対応を学び、まだ見ていないデータのラベルを予測することだと説明されています(出典: IBM)。つまり、学習用の問題で正解できるだけでは不十分です。似た問題をそのまま覚えるのではなく、新しい問題にも対応できることが求められます。
この区別を知っておくと、日常の会話で使う「このAIは学習している」という表現にも注意を向けられます。画面上で一度修正を伝えたからといって、その場で基礎となるモデルが再学習されるとは限りません。製品ごとの仕組みは資料で確認する必要がありますが、少なくとも「利用中の入力」と「モデルを作るための学習」は、分けて考えるのが安全です。
分類と数値予測という二つの身近な仕事
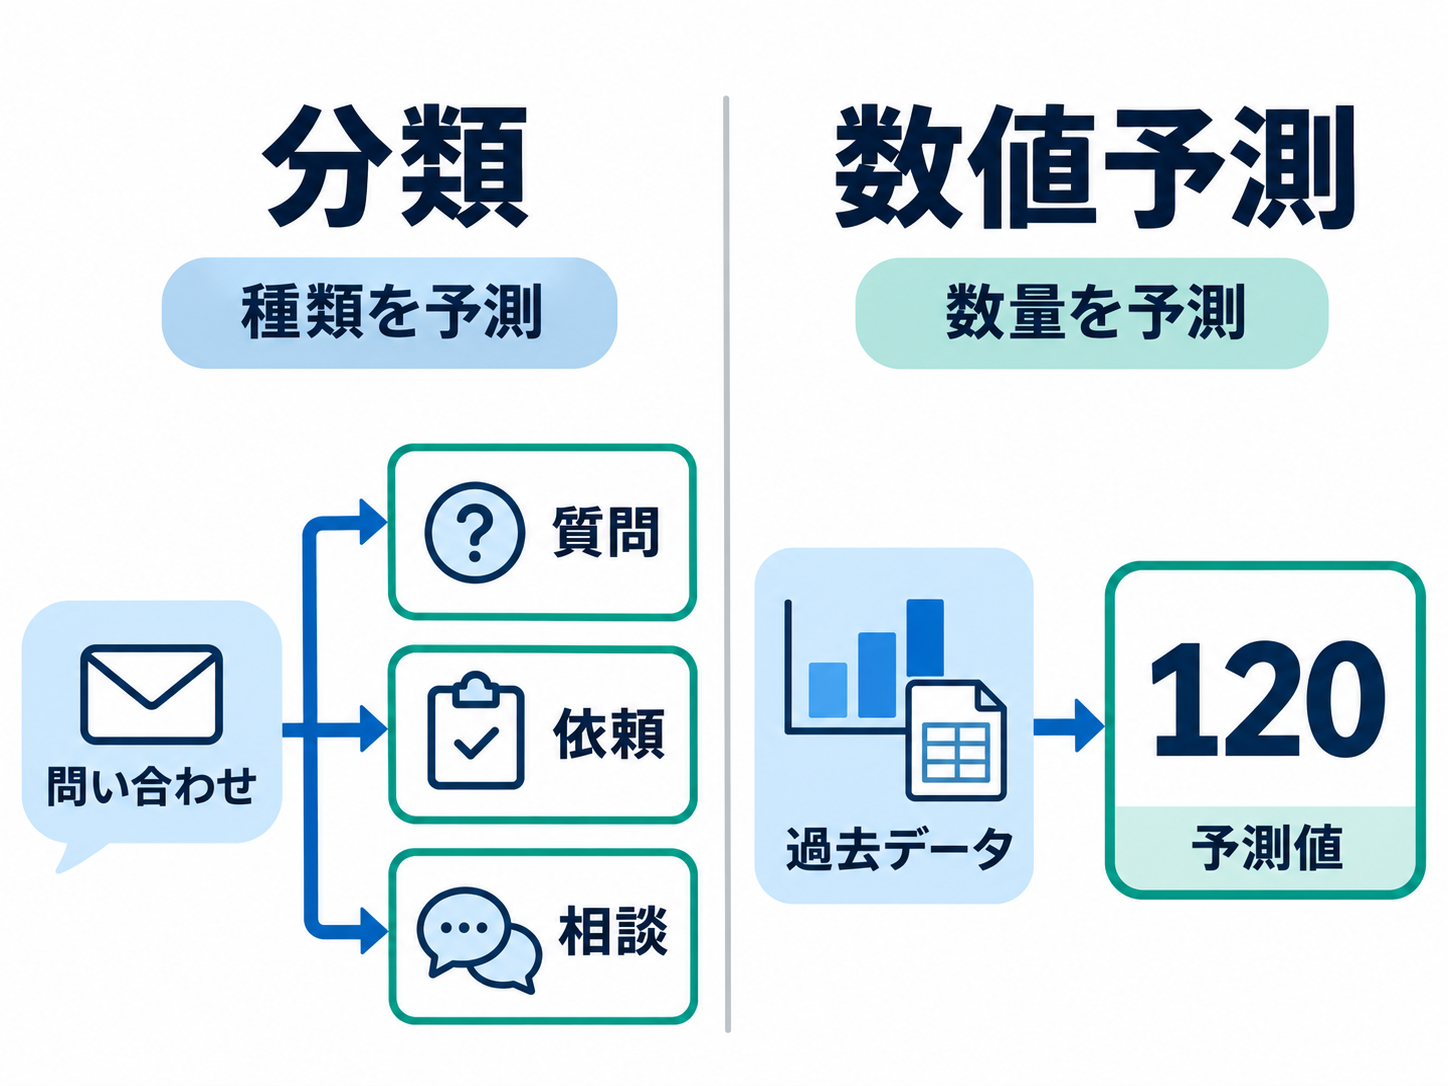
教師あり学習が担当する代表的な仕事は、分類と数値予測です。分類は、入力をあらかじめ用意した種類のどれかに分ける仕事です。数値予測は、入力に応じた数量を予測する仕事で、機械学習では回帰と呼ばれる場合があります。IBMの資料でも、教師あり学習はデータの分類や結果の予測に使われる方法として説明されています(出典: IBM)。
| 仕事の種類 | 架空の入力例 | 予測する答えの例 |
| --- | --- | --- |
| 分類 | 問い合わせ文の内容 | 配送、返品、商品説明 |
| 分類 | 写真に写った品物 | 文房具、食品、衣類 |
| 数値予測 | 過去の来店状況や曜日 | 翌日の来店数 |
| 数値予測 | 住居の広さや築年数 | 想定される価格 |
問い合わせの分類を例にすると、過去の文章に「配送」「返品」「商品説明」などの正解ラベルを付け、その組み合わせからモデルを作ります。新しい問い合わせが届いたとき、モデルはどの分類に近いかを予測します。これは業務への応用を考えるための架空例であり、分類結果が必ず正しいことや、実際の作業時間を短縮できることを保証するものではありません。
数値予測では、答えが種類ではなく数になります。たとえば、曜日や過去の来店状況を入力として、翌日の来店数を予測する場面が考えられます。ただし、予測値は未来を知っているわけではありません。学習用データに含まれていた関係を、新しい入力へ当てはめた結果です。過去にない出来事や、入力に含めていない条件があれば、予測と実際の結果が離れる可能性があります。
分類と数値予測を見分けるには、「この仕組みは、最終的に何を答えるのか」と考えると分かりやすくなります。決められた種類の名前を返すなら分類、数量を返すなら数値予測です。AIという言葉だけでは用途が広すぎますが、出力の形まで確認すれば、そのモデルがどのような正解つきデータで学んだのかを想像しやすくなります。
正解ラベルの質と偏りが結果へつながる理由
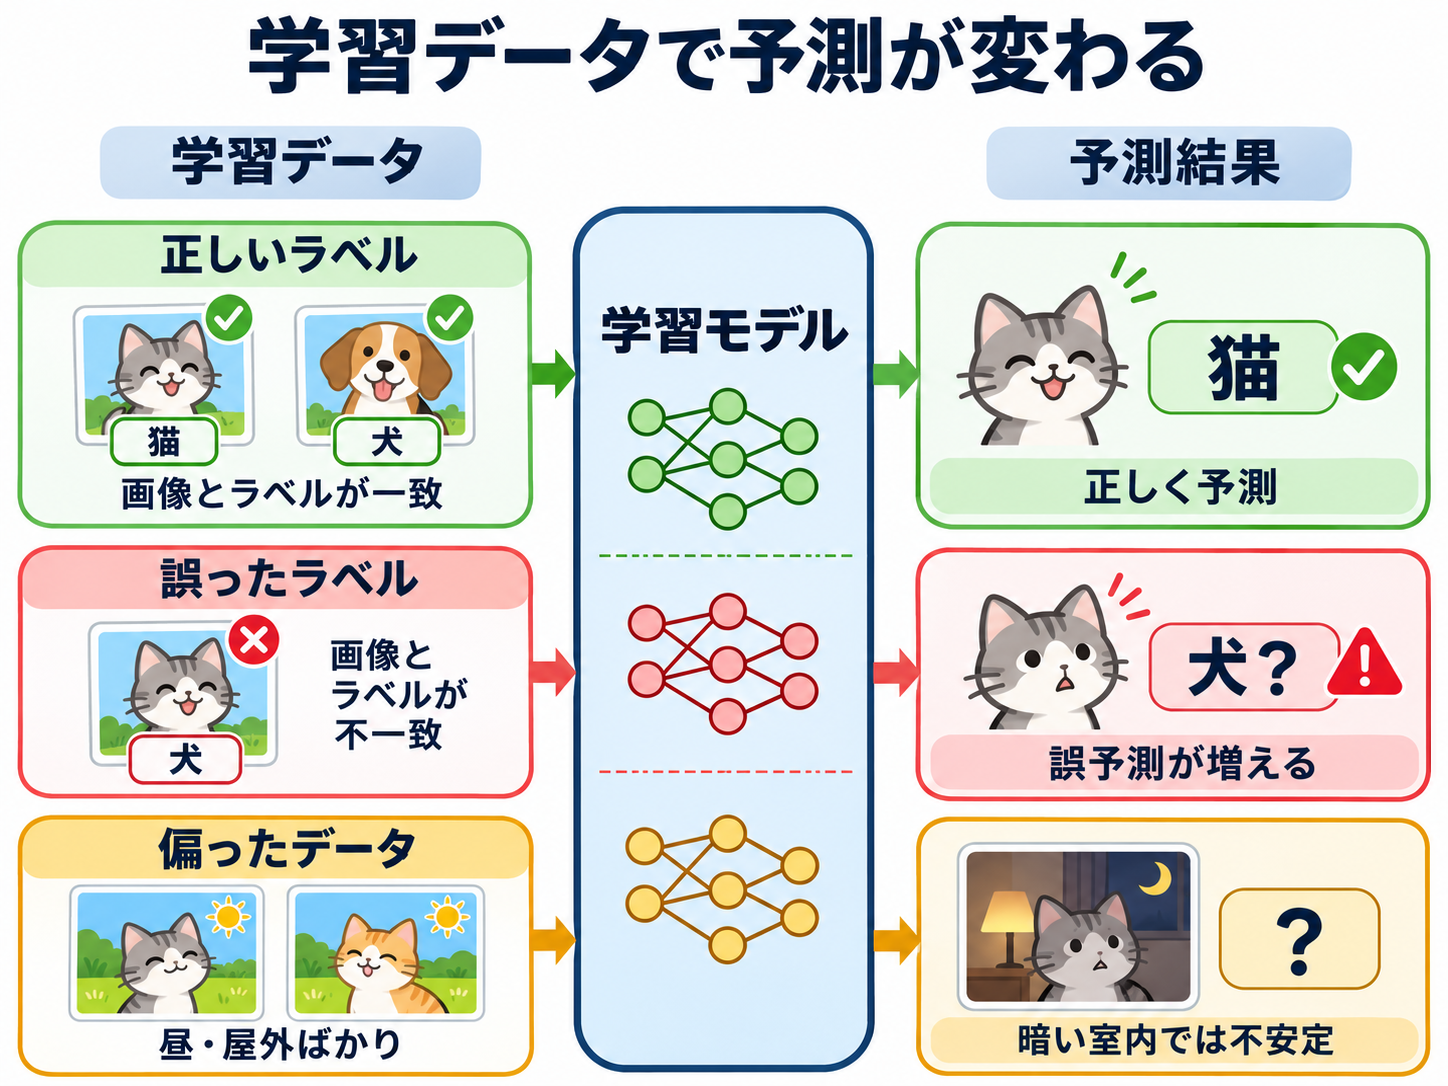
教師あり学習では、正解ラベルが学習の方向を決めます。人が間違ったラベルを付けた例が多ければ、モデルはその間違った対応も教材として受け取ります。同じ内容なのに、担当者によって異なるラベルが付いていれば、入力と答えの関係も曖昧になります。教師あり学習が入力と出力の対応を学ぶ仕組みである以上、教材側の不一致が予測に影響すると考えられます。
架空の経費分類を考えてみましょう。ある担当者はオンライン会議用の機器を「備品」とし、別の担当者は同じ種類の購入を「通信費」としていたとします。このデータを正解として学ばせると、モデルにとっては似た入力に異なる答えが結び付いている状態です。どの分類が組織のルールに合うのかを人が整理しなければ、モデルだけで矛盾を解決できるとは限りません。
偏りは、ラベルの誤りとは別の問題です。たとえば、果物の熟し具合を写真から分類するモデルを、明るい室内で撮影した写真だけで学習させたとします。暗い場所や屋外で撮った写真が教材にほとんどなければ、その条件での判断材料が不足します。学習用の例ではうまく分類できても、利用場面が変わると同じ結果になるとは限りません。これは、未知の入力を予測するという教師あり学習の目的を考えるうえで欠かせない視点です。
「正解」という言葉にも注意が必要です。迷惑メールかどうかのように、運用ルールや利用者の目的によって答えが変わる課題もあります。その場合のラベルは、世の中に一つだけ存在する絶対的な正解ではなく、決められた基準に沿って付けた答えです。基準が曖昧なら、ラベルを付ける人の判断も揺れます。
AIの結果に違和感があるときは、モデルの性能だけを見るのではなく、「何を正解として教えたのか」「利用場面に近い例が教材に含まれていたのか」を確認するとよいでしょう。データの件数だけでは、正解ラベルの一貫性や利用環境との違いまでは分かりません。量と同時に、中身や対象範囲を見る必要があります。
学習用データで正解しても十分ではない理由
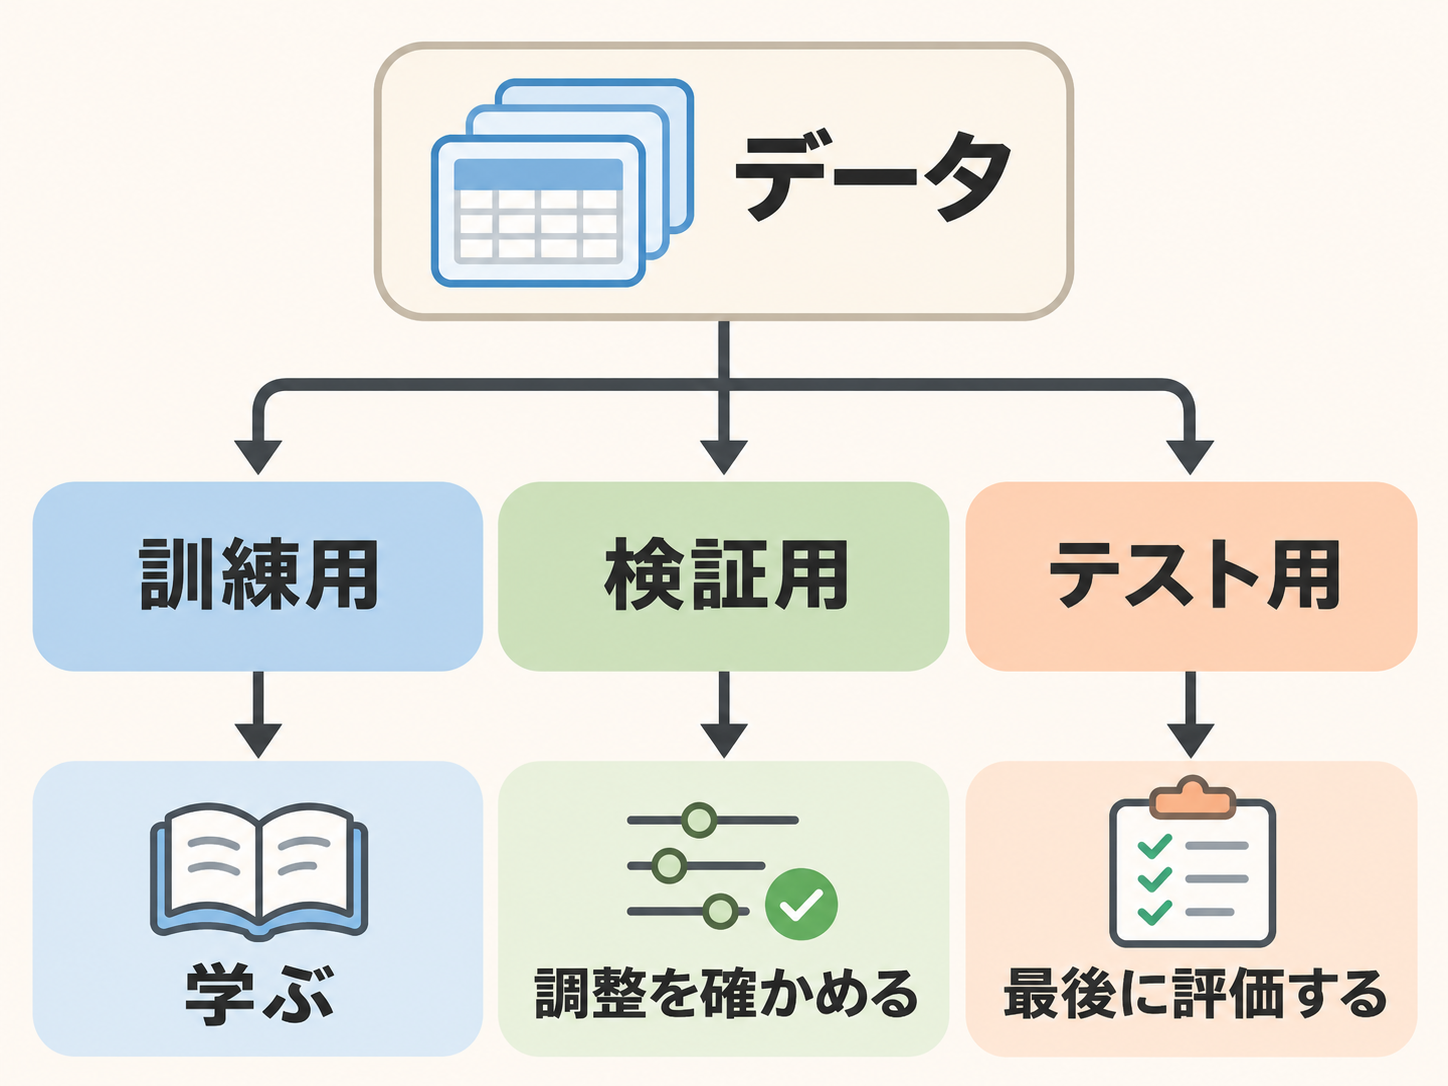
練習問題の答えを覚えただけの生徒が、初めて見る応用問題でつまずくことがあります。教師あり学習でも、学習に使った例への正解率だけを見ていると、新しいデータに対応できるかを判断しにくくなります。そのため、学習に直接使わないデータを用意し、完成したモデルの予測を確かめる考え方が必要です。
Google for Developersの用語集では、教師あり学習モデルの評価では、一般に検証用データとテスト用データを使って判断すると説明されています(出典: Google for Developers)。検証用データは、モデルの調整方針を確かめるための問題集に近い役割です。テスト用データは、調整を終えたモデルを最終的に確かめる試験と考えると理解しやすいでしょう。
架空の問い合わせ分類であれば、過去の問い合わせすべてを学習に使い切らず、一部を確認用として分けておく方法が考えられます。モデルが見ていない問い合わせに対して「配送」「返品」などを予測させ、人が付けたラベルと比べます。特定の言い回しだけを覚えていた場合、表現の異なる問い合わせで間違いが増えるかもしれません。
数字を一つ見るだけでなく、どのような場合に間違えたかを確認することも役立ちます。「返品」と「交換」を混同しやすいのか、短い文章で迷うのか、複数の用件を含む文章が苦手なのかでは、必要な見直しが異なります。分類基準を直すべき場合もあれば、学習用の例を追加したほうがよい場合もあります。この確認は人が行う評価の例であり、特定の改善効果を保証するものではありません。
モデルの評価は、AIを合格か不合格かの二択で決める作業でもありません。どの場面で使い、間違えたときに何が起きるかによって、求める確認の厳しさは変わります。候補を並べて人が選ぶ補助用途と、結果をそのまま処理へ使う用途では、同じ予測結果でも扱い方が違います。教師あり学習の結果を見るときは、正解した件数だけでなく、利用方法と失敗時の影響まで一緒に考える必要があります。
「正解を教えれば万能になる」という誤解
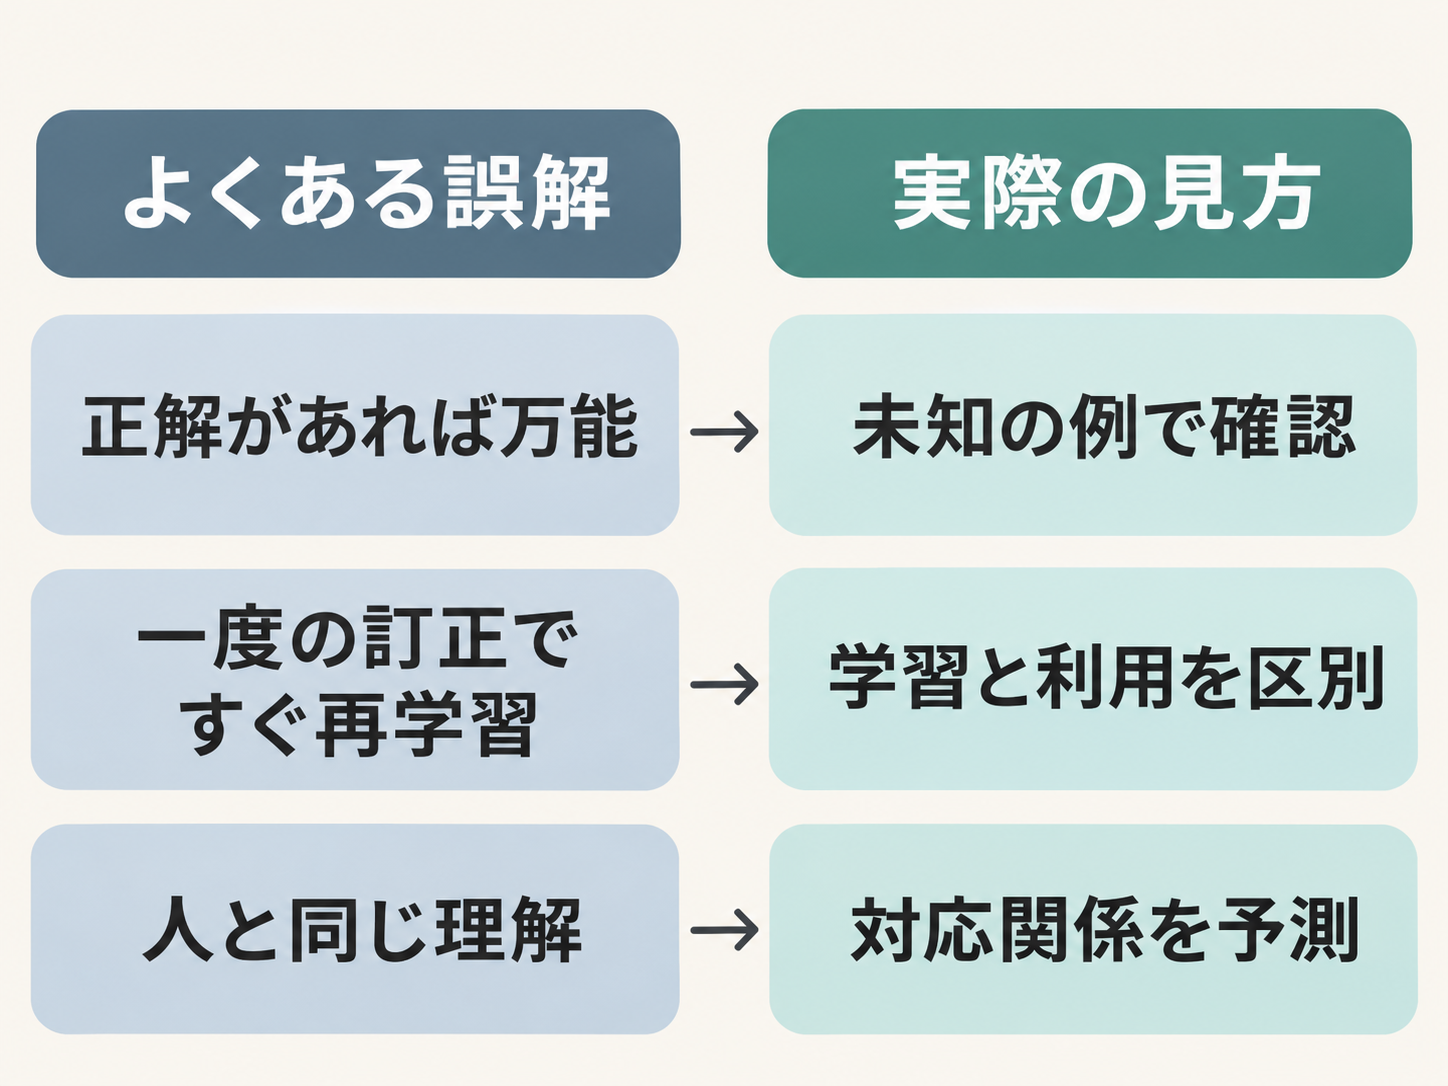
教師あり学習は、答え合わせ付きの教材を使うため、仕組みを直感的に理解しやすい方法です。ただし、「正解を大量に教えれば何でもできる」「人が一度訂正すればすぐ覚える」と考えると、実際の仕組みとのずれが生まれます。モデルが学ぶのは、用意された入力とラベルに含まれる対応関係であり、教材にない目的まで自動で理解するわけではありません。
一つ目の誤解は、正解ラベルがあれば必ず正しいモデルになるという考えです。ラベルが一貫していても、利用時に現れる条件が学習用データと大きく違えば、予測を外す可能性があります。反対に、例を増やしても、同じ種類のデータばかりなら、対象範囲が十分に広がらないことも考えられます。重要なのは件数だけではなく、何をどの範囲まで学ばせたかです。
二つ目は、AIが人間と同じ意味で理解しているという見方です。AIは人に関係する学習や判断の働きを模倣する技術として説明されていますが、それだけで人と同じ理解や意識を持つことにはなりません(出典: IBM、Google Cloud)。モデルが高い確率で適切な分類を返しても、その結果を人間のような経験や意図に基づいて説明しているとは限りません。
三つ目は、普段の入力がそのまま教師あり学習になるという誤解です。生成AIでは、利用者が入力する依頼をプロンプトと呼びます。IBMの資料では、生成AIの訓練、特定用途への調整、生成と評価は別の段階として説明されています(出典: IBM)。利用中に具体的な指示や例を加えることは、その回答を整える助けにはなりますが、基礎となるモデルの再学習と同じとは限りません。
AIの出力に問題があったとき、「もっと賢くしてほしい」だけでは原因を絞れません。入力が不足していたのか、ラベルの基準が曖昧なのか、学習例と利用場面が違うのか、モデルの予測を人が確認すべき用途なのかを分けて考える必要があります。教師あり学習を知る価値は、AIを万能視することでも過小評価することでもなく、確認すべき場所を具体的に見つけられる点にあります。
明日からAIの予測を見るための五つの質問
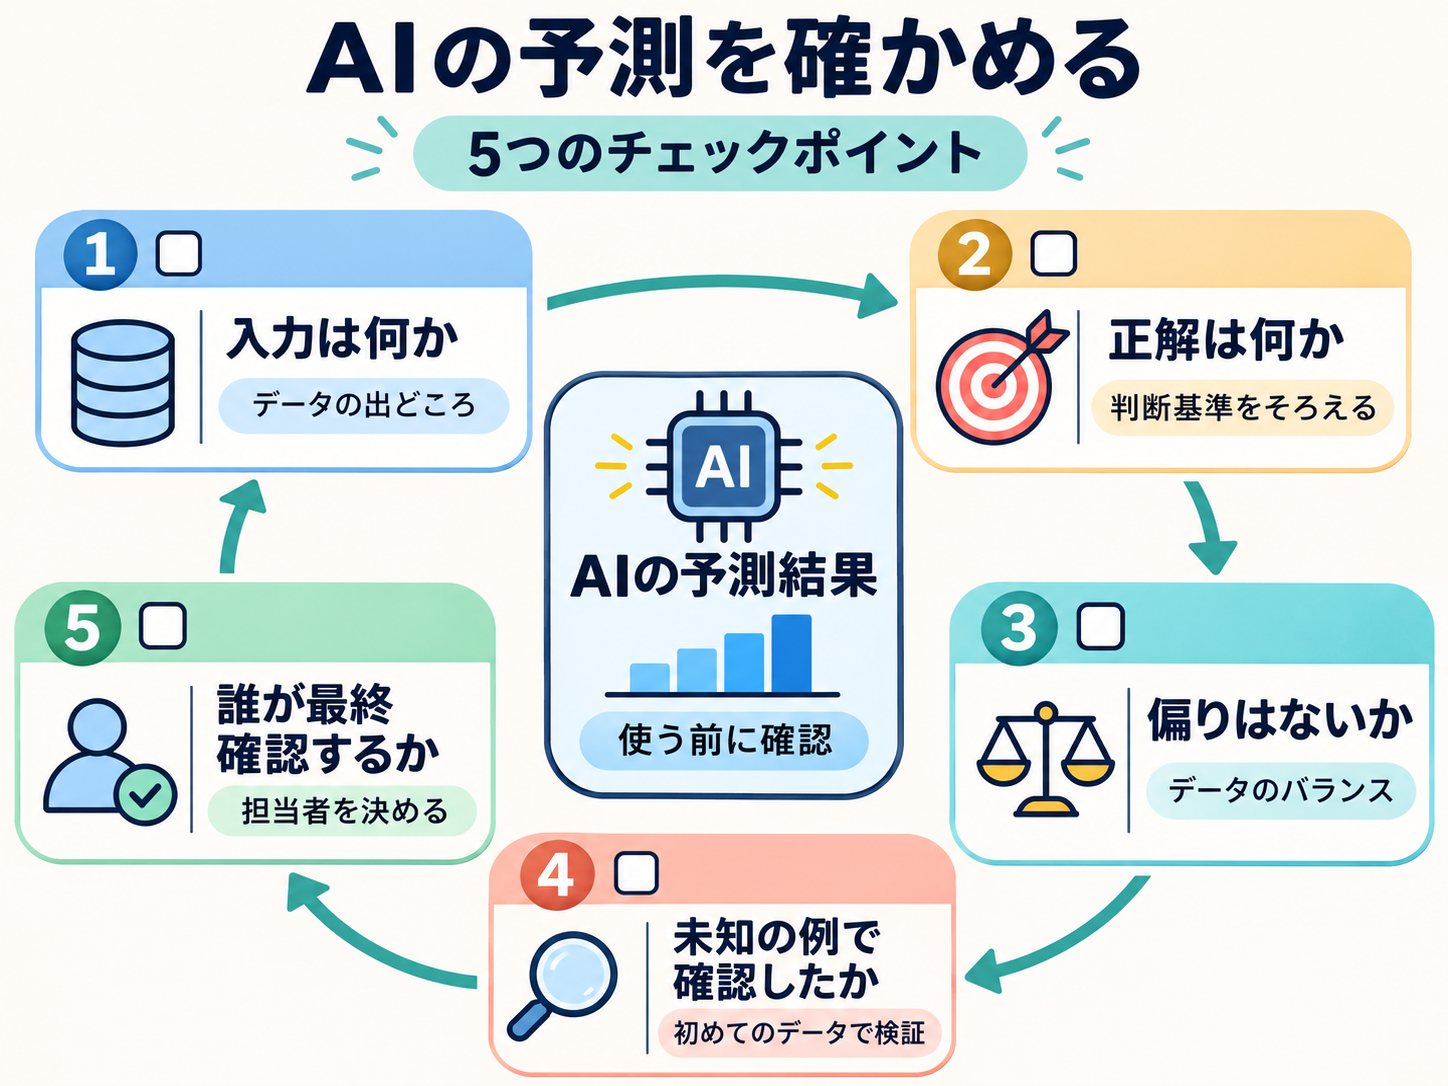
教師あり学習の仕組みを数式まで覚える必要はありません。AIによる分類や数値予測を見かけたとき、入力、正解、教材、未知の例、利用方法という五つの観点を持つだけでも、結果を落ち着いて判断しやすくなります。製品名や専門用語が分からない場合でも、何を材料に何を予測しているのかは尋ねられます。
1. 何を入力として使っているのかを確認します。文章、画像、過去の数値など、判断材料に含まれるものを見ます。
2. 何を正解として学ばせたのかを確認します。分類名や数値が、誰のどの基準で決められたのかを考えます。
3. 学習用データは利用場面に近いかを確認します。対象となる人、時期、環境、入力の種類に偏りがないかを見ます。
4. 初めて見るデータでも確かめたかを確認します。学習に使った例だけで評価していないかを尋ねます。
5. 間違えた場合に誰が確認するのかを決めます。予測を参考情報として扱うのか、そのまま処理へ使うのかを分けます。
たとえば、社内文書を種類別に振り分ける仕組みを提案された場合、「AIだから便利そうです」と判断する前に、分類名の定義を確認できます。「申請書」と「報告書」の境界が担当者ごとに違えば、学習用ラベルも揺れるでしょう。利用者が判断に迷う文書は、モデルにとっても一貫した教材を作りにくい対象です。先に分類ルールを整理することが、AIを使うかどうかとは別に必要かもしれません。
教師あり学習を一言で表すなら、「正解つきの例から、入力と答えの対応を学ぶ方法」です。覚えておきたいのは、正解が付いていることよりも、その正解を誰がどの基準で付け、どの範囲の例を用意したかです。明日、AIによる判定や予測を目にしたら、結果だけを受け取らず、「この答えの練習問題は何だったのか」と一度問いかけてみてください。その質問が、AIを必要以上に怖がらず、任せすぎもしないための具体的な一歩になります。
参考情報
- What Is Artificial Intelligence (AI)?(IBM、2024年8月9日公開、2026年10月2日更新、2026年11月2日取得)
- AI vs. Machine Learning: How Do They Differ?(Google Cloud、資料内に公開日記載なし、2026年11月2日取得)
- Machine Learning Glossary: Generative AI(Google for Developers、資料内に公開日記載なし、2026年11月2日取得)