

2026/11/13
今更聞けないAI知識
AIのファインチューニングとは?「質問の工夫」と「追加学習」の違い
この記事の要点
ファインチューニングは、学習済みのAIモデルに特定の用途の追加学習を行うことです。架空の問い合わせ分類を例に、質問に指示や資料を添える方法との違い、学習用の例を作る考え方、追加学習後も評価が必要な理由を説明します。
目次
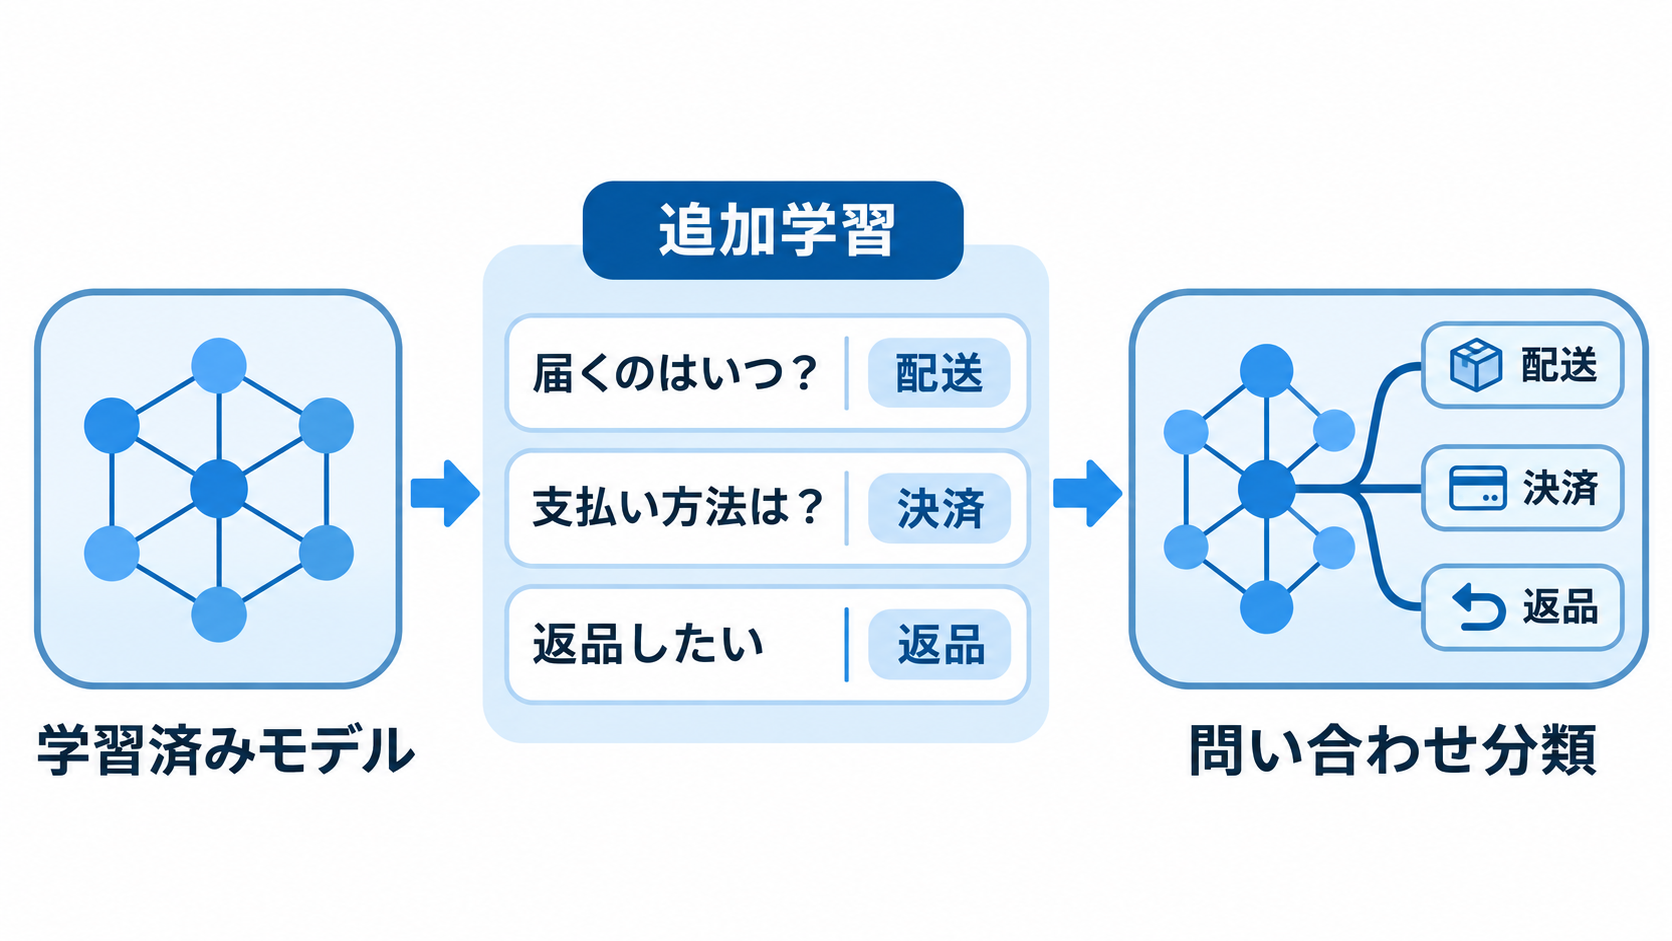
「社内の決まりに合わせたい」ときに出てくる言葉
AIに問い合わせ文の仕分けを頼んだところ、内容は読み取れているのに、自社で使う分類とは少し違う答えが返ってきます。「配送」と答えてほしいところで「注文の相談」と返されたら、担当者が仕分け直す必要があるでしょう。これは仕組みを説明するための架空の場面ですが、「一般的には答えられるAIを、特定の仕事に合わせたい」という疑問につながります。
その方法の一つが、ファインチューニングです。一言でいうと、**学習済みのモデルに、特定の用途に合わせた追加学習を行うことです**。Googleの公式用語集では、事前に学習したモデルのパラメーターを、特定の用途に向けた追加の学習で調整する手法と説明されています。「パラメーター」は、モデルの出力を左右する内部の数値設定、と捉えると入りやすいでしょう。(出典: Google Developers)
ここでいう「モデル」は、学習によって得られた、入力に応じて出力を作る仕組みです。Google Cloudは、機械学習のモデルを、学習用データにアルゴリズムを適用して得られるものと説明しています。画面に表示されるチャットそのものと、回答を作るモデルは、分けて考えると整理しやすくなります。(出典: Google Cloud)
ただし、「会社の事情を踏まえてほしい」と感じたら、すぐに追加学習が必要になるわけではありません。質問に分類ルールを添えるだけで、目的に合うかを確かめられる場合もあるでしょう。押さえたいのは、答えを変える方法には、質問の渡し方を変える方法と、モデルを追加学習する方法がある、という区別です。
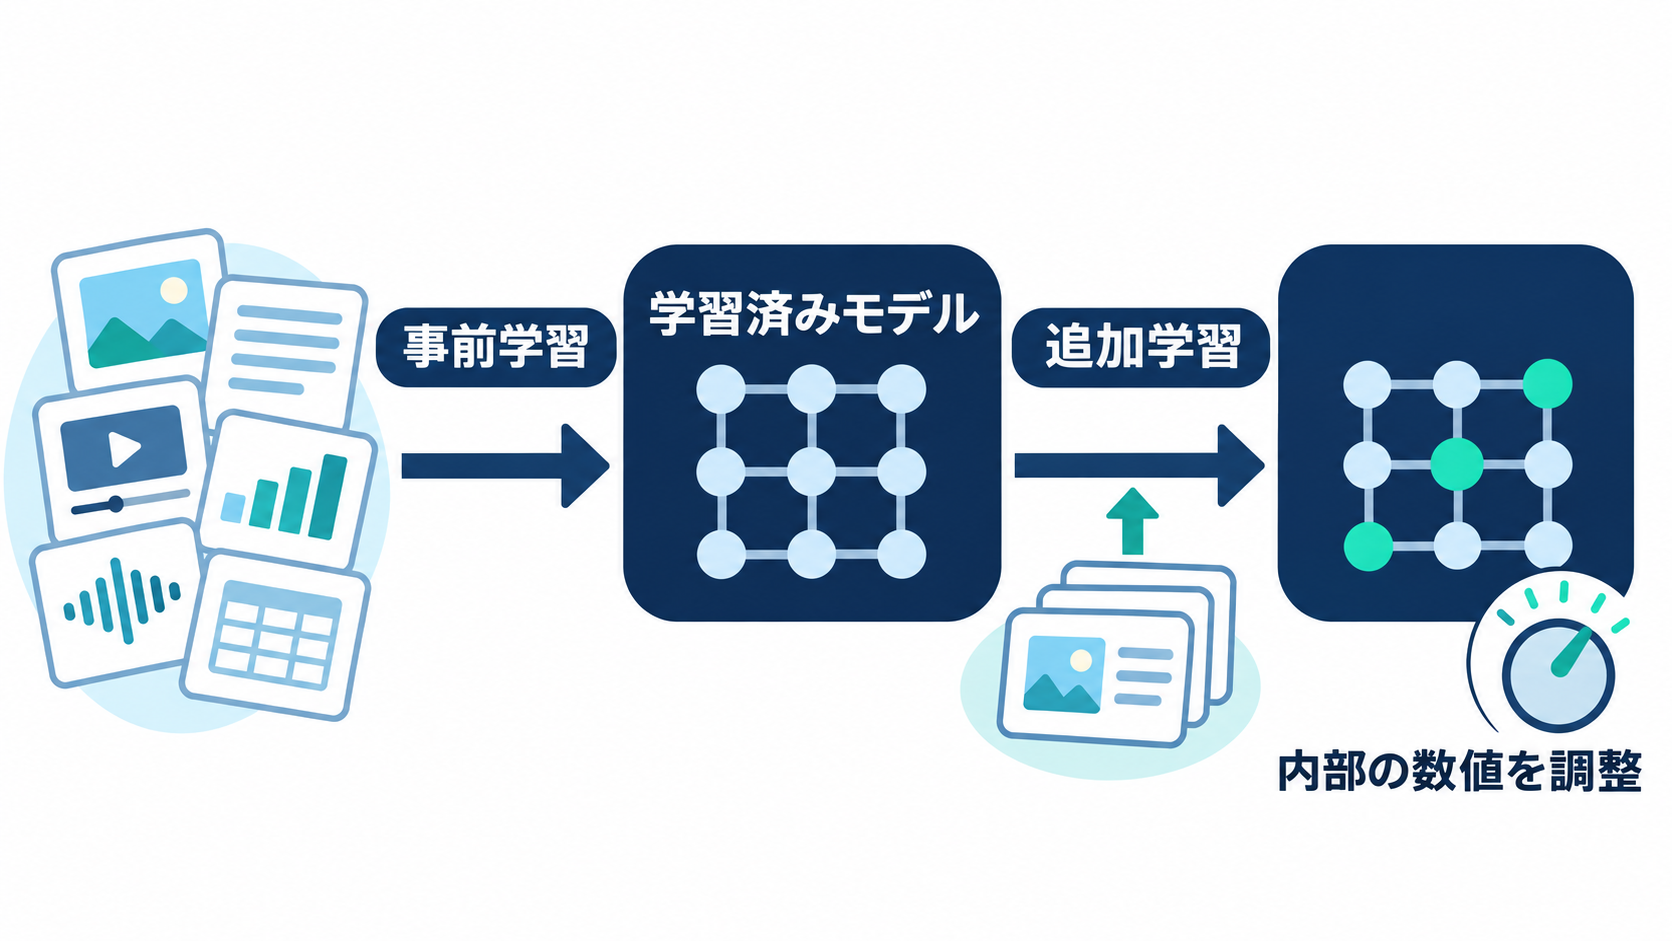
基礎練習のあとに、用途を絞った練習を重ねるイメージ
ファインチューニングは、幅広い基礎練習を終えたあと、特定の競技に必要な練習を重ねることにたとえられます。基礎からすべてやり直すのではなく、すでに身につけた土台を利用して、用途を絞って調整するイメージです。ただし、これは学習の段階を説明するたとえです。AIに人間のような意欲や理解があるという意味ではありません。
Googleの公式用語集では、事前学習として広い範囲のデータを使い、その後、特定の課題に向けてファインチューニングする流れが示されています。文章を扱うモデルだけでなく、画像を扱うモデルも例に挙げられており、文章の言い回しを整えるだけの技術ではないと分かります。(出典: Google Developers)
仕組みの中心は、学習用の例を通してモデルの内部を調整する点にあります。IBMは、特定の用途で想定される質問や入力と、望ましい形式の正しい回答を与える方法を説明しています。問い合わせの仕分けなら、「問い合わせ文」と「付けてほしい分類名」の組み合わせが、追加学習に使う例として考えられるでしょう。(出典: IBM)
「調整」といっても、内部の数値設定をすべて変更する方法だけではありません。Googleの用語集には、一部だけを変更する方法なども示されています。初心者の段階で方式の名前を覚える必要はありませんが、「モデル全体を一から作り直す」という理解では、実態を捉えきれません。(出典: Google Developers)
この区別が分かると、「新しくAIを作る」と「既存のAIを用途に合わせる」を同じ作業として受け取らずに済みます。ファインチューニングという言葉を見かけたら、すでにある学習の土台に対して、何を追加で学習させるのかに注目するとよいでしょう。
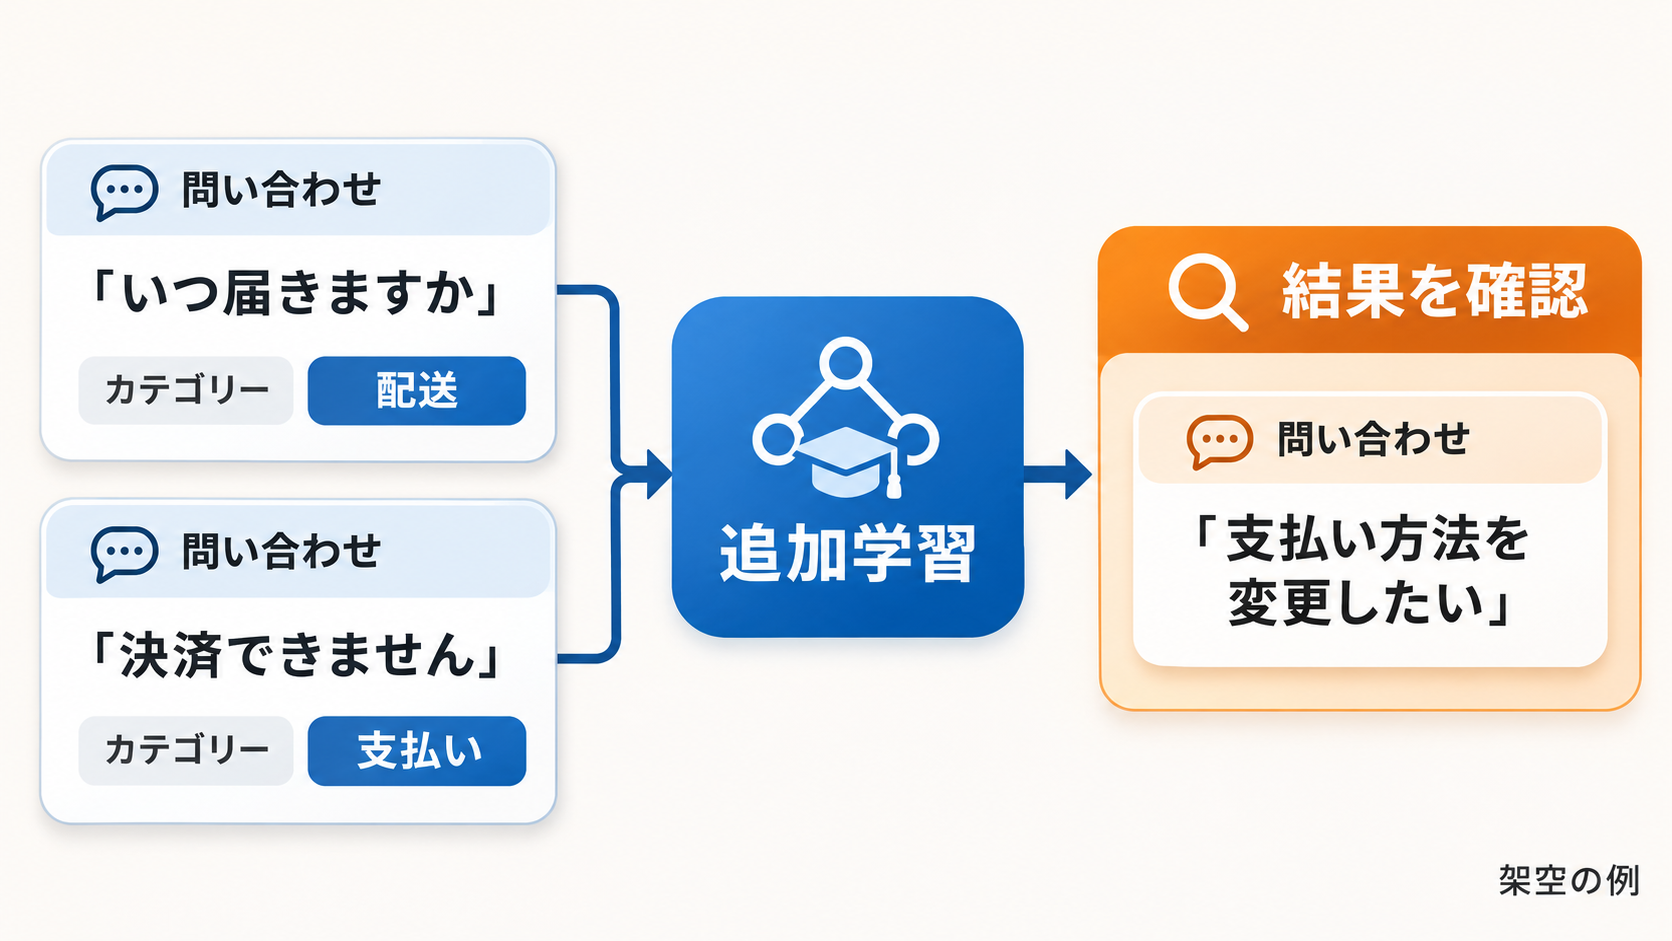
架空の問い合わせ分類で考える「学習させる例」
ここからは、問い合わせを「配送」「支払い」「返品」の三つに分けたい会社を想定します。以下は仕組みを理解するための架空の例であり、特定の製品で操作・検証した結果ではありません。狙いは、問い合わせの内容を、自社で使う分類基準に合わせて出力させることです。
例えば、「荷物はいつ届きますか」という文には「配送」、「カード決済ができません」という文には「支払い」を対応させます。このように、入力と望ましい出力を組にして考えます。IBMの説明でも、用途に合った入力と正しい回答の組み合わせが、ファインチューニングに使うデータとして示されています。(出典: IBM)
難しいのは、分類名を用意することより、境界を決めることでしょう。「届いた商品を返品したい」という文には、配送に関係する言葉も含まれます。それでも「返品」に分けたいなら、単語の有無だけでなく、どの相談内容を優先するかという基準が必要です。追加学習の準備では、こうした判断を人が説明できる形にすることを提案します。
また、「返品した商品の返金はいつですか」という問い合わせでは、返品と支払いの両方が関係しそうです。架空の運用案としては、どちらかを優先する基準を定めるか、「要確認」という扱いを設ける方法が考えられます。曖昧な例をどう扱うかは、AIに渡す前に整理したい点ではないでしょうか。
ここから見えてくるのは、追加学習が、未整理の社内ルールを自動的に完成させる作業ではないということです。期待する分類が人によって違えば、何を正しい出力とするかも決まりません。実施を検討する段階では、分かりやすい例だけでなく、担当者の判断が分かれる例も集め、基準をすり合わせるとよいでしょう。
質問に指示や資料を添えることとの違い
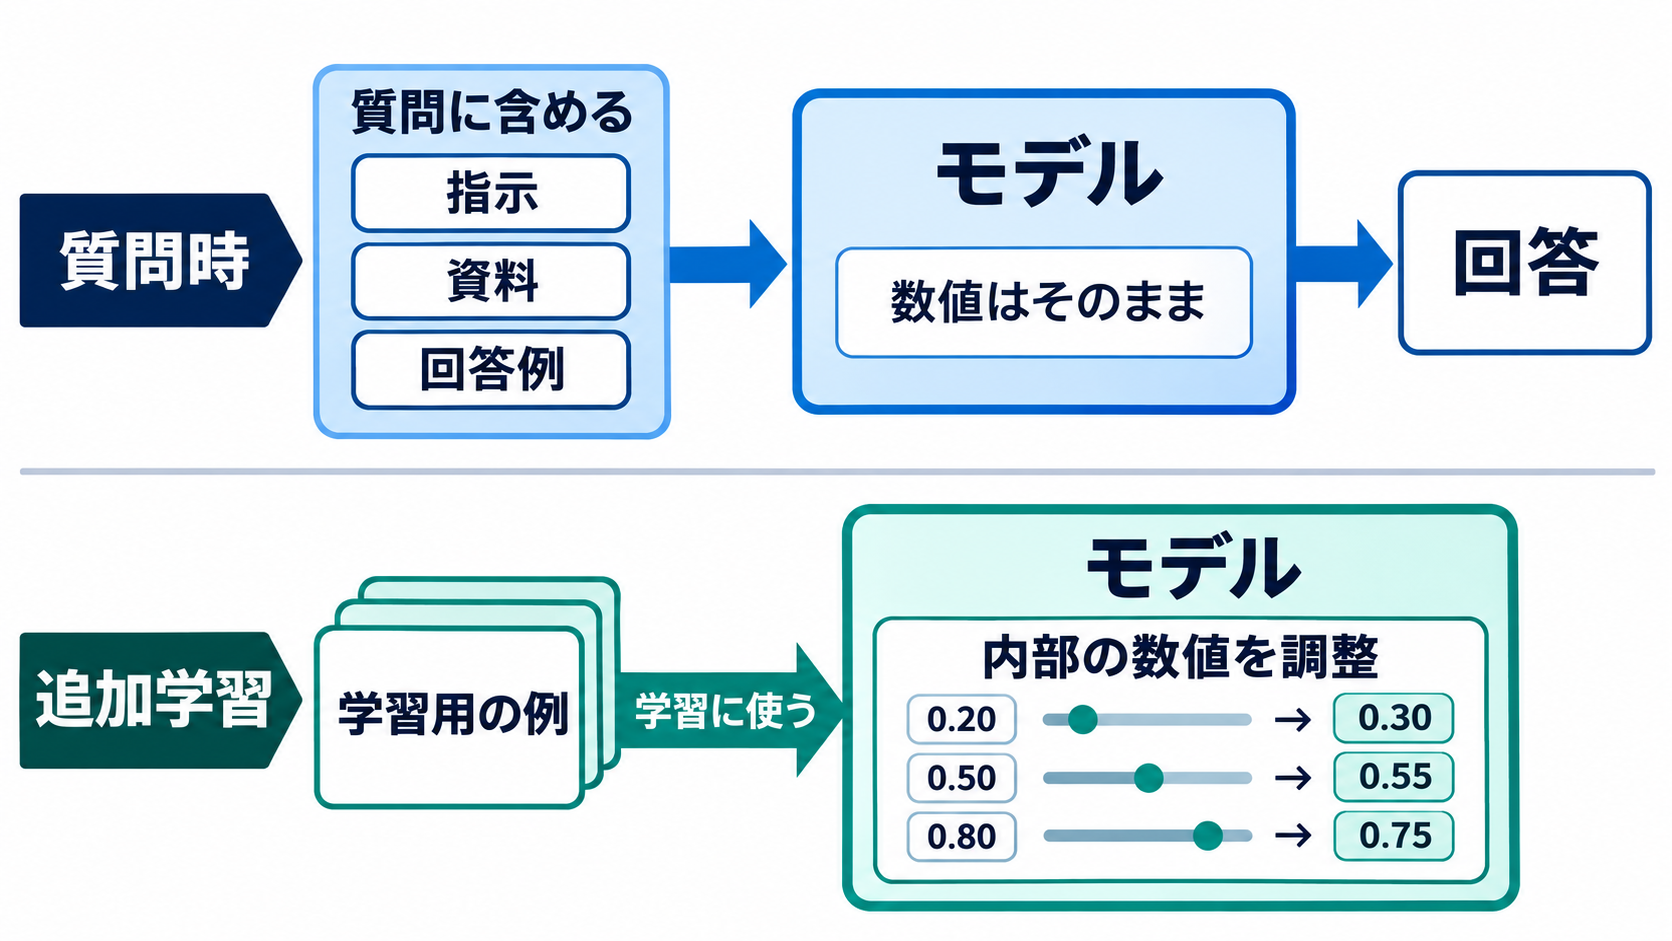
同じ問い合わせ分類でも、「次のルールに従って分類してください」と質問に書く方法があります。このときAIに渡す指示や入力を、プロンプトと呼びます。プロンプトに分類基準や回答例を含めることと、その例を使ってモデルを追加学習することは、分けて捉える必要があります。
Googleの公式用語集では、プロンプトの中に複数の回答例を含める方法が説明されています。これに対し、ファインチューニングは学習済みモデルへの追加の学習であり、内部の数値設定を調整する方法です。「例を見せる」という見かけが似ていても、例を質問の一部として渡すのか、学習用に使うのかが違います。(出典: Google Developers)
| 方法 | 情報を使う場面 | 架空の問い合わせ分類の例 |
| --- | --- | --- |
| プロンプトに指示を書く | 回答を求める際の入力として使います | 分類ルールを質問に添えます |
| プロンプトに回答例を入れる | 回答を求める際の見本として使います | 問い合わせ文と分類名の見本を添えます |
| ファインチューニング | 追加学習のデータとして使います | 問い合わせ文と分類名の組でモデルを調整します |
資料を添える場合も、考え方は同じです。「この規定を参照して答えてください」と回答時の材料を渡すことと、その資料を用いてモデルを追加学習することは、同じ操作とは限りません。少なくとも、資料を質問に含めたという事実だけで、ファインチューニングを行ったとは判断できません。
試し方の提案としては、短い分類基準と回答例を質問に添え、求める結果に近づくかを見るところから始められます。そこで残った困り事を具体化すれば、追加学習を検討する際も、「何となく自社向けにしたい」より相談しやすくなるでしょう。追加学習の実施を前提にせず、必要な出力を言葉にすることが出発点です。
追加学習しても「必ず正しい」にはならない理由
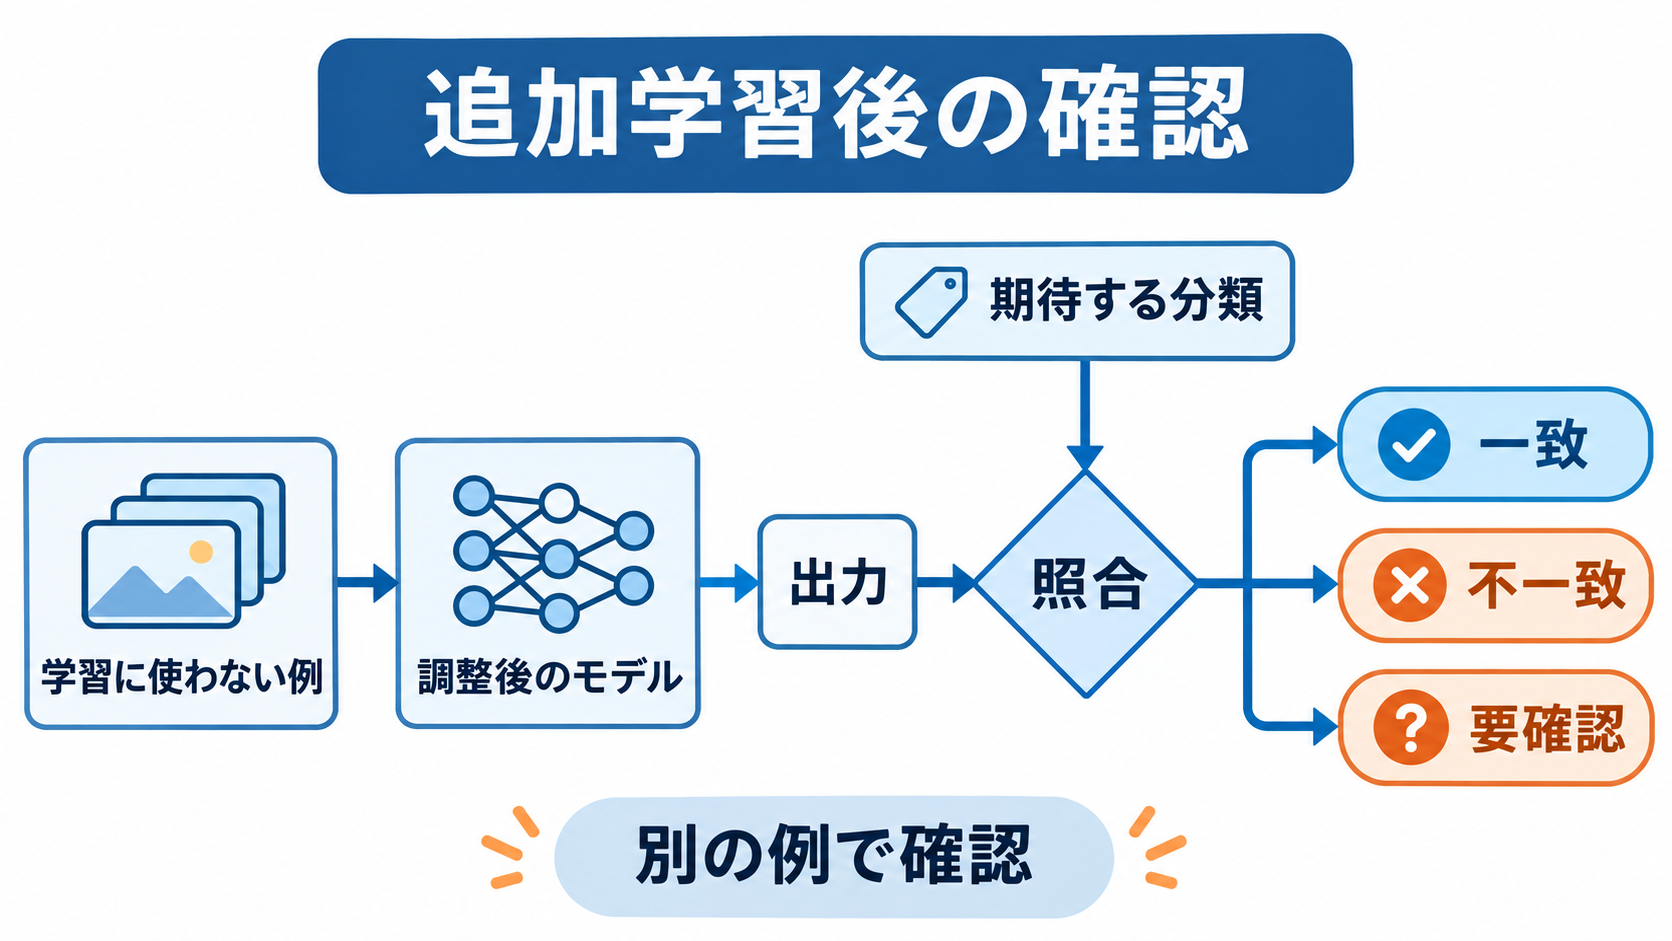
社内の基準に合わせて追加学習したと聞くと、「これで誤分類はなくなる」と期待したくなるかもしれません。しかし、特定の用途に向けて調整することと、あらゆる入力で正解することは別です。Googleの公式用語集では、モデルの品質を測ったり、モデル同士を比較したりする作業を「評価」と説明しています。学習を行ったという事実だけでは、品質の確認を終えたことにはなりません。(出典: Google Developers)
例えば、学習用の例では「返金」に関する問い合わせをすべて「支払い」にしていても、新しい問い合わせが同じように分類されるかは確かめたいところです。相談内容が二つ混ざる文や、事情が省略された短い文もあり得るでしょう。これらは架空の確認例ですが、期待する出力を決めたうえで、実際の出力と照らし合わせる必要性が見えてきます。
確認方法として、学習に使う例とは別に、評価用の問い合わせを用意することを提案します。Googleの評価の説明でも、教師あり学習のモデルについては、検証用・テスト用のデータで判断する考え方が示されています。見本どおりの出力を確かめるだけでなく、別の入力にも対応できるかを見る視点が大切です。(出典: Google Developers)
架空の分類業務なら、確認したいのは全体の正解数だけではありません。「返品を配送に振り分けると、担当窓口でどんな困り事が起きるか」「判断できない問い合わせを、どう受け止めるか」も検討事項になるでしょう。確認の厳しさや人が見直す範囲は、その結果を何に使うかに合わせて考えたいところです。
また、分類名が指定どおりに出力されることと、分類そのものが合っていることも区別してください。見た目が整っている回答でも、中身は確認が必要かもしれません。「社内向けに調整済み」という説明を、正しさの保証として受け取らず、何を使って評価したかまで見る姿勢が役立ちます。
明日からは「何を変えたいか」を書き出すところから
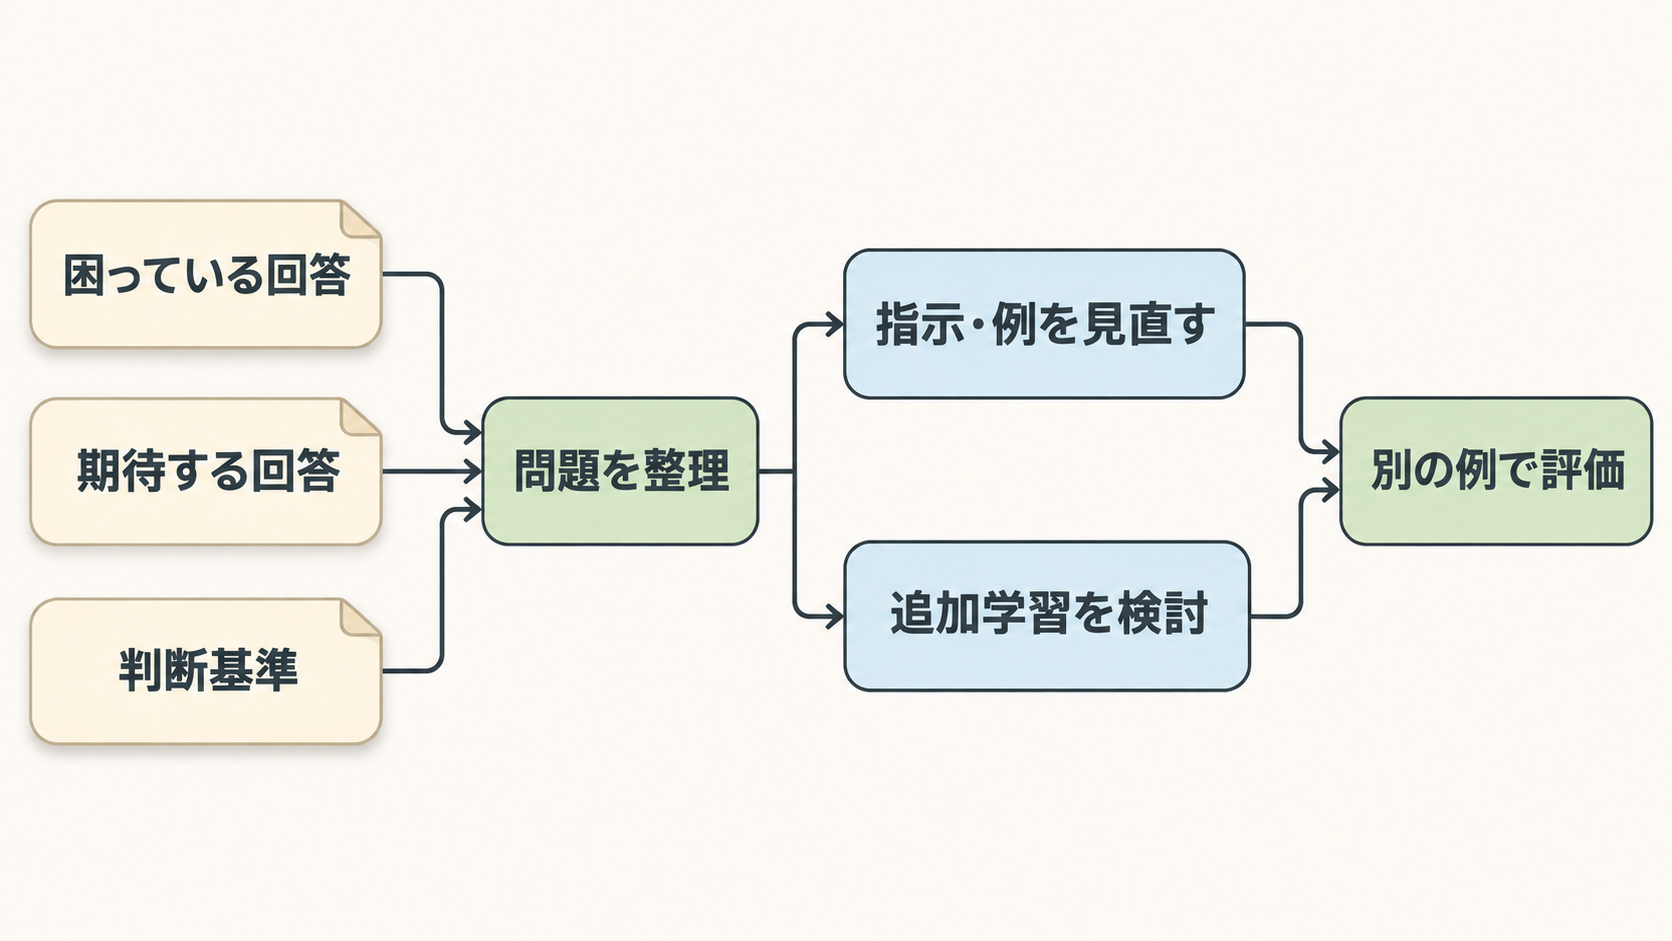
ファインチューニングを理解したあとにできることは、すぐに追加学習を申し込むことではありません。AIの答えで困っている点を、一つの具体例にすることです。「自社向けにしたい」という希望だけでは、情報が足りないのか、分類基準が伝わっていないのか、出力の形が合わないのかを見分けにくいでしょう。
架空の問い合わせ分類なら、「この文は配送と返してほしいのに、注文と返ってきます」と書き出します。そこに期待する分類の理由を添えると、確認すべき対象がはっきりします。これは実施手順を示したものではなく、身近な題材で問題を整理するための提案です。プログラミングや有料契約を前提にする必要はありません。
整理するときは、次の三つをメモにすると比較しやすくなります。
- どの入力に対して、どのような出力がほしいですか。
- その出力を正しいと判断する基準は、説明できますか。
- 指示や回答例を質問に添えた場合、どこに困り事が残りますか。
こうしたメモがあれば、技術に詳しい人へ相談する際も、希望を具体的に伝えられるでしょう。実施を検討するなら、学習に使う例の作り方だけでなく、別の例で結果をどう評価するかも相談したいところです。IBMも、生成AIの運用を、生成・評価・さらなる調整を含む流れとして説明しています。(出典: IBM)
ファインチューニングは、学習済みモデルを特定の用途へ近づける方法です。その言葉を覚えるだけでなく、「質問時に渡す材料を変えるのか、モデルを追加学習するのか」を見分けられると、説明を読み取りやすくなるでしょう。明日は、気になったAIの回答を一つ選び、期待する答えと、その理由を書いてみてください。その一組が、何を調整したいのかを考える具体的な出発点になります。
参考情報
- Machine Learning Glossary: Generative AI
- What Is Artificial Intelligence (AI)? | IBM
- AI vs. Machine Learning: How Do They Differ? | Google Cloud
資料の取得日時は2026年11月13日です。IBMの記事には、公開日が2024年8月9日、更新日が2026年10月2日と記載されています。取得日は記事の公開日とは異なります。