
2026/11/03
今更聞けないAI知識
ファインチューニングとは?「既製服の仕立て直し」でプロンプトとの違いを理解する
この記事の要点
ファインチューニングは、学習済みモデルを特定用途のデータで追加学習し、望ましい反応へ調整する方法です。既製服の仕立て直しをたとえに、プロンプトとの違い、学習例の役割、適した仕事、正解が保証されない理由を初心者向けに説明します。
目次
同じ指示を何度も書くなら、AIそのものを調整できるのか
社内向けの文章を生成AIに頼むたびに、「専門用語を避ける」「結論を先に書く」「この形式で出力する」と指定していると、AIそのものにルールを覚えさせたくなるかもしれません。そこで登場する言葉がファインチューニングです。名前は難しそうですが、一言で表すなら、**学習済みのモデルを、特定の用途に合うデータで追加学習して調整すること**です。
ここでいうモデルとは、入力を受け取り、学習したパターンをもとに出力を作る仕組みを指します。生成AIでは、文章や画像などを作る土台として利用されます。IBMの解説によると、生成AIでは広い用途に使える基盤モデルを用意し、その後、特定の内容生成タスクに合わせて調整する流れがあります。ファインチューニングは、その調整方法の一つとして位置付けられています(出典: IBM)。
ただし、「AIに一度お願いしたら、その内容を恒久的に覚えてくれる」という意味ではありません。会話で渡す依頼と、モデルを追加学習する工程は分けて考える必要があります。前者はプロンプト、つまりAIへの入力や指示であり、後者は学習済みモデルのパラメーターと呼ばれる内部の調整値を、用途に合わせて変える取り組みです。
ファインチューニングの中心にあるのは、AIを何でも知っている存在に変えることではなく、特定の仕事で望まれる反応の傾向を学ばせることです。出力形式や分類方法をそろえたい場面では検討対象になりますが、回答の事実性を保証する仕組みではありません。この区別を知っておくと、「指示文を工夫すればよい問題」と「モデルの調整まで検討する問題」を混同しにくくなります。
既製服を用途に合わせて仕立て直すイメージ
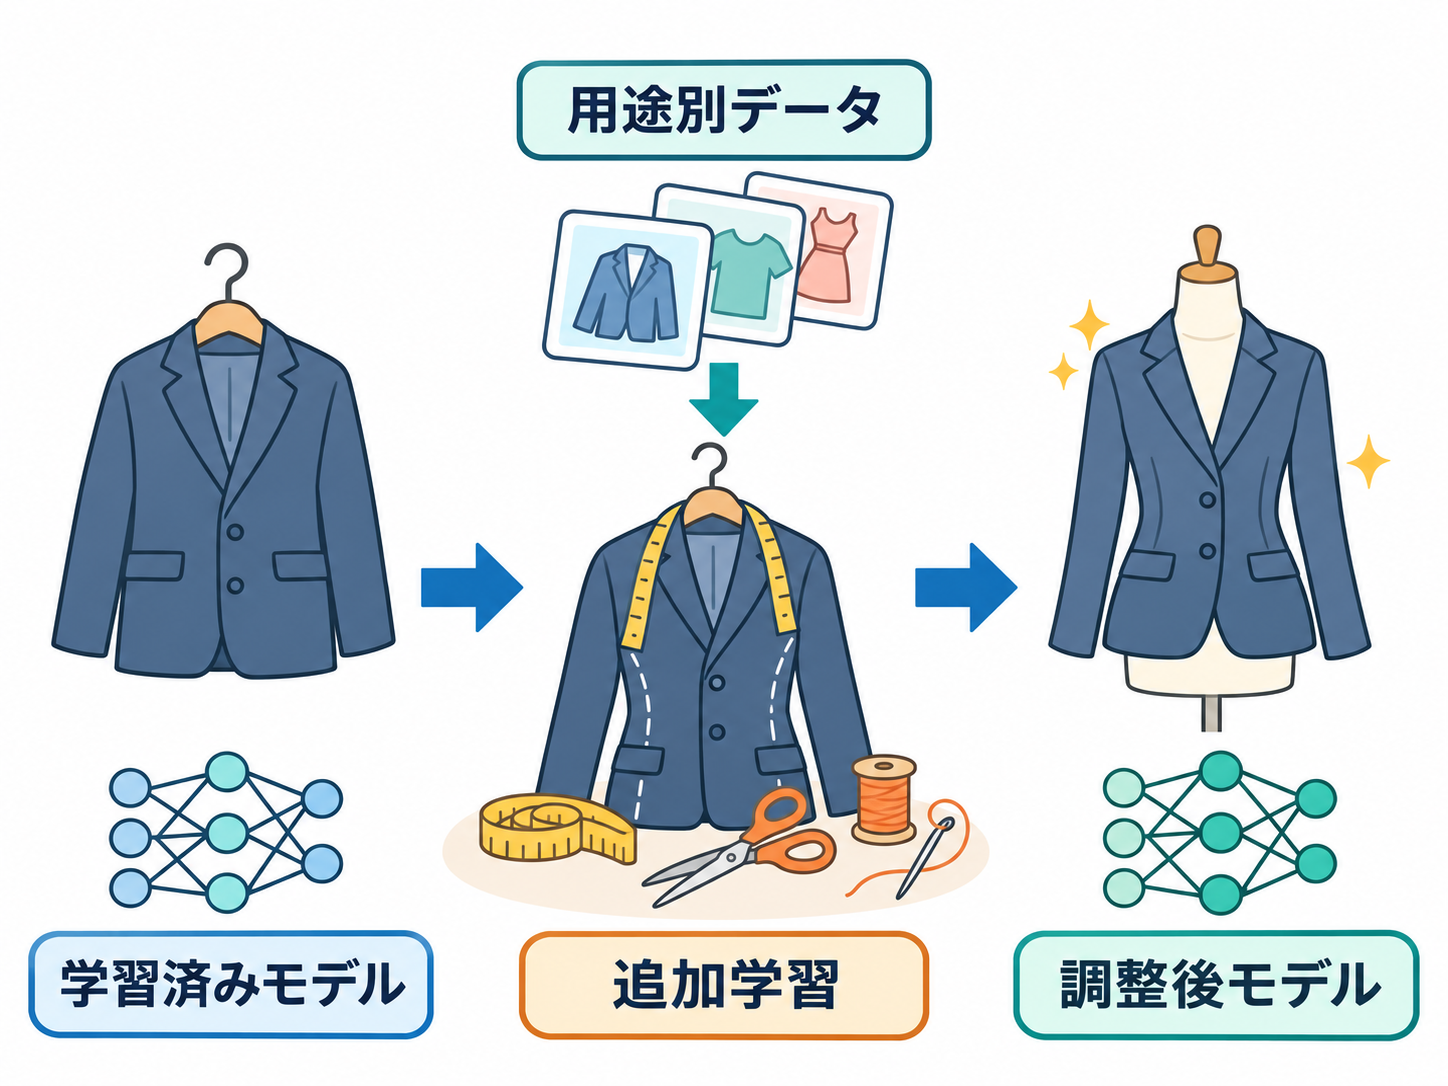
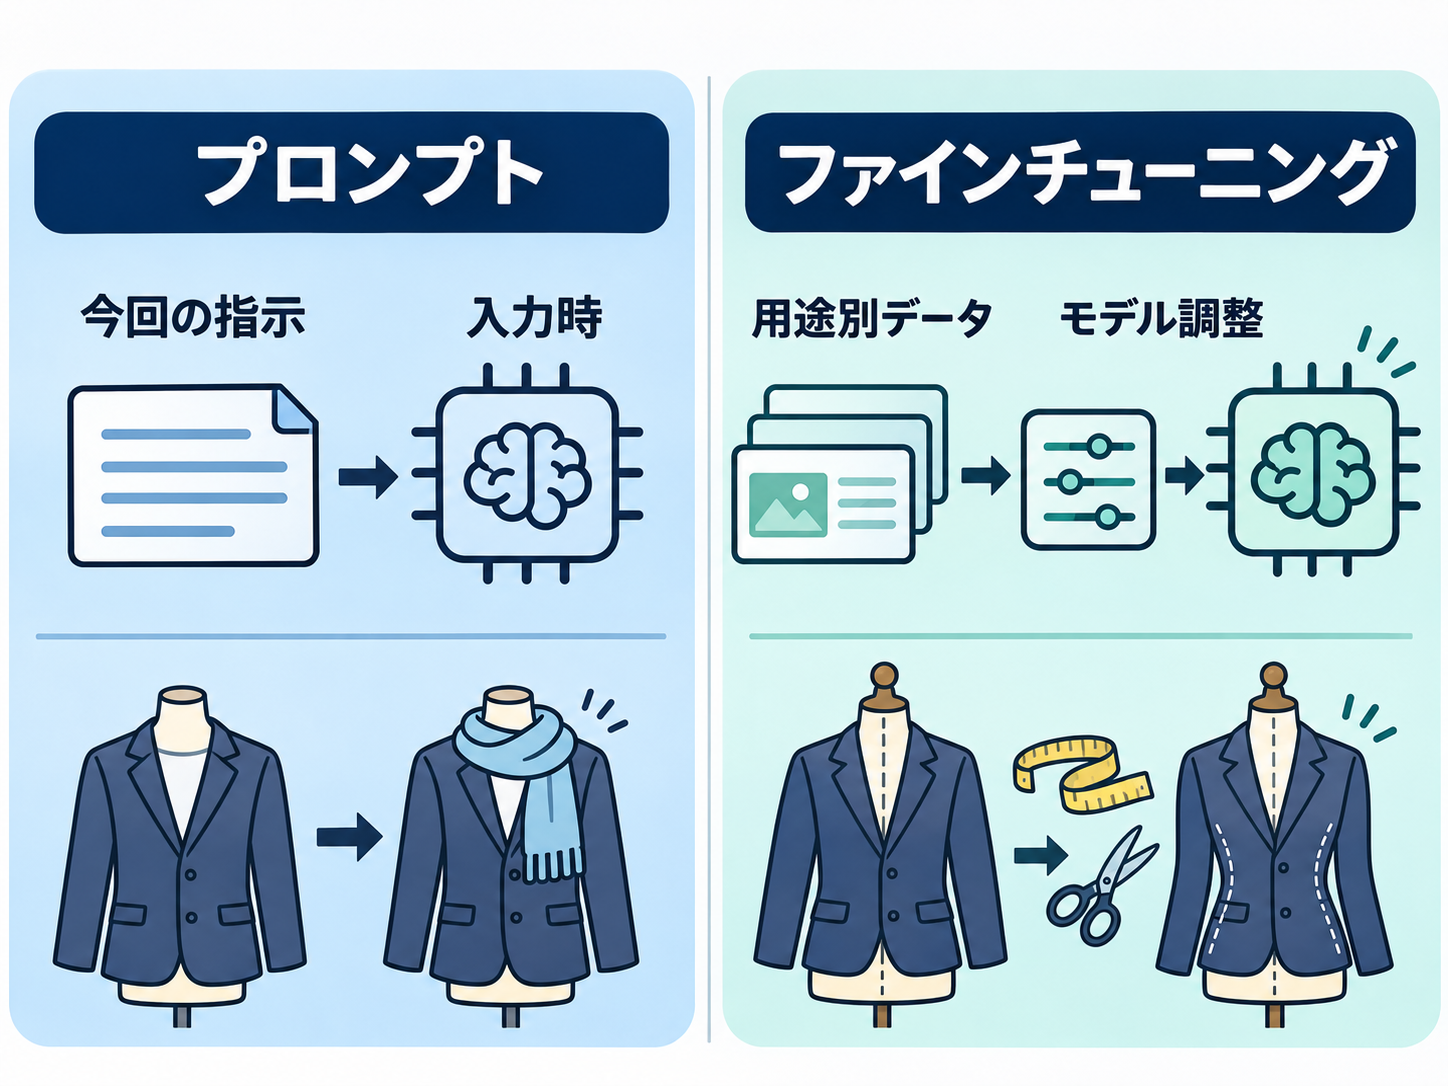
ファインチューニングは、既製服の仕立て直しに置き換えると理解しやすくなります。あらかじめ多くの人が着られるように作られた既製服が、広い用途に対応する学習済みモデルです。そのままでも使えますが、着る人や場面によっては、袖の長さ、裾、シルエットなどを調整したくなるでしょう。その採寸情報と完成見本に相当するものが、特定用途向けの学習データです。
たとえば、架空の相談窓口で、受け取った文章を「質問」「要望」「苦情」のいずれかに分類するモデルを考えます。一般的なモデルにも文章を扱う力はありますが、組織独自の分類基準までは自動的に共有されません。そこで、入力文と望ましい分類結果を組にした例を用意し、その用途に合わせて追加学習する、という考え方が成り立ちます。これは活用案であり、特定の製品で同じ手順や結果が保証されるという意味ではありません。
Google for Developersの用語集では、ファインチューニングは、学習済みモデルに対して行うタスク固有の二度目の学習工程と説明されています。また、事前学習で広いデータを扱った後、医療関連の問い合わせへの応答など、限定した仕事に焦点を当てて調整する例が示されています(出典: Google for Developers)。
このたとえで注意したいのは、仕立て直しが服をまったく別の物に作り替えるわけではない点です。元の服の素材や構造が残るように、ファインチューニング後のモデルも、土台となる学習済みモデルの性質を引き継ぎます。追加データだけで能力や知識が無制限に増えるわけではありません。「用途に合う傾向を強める調整」と捉えると、期待を膨らませすぎずに済むでしょう。
追加学習では何をモデルに見せるのか
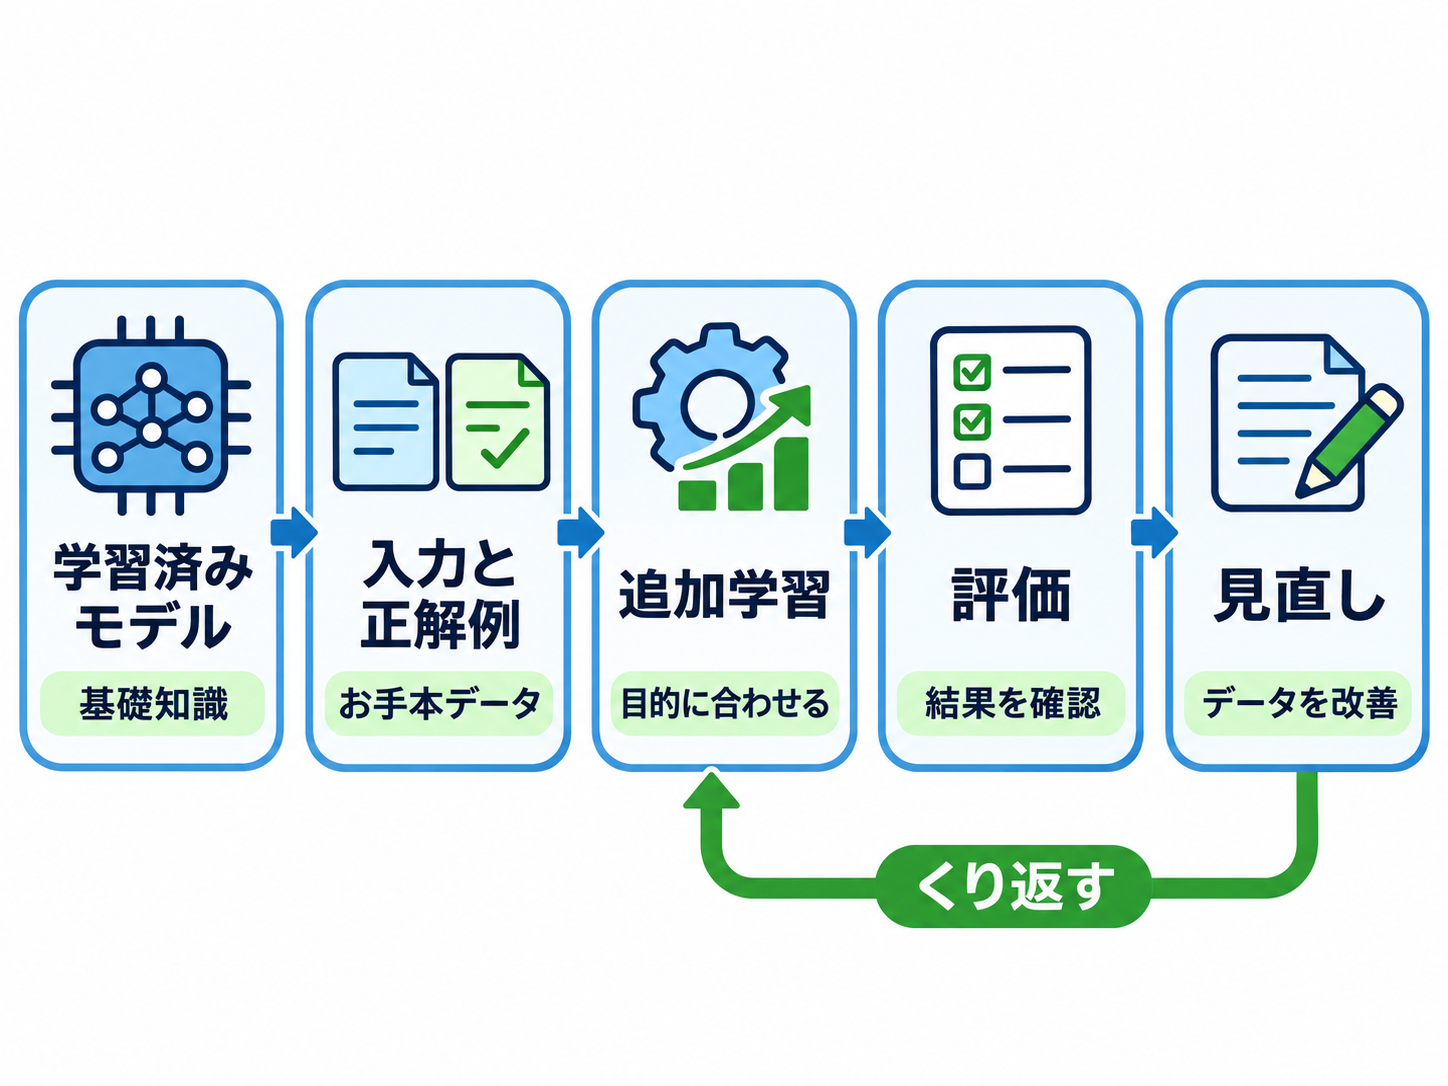
追加学習と聞くと、マニュアル一式をAIに読ませれば完了するように感じるかもしれません。しかし、ファインチューニングの説明で重視されているのは、用途に関係する入力と、望ましい出力の対応です。IBMは、用途固有のラベル付きデータ、想定される質問やプロンプト、それらに対する正しい回答を望ましい形式で与える方法を挙げています(出典: IBM)。ラベルとは、データに付ける正解や分類名のことです。
架空の例として、商品への問い合わせを分類する場合を考えてみましょう。「配送先を変えたい」という入力に「配送変更」、「届いた商品が壊れていた」という入力に「破損対応」という望ましい分類を組み合わせます。文章を作らせる用途なら、依頼文と模範的な回答文を組にする考え方もあります。ここで大切なのは、例の数だけではありません。分類基準が例ごとに揺れていれば、モデルが学ぶべきパターンも曖昧になります。
Google for Developersの用語集では、ファインチューニングには一般に、対象タスクへ焦点を当てた数百または数千の例が使われると説明されています(出典: Google for Developers)。ただし、この数はあらゆる用途に共通する成功条件ではありません。必要なデータの量や内容は、扱う仕事、土台となるモデル、求める出力によって変わると考えるべきです。
学習の後には評価も必要です。評価とは、モデルの出力品質を測ったり、複数のモデルを比べたりする工程です。用意した学習例に似た問題だけでなく、まだ見せていない入力でも、望む基準に沿っているかを確かめます。IBMの解説でも、生成AIの出力を継続的に評価し、必要に応じて調整する流れが示されています(出典: IBM)。
つまり、ファインチューニングは「資料を投入する作業」だけではありません。何を正解とするかを決め、対応する例を整え、学習後の出力を確かめる一連の取り組みです。判断基準が定まっていない段階では、モデルより先に、人の側で望ましい回答や分類を整理する必要があるでしょう。
プロンプトでの指示との境界線
プロンプトは、AIにその場で渡す質問や指示です。「200字以内でまとめてください」「専門用語には説明を添えてください」と入力する行為が該当します。ファインチューニングは、その都度の依頼文ではなく、学習済みモデルを用途に合わせて追加学習する工程です。どちらも出力を望む方向へ近づけるために使われますが、働きかける場所が異なります。
既製服のたとえを続けるなら、プロンプトは「今日はベルトを合わせて、袖を折って着る」という当日の着こなし指定です。ファインチューニングは、袖や裾そのものを仕立て直す作業に当たります。一度だけ必要な指定なら着こなしで対応できますが、同じ条件が繰り返され、用途として固定されているなら、仕立て直しを検討する余地が生まれます。
| 比較する点 | プロンプト | ファインチューニング |
| --- | --- | --- |
| 何をするか | その場の質問や条件を入力する | 学習済みモデルを特定用途向けに追加学習する |
| たとえ | 服の着こなし方を指定する | 服の寸法や形を仕立て直す |
| 向いている判断 | 一回ごとに目的や条件が変わる | 同じ判断基準や出力傾向を繰り返し求める |
| 用意するもの | 目的や条件を書いた指示 | 用途に沿った入力例と望ましい出力例 |
| 注意点 | 指示が曖昧だと出力もずれやすい | 追加学習しても回答の正しさは保証されない |
たとえば、架空の会議メモを「決定事項」「未決事項」「担当者」に分けたいだけなら、最初はプロンプトで見出しと形式を指定して試す方法が考えられます。入力の種類が少なく、担当者が結果を確認できるなら、それで目的を満たせるかもしれません。同じ形式を大量の異なる文章へ一貫して適用したい場合には、必要性や運用条件を整理したうえで、追加学習を検討する流れになります。
この比較は、ファインチューニングのほうが常に高度で優れている、という順位付けではありません。目的がその場の依頼で済むなら、プロンプトのほうが問題に直接合っています。モデルを変える前に、求める出力を言葉で説明できるかを確かめることが、判断の出発点になるでしょう。
検討しやすい仕事と、急がなくてよい仕事
ファインチューニングを検討しやすいのは、同じ種類の入力に対して、繰り返し同じ基準の出力を求める場面です。たとえば、架空の社内窓口で問い合わせを独自の区分に振り分ける、文章を決められた構成へ整える、特定用途の回答例に近い形式を求める、といった案が考えられます。いずれも提案上の例であり、導入効果や精度を実測した事例ではありません。
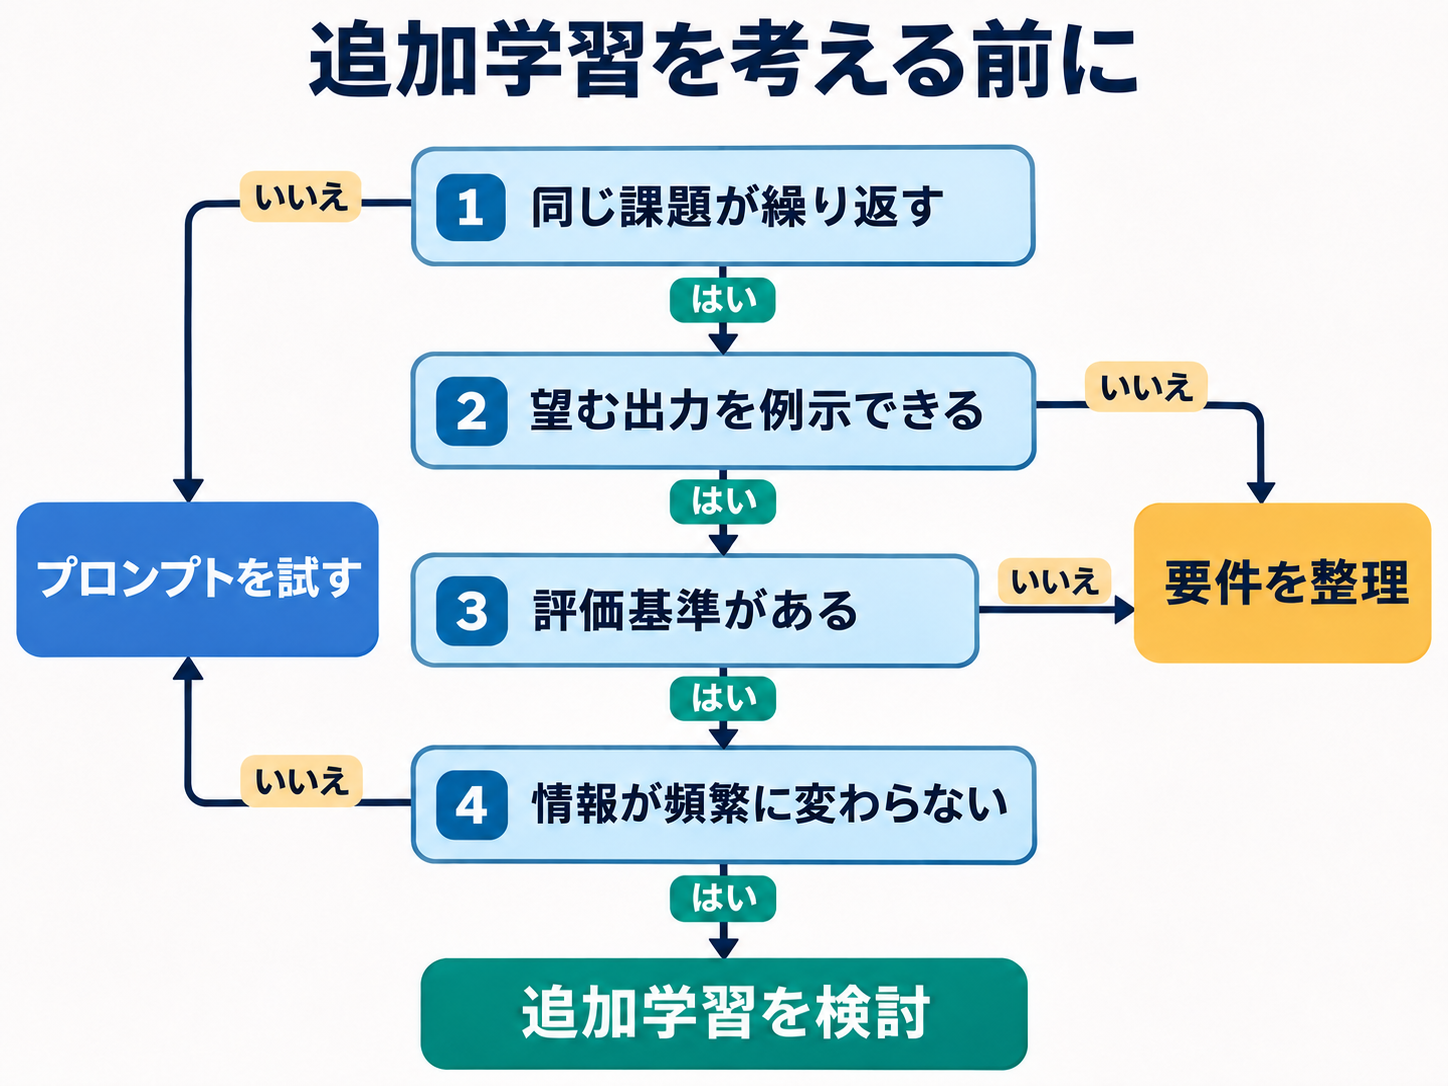
適しているかを考える際は、「模範となる出力を人が示せるか」が一つの手掛かりになります。担当者ごとに正解が異なる仕事や、判断基準が毎週変わる仕事では、追加学習に使う例をそろえること自体が難しくなります。学習データの中で方針が矛盾すれば、モデルに期待する反応も不明確になるでしょう。
反対に、一度だけ作る案内文、日によって条件が変わる相談、回答前に最新資料を確認する必要がある質問などは、すぐにファインチューニングへ進む必要があるとは限りません。特に最新情報が必要な場面では、過去のデータによる追加学習だけで解決しようとすると、情報の更新とモデル調整を混同してしまいます。IBMは、学習データの外にある関連情報を使う別の方法として、検索拡張生成を挙げています(出典: IBM)。ただし、本記事では仕組みの違いを示すための紹介にとどめます。
判断するときは、対象業務について「入力は似ているか」「望む出力を例示できるか」「正解を評価できるか」「情報は頻繁に変わらないか」を確認すると整理しやすくなります。四つすべてに明確な答えがあるからといって、必ず追加学習が必要になるわけではありません。プロンプトで試した結果と、残った問題を具体的に分ける材料になります。
ファインチューニングという言葉を知ると、今使っている生成AIにもすぐ設定したくなるかもしれません。しかし、初心者が最初に行うべきことは操作方法を探すことではなく、同じ困りごとが本当に繰り返されているかを見極めることです。用途が曖昧なままでは、どのような学習例を用意すべきかも決まりません。
追加学習しても正解が保証されない理由
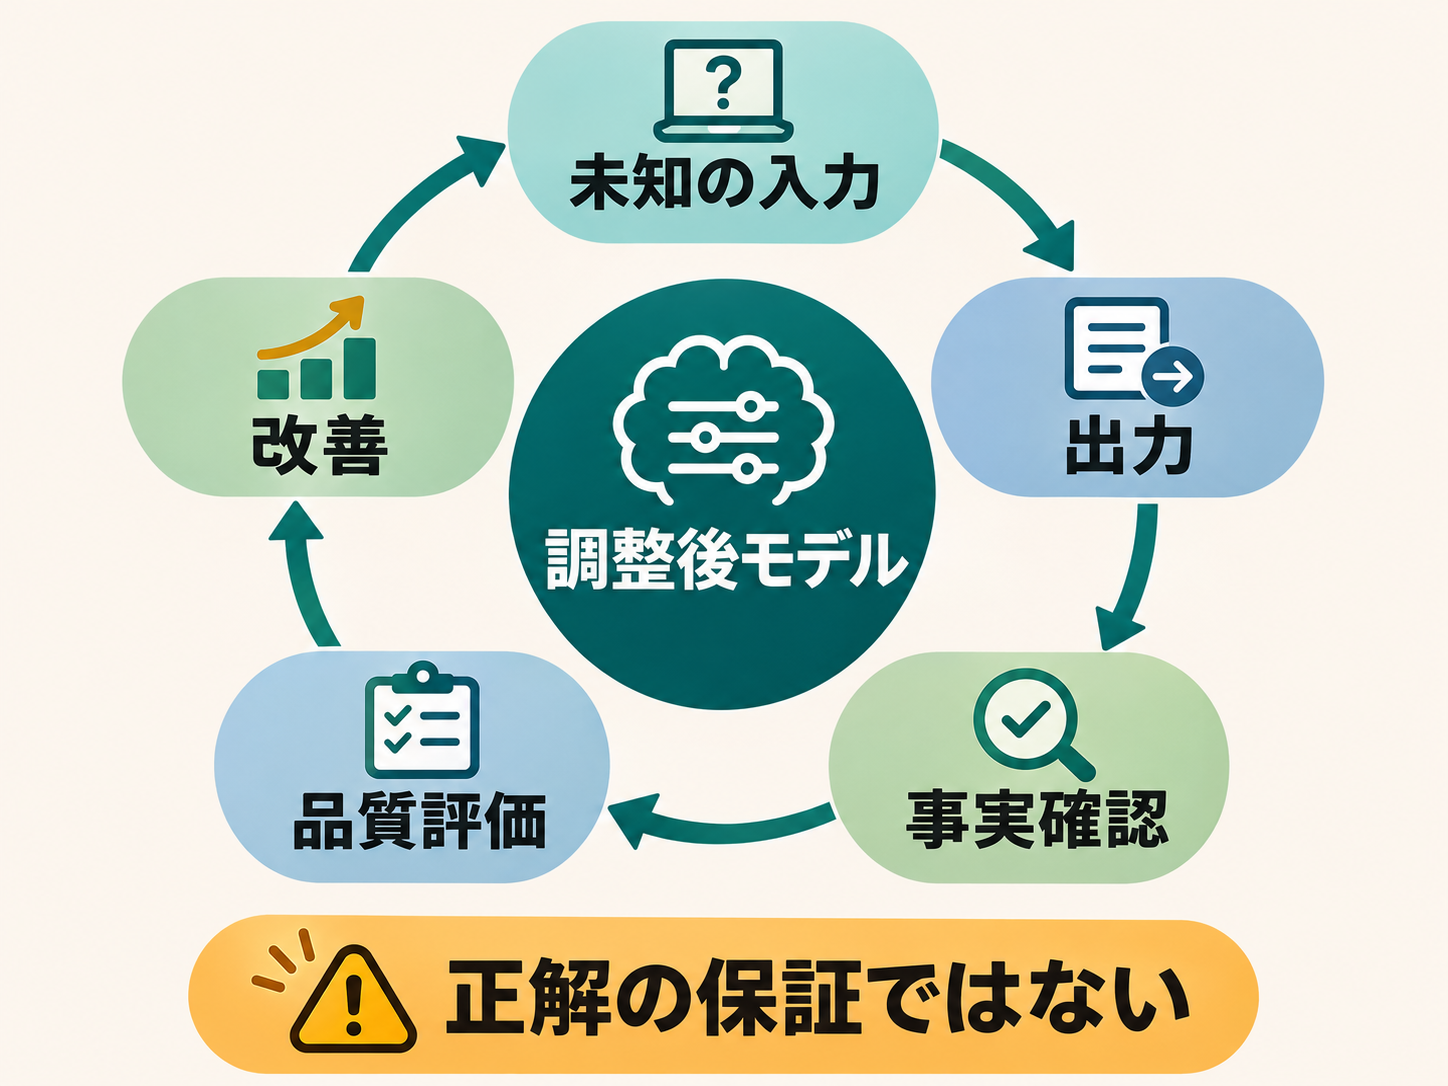
ファインチューニングをすると、AIが専門家になり、誤りを返さなくなると思われがちです。しかし、追加学習の目的は、特定用途に合うようモデルの反応を調整することであり、すべての回答を事実にすることではありません。望ましい形式や分類傾向を学習しても、未知の質問に対する正解が自動的に保証されるわけではないのです。
Google for Developersの用語集では、モデルの出力が現実に基づく性質を「事実性」と説明しています。同時に、事実性は一つの評価数値ではなく概念であり、創作を求める依頼では正確な事実より創造性を優先する場合もあると示されています(出典: Google for Developers)。求める品質は用途によって異なるため、「良い回答」の条件を先に決める必要があります。
架空の例として、商品の問い合わせ分類に使うモデルを追加学習したとします。分類名を正しく返す割合が改善される可能性はありますが、入力された商品情報そのものが正しいか、顧客の説明に不足がないか、現在の返品条件がどうなっているかまでは、分類の学習だけで保証できません。追加学習の対象と、判断に必要な事実の確認を分けて扱う必要があります。
評価用の例も、学習用の例と同じものだけでは不十分です。既に見た問題への反応が良くても、表現が違う入力や想定外の相談で同じ品質になるとは限りません。Google for Developersの用語集では、機械学習モデルの評価では検証用やテスト用のデータを使い、生成AIでは品質と安全性をより広く見ると説明されています(出典: Google for Developers)。
正確さが求められる用途では、人が出力を確認する範囲、参照資料の更新方法、誤りを見つけた際の扱いも必要です。「追加学習済み」という表示だけを信頼の根拠にせず、何を学習させ、どの条件で評価したのかを見るほうが実用的でしょう。ファインチューニングは誤りを消す魔法ではなく、目的に沿った出力傾向を作り、その結果を評価し続けるための選択肢です。
明日から変えられるAIへの質問の見方
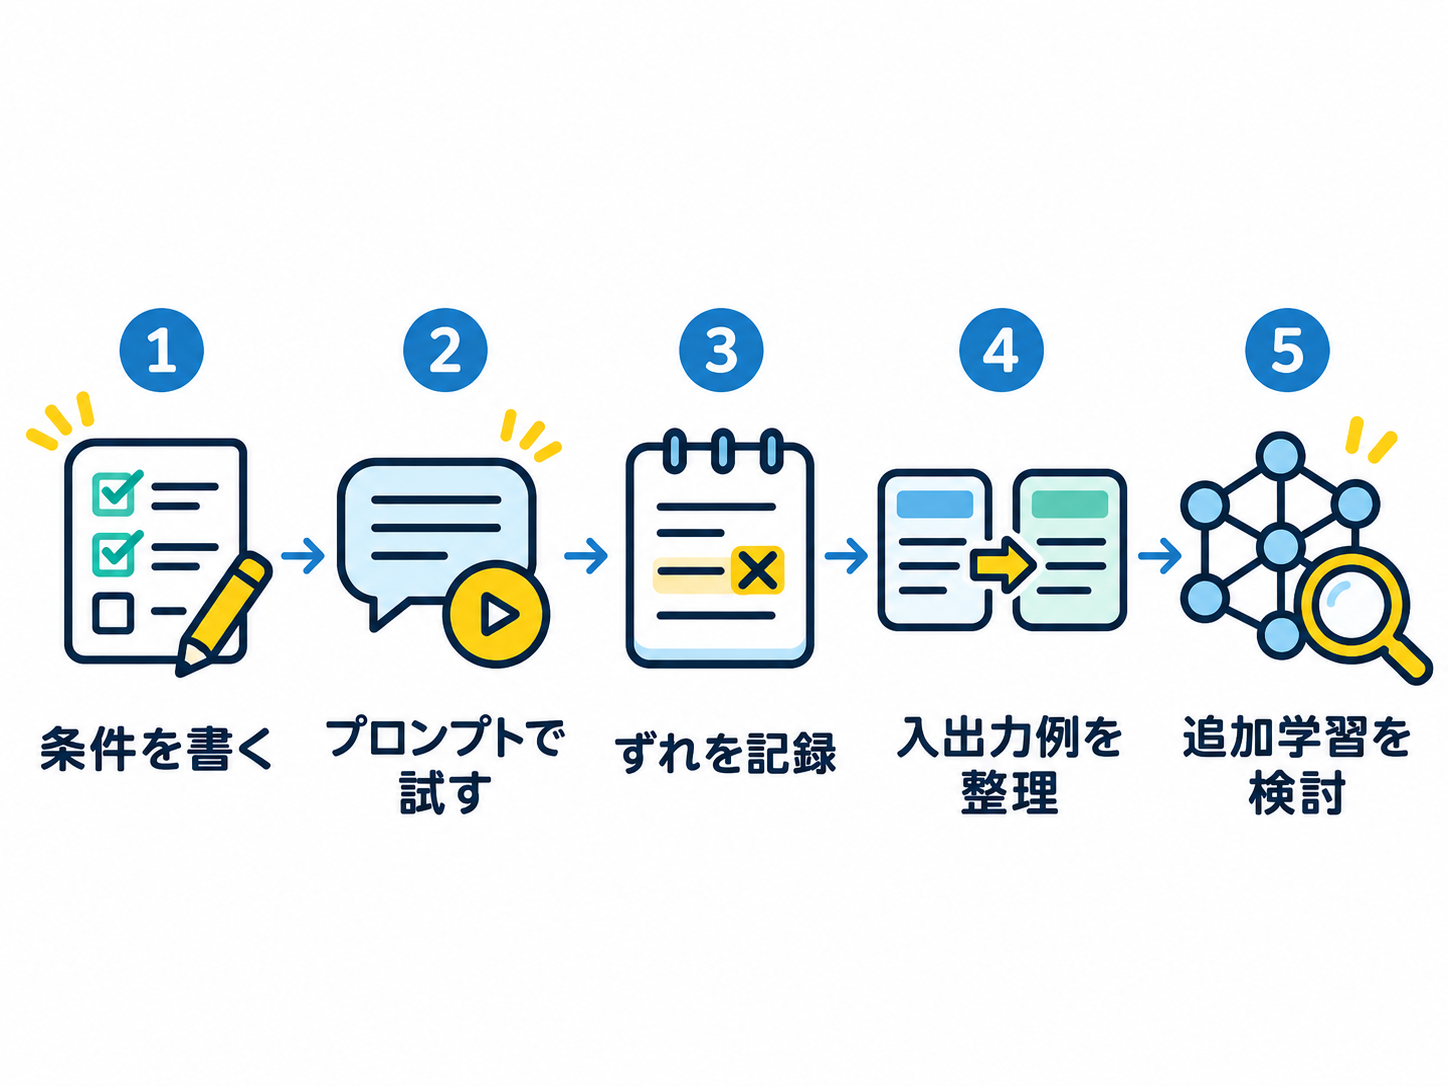
生成AIの回答が期待と違ったとき、すぐに「AIの学習が足りない」と考える必要はありません。最初に、依頼の目的、対象読者、出力形式、避けてほしい内容をプロンプトで伝えます。それでも同種のずれが繰り返されるなら、どの入力で、どの出力が望ましかったのかを記録してみてください。この記録は、単なる不満を、比較できる具体例へ変える作業になります。
たとえば、架空の広報文を依頼して、毎回説明が専門的になりすぎるとします。「初心者向けにしてください」だけでなく、知らない言葉に短い説明を添えること、略語だけで説明しないこと、読者が取れる次の行動を書くことを指定できます。そこで望む文章が得られるなら、課題はプロンプトで扱える範囲だったと考えられます。
同じ条件を何度指定しても、対象となる文章の種類が広がると結果が安定せず、しかも望ましい例を複数示せる場合には、ファインチューニングの考え方が候補になります。ただし、実際に行うには、利用するモデルが対応しているか、どのようなデータ形式や提供条件があるかを、そのサービスの公式資料で個別に確認しなければなりません。本記事の基礎説明だけから、特定製品の操作手順や利用可否を判断することはできません。
相談相手や提供会社へ確認するときは、「ファインチューニングできますか」とだけ尋ねるより、目的を具体化すると話が進みやすくなります。「この種類の入力を、三つの区分に分けたい」「望ましい入力例と出力例を用意できる」「結果は担当者が確認する」と説明すれば、追加学習が必要なのか、別の方法が適しているのかを比較しやすくなるでしょう。
明日からの一歩は、モデルを調整することではなく、生成AIに繰り返し頼んでいる条件を一つ書き出すことです。その条件が一時的な指示なのか、仕事全体で固定したい基準なのかを分けてみてください。前者ならプロンプトの改善、後者なら望ましい入出力例の整理が出発点になります。この見分け方を持つだけでも、「ファインチューニング」という言葉を必要以上に難しく捉えずに済みます。