

2026/11/13
AIニュース
GoogleのTPU Sync、生成AIの待ち時間を左右するKVキャッシュ転送を高速化
この記事の要点
Google Cloudが、Cloud TPU上のKVキャッシュやモデルの重みを移動するオープンソースライブラリ「TPU Sync」を公開しました。社内試験ではKV転送遅延を90%超削減したと報告しています。計算と転送の並行処理や推論エンジンとの連携が特徴ですが、一般利用はまだ推奨されていません。企業には、負荷条件と遅延の内訳を踏まえた検証が必要です。
目次
計算が速くても、データの移動で応答は遅れます
大規模な生成AIモデルに長い資料を渡すと、回答が始まるまで待たされることがあります。その待ち時間を縮めるには、計算性能を高めるだけでは足りません。入力を処理する過程で生まれたデータを、次の処理を担う装置へどれだけ速く届けられるかも、サービスの応答性を左右します。Google Cloudが公開したオープンソースライブラリ「TPU Sync」は、このデータ移動に焦点を当てています。
対象となるのは、GoogleのAI処理向け半導体であるCloud TPU上のKVキャッシュやモデルの重みです。KVキャッシュは、言語モデルが処理済みの文脈に関する計算結果を保持し、後続の生成で再利用する仕組みです。モデルの重みは、学習によって調整されたパラメーターを指します。どちらも処理を進めるために必要ですが、保存場所や実行先が変われば移動が発生します。
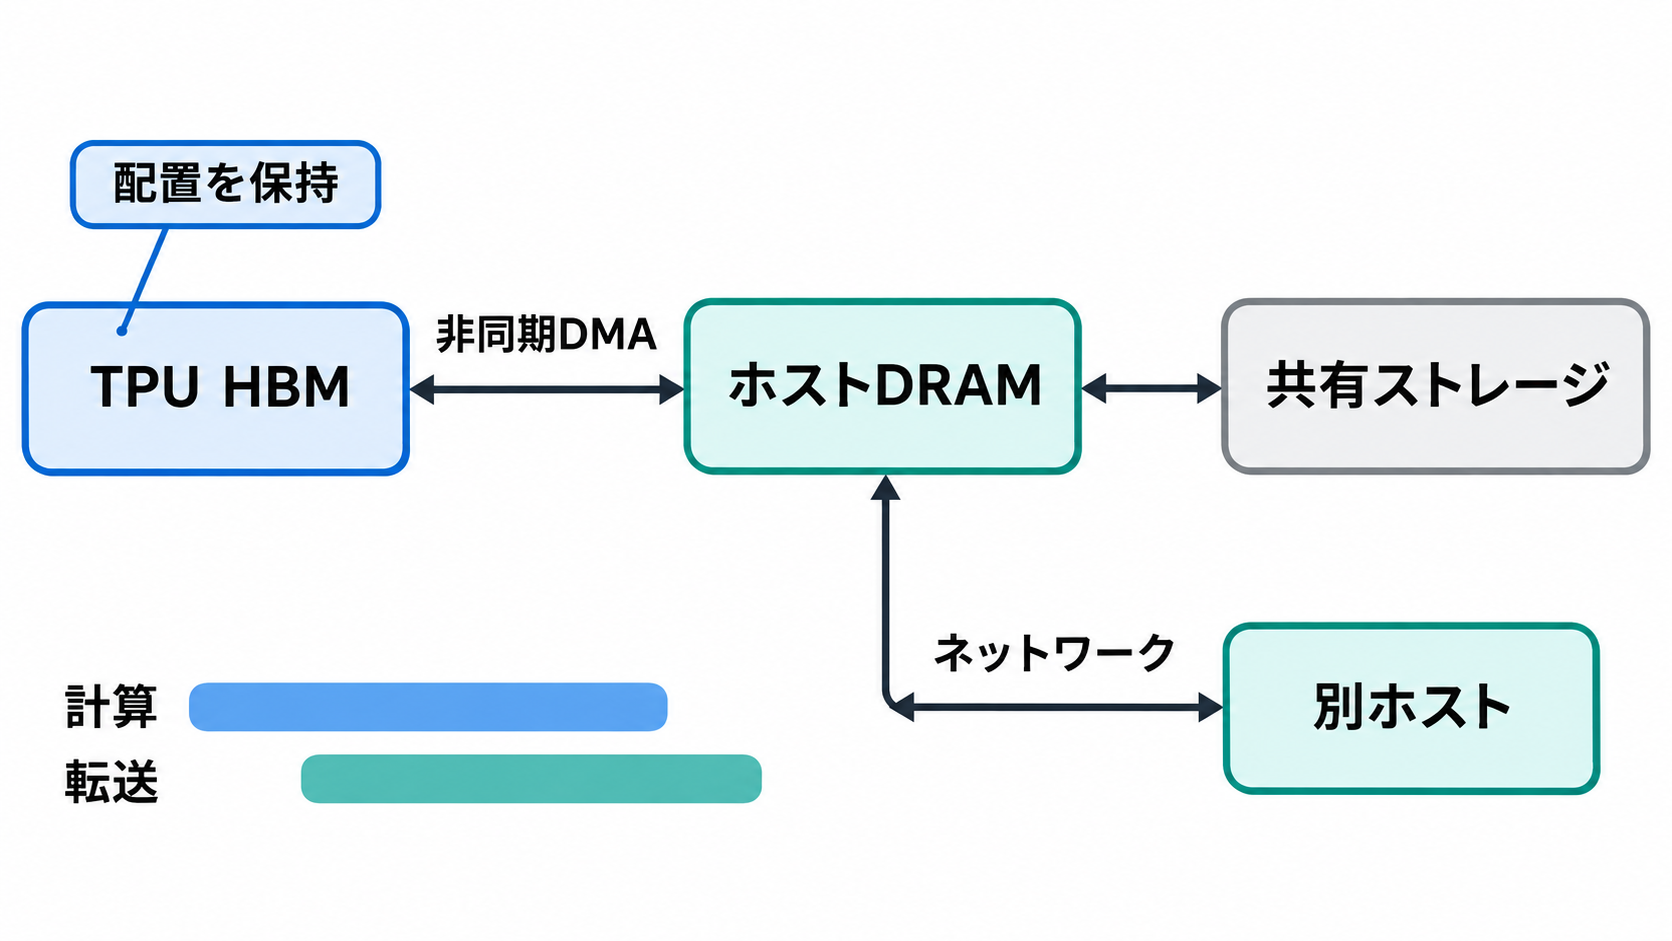
TPU SyncはC++を中核に実装され、TPUの高速メモリー、ホスト側のメモリー、共有ストレージ、データセンター内のネットワークを、一続きのメモリー階層として扱います。Googleは、パラメーター数が2,350億から4,800億のMoEモデルを使った社内試験で、KVキャッシュの転送遅延を90%超削減したと報告しています。MoEは、複数の専門家ネットワークの一部を入力に応じて使うモデル構成です。
企業が注目したいのは、この数字そのものより、改善の対象です。モデルを実行する計算資源に余力があっても、必要な状態の到着を待っていれば、その性能を十分には使えません。TPU Syncは、生成AI基盤の性能を「計算の速さ」に加えて「状態を運ぶ速さ」から見直す取り組みと捉えられます。ただし、公開されている性能値はGoogleによる初期段階の測定であり、自社環境で同じ改善幅が得られるとは限りません。
メモリー階層をまたぐ転送をC++で処理
TPUのHBMは、計算装置の近くにある高帯域メモリーです。高速にアクセスできる反面、保存できる容量には限りがあります。モデルの重みが多くの領域を使えば、KVキャッシュに割ける余地は小さくなります。そこで、ホスト側のDRAMやストレージも保存先として利用し、必要なデータを適切なタイミングでHBMへ戻す設計が意味を持ちます。ただし、保存先を増やすだけでは、転送の待ち時間まで解消できません。
TPU Syncは、TPU向けに配置されたテンソルの形式を保ったまま、DMAによって非同期にデータを移動します。DMAは、専用の転送機構を使ってメモリー間でデータをやり取りする方式です。JAXのPJRTバッファーやPyTorchのテンソルを直接扱い、Pythonでのシリアライズや中継用バッファーを避けます。転送の前後に必要な変換やコピーを減らすことが、設計上の狙いです。
計算と転送を重ねて進めることも特徴です。大きなコピー処理が計算カーネルの起動を遅らせないよう、DMAの実行ペースを調整する仕組みを備えています。また、転送やデータ分割の再配置は、機械学習向けコンパイラーXLAの計算グラフの外側で、ネイティブC++によって処理します。データ移動の経路でXLAのコンパイルを必要としない構成になっています。
Googleは、Ironwoodと呼ばれるTPU v7xのホスト当たりで最大223 GB/sの転送帯域を報告しています。比較対象として示すPCIe Gen5の上限は256 GB/sです。データセンターネットワークでは、NIC一つで約192 Gbps、二つで約350 Gbpsとしています。前者はホストとTPUの間、後者はネットワーク上の転送であり、単位も異なります。調達や構成検討では、一つの最大値にまとめず、どの経路が詰まっているかを分けて確認する必要があります。
入力処理と文章生成を分ける構成で生きる仕組み
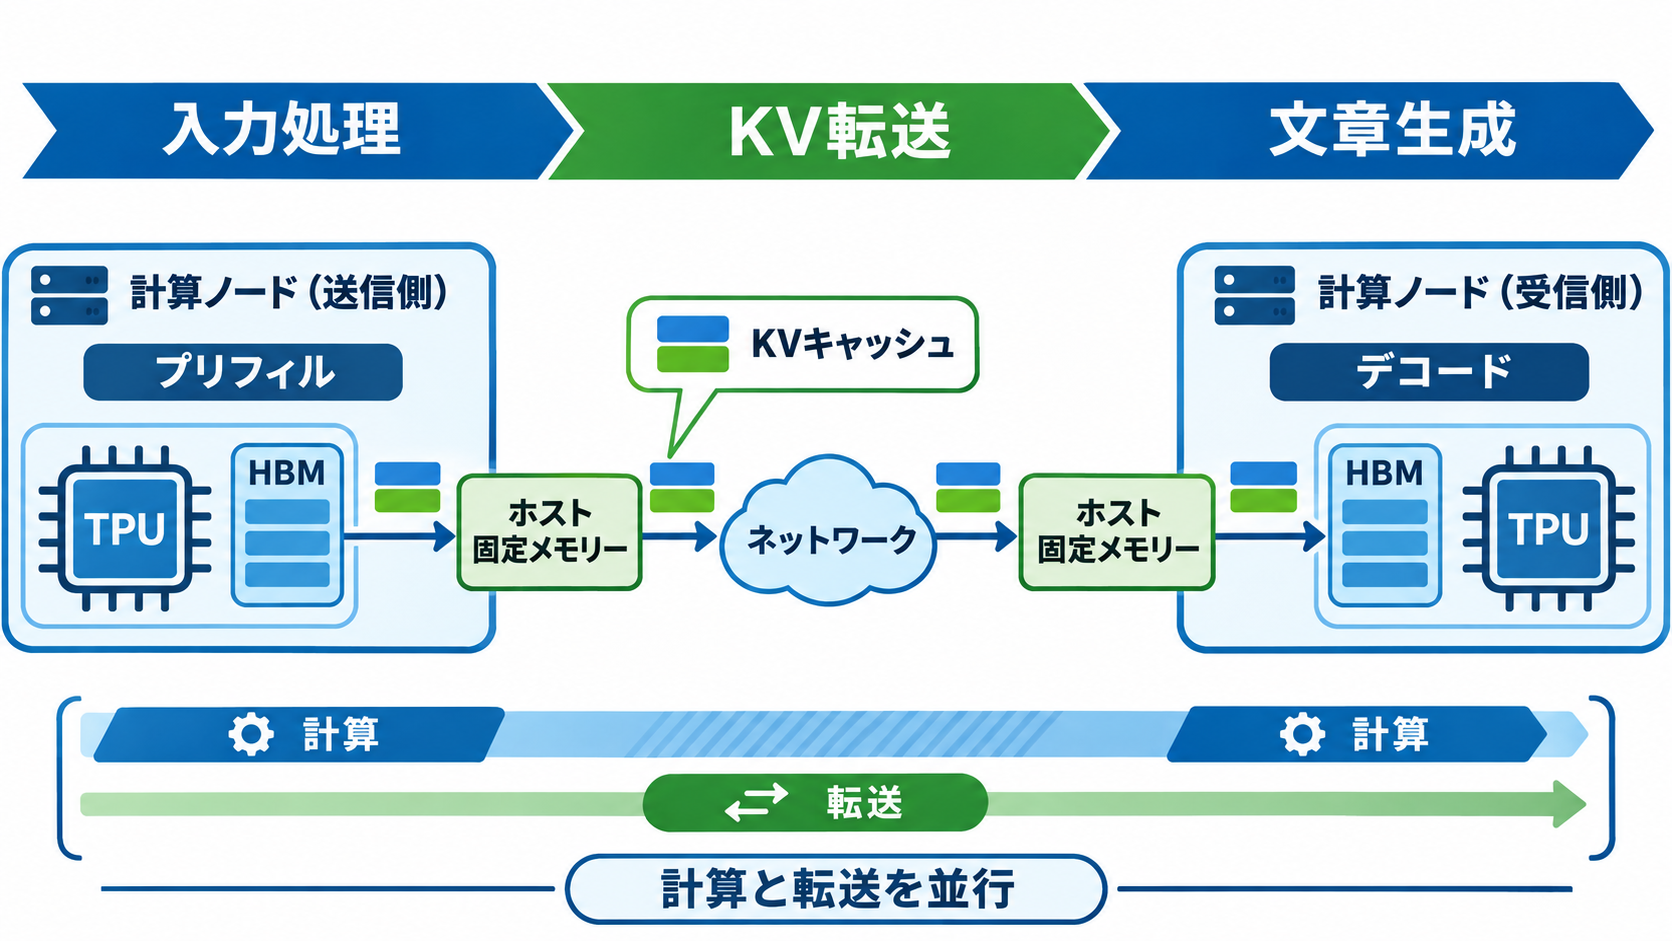
言語モデルの推論は、大きく二つの段階に分けて考えられます。入力された文章をまとめて処理する「プリフィル」と、その結果を使いながら出力トークンを順に生成する「デコード」です。トークンは、モデルが文章を扱う際の処理単位を指します。両段階は計算の性質が異なるため、別々のノードに担当させるP/D分離構成が使われます。P/Dは、それぞれプリフィルとデコードの頭文字です。
役割を分けると、入力処理側で作ったKVキャッシュを、文章生成側へ渡す必要があります。この引き継ぎが遅ければ、プリフィルを終えても回答の表示を始められません。利用者が感じる初動の速さを示す指標が、最初のトークンが出るまでの時間であるTTFTです。P/D分離の効果を判断するには、各段階の計算時間に加え、この引き継ぎ時間を含めて測る必要があります。
TPU Syncを使う構成では、プリフィル側がKVキャッシュのブロックを、非同期DMAでホストの固定メモリーへ退避します。固定メモリーは、DMAで扱えるよう領域を固定したホストメモリーです。転送コントローラーが割り当て先のデコードノードへデータを送り、到着したブロックをデコード側のHBMへ移します。デコード側では、生成処理を進めながら転送を処理する設計です。
この仕組みは、分離構成なら必ず応答が速くなるという意味ではありません。入力の長さ、同時に処理する要求数、ネットワークの余力によって、計算を分ける利点と状態を運ぶ負担の関係は変わります。企業向けサービスで検討するなら、長い資料を読む要求と短い対話を同じ平均値にまとめず、それぞれでTTFTと出力速度を見ると判断しやすいでしょう。TPU Syncの価値は、分離構成に伴う転送負担をどれだけ抑えられるかにあります。
最大90%の改善は、対象と測定条件を分けて読む必要があります
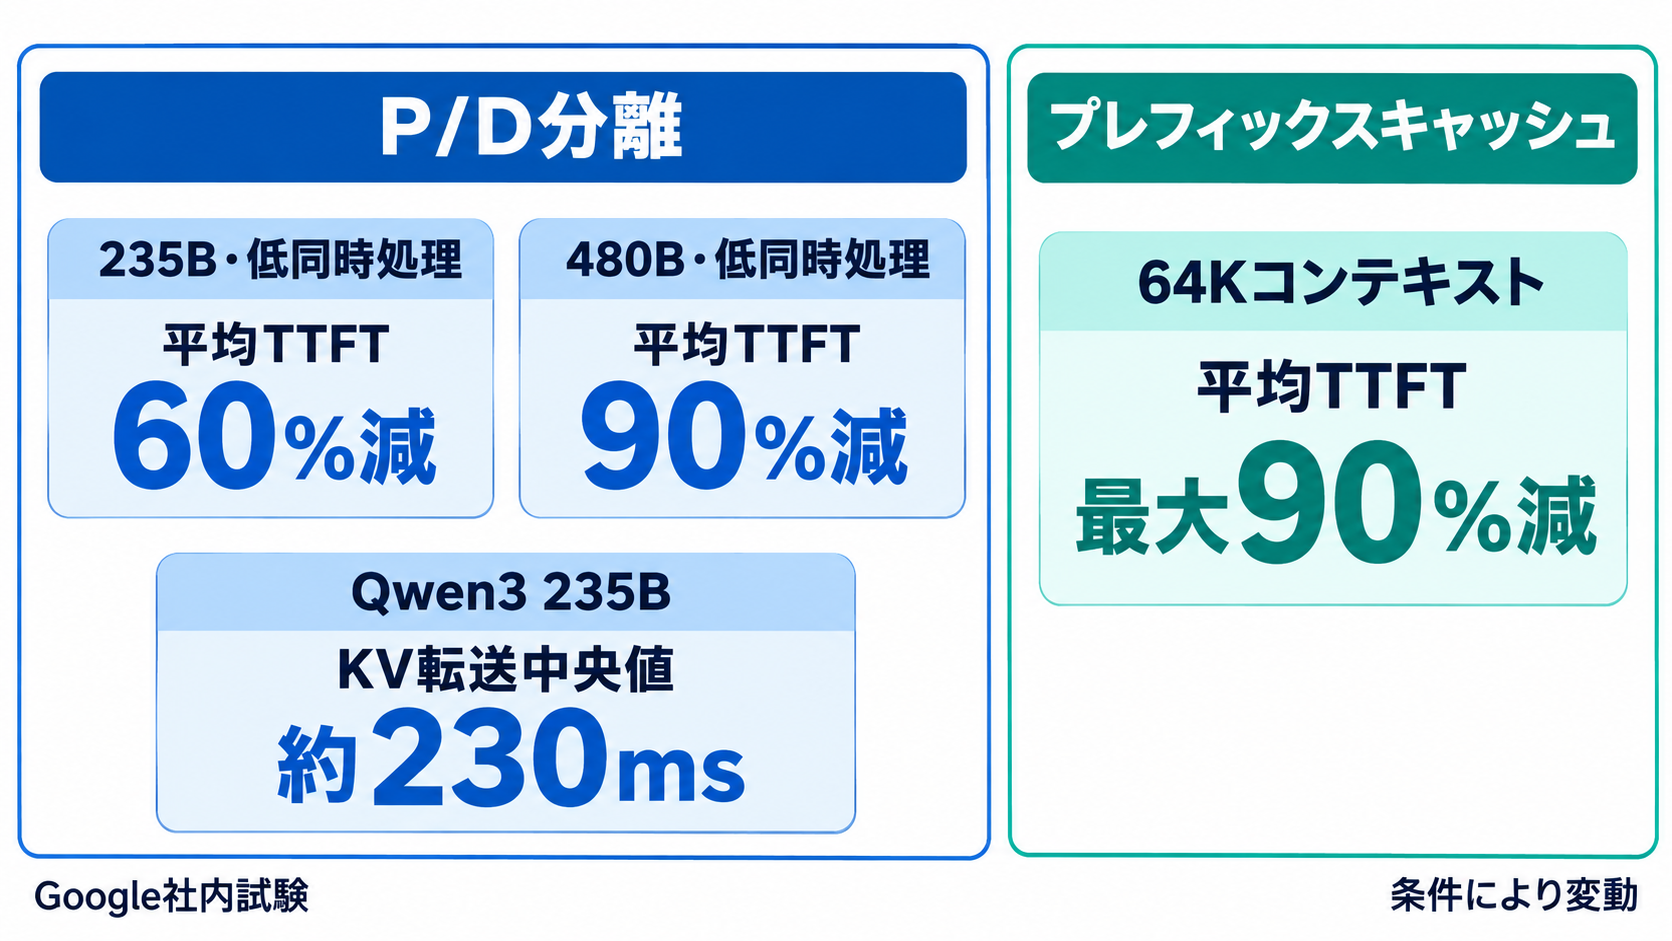
Googleの社内試験は2026年7月に実施され、TPU v7xの2×2×1構成、PCIe Gen5、200 GbpsのNICを使用しています。ソフトウェア構成はtpu-inference v0.24.0、JAX 0.10.2、libtpu 0.0.42.1です。測定環境が具体的に示されているため、導入側は自社との違いを確認できます。ただし、Google自身も、実環境での結果は変わると説明しています。
P/D分離構成では、KV転送のオーバーヘッドが90%超減少したと報告されています。Qwen3 235Bでは、KV転送遅延の中央値が数秒から約230ミリ秒へ短縮しました。同時処理数が少ない条件での平均TTFTは、2,350億パラメーターのモデルで60%、4,800億パラメーターのモデルで90%減少しています。また、2,350億パラメーターのモデルでは、アクセス急増時の出力トークンのスループットが30〜70%向上したとしています。
別の試験は、入力の共通部分を再利用するプレフィックスキャッシュを対象としています。MoEモデルの重みがHBMの大部分を占める条件で、有効なキャッシュ容量が約1桁増えたと報告されています。64Kコンテキストの負荷では平均TTFTが最大90%減少し、スループットは50%超向上しました。トークン間の待ち時間を示す指標では、遅い側の裾を見るP99の値が30%低下しています。
これらの数字は、異なる条件と指標を測った結果です。約230ミリ秒はKV転送遅延の中央値であり、利用者への回答開始時間そのものではありません。低い同時処理数でのTTFT改善を、高負荷時にもそのまま当てはめることもできません。導入評価では、平均TTFTだけでなく、混雑時の処理量や遅い要求の待ち時間も確認したいところです。公表値を効果の保証として使うより、再現を試みる仮説として扱うほうが、投資判断につながります。
既存エンジンとの接続と、GPU向け製品との比較軸
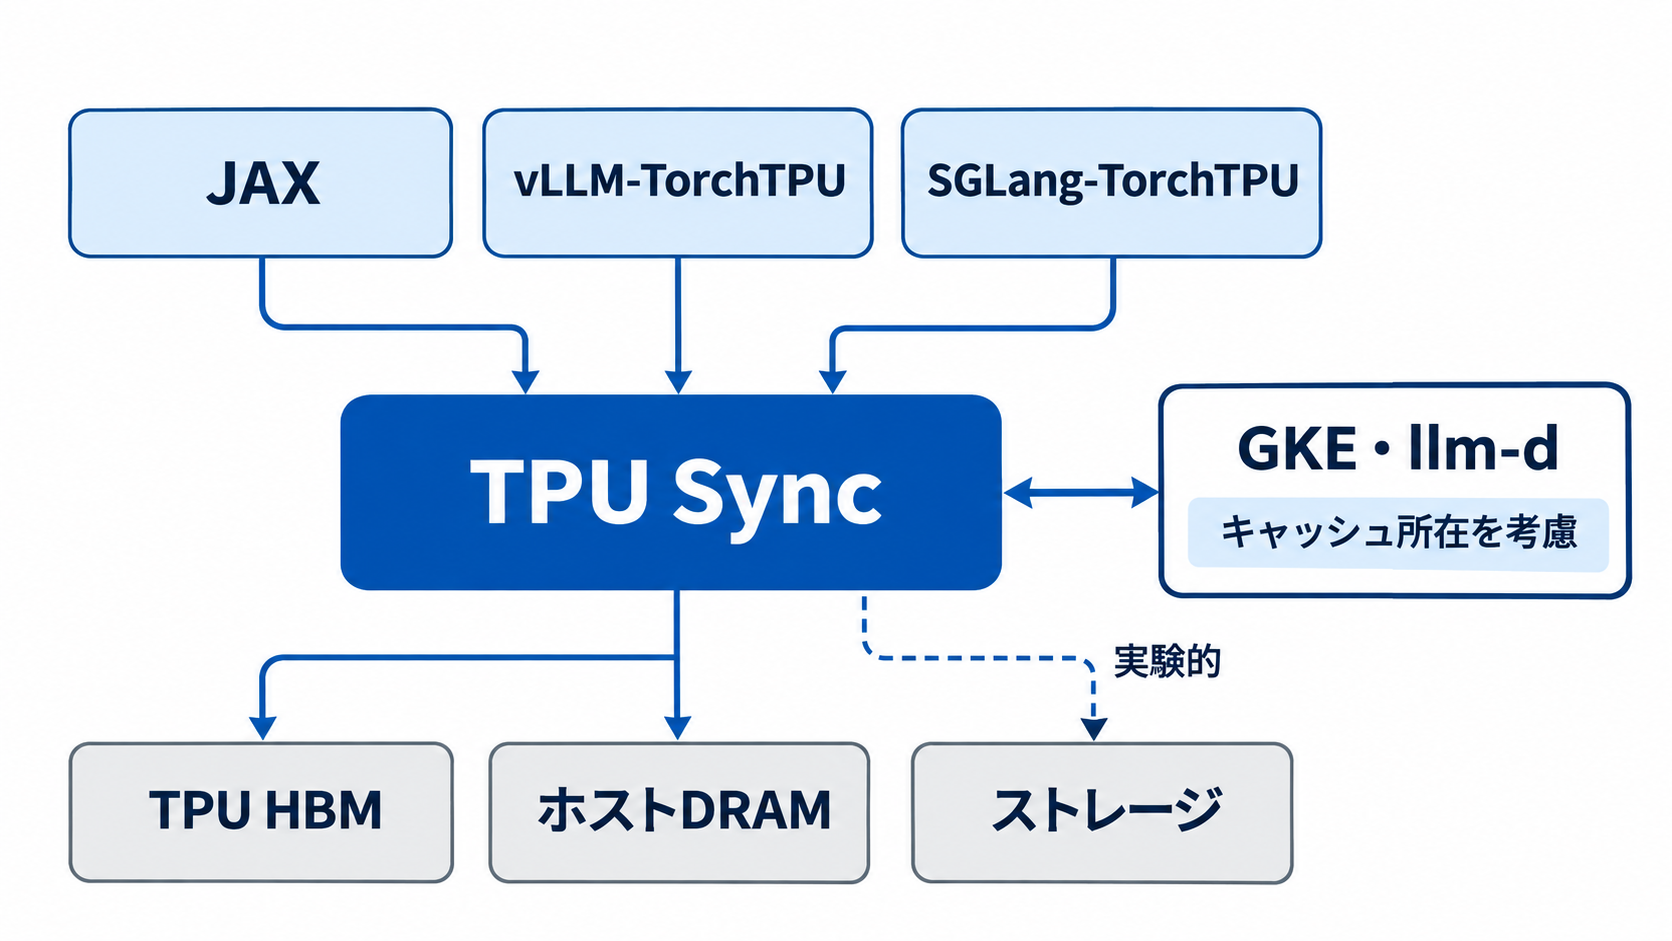
TPU Syncは、JAXにネイティブに対応し、PyTorchからはTorchTPUを通じて利用する構成です。C++の中核に加えてPython向けのwheelパッケージが用意されています。READMEに記載された対応ハードウェアはCloud TPU v7xとv6eで、ライセンスはApache-2.0です。導入を考える企業にとっては、転送ライブラリ単体の仕様だけでなく、既存の推論エンジンとどの接続点で組み合わせるかが実装範囲を左右します。
vLLM-TorchTPUでは、vLLMのKVConnectorインターフェースを通じてKVキャッシュ転送を担います。SGLang-TorchTPUでは、P/D転送と階層型キャッシュの入出力に利用されます。Google Kubernetes Engine、通称GKE上のllm-d 1.0では、プレフィックスキャッシュの所在を考慮するルーティングと、Managed Lustreへの実験的な退避に使われます。各連携は、利用中のエンジンに応じて確認する必要があります。
Googleは、vLLMとSGLangの統合をInferact、RadixArkと共同開発したと説明しています。また、MetaとWayfairがアーキテクチャを評価中としています。ただし、評価中という情報から、本番での採用や性能効果まで判断することはできません。企業名の存在より、自社のエンジン、バージョン、運用構成で必要な機能が利用できるかを確かめるほうが、実務上は有用です。
GPU向けにも、NVIDIA DynamoのKVBMとNIXL、LMCache、Mooncakeなど、モデル状態の保存や転送を扱う仕組みがあります。比較する際は、対応する半導体、保存先の階層、通信経路、推論エンジンとの接続をそろえて見る必要があります。たとえば、TPU Syncの最大223 GB/sはホスト側PCIeのDMA転送値ですが、Mooncakeの最大190 GB/sは8本の400 Gbps RoCEを使うネットワーク転送値です。この二つを直接並べても製品の優劣は決まりません。自社で必要な転送経路に合うかどうかが比較の出発点になります。
導入判断は、遅延の内訳を測るところから
TPU Syncを検討する際に見落とせないのは、READMEが現段階で一般利用を推奨していない点です。ストレージ向けのPOSIXバックエンドや強化学習向けの重み転送にも、実験的な位置づけが含まれています。公開された性能結果は、完成度や適用範囲まで保証するものではありません。検証環境で機能と効果を確認し、自社サービスに必要な安定性を別途評価する段階と考えるのが妥当です。
ストレージ連携では、ローカルSSDやGoogle Cloud Managed Lustreが挙げられています。Managed Lustreは共有ストレージの選択肢として扱われますが、HBMから保存領域を広げれば、容量と引き換えに異なるアクセス時間や運用条件を受け入れることになります。再利用する見込みが高いKVキャッシュを保持するのか、再計算したほうが扱いやすいのかは、入力の共通性や要求の頻度によって変わるでしょう。
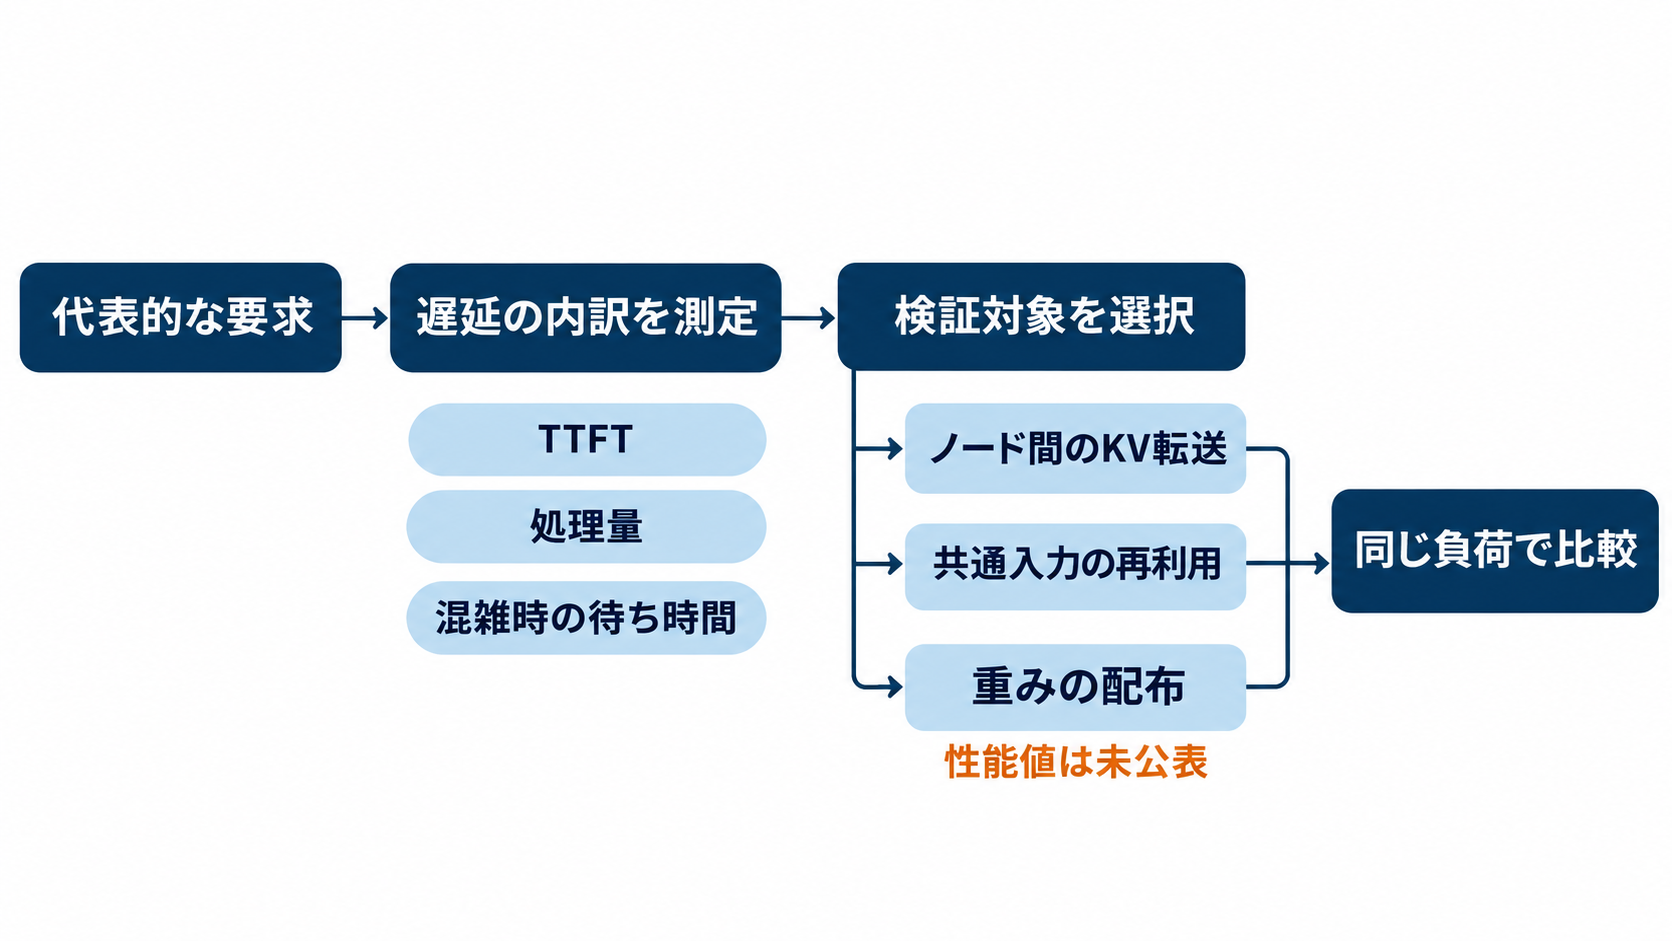
強化学習では、学習を行うトレーナーから、生成を担うサンプラーへモデルの重みを配る用途も想定されています。ただし、この用途の性能数値は公表されていません。推論時のKVキャッシュ転送で得られた改善幅を、そのまま重み配布の高速化に読み替えることはできません。検証する場合は、重みの転送量、更新の頻度、生成側が待つ時間を独立した項目として測る必要があります。
日本企業が最初に取り組めるのは、自社の代表的な要求を使い、回答開始までの時間を入力処理、KV転送、待機などに分けて把握することです。共通する長い入力が多ければプレフィックスキャッシュを、入力処理と生成を分離していればノード間転送を、検証の対象に選べます。改善したい指標と負荷条件を決めてからTPU Syncの有無を比較すれば、公開された最大値を追うだけでは見えない効果を判断できます。導入の第一歩は、現在のサービスで何を待っているのかを測ることです。