
2026/11/08
AIニュース
MoEの推論コストを左右する「振り分け」設計――7つのルーティング方式と企業の選定基準
この記事の要点
MoEモデルの運用コストは、総パラメータ数だけでなく、トークンの振り分け方やGPU間通信にも左右されます。Top-k、共有エキスパート、バイアスによる負荷調整など7つの方式を整理し、企業が設定確認と日本語業務の検証で確かめるべき点を説明します。
目次
総パラメータ数だけでは見えないMoEの運用コスト
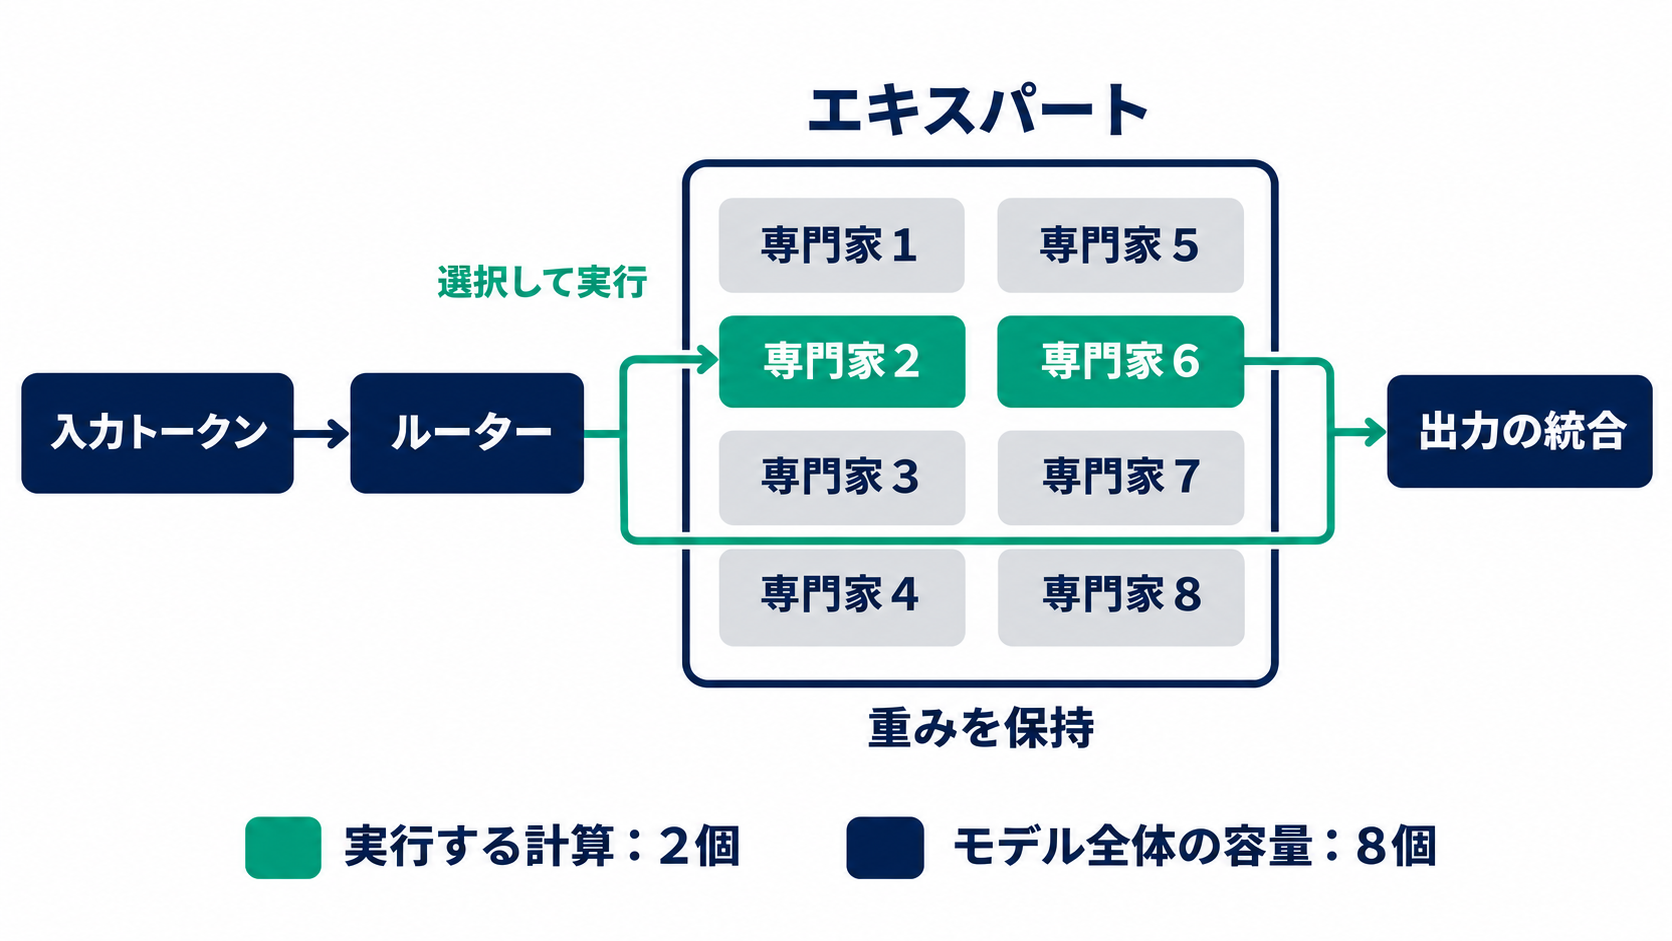
大規模言語モデルを自社環境で動かすとき、「パラメータ数が大きいほど、毎回の計算も重くなる」と考えると、MoEモデルの特徴を見落とします。MoEはMixture-of-Expertsの略で、複数のエキスパートと呼ばれる計算ネットワークを持ち、入力に応じて一部だけを動かす構造です。モデル全体の規模と、入力を処理する際に実際に使う規模を分けて考える必要があります。
この使い分けを担当するのがルーターです。文章を処理単位であるトークンに分け、それぞれをどのエキスパートへ送るか決めます。ここでいうエキスパートは、社内の専門家データベースや外部サービスではありません。モデル内部にある学習可能なネットワークであり、名前だけから法律担当、経理担当といった明確な役割分担を想定するのは適切ではないでしょう。
たとえばMixtral 8x7Bは、全体では約470億のパラメータを持ちながら、トークンごとに使うパラメータは約130億です。複数の候補から一部を選ぶことで、モデルが持つ容量を増やしつつ、実行する計算を抑えます。ただし、動かさない部分の重みも保持する必要があるため、計算量が減る割合と必要メモリが減る割合は一致しません。
企業の導入判断では、この構造に通信の問題が加わります。エキスパートを複数のGPUに分散すると、振り分け先の選択がデータ転送を発生させます。計算を担当するGPUが空いていても、転送待ちや特定のエキスパートへの集中があれば、応答は遅くなりかねません。
MoEを評価する際の中心課題は、少ない計算で高い品質を得られるかに加え、その計算を実際の設備で滞りなく実行できるかです。以下の7方式も、単純な性能ランキングとして読むより、選択方法、負荷の均等化、通信範囲という異なる設計上の工夫として捉えると、運用との関係を理解しやすくなります。
Top-kとTop-1――選ぶ数と受け入れ容量の設計
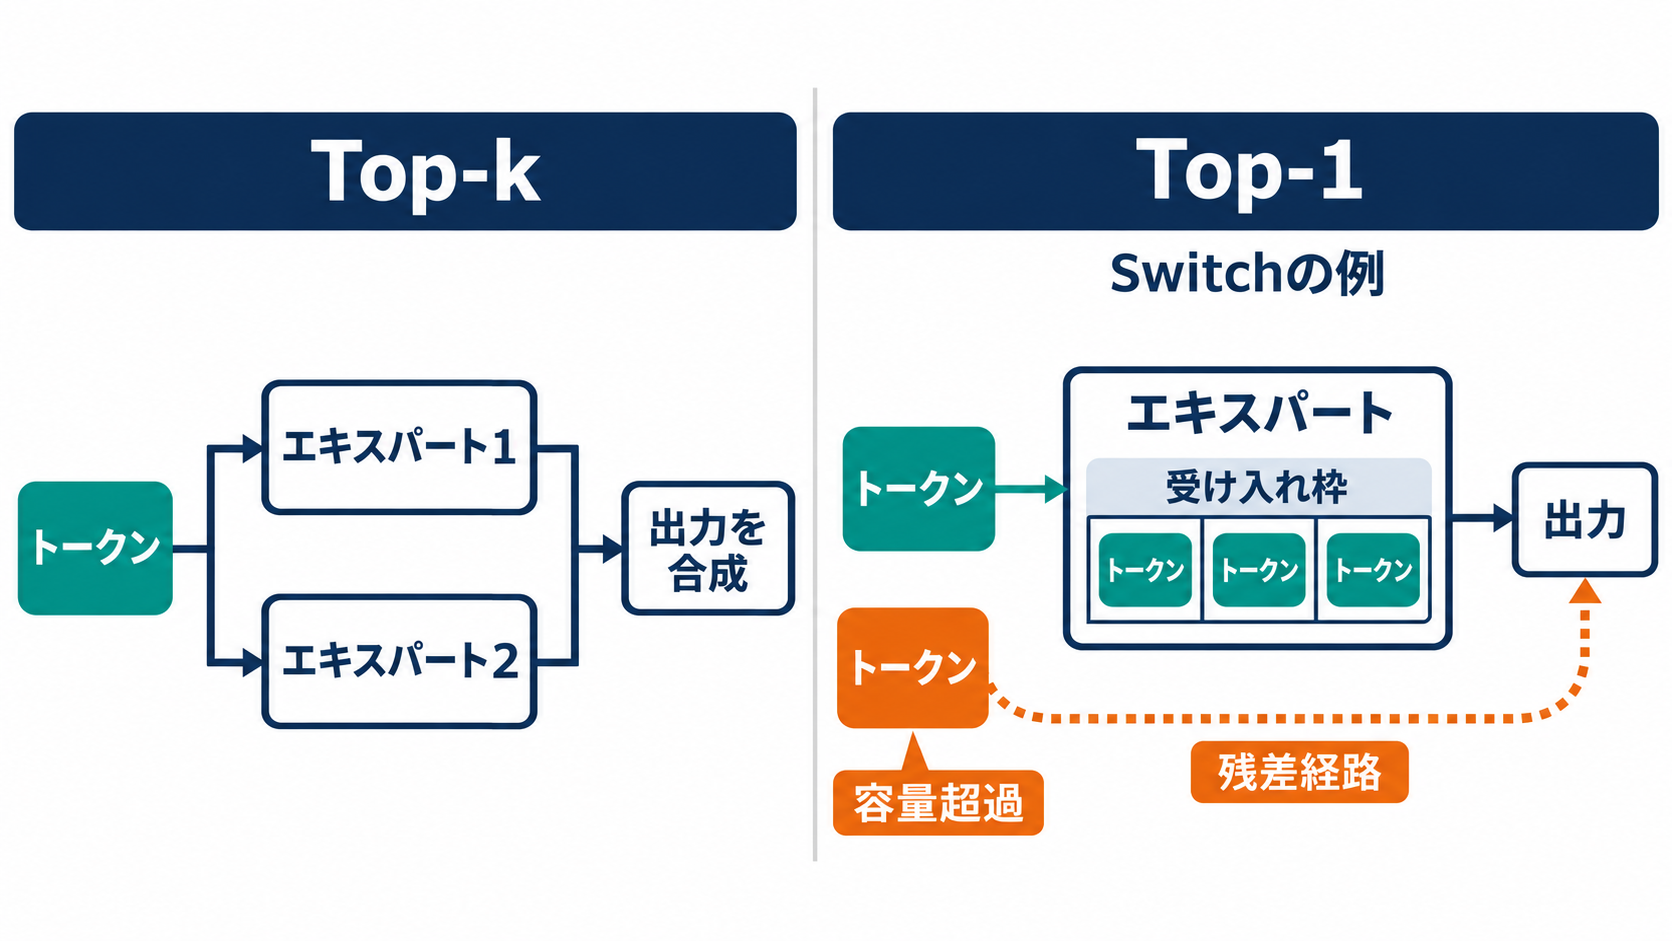
基本となる方式は、トークン側がエキスパートを選ぶ「Softmax Top-k」です。ルーターが候補を採点し、スコアの高いk個を選びます。選択した出力をどの割合で混ぜるかもスコアから決めるため、単に処理先を一つ指定する仕組みとは異なります。Softmaxは、複数のスコアを合計が1になる重みへ変換する関数です。
Mixtralは8個から2個、gpt-oss-120bは128個から4個、Qwen3-235B-A22Bは128個から8個を選びます。これらの数字は、同じMoEでも一度に動かす範囲が異なることを示しています。ただし、エキスパート自体の大きさやモデル全体の構造も違うため、選択数だけで速度や品質の優劣は決まりません。
選択を繰り返すうちに特定のエキスパートへ仕事が集中すると、待ち時間が増え、ほかのエキスパートは十分に使われなくなります。一般的な対策は、学習時に負荷の偏りを抑える補助損失を加える方法です。文章予測を改善する目的に、処理を均等に配る目的を組み合わせるため、その強さには調整が必要になります。
2つ目の「Top-1 Switch」は、各トークンの振り分け先を1個に絞る方式です。Switch Transformerでは、各エキスパートが受け入れるトークン数に上限を設けます。基準となる平均トークン数に容量係数を掛けて受け皿を確保し、あふれたトークンは残差接続を通じて、そのエキスパートによる処理を迂回します。
この容量制御は、Top-1を使うすべてのモデルに共通する動作ではありません。Llama 4 Maverickは、選択するエキスパートが1個でも、常時動く共有エキスパートを併用します。仕様書を読む際は「1個を選択」という記述だけで判断せず、共有部分の有無と、容量超過時の挙動まで確認すると、実際の処理を把握しやすくなります。
共有エキスパートとバイアス調整――品質と負荷を分けて考える工夫
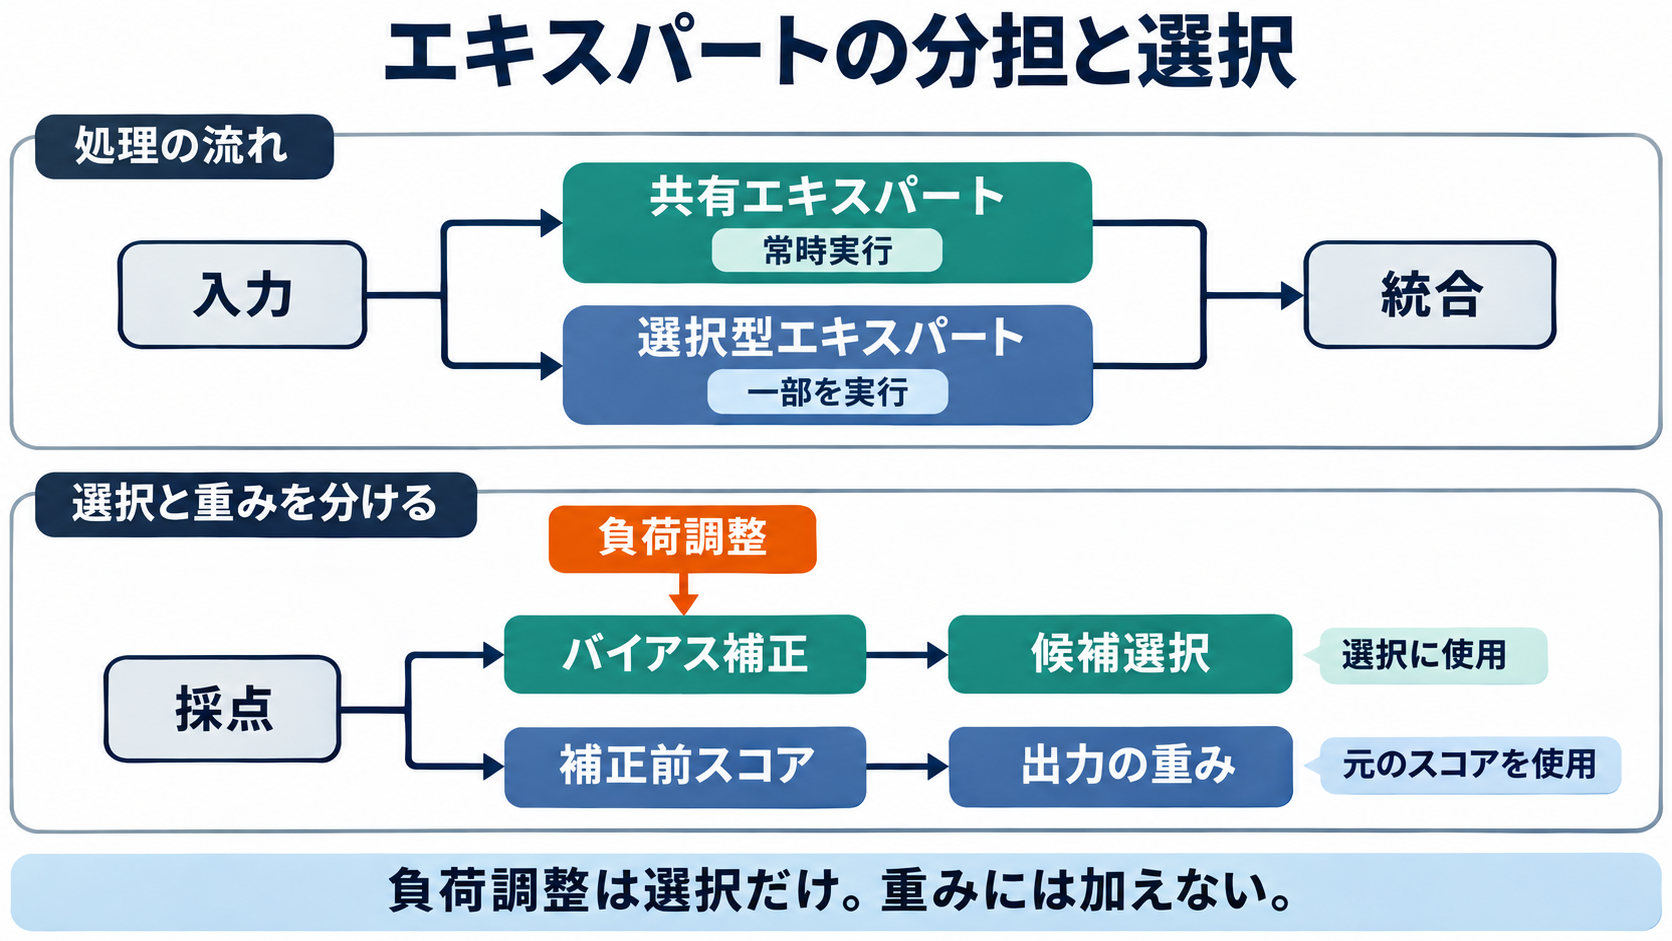
3つ目は「共有エキスパートと選択型エキスパートの併用」です。すべてのトークンに共通して働く部分と、ルーターが選んだ場合だけ働く部分を分けます。DeepSeekMoEは、共有側が共通知識を担うことで、選択型のエキスパートが専門化しやすくなる設計を採用しています。DeepSeek-V3では、共有1個と選択型256個を備え、選択型から8個を動かします。
共有部分があれば、毎回必ず発生する計算も増えます。そのため、選択型の個数だけを見てモデルの負荷を見積もると、実行する処理を過小評価しかねません。また、共有構造とルーティング方式は別の論点です。共有エキスパートを持つモデル同士でも、選択型の採点方法や負荷調整の仕組みは異なり得ます。
4つ目の「Sigmoidとバイアスによる負荷調整」は、エキスパートの選び方を工夫します。DeepSeek-V3は、採点にSigmoid関数を使い、上位候補を選ぶときにエキスパートごとの補正値であるバイアスを加えます。仕事が多すぎる候補は選ばれにくく、少なすぎる候補は選ばれやすくなるよう補正します。
ここでは、選択のための補正と、出力を混ぜるための重みを区別する点が肝心です。負荷をならすバイアスは選択に使い、出力の重みには補正前のスコアを使います。補助損失による勾配を増やさずに負荷を調整する考え方であり、Loss-Free Balancingの研究では、比較条件下で品質と負荷分散の改善が報告されています。
ただし、「補助損失なし」という名称から、関連する損失がモデル内に一切存在しないと解釈するのは早計です。DeepSeek-V3の技術報告では、系列単位で極端な偏りが生じることを防ぐため、小さな補助損失も併用しています。企業が仕様を比較する際は、方式名だけでなく、どの単位の負荷を何によって調整するかまで読み分ける必要があります。
ノード制限――選択先の精度だけでなく通信距離も管理
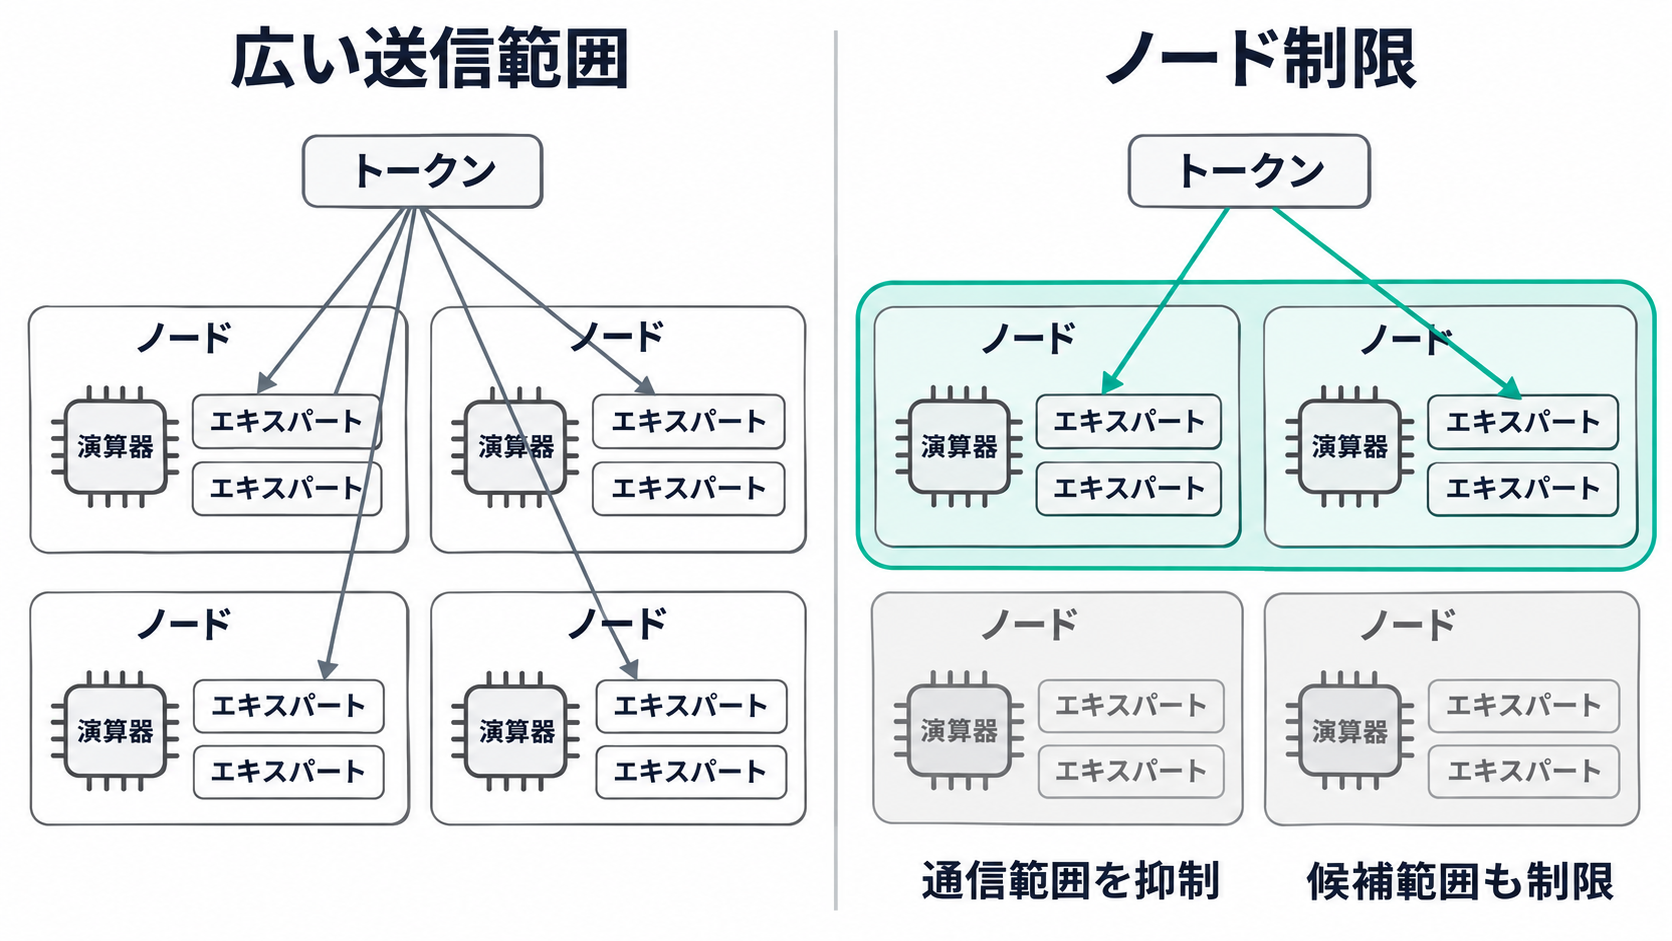
5つ目の「グループ制限・ノード制限」は、どのエキスパートが適しているかに加え、どこに配置されているかを考慮する方式です。ノードとは、ここではGPUなどを搭載した計算機を指します。複数の計算機へエキスパートを分散させる場合、トークンの送り先が広く散るほど、計算機間の通信が運用上の負担になります。
エキスパート並列と呼ばれる分散方式では、処理対象を各エキスパートへ配り、その結果を回収します。多くのGPUが相互にデータを交換するため、全体としてAll-to-All型の通信が生じます。GPU単体の演算性能だけを高めても、この転送が追いつかなければ、期待した応答速度には届きません。
DeepSeek-V3は、1トークンの送信先を最大4ノードに制限します。DeepSeekは、この制約によって学習中の計算と通信をほぼ重ね合わせられると説明しています。通信を完全になくすのではなく、転送が終わるのを待つ時間をほかの計算で覆うという発想です。先の技術報告で示された仕組みも、分散配置とルーティングを一体で設計する例と読めます。
ただし、送信先を制限すれば、選べるエキスパートの範囲も狭まります。適性の高い候補を自由に選ぶことと、通信を少なくすることの間には調整が必要です。こうした制限はTop-kなどに重ねて使うものであり、基本的な選択方式をすべて置き換えるわけではありません。
日本企業が自社設備で検証するなら、モデル名に加えてGPUの配置と接続条件を記録しておくと比較に役立ちます。単一ノードでの試験結果を、複数ノードへそのまま当てはめることはできません。学習時に負荷が均等でも、推論時の入力や同時実行数は変わるため、通信待ちや処理の偏りは実際の提供条件で確かめるべきでしょう。
Expert Choiceとハッシュ・動的Top-k――選択の前提を変える方式
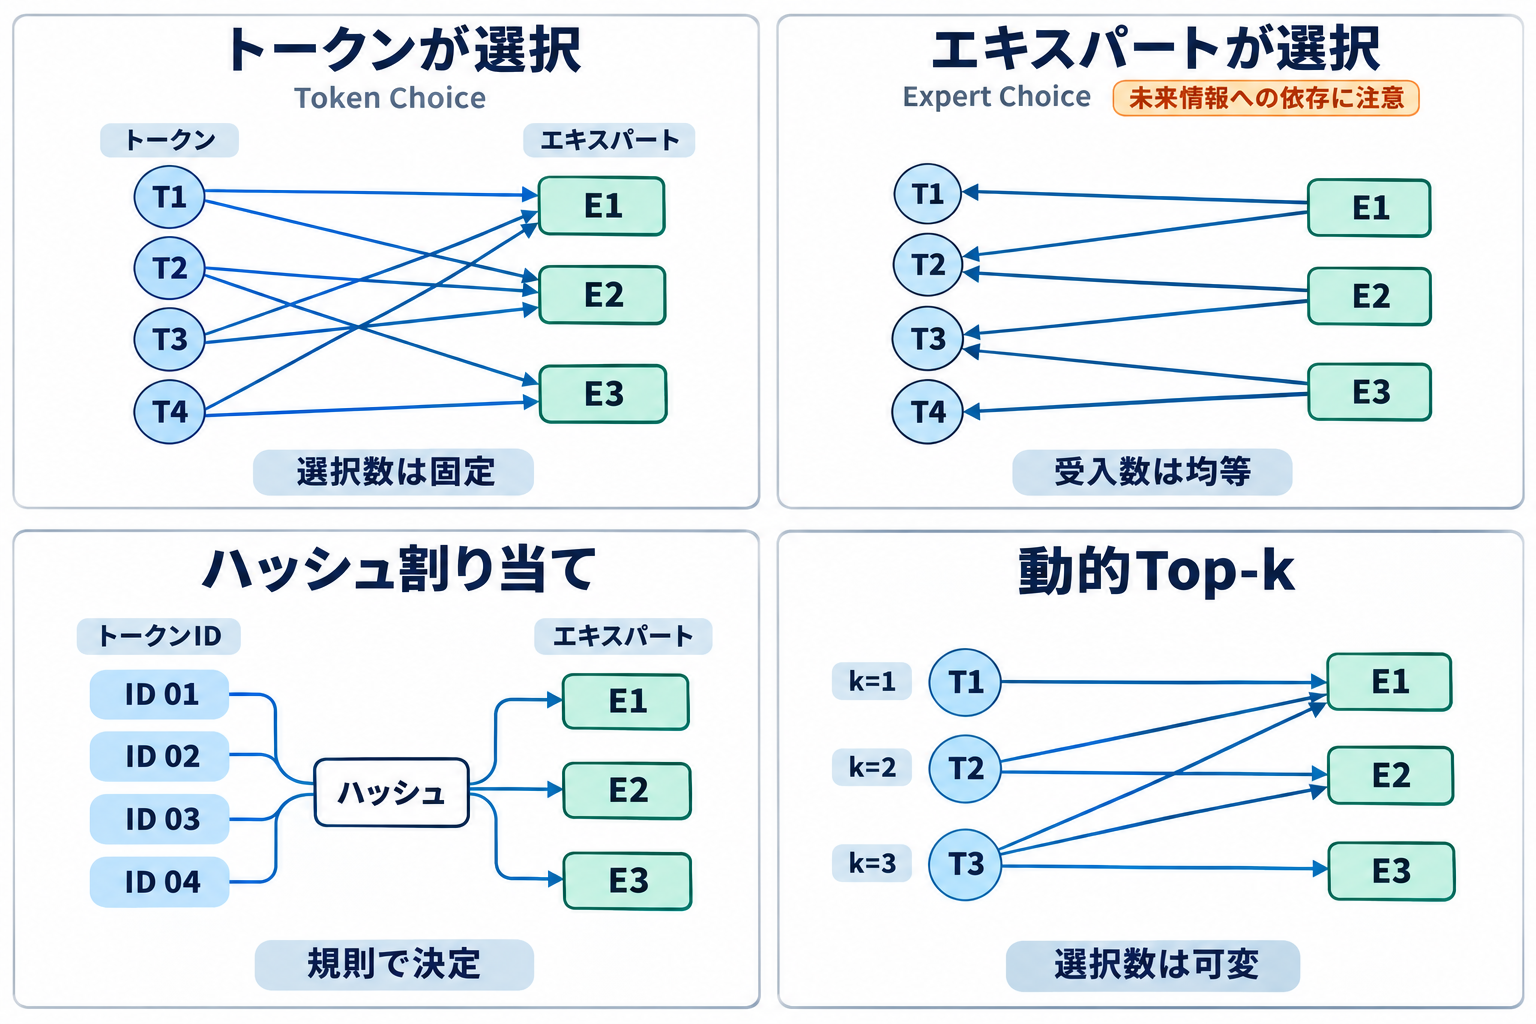
6つ目の「Expert Choice」は、選択する向きを逆転させます。各トークンが処理先を選ぶ代わりに、各エキスパートが担当したいトークンを選びます。エキスパートごとの受け入れ数を固定できるため、負荷をそろえやすくなる仕組みです。その代わり、トークンごとに担当するエキスパートの数は変動します。
Google Researchの説明では、比較対象に対して学習の収束が2倍以上速くなる結果を報告しています。ただし、これは学習が進む速さの評価です。利用者への文章生成が常に2倍速くなるという意味ではありません。学習効率と推論時の応答速度を分けて読む必要があります。
文章を左から順に生成するモデルでは、未来のトークンが選択に影響する問題にも注意が必要です。同じ受け入れ枠を複数のトークンで競うと、後続の入力次第で、前方のトークンが選ばれるかどうかも変わり得ます。負荷がきれいにそろうことと、生成時に使える情報だけで正しく処理できることは、別々に検証しなければなりません。
7つ目として紹介されているのが、「ハッシュルーティングと動的Top-k」です。ただし、この2つも同じ仕組みではありません。ハッシュ方式はトークンIDから処理先を割り当て、学習したルーターによる採点を使いません。動的Top-kは、トークンごとに動かすエキスパート数を変える考え方です。前者は割り当ての方法、後者は計算量の配分を変えます。
MarkTechPostは、DeepSeek-V4の最初の3つのMoE層へのハッシュ方式の採用や、推論基盤SGLangに動的Top-kを組み込んだSMIDTの結果を紹介しています。ここで企業が注目したいのは、新方式の名称そのものより、学習済みモデルのどの層・どの処理を変える技術なのかです。とくに動かす数を変更する場合は、速度の改善と回答品質を同じ条件で評価する必要があります。
企業の選定は設定確認と日本語業務の再現から
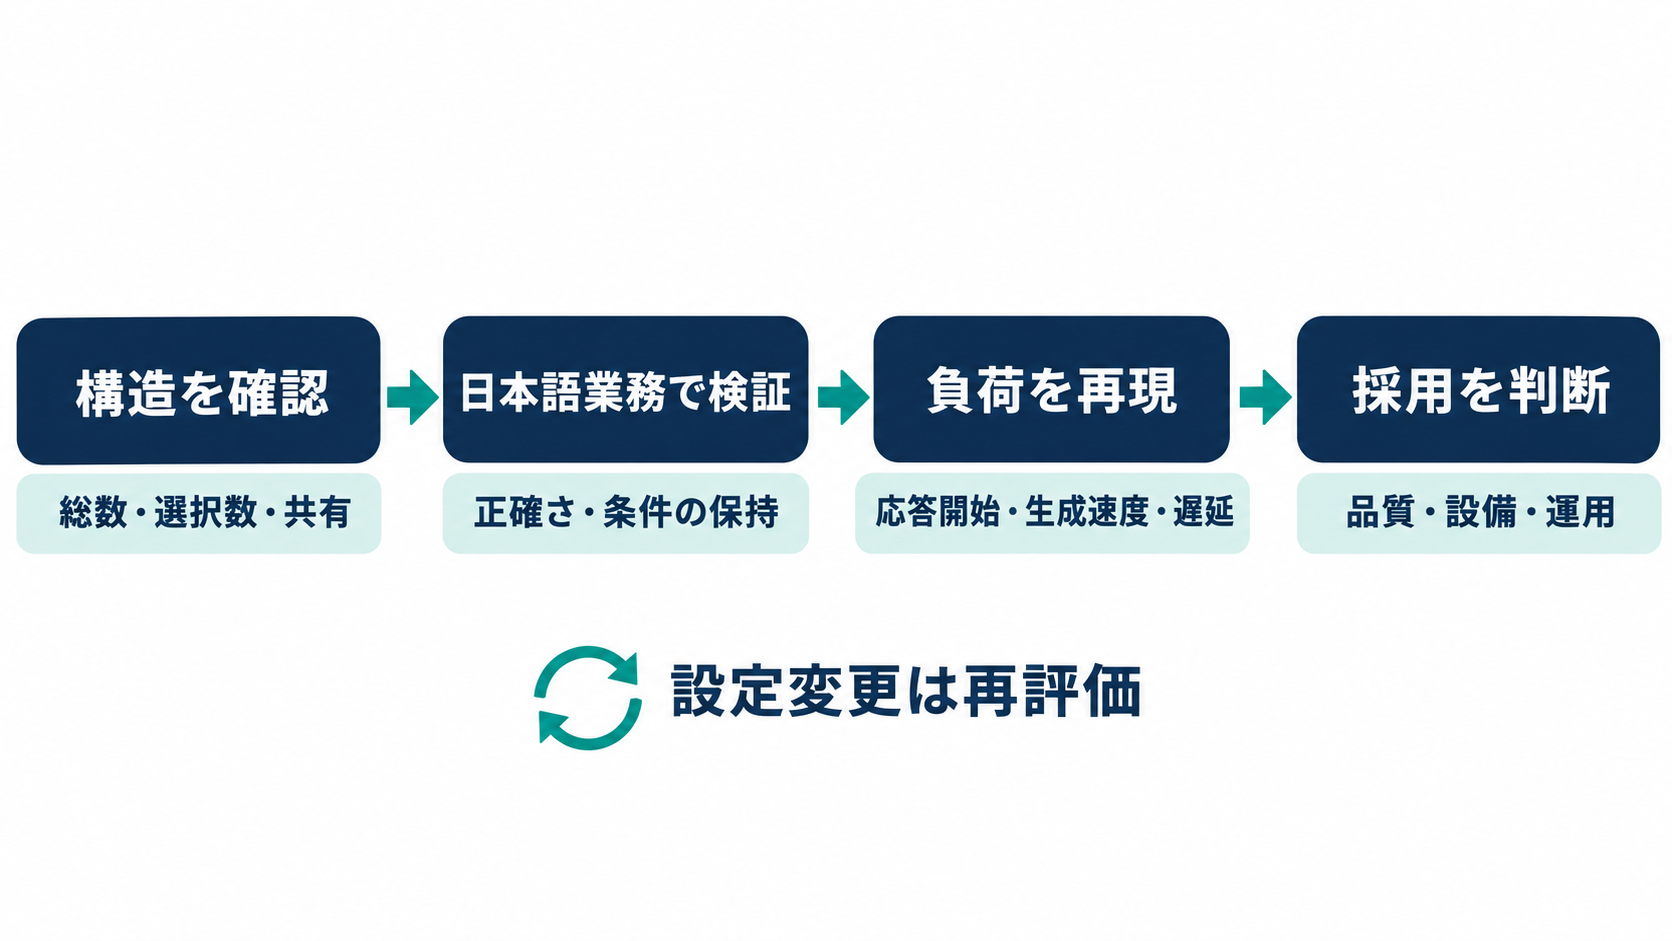
多くの企業は、ルーターを一から設計する立場にはありません。学習済みモデルを選んだ時点で、そのモデルが持つルーティング構造も引き継ぎます。導入時に取り組みやすいのは、方式を独自に置き換えることより、構造を理解したうえで、利用目的と設備に適した候補を絞る作業です。
確認の出発点は、モデル設定ファイルのconfig.jsonです。エキスパート総数、トークンごとの選択数、共有エキスパートの有無、選択方法を確認します。選択方法の設定としてtopk_methodが使われる場合もありますが、項目名や記述方法はモデルによって異なります。見つからない項目を推測で補わず、モデルの説明資料や実装と照合するのが確実でしょう。
推論時に選択数を減らせば、計算を減らせる可能性はあります。しかし、学習時とは異なる組み合わせで出力を作ることになり、品質が維持される保証はありません。Top-kの変更は単なるサーバー設定の調整として扱わず、モデルの挙動を変える実験として評価記録を残す必要があります。
評価用の入力には、自社で実際に扱う日本語の文章や依頼を使うと判断しやすくなります。たとえば社内文書の要約なら、必要な条件を落とさず、根拠のない補足を加えないかを確認します。短い問い合わせへの応答と、長い文書を読み込む処理では負荷のかかり方も違うため、代表的な利用場面を分けて測ることを勧めます。
速度の記録も平均値だけでは足りません。回答が出始めるまでの時間、生成が進む速さ、遅いリクエストの待ち時間を、品質や同時実行数と組み合わせて見ます。方式の新しさだけでは、自社の利用者が待たされにくいかまでは分からないためです。最初の一歩として、候補モデルの構造と設備条件を一枚に整理し、同じ日本語業務データで品質と応答時間を比較してください。その結果が、ルーティングの違いを実際の採用判断へつなげる根拠になります。