
2026/11/08
今更聞けないAI知識
AIは「報酬」でどう学ぶ?迷路の点数からわかる強化学習の基本
この記事の要点
強化学習は、行動の結果への評価を手がかりに、より高い評価につながる行動を学ぶ方法です。架空の迷路ゲームを通じて、行動・結果・報酬の関係を説明します。報酬はAIの喜びを意味せず、点数の決め方と人が望む結果を照らし合わせることが理解の助けになります。
目次
AIに渡す「報酬」は、何のためのもの?
ゲームで得点が入ると、どの進み方がよかったのかを振り返りやすくなります。では、AIの説明に登場する「報酬」も、ご褒美をもらって喜ぶような話なのでしょうか。言葉からは感情を連想しがちですが、仕組みを理解するには、行動を評価するための点数として捉えるとわかりやすくなります。
一言で答えると、強化学習は、行動の結果を点数などで評価し、より高い評価につながる行動を学ぶ方法です。IBMの解説でも、強化学習は試行錯誤と報酬関数によって学ぶ方法として説明されています。報酬関数とは、結果などに応じて評価を与えるための決め方です。(出典: IBM)
ここで押さえたいのは、「何をすればよいか」をすべて手順として渡す説明とは違う点です。たとえば迷路なら、「右、右、上」と正解の道順を示す代わりに、進んだ結果を評価するルールを用意する、という見方ができます。これは仕組みをつかむための架空の例です。実際の製品の操作や、特定のAIの学習条件を示すものではありません。
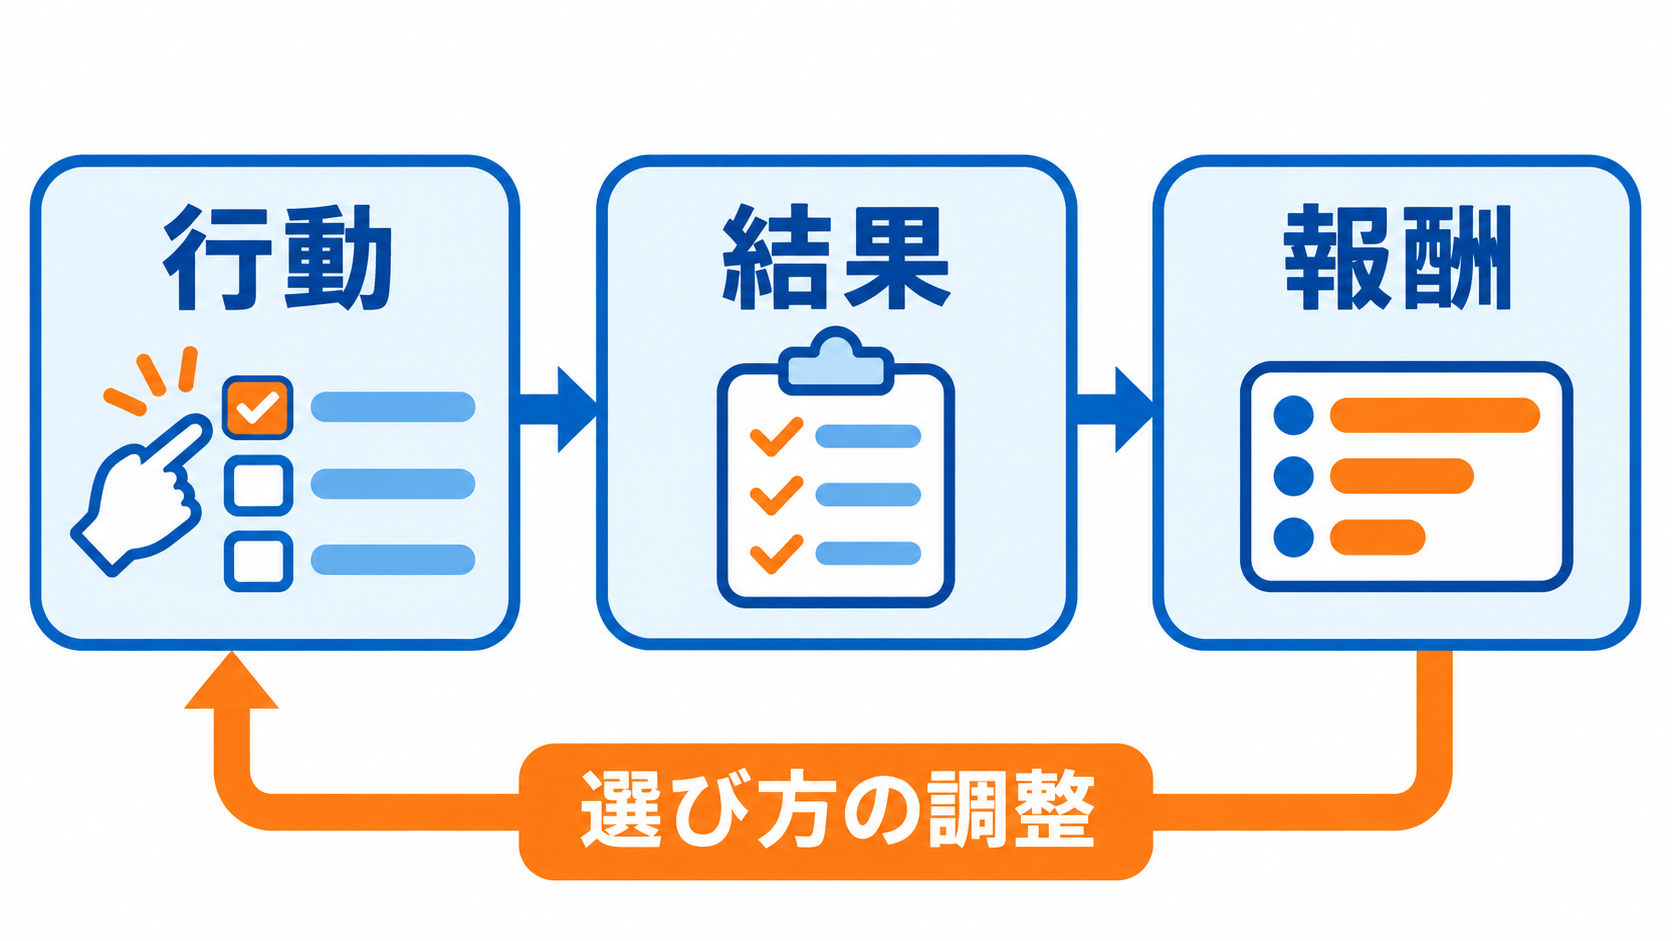
この記事で考える疑問は、「点数を渡すと、どうして行動の学習につながるのか」です。AI全体の用語を一度に覚える必要はありません。「行動する」「結果が変わる」「評価を受ける」という関係を追えば、報酬という言葉の役割が見えてきます。そして、その点数の決め方が、望ましい結果とずれることも理解しやすくなるでしょう。
ゲームの得点にたとえると見える、報酬の役割
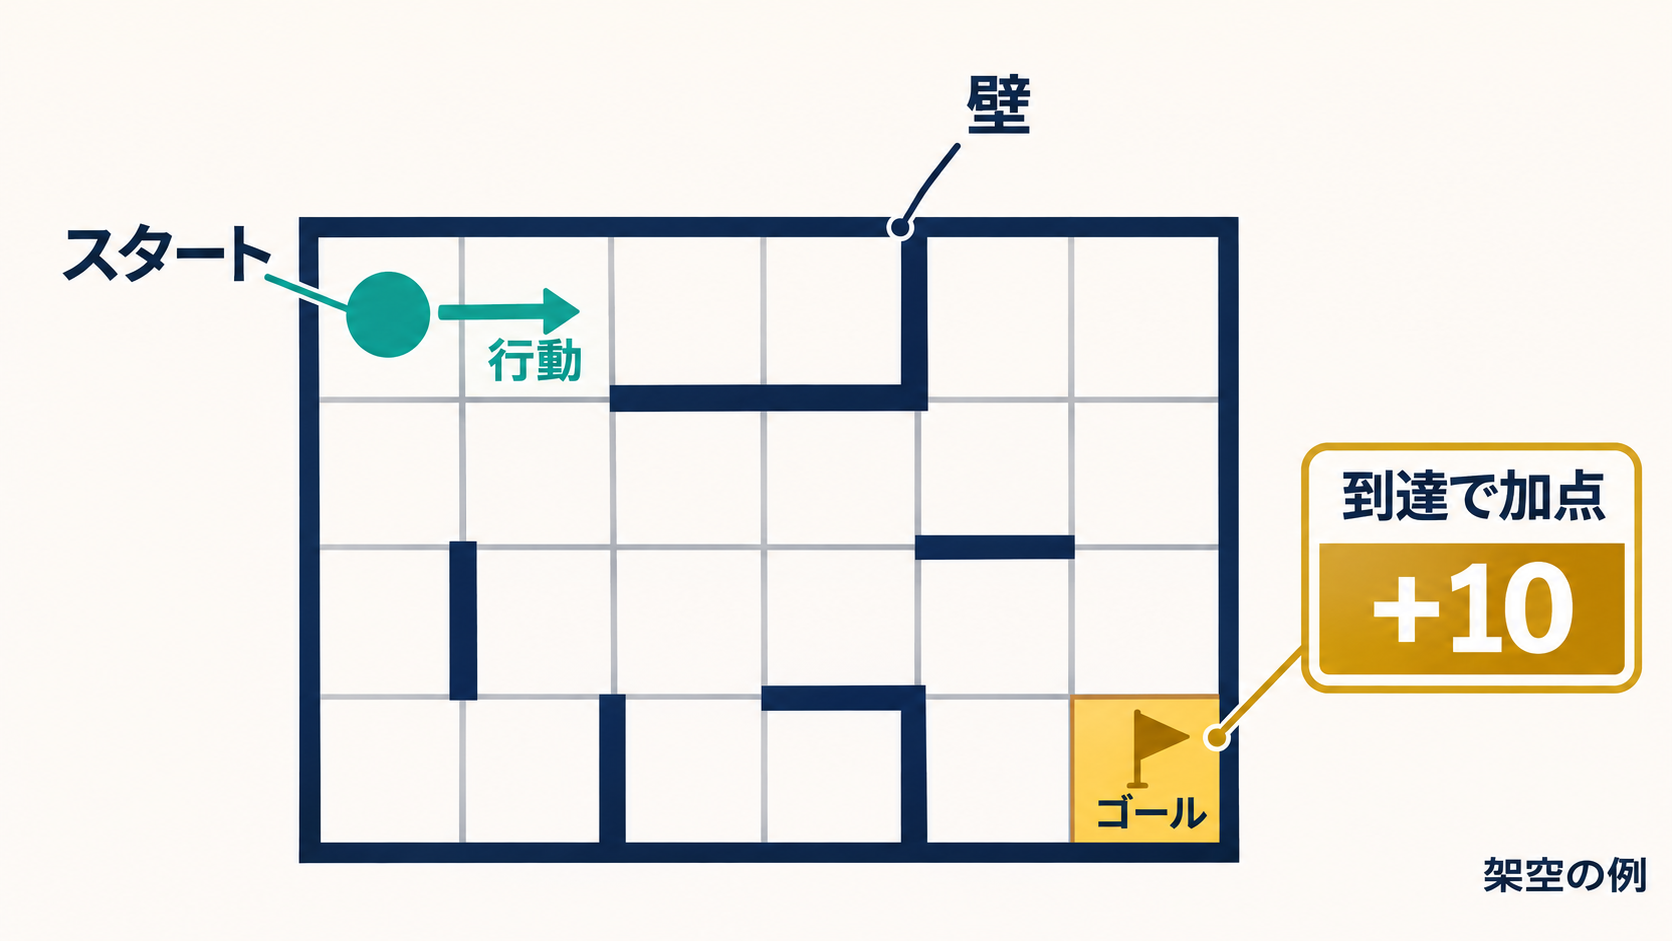
架空の迷路ゲームを想像してください。画面にはスタート地点、通路、壁、ゴールがあります。プレイヤーができる操作は、上下左右へ進むことだけです。初めて遊ぶ段階では、どの分かれ道を選べば出口に近づけるのかはわかりません。道を選び、その結果を見ながら進め方を変えていく場面を考えます。
このゲームに「ゴールに着いたら点数が入る」というルールを設けます。すると、得点は、たどり着いた結果を評価する手がかりになります。単に何回動いたかを見る場合とは、評価している内容が違います。同じ迷路でも、何に点数を付けるかによって、よいとされる進み方が変わるわけです。ここでの得点ルールは、説明のために置いた仮定です。
強化学習の文脈では、行動を選ぶ側を「エージェント」、行動する相手や状況を含む場を「環境」と呼びます。Googleの用語集では、エージェントは方策を使い、環境の状態が変わる過程で得られる累積的な報酬の期待値を最大化する存在として説明されています。方策は、どのように行動を選ぶかというルールです。(出典: Google for Developers)
迷路の例に置き換えるなら、動くプログラムがエージェントで、迷路が環境に当たります。ただし、人がゲームを遊ぶときの楽しさや悔しさまで、このたとえに持ち込む必要はありません。役立つのは、行動と得点の関係を具体的に思い描けるところです。「AIがうれしくなるから繰り返す」と説明するよりも、「高い評価につながる選び方を学ぶ」と整理したほうが、仕組みを取り違えずに済みます。
迷路を一歩進むたびに、何が起きる?
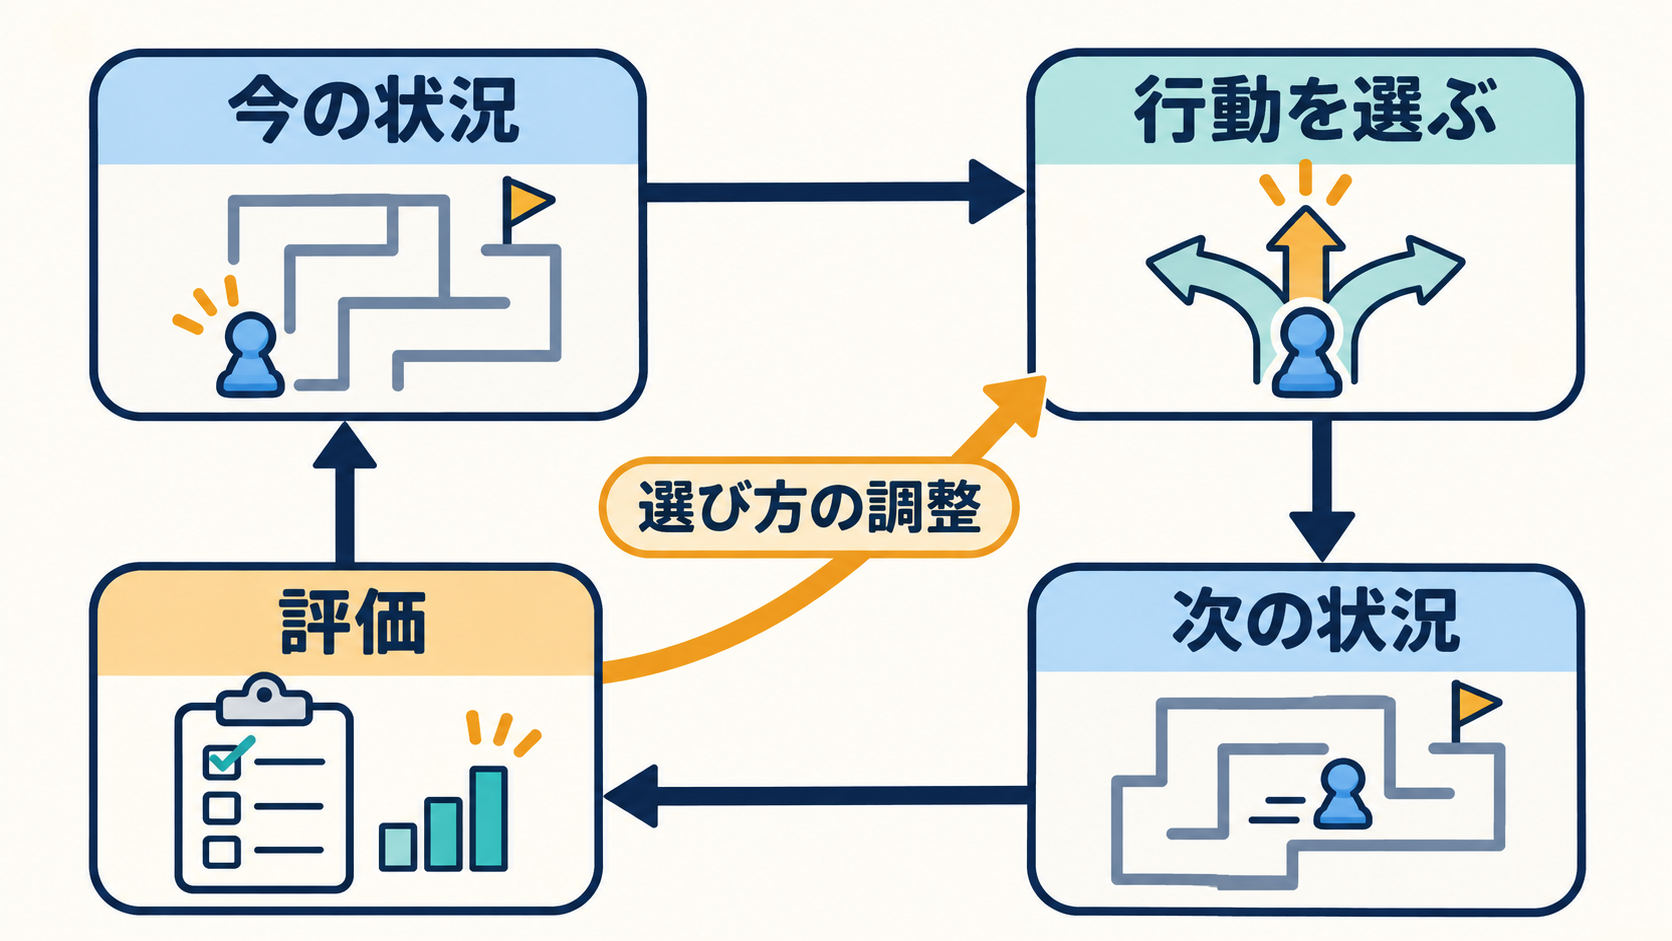
迷路の例を、もう少し細かく追ってみましょう。スタートの先に分かれ道があり、右へ進むと行き止まり、上へ進むと別の通路につながると仮定します。エージェントが右を選ぶと、位置や周囲の状況が変わります。その結果に対して、あらかじめ設けたルールに沿った評価が与えられる、という流れです。
理解のためには、「今の状況」「選んだ行動」「その後の状況」「与えられる報酬」を分けて考えると整理しやすくなります。行動そのものと、行動の評価は同じものではありません。「右に進んだ」という記録だけでは、それがゴールへの近道だったのか、遠回りだったのかまでは決まらないためです。
IBMは、強化学習を試行錯誤と報酬関数に基づく学習として紹介しています。また、Googleの用語集では、エージェントが目指す対象は期待される累積的な報酬とされています。両者を合わせると、一度の動作だけでなく、行動が続いた先の評価まで考えるための枠組みとして捉えられます。(出典: IBM、Google for Developers)
たとえば、架空のルールとして、ゴールでだけ得点が入る迷路を考えます。途中の一歩で得点が入らなくても、その一歩がゴールへ続く道の一部なら、学習上の意味を持ち得ます。「今すぐ点数が入らない行動は、すべて無意味」とは限らないわけです。反対に、ある一歩で点数が入ったとしても、その先で行き止まりになるなら、目先の点数だけでは道全体を評価できません。具体的な計算方法を覚える前に、評価の対象には行動のつながりも含まれる、と押さえておくとよいでしょう。
点数の付け方を変えると、目指す行動も変わる
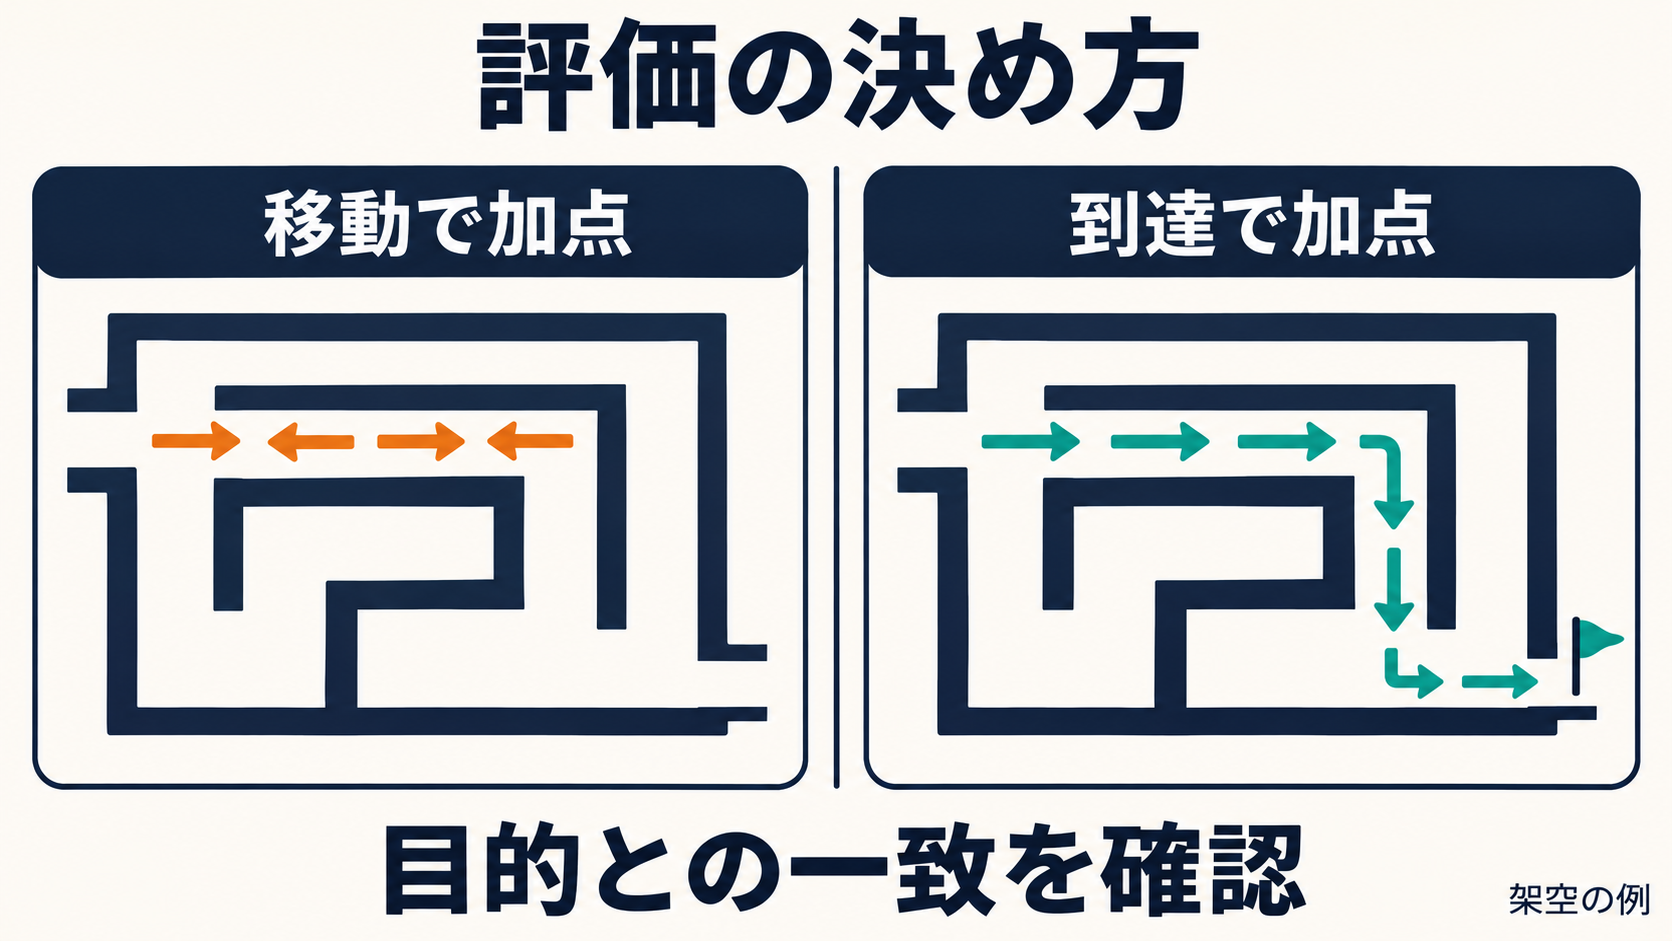
迷路から早く出てほしいとき、「とにかくたくさん動いたら加点する」というルールを置いたらどうなるでしょうか。架空の単純な設定では、ゴールへ向かうより、同じ通路を行ったり来たりするほうが点数を集めやすくなる可能性があります。動く量は増えても、出口に着くという目的には近づかないかもしれません。
これは実際に検証した結果ではなく、評価の決め方を考えるための思考実験です。動いた回数とゴールへの到達は別の指標なので、片方に点数を付けただけで、もう片方まで満たせるとは限りません。強化学習が試行錯誤と報酬関数によって学ぶという説明を踏まえると、報酬をどう決めるかも学習の方向を考えるうえで欠かせないと理解できます。(出典: IBM)
仕事に置き換えた架空の例として、問い合わせへの返信を評価する場面を考えてみます。「返信が短いほどよい」とだけ採点すると、必要な説明まで省いた回答を高く評価するおそれがあります。短さと、相手の疑問が解消されることは同じではありません。これは特定のサービスの採点方法を説明するものではなく、評価項目を考えるための例示です。
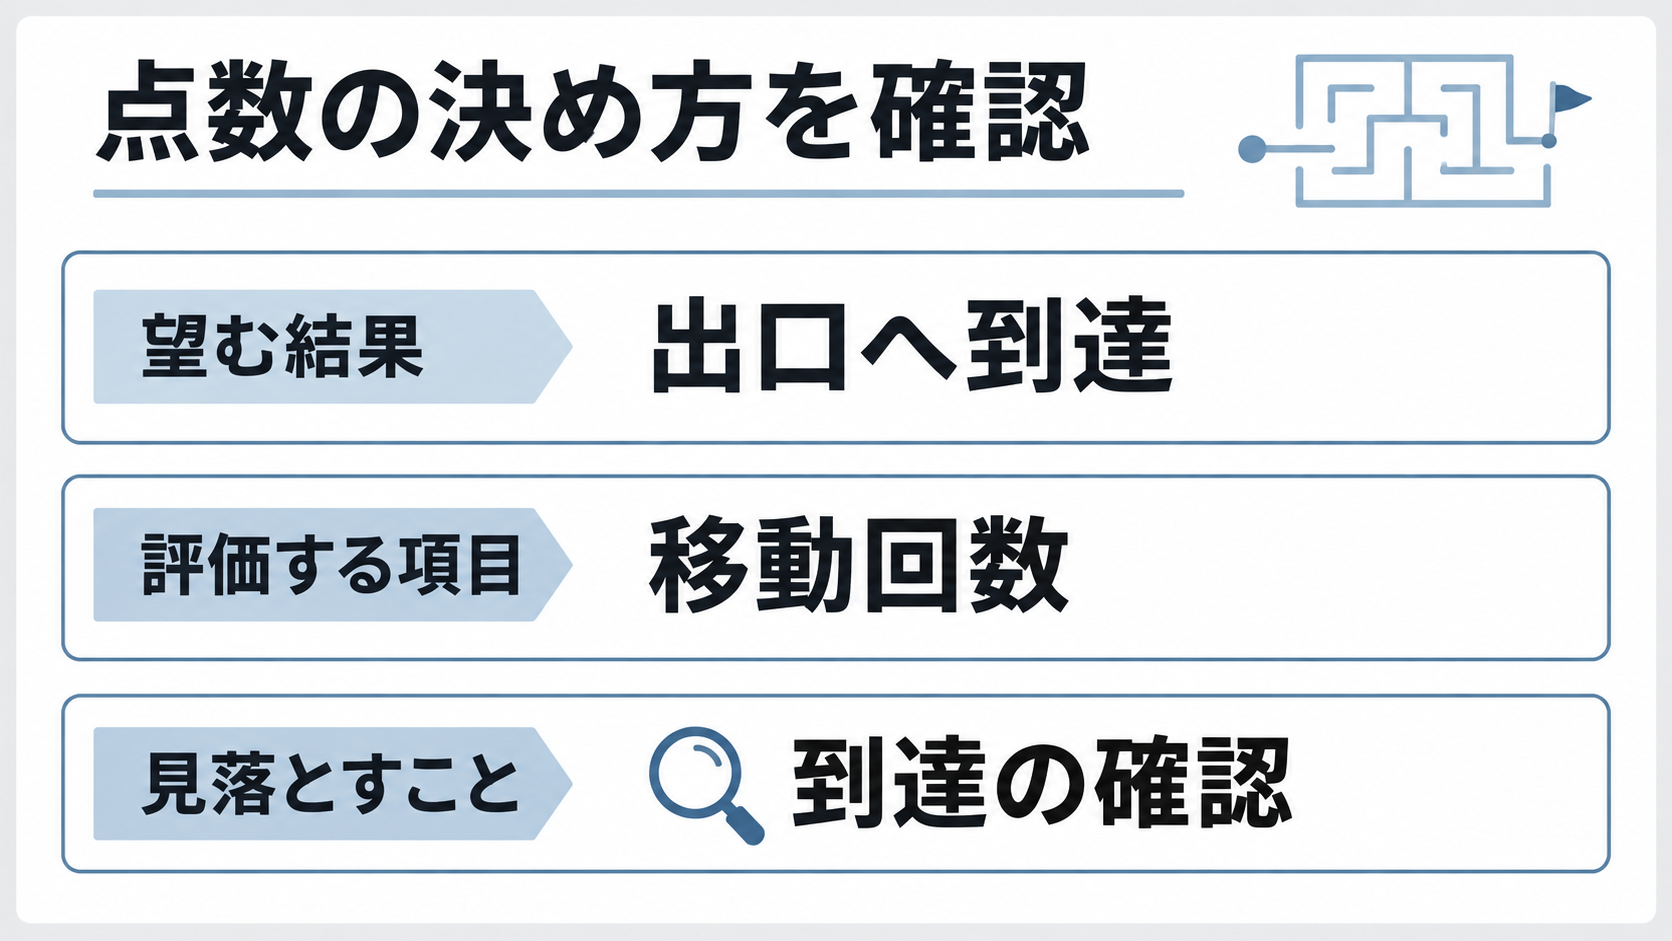
評価を設計する練習としては、「望む結果」「点数にできそうな項目」「その項目だけでは見落とすこと」を分けて書く方法を提案できます。迷路なら、望む結果は出口への到達です。点数にできそうな項目として移動回数を挙げたなら、それだけでは到達を確かめられないと気づけます。数字を置けば目的まで自動的に伝わるわけではない、と考えることが、この仕組みを理解する助けになるでしょう。
「報酬で学ぶ」と聞いたときの、三つの思い違い
一つ目は、報酬をAIの喜びと受け取ることです。今回の資料で説明されているのは、評価を手がかりに行動を学ぶ仕組みです。Googleの用語集でも、強化学習のエージェントは方策と期待される累積的な報酬の関係で定義されています。この説明に、うれしさや意欲といった感情を仮定する必要はありません。(出典: Google for Developers)
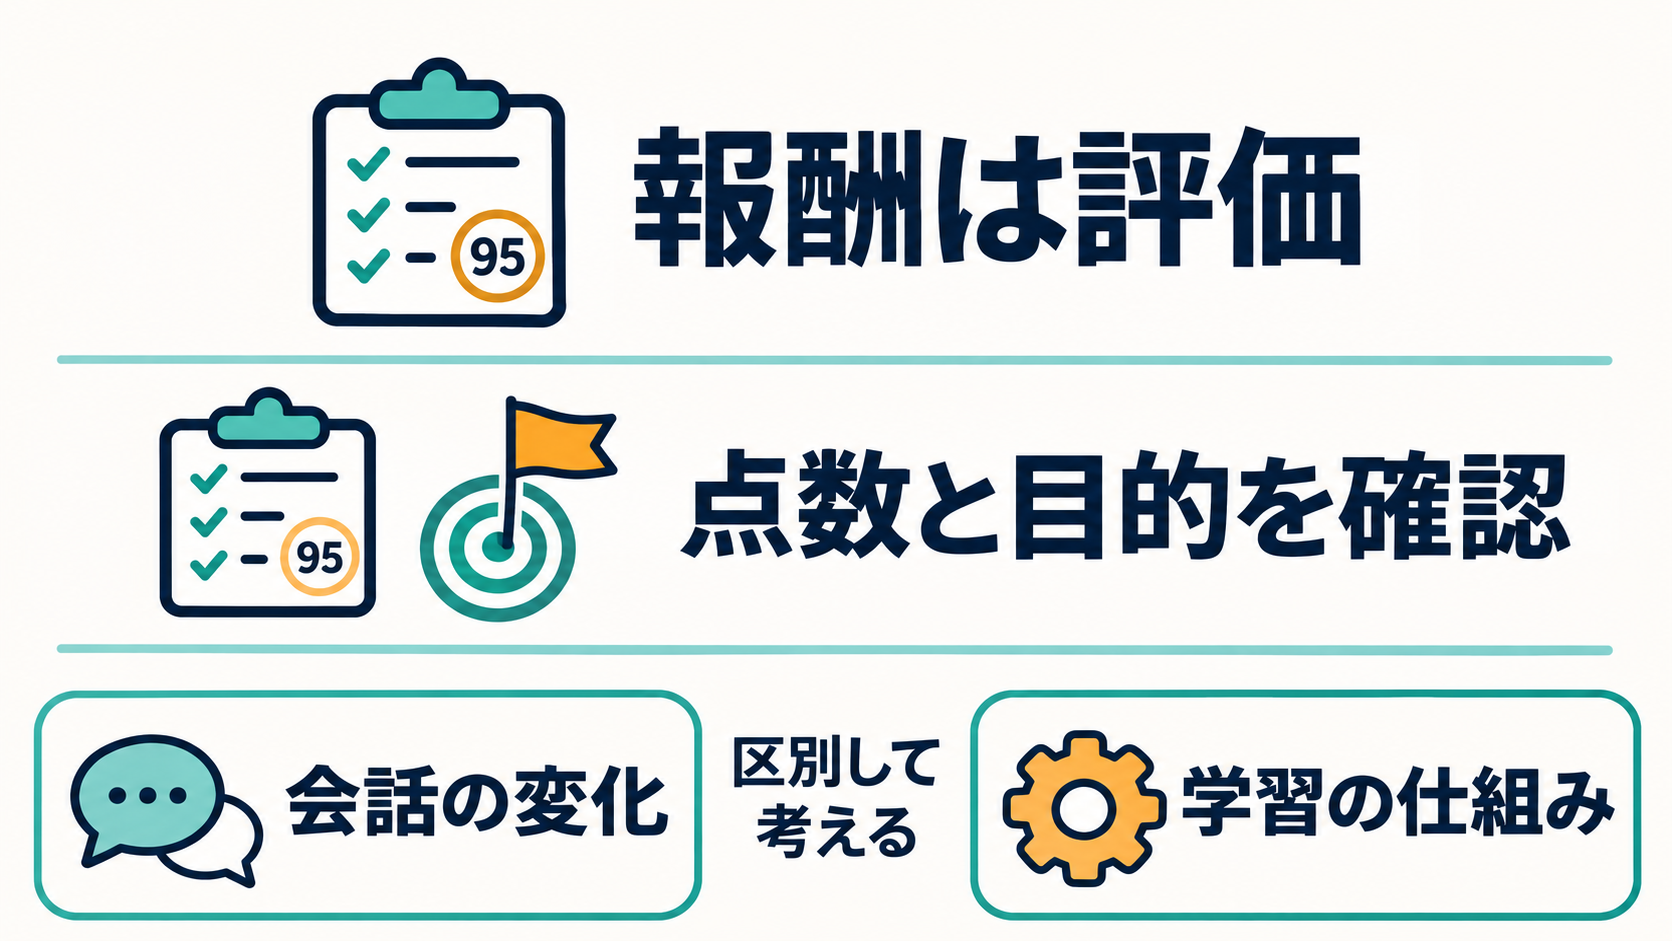
二つ目は、「点数が高いなら、人にとっても必ずよい結果になる」という受け取り方です。前章の架空の迷路では、移動回数に加点するだけでは、ゴールへの到達を保証できませんでした。点数を見るときには、同時に「何を評価した点数なのか」を確かめる必要があります。評価の数字と、本来の目的を並べて見る姿勢が役立ちます。
三つ目は、「会話中に褒めれば、その場で強化学習が行われる」と決めつけることです。Googleの用語集では、チャットの過去のやり取りが、その後の応答の文脈になると説明されています。会話の流れを踏まえて次の回答が変わることと、報酬に基づく学習の仕組みが実行されることは、説明上、区別して考える必要があります。(出典: Google for Developers)
たとえば「その説明は短すぎるので、例を足してください」という依頼は、次の回答で何を求めるかを伝える文として読めます。それだけで、製品内部の学習方法やモデルの更新まで確認できるわけではありません。今回の資料からも、特定のサービスで、どの操作がいつ学習へ反映されるかは確定できません。「返事が変わった」という観察だけから、内部で起きた処理まで言い切らないことが、身近なAIを理解する際の手がかりになります。
明日からは「何に点数を付けているか」を考える
強化学習という言葉に出会ったら、難しい計算式より先に、「どんな行動ができるのか」「何を評価するのか」「続けた先で何を目指すのか」を考えてみてください。迷路なら、上下左右への移動、行動の結果に対する得点、ゴールへ続く進み方という形で対応を付けられます。用語だけを覚えるよりも、説明のどこがまだわからないかを見つけやすくなるでしょう。
この見方は、AIに関する説明を読む際にも使えます。「報酬を使って改善します」と書かれていても、その一文だけでは評価対象まではわかりません。正確さを見ているのか、形式を守れたかを見ているのか、それとも別の項目なのか。資料に説明がなければ、わからない部分として残しておいて構いません。
理解を確かめるための練習として、架空の迷路に二つの得点ルールを作ることを提案します。一つは「動くたびに加点する」、もう一つは「ゴールに着いたら加点する」という設定です。それぞれで、どんな進み方が点数を得やすそうかを紙に書き出してみてください。実際にAIを操作しなくても、同じ行動の場に違う評価を置くと、望まれる進み方がどう変わるかを考えられます。
ここで紹介した基礎は、新製品の発表として扱うものではありません。IBMの資料には2024年8月9日公開、2026年10月2日更新と記載されています。今回提供された資料の取得日は2026年11月8日で、公開日や更新日とは区別する必要があります。(出典: IBM)
次にAIの「報酬」という言葉を見かけたら、「何をしたら、どんな評価になるのか」を一つ確かめてみましょう。説明されている点数の決め方と、人が望む結果を並べてみることが、強化学習を自分の言葉で理解する具体的な一歩になります。