
2026/11/03
今更聞けないAI知識
AIは正解を教わらずに上達できる?ゲームの得点でわかる強化学習
得点を手がかりに学ぶ「強化学習」
ゲームを何度か遊ぶうちに、得点を取りやすい動きと失点につながる動きが見えてくることがあります。では、AIにも同じような試行錯誤をさせれば、正解の手順を一つずつ教えなくても上達できるのでしょうか。
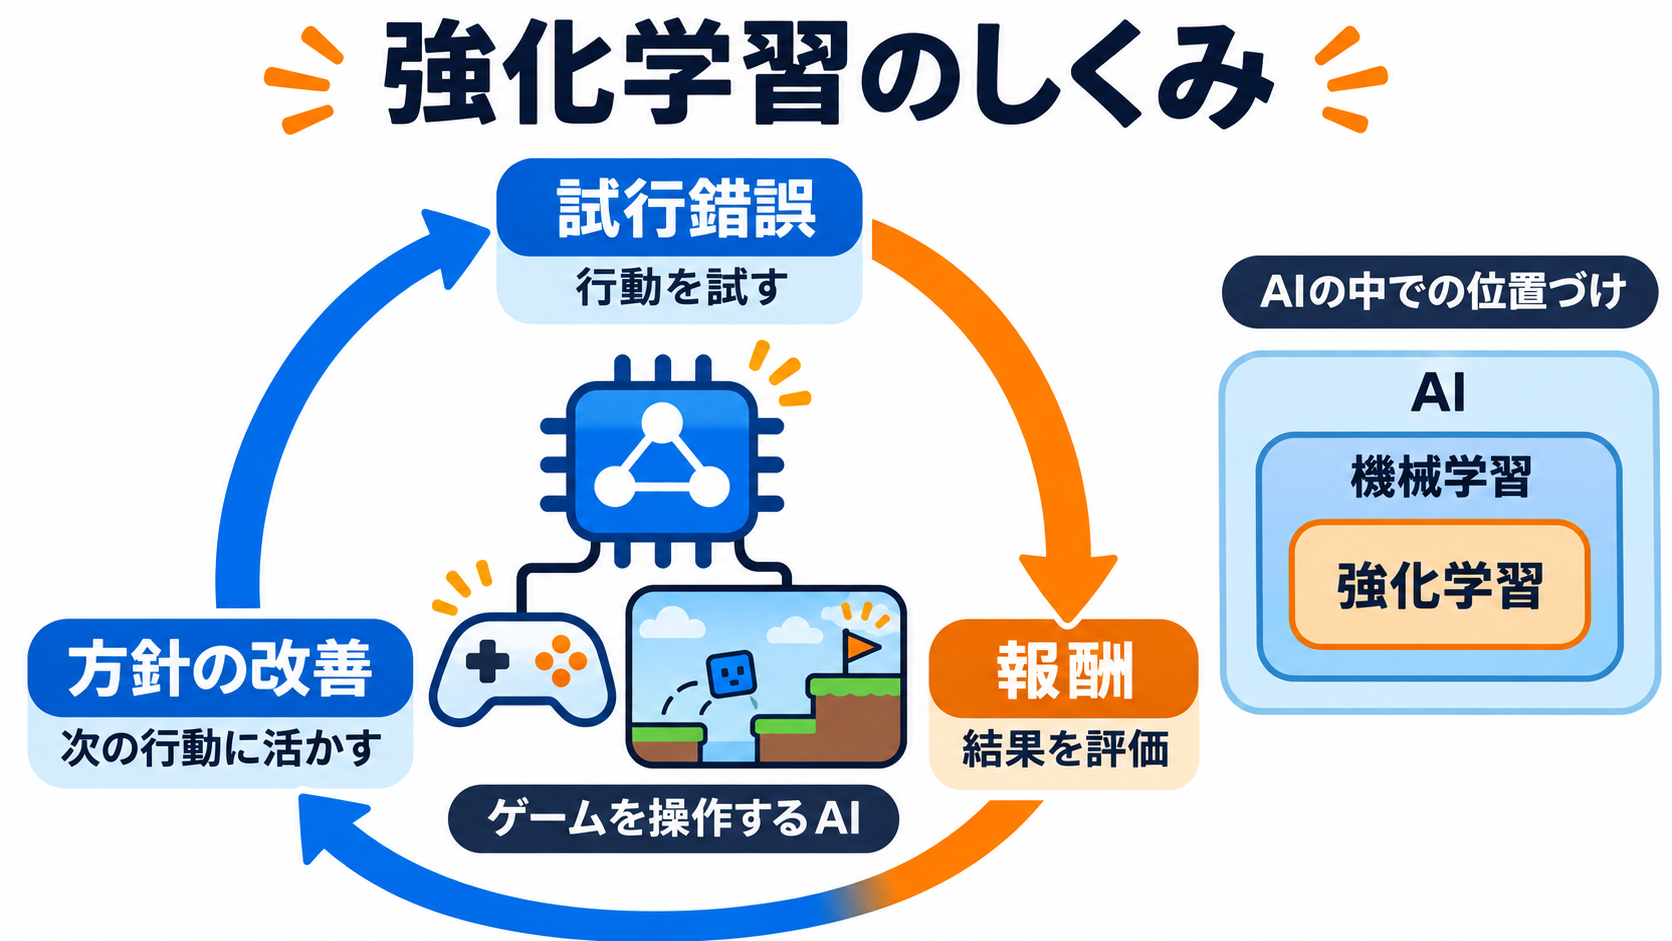
一言で答えると、強化学習とは、行動の結果として得られる「報酬」を手がかりに、行動の選び方を改善する機械学習の方法です。IBMの公式資料でも、強化学習は隠れたパターンから情報を取り出すのではなく、試行錯誤と報酬関数によって学ぶ方法として説明されています(出典: IBM)。ここでいう報酬は、ご褒美を喜ぶ感情ではありません。得点や評価など、結果の良し悪しをシステムへ伝えるための信号です。
強化学習の中心にある問いは、「唯一の正解はどれか」ではなく、「目標に近づく行動はどれか」です。たとえば、架空の迷路ゲームなら、出口への到達に得点を設定し、遠回りや行き止まりを低い評価にする方法が考えられます。AIは人間のように迷路を理解したり、達成感を覚えたりするわけではありません。設定された条件のもとで行動を選び、その結果を比較していると捉えるほうが正確でしょう。
なお、強化学習はAI全体を指す言葉ではありません。AIは、認識、予測、意思決定、生成などを含む広い技術分野であり、機械学習はその中でデータや経験からモデルを作る方法です。強化学習は、さらにその機械学習に含まれる一つの考え方です。この位置関係を押さえると、「AIはすべて得点を与えて育てるもの」という混同を避けやすくなります。
「行動・報酬・方針」で見る学習の仕組み
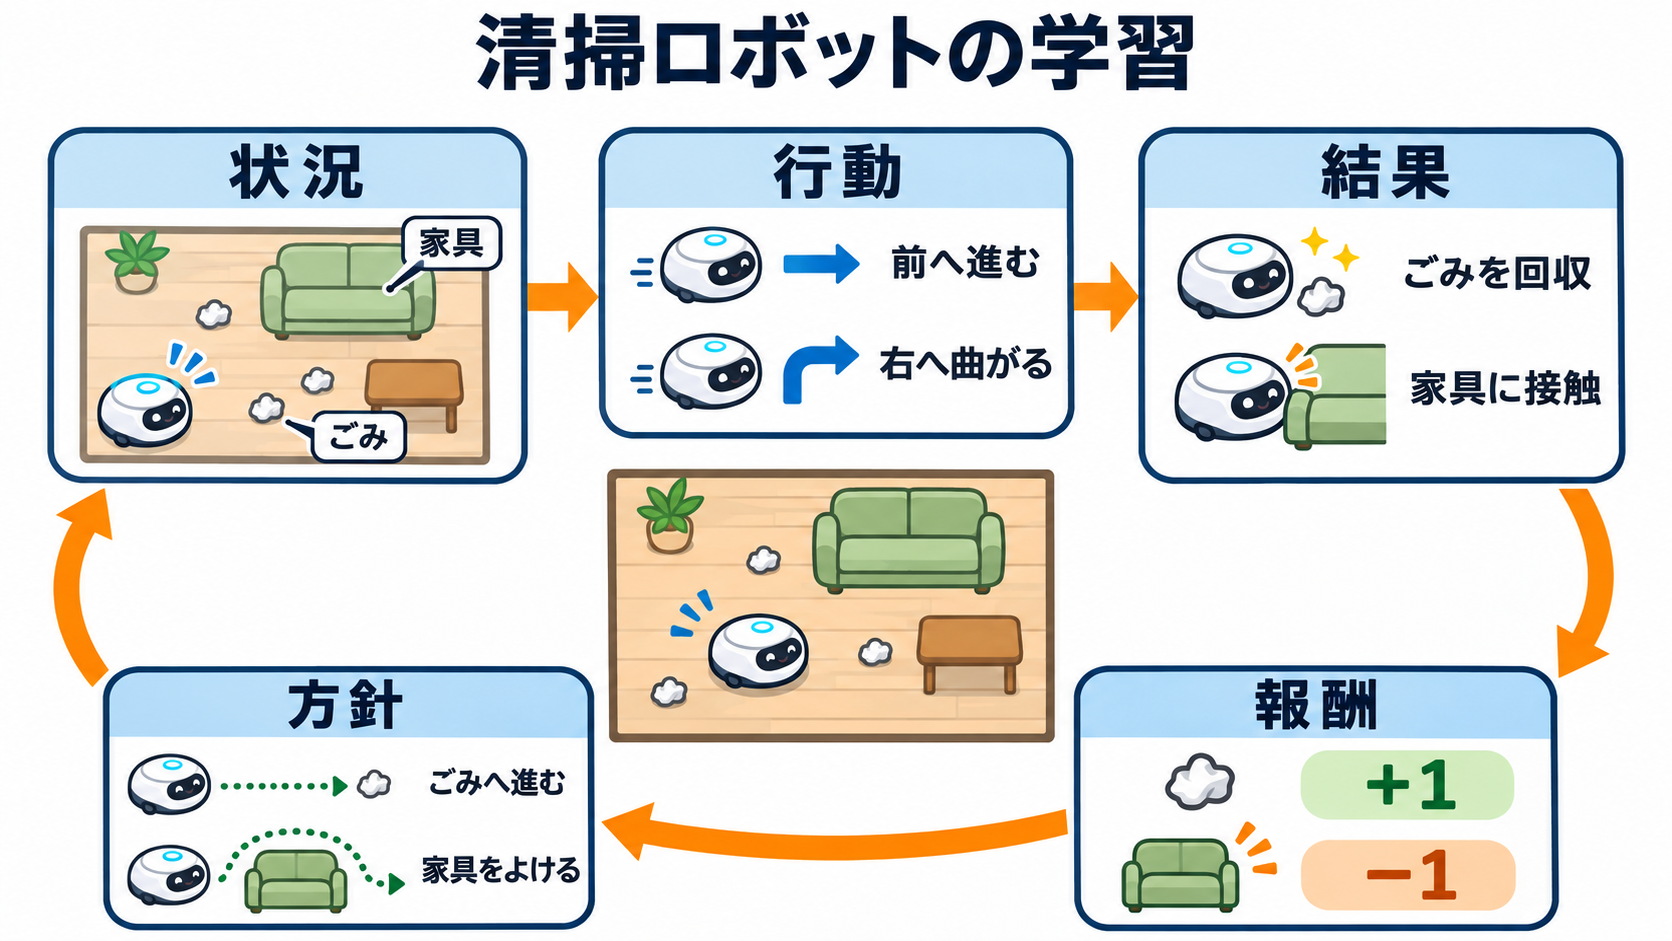
強化学習の基本は、「行動」「報酬」「方針」という三つの言葉で整理できます。行動は、ある状況でシステムが選べる動きです。報酬は、その結果が目標にどれだけ合っていたかを示す手がかりになります。方針は、どの状況でどの行動を選ぶかというルールです。Google for Developersの用語集では、強化学習におけるエージェントを、方針を使って環境内の状態を移りながら、期待される収益を最大化しようとする主体として説明しています(出典: Google for Developers)。
架空の清掃ロボットを例に考えてみましょう。ロボットの候補となる行動は、「前へ進む」「右へ曲がる」「充電場所へ戻る」などです。ごみのある場所を通れば高い評価、家具にぶつかれば低い評価になるよう設計したと仮定します。ロボットは行動を選び、結果として受け取った評価を、以後の選択を調整する材料にします。この繰り返しが試行錯誤に当たります。
ただし、報酬が一度高かった行動を、いつでもそのまま選べばよいわけではありません。同じ「前へ進む」でも、目の前が開いている場合と家具がある場合では結果が異なります。そのため、状況と行動の組み合わせを踏まえて方針を改善する必要があります。強化学習を単なる成功回数の集計ではなく、「状況に応じた選び方を整える仕組み」と見ると理解しやすいでしょう。
この例は仕組みをつかむための架空の説明であり、特定製品の動作を示すものではありません。実際のシステムで選択できる行動、評価の付け方、改善の頻度は設計によって変わります。強化学習という名前だけから、自律的に何でも学べると受け取らないことが大切です。
ゲームの得点が「先生」の代わりになる理由
強化学習を身近に捉えるなら、得点のあるゲームが分かりやすい例です。プレイヤーは、すべての場面について「ここでは右へ動くのが正解です」と教えられなくても、得点の増減を見ながら動き方を変えられます。強化学習でも、個々の場面に正解ラベルを付ける代わりに、行動後の評価を手がかりとして方針を調整します。IBMの資料では、この特徴が「試行錯誤と報酬関数から学ぶ」と整理されています(出典: IBM)。
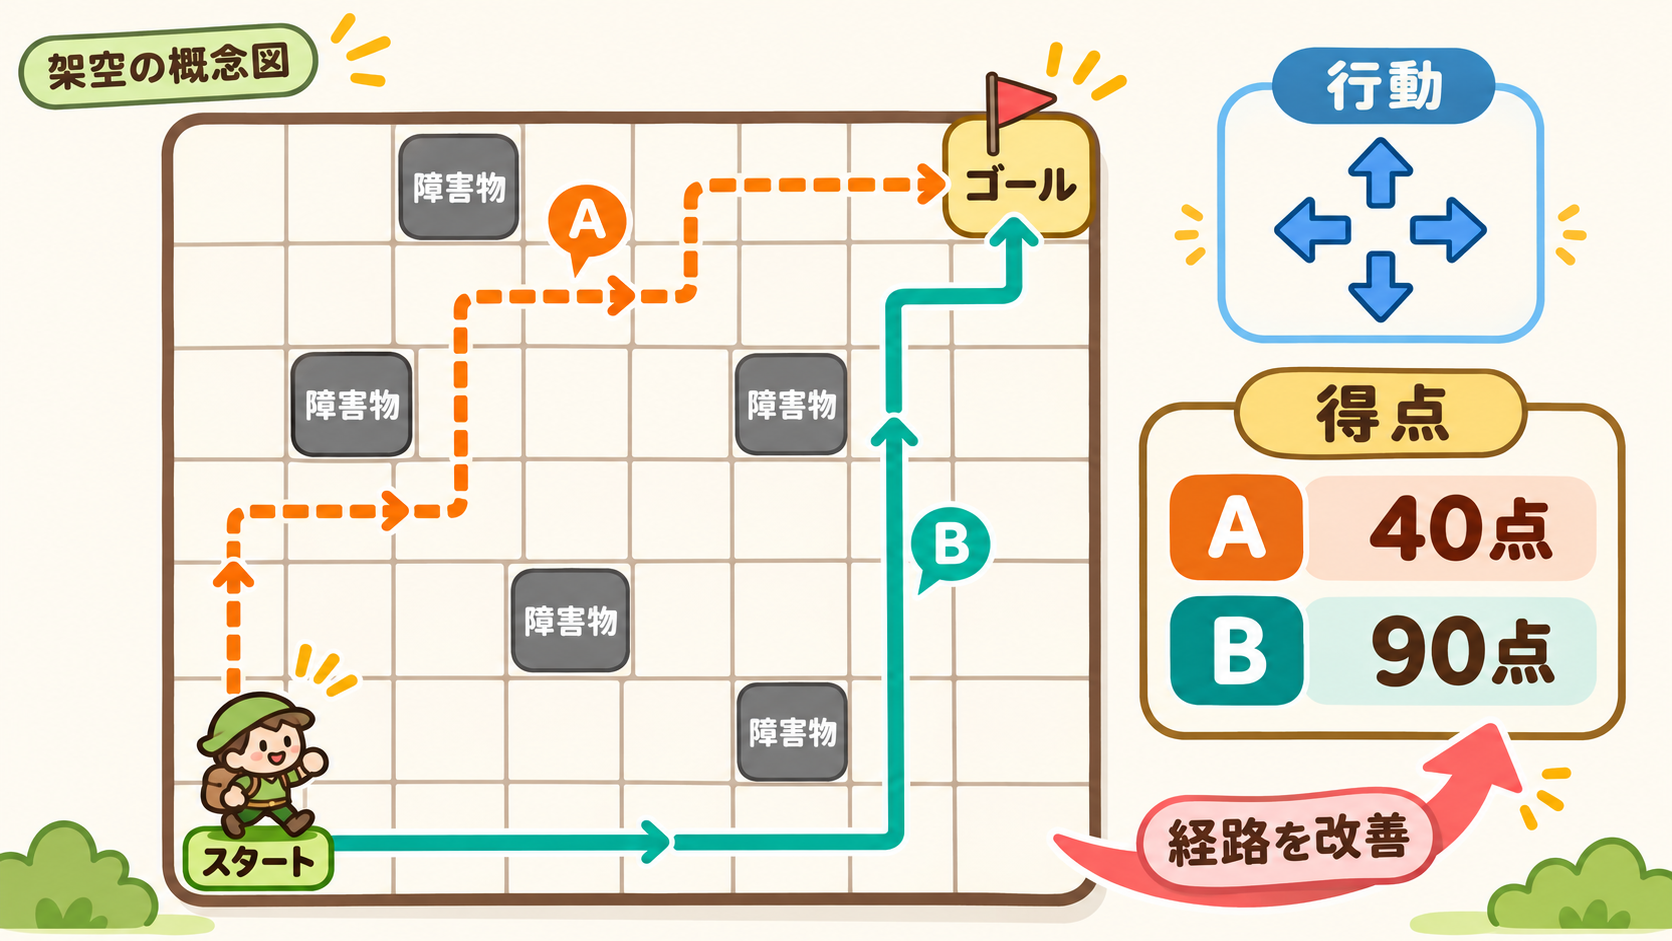
たとえば、マス目の上でゴールを目指す架空のゲームを考えてください。ゴールに着けば得点が入り、障害物へ進めば評価が下がる設定です。最初から最短経路を渡すのではなく、いくつかの行動と結果を経験させ、より良い結果につながる選び方を見つけるという構成が考えられます。このときAIが学んでいるのは、人間にとってのゲームの意味や楽しさではありません。与えられた評価の基準に対して、どの選択が有利だったかという関係です。
ここには注意点もあります。何を報酬とするかによって、望ましい行動の意味が変わるからです。「早くゴールすること」だけを評価する設定と、「障害物を避けながらゴールすること」を評価する設定では、目指す方針が同じとは限りません。つまり、報酬は万能な先生というより、作り手が示した採点基準に近い存在です。採点基準に含まれていない価値まで、自動的にくみ取るとは限りません。
ニュースや製品説明で「AIが自ら学んだ」と書かれていたら、何を試し、どの結果を評価し、何を目標に改善したのかを確認するとよいでしょう。その三点が分かれば、漠然とした「自分で考えるAI」という印象から離れ、実際の仕組みに沿って説明を読めます。
正解例から学ぶ教師あり学習との違い
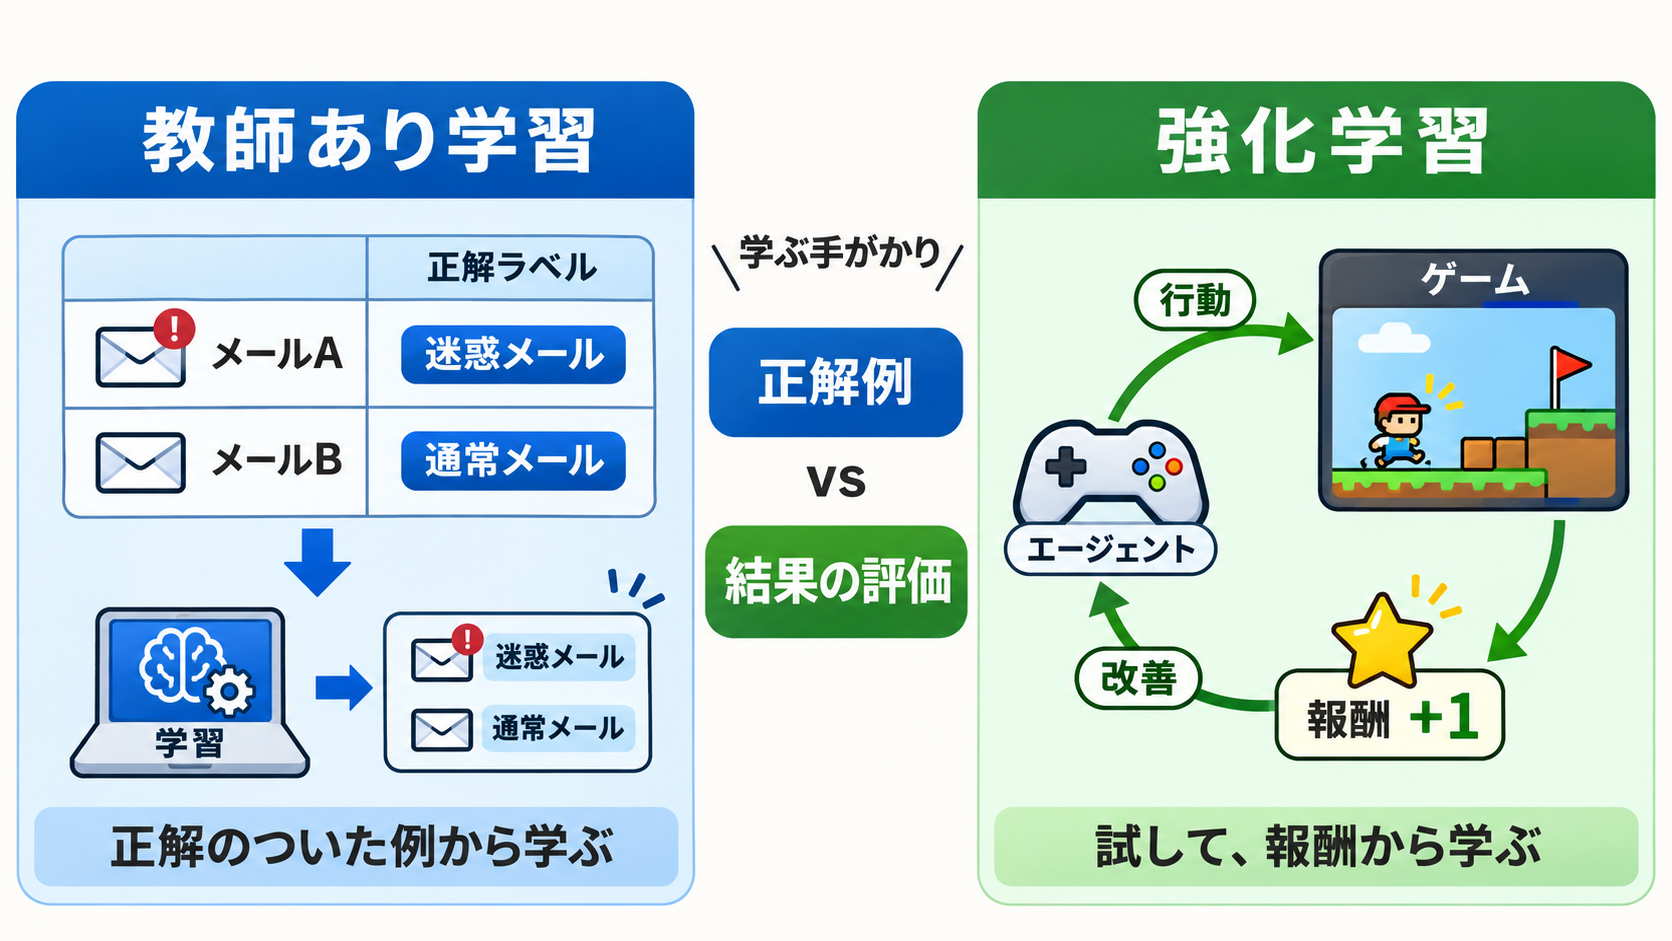
強化学習と混同されやすい方法に、教師あり学習があります。教師あり学習では、入力例と正しい出力を組み合わせた「ラベル付きデータ」を使い、未知の入力に対する分類や予測を学ばせます。IBMの資料では、人が各訓練例に出力ラベルを対応させ、モデルが入力と出力の関係を学ぶ方法として説明されています(出典: IBM)。Google Cloudも、機械学習をAIの一部と位置付け、データから特定の課題に役立つパターンを学ぶ技術として整理しています(出典: Google Cloud)。
両者の違いは、「人が何を手がかりとして渡すか」に注目すると見えやすくなります。
| 見る点 | 教師あり学習 | 強化学習 |
| --- | --- | --- |
| 主な手がかり | 入力に対応する正解例 | 行動後に得られる報酬 |
| 学ぶ対象 | 入力と正しい出力の対応 | 状況に応じた行動の方針 |
| 架空の例 | メールと迷惑メール判定の組を学ぶ | ゲームの得点を頼りに動き方を変える |
| よくある誤解 | 人間の先生と会話しながら学ぶ | AIが目的まで自分で決める |
たとえば、迷惑メールの判定を教える架空の課題では、「このメールは迷惑メール」「こちらは通常のメール」という正解例を用意する方法が考えられます。これが教師あり学習のイメージです。対して、移動経路を選ぶ課題で、到着や安全性に評価を設定し、行動の結果から選び方を改善するなら、強化学習の考え方に近づきます。
どちらかが常に優れているわけではありません。正解例を用意しやすい課題なのか、連続した行動の結果を評価したい課題なのかによって、適した方法は変わります。また、実際のAIシステムでは複数の学習方法が組み合わされる場合もあります。名称だけで仕組みを決めつけず、「正解例を渡したのか」「行動後の評価を渡したのか」と問い直すことが、違いを見分ける近道です。
質問するたびにAIが勝手に学ぶわけではない
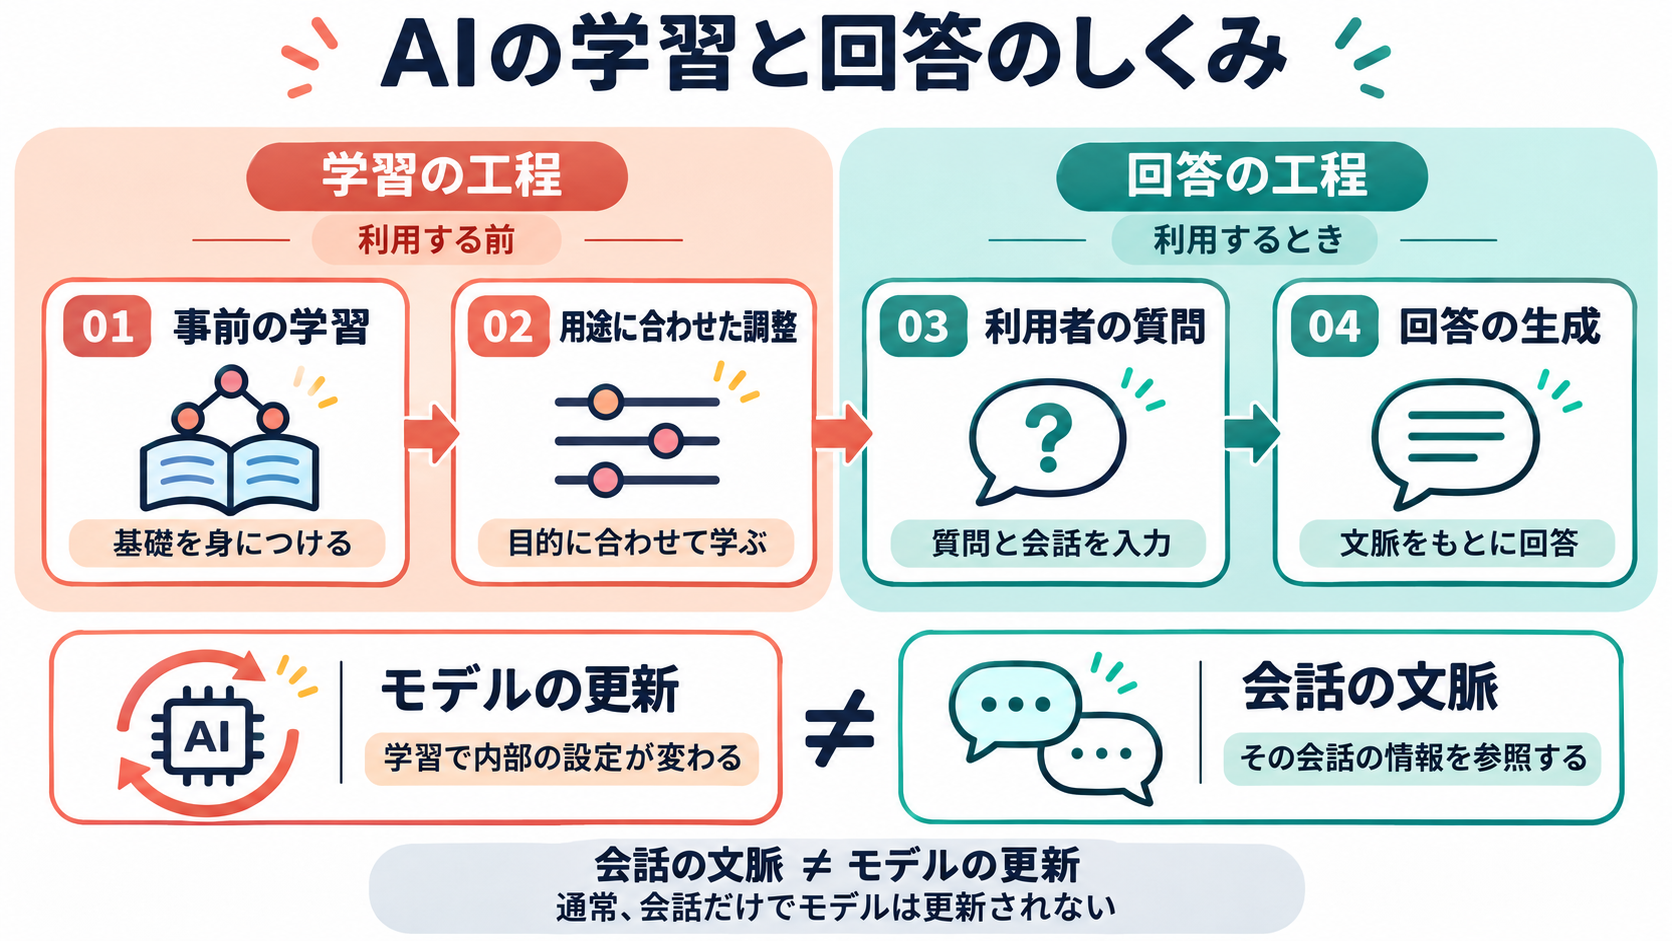
チャット型のAIが前の発言を踏まえて答えると、「今の会話で学習したのでは」と感じるかもしれません。しかし、会話の内容を回答の文脈として使うことと、モデルの学習によって内部の調整値を変えることは別です。Google for Developersの用語集では、チャットの過去のやり取りが後続部分のコンテキスト、つまり回答を組み立てるための前提情報になると説明されています(出典: Google for Developers)。前の発言に合わせた返答が出ても、それだけで再学習が行われたとは判断できません。
IBMの公式資料は、生成AIの流れを大きく「学習」「特定用途への調整」「生成・評価と追加調整」に分けています。基盤となるモデルは大量のデータを使って訓練され、その後、用途に合わせたファインチューニングなどが行われます。利用時には、その準備済みのモデルがプロンプトに応じて内容を生成します(出典: IBM)。したがって、「質問を送る」「返答が生成される」「モデル自体が更新される」は、同じ出来事ではありません。
架空の例として、会話の冒頭で「商品名は略さず書いてください」と頼んだとします。その後の回答で表記がそろったなら、会話内の指示を文脈として参照している可能性があります。これを「AIが永続的に新しいルールを習得した」と言い換えるのは適切ではありません。別の会話や別の利用者にも同じ変化が残るかどうかは、サービスの機能や提供条件を確認しなければ分からないからです。
強化学習についても同様です。利用者が一度訂正しただけで、AIがその場で方針を恒久的に更新するとは限りません。フィードバックの保存、学習への利用、反映時期はサービスごとに異なり得ます。画面上の反応だけから推測せず、公式の説明を確認する姿勢が必要でしょう。
生成AIの調整にも使われる人の評価
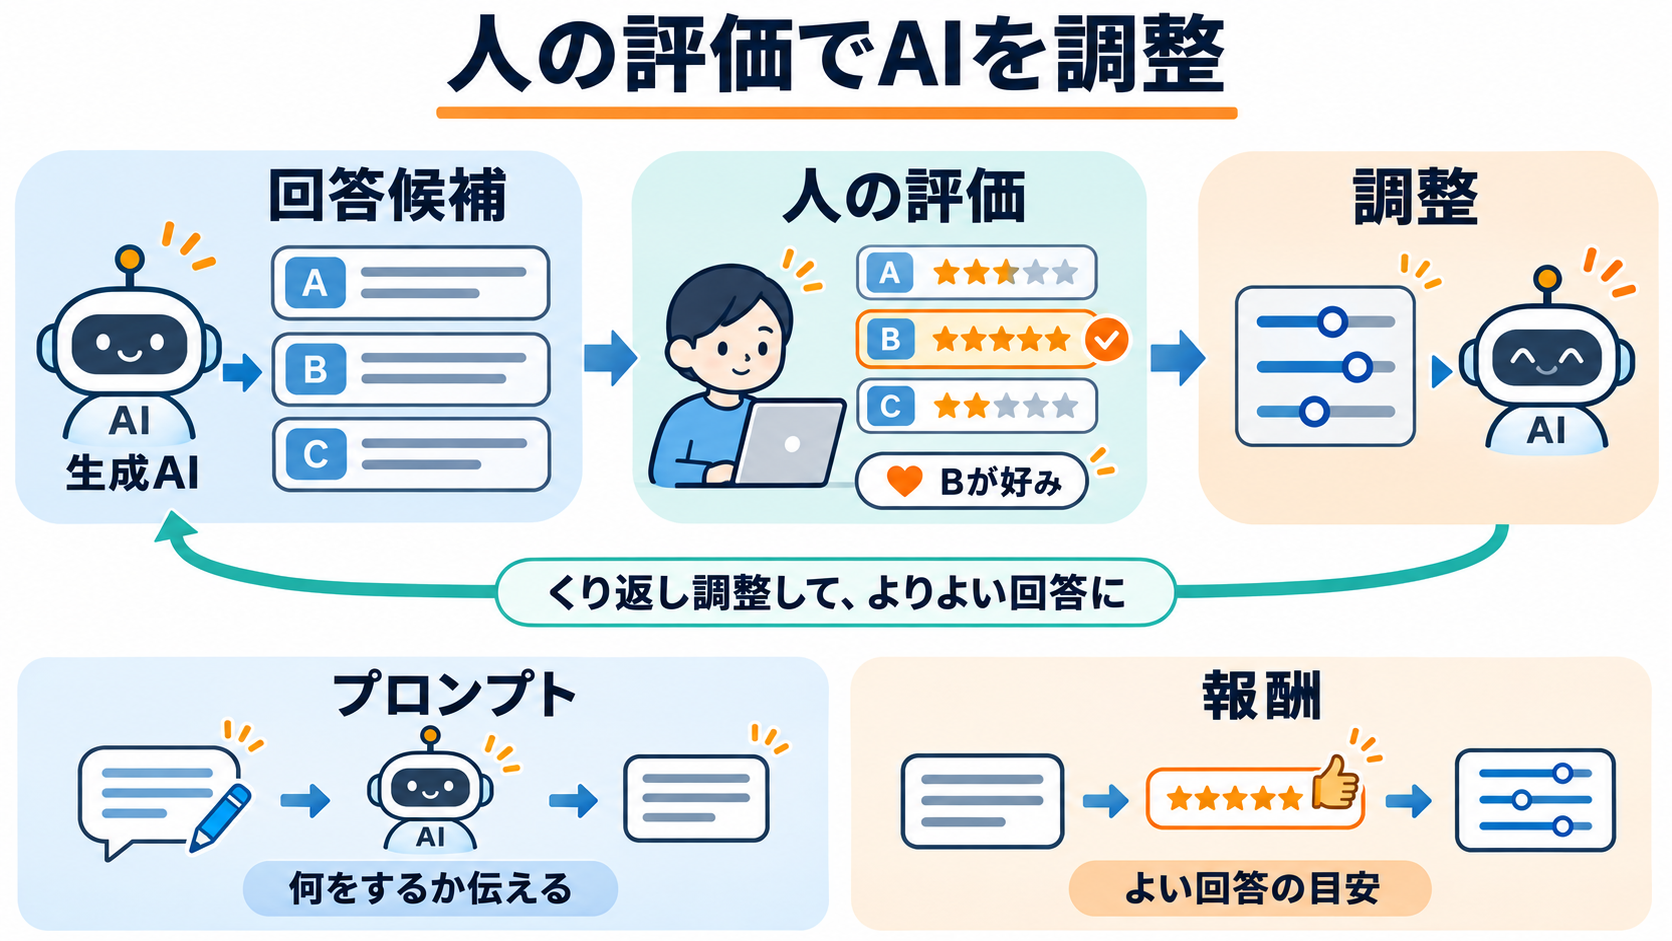
強化学習はゲームやロボットだけに関係する言葉ではありません。生成AIの調整方法として目にすることもあります。IBMの資料では、特定用途への調整方法の一つとして「人間のフィードバックによる強化学習」が挙げられています。これは一般にRLHFと略され、人がモデルの出力の正確さや関連性などを評価し、その評価を改善に利用する考え方です(出典: IBM)。
仕組みを理解するため、架空の文章生成システムを考えてみましょう。同じ依頼に対する複数の回答候補を用意し、人が「依頼に沿っているか」「読みやすいか」といった基準で評価します。その評価を、望ましい回答へ近づけるための調整材料にするという例です。ここでも、人がAIへ知識を口頭で理解させるわけではありません。出力に対する評価を、モデルやシステムの調整に利用します。
プロンプトと報酬も区別しておきましょう。プロンプトは、生成AIへ依頼や条件を伝える入力です。たとえば「専門用語を避け、三つの要点にまとめてください」という文章がプロンプトに当たります。報酬は、行動や出力の結果を評価するための手がかりです。利用者から見ればどちらもAIへ渡す情報ですが、学習や生成の流れにおける役割は異なります。
また、人の評価を使って調整されたモデルでも、すべての回答が正しいとは限りません。回答は学習された表現や関係をもとに生成されるため、事実と異なる内容をもっともらしく示す可能性があります。強化学習による調整を「真実を保証する仕組み」と理解せず、重要な内容は根拠となる資料で確認する必要があります。
「何を報酬にしたのか」を確かめる習慣
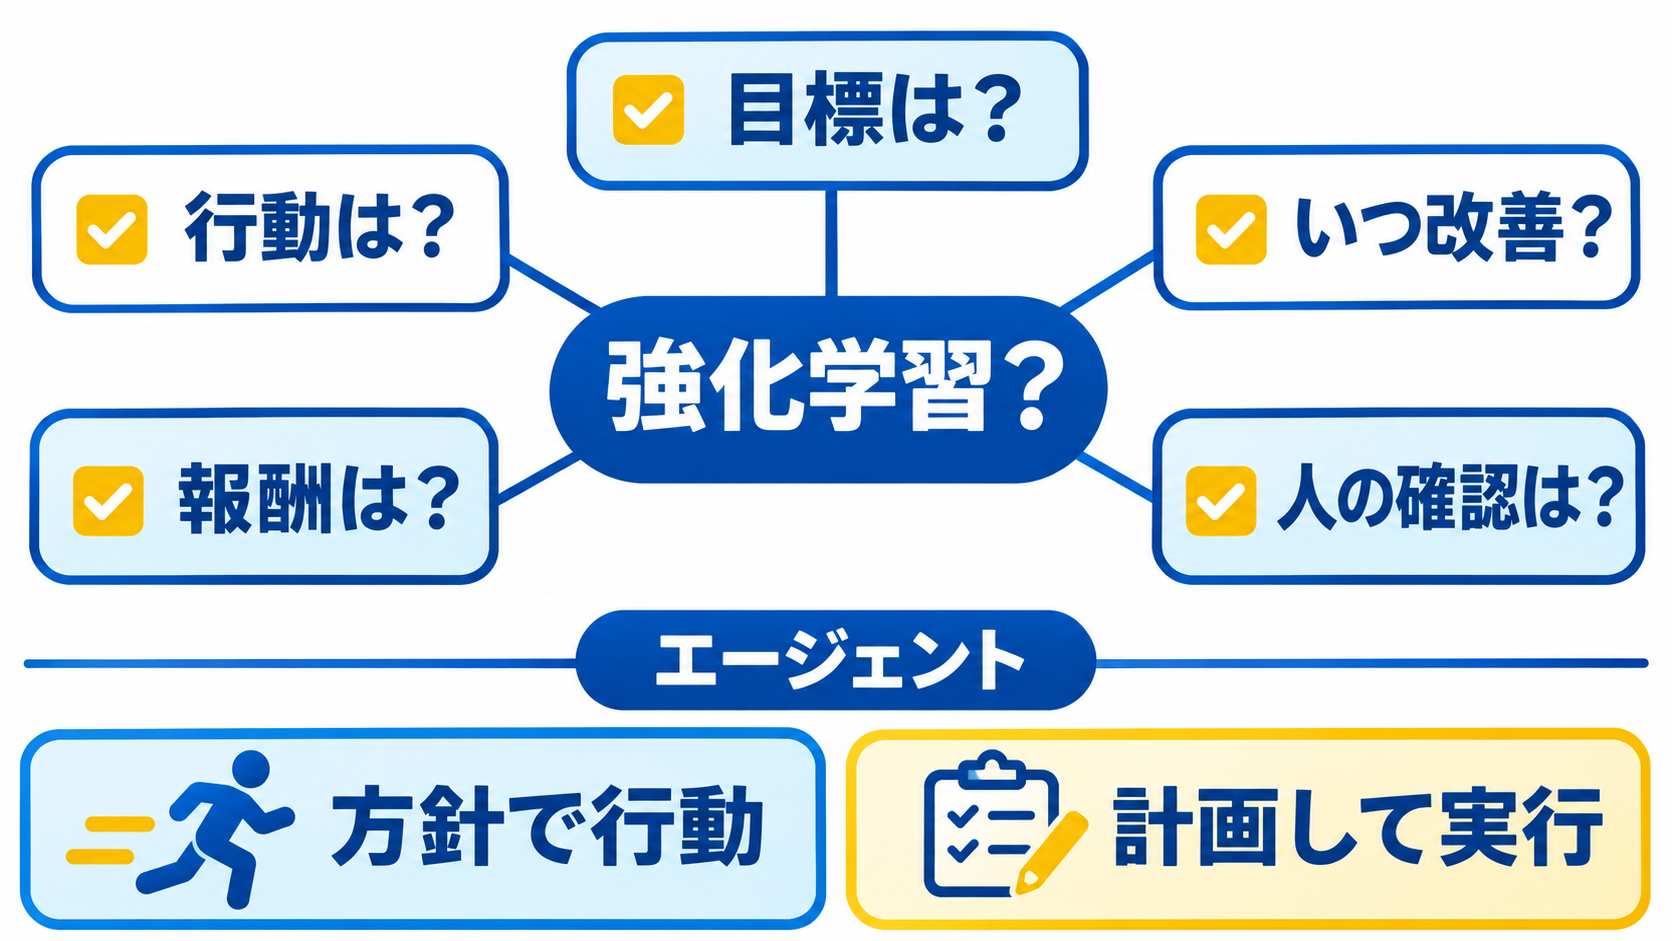
強化学習を理解した後に役立つのは、難しい数式を覚えることよりも、AIの説明を読むときの問いを持つことです。「学習するAI」「自律的に改善するシステム」と紹介されていても、その言葉だけでは、教師あり学習なのか強化学習なのか、利用中にモデルが更新されるのかは判断できません。説明の中から、行動、評価、方針の三点を探してみてください。
確認するときは、次のような問いが手がかりになります。
- システムが選べる行動は何でしょうか。
- 行動の良し悪しを示す報酬は何でしょうか。
- その報酬は、誰がどの目的で設定したのでしょうか。
- 方針を改善する処理は、いつ行われるのでしょうか。
- 利用者の入力は回答の文脈に使われるだけなのか、後の調整にも使われるのでしょうか。
「エージェント」という言葉にも文脈の違いがあります。強化学習では、方針を使って環境内で行動する主体をエージェントと呼びます。生成AIの分野では、入力をもとに計画を立て、利用可能な道具を使って利用者の代わりに行動するソフトウェアを指す場合があります。Google for DevelopersとIBMの資料でも、それぞれの文脈でエージェントが説明されています(出典: Google for Developers、IBM)。同じ単語が出ても、何を行動とし、どこまで実行できるのかを確認したほうがよいでしょう。
強化学習の要点は、「AIが自分の意思で成長すること」ではなく、「設計された評価を手がかりに行動の選び方を改善すること」です。明日からAI関連の記事や製品説明を読む際は、まず報酬に当たるものを一つ探してみてください。見つからなければ、その「学習」は強化学習とは別の仕組みかもしれません。この切り分けができるだけでも、AIという大きな言葉に振り回されにくくなります。