
2026/11/03
今更聞けないAI知識
AIの性能は一つの点数で決まらない—「評価(evals)」を模擬試験で理解する
「このAIは優秀ですか」と聞く前に決めたいこと
新しいAIサービスを目にしたとき、「どれが一番賢いのですか」と知りたくなるかもしれません。ところが、文章を自然に整えるAIと、入力された数字を正確に分類するAIを、同じ物差しだけで比べても判断しにくいものです。人を評価するときも、計算の速さ、説明の分かりやすさ、慎重さを一つの点数で表すのは難しいでしょう。AIにも似た事情があります。
一言で答えると、AIの「評価(evals)」とは、決めた基準に沿ってモデルの出力品質を測ることです。evalsは主に大規模言語モデルの評価を指す略称として使われ、広い意味ではさまざまな評価を含むと説明されています。また、evaluationはモデルの品質を測ったり、複数のモデルを比べたりする過程を意味します(出典: Google for Developers)。ここでいうモデルとは、入力を受け取り、予測や文章などの出力を返す仕組みです。
評価で大切なのは、AIに漠然と順位を付けることではありません。「自分が任せたい作業に対して、どの程度ふさわしい回答を返すか」を確かめることです。たとえば、架空の用途として、社内向けのお知らせ文を作りたい場合を考えます。この場合、漢字テストだけで高得点を取っても、必要事項が抜けたり、読み手に合わない言葉を使ったりすれば目的には合いません。内容の正確さ、条件の反映、読みやすさなどを分けて見る必要があります。
つまり、「性能が高いか」という問いには、先に「何をさせたいのか」という問いが必要です。評価は、AIの能力を絶対的に証明する印鑑ではなく、目的と回答の相性を点検する道具だと捉えると分かりやすくなります。この見方を持つだけでも、広告やランキングの数字をそのまま受け入れず、自分の用途に引き寄せて考えられるでしょう。
評価を模擬試験と採点にたとえた仕組み
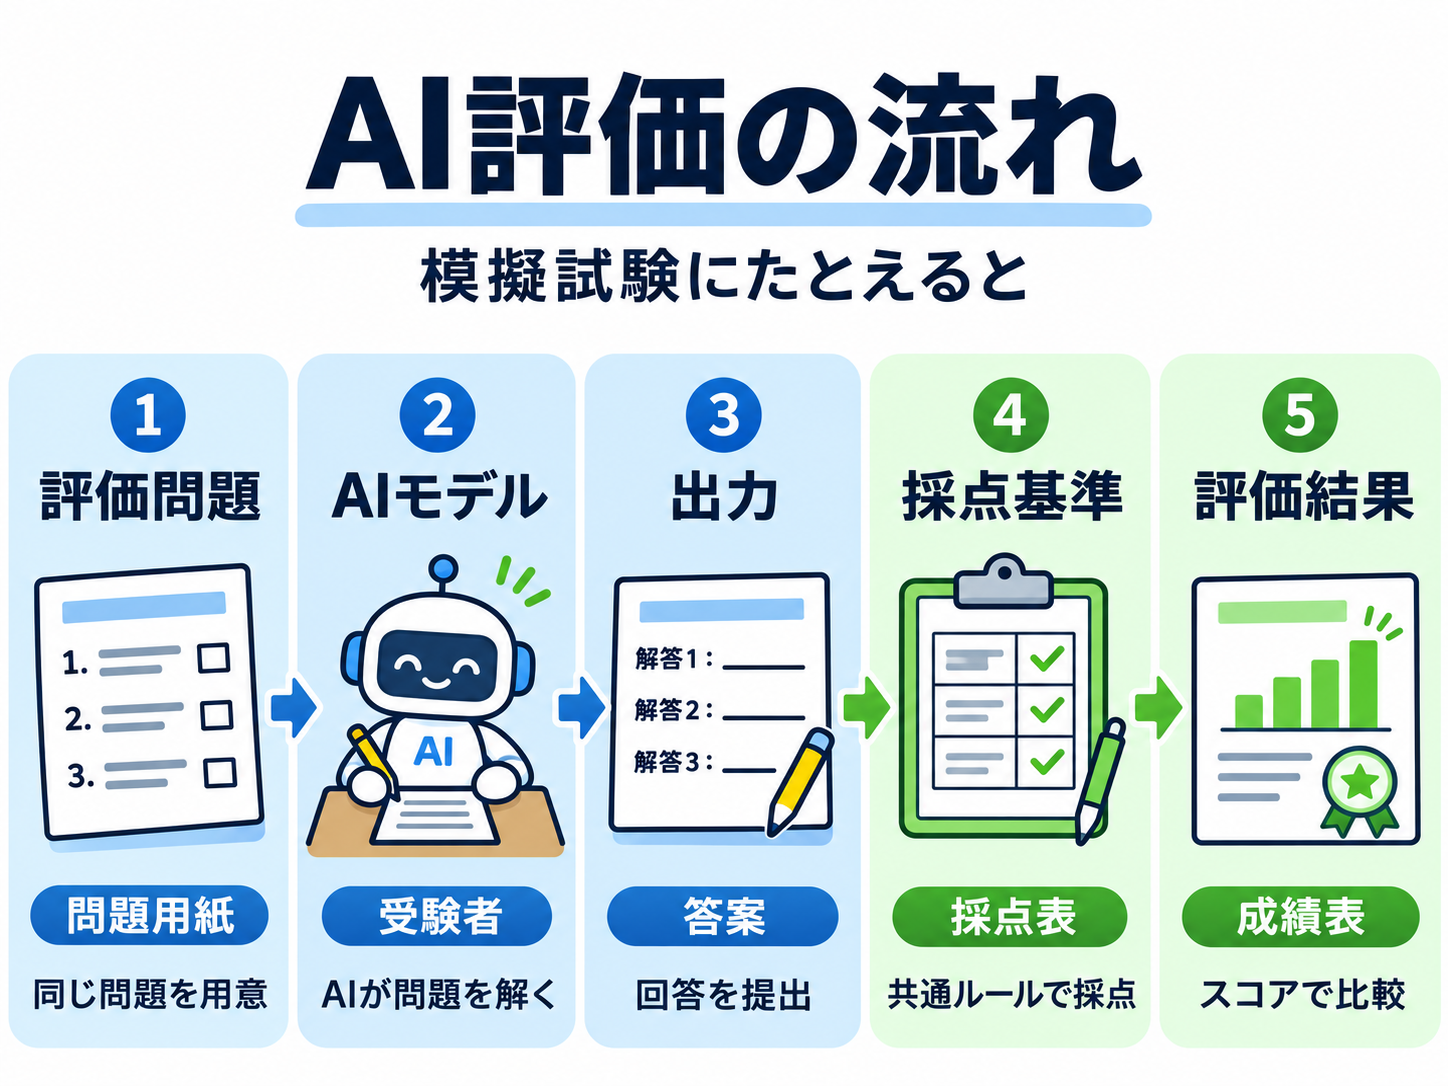
評価の流れは、学校の模擬試験に置き換えると理解しやすくなります。受験者に当たるのがAIモデル、問題用紙に当たるのが評価用の入力、答案に当たるのがAIの出力です。そして、採点基準が「何を良い回答とするか」を決めます。試験科目を決めずに受験者の優劣を語れないのと同じで、評価でも目的と基準が欠かせません。
教師あり機械学習のモデルでは、通常、検証用データやテスト用データと照らして性能を判断します。これに対して大規模言語モデルでは、品質だけでなく安全性も含む、より幅広い評価が行われると説明されています(出典: Google for Developers)。文章には唯一の正解がない場合も多いため、答え合わせだけでは十分でない場面があるからです。
架空の例として、「会議の日程変更を伝えるメールを作ってください。新しい日時、場所、返信期限を含めてください」と入力するとします。この評価では、文章が流暢かどうかだけでなく、指定した三つの情報が入っているか、存在しない事情を書き足していないか、相手に失礼な表現がないかを確認できます。採点項目を先に決めておけば、「なんとなく良い」という印象に引っ張られにくくなります。
問題の選び方にも注意が必要です。普段は短い依頼文を扱うのに、評価では長い専門文書しか使わなければ、実際の用途とのずれが生じます。反対に、簡単な問題だけを並べれば、難しい依頼での弱点を見落とすかもしれません。これは、漢字の読みだけを試して「国語全般が得意です」と判断するようなものです。
評価結果を読むときは、モデル、問題、採点基準の三つをセットで確認します。点数はモデルだけの性質ではなく、「どの問題を、どの基準で採点したか」によって意味が変わります。試験名や評価条件が分からない数字は、用途を選ぶ材料としては不足していると考えたほうが安全でしょう。
自動評価と人による評価の役割分担
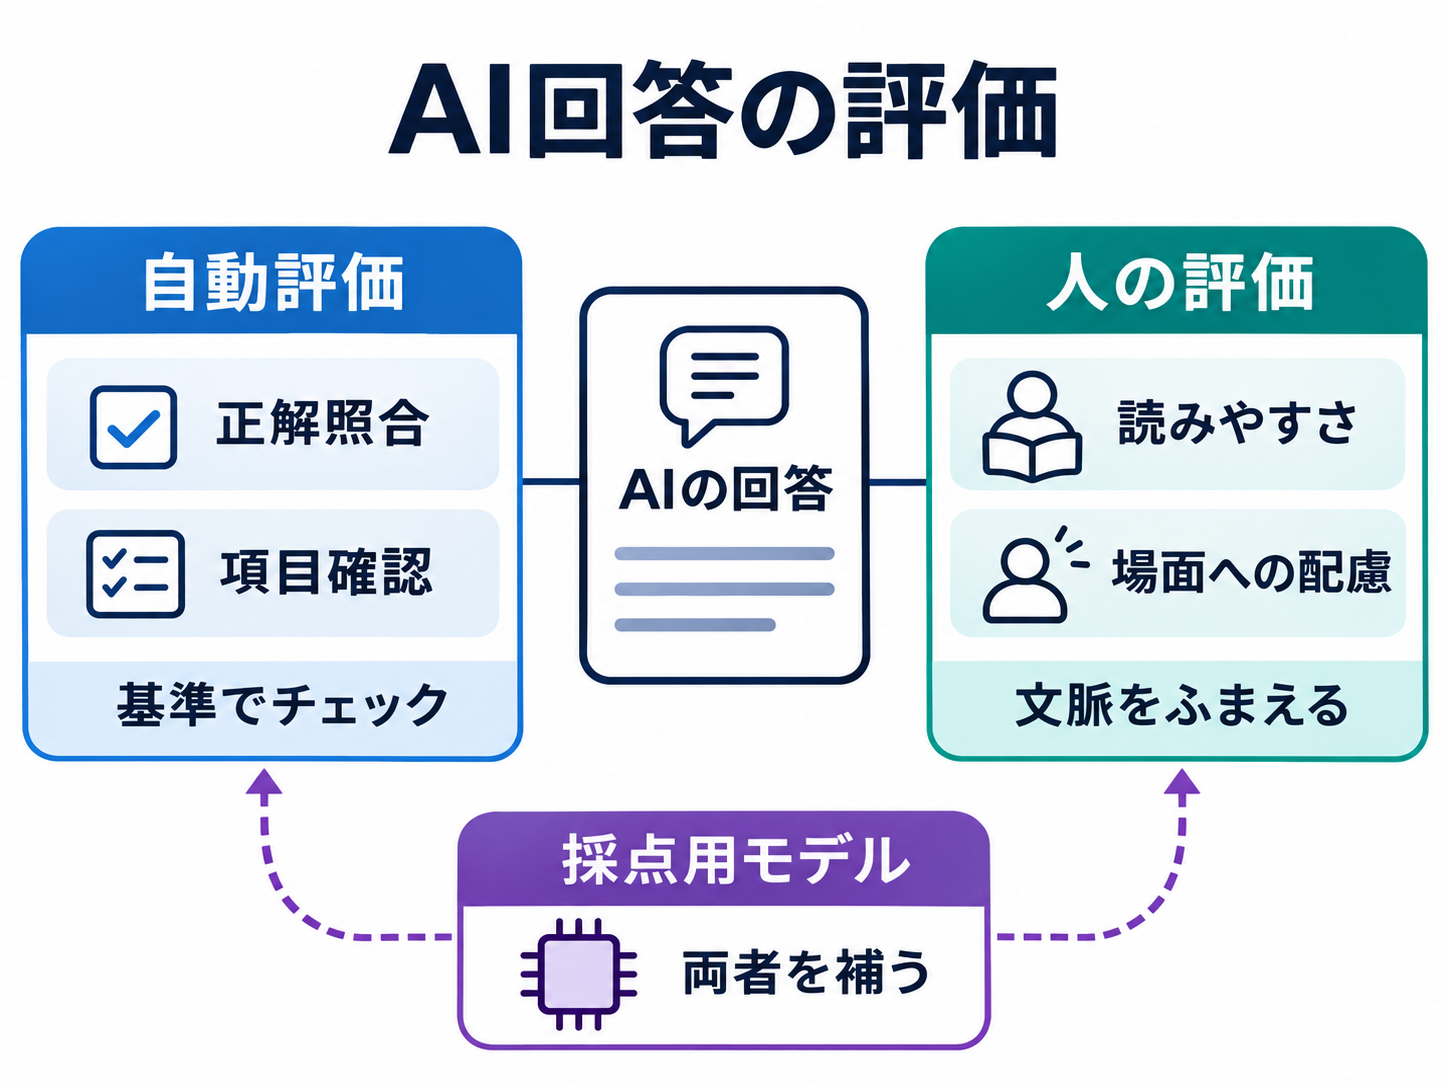
採点方法は、大きく自動評価と人による評価に分けて考えられます。Googleの機械学習用語集では、自動評価はソフトウェアを使ってモデルの出力品質を判定することと説明されています。答えが比較的明確なら、プログラムで模範解答と照合できます。複雑で正解が一つではない出力には、別の機械学習モデルが採点役を担う場合もあるとされています(出典: Google for Developers)。
| 評価方法 | 向いている確認 | 気を付けたい点 |
| --- | --- | --- |
| 自動評価 | 正解との一致や指定項目の有無 | 基準にない良さや問題を拾えない場合がある |
| 人による評価 | 読みやすさや配慮など文脈を伴う判断 | 判断の個人差を抑える基準が必要になる |
| 採点用モデルによる評価 | 正解が一つでない回答の反復確認 | 採点用モデルの判断も点検対象になる |
たとえば、架空の確認作業として、「回答に新しい開催日が含まれているか」は機械的に調べやすい項目です。しかし、「不安を感じている顧客に対して、説明が冷たく見えないか」は、単語の有無だけでは判断しにくいでしょう。人が実際に読み、場面に合っているかを確かめる意味があります。逆に、百件の回答すべてについて、日付が入っているかを人が目視する方法は、見落としが起きないとは限りません。役割を分ける発想が役立ちます。
用語集には、人の評価で作られたデータを学んで人の判断をまねる「autorater」という採点用モデルも紹介されています。これは人による評価と自動評価を組み合わせた仕組みとされ、評価する作業に合わせて調整されたものが望ましいと説明されています(出典: Google for Developers)。ただし、採点役がAIだからといって、その結果が自動的に正しくなるわけではありません。何を高く評価し、何を見落とす可能性があるかを確かめる必要があります。
どちらか一方を万能と考えるより、確認したい内容に合わせて選ぶのが現実的です。正誤が明確な項目は自動で数え、意味や印象に関わる項目は人が読むという組み合わせが考えられます。これは導入手順の断定ではなく、評価方法を整理するための一例です。実際の運用では、扱う情報の重要度や、誤りが生じた場合の影響も踏まえて決めることになります。
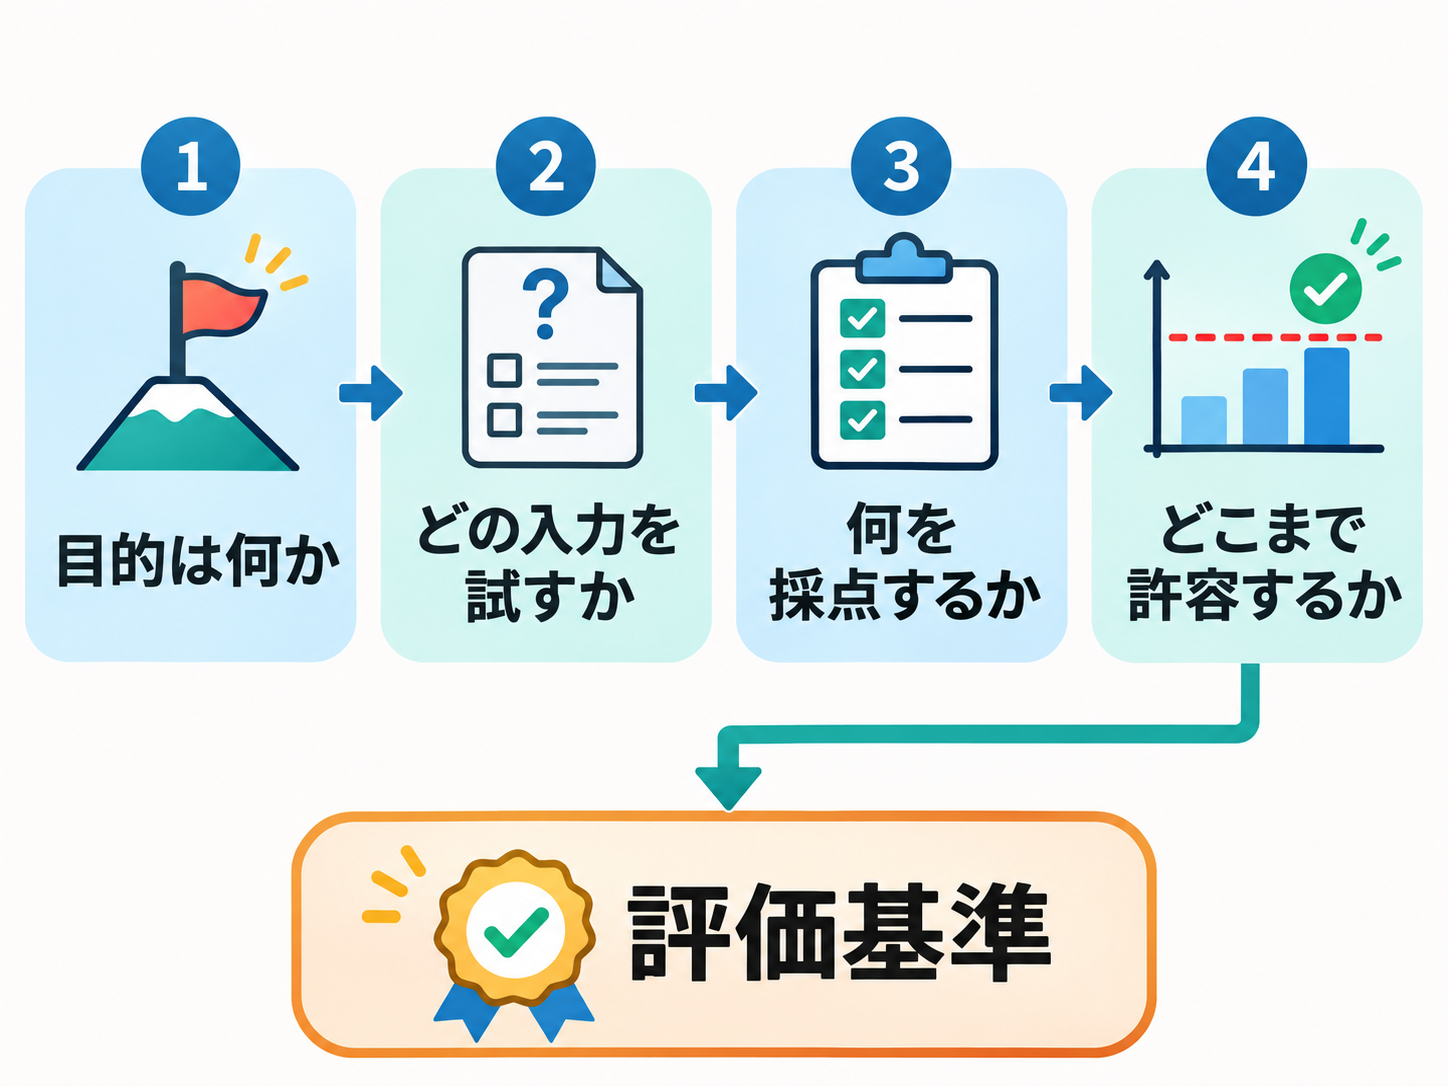
良い評価を作る四つの問い
自分の用途でAIを確かめたい場合、専門的な試験設備がなくても、評価の考え方は使えます。出発点になるのは、「誰が、どんな場面で、何を頼み、どの状態なら役に立つのか」という整理です。評価用の質問をたくさん集める前に、合格の意味を言葉にしておくほうが迷いにくくなります。
一つ目の問いは「目的は何か」です。架空の例として、地域の催しを知らせる文章を作るなら、文学的な美しさより、日時や会場を誤らずに記載することが優先されるかもしれません。二つ目は「どの入力を試すか」です。情報がすべてそろった依頼だけでなく、会場名が抜けている依頼も例に含めれば、不明点を勝手に補わないかを確かめられます。ここで挙げた設計は提案であり、特定製品の評価手順ではありません。
三つ目は「何を採点するか」です。候補には、指定事項の反映、事実との一致、読みやすさ、不要な情報の少なさなどがあります。ただし、何でも盛り込むと判断がぼやけます。失敗したときに困る項目から選ぶとよいでしょう。医療や契約など判断の影響が大きい用途では、一般的な文章作成と同じ感覚で合否を決めず、専門家による確認や組織のルールが必要になります。
四つ目は「どこまでなら許容できるか」です。すべての項目を満たす回答だけを合格にするのか、軽微な言い換えは認めるのかを決めます。成功した出力数を全出力数で割る「成功率」は、計算問題のように成否を検証しやすい作業で特に使いやすい指標として紹介されています(出典: Google for Developers)。しかし、「成功」を定義しなければ数字は作れません。
評価問題には、日常的な依頼だけでなく、起こると困る例も少量含めると弱点を見つけやすくなります。たとえば、元資料にない日付の推測を求める入力や、互いに矛盾する条件を含む入力です。ここでも目的はAIを意地悪に困らせることではありません。実際の利用時に人がどこを確認すべきか、事前に知るための点検です。
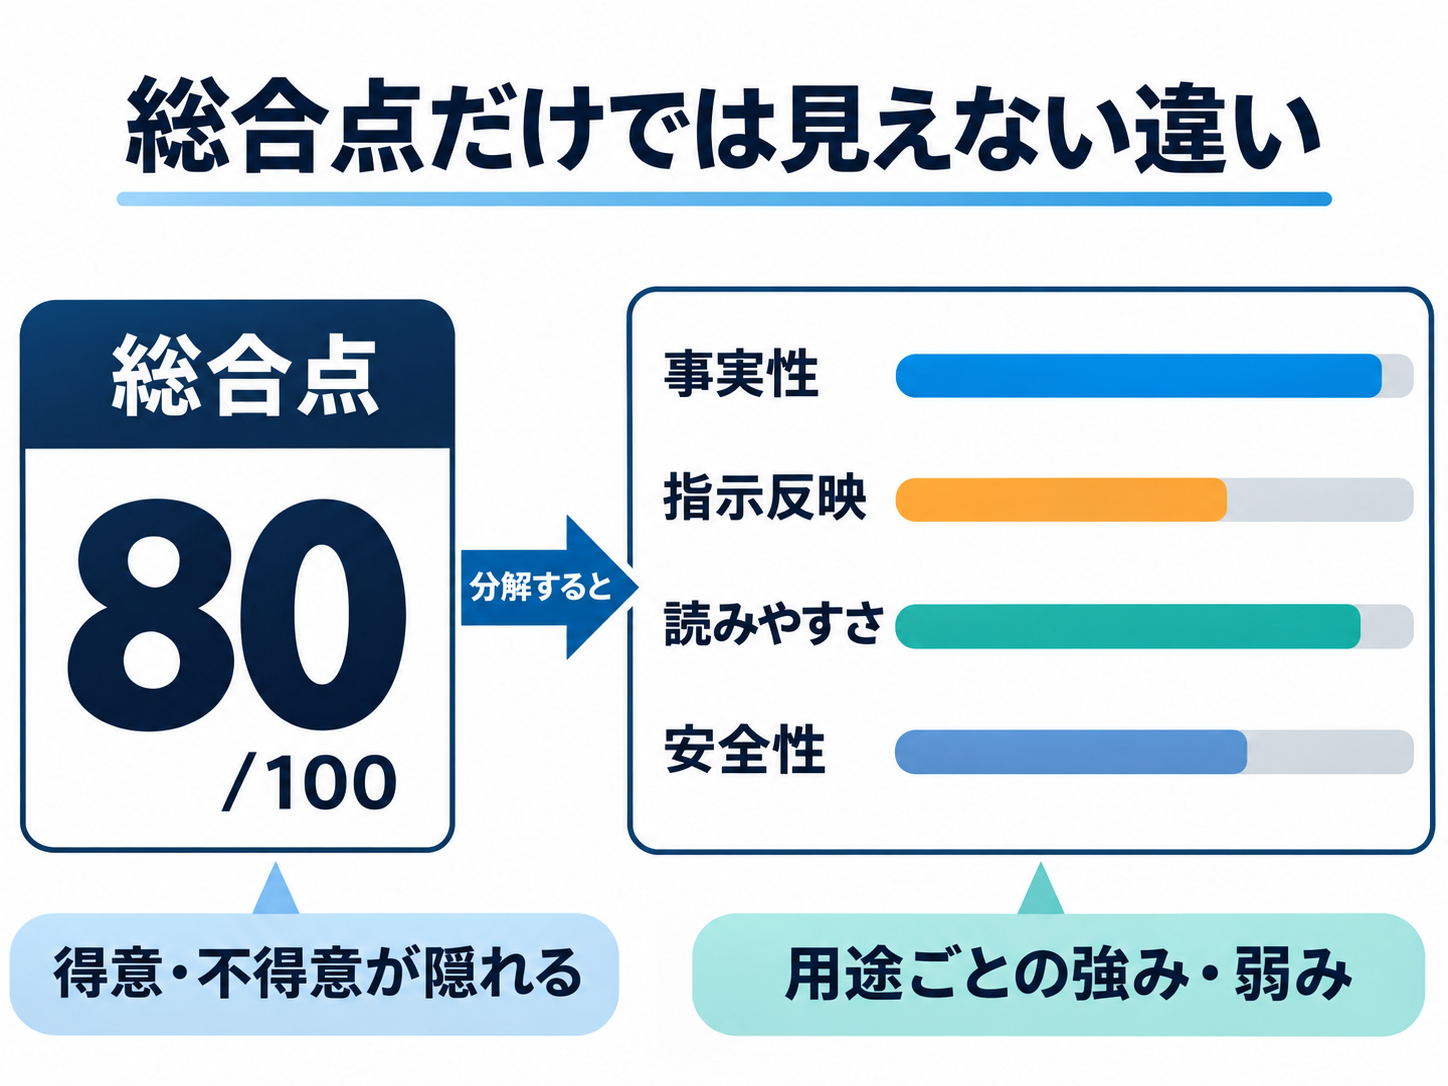
一つの点数がAIの万能さを示さない理由
評価結果が「90点」と示されると、別のAIの「85点」より優れているように見えます。しかし、試験内容が違えば単純には比べられません。計算問題の正解率、文章の読みやすさ、安全性への配慮は、それぞれ異なる側面です。合計点だけを見れば、どこが得意で、どこに注意が必要なのかが隠れてしまいます。
Googleの用語集では、事実性は現実に基づく出力の性質であり、単一の評価指標そのものではなく概念だと説明されています。食塩の化学式を尋ねるような問いでは事実性が重視されますが、架空の詩を求める問いでは創造性が求められ、現実の出来事である必要はありません(出典: Google for Developers)。同じ回答でも、目的が変われば良し悪しの基準が変わる例です。
仕事で文章を作る場面でも、評価軸の衝突が起こります。短くまとめることを優先すれば、細かな条件が省かれるかもしれません。情報を漏れなく書かせれば、読み手にとって長すぎる文章になる可能性があります。どちらが正しいかではなく、用途に応じて優先順位を決める必要があります。社内メモと顧客への正式な案内を、同じ採点基準で評価するのは適切とは限りません。
ランキングを見るときは、少なくとも「何を試した点数か」「誰が、または何が採点したか」「自分の用途に近い問題か」を確認するとよいでしょう。数字の差が小さい場合、その差が実際の作業で意味を持つかも別の問題です。提供された資料だけでは、特定のベンチマークの点差が利用時にどの程度の差になるかまでは判断できません。
モデル選びでは、総合点の高いものを探すより、自分が避けたい失敗を具体化するほうが役立つ場合があります。固有名詞を勝手に補う、指示した形式を外す、元資料と異なる数字を書くといった失敗例を先に決めておけば、結果を実務に結び付けて読めます。高得点は安心材料の一つですが、あらゆる入力への正しさを保証するものではありません。
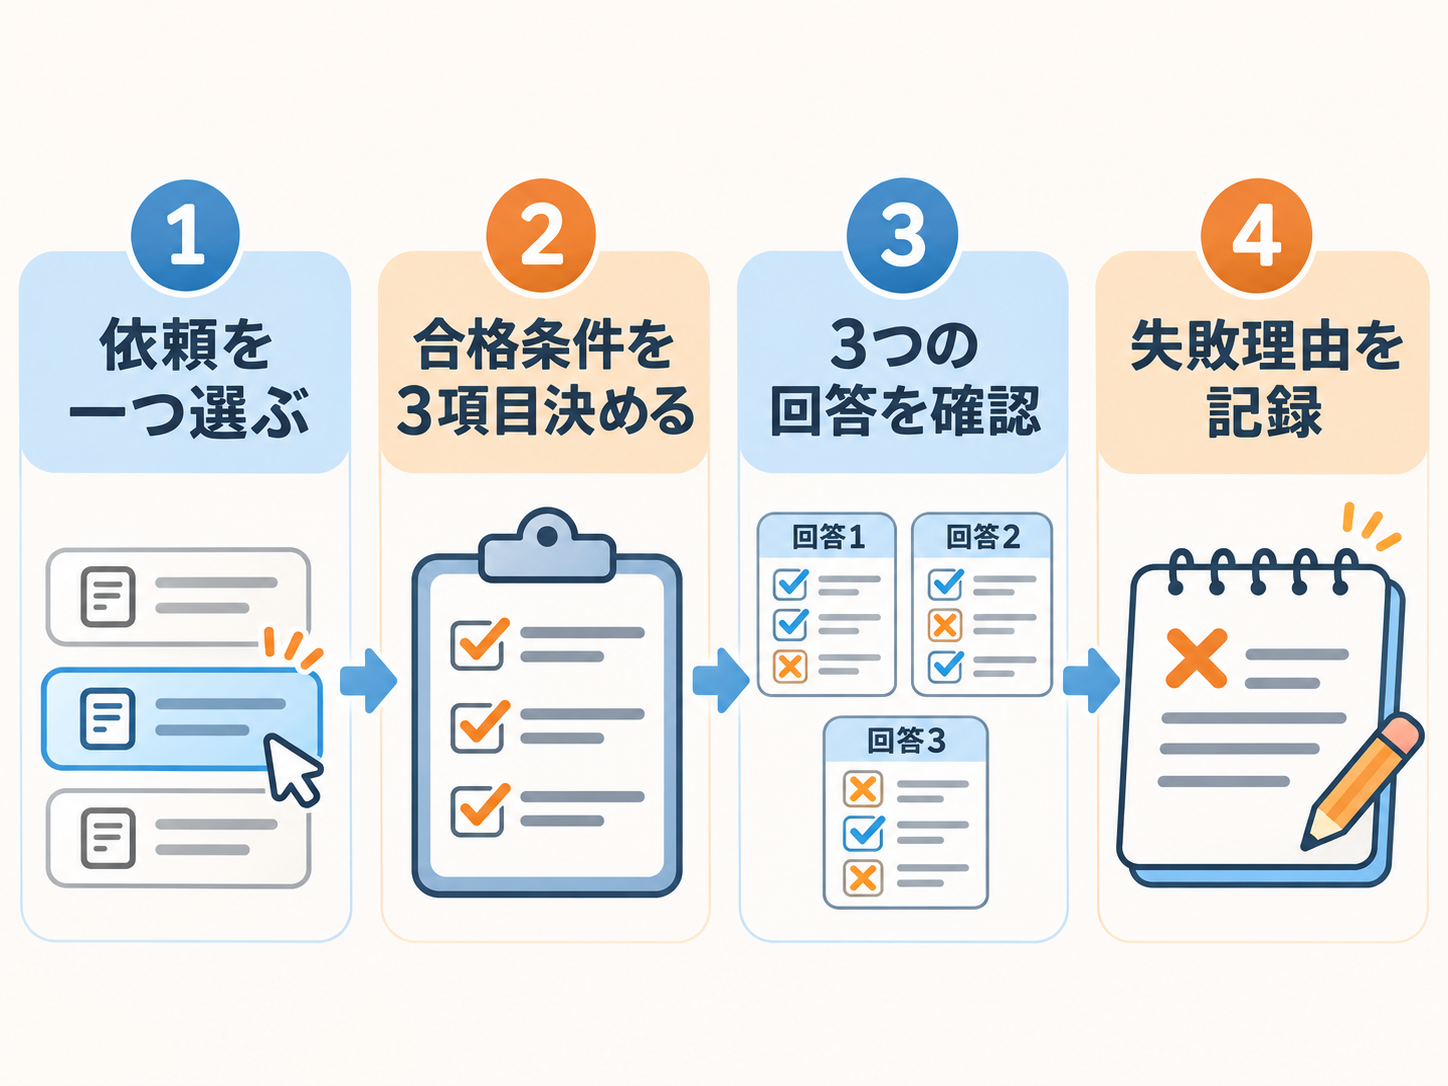
明日からできる「三つの回答」の見比べ方
評価を知ったあとに取れる小さな一歩は、普段の依頼を一件だけ選び、合格条件を三つ書き出すことです。専用ツールや有料契約を前提にする必要はありません。現在使えるAIサービスがあるなら、同じ目的の回答を複数確認し、自分の基準で見比べます。利用していない場合でも、過去に人が作成した文章を題材に採点項目を考えるだけで、評価の感覚をつかめます。
架空の例として、「町内会の清掃日を知らせる短い案内文」を考えます。合格条件は、日時と集合場所が元情報どおりであること、持ち物が抜けていないこと、初めて参加する人にも分かる表現であること、と設定できます。AIに依頼する場合は、回答を三つ用意して比較する方法が考えられます。ただし、これは評価の練習としての提案であり、三回答あれば性能を確定できるという意味ではありません。
見比べる際は、「好き・嫌い」だけで終わらせず、各条件を満たしたかを記録します。判断に迷う表現があれば、その理由も短く残します。たとえば「場所は合っているが、元情報にない駐車場の案内が追加されている」と書けば、次回から確認すべき点が明確になります。回答の書き直しを頼む場合も、「もっと良くしてください」ではなく、「元情報にない内容を追加せず、日時と集合場所を冒頭に置いてください」と条件を伝えやすくなるでしょう。
生成AIの開発では、生成した出力を評価し、その結果を踏まえて調整を重ねる段階があるとIBMは説明しています(出典: IBM)。利用者が同じ調整作業を行う必要はありませんが、「一度の回答で性能を決めず、目的に沿って出力を確かめる」という見方は日常の利用にも応用できます。
AIを選ぶときも使うときも、最初に探すべきなのは万能な点数ではありません。「自分の作業では何ができれば合格で、何を間違えると困るのか」という基準です。明日は身近な文章を一つ選び、合格条件を三項目だけ書いてみてください。その三項目が、AIの評価結果や製品紹介を自分の目で読むための物差しになります。
参考情報
- Machine Learning Glossary: Generative AI(2026年11月3日取得。提供資料には公開日の記載なし)
- What Is Artificial Intelligence (AI)?(2024年8月9日公開、2026年10月2日更新、2026年11月3日取得)