
2026/11/03
AIニュース
Google「Dreambeans」がインド進出、プロンプト不要の生成AIが問う利便性と個人データの境界
米国外で初めてインドを選んだGoogleの狙い
Googleは2026年11月2日、実験的な生成AIアプリ「Dreambeans」をインドで提供開始しました。米国外では初の展開となり、AndroidとiOSの両方で利用できます。英語に加えて、ヒンディー語、パンジャブ語、タミル語、テルグ語、ベンガル語など、インドで使われる13言語に対応しました。米国で18歳以上の対象ユーザー全体へ開放してから、まだ2カ月も経たない時期の海外進出です。
Googleがインドを選んだ理由は、市場の人口規模だけではありません。プロダクトマネージャーのGozde Oznur氏によると、インドのユーザーから利用を望む声が多く、Gemini、Gmail、Googleフォトを横断して使う人の重なりも大きかったといいます。Dreambeansは複数のGoogleサービスに蓄積された情報を使うため、単一サービスの利用者数よりも、サービスをまたいで日常的に利用する人がどれだけいるかが展開先を決める条件になります。
世界第2位のインターネット市場であるインドは、利用者の広がりを試せる場所であると同時に、多言語社会に合わせた設計や個人データへの信頼を検証する場でもあります。今回の中心的な論点は、生成AIの性能競争というより、入力を求めず先回りしてコンテンツを提示するサービスを、どこまで利用者が受け入れるかという点です。Googleの豊富なサービス群は強みになりますが、同じ仕組みがプライバシーへの懸念にも直結します。
入力を待たずに物語を作る仕組み
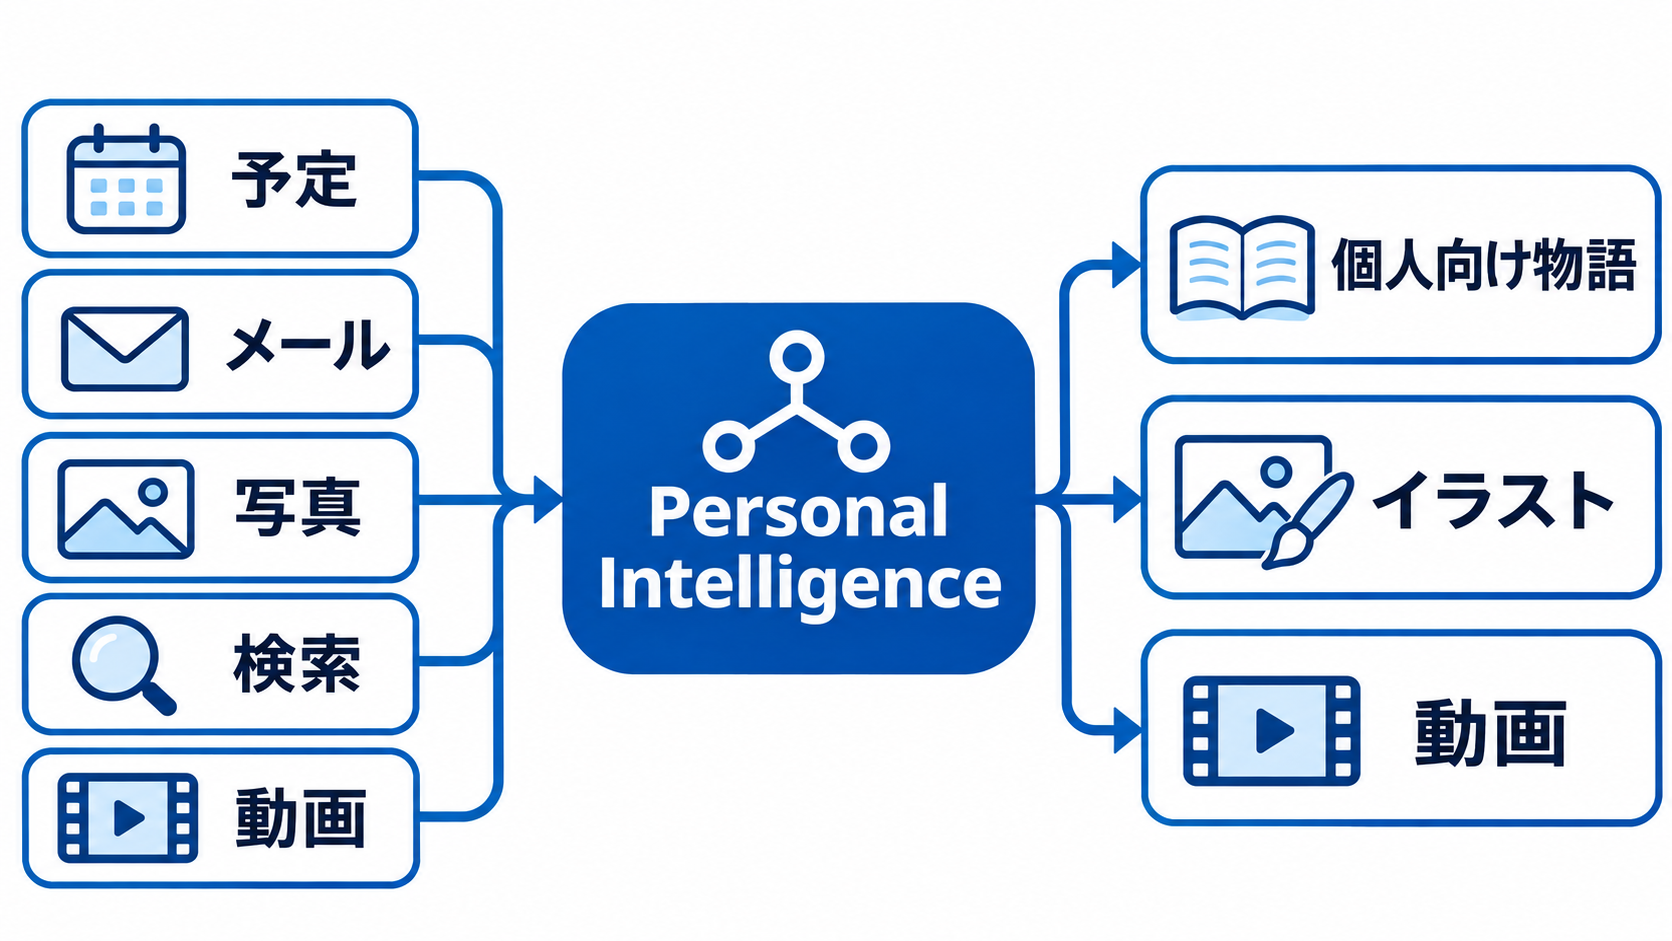
Dreambeansの特徴は、利用者が毎回プロンプトを書く必要がないことです。接続を許可されたGoogleカレンダー、Gemini、Gmail、Googleフォト、Google検索、YouTubeの情報を参照し、関心事や日常生活を題材にしたイラスト付きの物語を能動的に生成します。一般的な対話型AIが質問や指示への回答を起点とするのに対し、Dreambeansではサービス側が題材を見つけ、利用者へ提示します。
たとえば、予定、写真、検索履歴、視聴傾向といった異なる種類の情報を結び付ければ、単独のデータだけでは作りにくい個人的な内容を構成できます。ただし、具体的にどの情報がどの物語へ反映されるか、生成時に各サービスのデータがどのように評価されるかについては、現時点で詳しい技術仕様が示されていません。利用者から見れば、便利さを感じるためにも、思いがけない情報が現れた際に理由を理解するためにも、参照範囲の分かりやすさが欠かせないでしょう。
提供当初の物語は静止画によるものでしたが、Googleは一部の物語に、動画生成モデル「Veo」で画像を動かす機能を追加しました。これによりDreambeansは、文章を生成するだけのツールではなく、利用者自身を題材にした視覚的なコンテンツ体験へ近づいています。プロンプト入力の手間を減らせる反面、AIが利用者の関心や人生の出来事を正しく解釈できるとは限りません。先回り型の設計では、生成品質だけでなく、題材の選び方そのものが体験の評価を左右します。
米国の利用データが示す初動と定着の差
市場調査会社Sensor Towerの推計では、Dreambeansは2026年6月の登場から米国で約5万5,000件ダウンロードされました。その約63%は、18歳以上の対象ユーザー全体に公開された9月に集中しています。公開範囲の拡大によって一時的に利用が増えた一方、10月のダウンロード数は前月比84%減の約5,500件でした。認知を獲得した後も利用への関心を保てるかが、今後の課題として浮かびます。
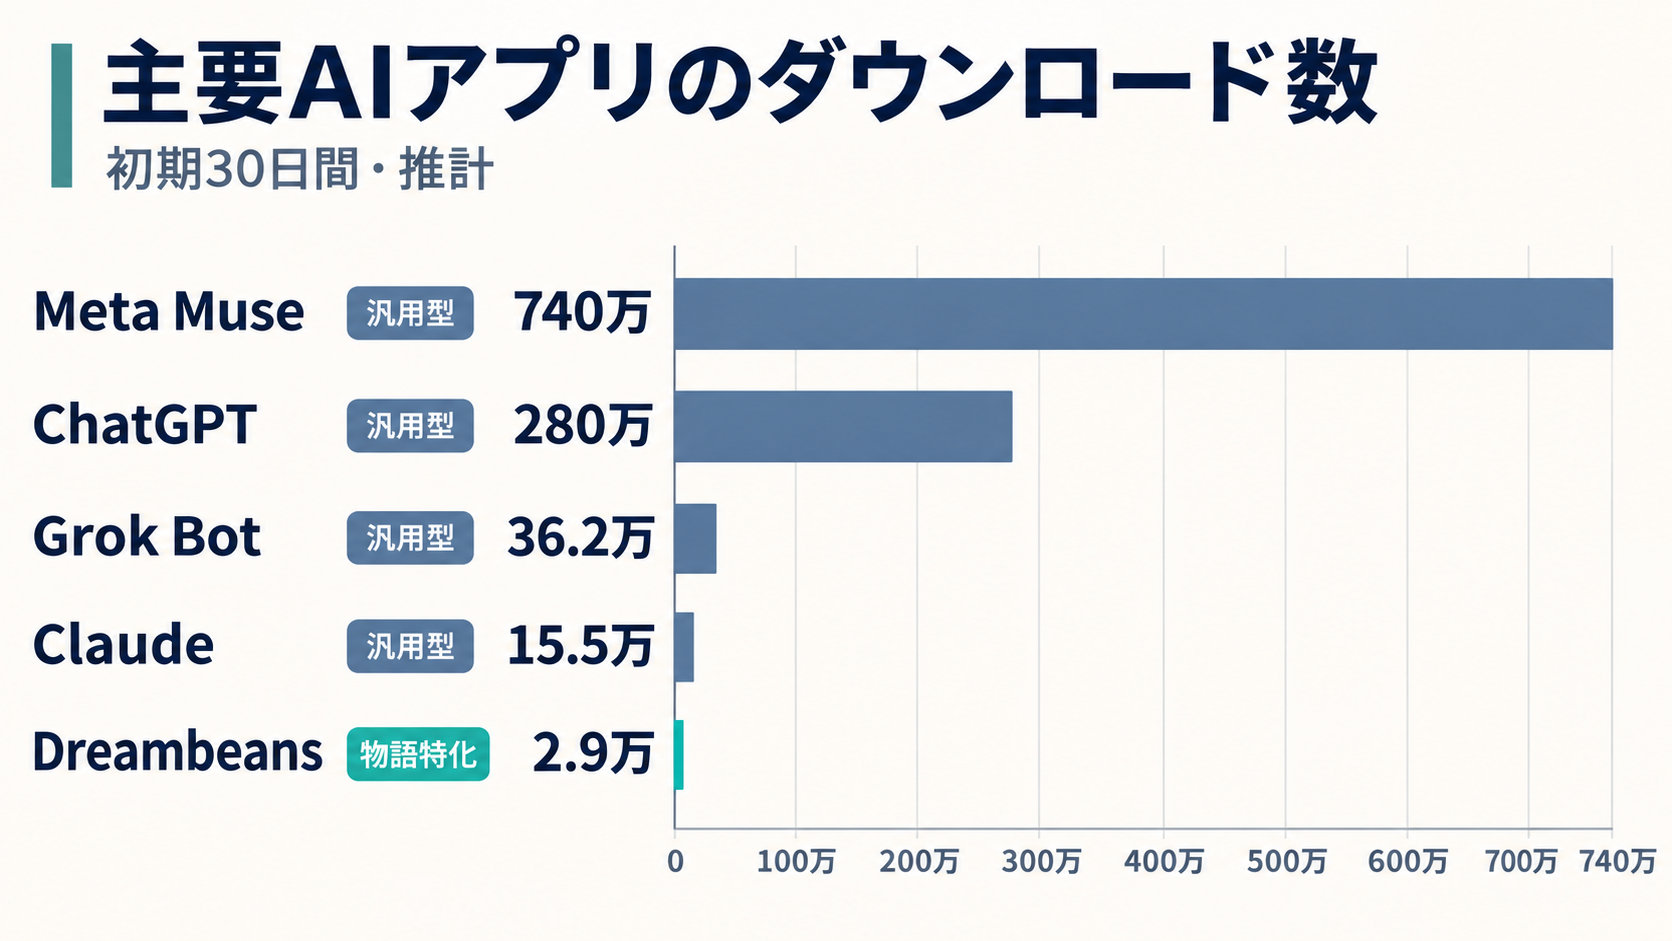
対象ユーザー全体への開放後30日間に限ると、Dreambeansは約2万9,000件でした。Sensor Towerが示した各サービスの提供開始後30日間の推計は、次の通りです。
| アプリ | 推計ダウンロード数 | 主な位置付け |
| --- | --- | --- |
| Meta Muse | 740万件 | 汎用型AIアプリ |
| ChatGPT | 280万件 | 汎用型AIアプリ |
| Grok Bot | 36万2,000件 | 汎用型AIアプリ |
| Claude | 15万5,000件 | 汎用型AIアプリ |
| Dreambeans | 2万9,000件 | 個人向け物語生成 |
数字だけを見れば大きな差がありますが、Dreambeansは幅広い質問に答える汎用AIではなく、個人向けの物語生成に用途を絞っています。利用目的も提供条件も異なるため、この比較をそのまま製品の優劣と捉えることはできません。それでも、プロンプト不要という新しい体験が、汎用AIと同じ規模で直ちに受け入れられたわけではないことは読み取れます。
企業が同様の先回り型AIを企画する場合、初回利用数だけでは判断材料が不足します。生成された内容を利用者が継続して閲覧するか、不要な題材を調整した後も使い続けるか、接続するデータを増やしてよいと感じるかといった指標を併せて見る必要があります。Dreambeansの米国での推移は、配布対象を広げることと、日常の習慣として定着させることが別の課題であると示唆しています。
13言語対応でも残るインド特有の壁
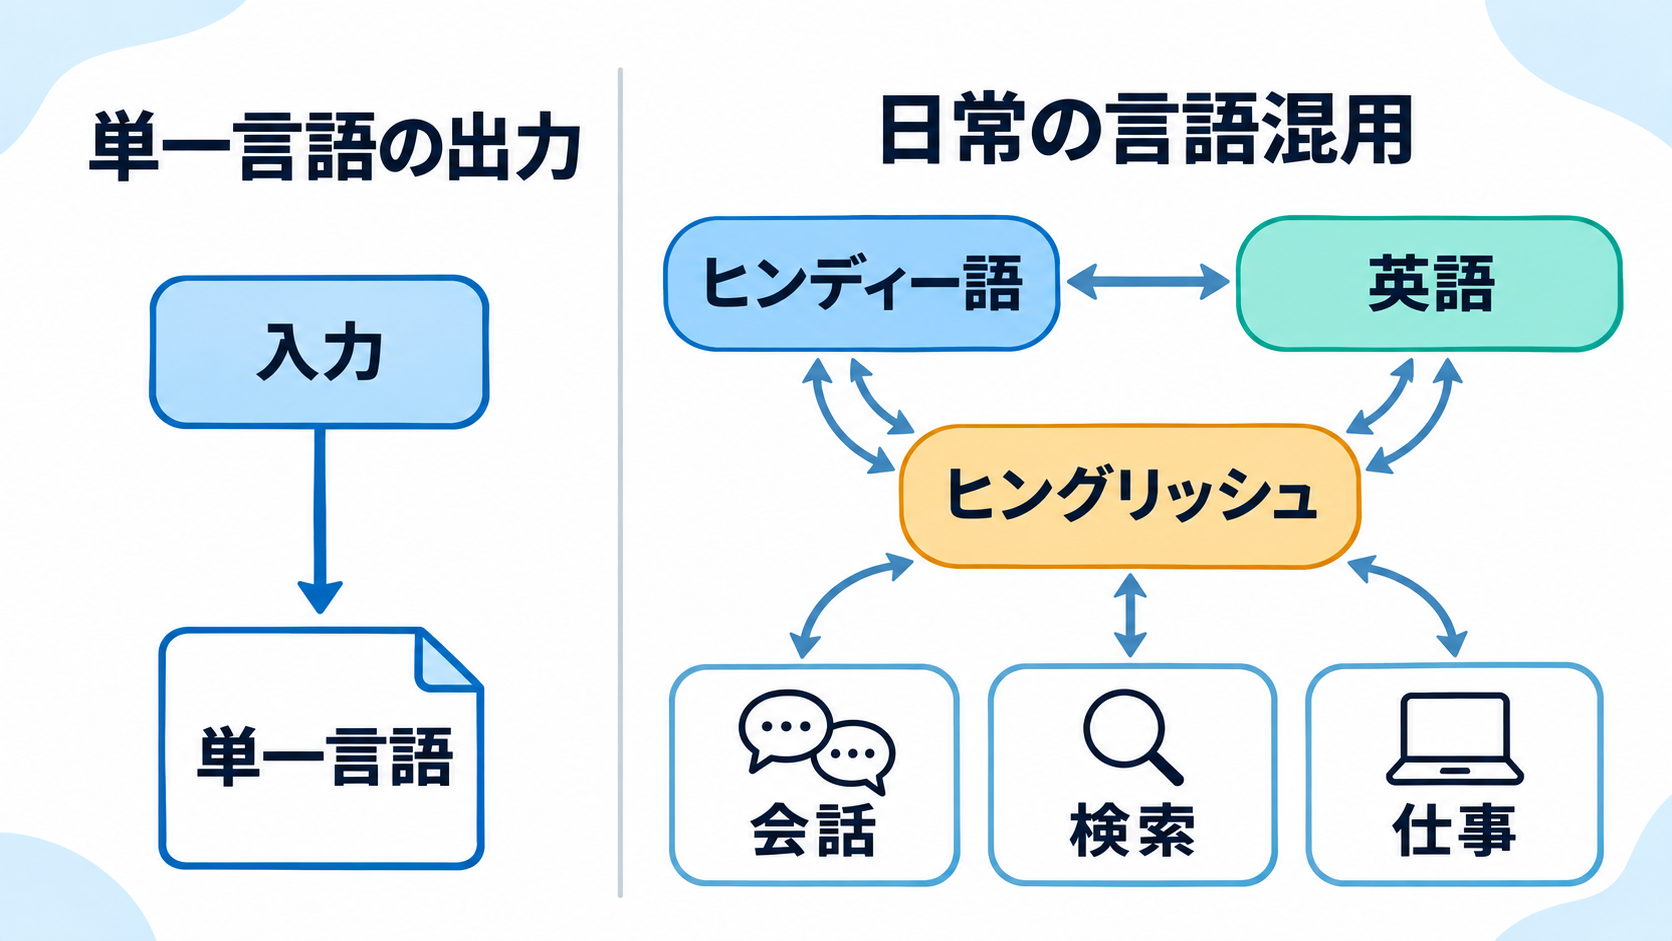
インド版Dreambeansは、広く使われている複数の地域言語に対応しています。しかし、生成する物語の言語は一度に一つしか選べません。接続したGoogleサービスに複数言語の情報が含まれていても、それらを読み取って単一言語の物語を作ることはできる一方、複数言語を混ぜた出力には対応していないとOznur氏は説明しています。
この制限は、日常会話で言語を切り替える人が多いインドでは目立ちやすくなります。代表例が、ヒンディー語と英語を組み合わせる「ヒングリッシュ」です。家族との会話、仕事、検索、動画視聴など、場面によって使う言語が変わる利用者にとって、出力言語を一つに固定すると、自分らしさを再現した物語にならない可能性があります。単語を翻訳できることと、実際の言語習慣へ適応することは同じではありません。
Dreambeansのインド展開は、多言語対応を対応言語数だけで評価することの難しさも映しています。個人向け生成AIでは、敬称、家族の呼び方、固有名詞の表記、会話中の言語切り替えなども体験を左右します。今回確認できる制約からは、AIが複数言語のデータを処理できても、その人が普段使う自然な表現として組み直せるとは限らないことが分かります。
日本企業にとっても無関係ではありません。日本語の文章に英語の製品名や社内用語が頻繁に混ざる業務では、単純な単一言語出力が不自然になる場合があります。海外展開を想定するなら、翻訳精度の評価に加え、利用者が実際に言語を使い分ける状況をテストへ含める必要があるでしょう。インドでの反応は、生成AIのローカライズをUIの翻訳より広い設計課題として捉える材料になります。
Personal Intelligenceとデータ接続の選択権
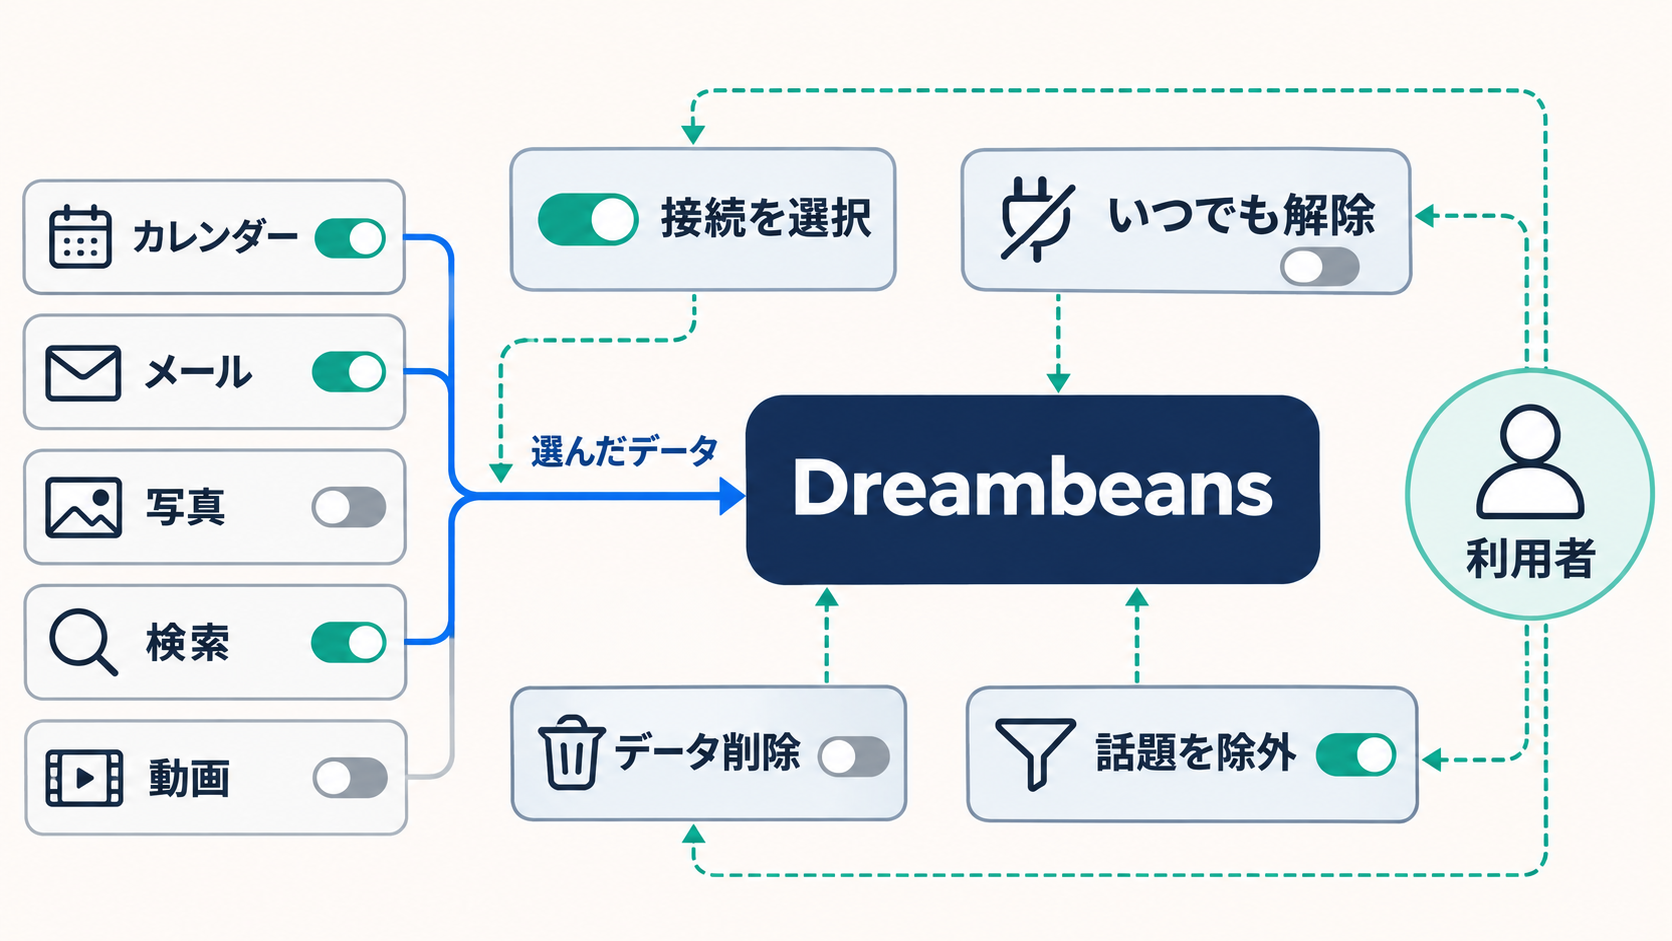
Dreambeansは、Googleの「Personal Intelligence」と呼ばれる技術を利用し、接続されたサービスから個人向けの内容を組み立てます。カレンダーやメール、写真には、予定、交友関係、過去の出来事など、検索履歴や動画の好みとは異なる性質の情報が含まれます。物語を個別化する材料が豊富になるほど内容は利用者に近づきますが、娯楽的なコンテンツを得るためにどこまでAIへ情報を渡すかという判断も必要になります。
Googleの説明では、利用者はDreambeansへ接続するサービスを自分で選び、いつでも解除できます。アプリ内からDreambeansのデータを削除することも可能です。Oznur氏は、接続元のGoogleサービスで削除された情報についても、Dreambeansのパーソナライズ機構から取り除かれると述べています。また、仕事に関する情報など、扱ってほしくない題材を指定すれば、アプリは以後の物語を調整しようとします。
こうした操作手段があっても、接続時の同意だけで懸念がすべて解消するわけではありません。利用者が判断するには、サービスを接続すると何が参照対象になるのか、解除や削除によって何が変わるのか、望まない題材が現れた際にどこで設定できるのかを理解できる必要があります。設定画面の存在だけでなく、生成結果から制御方法へ迷わず移動できる設計が信頼に影響すると考えられます。
Dreambeansは個人用Gmailアカウントの保有者だけが利用でき、企業ユーザーには提供されていません。生成された物語もアカウント保有者本人だけに表示されます。そのため、現時点で企業向け製品として評価すべきサービスではありません。ただし、複数の業務データを結び付けてAIが先回りする仕組みを検討する企業にとって、データ接続をサービス単位で選べること、後から解除できること、生成してほしくない話題を指定できることは、設計上の参考になります。
忘れたい記憶まで提示する先回り型AIのリスク
プロンプトを入力して使うAIでは、少なくとも会話を始める題材は利用者が選べます。DreambeansはAI側から物語を提示するため、本人がその時点では見たくなかった写真や人物に触れる可能性があります。Oznur氏も、すでに亡くなった人を含む物語が生成される場合を認めています。懐かしい思い出になる人もいれば、予期しないタイミングで心理的な負担を感じる人もいるでしょう。
利用者は特定の題材を表示しないようDreambeansへ伝えられます。Oznur氏は、この仕組みをGoogleフォトで特定の思い出が現れる頻度を制限する機能になぞらえています。ただし、最初に不快な内容が表示されてから設定する方式では、利用者が一度は望まない体験に直面します。どの段階で意向を尋ねるか、制御内容をどれだけ細かく選べるかが、先回り型AIでは重い意味を持ちます。
感情に関わるリスクは、誤情報とは異なり、内容が事実であっても発生します。写真に写っている人物や過去の予定を正しく認識できたとしても、それを今日提示してよいとは限りません。AIの評価項目に正確性だけを置くと、この問題を見落としかねません。利用者が避けたい人物や時期、話題を管理できることに加え、表示後に簡単な操作で今後の生成へ反映できることが求められます。
社内向けAIでも同じ構造は起こり得ます。過去のメールや会議情報から提案を自動生成する場合、機密性だけでなく、人事上の出来事や終了した案件など、文脈上は提示を控えるべき情報があります。Dreambeansが直面する課題は消費者向けサービス特有のものに見えますが、データを横断して能動的に情報を出すAI全般に通じる論点です。
企業が先回り型AIを検討する際の判断軸
Googleは、Dreambeansを物語やおすすめの提示にとどめず、提案を実際の行動へつなげる方法を検討しています。具体的な機能や提供時期は明らかにされていませんが、閲覧するコンテンツから、利用者の次の操作を支援するサービスへ進む方向性が示されています。実現すれば便利さは増す半面、誤った推測や望まない提案が実際の行動へ影響するため、制御の必要性も高まります。
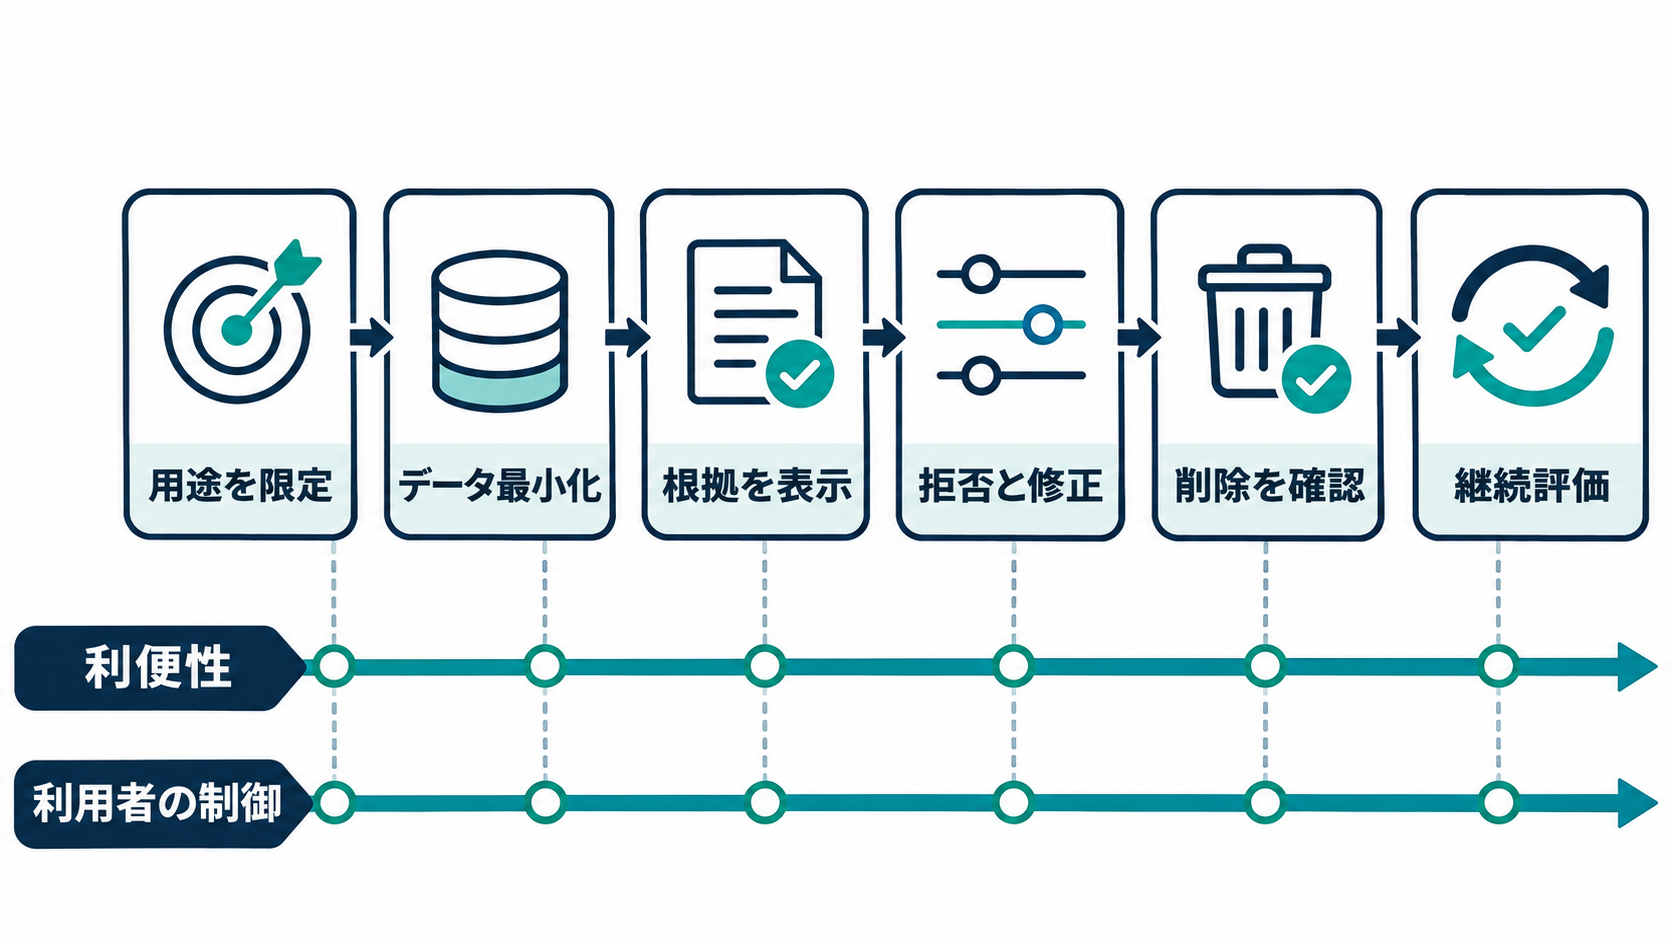
B2B領域で参考になるのは、Dreambeansそのものの導入可否ではなく、入力待ちのAIから能動的なAIへ移る際の設計条件です。企業が検証を始めるなら、どのデータを接続するかを一括で決めるのではなく、用途ごとに最小限の範囲を定める必要があります。提案の根拠を利用者が確認できることや、不要な話題をその場で除外できることも、業務上の信頼を保つ条件になるでしょう。
評価では、生成文章の品質だけに目を向けないことが大切です。提案が必要なタイミングで表示されたか、利用者の作業を中断しなかったか、修正や拒否の結果が次回へ反映されたかを確認する必要があります。多言語環境では、正式な対応言語に加え、製品名、略語、社内用語が混ざった入力と出力も試すべきです。情報を削除した後に提案へ残らないかという確認も欠かせません。
Dreambeansのインド展開は、豊富な個人データを持つ企業であっても、それだけで先回り型AIが定着するとは限らないことを示しています。利用者が価値を感じる提案、地域の言語習慣、データを渡す納得感、避けたい内容を管理する手段がそろって初めて、継続利用を検討できる体験になります。企業が次に取るべき一歩は、大規模なデータ接続ではなく、対象業務を一つに絞った検証です。参照するデータ、提案する内容、拒否と削除の手順を先に定義すれば、利便性とリスクを同じ条件で評価できます。