
2026/11/05
AIニュース
Together AI、推論を継続的に最適化する「Together Compiler」を発表――最大2.6倍の高速化と実運用の条件
この記事の要点
Together AIは、実際の利用状況に合わせて推論コードと並列化構成を継続的に最適化するTogether Compilerを発表しました。同社は最大2.6倍のTPSを報告していますが、改善幅は構成によって異なります。常駐エンジンによる検証の高速化と実トラフィックでの評価が特徴で、企業には自社の入力と品質基準を使った効果確認が求められます。
目次
一度きりの高速化から、利用状況に追随する推論基盤へ
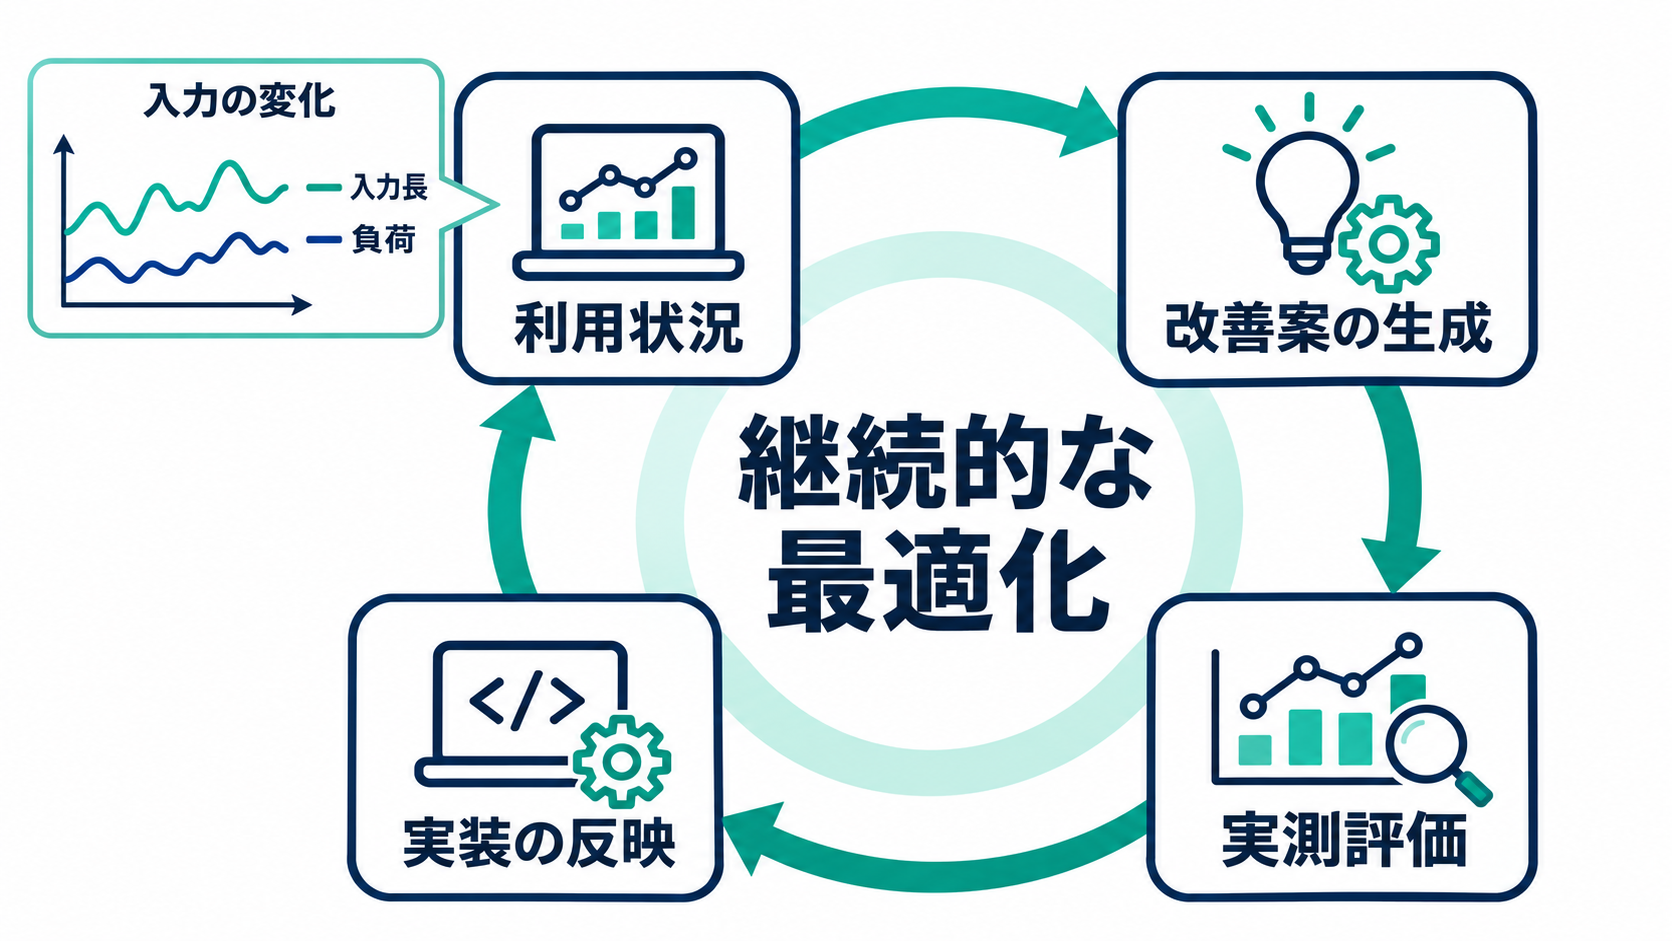
生成AIの推論環境を導入時に調整しても、利用者や入力の傾向が変われば、同じ設定が最適であり続けるとは限りません。Together AIが発表した「Together Compiler(TKCC)」は、この変化を前提にした最適化システムです。コードを変更するAIエージェントが推論処理を繰り返し書き換え、測定で効果を確認した実装を配信エンジンに反映します。同社によると、すでに複数のサーバーレスエンドポイントで稼働しています。
開発者が与えるのは、サーバーの起動コマンド、処理するリクエストの傾向を示すトラフィックプロファイル、ハードウェア構成です。エージェントはそれらを手掛かりに、モデルの出力を計算する「フォワードパス」を高速化します。候補を提案するだけでなく、実際の配信エンジンで性能を測り、良い実装を選ぶところまでを一つの循環として扱う点が特徴です。
Together AIは、公開されているInferenceXの最良構成に対し、条件によって最大2.6倍のTPSを達成したと報告しています。TPSは1秒当たりに処理・生成するトークン数を示す指標です。ただし、すべての構成で同程度に速くなったわけではありません。改善が約4%にとどまる組み合わせもあり、数値は同社の自己申告です。
企業にとっての論点は、最大倍率そのものよりも、運用開始後に最適化を続ける仕組みを持てるかどうかでしょう。問い合わせの長文化や顧客構成の変化に合わせて推論処理を見直せれば、導入時の性能評価と本番環境の実態が離れていく問題に対応しやすくなります。ただし、その効果はモデル、機器、実際の入力によって確かめる必要があります。
ランダムな入力では、本番の遅さを見落とす可能性
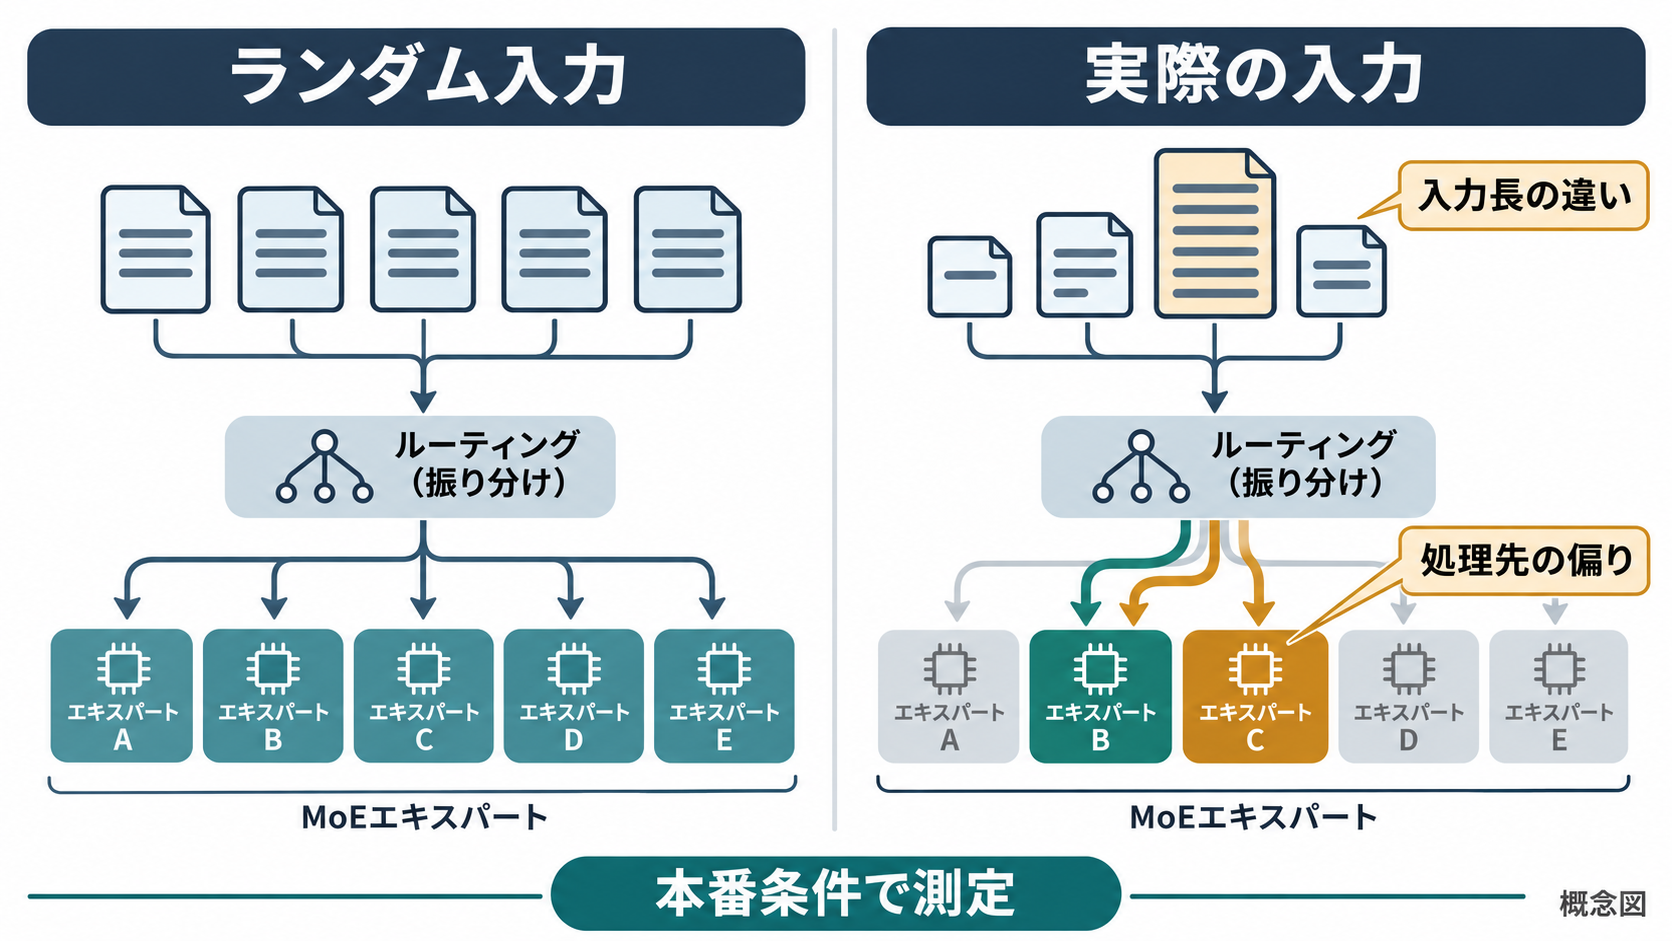
Together AIが継続的な最適化を必要とする理由は、実際の入力が短期間でも変わるためです。同社の報告では、ある国からのプロンプト長が約9万7,000トークンだったのに対し、ほかの地域では約7万トークンでした。別の顧客では、入力長のP90が3日間で1万8,000トークンから3万3,000トークンへ増えています。P90は分布の90パーセンタイルを指し、この場合は入力の90%がその長さ以下に収まる境界です。
長い入力が増えると、モデルのどの処理に時間がかかるかも変わり得ます。平均的な長さだけを使った試験では、一部の長いリクエストが引き起こす負荷を捉えきれません。企業の文書検索や長文分析に当てはめるなら、日常的な短い質問と、大量の資料を渡す依頼を同じ代表値だけで評価しないことが実務上の検討点になります。
入力内容そのものも性能に関係します。MoEは、複数の専門的な処理部分である「エキスパート」から一部を選んで計算する仕組みです。Together AIによると、ランダムに生成した入力では、実トラフィックより13〜38%多くのエキスパートが動作しました。試験データの作り方によって、計算や通信の負荷が本番とは異なる可能性を示しています。
同社は、エージェントが作成したtop-kカーネルについても差を報告しています。上位の候補を選ぶこの処理は、ランダム入力では20マイクロ秒でしたが、7万トークンのコンテキストを持つ実データでは最大62ミリ秒かかりました。この例だけで特定の実装全般を評価することはできませんが、人工的な入力で速いという結果だけでは、本番での高速化を保証できないことが分かります。評価データの代表性は、最適化手法と同じくらい慎重に確認すべき条件です。
エンジンを再起動せず、改善候補を試す仕組み
推論コードの改善を自動化しても、実験のたびに配信エンジンを起動し直していては、候補を十分に試せません。Together AIは、TensorRT-LLM上でMiniMax M3.1 Flashをコールドスタートさせる際に761秒かかったと報告しています。TensorRT-LLMやvLLM、SGLangは、大規模言語モデルの推論を実行・配信するためのソフトウェアです。起動待ちが長ければ、エージェントがコードを素早く生成しても、検証が追いつかなくなります。
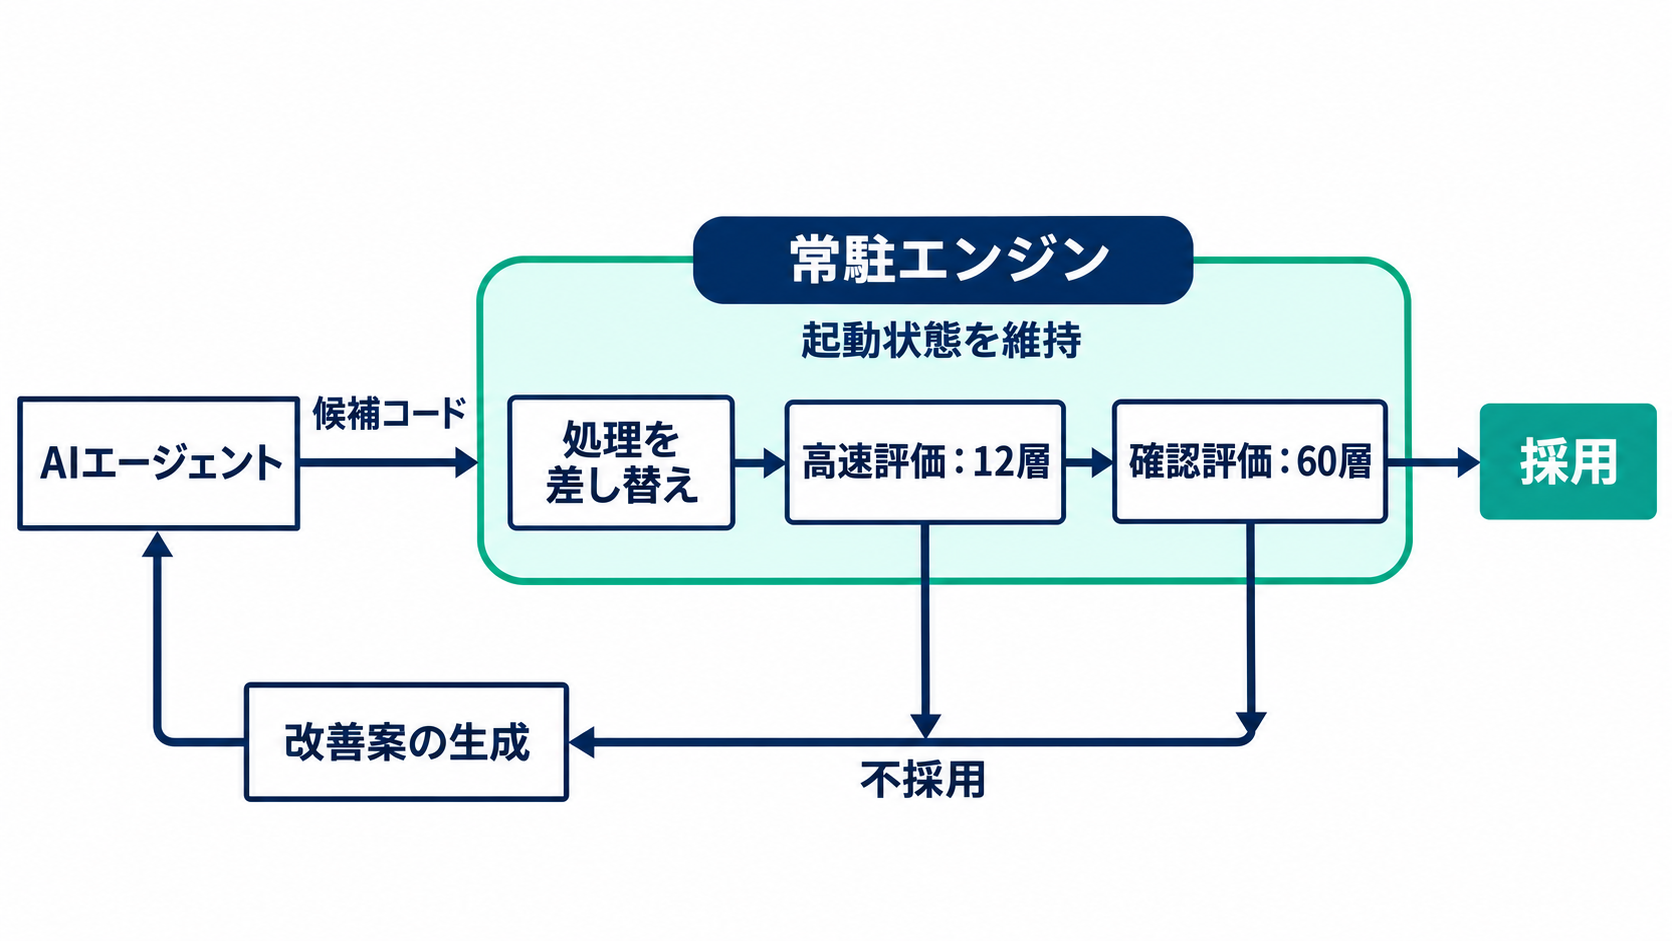
Together Compilerは、エンジンを起動したまま候補を受け取ります。エージェントがRPCという遠隔呼び出しの仕組みで新しいフォワードパスを送り、サーバー側が実行する関数の参照先を切り替えます。その後、GPU処理の実行手順をまとめるCUDAグラフを再取得し、変更後の性能を測る構成です。候補のたびに環境全体を立ち上げ直す待ち時間を減らせます。
候補の評価には、速度と再現性のバランスを取るために二つの段階を設けています。高速な段階では12層を使って候補を絞り込み、時間をかける段階では60層を使い、実際の入力分布で改善を確認します。すべてを重い試験にかけるのではなく、有望な実装に検証資源を集中する考え方です。
同社の比較では、遅い評価段階だけを使った場合の168候補に対し、二段階方式では1,354候補を試せました。候補数は8.1倍となり、見つかった実装も7.2%高速だったとしています。また、エンジン再起動を前提にした比較対象に対して、エージェントの実験処理量は252倍だったと報告しています。この252倍は利用者向けの生成速度ではありません。改善案を試す速さと、採用された実装が推論を速める効果は、別々の指標として読む必要があります。
GPUへの仕事の分け方も最適化の対象
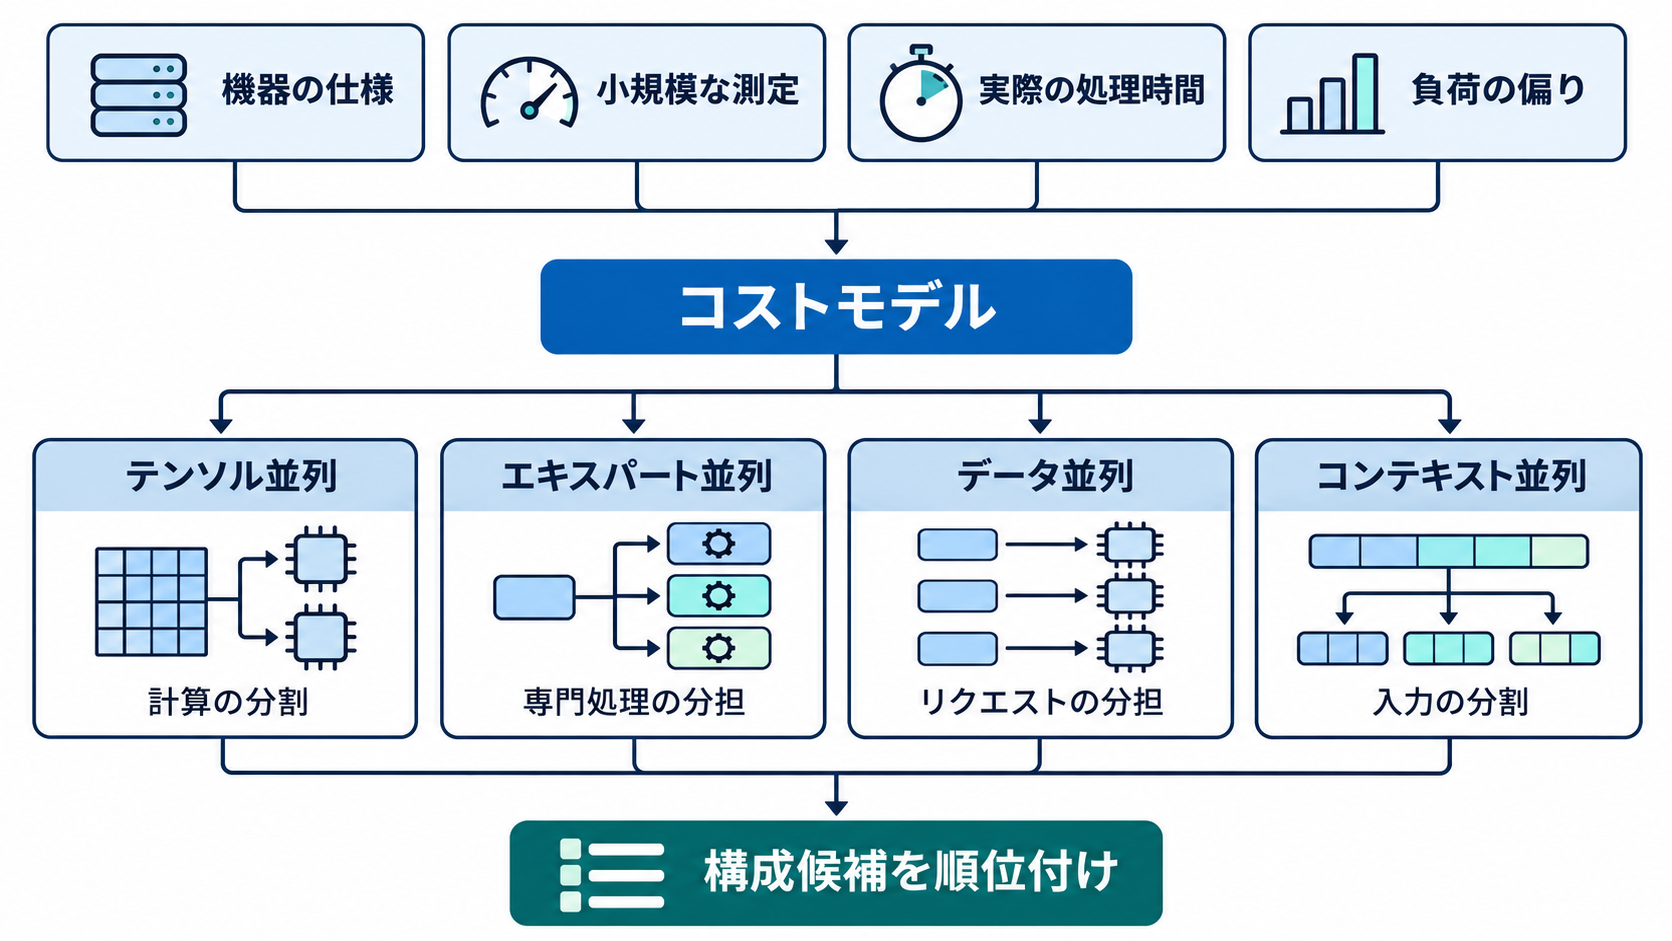
推論の高速化では、個々の計算処理を書き換えるだけでなく、複数のアクセラレーターへ仕事をどう分けるかも影響します。Together Compilerは、エージェントがコードの改善を始める前に、コストモデルを使って並列化構成の候補を順位付けします。ここでいうコストモデルは、処理時間などを見積もって構成を比較するためのモデルです。利用料金そのものを算出する仕組みとは区別して理解するとよいでしょう。
比較するのは、テンソル並列、エキスパート並列、データ並列、コンテキスト並列です。それぞれ、モデル内部の計算、MoEのエキスパート、リクエスト群、入力のコンテキストを分担する方法です。分担を細かくすれば各機器の負荷を減らせる場合がありますが、機器間の通信も必要になります。機器の台数を増やすだけで、比例して速くなるわけではありません。
Together AIのコストモデルは、仕様書の数値に加え、小規模な性能測定とフォワードパスの実測値を組み合わせます。MoEのエキスパートに負荷が偏る状況や、リクエストごとに入力長が異なる状況も考慮します。Kimi K3では、この方法で本番向けの構成を選び、最大24%高いTPSを得たと報告しています。
MiniMax M3.1 Flashの評価では、比較対象のTP4に対してTP8を選択しました。TPはテンソル並列の分割数を表します。同社は、メモリーからの読み出しが律速になるデコード処理で、各GPUが読み出す重みのデータ量を半分にできると説明しています。ただし、この選択を別のモデルへそのまま適用しても同じ結果になるとは限りません。通信とメモリーアクセスのどちらが制約になるかは構成によって変わるため、自社環境で測定して選ぶ姿勢が必要です。
最大2.6倍という結果を、条件とともに読む
Together AIは、SemiAnalysisの推論性能評価であるInferenceXのAgentXワークロードを使い、公開されている最良構成との比較を行いました。各設定の最適化時間は24時間未満で、使用した計算資源はモデル当たり最大2ノードとしています。対応・検証対象として挙げられている機器は、NVIDIAのB200、B300、GB300、H100、AMDのMI355X、AWS Trainium2です。
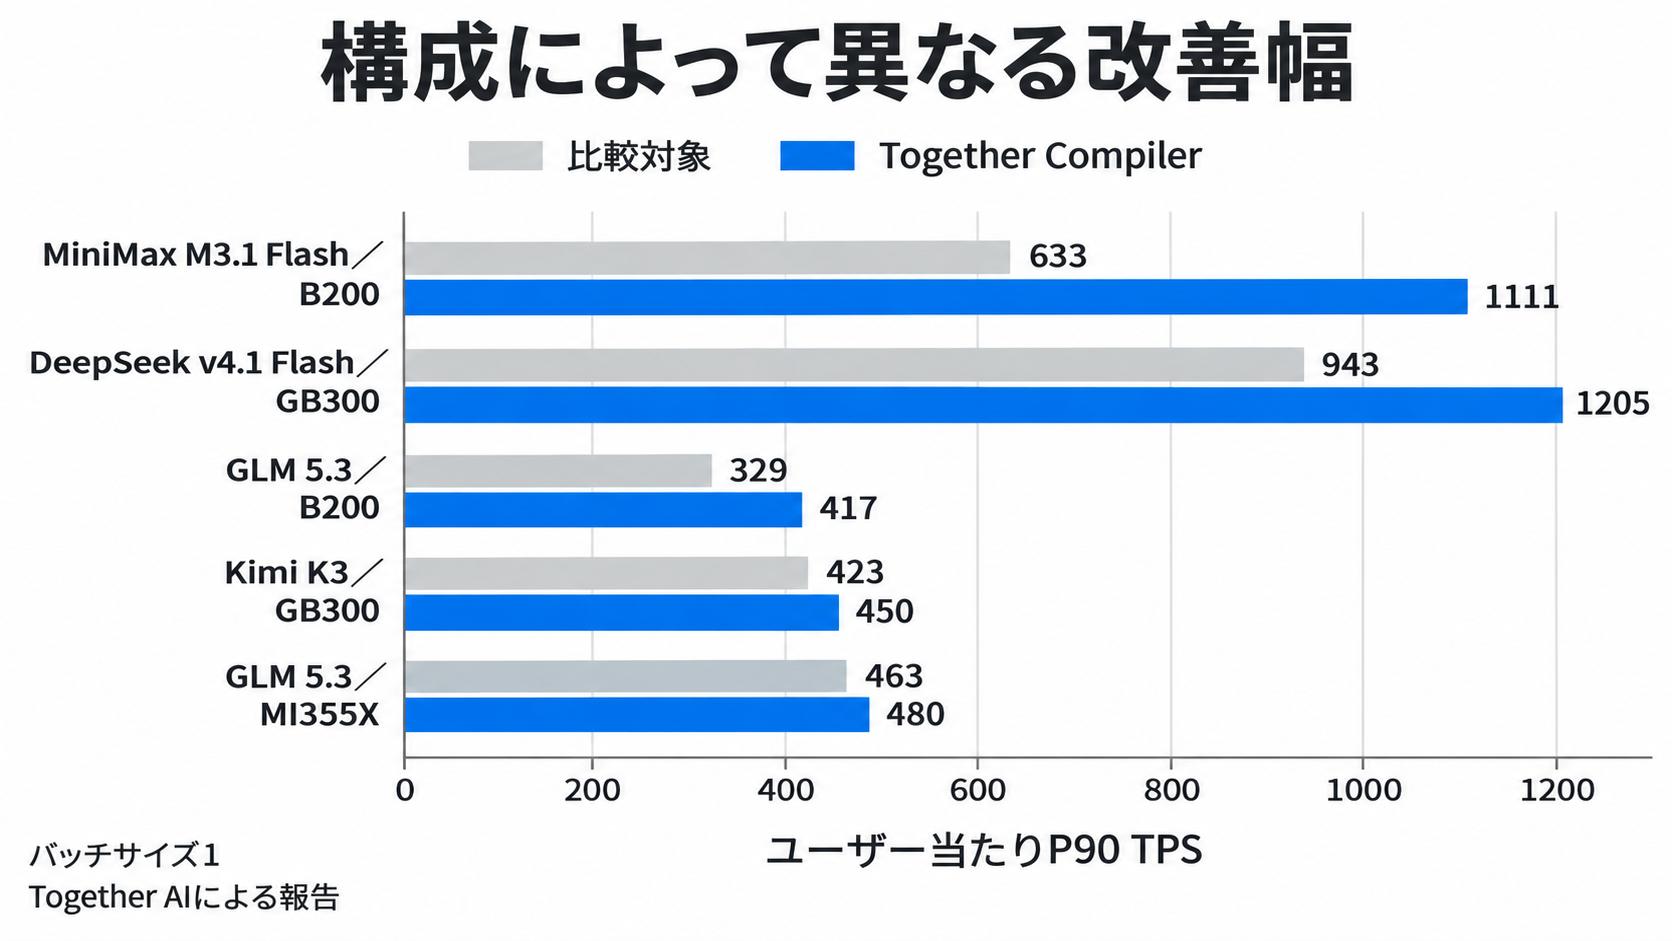
バッチサイズ1で報告された、ユーザー当たりのP90 TPSは次の通りです。バッチサイズ1は、一度の処理にまとめるリクエスト数が1である条件を示します。P90という集計方法を含め、単一の数値だけを別の環境の測定結果と比較しないことが大切です。
| モデル | ハードウェア | Together CompilerのTPS | 比較対象のTPS |
| --- | --- | --- | --- |
| MiniMax M3.1 Flash | B200 | 1,111 | 633 |
| DeepSeek v4.1 Flash | GB300 | 1,205 | 943 |
| GLM 5.3 | B200 | 417 | 329 |
| Kimi K3 | GB300 | 450 | 423 |
| GLM 5.3 | MI355X | 480 | 463 |
MiniMax M3.1 Flashの結果は約1.8倍ですが、GLM 5.3とMI355Xの組み合わせは約4%の改善です。この表の数値を、発表全体の最大値である2.6倍と混同するべきではありません。同じ仕組みでも、既存構成の完成度やハードウェア上の制約によって、追加で改善できる余地が異なると考えられます。
同社はLlama 1Bについても、バッチサイズ1で複数の比較対象に対し最大1.7倍の高速化を報告しています。LLM以外の科学計算モデル8件では、出力がビット単位で一致する条件で1.5〜6.4倍としています。ただし、科学計算モデルでの一致確認を、そのまますべてのLLM評価に適用された保証として扱うことはできません。企業が採用を判断する際は、速度の改善率に加え、どの条件で出力の正しさを検証したのかを分けて確認する必要があります。
企業が試すなら、代表的な入力と品質基準から
Together Compilerの報告には、エージェントの支援方法に関する示唆もあります。Together AIによると、専門家が整備した知識ベースを使う方式は、12時間後の高速化の伸びが25〜31%低くなりました。また、専門家の戦略を与えた方式より、フォワードパスを可能な限り速くするよう単純に指示したエージェントが良い結果を出したとしています。独自のログ構造への対応が、ツール呼び出しの最大43%を占めたという報告もあります。
同社は現在、中間表現を介するのではなく、エンジンのソースコードを直接エージェントに渡しています。ただし、この結果から専門知識が不要になったと一般化することはできません。今回の条件では、与えた知識や補助構造が探索を助けるとは限らなかった、と読むのが適切です。測定環境や正しさの判定基準を設計する役割は、コードの候補を生成する役割とは別に残ります。
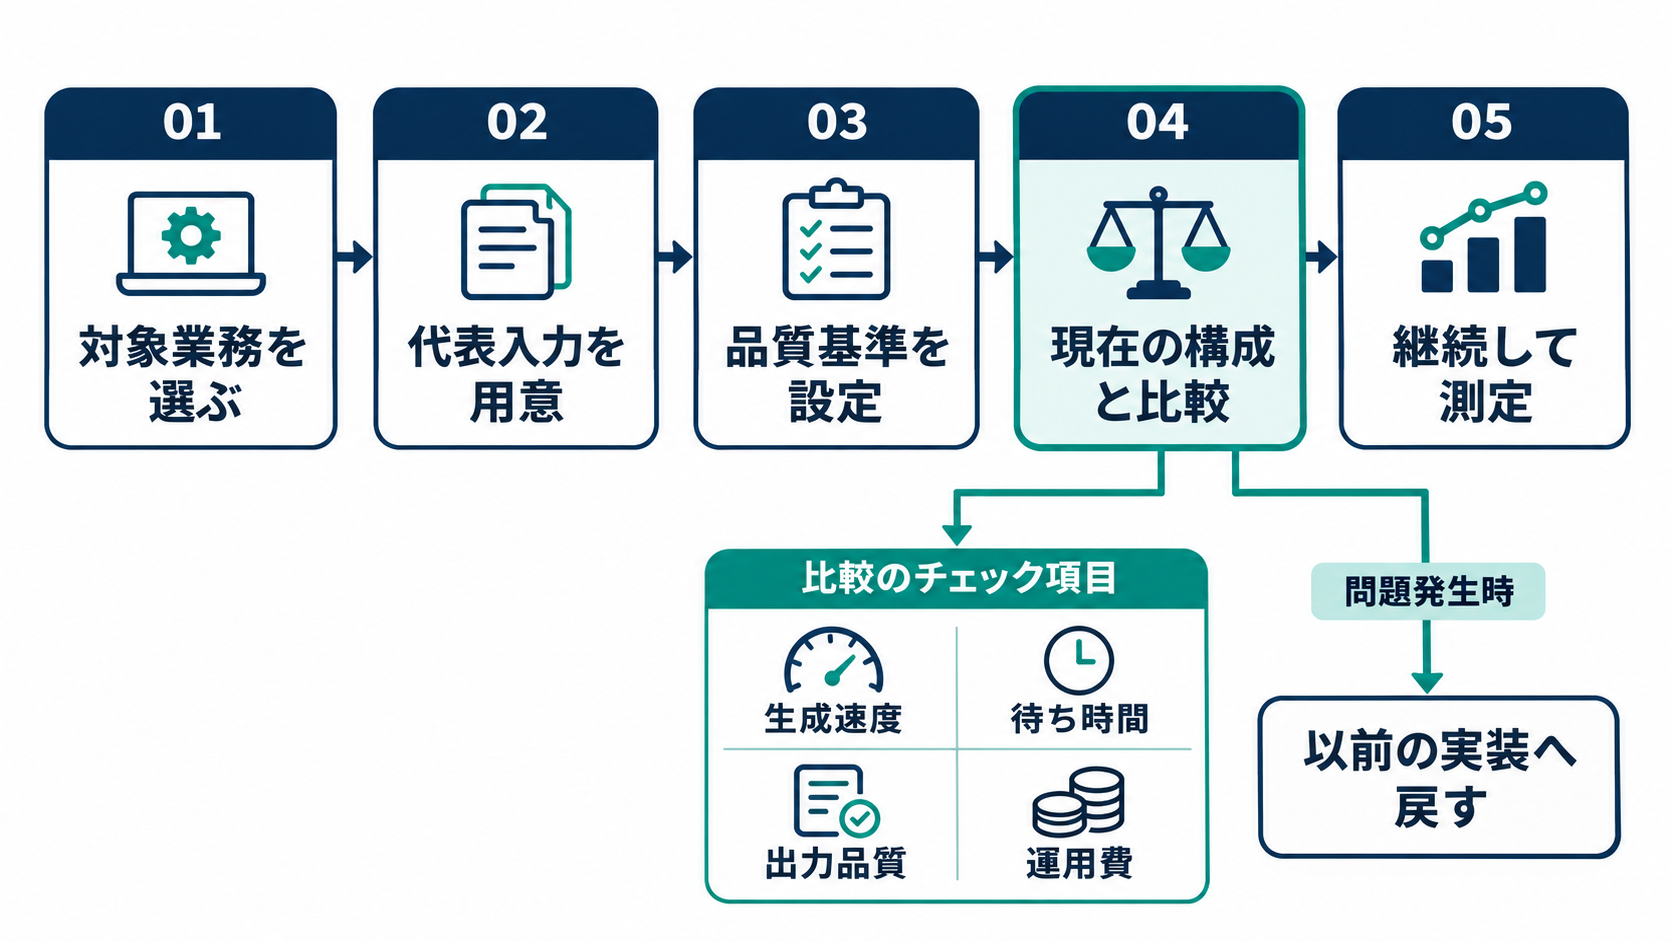
Together Compilerは、Together AIの顧客向けに限定ベータとして提供されています。自社で試す場合は、最も速いデモ入力を探すより、普段の業務を代表する入力をそろえるところから始めると判断しやすくなるでしょう。短い問い合わせだけでなく、長文、混雑する時間帯、利用部門ごとの違いを評価条件として整理すれば、改善がどの業務に効くかを確認できます。
速度だけで採用を決めるのも早計です。生成速度が上がっても、待ち時間全体や運用費が同じ割合で改善するとは限りません。出力品質の許容範囲、変更後の検証方法、問題が起きた際に以前の実装へ戻す手順も、試験導入の評価項目になります。最初の一歩は、対象業務を一つ選び、代表的な入力群と品質の合格基準を固定して、現在の構成と比較することです。その測定を利用状況の変化に合わせて続けられるかが、継続的な最適化を導入する判断材料になります。