
2026/11/05
AIニュース
GoogleのAgile Deliberation、曖昧な画像判定基準を人とAIで言語化
この記事の要点
Google ResearchのAgile Deliberationは、判断に迷う画像を人とAIで検討し、曖昧な分類基準を文章にする仕組みです。二つの概念の評価でF1が平均10.5ポイント向上した一方、再現率は低下しており、企業での導入には誤検出と見逃しの両面を確認する必要があります。
目次
「健康的な食事」の境界を、判定する前に見つける
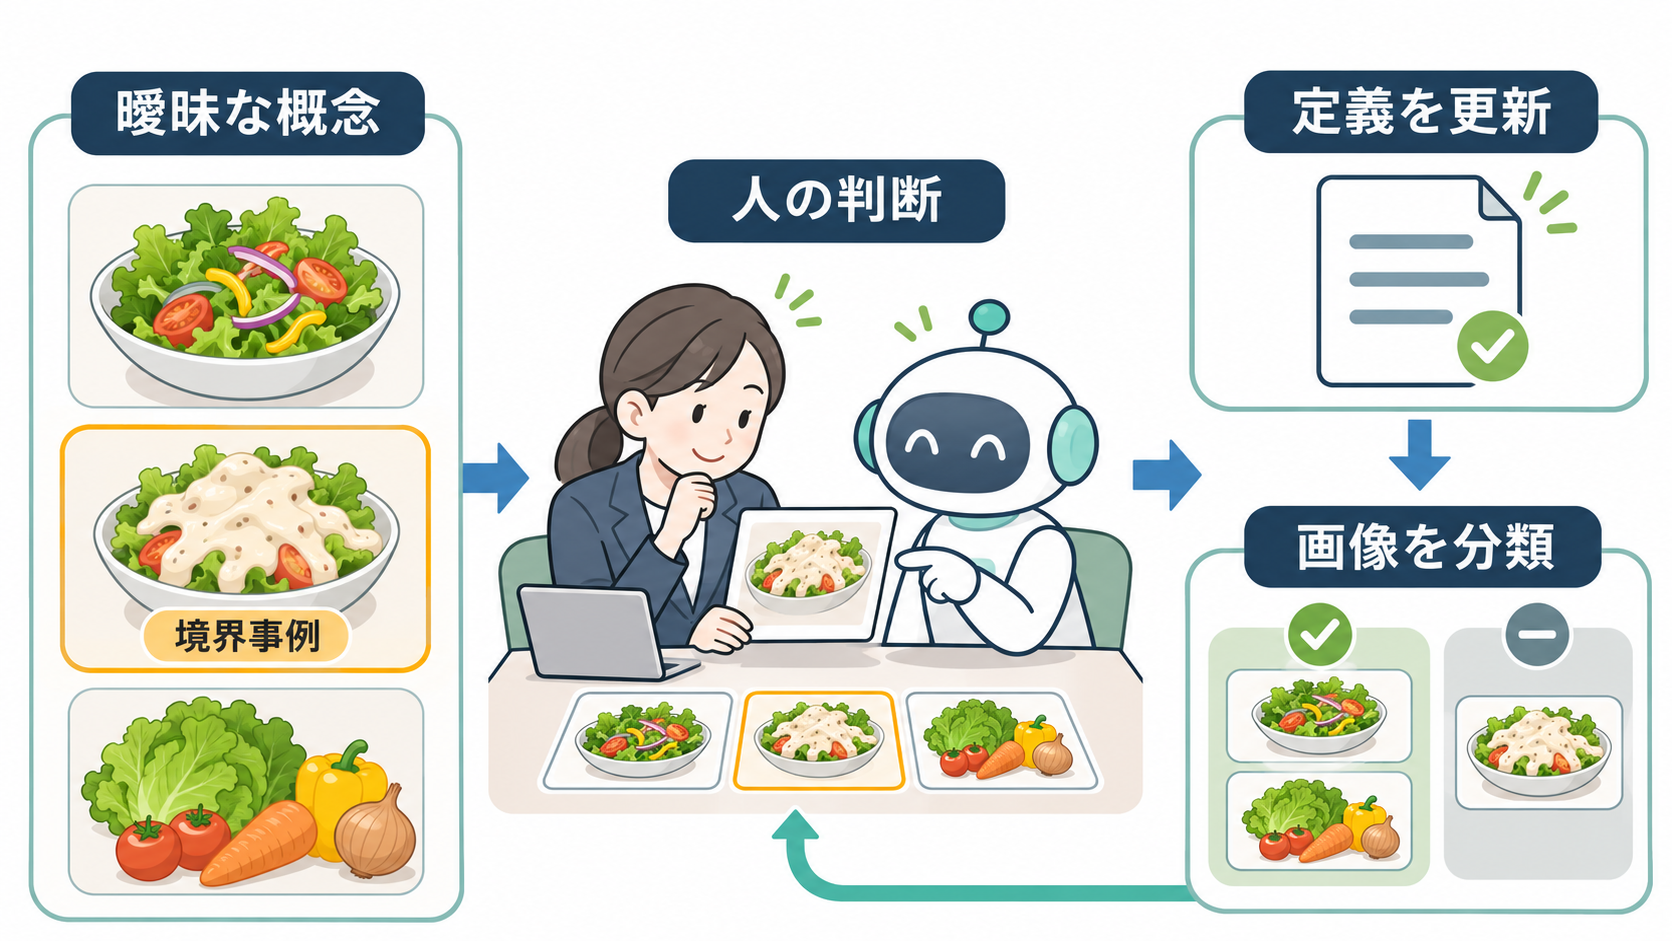
サラダの写真なら「健康的な食事」と判定してよいのでしょうか。マヨネーズをたっぷり使っている場合や、調理前の野菜だけが写っている場合には、判断が分かれるかもしれません。企業が画像の分類をAIに任せようとすると、モデルの性能を検証する前に、担当者自身も判定基準を明確に言葉にできていないという問題に直面します。
Google Researchが公開した「Agile Deliberation」は、この曖昧さを出発点にする、人が判断に関わる画像分類のフレームワークです。「健康的な食事」や「人を鼓舞するアート」のように、意味の境界が一意に定まらない概念を扱います。完成済みの基準をAIに渡すのではなく、具体的な画像を見ながら、人とAIで基準を探っていく設計です。
ここで作るのは、構造化された文章による定義です。この定義は、担当者が読んで理解できる判定方針になると同時に、画像を分類するAIへの指示文としても使われます。運用ルールの説明と、モデルに渡すプロンプトが同じ文章に結び付く点が特徴です。
設計の背景には、コンテンツモデレーションの専門家へのインタビューがあります。専門家は概念の範囲を大まかに決めた後、判断に迷う画像を使って基準を調整していました。ただし、そのような画像を探す作業に時間がかかっていたそうです。Agile Deliberationは、境界にある事例を見つけ、そこから基準を書き直す作業を支援します。企業にとっての焦点も、単に画像分類を自動化できるかという点から、自社が何を分類したいのかを定義できるかという点へ移るでしょう。
概念を分解し、具体例から対象範囲を絞る
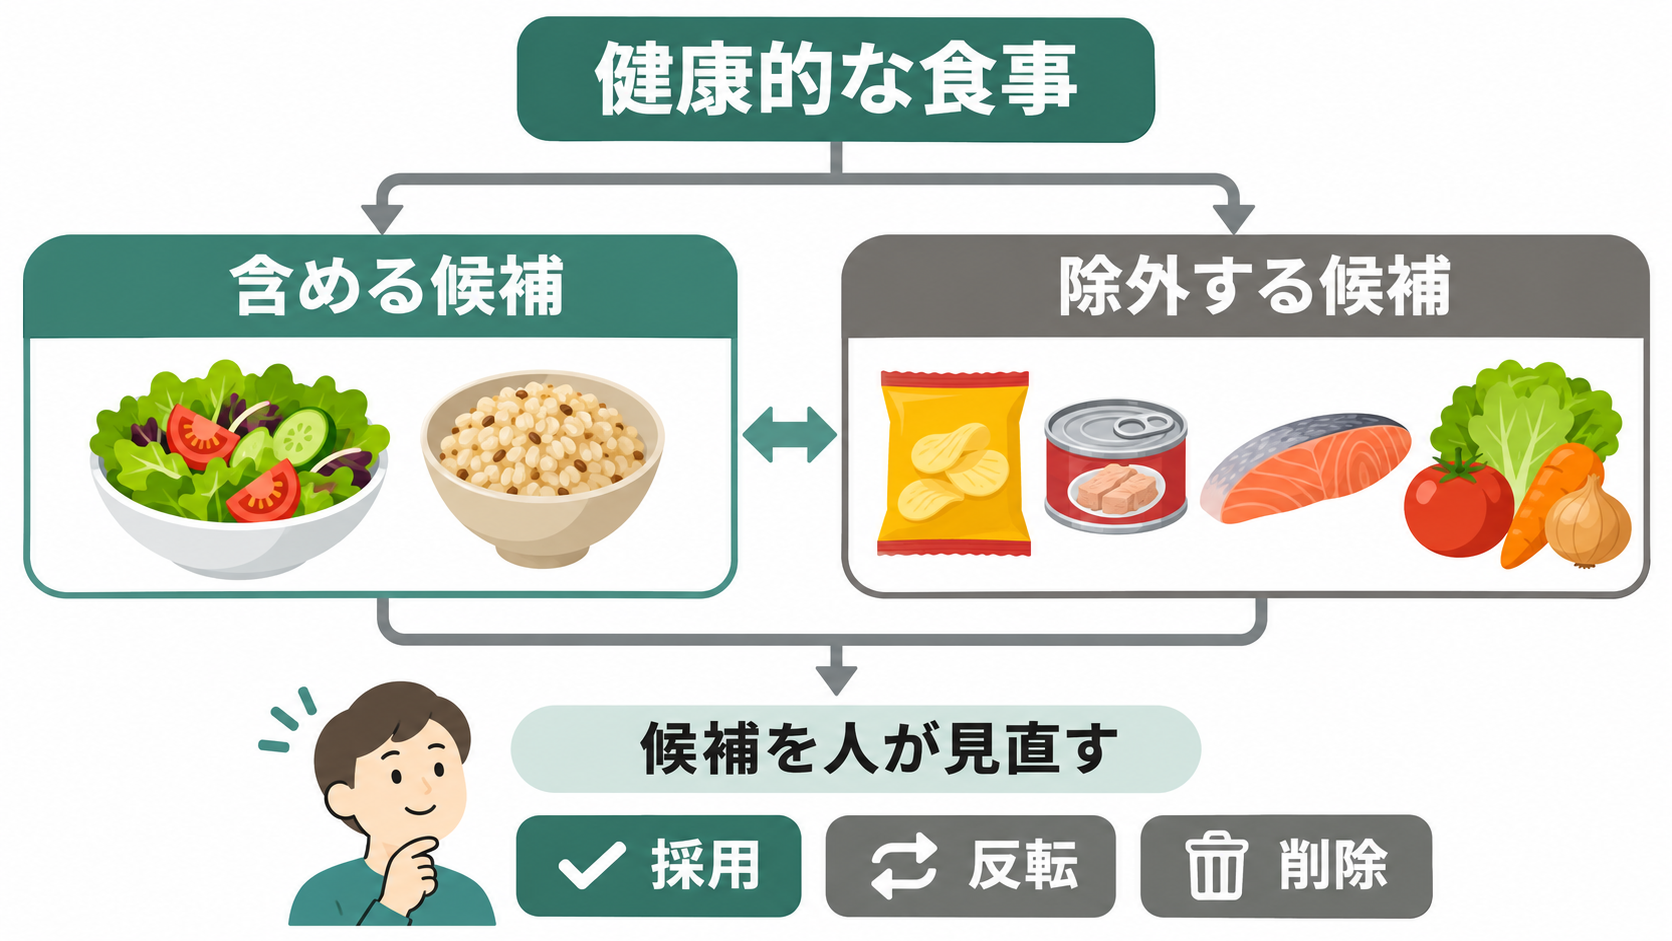
Agile Deliberationの最初の段階は、概念の対象範囲を定める作業です。Gemini 2.5 Proに段階的な指示を与え、入力された概念を最大三つの単位概念に分解します。それぞれに対して、対象に含める候補と、対象から外す候補を提示し、検索した画像とともに利用者へ見せる仕組みです。
「健康的な食事」であれば、含める候補にはサラダや穀物を使ったボウル料理、除外する候補には加工食品や未調理の食材などが挙がります。これらは最終的な正解ではありません。利用者は候補を採用するほか、含める側と除外する側を入れ替えたり、候補自体を削除したりできます。
この手順には、抽象的な言葉だけで議論する負担を減らす意味があります。「健康的」という言葉への賛同が得られていても、食材を評価したいのか、調理済みの一食を評価したいのかによって、対象範囲は変わるでしょう。画像を見ながら候補を選び直すことで、言葉の上では見えにくかった前提の違いを確かめられます。
企業で応用する場合も、最初から長い指示文を完成させることにこだわる必要はないと考えられます。対象に含めたい代表例、除外したい代表例、まだ判断できない例を見比べれば、基準のどこが曖昧なのかを議論しやすくなります。ただし、利用者が選んだ範囲が、そのまま社会一般に通用する定義になるわけではありません。この段階で明らかにするのは、今回の分類業務で採用する範囲です。その用途を意識して候補を確認することが、後の評価結果を解釈する土台になります。
自信の低さではなく、意味の曖昧さから画像を探す
対象範囲を大まかに決めた後は、判断が分かれそうな画像を使って定義を調整します。Agile Deliberationが採用するのは、分類器の確信度が低い画像を選ぶ一般的な方法ではありません。指示文で動かす生成型の視覚言語モデルでは、確信度の数値が実際の正しさと十分に対応しているとは限らないためです。
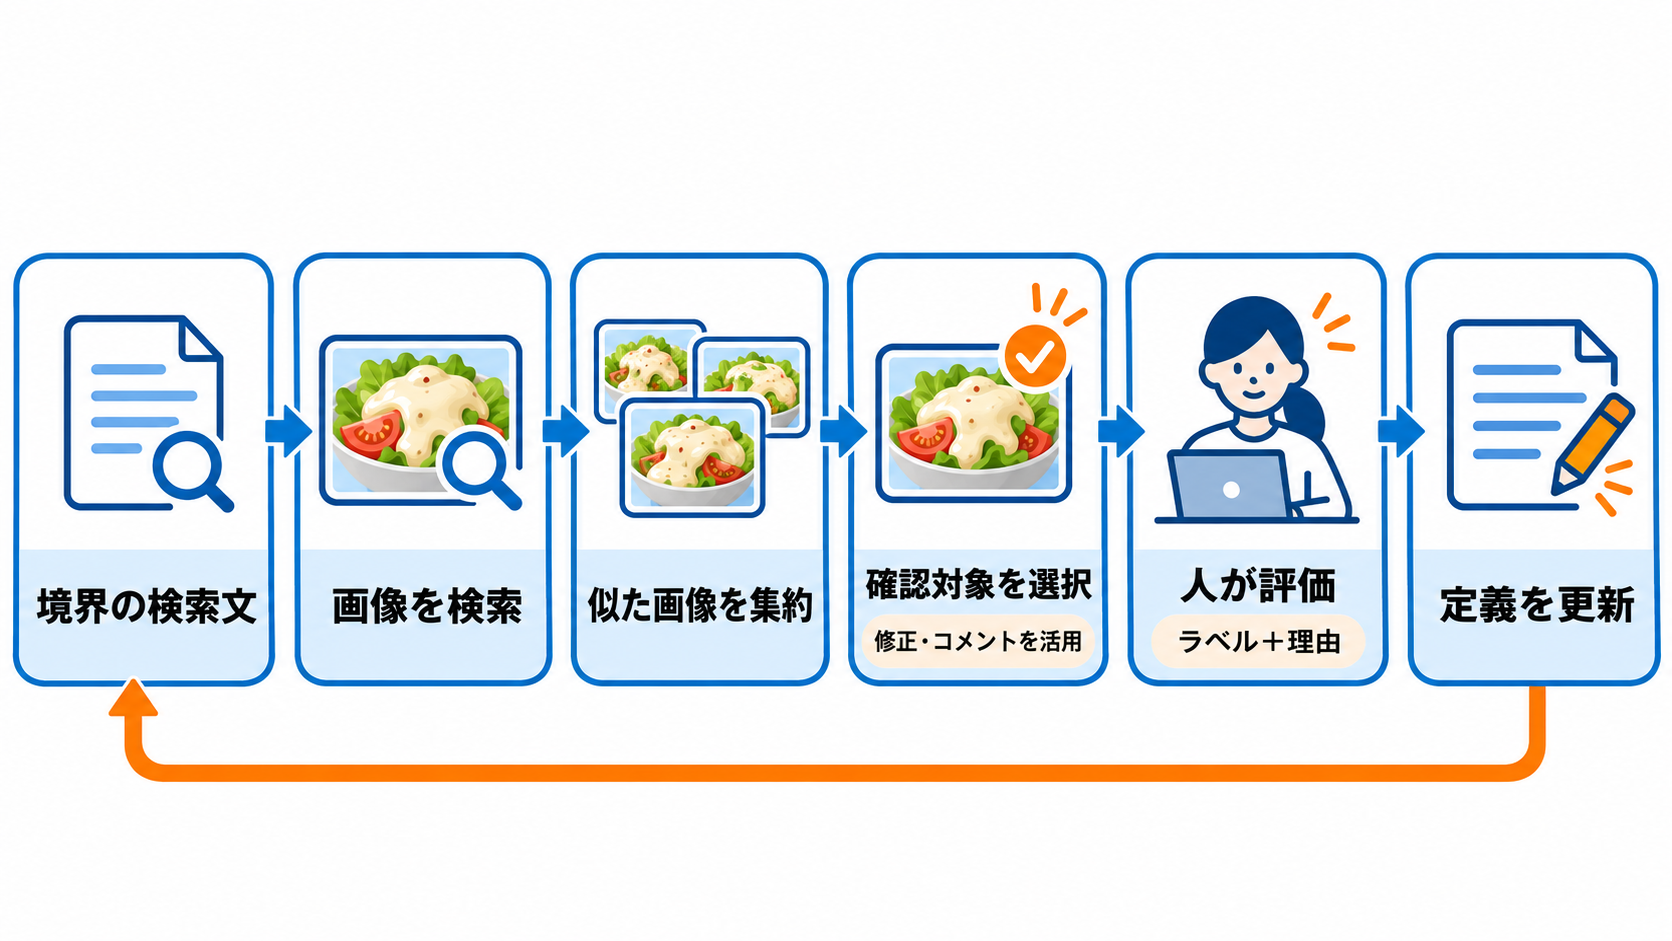
代わりに、Gemini 2.5 Flashが「マヨネーズの多いドレッシングを使ったサラダ」といった、意味の境界を探る検索文を作ります。各検索文で50〜100枚の画像を取得し、重複を除いたうえで、画像の特徴を数値化します。その後、辞書学習という手法を使い、似た特徴を持つ画像をグループにまとめます。
どのグループを次に確認してもらうかは、UCBという探索手法を使う多腕バンディット方式で選びます。これは、複数の候補を試しながら、役立つ反応が得られそうな候補へ確認作業を振り向ける方法です。利用者がモデルの判定を修正したグループや、詳しいコメントを残したグループが優先されます。利用者には、共通する一つの曖昧さを持つ画像が少なくとも5枚提示され、視覚言語モデルによる各画像の一文の説明も添えられます。
利用者は画像にラベルを付け、判断が食い違った理由を短く記入します。言語モデルはその内容から定義の候補を作成し、利用者のラベルに対するF1スコアが最も高い候補を残します。F1は、適合率と再現率のバランスを見る指標です。この反復によって、単に正誤のラベルを増やすだけでなく、「どの条件なら含めるのか」という説明を更新していく仕組みになっています。
F1の改善と同時に、見逃しの増加も確認
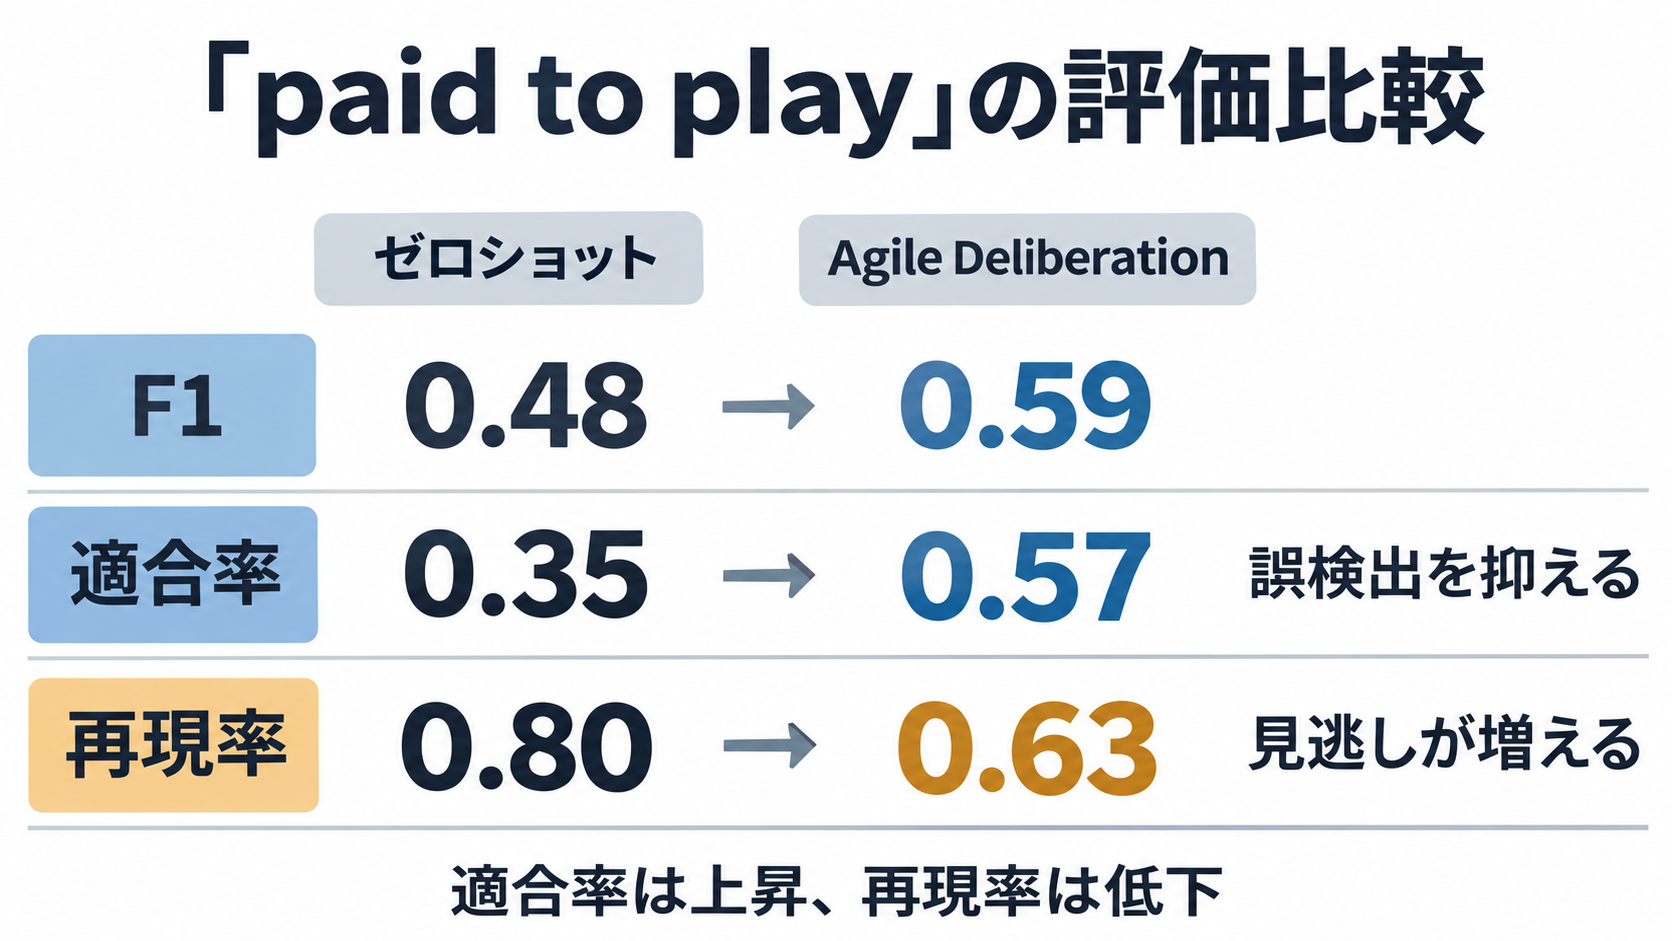
Googleの評価では、Agile Deliberationは初期の説明だけで分類するゼロショットのGemini 2.5 Flashに対し、二つの概念で平均10.5ポイント高いF1スコアを記録しました。対象は「paid to play」と呼ばれるクリックベイトの分類と、「健康的な食事」の分類です。クリックベイトは、クリックを強く誘う表現やコンテンツを指しますが、今回の数値は評価対象となった特定の概念についての結果です。
| 評価対象 | ゼロショットのF1 | Modeling CollaboratorのF1 | Agile DeliberationのF1 |
| --- | --- | --- | --- |
| paid to play | 0.48 | 0.53 | 0.59 |
| 健康的な食事 | 0.48 | 0.50 | 0.58 |
比較対象のModeling Collaboratorは、言語モデルのエージェントで概念を分解し、データへのラベル付けを自動化する手法です。ただし、今回の結果だけで、あらゆる主観的な分類に対する優劣が確定するわけではありません。
業務上は、F1の上昇とともに、誤りの内訳を確認する必要があります。「paid to play」では、対象と判定した画像のうち正しかった割合を示す適合率が、0.35から0.57へ上昇しました。その反面、対象の画像をどれだけ拾えたかを示す再現率は、0.80から0.63へ低下しています。「健康的な食事」でも、再現率は15ポイント低下しました。
つまり、対象外の画像を誤って拾うケースが減っても、本来拾いたい画像を見逃すケースは増えています。例えば、担当者へ渡す確認候補を絞る用途と、見逃しをできるだけ避けたい監視用途では、望ましい判定のバランスが異なるでしょう。導入判断では、F1の改善を成果として受け止めつつ、誤検出と見逃しのどちらが業務へ強く影響するかを先に整理しておくことが欠かせません。
18回の対話型評価から読み取れる範囲
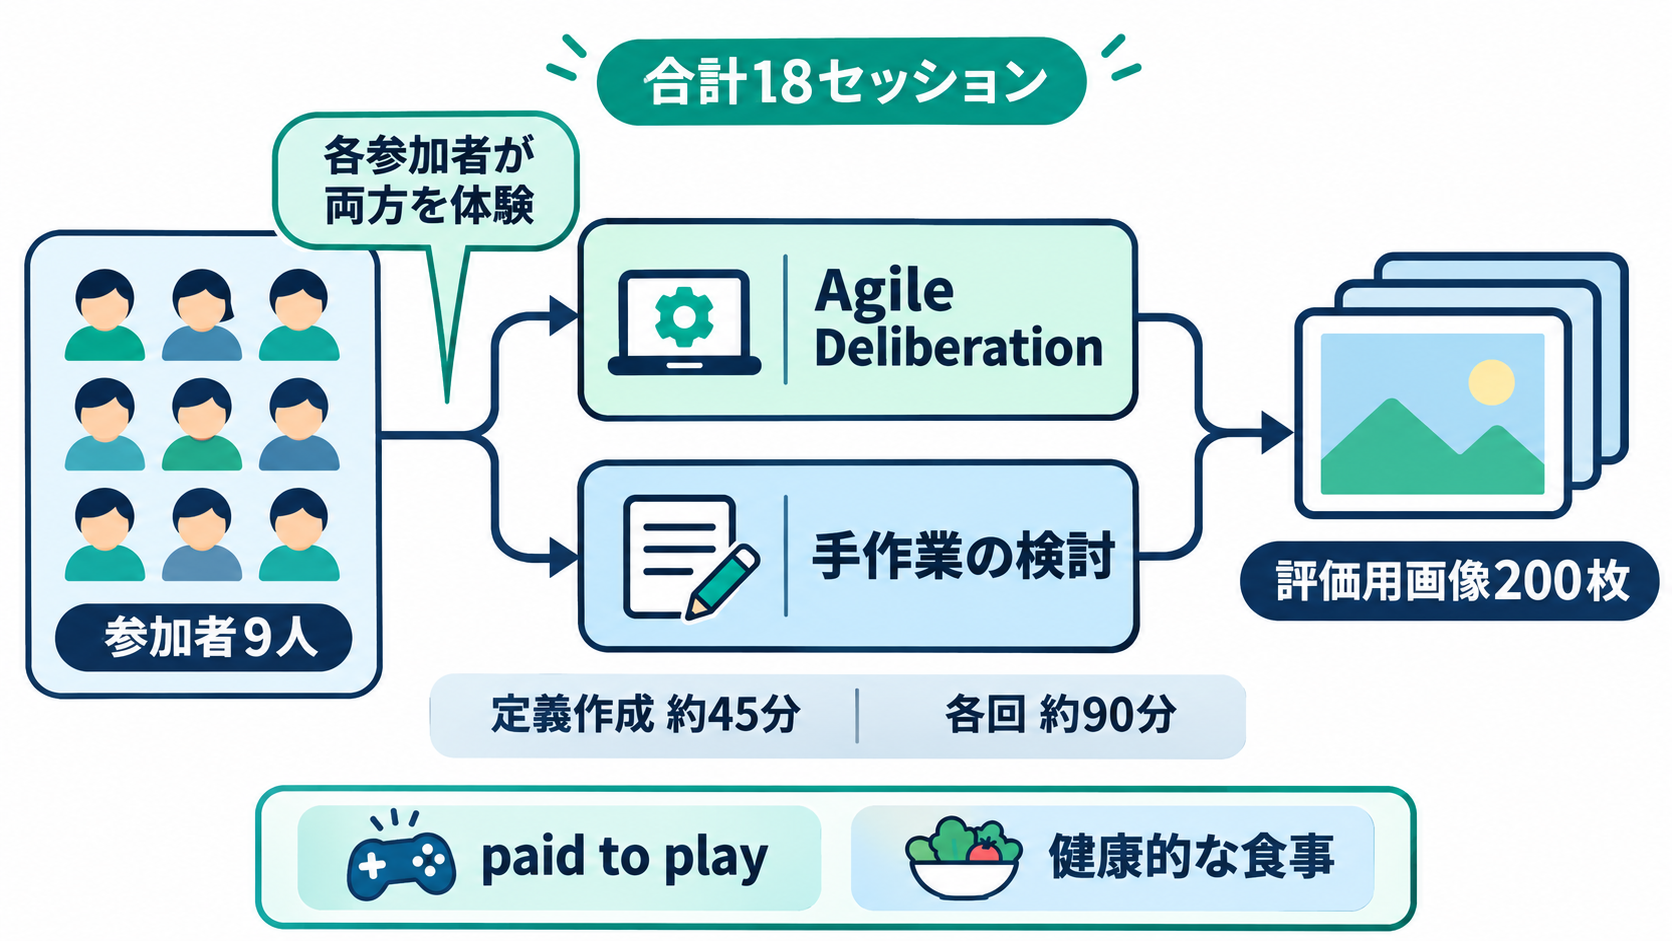
主観的な概念には、誰にとっても共通する固定的な正解を用意しにくいという難しさがあります。Googleは、あらかじめ用意した静的なベンチマークだけで評価する方法を採らず、利用者が実際に定義を作るセッションを実施しました。評価には、専門的なモデレーション経験のない9人が参加しています。
各参加者は、Agile Deliberationを使う場合と、手作業で検討する場合の二つのセッションを経験しました。合計18回のセッションは、それぞれ約90分です。概念の定義には約45分を使い、その後、評価用に分けておいた200枚の画像へラベルを付けました。報告されたF1は、参加者ごとの結果を平均した値です。
画像検索に使ったデータも、二つの概念で異なります。「paid to play」では独自の1億枚規模の画像データセットを、「健康的な食事」ではWebLIという画像・言語データセットを使っています。この評価条件と、後述する公開デモの条件を区別して読む必要があるでしょう。公開デモを動かせば、そのまま同じ性能が得られるという意味ではありません。
参加者は、手作業でプロンプトを編集する場合に比べて、労力やストレスが有意に低かったと報告しています。基準作りを支援する仕組みとして、分類性能だけでなく、人の負担も評価した点は参考になります。ただし、検証した概念は二つで、参加者も9人です。日本語の業務基準や、専門資格を持つ担当者の判断、長期にわたる運用に同じ結果を当てはめられるかは、この評価からは判断できません。自社で試す際には、最終的な精度に加えて、基準がどこで変わったか、担当者が納得して説明できるかも確認すると有用でしょう。
公開デモを試す前に、業務上の判断軸を決める
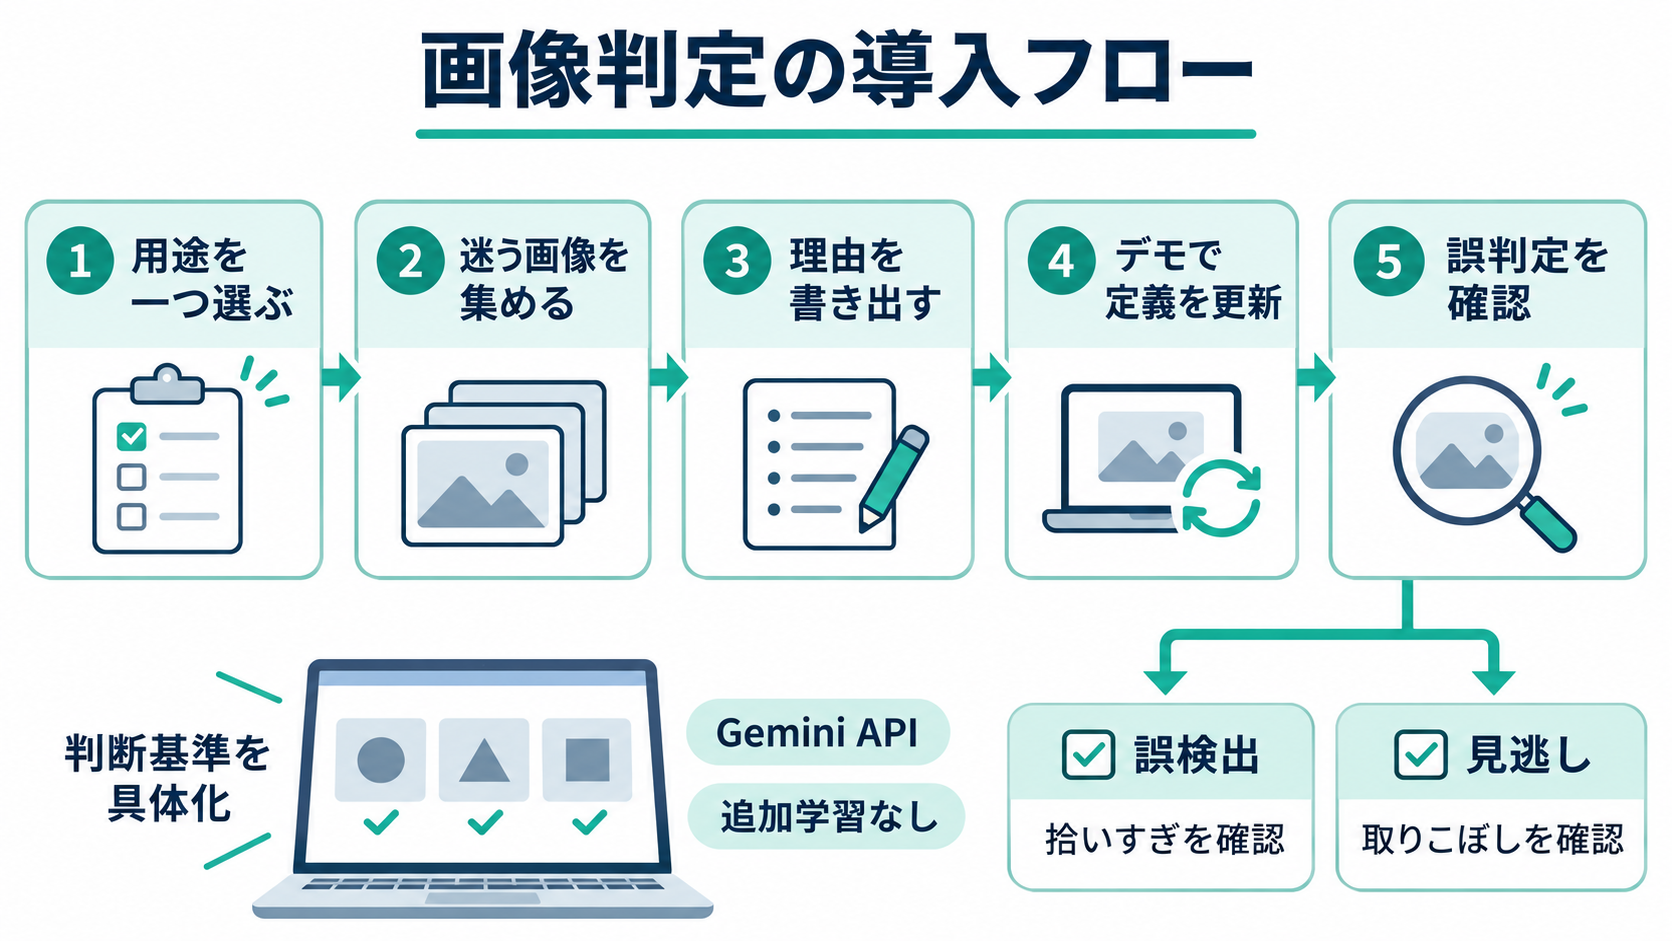
開発者向けには、GitHub上でApache 2.0ライセンスのコードと、健康的な食事を題材にした「Demo.ipynb」が公開されています。JupyterまたはColabのノートブックで動作し、Gemini APIキーが必要です。標準ではGemini 2.5 ProとGemini 2.5 FlashをAPI経由で呼び出し、モデルの追加学習は行いません。
画像検索には、画像と文章の対応を扱うCLIPの埋め込み表現と、高速な類似検索を行うFAISSのインデックスを使います。検索処理はCPUまたはGPUで実行できます。セットアップ用スクリプトは、LAION-400MのCLIP埋め込みをもとにインデックスを構築し、標準の2分割分で約260MB、全100分割分では約13GBになる構成です。これらは検索インデックスの規模であり、システム全体の必要資源やAPI利用費用を示す数字ではありません。
企業での試行は、「曖昧だが、現場では繰り返し判断している画像分類」を一つ選ぶところから始めるとよいでしょう。そのうえで、対象に含めたい例、除外したい例、担当者間で意見が分かれる例を用意します。境界事例を検討する仕組みなので、誰も迷わない画像だけでは、基準を具体化する効果を十分に確かめられません。
検証時には、更新された定義が読みやすいかという確認と、分類結果が用途に合うかという確認の両方が必要です。F1だけを採用基準にせず、適合率と再現率を分けて見ることで、業務上許容できる誤りかを判断しやすくなります。最初の一歩は、自社の担当者が判断に迷う画像を少数集め、迷う理由を一文ずつ書き出すことです。その理由を定義へ反映できるかを試せば、Agile Deliberationが自社の基準作りに役立つかを具体的に評価できるでしょう。