
2026/11/07
AIニュース
BuoyantがKinferenceを公開、vLLMの推論基盤にキャッシュを生かす振り分けと運用ポリシーを追加
この記事の要点
Buoyantが、KubernetesとvLLM向けの推論制御基盤「Kinference」を公開しました。キャッシュと待ち行列を考慮した配送に加え、モデル選択や外部サービスへの切り替えをポリシーで管理できます。共通する入力の先頭部分がある評価ではTTFT中央値を約95%短縮しましたが、自己申告の結果で、比較対象は通常のKubernetesの振り分けです。現在はアルファ版のため、自社の入力特性と応答時間目標に沿った検証が必要です。
目次
モデルを動かす基盤から、依頼を振り分ける基盤へ
社内向けの生成AIサービスで複数のモデルを提供すると、モデルをGPU上で動かすだけでは解決しない課題が出てきます。どの部署の依頼を、どのモデルに、どのGPUで処理させるのでしょうか。混雑した際に外部サービスへ処理を回すとしても、個人情報を含む入力まで同じ扱いにするわけにはいきません。利用者が増えるほど、推論の実行と同じくらい、依頼の振り分け方が運用品質を左右します。
サービス間通信を管理するオープンソースソフトウェア「Linkerd」の開発元であるBuoyantは、この領域に向けて「Kinference」を公開しました。コンテナ運用基盤のKubernetesと、LLMの推論サーバーであるvLLMを組み合わせた環境で、リクエストの配送先を制御するプロジェクトです。公開されたバージョンはv0.1.0-alpha.7で、実装言語はRust、ライセンスはApache 2.0です。
Kinferenceの中心的な価値は、モデル自体の能力を高めることではありません。既存のモデルサーバーの手前に、モデル選択、キャッシュを考慮した負荷分散、利用部門ごとの計測を担う共通の制御層を置く点にあります。部署や用途ごとにアプリケーションへ振り分け処理を書き込む構成では、ルールの変更や監査が分散しがちです。こうした判断を基盤側へ集めることで、推論サービスを組織として管理しやすくする狙いがあります。
ただし、現在はアルファ版です。公開情報ではレート制限、分類器、Anthropic APIへの対応は未提供とされており、構想として挙げられた機能と、現在利用できる機能を分けて評価する必要があります。
KVキャッシュの所在と待ち行列で配送先を選択
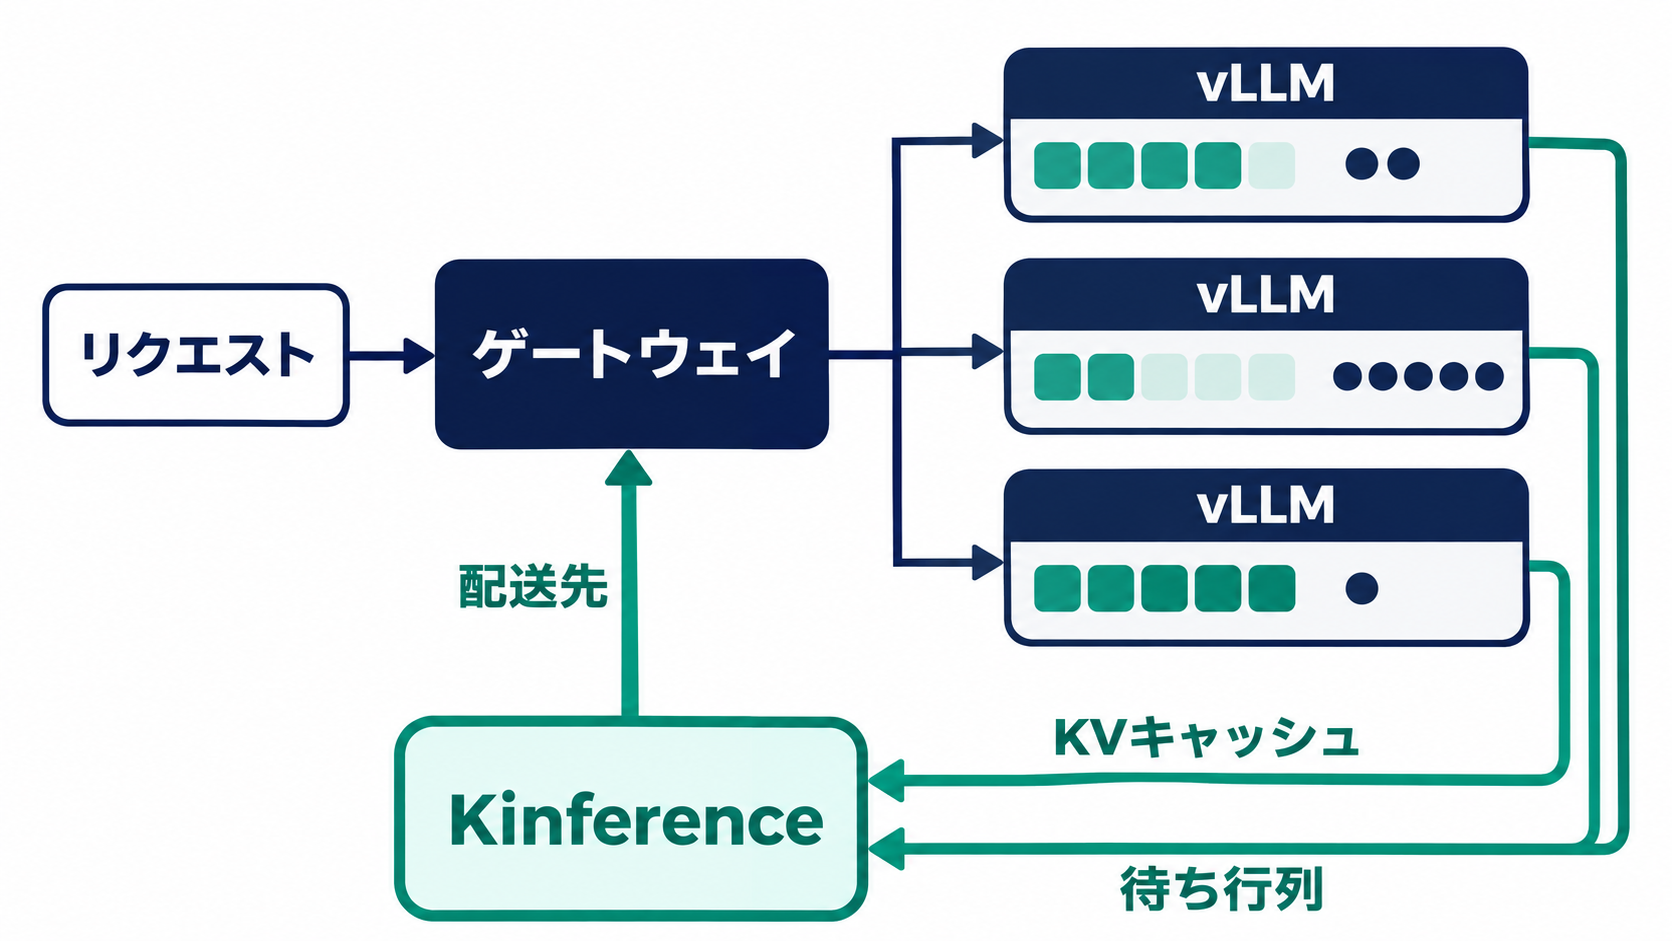
vLLMとKinferenceの役割を理解するには、「実際に推論する部分」と「どこで推論するかを決める部分」を分けると整理できます。Buoyantは、vLLMをデータプレーン、Kinferenceをコントロールプレーンと位置付けています。前者がモデルを実行し、後者がリクエストの処理先を判断する関係です。Kinferenceを導入しても、モデルの実行エンジンを置き換えるわけではありません。
システムはトラフィックを受けるゲートウェイと、推論ハンドラーの二つから構成されます。ハンドラーはgRPCというサービス間通信の仕組みで呼び出せるインターフェースを持ち、選択したエンドポイントと、必要に応じて変更したリクエスト本文を返します。Buoyant Gatewayなどのプロキシと組み合わせて、判断結果を実際の配送へつなげる仕組みです。
配送判断の材料になるのが、vLLMから得られるKVキャッシュのイベントとエンジンの稼働指標です。KVキャッシュは、LLMが入力を処理する際の中間計算結果を保存する仕組みです。共通する入力の先頭部分を再利用できれば、同じ計算を繰り返す負担を減らせます。ただし、その情報を持つワーカーへ依頼が届かなければ、キャッシュの利点を十分に生かせません。
Kinferenceは、キャッシュの重なりと待ち行列の長さから、最初のトークンが出るまでの時間であるTTFTを予測します。キャッシュがあるワーカーでも混雑していれば、別の候補が有利になる可能性があります。単に接続先を均等に選ぶのではなく、「今回の入力を早く処理できそうな場所」を探す考え方です。キャッシュイベントの処理には、NVIDIAのdynamo-kv-routerクレートを利用しています。
社内ルールを宣言的な推論ポリシーとして管理
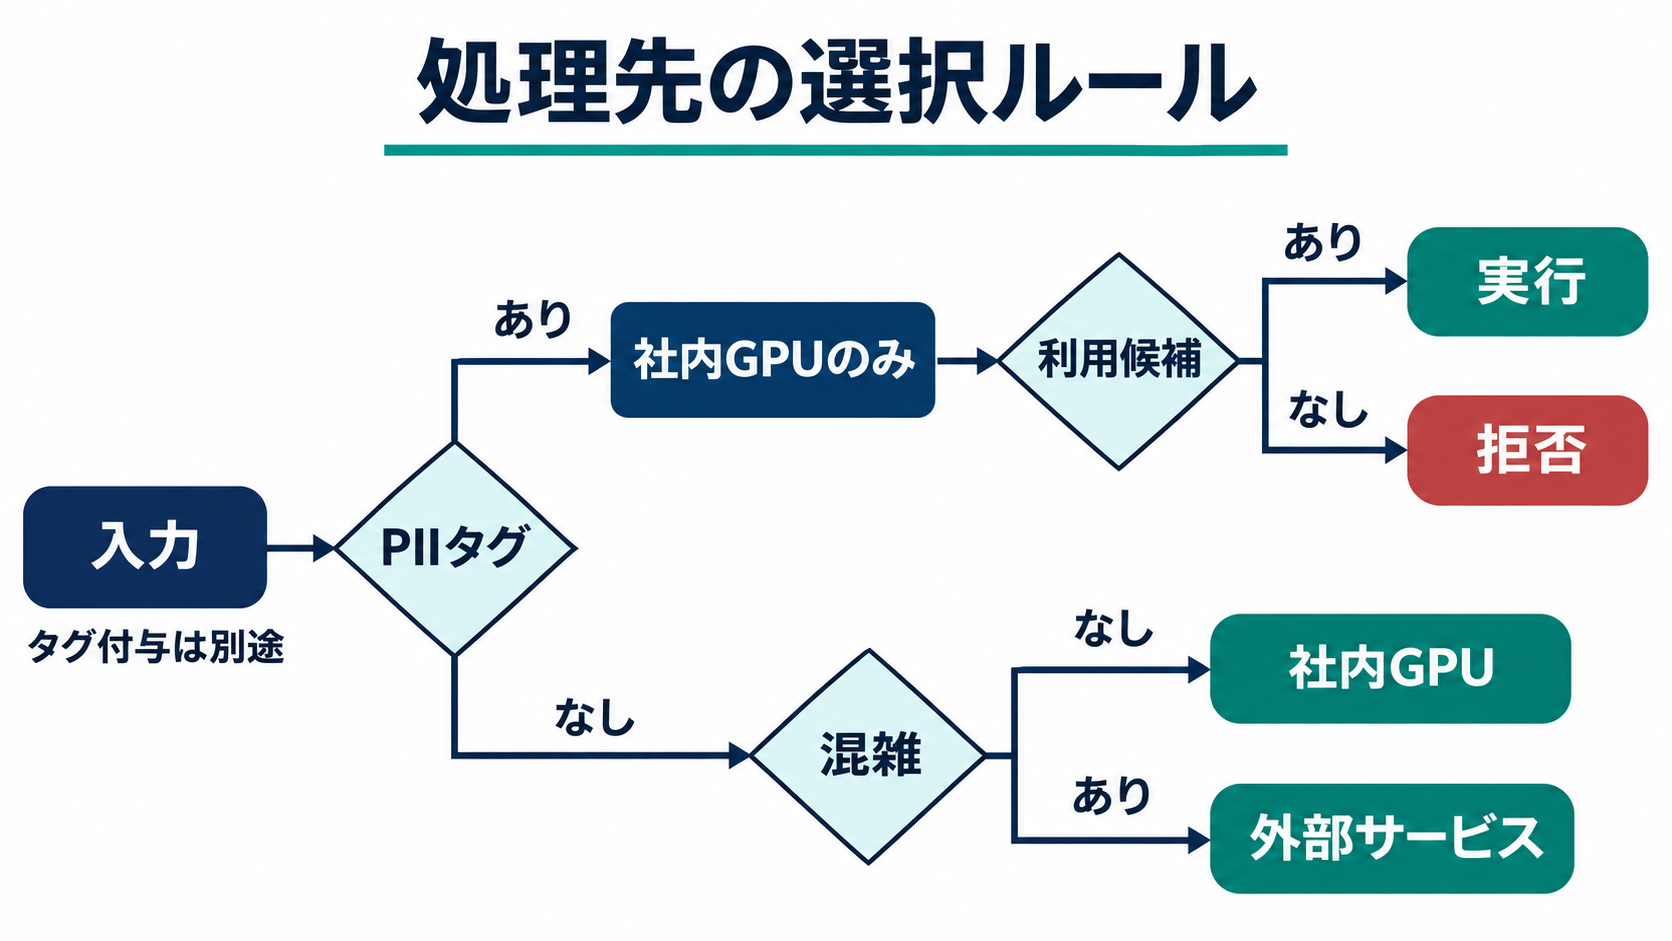
企業での導入を考える際、速度と同じくらい確認したいのが、リクエストの扱いをどこまで明示できるかです。KinferenceのInferencePolicyは、配送や拒否の条件を宣言的に記述する仕組みです。利用部門などを表すテナント、要求されたモデル、GPUプールの状態、意味に基づくタグなどを条件にできます。処理の手順を細かく書くのではなく、満たすべき条件と選択方針を設定する形です。
公開されている例では、単純な入力を小さなモデルへ回しつつ、キャッシュの重なりによって大きなモデルのほうが速い場合には選択を変えます。待機中の入力が二つを超えるワーカーを候補から外し、Amazon Bedrockなどの外部プロバイダーへ切り替える例もあります。Bedrockは、AWSが提供する生成AIモデルの利用サービスです。これらは、コストや混雑への対応を同じ判断層で扱う使い方を示しています。
個人を特定できる情報を表すPIIのタグが付いた場合に、外部プロバイダーを候補から除外する設定例もあります。候補がなくなれば処理を拒否するため、混雑時に意図せず外部へ送る挙動を避ける設計です。ただし、タグを条件に配送を制限できることと、入力から個人情報を自動検出できることは別の機能です。分類器は未提供とされており、例をそのまま個人情報保護の完成済み機能と受け取るべきではありません。
ほかにも、KVキャッシュ使用率が70%未満のワーカーだけへバッチ処理を送る例や、複数のモデルを一つの安定した名前で公開するモデル別名の例があります。設定はGitで管理でき、kinfctlというCLIでオフライン検証も可能です。変更内容をレビューできる点は、複数部署で基盤を共有する企業にとって検討しやすい特徴でしょう。
TTFTが95%短縮した条件と、効果が限定的だった条件
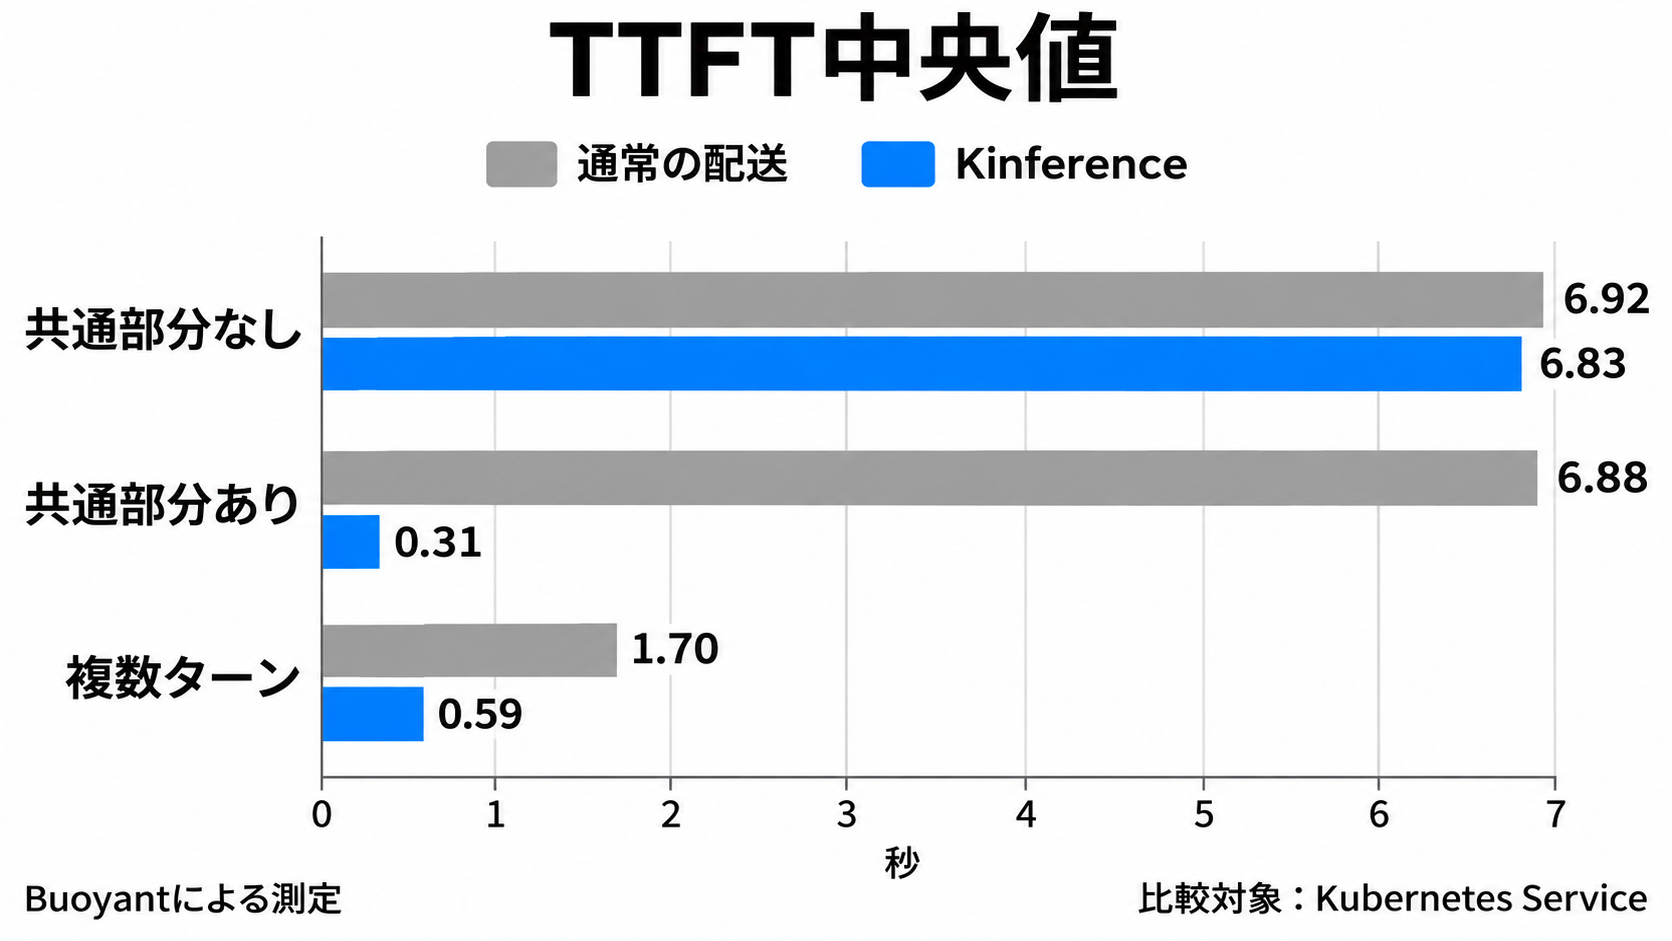
Buoyantが公表したベンチマークでは、共通する入力の先頭部分を持つワークロードで、TTFTの中央値が6.88秒から0.31秒へ短縮しました。削減率は約95%です。ただし、この結果をあらゆる生成AI処理へ当てはめることはできません。評価の焦点は、キャッシュを生かした配送が通常のKubernetesの振り分けに対してどれだけ有効かという点にあります。
比較では、それぞれの構成でL40S GPUを一基ずつ使うvLLM 0.31.0のPodを三つ稼働させています。モデルはQwen3.8-27B-FP8、負荷生成にはGuideLLM 0.8.1を使用しました。比較対象はClusterIP Serviceで、kube-proxyが接続ごとにランダムなPodを選ぶ構成です。以下はいずれもBuoyantによる自己申告の測定値です。
| 入力の種類 | Kubernetes ServiceのTTFT中央値 | KinferenceのTTFT中央値 | 変化 |
| --- | --- | --- | --- |
| 共通する先頭部分がない入力 | 6.92秒 | 6.83秒 | 有意な差はなし |
| 共通する先頭部分がある入力 | 6.88秒 | 0.31秒 | 約95%短縮 |
| 複数ターンの対話 | 1.70秒 | 0.59秒 | 約65%短縮 |
共通の先頭部分がない入力で中央値に有意な差がなかった点は、導入判断に直結します。社内検索の共通指示文や対話履歴など、再利用できる入力が多い環境ほど、今回の方式が効果を発揮する余地があると考えられます。反対に、入力が毎回大きく異なる業務では、同じ短縮率を前提にできません。
共通部分がない入力でも、遅い側から見た指標であるp95のTTFTは21.46秒から12.33秒へ下がりました。Buoyantは、待ち行列を考慮した負荷分散の効果と説明しています。ただし、比較相手はほかのキャッシュ対応ルーターではありません。llm-dやNVIDIA Dynamoに対する優位性まで示す結果ではないことに注意が必要です。
処理能力の数字は、自社の応答時間目標とセットで評価
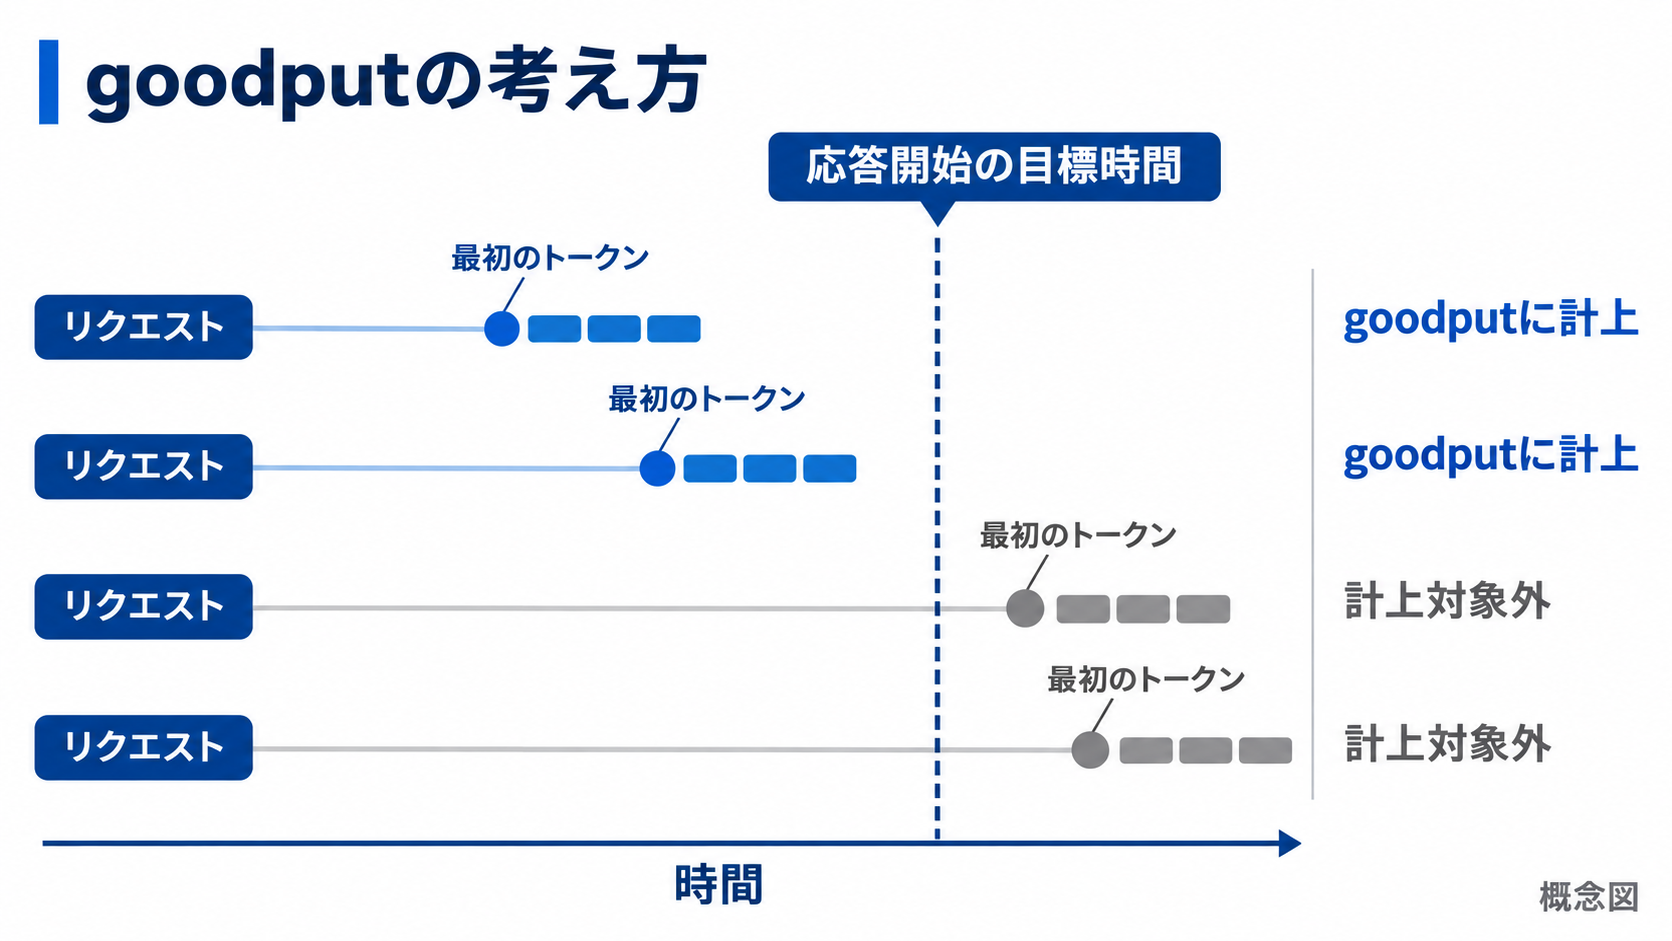
推論基盤の処理能力は、単純に何件受け付けられるかだけでは判断できません。利用者が許容できる時間内に応答を始められるかが、実際のサービス品質に関わります。Buoyantは容量評価で、TTFTのサービス水準目標であるSLOを満たしたリクエスト数を「goodput」として測定しています。遅すぎる応答も含めた総処理件数とは、評価の意味が異なります。
公表されたピーク値では、共通する先頭部分を持つ入力のgoodputが毎分14.0件から103.0件へ増え、約7.4倍になりました。複数ターンの対話では毎分23.8件から82.7件へ増え、約3.5倍です。リクエスト全体の処理時間の中央値も、共通部分がある入力で45%、複数ターンの対話で32%短縮したと報告されています。
ここで確認しておきたいのが、評価に使われたSLOです。Buoyantは8秒と4秒という設定について、チャットよりもオフラインで動くエージェント向けと説明しています。画面を見ながら返答を待つ利用者と、裏側で複数の作業を進める処理では、許容時間が異なります。公表された倍率が高くても、自社の対話サービスに必要な応答速度を満たすかは別途確かめなければなりません。
日本企業が検証するなら、業務で使う共通指示文や会話履歴を含めた入力を用意し、期待する同時利用数で測る方法が考えられます。TTFTだけでなく、出力中のトークン間隔を示すITLや、処理完了までの時間も合わせて確認すると、応答の体感を判断しやすくなるでしょう。平均的な速さだけでなく、特定の部署や長い入力に待ち時間が偏らないかまで見れば、基盤を共有する際の課題も把握できます。
導入の第一歩は、配送ルールと観測項目の整理
Kinferenceを既存の推論基盤と比較する際は、どの問題を解決したいかを先に定めると判断しやすくなります。llm-dやNVIDIA Dynamoも、キャッシュを考慮した配送や推論の効率化に取り組むプロジェクトです。Kinferenceはその中で、宣言的なポリシー、モデルの別名、外部プロバイダーへの切り替え、テナントごとの計測をまとめて扱う運用面を打ち出しています。公開された測定結果だけで、製品全体の優劣を決めるのは早計でしょう。
設定はKubernetesの独自リソース定義であるCRDとして管理します。対象はGatewayBackend、InferencePolicy、InferencePool、InferenceProvider、InferenceWorkerSetの五つです。導入手順ではGateway API v1.5.1のCRDを用意し、Buoyant GatewayとKinferenceのHelmチャートをインストールします。HelmはKubernetes向けソフトウェアの配布や設定に使うツールです。GPU対応のKubernetesとvLLMが、動作環境の前提になります。
監視用にはPrometheusのメトリクスとGrafanaのダッシュボードが提供されます。TTFT、ITL、処理全体の遅延、キャッシュを利用した入力トークンと利用しなかった入力トークンなどを、主にテナント単位で観測できる構成です。部署ごとの利用実態と待ち時間を結び付けられれば、GPUを増やすべきなのか、配送ルールを見直すべきなのかを検討する材料になると考えられます。
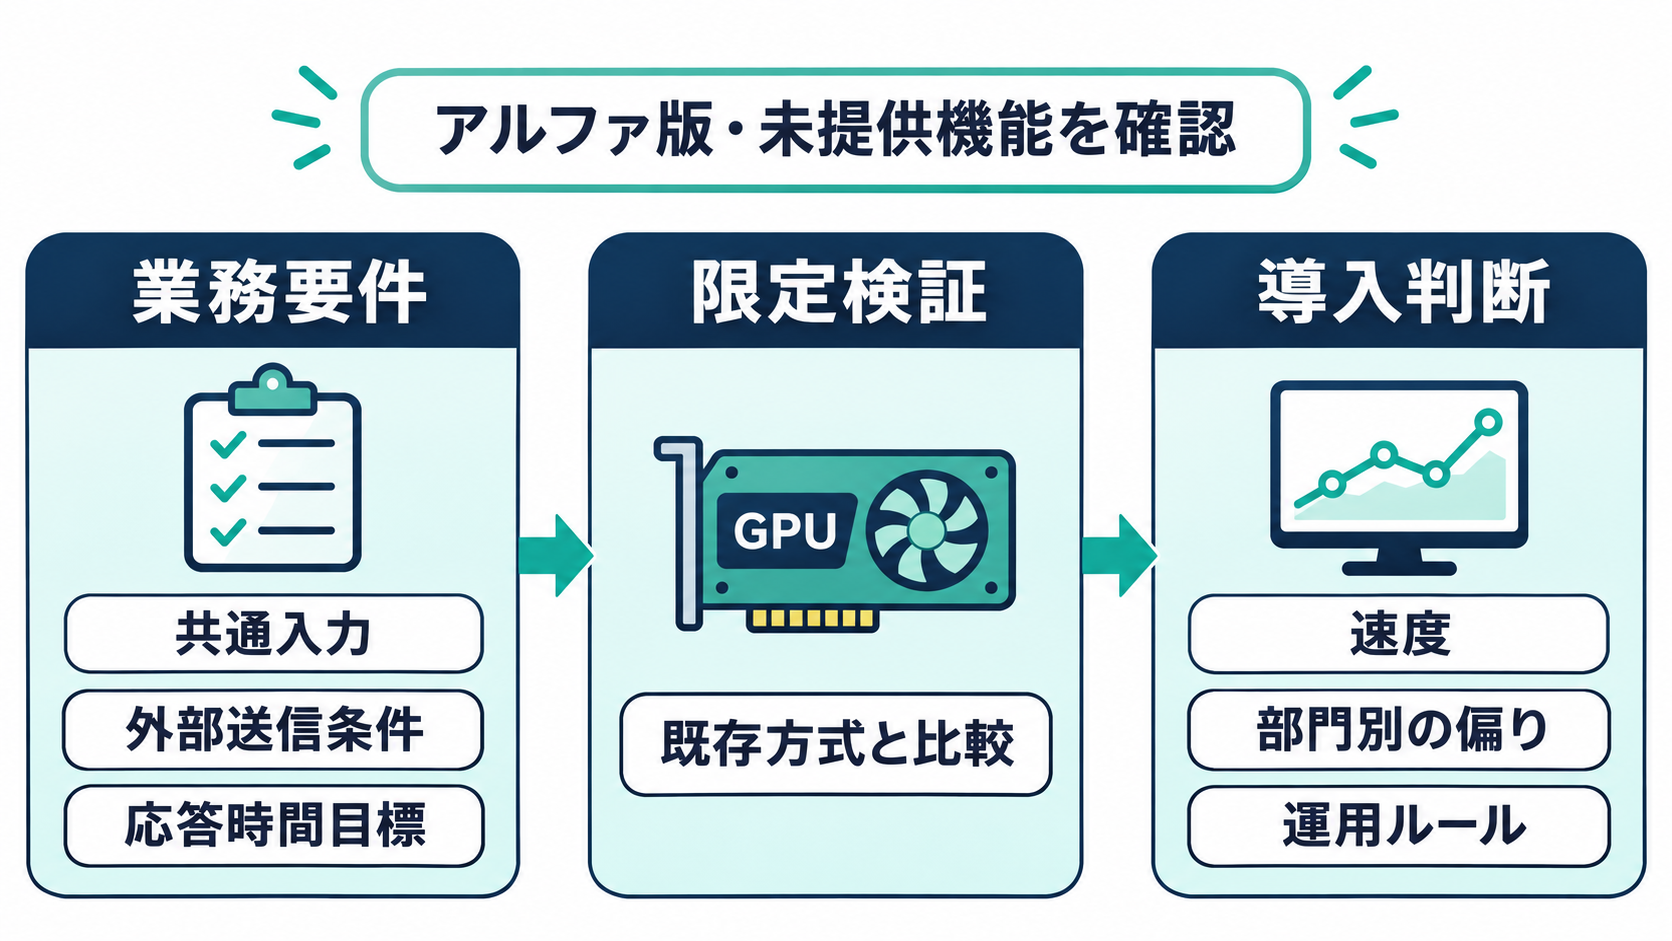
現在のアルファ版を試す場合は、未提供のレート制限や分類器を導入効果に織り込まないことが大切です。最初の一歩として、対象業務について「共通する入力は何か」「外部送信を許可する条件は何か」「何秒以内の応答開始を求めるか」を整理するとよいでしょう。そのうえで限定したGPUプールを使い、現在の配送方式と比較すれば、Kinferenceの制御層が自社の運用課題に合うかを具体的に判断できます。