
2026/11/07
今更聞けないAI知識
AIの「モデル」はアプリのこと?エンジンと車でわかる役割の違い
この記事の要点
AIのモデルは、データから学習したパターンを使って入力を処理する仕組みです。モデルをエンジン、アプリを車全体にたとえ、架空の文章作成アプリで役割の違いを説明します。モデル名とアプリ名を分けて、サービスの説明や出力内容を確認する見方が身につきます。
目次
「どのAIを使っていますか?」で名前がかみ合わない理由
「どのAIを使っていますか?」と聞かれて、いつも開いているアプリの名前を答えたのに、相手から別の名前が返ってくることがあります。相手は、アプリの中で文章などを処理する「モデル」の名前を話しているのかもしれません。同じAIの話でも、利用するサービス全体と、その内部で働く仕組みでは、指しているものが違います。この区別がつくと、サービスの紹介文も読みやすくなるでしょう。
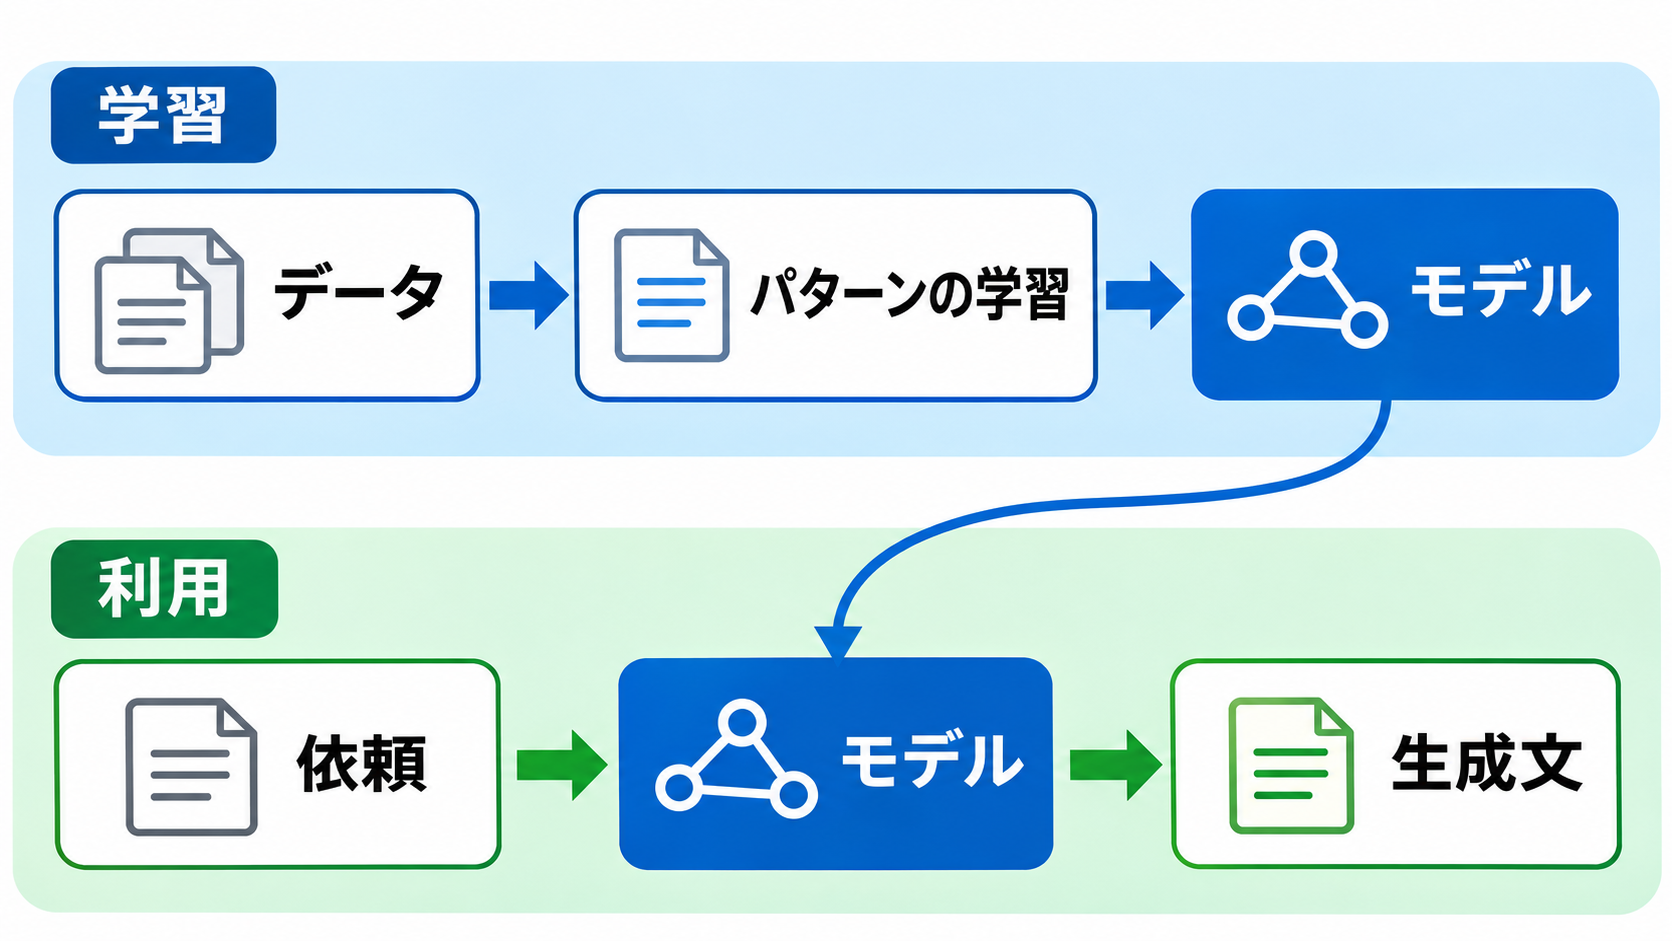
一言で答えるなら、AIのモデルは「データから学習したパターンを使って、入力を処理する仕組み」です。ここでいう学習とは、人が勉強する姿をそのまま指す言葉ではありません。データの中にある特徴や関係を、計算によって処理に使える形にすることです。Google Cloudの解説では、機械学習のモデルは、学習用データに対して計算の手順を実行することで得られるものと説明されています。(出典: Google Cloud)
アプリは、その仕組みを利用者が使えるようにまとめたものとして考えると整理しやすくなります。Googleの用語集でも、チャットボットは大規模言語モデル、つまり文章などの言語を扱う大きなモデルの応用と説明されています。会話をするアプリと、会話の文章を処理するモデルは、同じ言葉の言い換えではないのです。(出典: Google for Developers)
初心者のうちから、たくさんのモデル名を暗記する必要はありません。「これは自分が使うアプリの名前でしょうか。それとも、その中で働く仕組みの名前でしょうか」と分けて読むだけで十分です。名前を知っているかどうかより、説明がどの部分を指しているかを見分けることが、理解の出発点になります。
モデルがエンジンなら、アプリは車全体
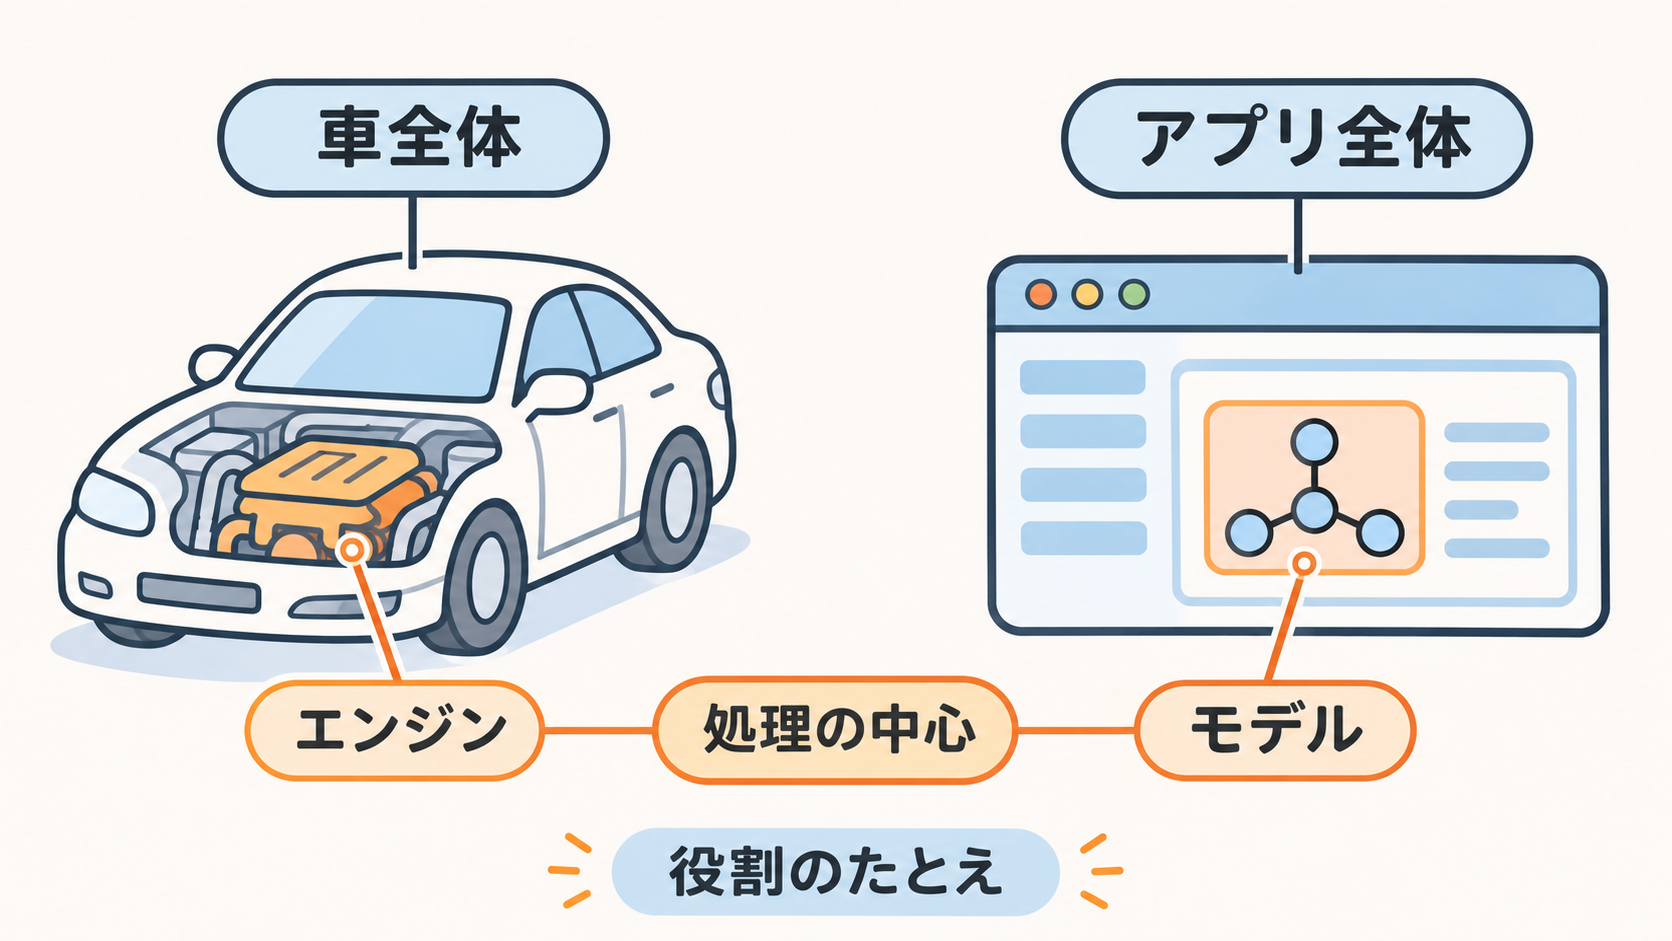
モデルとアプリの関係は、エンジンと車全体にたとえるとつかみやすくなります。車を動かすうえでエンジンは中心的な役割を担いますが、運転する人が使うのはエンジン単体ではありません。ハンドルや座席、計器などを含む車全体です。AIでも、入力を処理するモデルと、利用者が触れる画面や操作をまとめたアプリを分けると、役割の違いが見えてきます。
このたとえは、理解のためのものです。モデルが実際に燃料で動くわけでも、すべてのAIアプリが車の部品と一対一で対応するわけでもありません。Google Cloudは、機械学習を、より広いAIシステムが学習し、適応するためのエンジンに相当するものとして説明しています。ここではその考え方を借りて、「処理の中心」と「利用するための全体」を区別しています。(出典: Google Cloud)
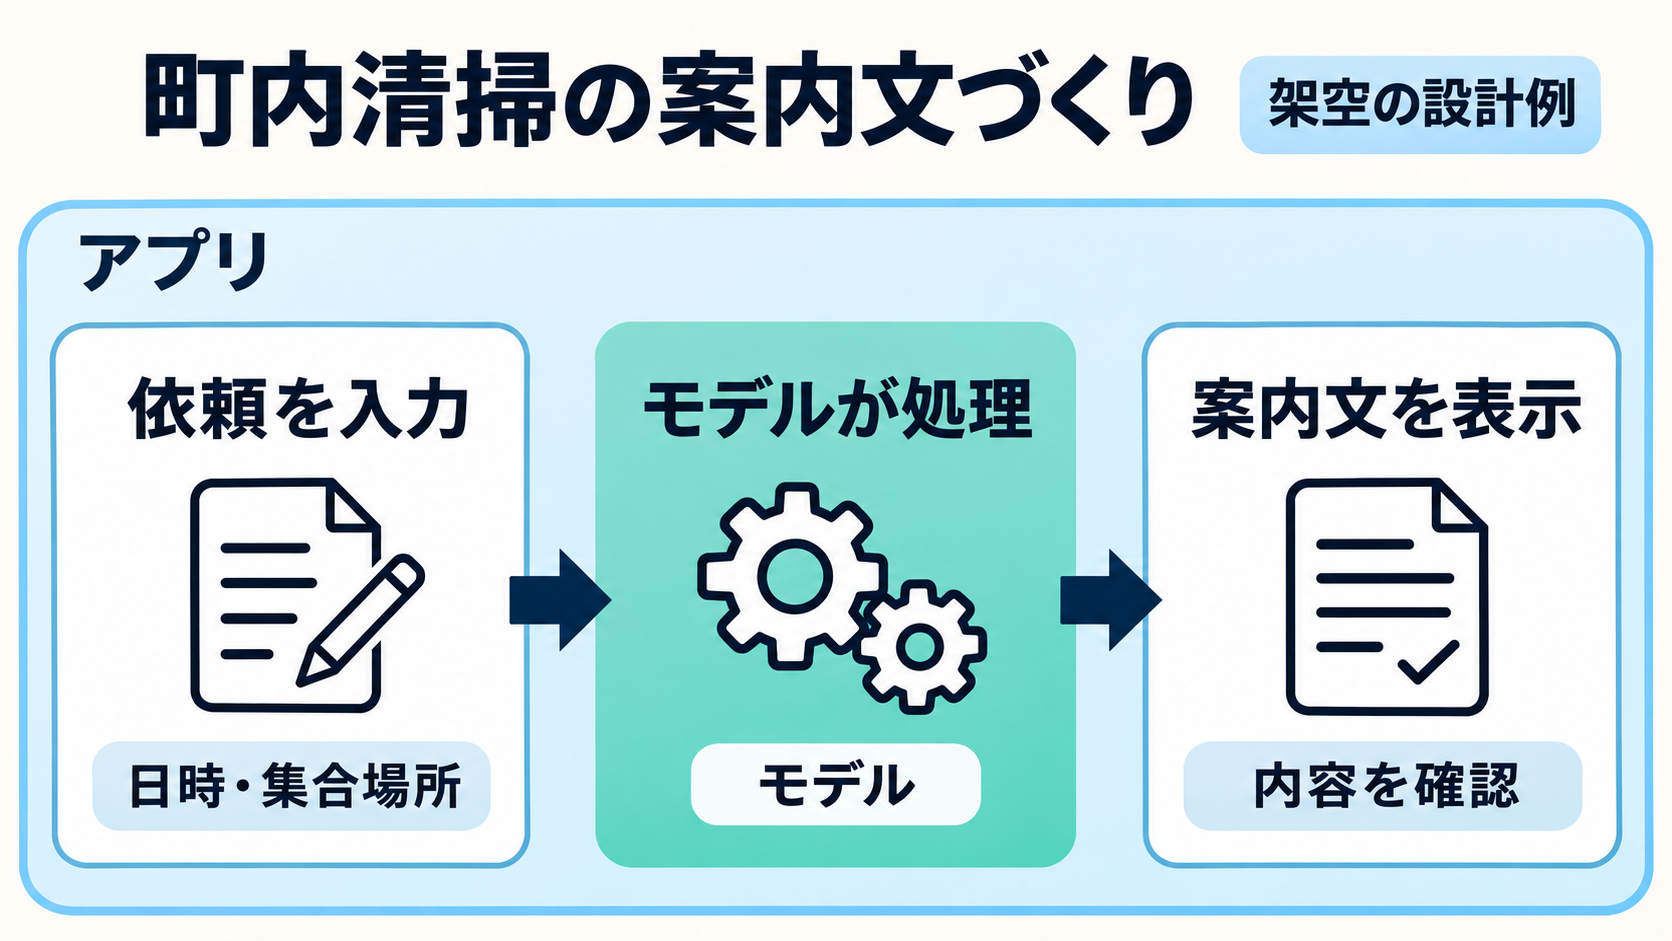
たとえば、架空の文章作成アプリを考えてみましょう。画面には文章の入力欄と、作成を依頼するためのボタンがあるとします。入力された内容をもとに文章を生成する役割をモデルが担い、入力を受け付けたり、結果を読みやすく表示したりする役割をアプリ側が担う、という設計例です。これは説明用の例であり、特定の製品の画面や内部構成を紹介するものではありません。
この区別からわかるのは、使い心地の感想と、モデルの処理に対する感想を分けられるということです。「入力欄が見つけにくい」という困りごとは、画面の設計に関係するでしょう。「作成された文章が依頼した内容から外れる」という場合は、入力内容やモデルの処理を含めて考える必要があります。同じ「使いにくい」でも、どこで困っているかを具体的に伝えられるようになります。
モデルは、データから何を受け取るのでしょうか
モデルの「学習」と聞くと、文章や画像をそのまま大量にしまってある保管庫を想像するかもしれません。しかし、モデルを理解する入口としては、データの特徴や関係が処理に使える形になっている、と考えるほうが適切です。IBMの解説では、生成モデルは学習データの簡略化された表現を取り込み、それをもとに、元のデータと似ていても同一ではない内容を作ると説明されています。(出典: IBM)
ここで「生成AI」は、依頼に応じて文章や画像などの内容を作るAIを指します。モデルという言葉は生成AIだけのものではありませんが、文章を作るアプリを考える場合には、文章生成を担うモデルに注目すると理解しやすいでしょう。IBMは、生成AIアプリの基礎になるモデルとして、文章向けのほか、画像や音声などを扱うものも紹介しています。(出典: IBM)
身近なたとえとして、案内文の書き方を比べる場面を想像してみてください。複数の案内文を見ると、日時を先に伝える書き方や、相手への配慮を添える書き方などに気づけます。モデルの学習も、個々の文章を一枚ずつ取り出す説明より、データに含まれるパターンを処理に生かす説明のほうが近くなります。ただし、人が文章を読んで理解する過程と、計算による学習が同じという意味ではありません。
この見方を持つと、「自然な文章が出てきたのだから、どこかの正しい文章を見つけてきたはずです」という受け止め方を避けやすくなります。生成された案内文に読みやすさがあっても、そこに書かれた開催日や会場名まで、実在する資料で確認されたことにはなりません。文章を組み立てる働きと、個別の事実を確かめる作業は、読者の側でも分けて考える必要があります。
架空の文章作成アプリで見る、入力から回答まで
ここからは、架空のアプリ「お知らせ文づくり」を例に、モデルとアプリの役割を追ってみます。町内の清掃活動を案内する文章を作る、という想定です。この例で示す画面や処理の流れは、理解を助けるための設計例であり、実在するサービスを操作して確かめた手順ではありません。特別な契約や設定を案内するものでもありません。
利用者は、入力欄に「清掃活動のお知らせを、初めて参加する人にも伝わる文章にしてください。日時は○月○日午前○時、集合場所は○○公園です」と書くとします。このようにAIへ渡す依頼や入力を「プロンプト」と呼びます。IBMの解説では、生成AIのモデルは、利用者のプロンプトや要求に応じて文章などを作るものと説明されています。(出典: IBM)
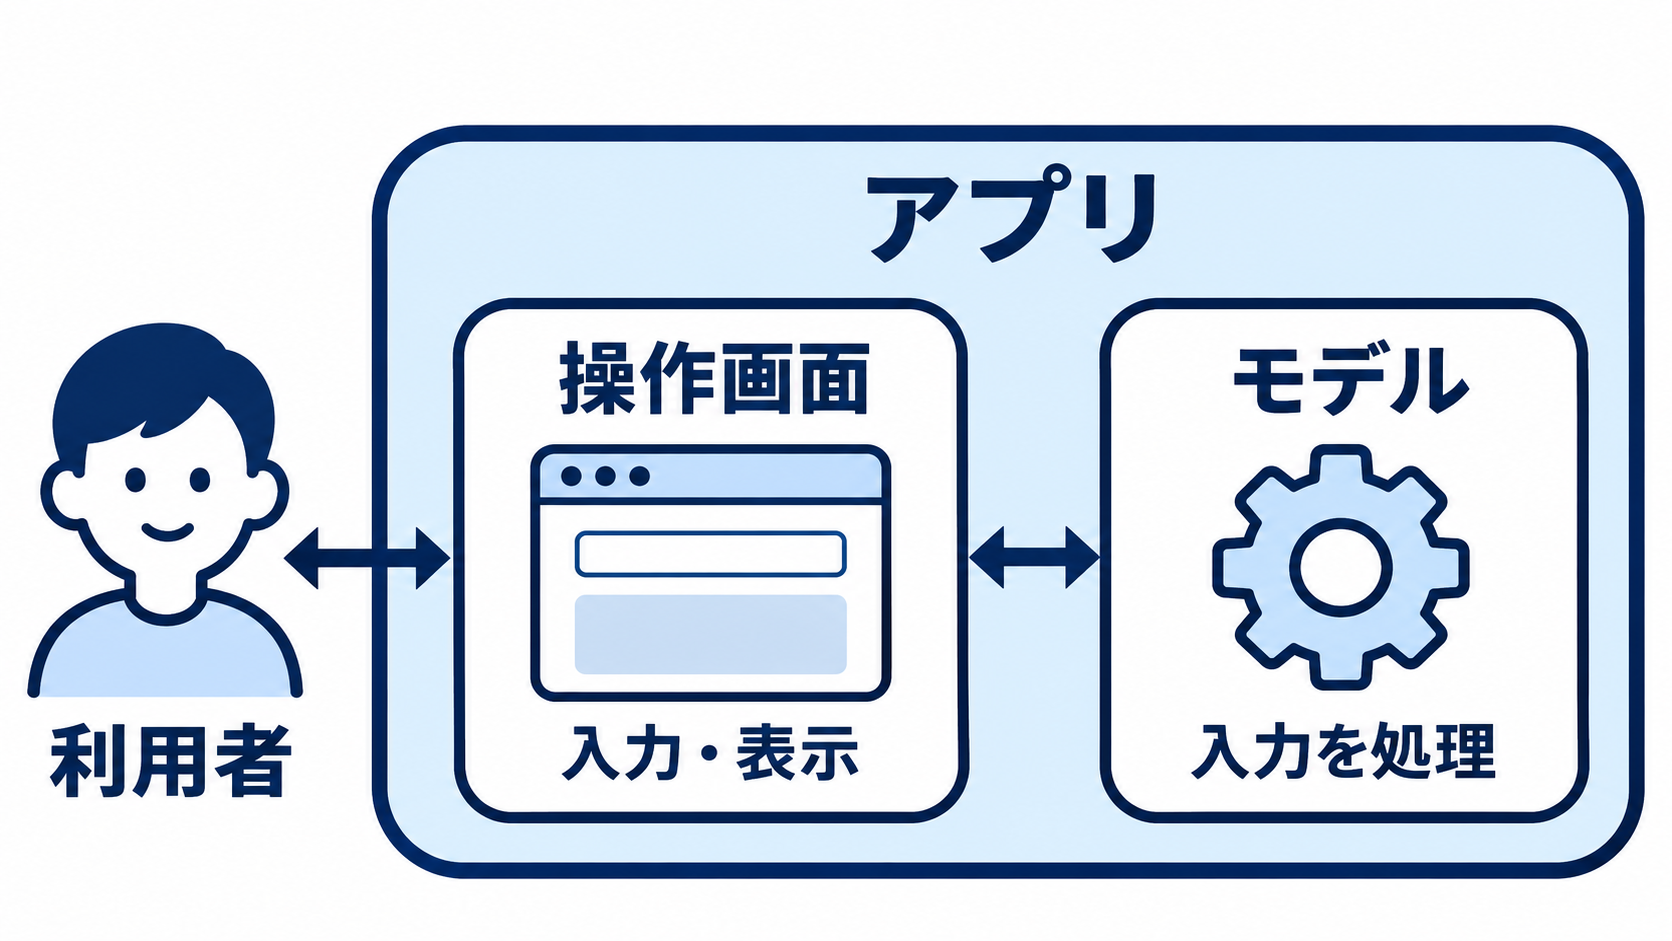
この架空の設計では、アプリが入力を受け付け、モデルがその内容を処理して案内文を生成し、アプリが結果を画面に表示します。利用者から見ると、一つの画面の中で回答が出てきます。そのため、アプリそのものが文章を作る仕組みのすべてだと感じやすいのですが、役割を分けて見ると、画面の奥でモデルが働く関係を整理できます。
もし案内文が堅すぎたら、「小学生の保護者にも読みやすい言葉にしてください」と追加で依頼する方法が考えられます。これは使い方の提案です。Googleの用語集では、チャットの過去のやり取りは、その後の会話の文脈になると説明されています。ただし、会話の中で依頼を補うことと、モデルを作るための学習は区別して考えましょう。Googleは、学習済みのモデルを特定の用途に合わせて追加で学習させる工程を「ファインチューニング」として別に説明しています。(出典: Google for Developers)
「同じモデル」でも、アプリの説明は別に読む理由
モデルの名前がわかると、サービス選びがすべて解決するように感じるかもしれません。しかし、モデルの説明から読み取れることと、アプリ全体の説明から確認することは分ける必要があります。IBMは、生成AIの基礎になるモデルを、複数の異なるアプリの土台となるものとして説明しています。Googleの用語集でも、学習済みのモデルを特定の用途に合わせて調整する考え方が示されています。(出典: IBM、Google for Developers)
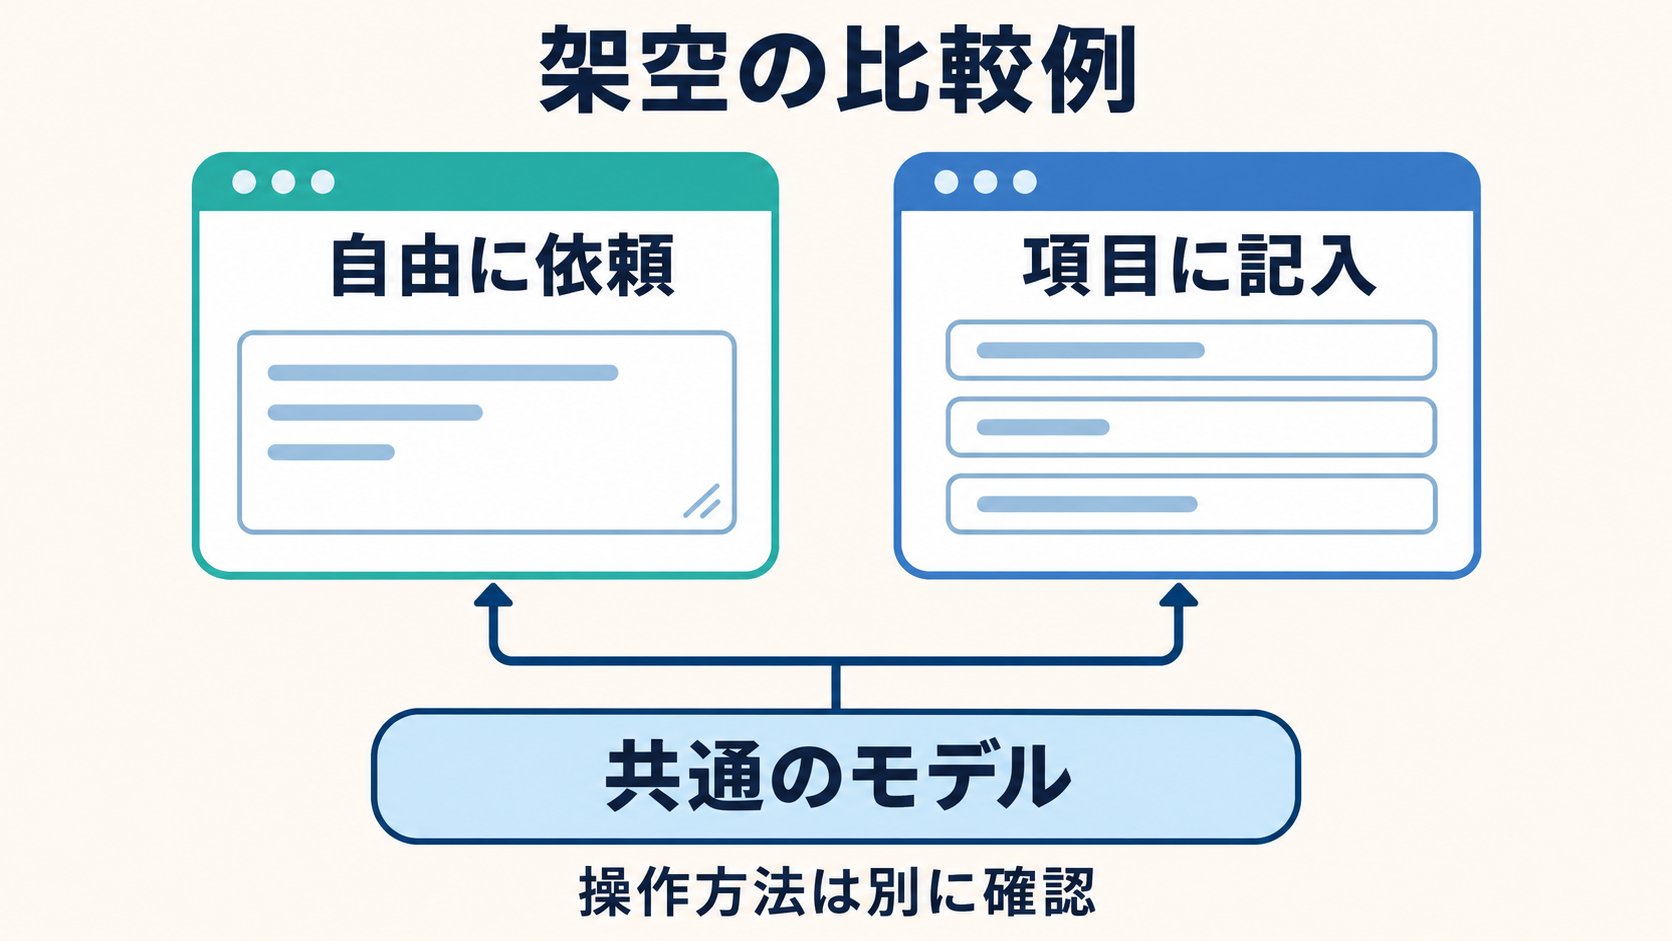
理解のための架空の比較として、同じ土台のモデルを使う二つの文章作成アプリを考えます。一つは自由に依頼文を入力する設計、もう一つは「誰に伝えるか」「何を知らせるか」を順に記入する設計とします。この場合、土台となる処理の仕組みに共通点があっても、利用者が情報を渡す方法は違います。どちらが使いやすいかは、利用者の目的や、入力したい内容によって変わるでしょう。
ここで気をつけたいのは、「このモデルを使っています」という説明だけで、アプリに備わる機能や利用条件まで判断しないことです。たとえば、必要な種類の情報を入力できるか、結果をどのように扱えるかといった点は、そのサービスの説明で確認する項目になります。モデル名は処理の仕組みを知る手がかりですが、サービス全体の取扱説明書にはなりません。
逆に、画面が親しみやすいという理由だけで、生成される文章の事実まで確かだと判断するのも早計です。先ほどの清掃活動の例なら、見るべき点は「案内文を作りやすいか」と「日時や集合場所が正しく書かれているか」で異なります。モデルとアプリを分ける意味は、難しい内部構造を覚えることよりも、使いやすさ、出力内容、利用条件を、それぞれ必要な場所で確かめられるようになることにあります。
次にAIの説明を読むときは、名前を二つに分ける
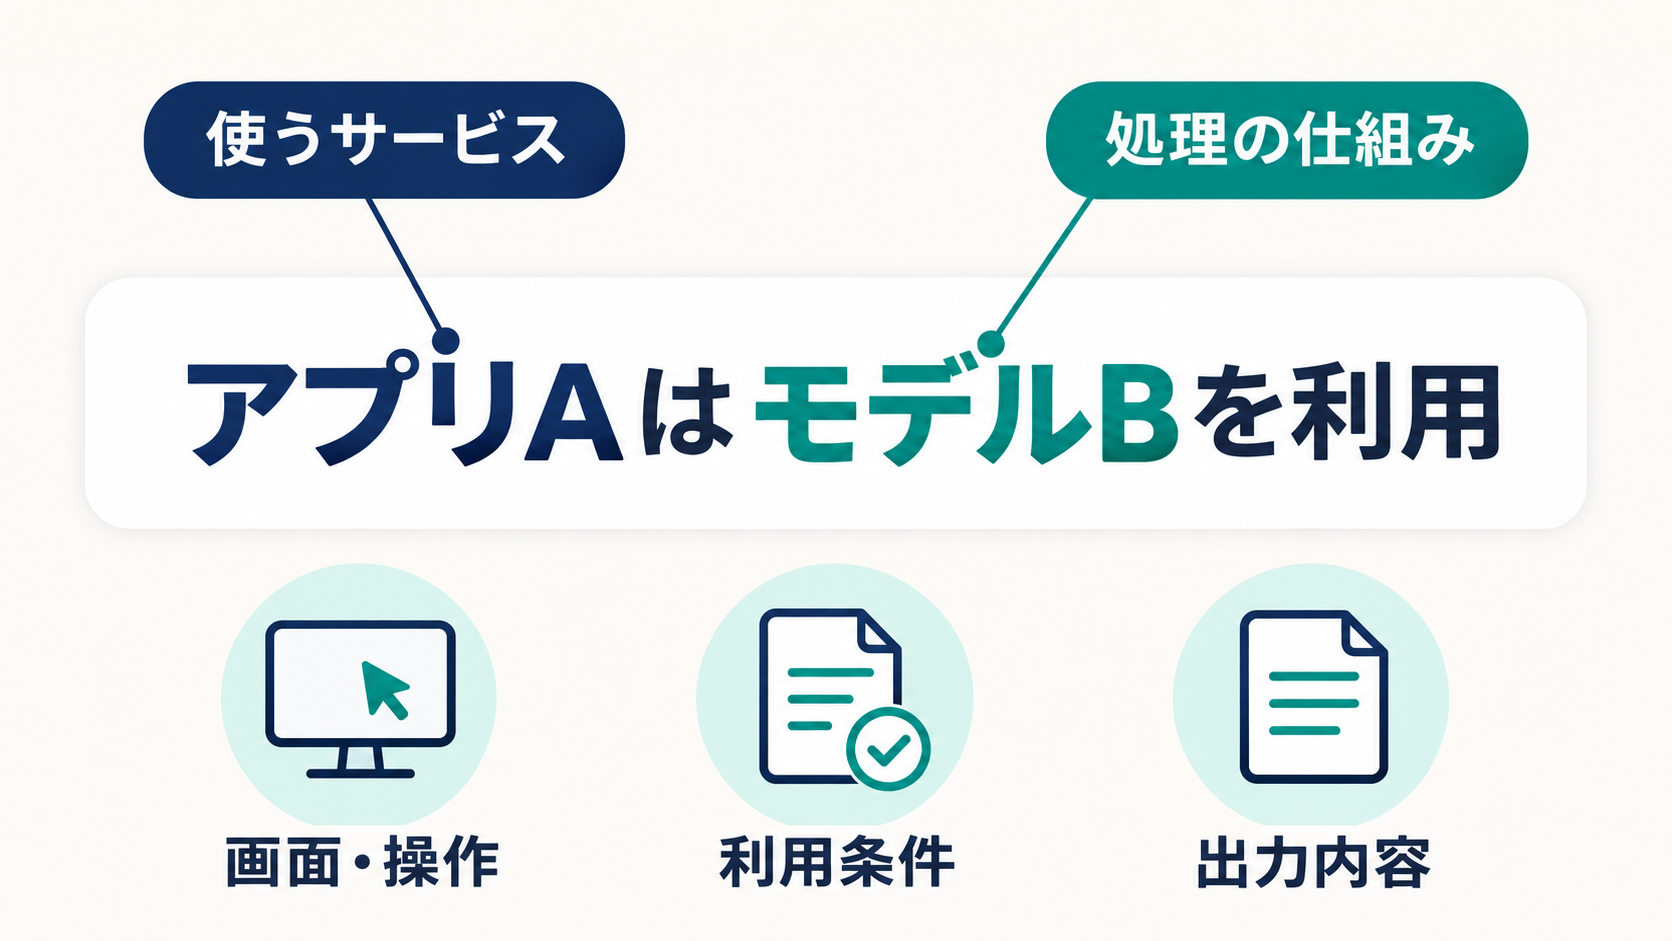
次にAIサービスの紹介を読む機会があれば、そこに出てくる名前を「利用するアプリ」と「処理を担うモデル」に分けてみてください。たとえば、架空の説明文として「文章作成アプリAは、言語モデルBを利用しています」とあれば、普段開くサービスがA、文章を処理する仕組みがBに当たります。名前の形や響きから推測するより、説明文の中で何をするものとして紹介されているかを読むほうが確実です。
紹介文にモデル名が見当たらなくても、無理に推測する必要はありません。書かれている範囲で役割を整理し、判断に必要な情報が足りなければ、そのサービスの公式説明を確認する、という順番で十分でしょう。アプリの名前だけを見て内部のモデルを決めつけたり、モデルの名前だけで使える機能を想像したりしないことが、説明を落ち着いて読む助けになります。
仕事や日常で誰かに相談するときにも、この分け方が役立ちます。「AIがうまく使えません」とだけ伝えるより、「案内文を作るアプリで、入力欄に何を書けばよいか迷っています」「生成された文章の日付を確認したいです」と、困っている箇所を言葉にしてみてください。モデル名を知らなくても、画面の操作、依頼内容、出力の確認を分ければ、相談したいことが具体的になります。これは利用場面への提案です。
この記事で参照した資料は、2026年11月7日に取得されたものです。IBMの記事には2024年8月9日公開、2026年10月2日更新と記載されており、取得日が新しい発表日を意味するわけではありません。(出典: IBM)今回扱ったのも新機能の発表ではなく、説明を読むための基礎です。明日、いつものAIアプリの紹介文を一つ開いたら、「使うための全体」と「処理の中心」がどう書き分けられているかを探してみましょう。