

2026/11/19
AIニュース
Nutrientの文書抽出API、項目ごとの出典と信頼度で業務確認をどう変えるか
この記事の要点
NutrientのData Extraction APIは、抽出値に文書内の位置や照合ラベル、取得できる場合には信頼度を付け、確認作業を支援します。ただし、高い信頼度でも別項目の値を選ぶことがあります。解析と抽出の料金差、ベンチマークの評価範囲、ローカル処理の条件を整理し、自社文書で確認工程まで検証する進め方を紹介します。
目次
抽出した金額を、文書のどこまで戻って確認できるか
請求書から取り出した金額が、実際には隣の列にあった別の金額だったとします。数字として不自然でなければ、後続のシステムはそのまま処理してしまうかもしれません。文書を生成AIで読み取る業務では、値を取得できることに加え、その値がどこから来たのかを確認できる設計が必要です。
文書処理ソフトウェアを手がけるNutrient(旧PSPDFKit)のData Extraction APIは、この確認作業を支える機能を備えています。PDF、スキャン、画像、Officeファイルを解析し、位置情報を含むJSONやMarkdownへ変換します。抽出機能では、利用者が指定したJSONスキーマに合わせて項目を取り出せます。JSONスキーマとは、必要な項目名やデータ型などを定義する、出力の設計図に相当するものです。
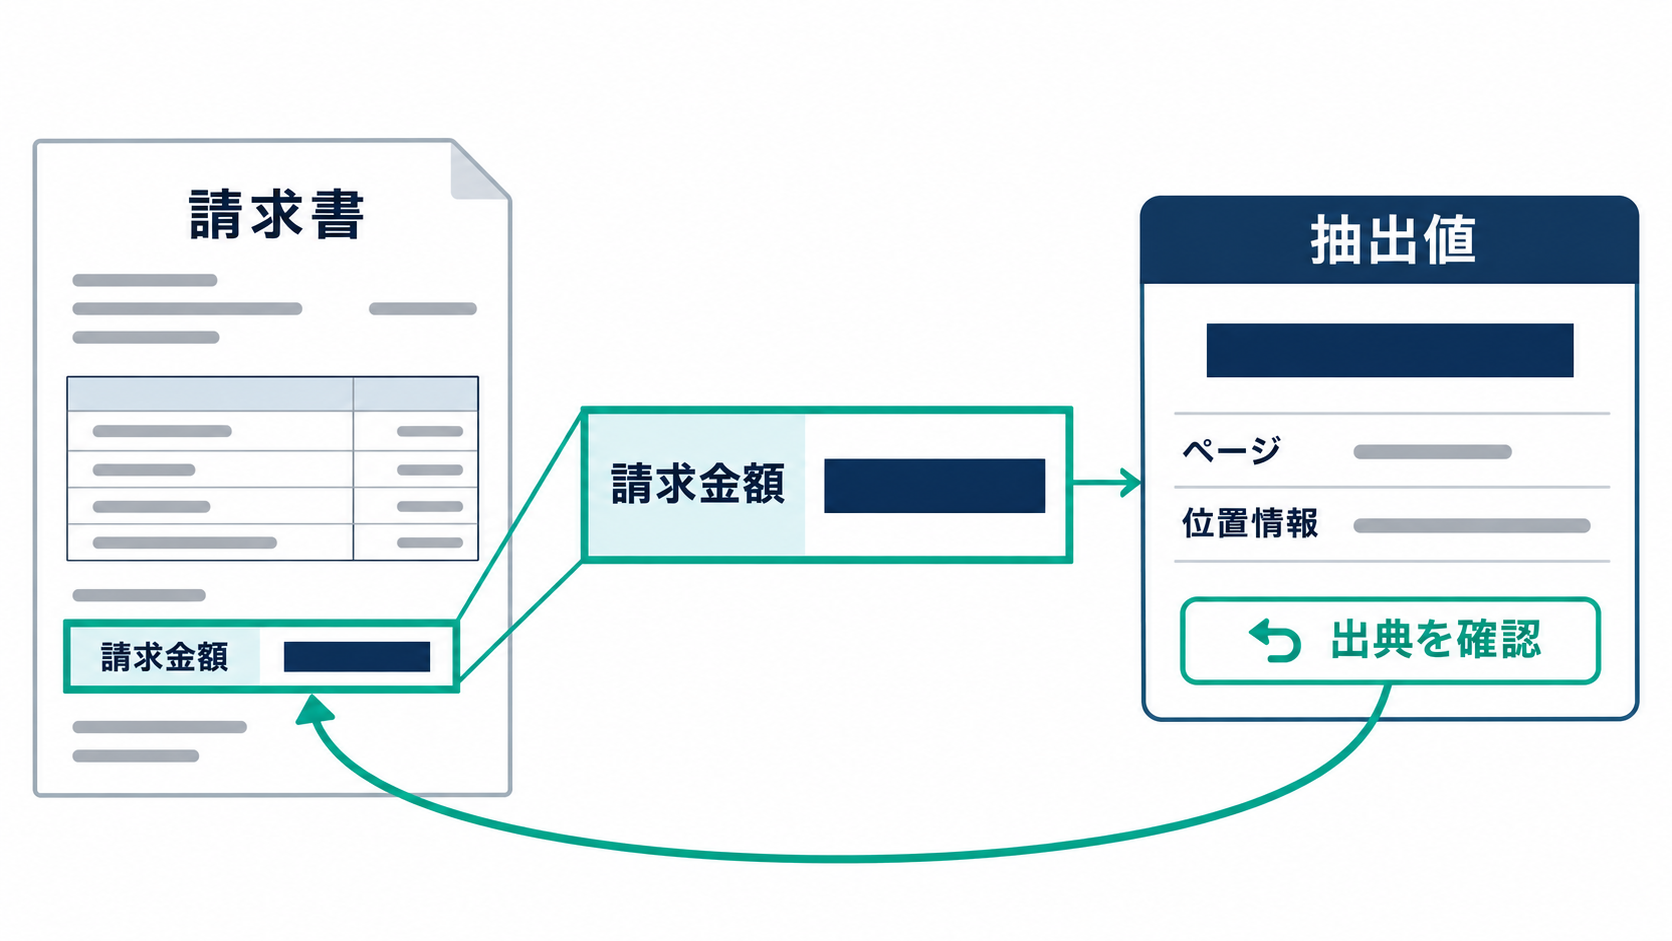
特徴は、抽出した各値にページや矩形領域、照合状態を示すラベル、取得できる場合には信頼度スコアを関連付ける点にあります。例えば請求金額の確認では、出力された数字だけで判断せず、文書内の該当箇所へ戻れるようになります。確認担当者にとっては、誤りを探す範囲を絞れることが実務上の利点でしょう。
ただし、出典を示せることと、業務上の意味まで正しく解釈できることは別です。文書に存在する数字でも、税込総額を求めているのに税抜小計を返せば、目的に合った抽出にはなりません。このAPIを評価する軸は、単純な読み取り精度だけでなく、誤りを発見して人の確認につなげられるかにあります。
信頼度0.97でも、正しい項目とは限りません
Nutrientが紹介している事例には、信頼度が0.97と高くても、別の列から値を取得していたケースがあります。この数字を、そのまま「97%の確率で業務上正しい」と読むことはできません。文書内に根拠があることと、求めた項目に回答していることを分けて考える必要があります。
同社の現在の信頼度スコアは、トークンの確率、候補間の差、文書との根拠の対応、形式への適合といった、利用可能な複数の信号を組み合わせています。根拠との対応を判定するNLIモデルは、Apache-2.0ライセンスで公開されています。NLIは自然言語推論のことで、ここでは抽出値が文書の内容によって裏付けられるかを評価する仕組みに関係します。ただし、裏付けがあっても、別項目の値を選ぶ問題は残ります。
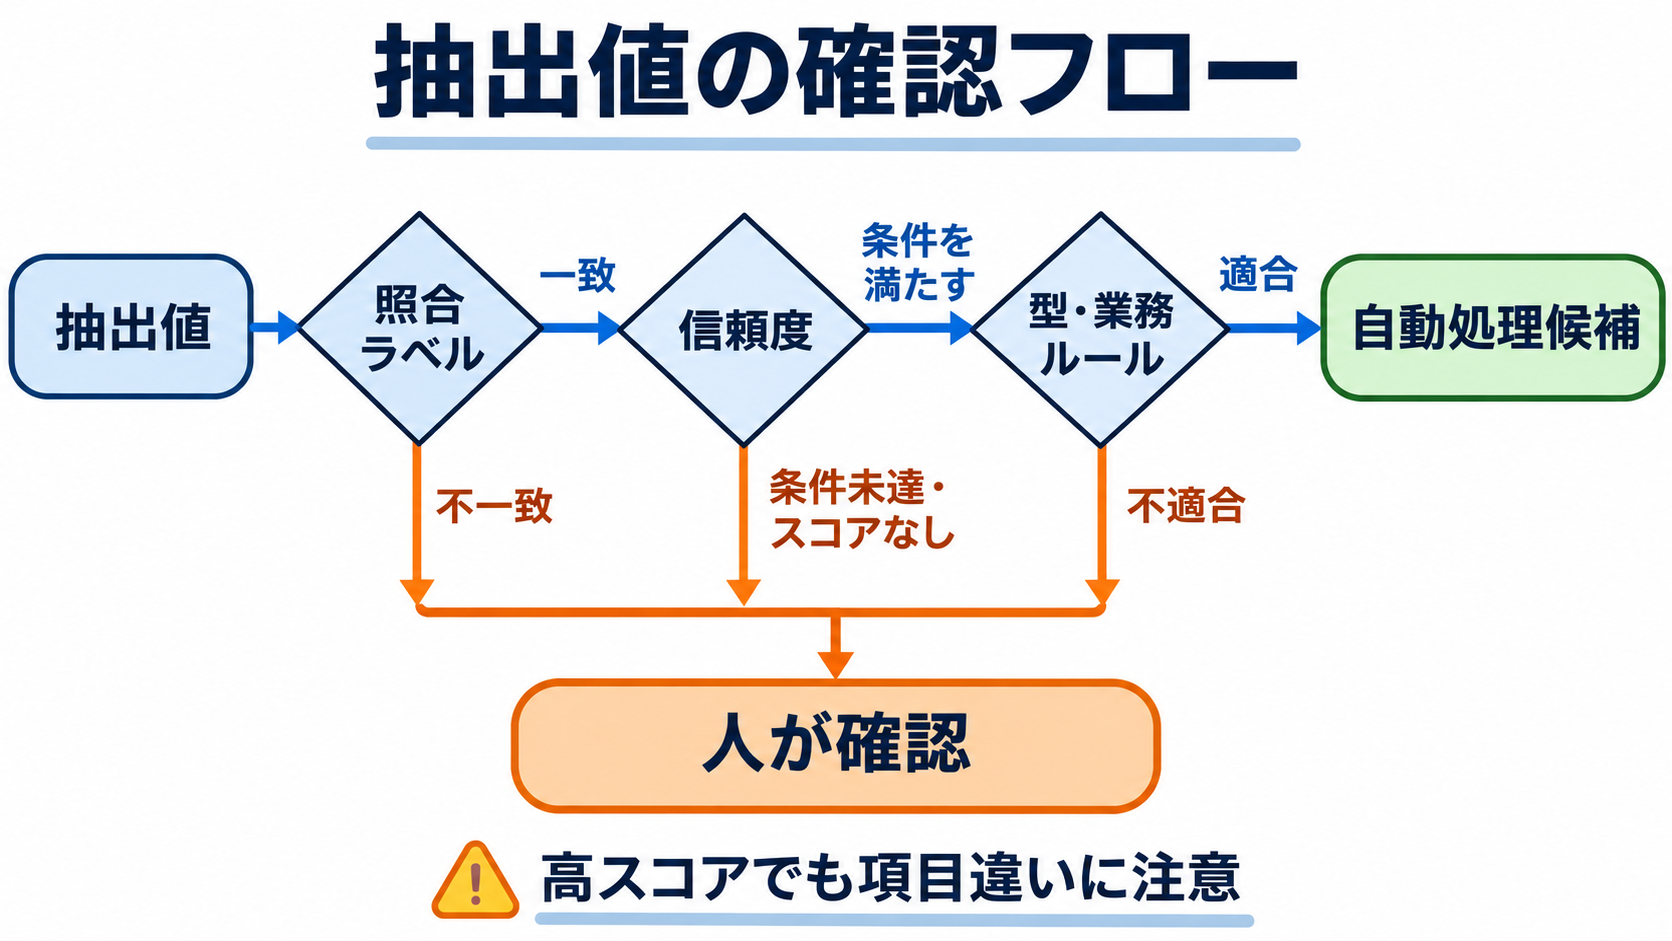
そこで確認したいのが、各項目に付くmatchラベルです。提供されるラベルには、id_match、id_match_multiblock、id_match_partial、fuzzy_match、not_foundがあります。これらは照合の状態を区別する情報で、信頼度とは異なる判断材料になります。紹介されている実装例では、先にラベルを確認し、その後で信頼度のしきい値を適用しています。
この例では、値が存在し、ラベルがid_matchまたはid_match_multiblockで、信頼度が0.97以上の場合に基本確認を通過させます。ただし0.97は例示であり、あらゆる帳票に適した基準ではありません。スコアがない場合も、低い値として返されるのではなく、confidence自体が省略されます。実運用では「未取得」を独立した状態として扱い、型の検証や合計金額の整合性など、業務ルールによる確認を加える必要があります。
解析モードの選択は、抽出料金と分けて考えます
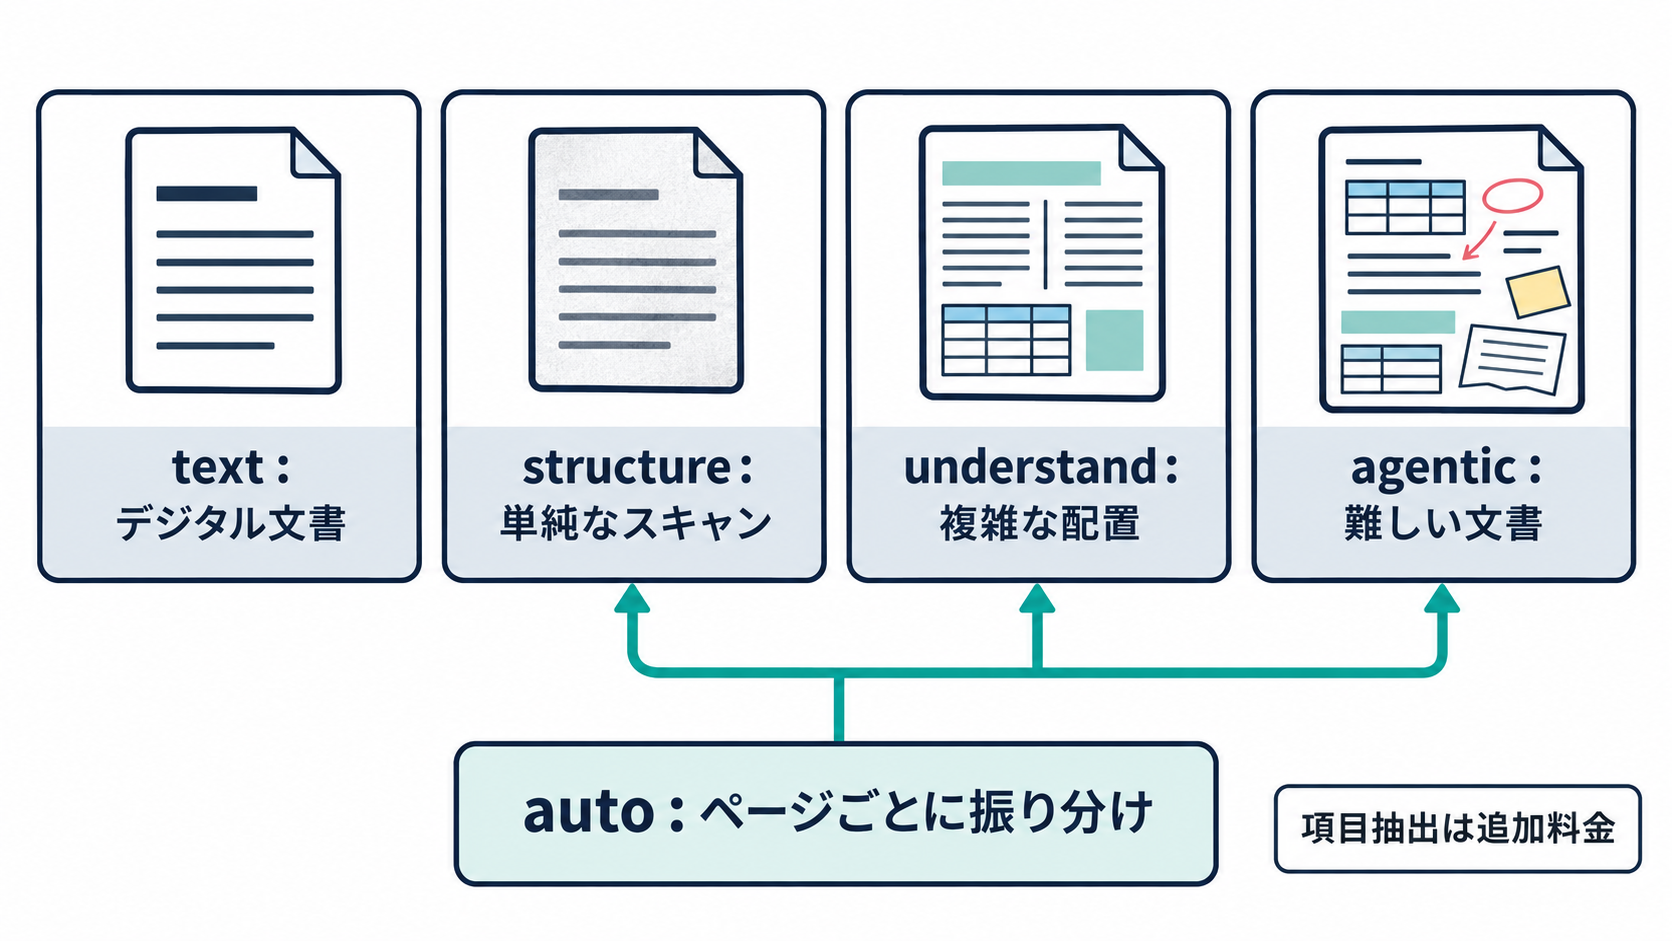
Nutrientは、文書の性質に応じた4種類の解析モードと、自動振り分けを用意しています。textは、スキャンではなく、最初からデジタルデータとして作られたPDFやOfficeファイル向けです。OCRによる文字認識は行いません。structureは、単純なレイアウトのスキャンに対してOCRを利用し、AIによる解析は使わないモードとされています。
understandは、帳票や複雑な配置を対象とするAIレイアウト解析です。agenticは視覚言語モデルを利用し、筆記体、状態の悪いスキャン、グラフなどを対象にしています。autoを指定すると、ページごとにstructure、understand、agenticへ振り分けます。モードを省略した場合の既定値はunderstandです。
2026年11月18日付の紹介で示された1ページ当たりの解析料金は、textが0.001ドル、structureが0.0015ドル、understandが0.009ドル、agenticが0.018ドルです。指定した項目を取り出すExtractには、解析料金に加えて1ページ当たり0.006ドルがかかります。したがってunderstandでの項目抽出は0.015ドル、1,000ページでは15ドルという計算になります。agenticでの項目抽出は0.024ドルです。
ここで注意したいのは、ベンチマークで示されるagenticの1ページ当たり1.8セントが、解析の料金である点です。項目抽出まで含めた見積もりでは、追加料金を織り込む必要があります。難しい文書を扱えるモードを一律に選ぶのではなく、自社の帳票で必要な処理を確認するのが適切でしょう。
業務コストには、人が確認する時間も含まれます。例えば安いモードで確認対象が増えるなら、API利用料だけでは比較できません。逆に読みやすいデジタル文書が中心なら、高度な解析が常に必要とは限らないでしょう。文書の種類ごとに料金と確認作業を測ることが、選定の判断材料になります。
Studioで確かめるのは、設定を変えた後の再現性です
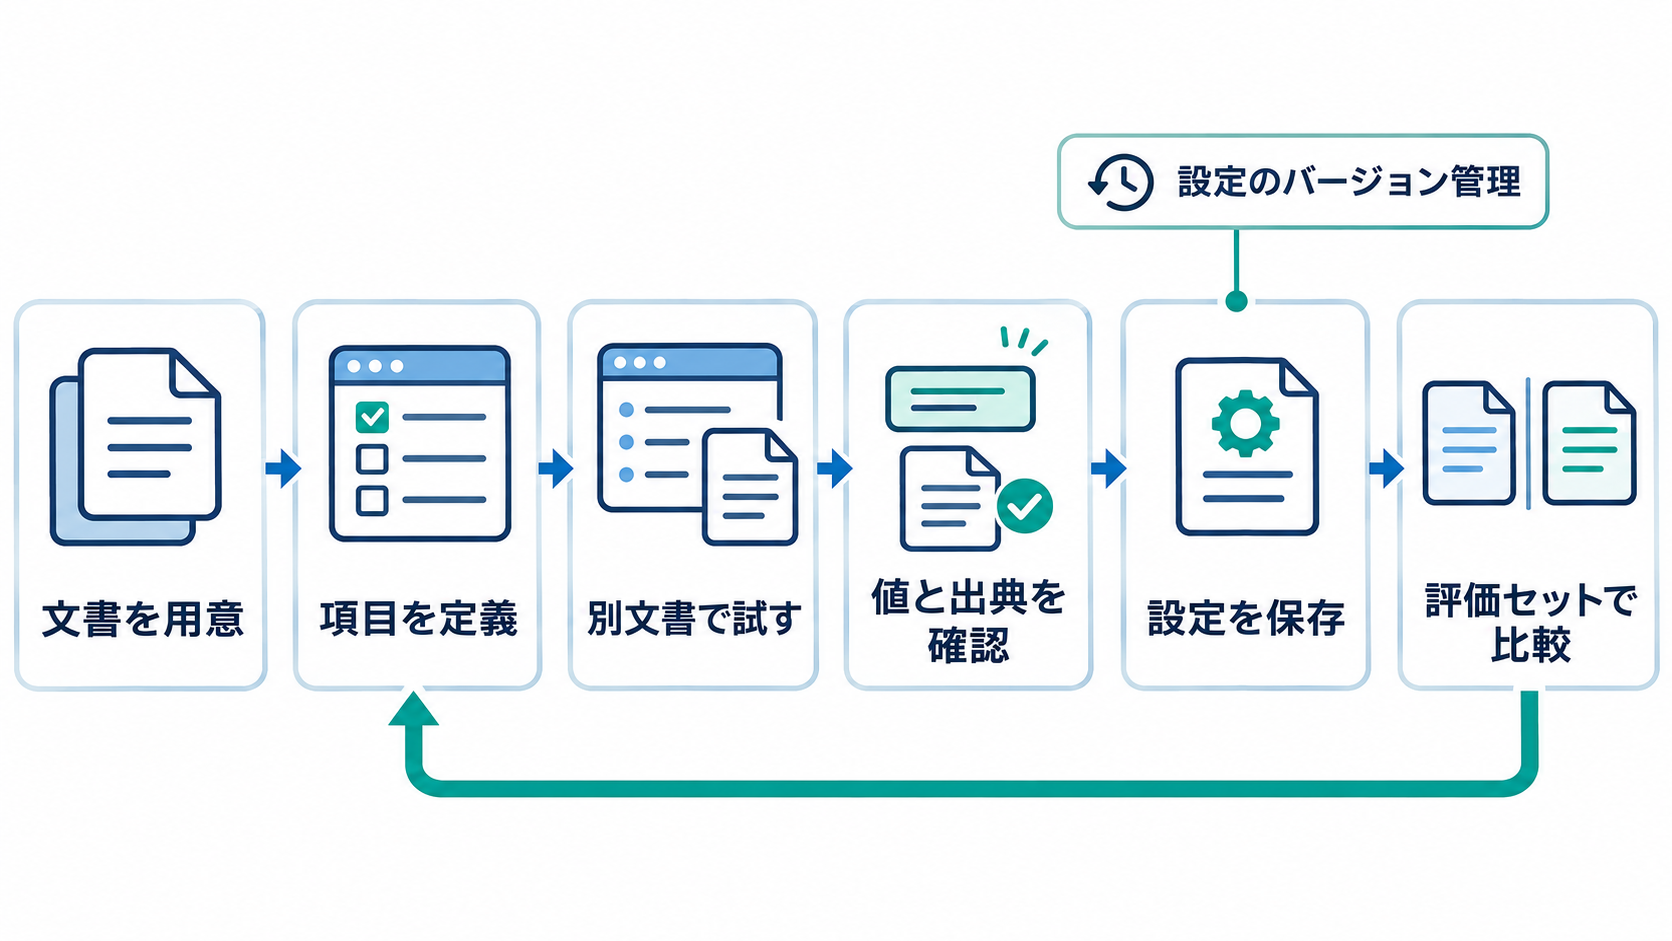
コードを書く前の検証環境として、Nutrientはブラウザ上のStudioを提供しています。自社のファイルを使い、解析、項目抽出、分類、分割、フォーム入力を試せます。抽出項目のスキーマは画面上で作成でき、文書から生成することも可能です。開発担当者がAPI連携を実装する前に、どの項目をどう定義するかを確認できる構成です。
検証では、設定に使った文書とは別の文書を読み込ませ、抽出値と出典の対応を見ます。同じ帳票に合わせて設定を調整し続けるだけでは、別の取引先や別様式で通用するかが分かりません。請求書であれば、項目名だけを指定するのではなく、「税を含む最終合計であり、小計ではない」といった意味の違いを定義に含めることが考えられます。
設定はバージョン付きのプリセットとして保存できます。API上ではprocessorと呼ばれ、proc_で始まるIDを使って呼び出します。Studioでは、確認済み文書を最大25件含む評価セットを使い、プリセットのバージョン間で結果を評価できます。設定変更によって特定の帳票が改善しても、別の帳票が悪化していないかを確かめる用途に向くでしょう。
APIには、文書へラベルを付けるClassifyや、結合されたPDFを文書単位に分けるSplitもあります。複数種類の書類をまとめて受け取る業務では、抽出前の整理に相当する機能です。分類や分割が誤ると後続処理にも影響するため、抽出値だけを評価対象にしない方がよいと考えられます。
日本企業の導入検証でも、正常に読めた例だけを集めるのではなく、確認が必要だった文書を評価セットに残す運用が役立ちます。どの誤りを防ぐために設定を変更したのかが分かれば、担当者が変わっても改善の意図を引き継ぎやすくなります。
総合86.2は、項目抽出の正答率を示す数字ではありません
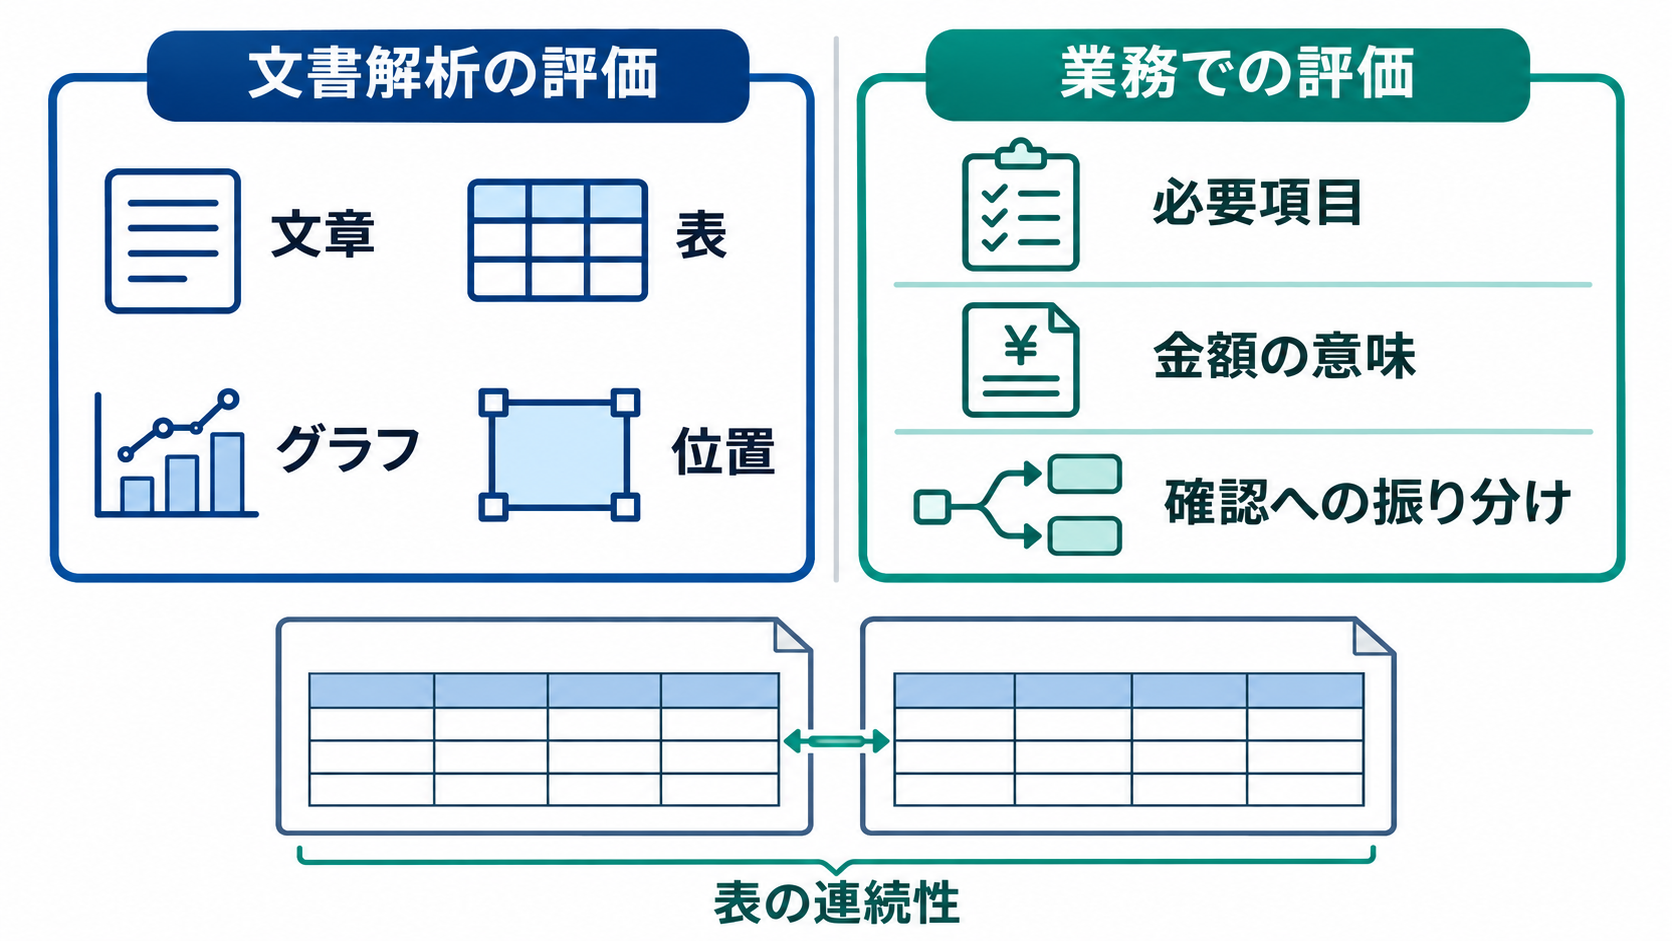
Nutrientは、自社が構築・実施したWholeDoc Benchで、agenticが総合86.2を記録し、19設定の中で首位だったと報告しています。対象は480文書、30以上の言語、7領域です。2026年11月5日時点の結果では、understandの総合スコアは80.8でした。ただし、これは文書解析の評価であり、請求番号や請求金額などを指定して取り出す項目抽出の正答率ではありません。
WholeDoc Benchが見るのは、単一ページだけでなく文書全体の処理です。特にページをまたぐ表の連続性が課題として示されています。複数ページに続く表を含む44文書では、19設定のうち15設定が、表を一続きに保持することにほとんど成功しなかったとされています。ページごとの文字認識ができても、表全体の構造が保たれるとは限らない点は、業務上も見逃せません。
agenticの内訳は、表が87.1、グラフが64.5、位置が88.6です。総合値だけを見ると、文書の種類による得意不得意を捉えにくくなります。グラフを多く含む資料と、表が中心の帳票では、確認すべき失敗の種類も変わるでしょう。自社で必要なのが文章の再構成なのか、表の保持なのか、特定項目の抽出なのかを整理して読む必要があります。
評価の公開範囲にも留意が必要です。主要なテストセットは非公開で、公開サンプルは10文書です。評価コードはApache-2.0で公開されていますが、利用者が全条件を追試できる構成ではありません。また、今回の製品紹介はスポンサー付きで公開されています。
これらの条件を踏まえると、86.2という値は候補を絞る手掛かりとして扱うのが適切でしょう。導入判断では、自社文書で必要項目が正しく得られる割合に加え、誤りを確認工程へ回せるかまで測る必要があります。総合スコアの高さと、誤った支払金額を通さないことは、別の評価課題です。
導入の第一歩は、文書の処理場所と確認条件を決めることです
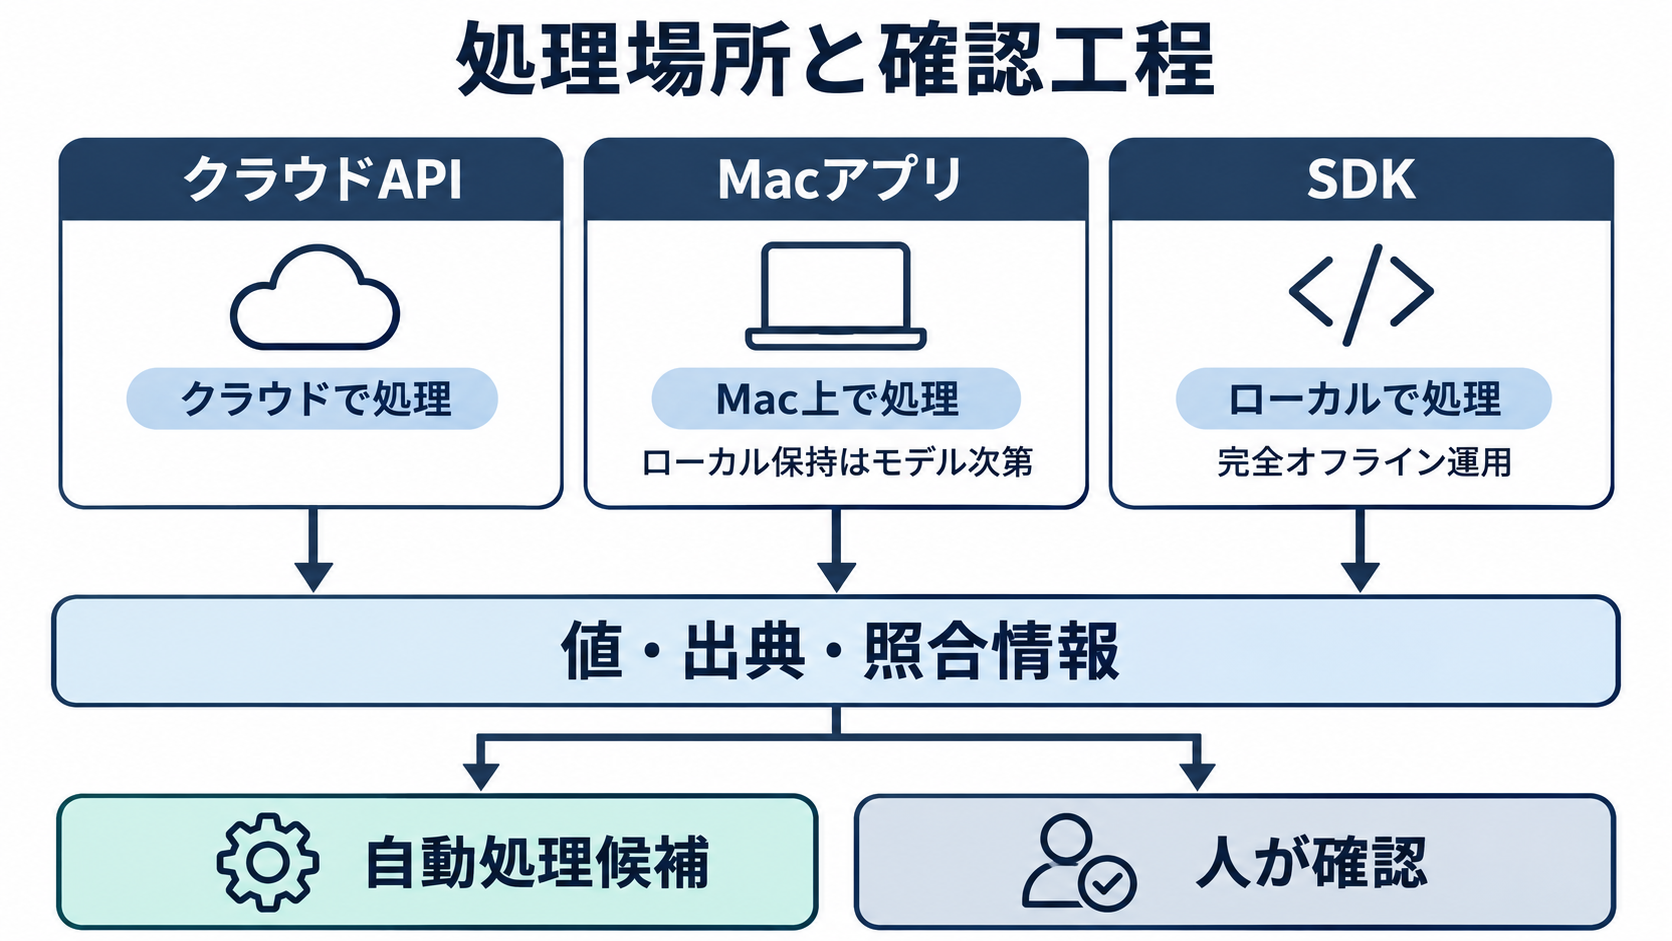
Nutrientは、クラウドAPIに加え、MCPサーバー、エージェント向けスキル、Macアプリ、SDKという利用経路を提供しています。MCPは、AIエージェントが外部のツールを利用するための接続規格です。文書処理をエージェントの作業に組み込めますが、接続できることだけで業務上の確認が完了するわけではありません。
ホスト型MCPサーバーはAPIキーを必要とせず、ClaudeやCodexではOAuthによる認証にも対応しています。この経路では、既定のagenticモードによる解析料金が1ページ当たり0.018ドルとされています。エージェントに処理を任せる場合も、利用モードと対象ページ数を把握できるようにしておくことが、費用を見積もる前提になります。
機密文書を扱う企業では、処理場所の確認が先に来ます。Macアプリで文書がローカルにとどまるのは、ローカルモデルを使う場合です。Mac上のアプリを使うことだけでは、端末内で処理が完結する条件を満たしません。完全オフラインの本番運用にはSDKが必要とされています。クラウド利用、社内サーバー、Appleシリコン搭載Macという選択肢を、自社の文書管理条件に照らして選ぶ必要があります。
導入候補として試すなら、対象を一種類の帳票と、判断に直結する少数の項目に絞ると検証しやすくなります。例えば請求書であれば、請求番号と税込総額について、出典の位置、照合ラベル、信頼度の有無、業務ルールへの適合を確認します。そのうえで、自動処理を認める条件と、人に回す条件を定義する進め方が考えられます。
最初に決めたいのは、一律の信頼度しきい値ではありません。自社で見逃せない誤りを選び、その誤りが起きた文書をStudioの評価セットに含めることです。出典情報と信頼度を、実際の確認判断につなげられるかを確かめるところから着手できます。
参考情報
Nutrient Data Extraction API: JSON Matching Your Schema With Per-Field Citations and Confidence
2026年11月18日公開のスポンサー付き記事です。料金・機能は同記事の紹介内容、ベンチマークは2026年11月5日時点の報告に基づきます。