
2026/11/04
AIニュース
Tencent「WeVisOne-VL」が画像認識を一体化、検出・OCR・切り抜きを1モデルで処理
この記事の要点
TencentのWeChat Visionチームが、検出、OCR、カウント、セグメンテーション、アルファマッティングを一つに統合した視覚言語モデル「WeVisOne-VL」を公開しました。高密度検出などで強い結果を示す一方、対象が存在しない場合の拒否性能や必要GPUメモリーには、導入前に検証すべき課題が残っています。
目次
画像認識パイプラインを一つにまとめるWeVisOne-VL
商品画像の文字を読み取り、写っている物体を数え、人物だけを背景から切り抜く場合、従来はOCR、物体検出、セグメンテーションなどのモデルを組み合わせる構成が一般的です。TencentのWeChat Visionチームが公開した「WeVisOne-VL」は、こうした処理を単一の視覚言語モデルで扱うことを狙っています。モデルは約24.4億パラメータの2B版と約48.3億パラメータの4B版が用意され、いずれもAlibaba系の視覚言語モデルQwen3-VLを基盤としています。
対応するのは、物体検出、指定対象の位置特定、個数のカウント、点による位置指定、OCR、セグメンテーション、アルファマッティングです。アルファマッティングとは、髪の毛や半透明部分を含む境界を連続的な透明度として表現する処理を指します。単純な領域分割よりも、人物や商品の自然な切り抜きに向いた出力です。
注目すべき点は、機能の数そのものより、座標からピクセル単位の出力までを同じモデル内でつないだ設計にあります。マスクとアルファマットは960万パラメータの小型ピクセルデコーダーが生成するため、別のSAM系セグメンテーションモデルを後段に置く必要がありません。実運用で期待できるのは、単なるモデル数の削減ではなく、モデル間で座標や画像特徴を受け渡す処理を整理できることです。ただし、既存システムをそのまま置き換えられるかは、精度だけでなく速度、メモリー消費、対象画像との相性を含めて判断する必要があります。
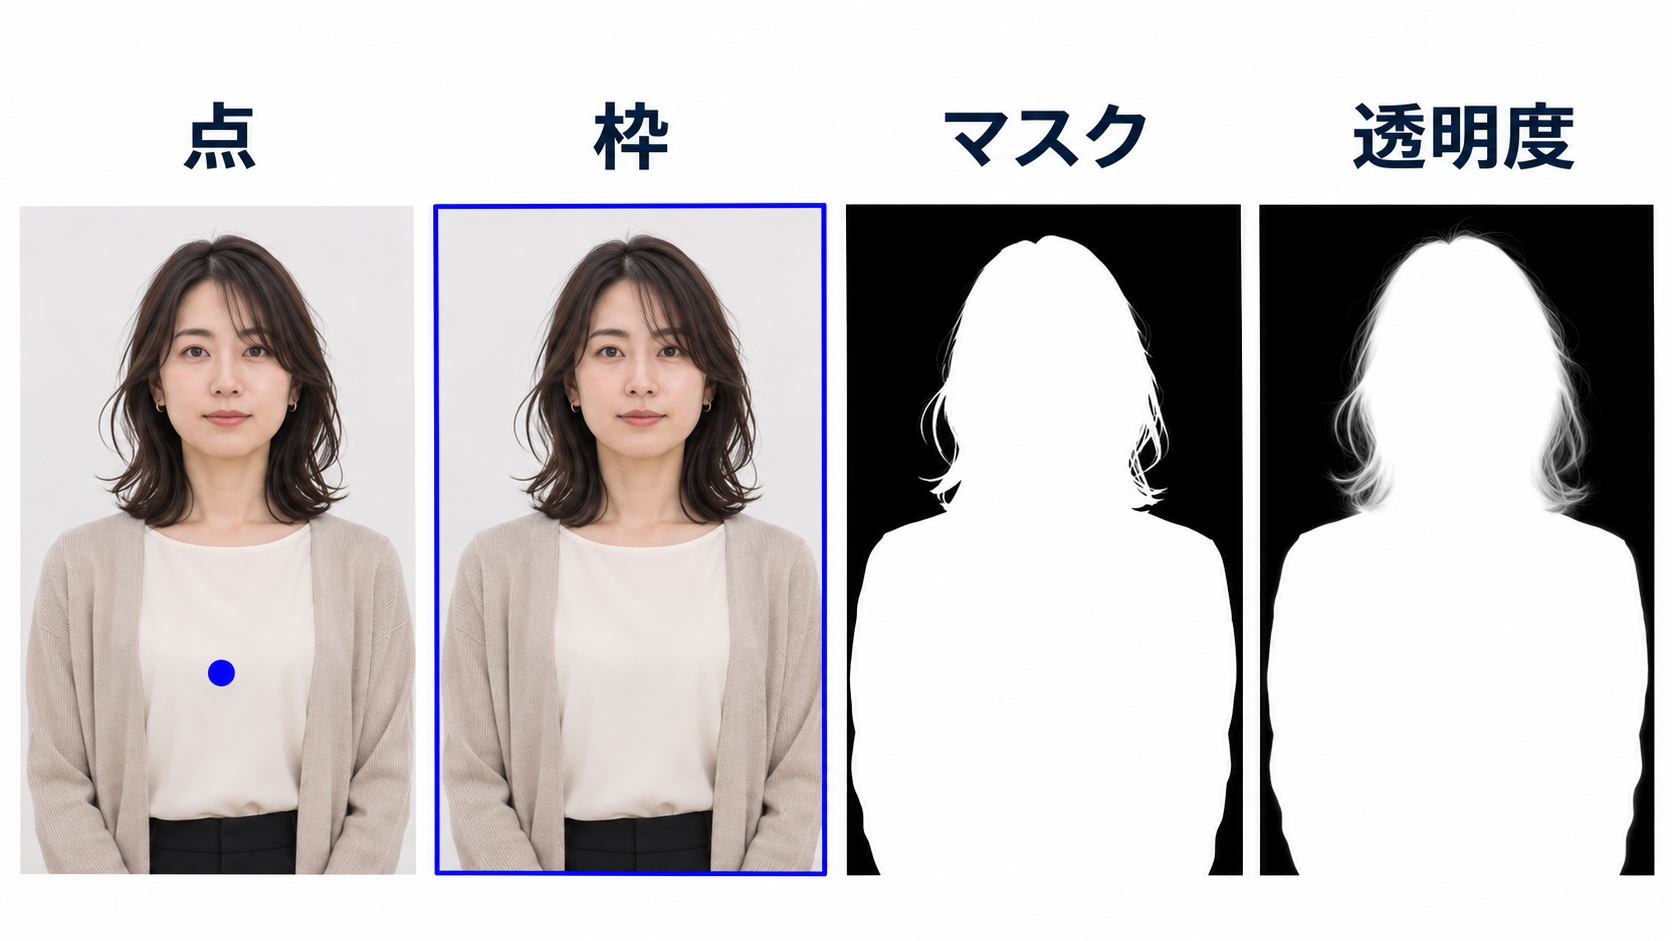
点・枠・マスクを使い分ける出力設計
WeVisOne-VLは、自由な対話よりも画像内の対象を細かく特定する知覚処理に重点を置いています。同じ画像と指示を入力しても、用途に応じて点、矩形の枠、二値マスク、連続的なアルファマットを選べます。店舗の棚で商品のおおよその位置を得るだけなら枠、クリック位置を決めるなら点、画像編集や合成に使うならマスクまたはアルファマットという使い分けが考えられます。
| 出力形式 | 表現する内容 | 想定しやすい用途 |
| --- | --- | --- |
| 点 | 対象を代表する画像上の位置 | 画面操作や対象位置の指示 |
| 矩形枠 | 対象を囲む範囲 | 物体検出や個数確認 |
| 二値マスク | 対象と背景をピクセル単位で分離 | 領域抽出や画像解析 |
| アルファマット | 境界を連続的な透明度で表現 | 人物や商品の自然な切り抜き |
業務利用で見逃せないのが、指定された対象が画像内に存在しない場合に「None」を返す仕組みです。通常の位置特定モデルが存在しない対象にも枠を出すと、その後の在庫判定や検査処理まで誤作動するおそれがあります。何も出力しない判断は、正しい位置を示す能力と同じくらい重要でしょう。
もっとも、拒否機能が設けられていることと、常に正しく拒否できることは別です。Tencentの社内評価では高い拒否率が報告されていますが、PR-Benchでは拒否率が52.6%にとどまり、存在しない対象に枠を返すケースが残りました。対象物の種類や質問の表現によって結果が変わる可能性があるため、自社データでは正常画像だけでなく「対象なし」の画像も評価セットへ入れる必要があります。
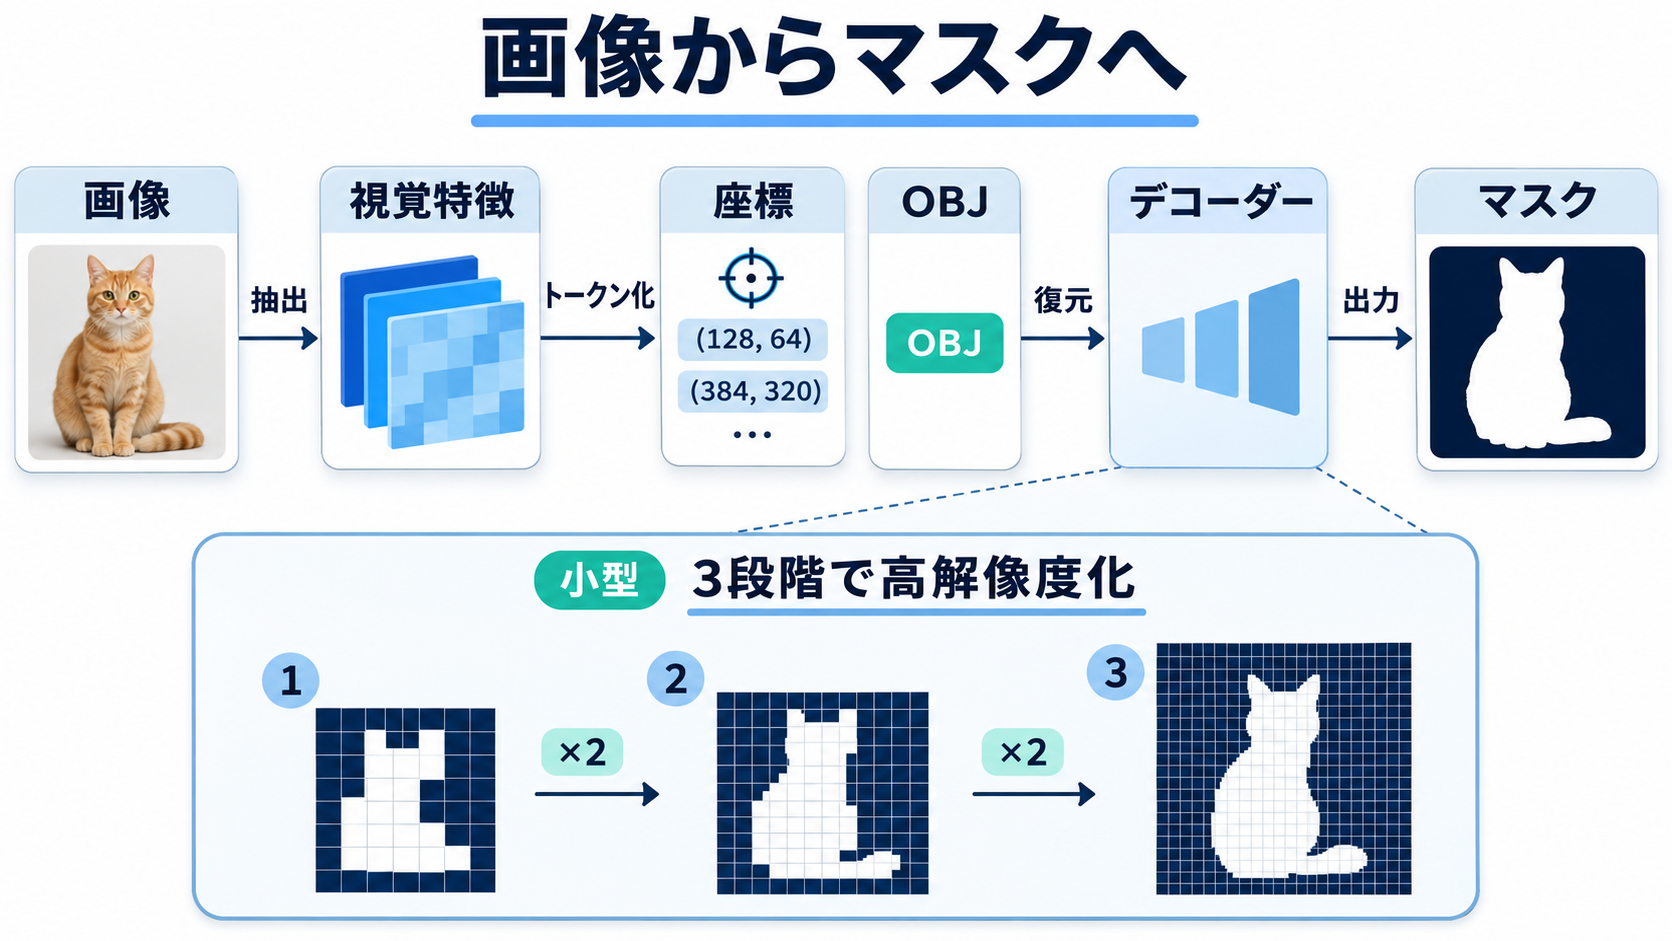
座標トークンと小型デコーダーをつなぐ仕組み
モデル内部では、検出や位置指定を構造化された次トークン予測として扱います。画像内の座標は0から1000までの専用トークンに正規化されるため、点や矩形枠を文章生成と共通の枠組みで出力できます。画像サイズが異なっても同じ座標表現を利用でき、対象がなければ座標の代わりに「None」を生成する構成です。
セグメンテーションやマッティングでは、予測した枠の後に専用のOBJトークンを出力します。その隠れ状態と矩形情報がピクセルデコーダーへの問い合わせとして渡され、対象領域が画像と同じ解像度まで復元されます。言語モデルが直接すべてのピクセル値を並べるのではなく、対象を示す内部表現を小型の専用デコーダーへ橋渡しする設計と理解すると分かりやすいでしょう。
ピクセルデコーダーは三つの要素で構成されます。Visual Feature AdapterはQwen3-VLの画像エンコーダーが持つ複数階層の特徴を再利用し、別の画像エンコーダーを追加しません。Box-Guided Query Decoderは、OBJトークンの状態と予測枠を起点に、6層の変形可能なクロスアテンションで対象を追います。Dense Prediction Headは、段階的に解像度を上げながらマスクまたはアルファマットを仕上げます。
この構造により、言語的な指示とピクセル単位の出力を同じモデル内で結び付けています。ただし、960万パラメータという小ささだけで処理負荷全体を判断することはできません。基盤となる2B版または4B版の推論、画像トークン数、入力解像度も速度やGPUメモリー使用量を左右するためです。
100M超の画像を使った段階的な学習工程
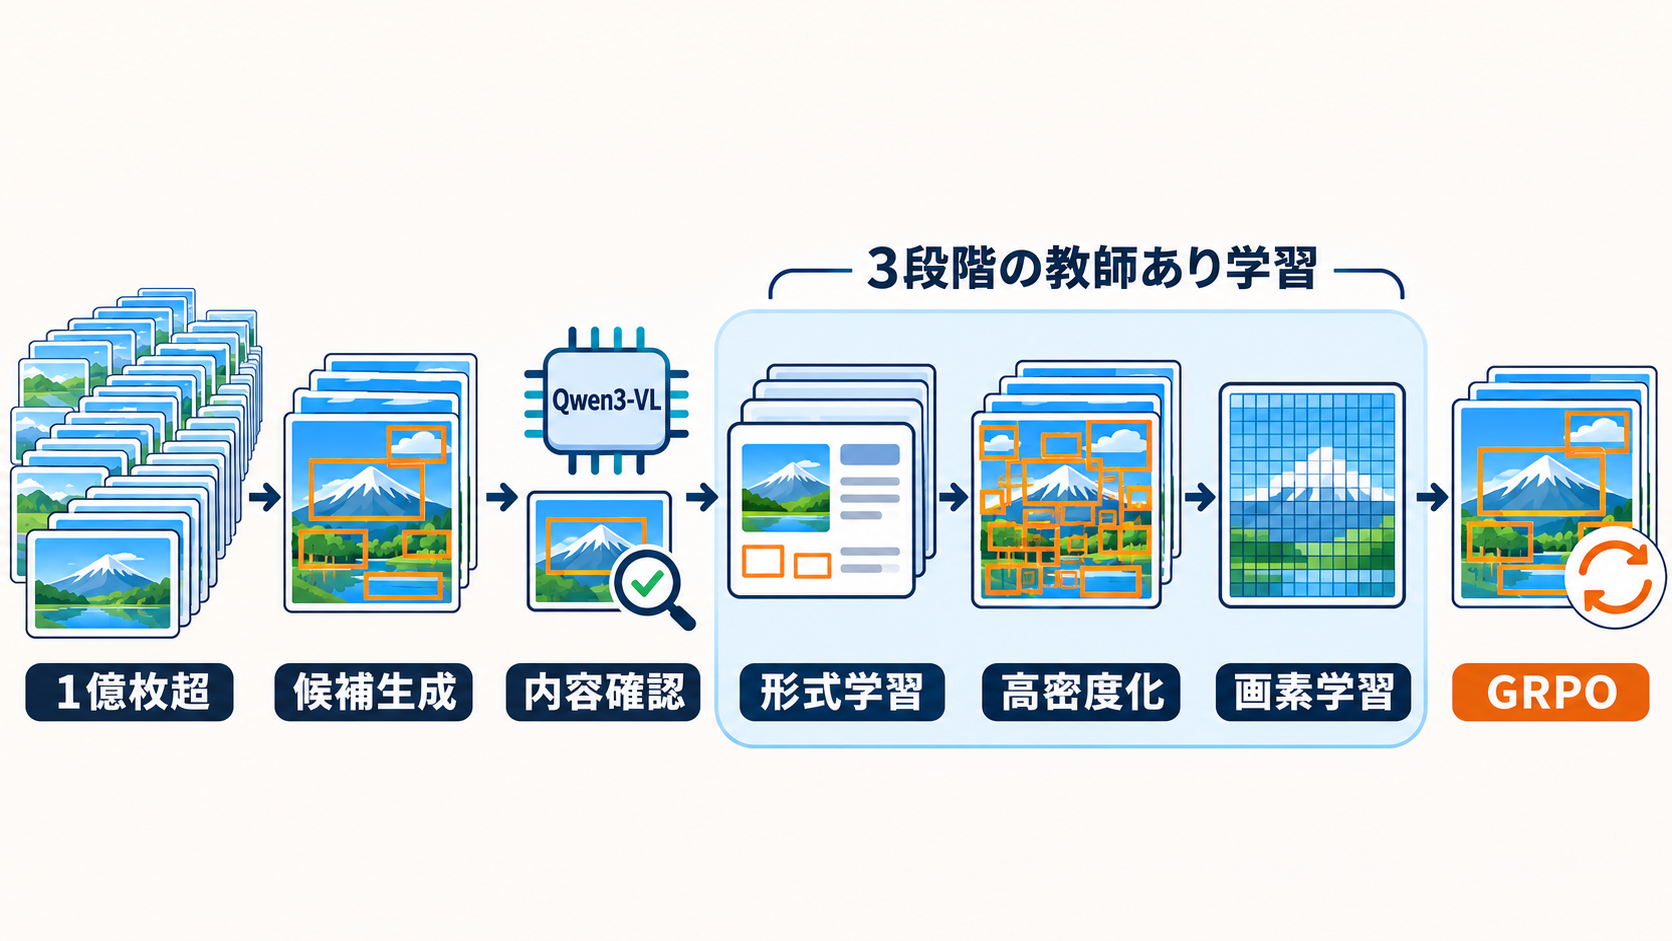
Tencentは、知識グラフを利用したデータ生成基盤によって、1億枚を超える画像に約36億個の矩形枠を付与したと説明しています。領域候補の作成にはSAM3、Rex-Omni、社内開発の検出器を使い、Qwen3-VLで内容を検証しました。複数のモデルを利用して候補生成と確認を分担することで、大規模な教師データを構築した形です。
学習は、教師ありファインチューニングを三段階に分けています。第1段階では9000万件の例を用い、点や枠などの出力形式をそろえました。第2段階では、1画像当たりの入力を最大1960個の視覚トークンへ引き上げ、1回の応答で最大500個の枠を扱えるようにしています。対象が密集する画像を処理するには、一つの物体だけでなく、多数の候補を一定の形式で出す能力が欠かせません。
第3段階ではピクセルデコーダーを学習し、その後、1億3000万件のサンプルを使ってマッティング向けに特化させました。仕上げには、判断の不確実性で選別した17万8000件の例を用いるGRPO段階が加えられています。GRPOは強化学習系の最適化手法で、ここでは出力の調整に利用されています。
これらの規模はモデル開発の背景を理解する手掛かりになりますが、データ量だけで特定業界への適合性は決まりません。製造現場の微細な傷、医療画像、縦書きの日本語、独自フォントの帳票などは、一般画像とは対象や評価基準が異なります。企業が導入を検討する際は、大規模学習済みであることを出発点とし、自社画像でどの失敗が起きるかを確認する姿勢が求められます。
ベンチマークで見える強みと拒否性能のばらつき
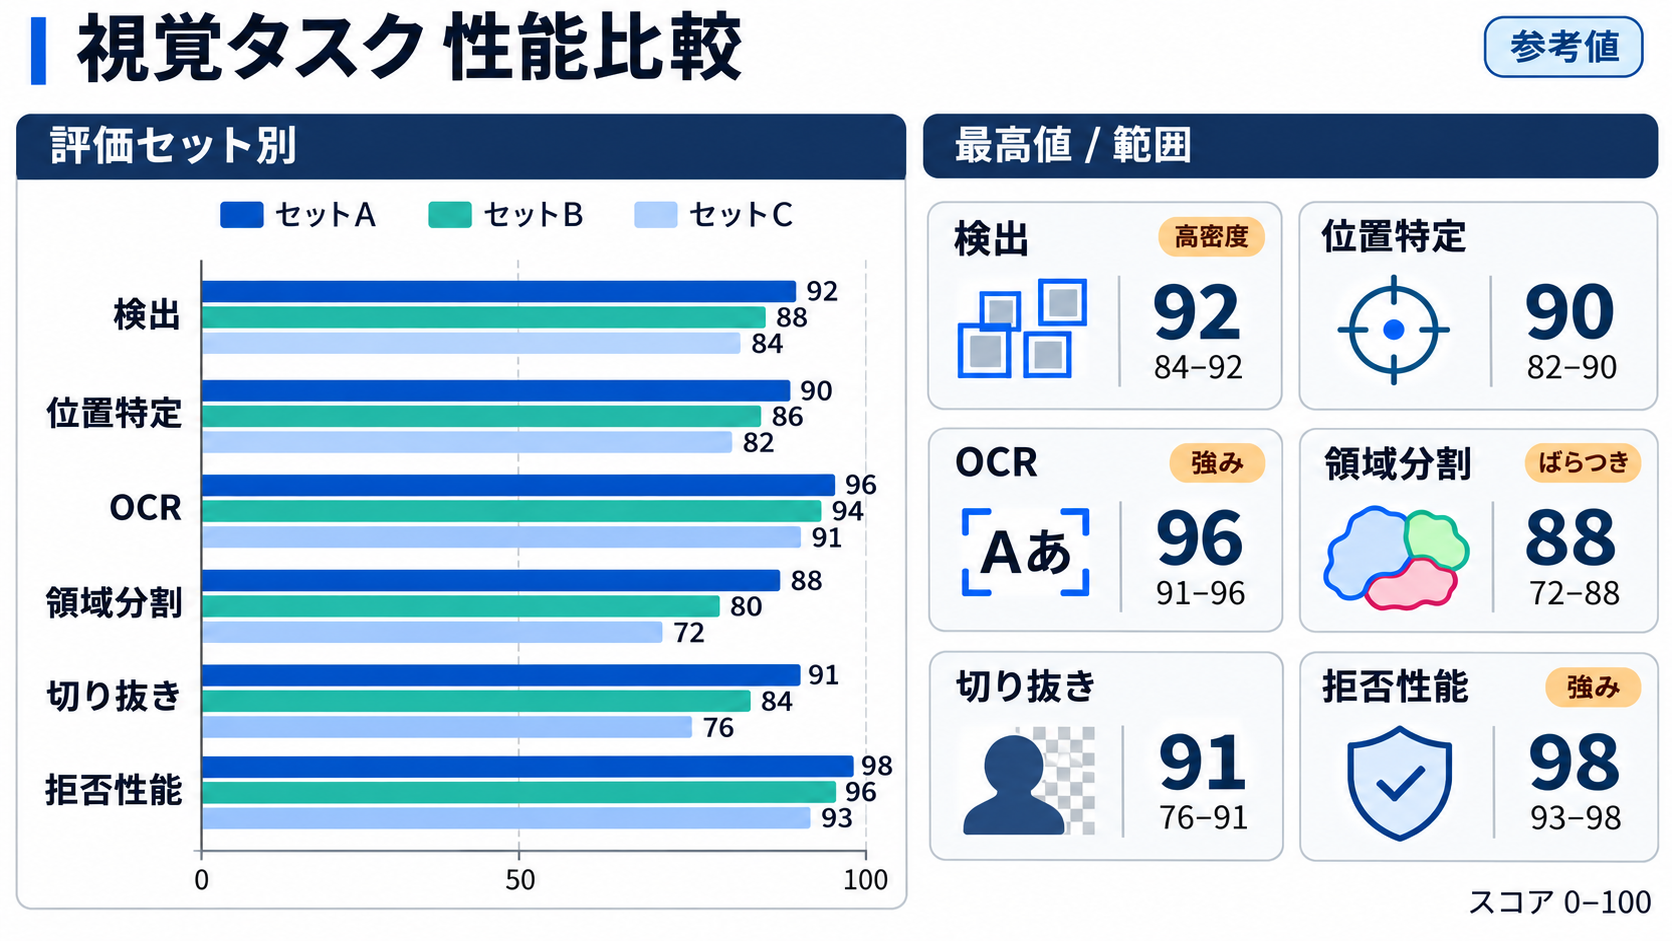
Tencentが公表した評価では、4B版が同規模の視覚言語モデルを30件超のベンチマークの多くで上回りました。評価は貪欲デコーディングを使い、1画像当たり最大1960個の視覚トークンという条件です。検出、指定対象の位置特定、OCRでは、IoUが0.5から0.95までの範囲におけるF1平均が用いられています。数値はいずれも開発側による報告であり、第三者検証済みの結果とは分けて見る必要があります。
| 評価領域 | WeVisOne-VLの結果 | 掲載された比較結果 |
| --- | --- | --- |
| 高密度物体検出 | Dense200で71.3 F1 | LocateAnything-3Bは58.7 F1 |
| 指定対象の位置特定 | RefCOCOg testで81.8 F1 | LocateAnything-3Bは77.6 F1 |
| 個数カウント | PixMo-Count testで89.6%完全一致 | 比較対象は82.8% |
| OCR | TotalTextで52.0 F1 | PP-OCRv5は25.7 F1 |
| セグメンテーション | ReasonSeg valで71.2 gIoU | LISA-13Bは65.0 gIoU |
| マッティング | P3M-500-NPで7.3 MAD | 比較対象は15.4 MADで低いほど良好 |
Dense200では71.3 F1を記録し、LocateAnything-3Bとの差は12.6ポイントでした。LVISでは55.3 F1、TotalTextのOCRでは52.0 F1、ReasonSegのセグメンテーションでは71.2 gIoUと報告されています。マッティングのMADは低いほど良く、4B版が7.3、2B版が6.6でした。2B版は多くの課題で4B版を下回るものの、この箱指定マッティングでは良い数値を示しています。パラメータ数の大きさだけで全用途の優劣を決められない例です。
拒否性能は評価セットによる差が目立ちます。社内のWeRef-Benchでは96.4%だった一方、PR-Benchでは52.6%でした。RefCOCOg-RejでもWeVisOne-VL-4Bは67.4%で、完全な拒否には届いていません。実務では平均スコアだけを見るのではなく、見逃しと誤検出のどちらが業務上重いかを決め、閾値や人手確認を含む運用設計へ落とし込む必要があるでしょう。
導入前に確認したい実行環境と未公開情報
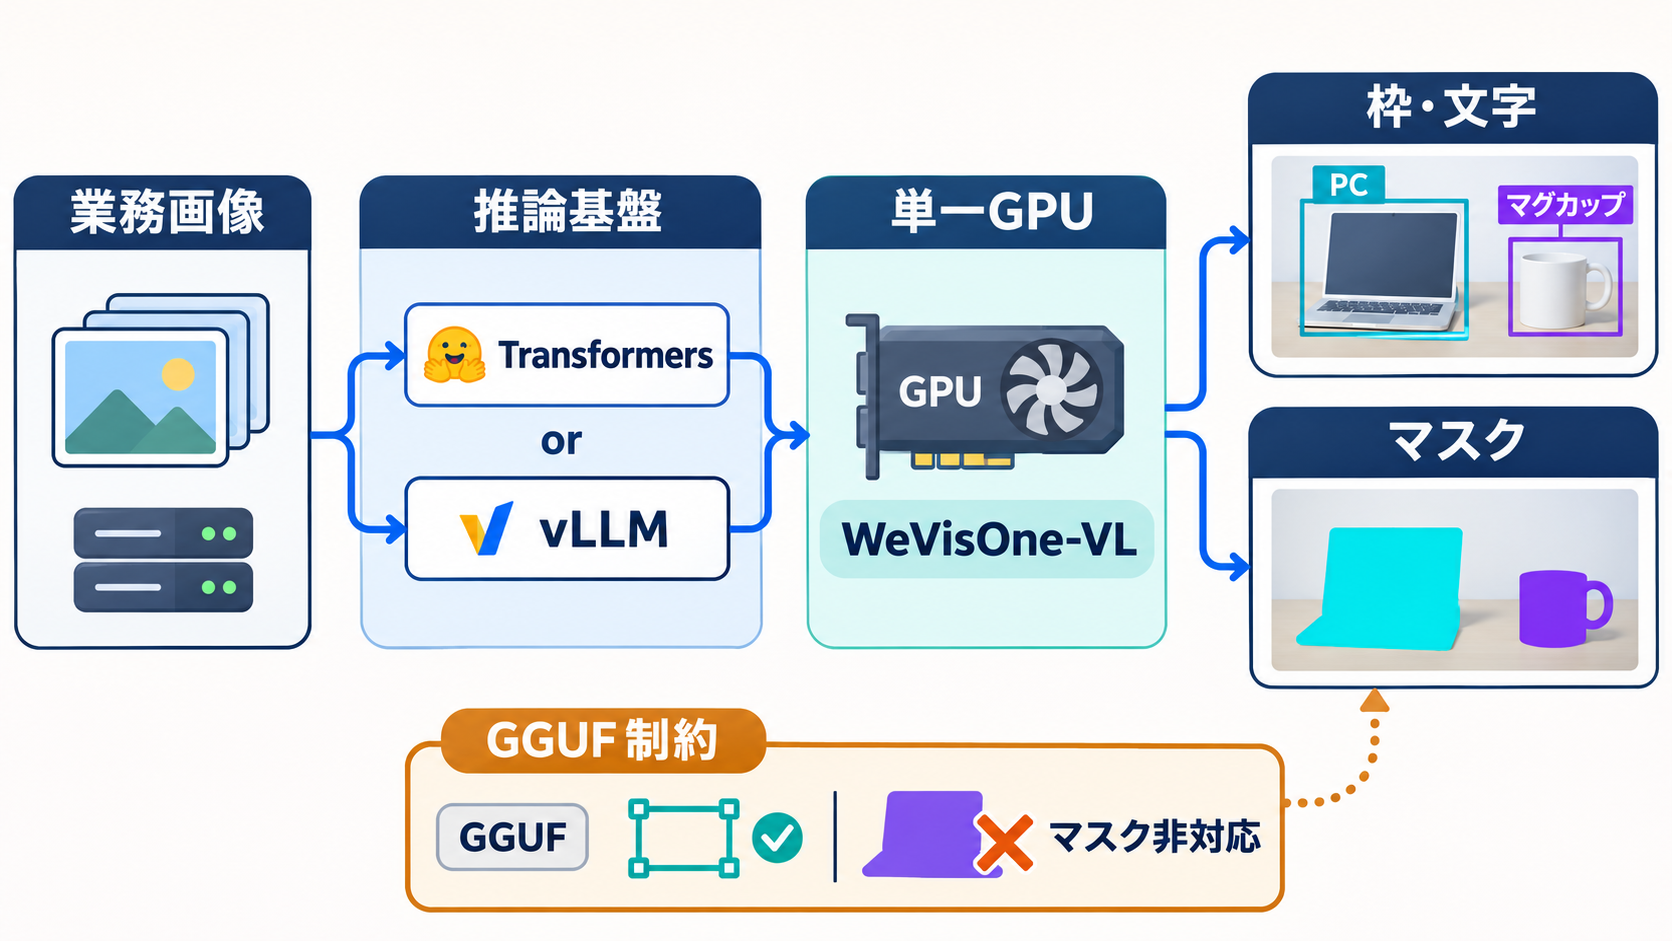
2B版と4B版の重みはHugging Faceで公開され、ライセンスはApache 2.0です。専用パッケージはTransformersとvLLMのバックエンドを包み、検出、位置特定、点指定、枠を使ったカウント、OCR、セグメンテーション、マッティングの各タスクを呼び出せます。BF16を利用した単一GPUでの実行方法が案内されており、デバイスの選択肢にはNPUとCPUも記載されています。
ただし、必要なGPUメモリー量は明らかにされていません。学習では最大8192トークンのコンテキストが使われましたが、配布版を運用するときのコンテキスト長も非公開です。単一GPUで動作するという情報だけでは、利用中のGPUに収まるか、必要な応答時間を満たせるかまでは判断できません。入力解像度、同時実行数、出力する枠の数を変えた測定が必要です。
コミュニティが作成したGGUF版では、6GBのメモリーを持つRTX 2060で物体単位の処理が実行されたと報告されています。ただし、GGUF版はネイティブな画像特徴を必要とするピクセルデコーダーを利用できず、マスクを生成できません。軽量化された変換版の動作実績と、公式構成で全機能を利用できることを混同しない注意が要ります。
2B版と4B版にはホスト型デモも用意され、学習用データ生成で使われたマッティング注釈ツール「Mask2Alpha」も公開されています。その一方、ファインチューニング用コードは今後の対応項目に残されています。現時点で試しやすいのは推論とデモの確認であり、独自データによる再学習まで含めた導入計画には不確定要素があります。
日本企業がPoCで確かめるべき判断軸
WeVisOne-VLが企業にもたらし得る利点は、個々のベンチマーク首位より、複数の画像処理を共通の入出力で扱える点にあります。ECの商品登録なら文字抽出、商品数の確認、背景除去を連続して実行できる可能性があります。製造や物流では、対象の検出、位置指定、領域抽出を一つの推論基盤へ集約する構成が候補になるでしょう。これらは想定される活用例であり、各業務での精度が公表結果によって保証されるわけではありません。
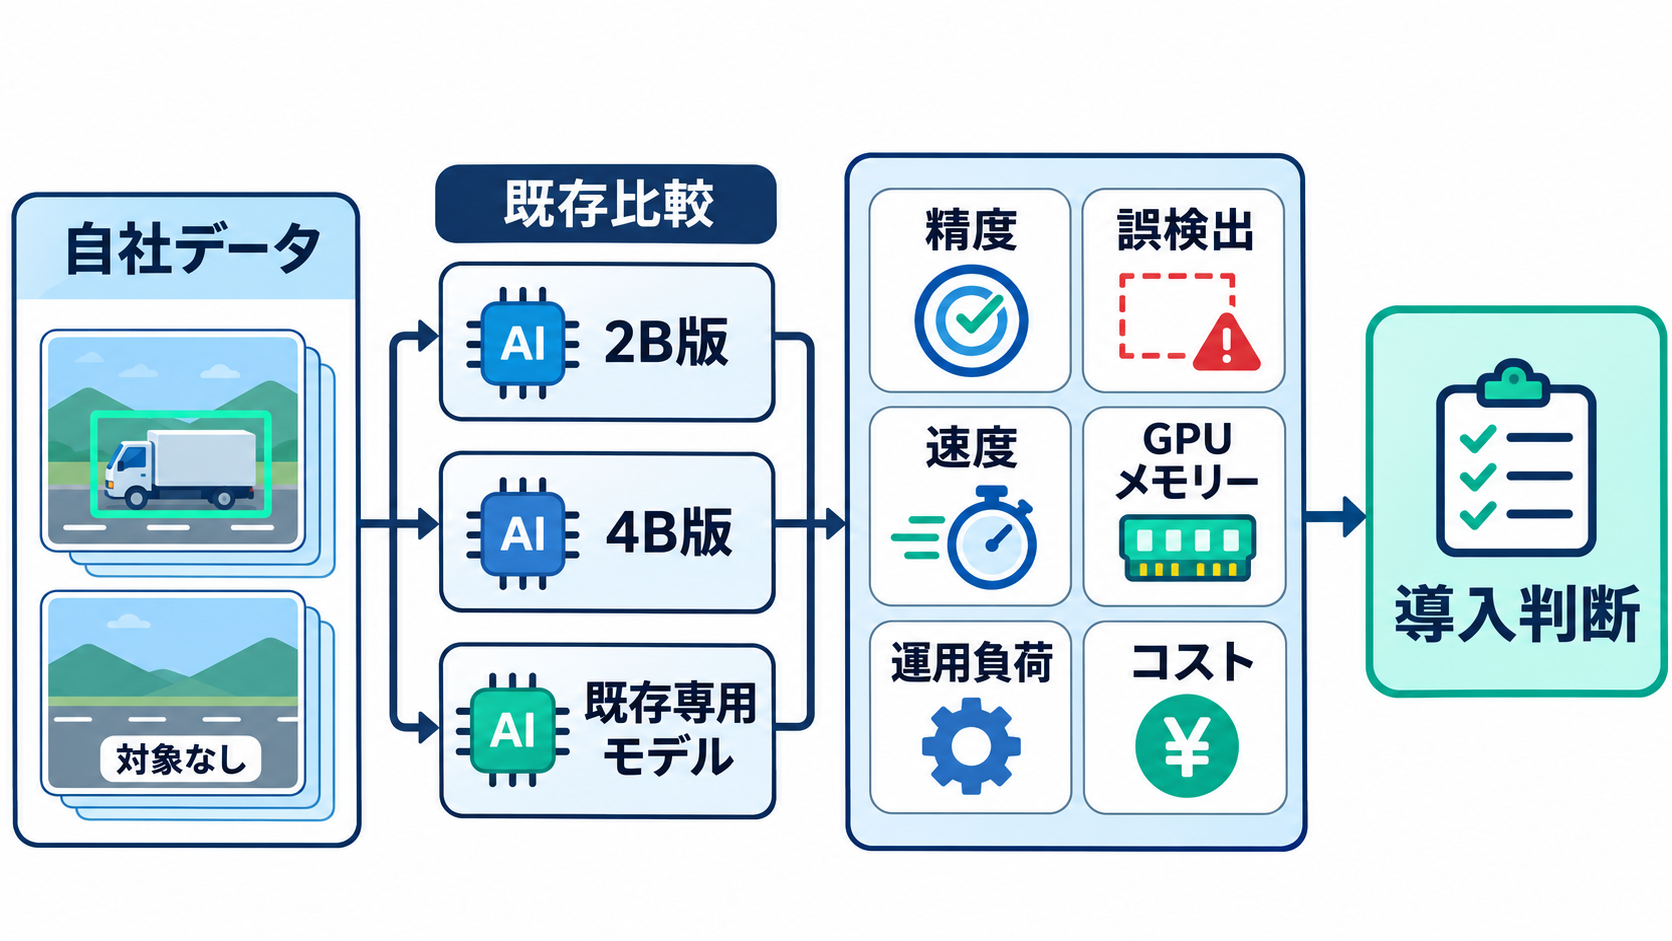
PoCでは、機能ごとに別々の成功例を並べるだけでは不十分です。実際の業務フローに合わせ、同じ画像に対するOCR、検出、マスク生成の結果が整合するかを確認します。評価項目には、正常な対象だけでなく、対象が存在しない画像、物体が重なる画像、小さな文字、低照度、反射、部分的な遮蔽も含めたいところです。特に「None」の誤りは後続処理を誤作動させる可能性があるため、誤検出率を独立した指標として記録する必要があります。
システム面では、2B版と4B版の精度差だけでなく、レイテンシ、GPUメモリー、同時処理数、入力画像の縮小による精度変化を比較します。セグメンテーションやマッティングが不要なら軽量な構成を選べる余地がありますが、GGUF版ではマスクを出せないという制約があります。Apache 2.0で公開されていても、社内のライセンス審査、モデル重みの管理、入力画像に含まれる個人情報や機密情報の取り扱いは別途確認しなければなりません。
導入判断の最初の一歩は、自社で頻出する画像を用途別に分け、現在の専用モデル群とWeVisOne-VLを同じ条件で比較することです。精度が同等でも、統合によって保守対象やデータ変換が減るなら採用理由になります。反対に、拒否性能や日本語OCRが要件に届かなければ、既存の専用モデルを残す判断が妥当でしょう。一体型という特徴を目的にせず、運用全体の複雑さと失敗時の影響を減らせるかを基準に評価することが現実的です。