
2026/11/04
今更聞けないAI知識
生成AIは知らない資料をどう使う?RAGを「資料を開いて答える仕組み」で理解する
この記事の要点
RAGは、生成AIが回答を作る前に関連資料を検索し、その内容を材料として利用する仕組みです。追加学習や通常の検索との違い、RAGでも誤りが残る理由、参照元を確かめる際の見方を、資料を開いて答える試験にたとえて説明します。
目次
「学習していない資料なのに答えられる」の正体
社内規程を生成AIに質問したところ、自社独自の申請手順まで説明されたとします。そこで浮かぶのが、「このAIは、いつ会社の資料を学習したのでしょうか」という疑問です。実際には、AIのモデル自体がその資料を追加で学習したとは限りません。回答を作る直前に必要な資料を探し、その内容を材料として文章を組み立てている場合があります。
この仕組みがRAGです。RAGは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」と呼ばれます。一言で表すなら、関連資料を検索してから回答づくりに利用する仕組みです。IBMも、RAGを、基盤モデルが学習データの外にある関連情報源を利用し、回答の正確さや関連性を高めるための技術として説明しています(出典: IBM)。
身近なたとえは、資料を見ずに受ける試験と、教科書を開いてよい試験の違いです。通常の生成AIは、あらかじめ学習したパターンをもとに回答を作ります。RAGを使う生成AIは、質問に関係するページを探し、そのページを開いた状態で答える受験者に近い存在です。ただし、資料を読めることと、内容を正しく理解して答えられることは同じではありません。
ここで押さえたい中心点は、RAGがAIに知識を永久に覚えさせる方法ではないことです。質問に応じて外部資料を参照しやすくする考え方であり、モデルの中身そのものを作り直す話とは区別されます。この違いが分かると、「AIが知っているはず」と考えるのではなく、「どの資料を見て答えたのか」と確認できるようになります。それがRAGを理解する最初の一歩です。
資料を開いて答える試験にたとえた流れ
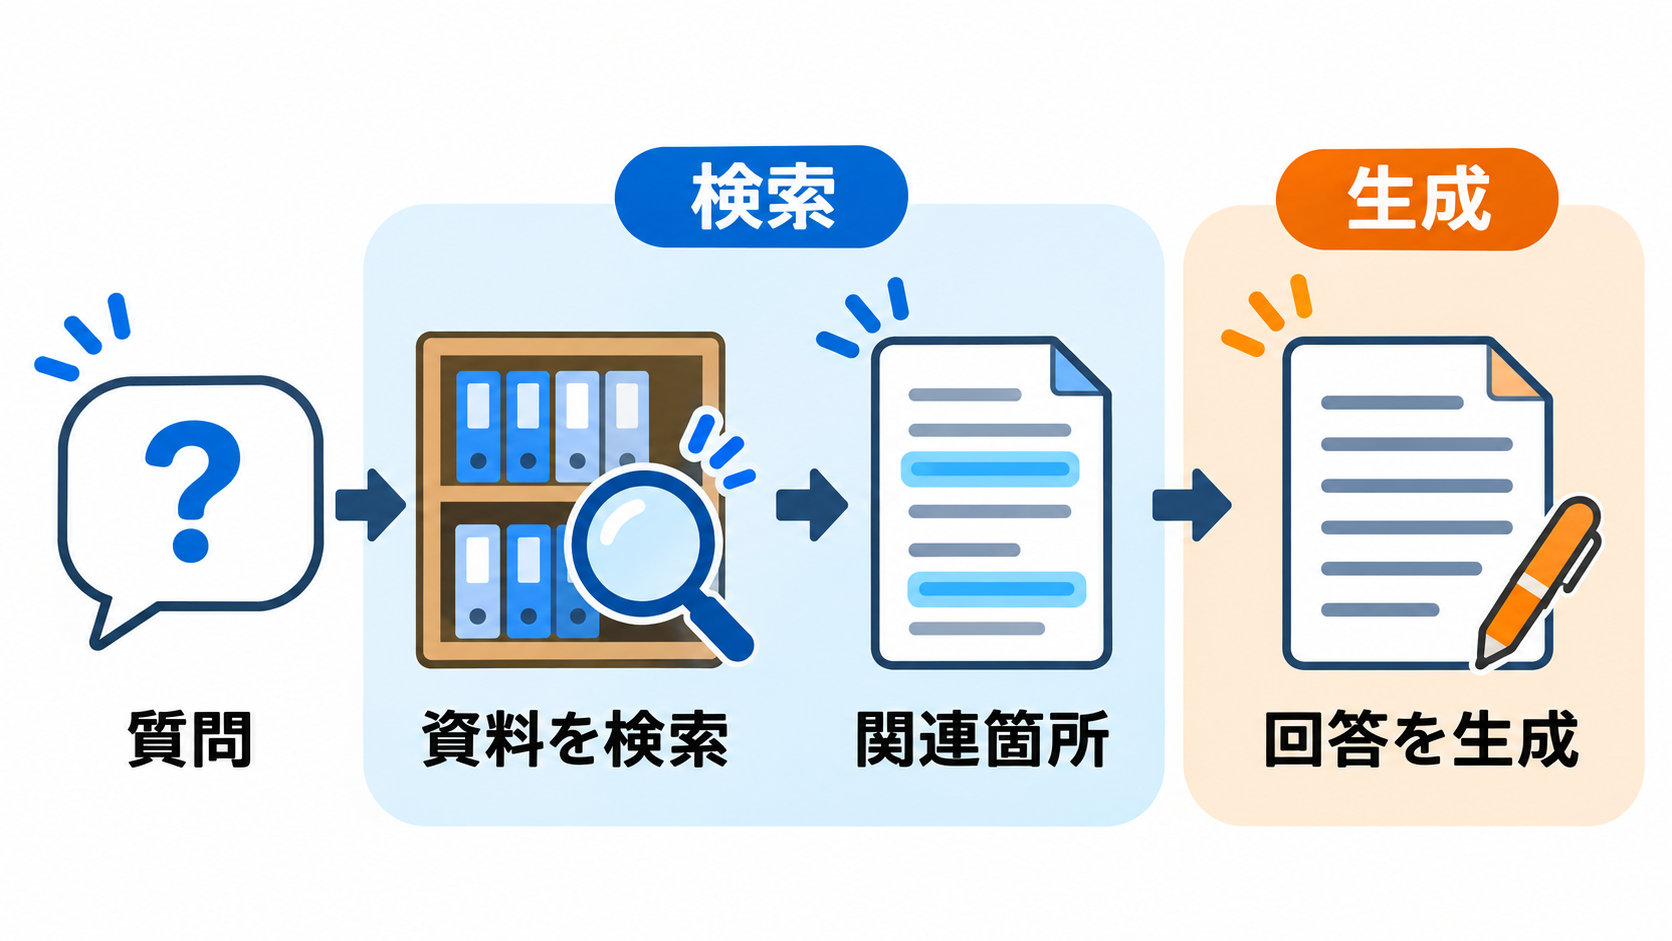
RAGの流れは、難しい計算式を知らなくても理解できます。質問を受け取った仕組みが、最初から回答文を書き始めるのではなく、先に関連しそうな資料を探します。たとえば「出張後の精算期限はいつですか」という質問なら、旅行案内や営業資料ではなく、経費精算規程の該当箇所を候補として取り出します。その内容と元の質問を生成AIへ渡し、回答文を組み立てるという順序です。
流れを分けると、「質問を受け取る」「関連資料を検索する」「見つかった箇所を回答の材料に加える」「生成AIが文章にまとめる」という四つの段階になります。これは概念を理解するための簡略化であり、特定製品の画面や操作手順を表したものではありません。利用者からは普通の会話に見えても、その裏側では検索と文章生成が役割を分担していると考えると分かりやすいでしょう。
開いてよい資料が指定された試験を想像してください。受験者は設問を読み、索引から関係する章を探し、見つけた記述を使って答案を書きます。RAGでも、検索によって適切な箇所を選べなければ、回答づくりの材料が不足します。反対に、関係するページを見つけても、文章の意味を取り違えれば正しい答案にはなりません。
この流れから分かるのは、RAGが単なる検索でも、単なる文章生成でもないという点です。検索は材料を集め、生成AIは質問に合わせて材料を整理します。利用者が確認すべき対象も二つあります。必要な資料が検索対象に含まれているか、そして最終回答が資料の内容を正しく反映しているかです。回答だけを眺めるより、この二段階に分けて考えたほうが、誤りの場所を見つけやすくなります。
RAGと追加学習を分ける境界
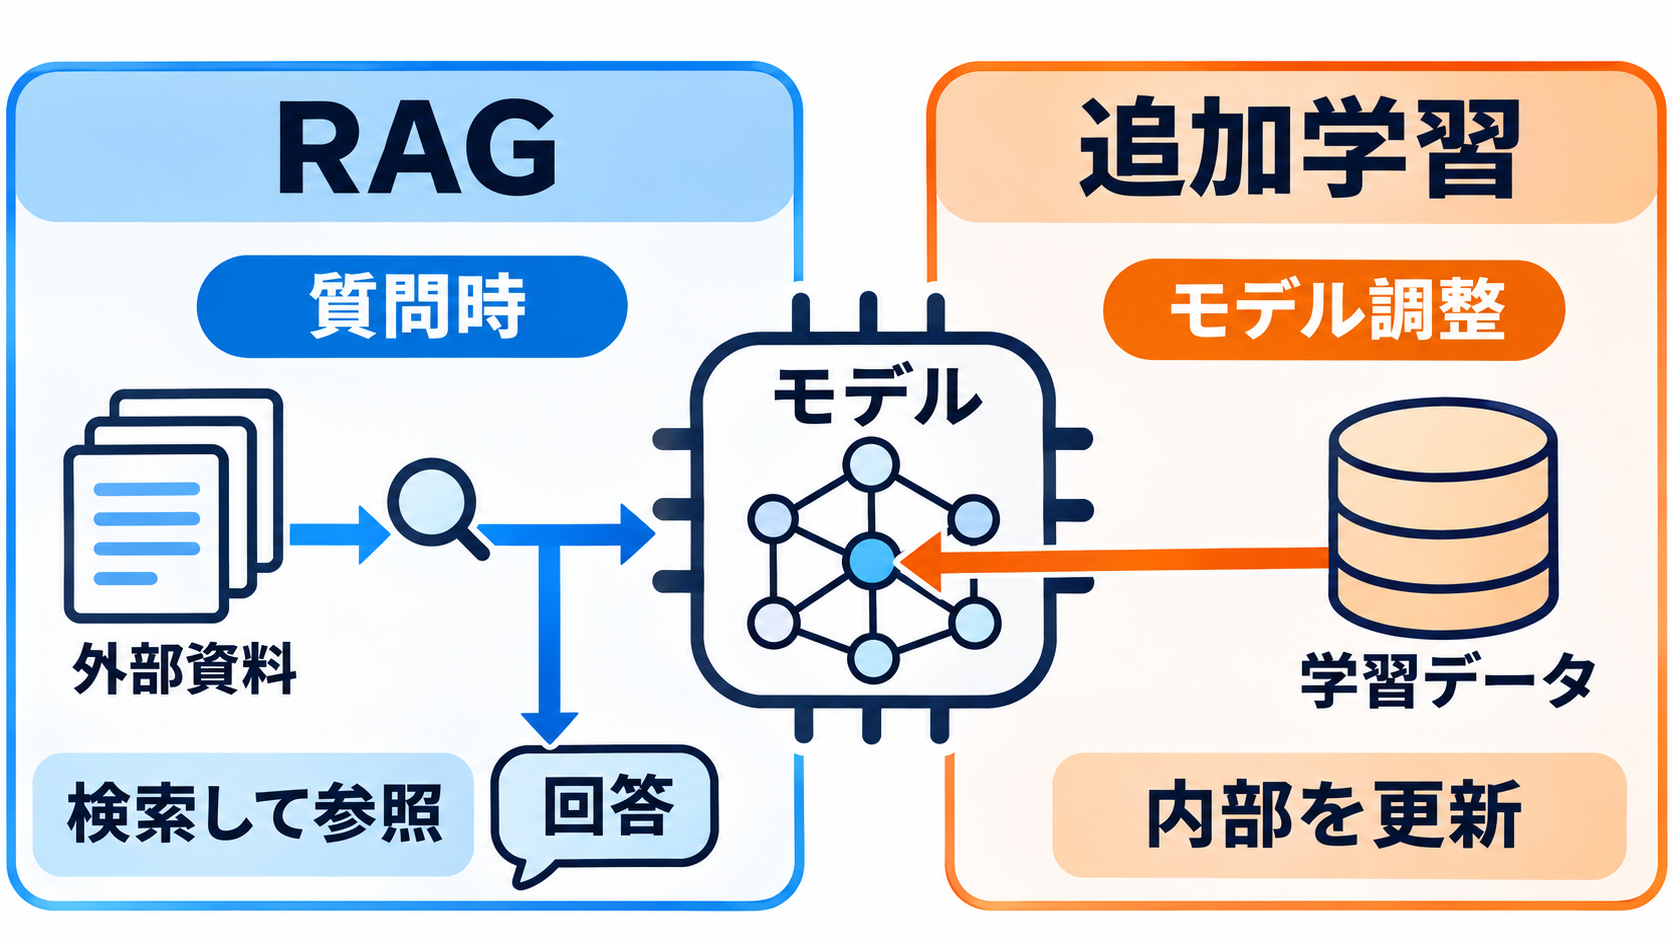
「社内資料をAIに追加する」と聞くと、AIがその内容を暗記する場面を思い浮かべるかもしれません。しかし、RAGと追加学習は、資料を使う時点も目的も異なります。RAGは質問への回答時に外部の情報源を探し、見つけた内容を回答材料として渡す方法です。追加学習では、データを使ってモデル側の調整を行います。
Google Developersの生成AI用語集では、ファインチューニングを、事前学習済みモデルに対して特定用途向けの二次的な学習を行い、パラメーターを調整する方法として説明しています(出典: Google Developers)。パラメーターとは、モデルが学習によって得たパターンを保持するための内部的な数値です。初心者向けには、「モデルの中身を用途に合わせて調整する」と捉えれば十分でしょう。
たとえば、毎月改定される社内規程について質問できる状態を考えます。RAGでは、更新済みの規程が検索対象へ正しく反映されていれば、質問時に新しい資料を参照できる可能性があります。追加学習は、資料を見つけて開く仕組みではなく、モデル自体の応答傾向や特定の課題への適応を調整する考え方です。そのため、「新しい文書を使わせたい」という要望と、「回答の仕方を特定用途に合わせたい」という要望は、分けて整理する必要があります。
両者は優劣で選ぶものではありません。必要な情報が頻繁に更新され、回答の根拠となる文書を確認したい場合は、RAGという考え方が要望に合いやすくなります。専門領域向けにモデルの振る舞いを調整する話では、ファインチューニングが検討対象になるかもしれません。ただし、実際の構成や提供条件は製品ごとに異なります。
会話の中で「AIに学習させておいてください」と言いたくなったら、何を実現したいのかを言い換えてみてください。「新しい資料を質問時に参照したい」のか、「回答の形式や傾向を変えたい」のかで、必要な仕組みは変わります。この切り分けができれば、詳しい技術用語を知らなくても、担当者との認識違いを減らせるでしょう。
検索サービスとの似ている点と違う点
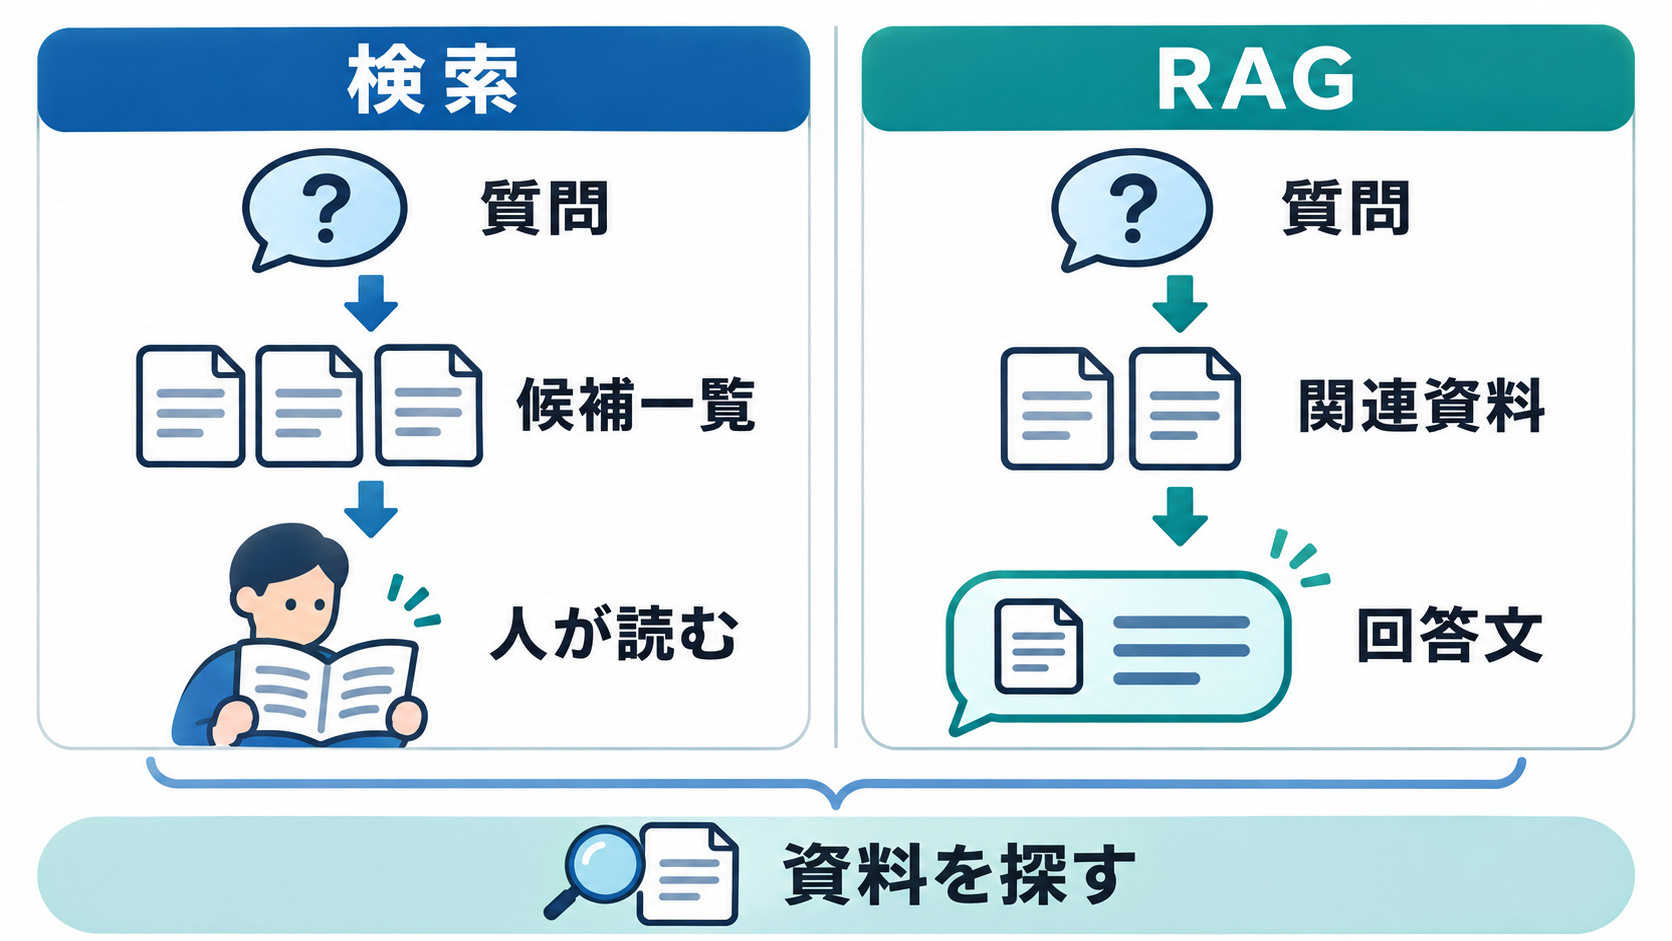
RAGの「R」は検索を表しますが、検索サービスを別の名前で呼んでいるわけではありません。一般的な検索では、入力した言葉に関係するページや文書の候補が並び、どれを開いて読むかは利用者が判断します。RAGでは、検索によって取り出した内容を生成AIへ渡し、質問に対応した文章を作るところまでが一つの流れに含まれます。
架空の例として、就業規則の中から「忌引休暇の日数」を確認する場面を考えます。文書検索なら、関連する規程やページを見つけ、利用者自身が条件を読み比べます。RAGを利用する仕組みなら、検索した記述をもとに「対象となる親族の区分によって日数が異なります」といった回答文を作ることが考えられます。これは活用イメージであり、実際の回答内容や参照できる資料は利用環境によって変わります。
文章にまとめてもらえる点は便利ですが、検索結果より確実になるとは限りません。検索サービスでは原文を自分で読むため、解釈の責任が見えやすくなります。RAGでは読みやすい回答が先に示されるため、その文章が原文そのもののように感じられるかもしれません。しかし、回答は検索された資料を材料として生成された文章です。原文の抜粋と、AIによる要約や説明は区別して受け取る必要があります。
使い分けの基準は、「候補を探したいのか」「候補を使って問いに合う説明を作りたいのか」です。関連文書の一覧を広く確認したいなら、検索結果を自分で見比べる方法が向いています。概要をつかみたい場合は、RAGによる整理が役立つ可能性があります。契約、金額、期限、安全など判断への影響が大きい内容では、生成された答えだけで完了させず、元資料までたどる姿勢が欠かせません。
RAGを使っても誤りが残る理由
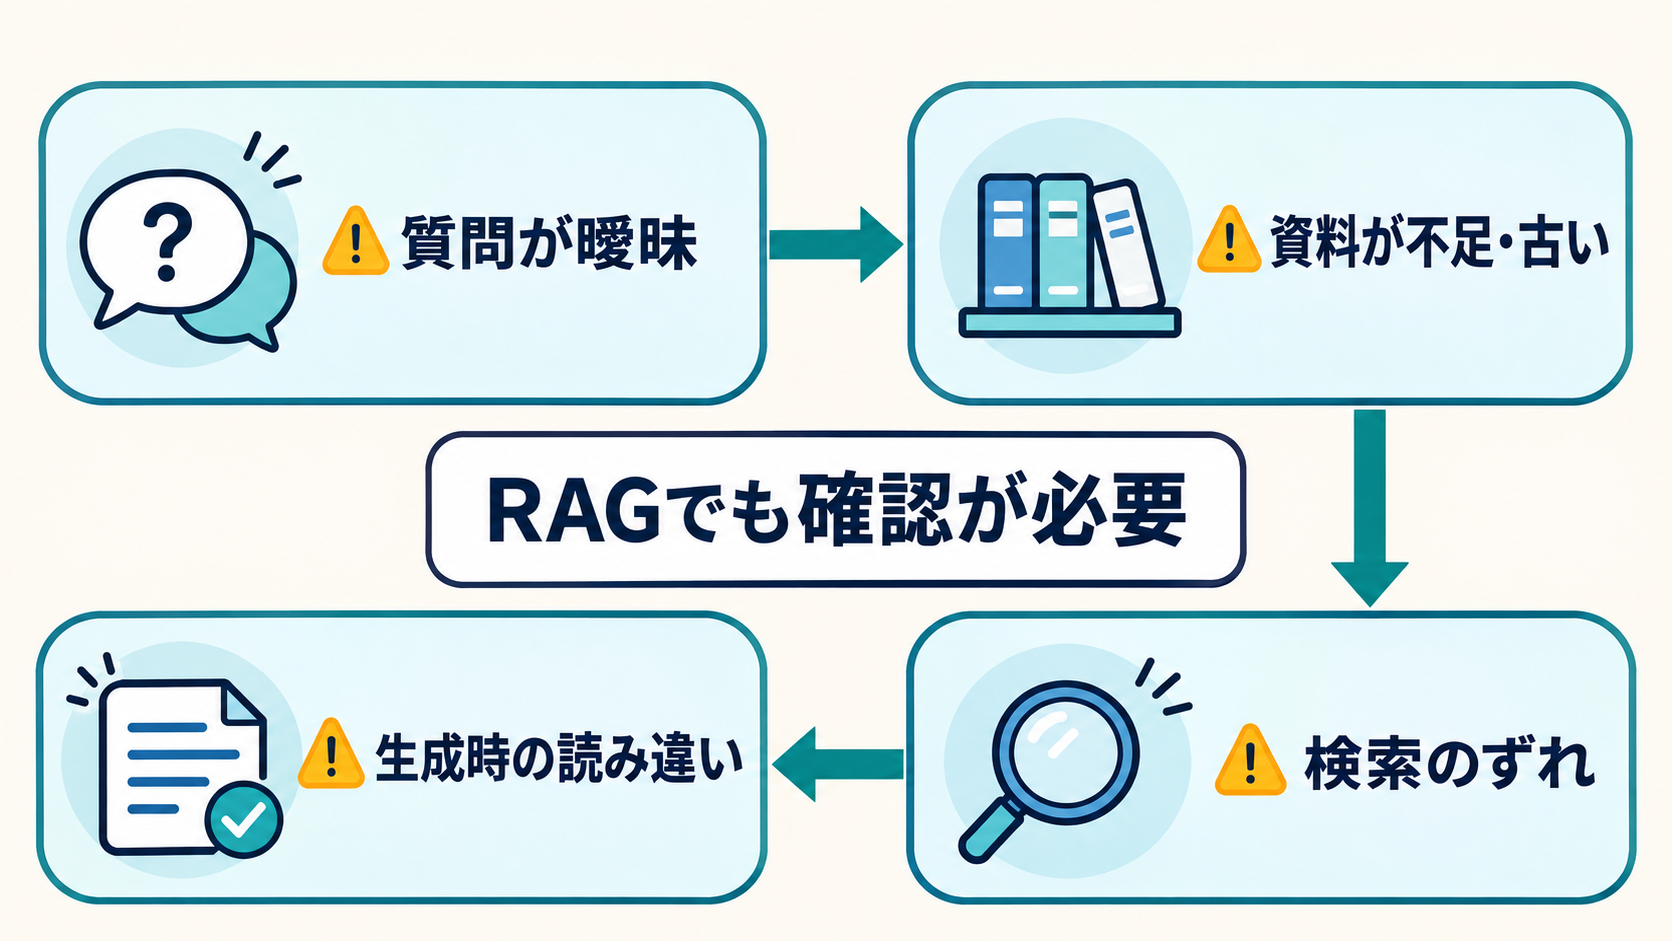
RAGは、正しい答えを保証する仕組みではありません。IBMの説明も、外部の関連情報源を利用して正確さや関連性を高める技術という位置づけであり、「必ず正しくなる」とは述べていません(出典: IBM)。資料を開いて答える試験でも、間違ったページを開く、条件を読み落とす、設問の意味を取り違えるといった失敗が起こります。RAGも同じように、検索と生成のそれぞれで誤る可能性があります。
検索段階では、質問に必要な資料が検索対象に入っていなかったり、似ている別の記述が選ばれたりすることが考えられます。資料自体が古い場合には、正しく検索できても現在のルールとは一致しません。質問が「申請はいつまでですか」のように曖昧なら、どの申請を指しているのか判断できず、関係の薄い資料が選ばれるかもしれません。
生成段階では、見つかった記述の条件を省略したり、複数の資料を不適切につないだりする可能性があります。生成AIが、根拠の不足を自然な文章で補ってしまうことも考慮しなければなりません。事実と異なる内容を、もっともらしい文章として生成する現象は「ハルシネーション」と呼ばれます。RAGは回答材料を与える方法ですが、ハルシネーションを完全に消すという意味ではありません。
確認するときは、回答の滑らかさではなく、根拠との対応に注目してください。出典や参照箇所が示されているなら、その資料が質問と本当に関係しているか、日付や版は適切か、条件や例外が回答から抜けていないかを見ます。参照元を確認できない場合は、重要な判断にそのまま使わないほうが安全でしょう。「出典があるから正しい」ではなく、「出典と回答が一致しているかを確かめられる」と考えることが、RAGとの適切な付き合い方です。
仕事で試すなら回答より根拠を指定する方法
RAGの考え方は、社内文書への質問、製品マニュアルの確認、会議資料の整理などに応用できる可能性があります。ただし、ここで挙げるのは架空の活用例です。利用中のサービスが指定資料の検索や参照元の表示に対応しているか、機密情報を入力してよいかといった条件は、組織のルールとサービスの説明を別途確認する必要があります。
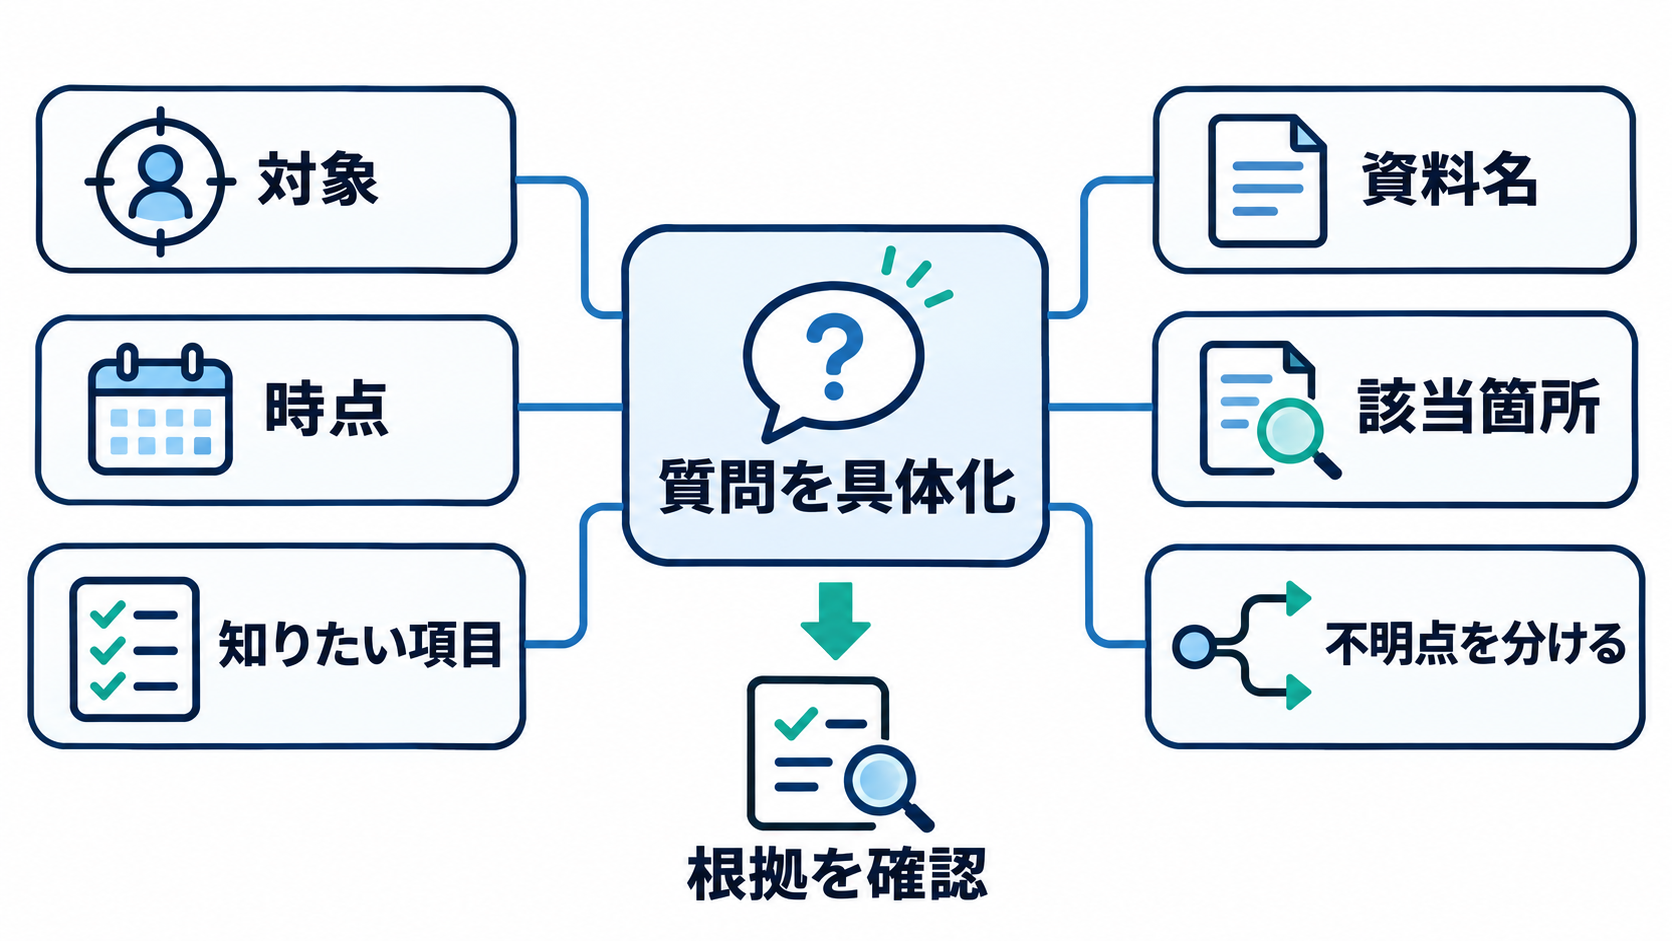
たとえば、新入社員が経費精算の流れを調べる場面では、「精算方法を教えてください」だけでは対象が広すぎます。「国内出張後の交通費精算について、申請期限、必要書類、承認者を分けて説明してください。参照した規程名と該当箇所も示してください」と尋ねる案が考えられます。これは回答を正しいと決めつける指示ではなく、確認しやすい形で出してもらうための提案例です。
指定資料を検索する仕組みが用意されている場合のプロンプト例は、次のようになります。
指定された社内規程の範囲で、在宅勤務日の交通費の扱いを説明してください。
根拠が見つかった内容と、資料だけでは判断できない内容を分けてください。
参照した規程名、版の日付、該当する項目も示してください。
この入力例の狙いは、AIに断定させることではありません。「分からない部分を分ける」「資料名や日付を示す」「該当箇所まで戻れるようにする」という三つの確認手段を求めています。もっとも、指示を書けば必ず守られるわけではないため、表示された根拠は利用者が読み直す必要があります。
よくある失敗は、質問の対象や時点を省いたまま、短い答えだけを求めることです。「休暇制度を教えてください」より、「2026年度の正社員向け規程を対象に、子の看護等休暇の申請条件を確認してください」のように、対象、時点、知りたい項目を具体化したほうが確認しやすくなります。RAGを使う場面では、長い回答を得ることよりも、どの資料のどこを根拠にしたのかを追える状態にすることが大切です。
明日から変えられる「AIは何を見たか」という視点
RAGを知ったあとに変えたいのは、技術用語の数ではなく、生成AIの回答を見る順序です。これまでは、文章が自然か、質問に答えているかだけを見ていたかもしれません。これからは、その前に「この回答はモデルが学習した一般的なパターンだけで作られたのか、それとも外部資料を検索して作られたのか」と考えてみてください。
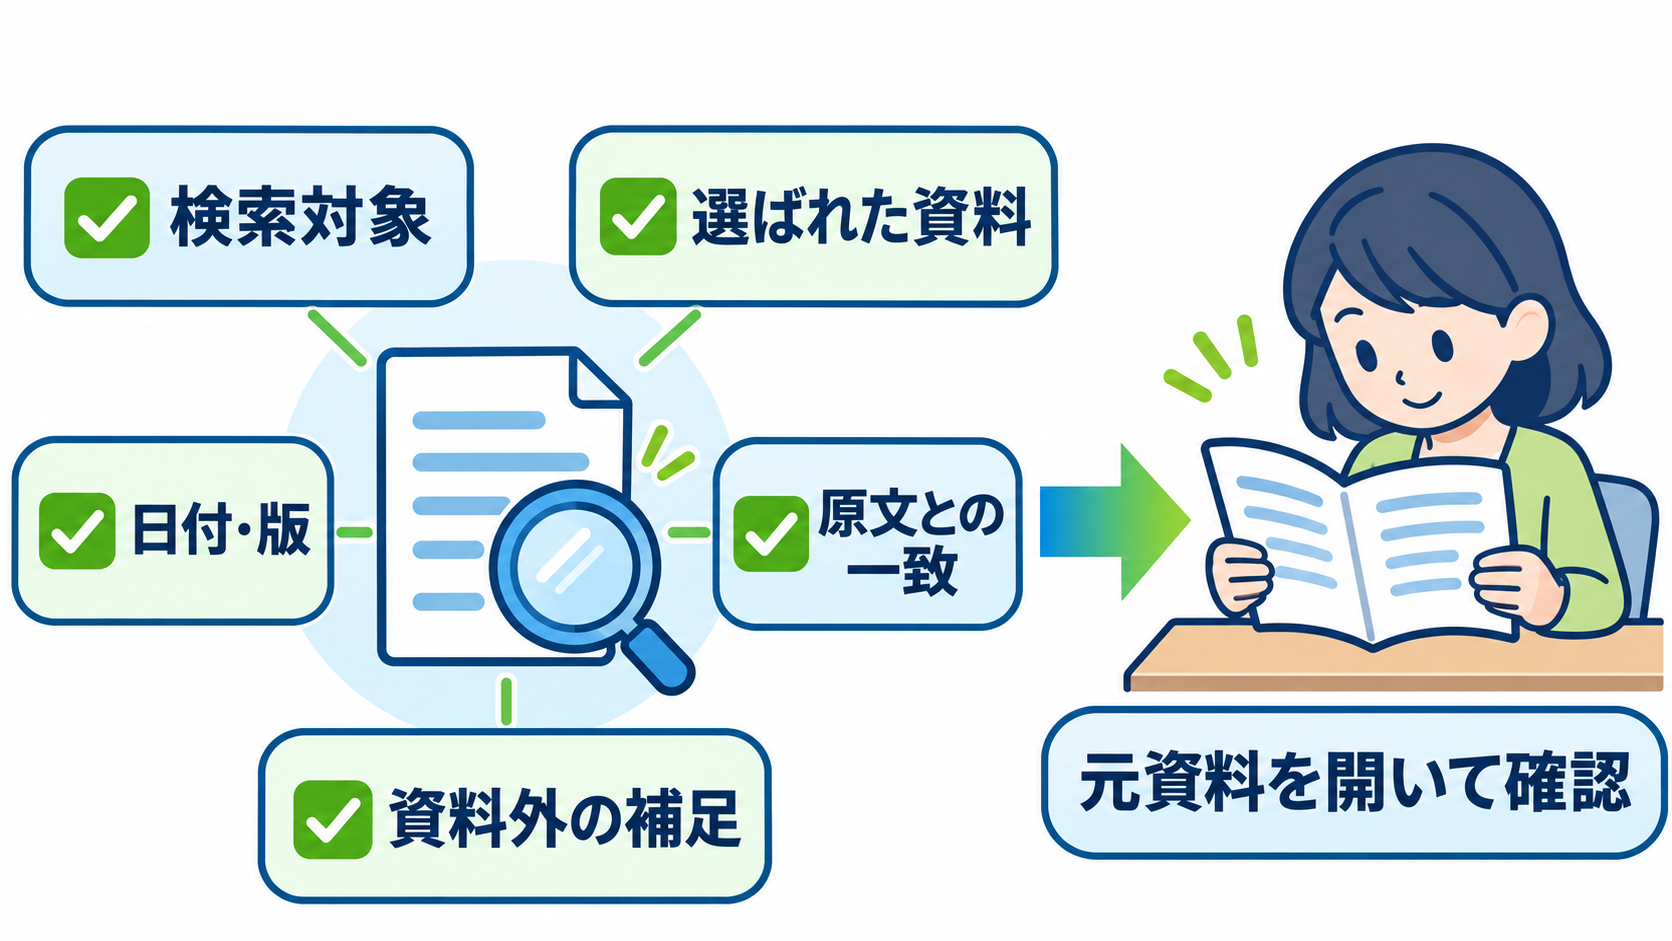
RAGを使っていると分かったら、確認する項目は五つに絞れます。何を検索対象にしているのか、どの資料が選ばれたのか、資料の日付や版は適切か、回答が原文の条件を保っているか、資料にない内容まで補っていないかです。すべてを技術的に調べる必要はありません。少なくとも参照元を開き、重要な一文の前後を読むだけでも、回答の受け取り方は変わります。
仕事で導入を相談する場合も、「高性能なAIが欲しい」と伝えるより、「最新版の社内規程を参照し、回答から根拠の箇所へ戻れるようにしたい」と目的を具体化したほうが話を進めやすくなります。反対に、文章の言い回しを整えるだけなら、RAGが必要とは限りません。必要なのが知識の参照なのか、文章の生成なのかを分けて考えられるからです。
明日試せる一歩は、生成AIに業務上の質問をしたとき、回答内容をすぐ転記せず、「参照した資料名と該当箇所を示してください」と尋ねることです。参照元が示されなければ、元の規程や公式資料を自分で探します。RAGとは、AIを物知りに見せるための魔法ではありません。回答の前に資料を探す工程を加える仕組みです。この一言を覚えておけば、便利さを利用しながら、最終的な確認を人が引き受けるべき場面も見分けやすくなるでしょう。