

2026/11/19
今更聞けないAI知識
AIのファインチューニングって何を調整するの?「見本を渡す」と「追加学習」の違い
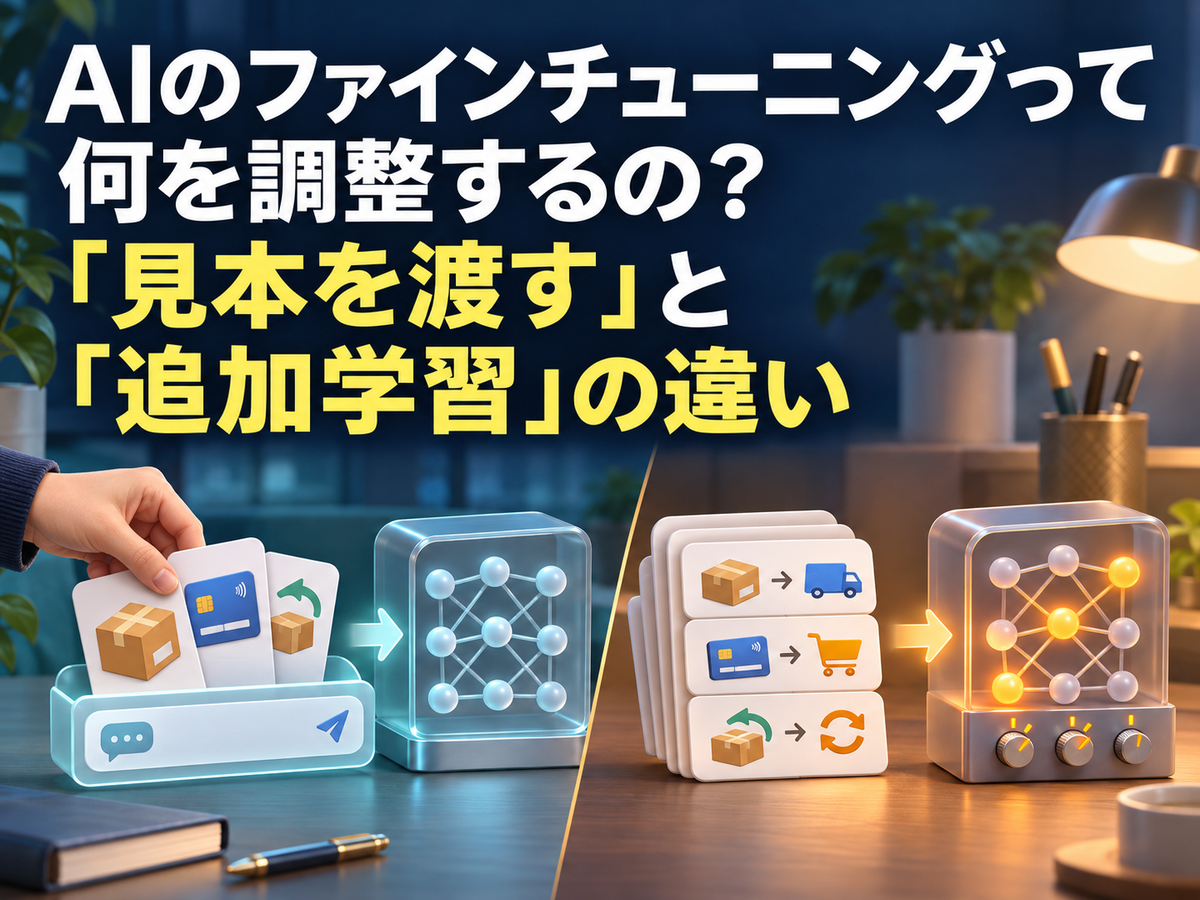
この記事の要点
ファインチューニングは、学習済みのAIモデルを用途別の追加学習で調整することです。架空の問い合わせ分類を例に、調整する対象、見本の役割、プロンプトとの違いを説明します。用途に合わせた後も、期待する出力が得られるかの評価が必要です。
目次
「うちの仕事向けにAIを調整する」とはどういう意味?
問い合わせの文章をAIに読ませて、「配送」「支払い」「返品」に分けてもらう場面を想像してください。毎回、分類の決まりを長く説明するうちに、「この仕事向けに、あらかじめ調整できないのかな」と感じるかもしれません。この疑問に関わる言葉が、ファインチューニングです。
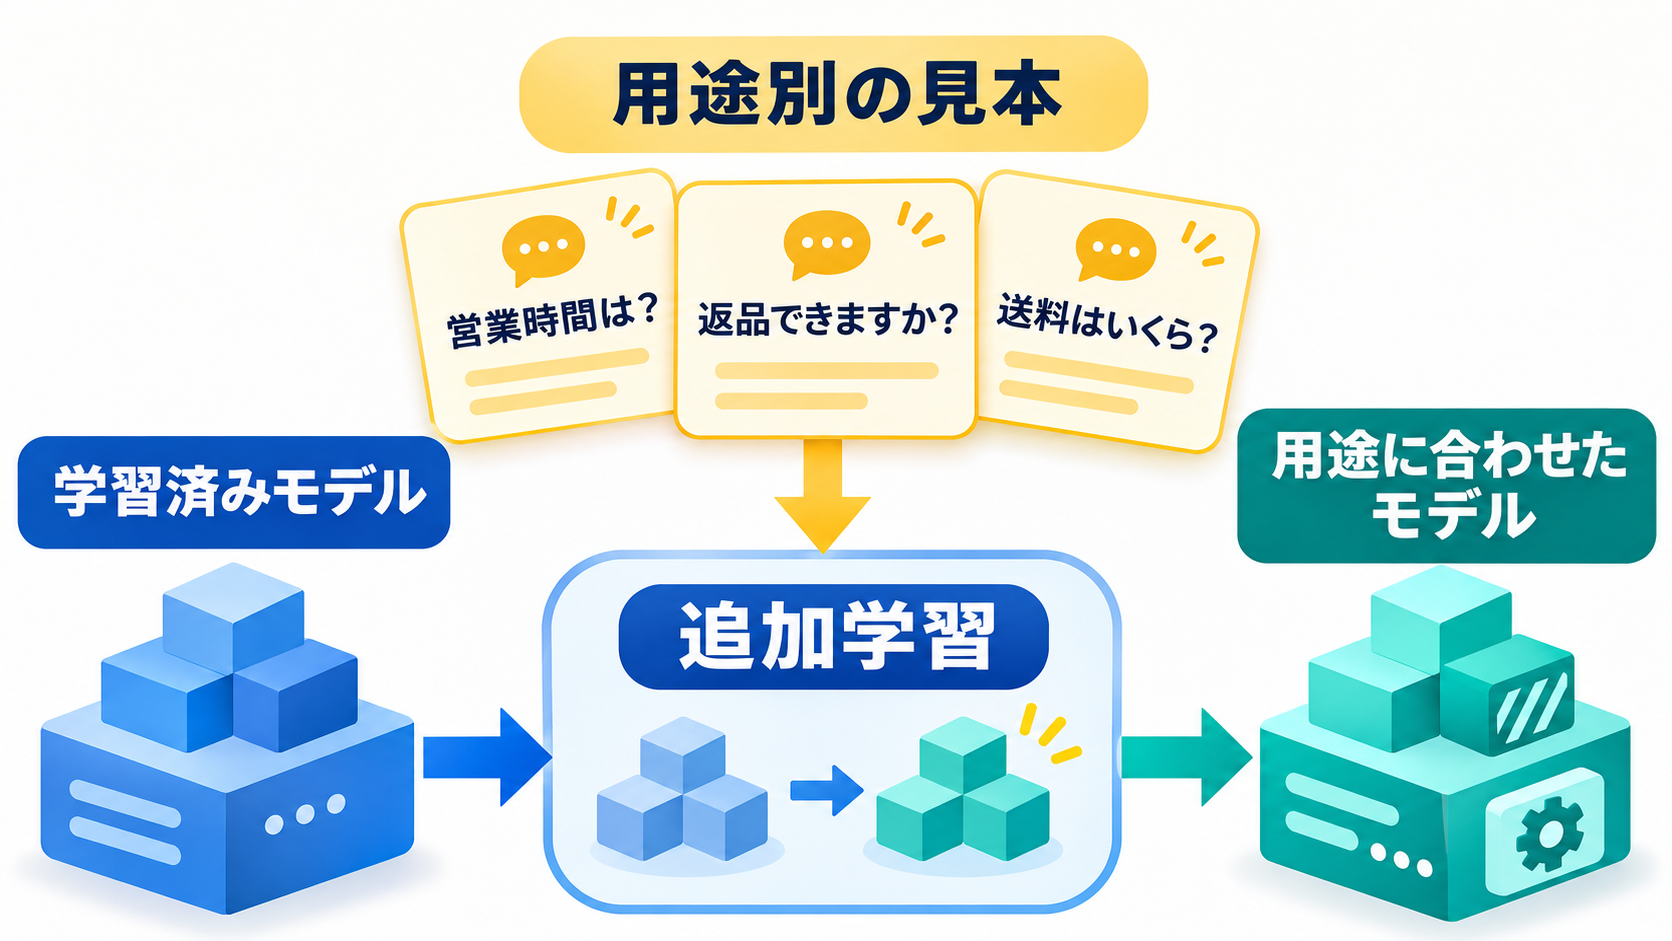
一言でいうと、ファインチューニングとは、学習済みのモデルを特定の用途に合わせて追加学習で調整することです。モデルとは、データから学んだパターンを使い、入力に対する出力を生み出す仕組みを指します。Googleの公式用語集では、事前に学習したモデルに対して、用途に応じた追加の学習を行い、内部のパラメータを調整するものと説明されています。(出典: Google Developers)
身近なたとえなら、幅広い基礎練習を終えた後に、用途別の練習を重ねるイメージです。ただし、これは学習の段階をつかむためのたとえにすぎません。AIに人と同じ理解や意識が生まれるという意味ではありませんし、特定の仕事向けに調整しただけで、何でも正しく答えられるようになるわけでもありません。
押さえたいのは、「AI全体を最初から作り直すこと」と「完成した回答の言葉を手で直すこと」の、どちらとも違う点です。すでにあるモデルを出発点として、その後の出力の傾向を用途に合わせるために学習を加えます。日常的にAIを使う読者にとっても、この区別が分かると、「依頼文を工夫する話なのか」「モデルを追加学習させる話なのか」を読み分けやすくなるでしょう。
調整するのは、モデル内部の「パラメータ」
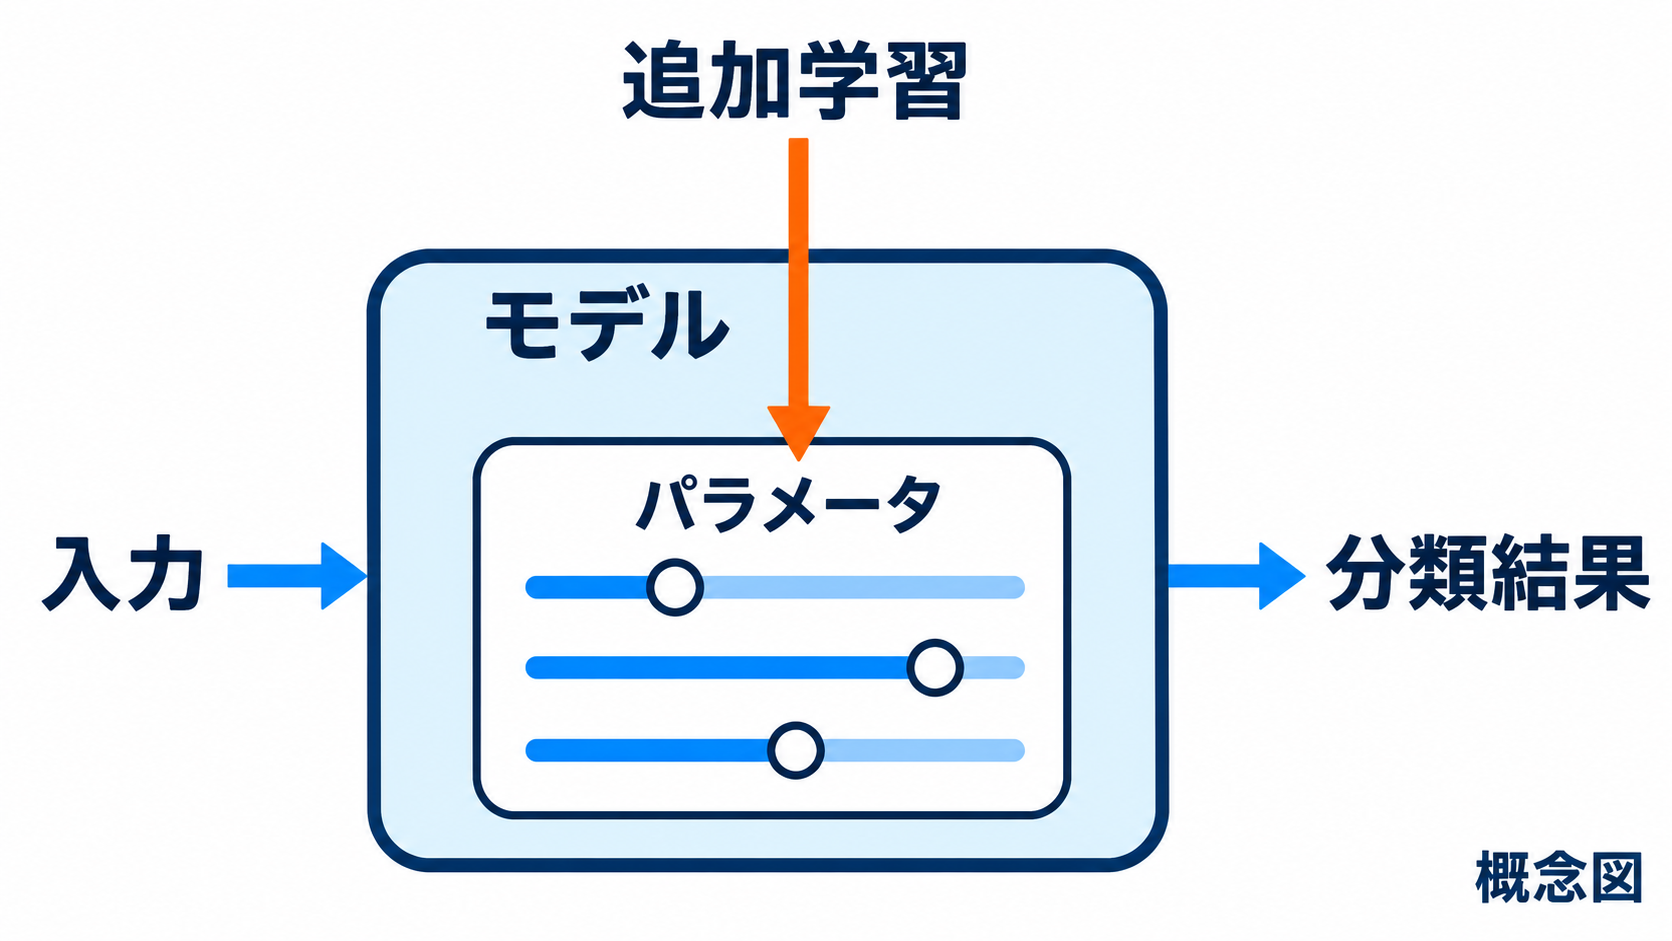
ファインチューニングで何を変えるのかを、もう少し具体的に見てみましょう。中心となるのは、パラメータと呼ばれるモデル内部の数値です。難しく感じるかもしれませんが、ここでは「学んだパターンを出力に反映するための調整値」と考えれば十分です。文章の表面を編集するのではなく、入力から出力を生み出す仕組みの内側を調整します。
Googleの公式用語集では、ファインチューニングの方法として、既存のパラメータをすべて変更する方法、一部だけを変更する方法、層を追加する方法などが挙げられています。「ファインチューニング」という言葉が出てきても、モデルの内部すべてを同じように変更するとは限りません。(出典: Google Developers)
ここでは、追加学習の段階と、調整後のモデルに回答を求める段階を分けて考えると理解しやすくなります。追加学習では、特定の用途に関係するデータを使ってモデルを調整します。その後、調整したモデルに新しい問い合わせ文を入力し、どの分類を返すかを確かめる、という関係です。Googleは、ファインチューニングを、事前学習済みモデルに対する用途別の学習として位置づけています。(出典: Google Developers)
たとえば、架空の問い合わせ分類なら、調整の目的は「この文章を読んだときに、どの分類を出すか」という対応を用途に合わせることです。すべての問い合わせを文章ごと保存して、同じものを探し出す仕組みとして捉えると、追加学習の意味を取り違えやすくなるでしょう。初心者の段階では、数式や細かな学習方法を覚える必要はありません。「その場の文章だけでなく、モデル内部の調整に関わる話」と理解しておくと、その後の説明がつながります。
問い合わせ文と「期待する分類」を組にする理由
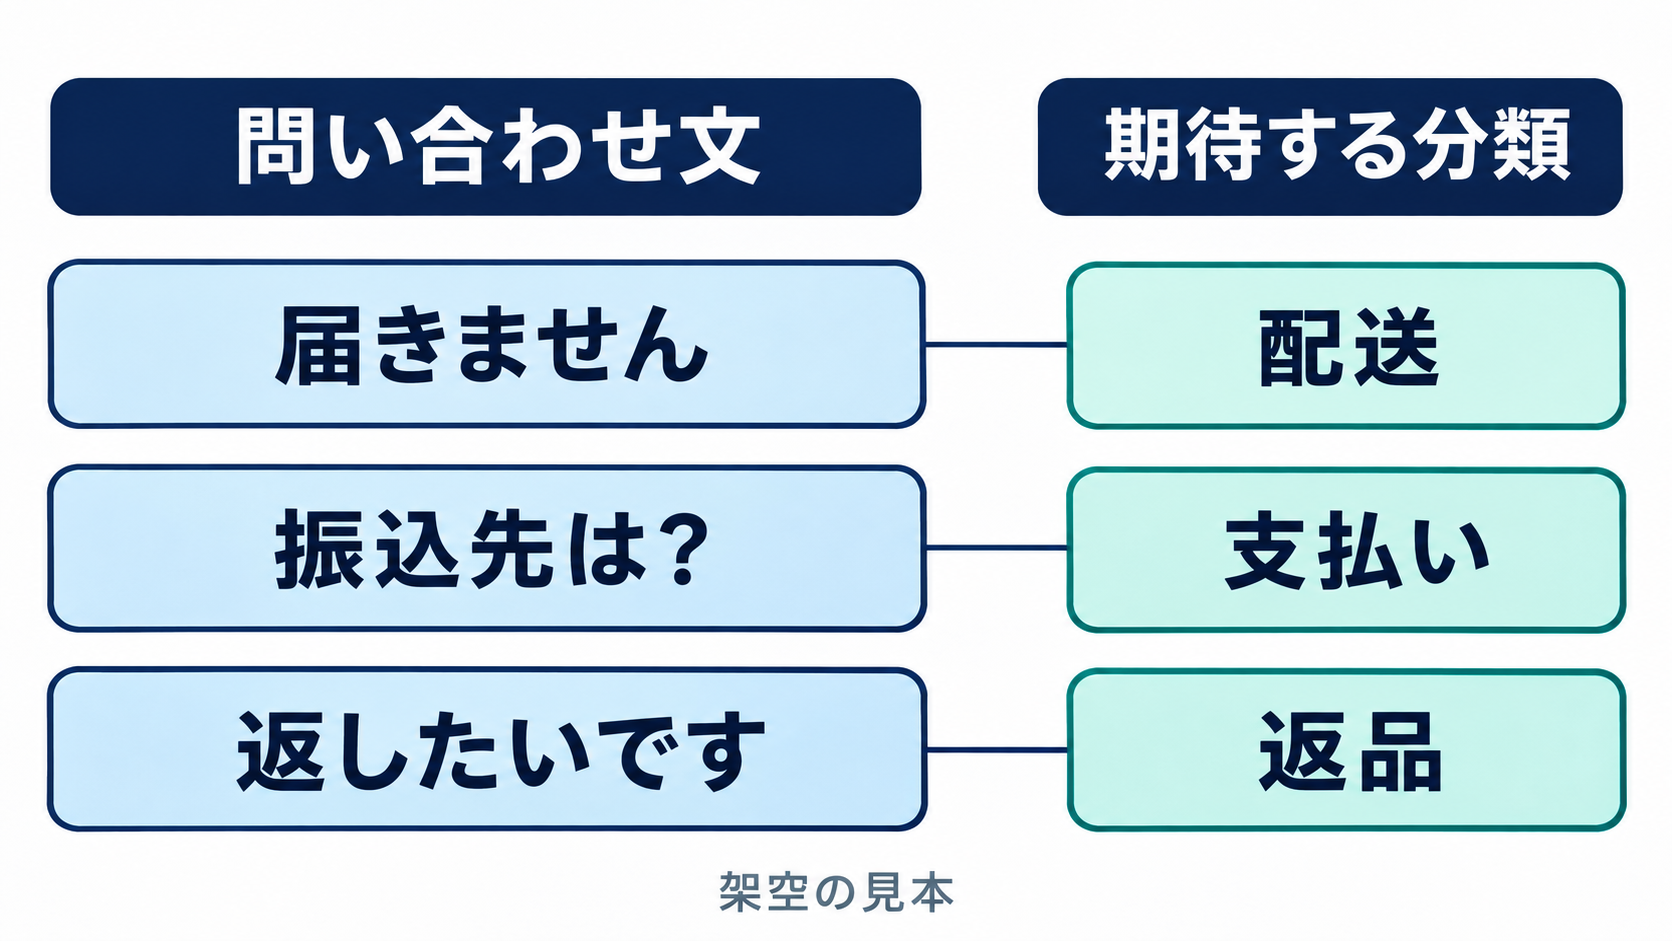
用途別の学習では、どのような見本を用意するのでしょうか。IBMの解説では、ファインチューニングに使うものとして、その用途で想定される質問や依頼文と、望ましい形式の正しい回答を含むデータが紹介されています。文章を集めるだけでなく、「その入力に対して、何を出してほしいか」を示すことがポイントです。(出典: IBM)
ここからは、仕組みを理解するための架空の例です。ある通販窓口で、問い合わせを「配送」「支払い」「返品」の三つに分けるとします。学習用の見本は、次のような組み合わせで表せるでしょう。実際に追加学習を行った結果ではありません。
| 問い合わせ文の見本 | 期待する分類 |
| --- | --- |
| 荷物がまだ届きません | 配送 |
| 振込先を確認したいです | 支払い |
| 届いた商品を返したいです | 返品 |
この例で考えたいのは、分類の名前よりも、分類の基準です。「商品が壊れて届いたので返したいです」という文章を、配送中の問題として扱うのか、返品の希望として扱うのかは、窓口の運用によって判断が分かれるかもしれません。そこで、見本を作る前に「返品を希望している場合は返品に分けます」といったルールを、人が決めておく方法を提案します。
同じような問い合わせに異なる正解を付けてしまうと、何を望む調整なのかを人も説明しにくくなります。見本を点検する際は、件数だけを見るより、「似た文章に同じ基準を適用しているか」「短い表現や言い換えも想定しているか」を確認するとよいでしょう。この表はあくまで説明用であり、三つの見本だけで実用的な調整ができることを示してはいません。実際に何をどれだけ用意するかは、目的と評価結果に応じて検討する必要があります。
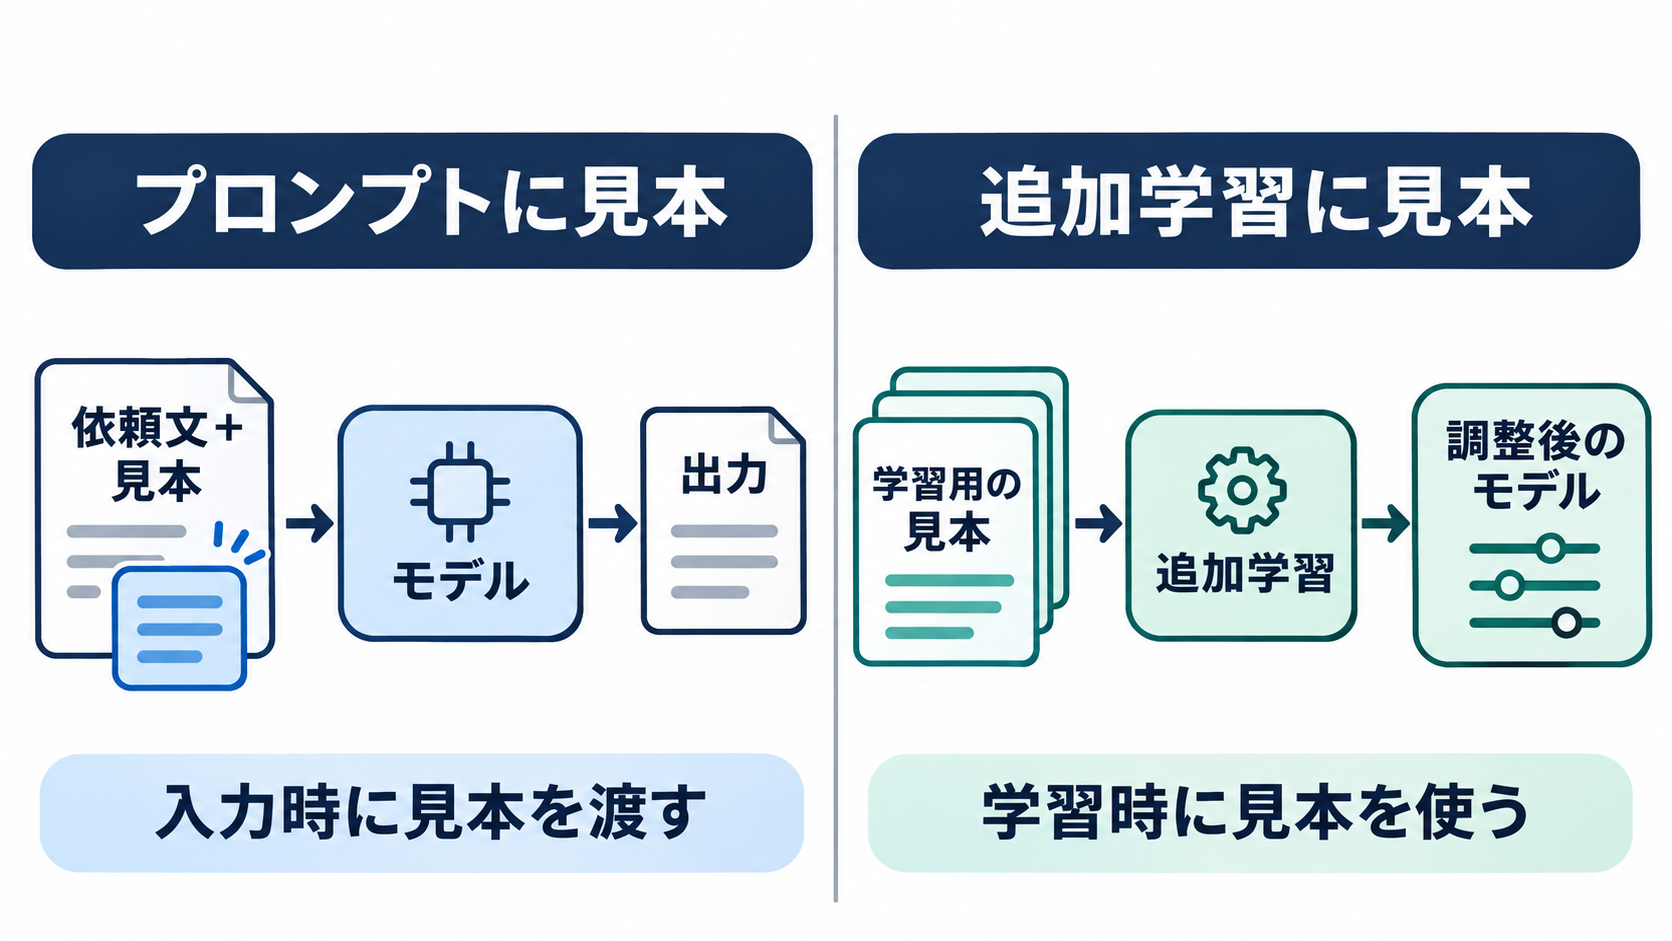
プロンプトに見本を添える方法とは、何が違う?
「見本を示すなら、普段の依頼文に書けばよいのでは」と思うかもしれません。実際、その場の依頼文であるプロンプトに、期待する回答の例を添える方法があります。Googleの公式用語集では、複数の例を含めて回答の仕方を示す手法を、フューショット・プロンプティングと説明しています。名前を暗記するより、「依頼と一緒に見本を渡す方法」と捉えると分かりやすいでしょう。(出典: Google Developers)
たとえば、次の文章は問い合わせ分類を試すためのプロンプト例です。特定のサービスで動作を検証したものではなく、依頼の組み立て方の提案です。
> 問い合わせを「配送」「支払い」「返品」のいずれかに分類してください。例として、「荷物が届きません」は配送、「振込先を知りたいです」は支払いに分けます。分類する文章は「商品を返したいのですが、どうすればよいですか」です。分類名だけを回答してください。
両者の違いは、見本が使われる場所です。プロンプトに添えた見本は、その入力の中で回答の仕方を示します。ファインチューニングでは、用途別の見本を追加学習に使い、モデルのパラメータを調整します。同じ問い合わせ文と分類の組でも、入力時の参考にするのか、学習による調整に使うのかで役割が変わります。(出典: Google Developers)
初心者が用途の条件を整理する段階では、依頼文に分類ルールと見本を書き出すところから始める方法を提案します。試しながら「説明が足りないのか」「分類自体が曖昧なのか」を確認できるからです。その場の入力に例を添えたというだけで、ファインチューニングを実施したとは呼べません。また、追加学習をすれば常にプロンプトの工夫よりよい結果になる、と決めつけることも避けたいところです。
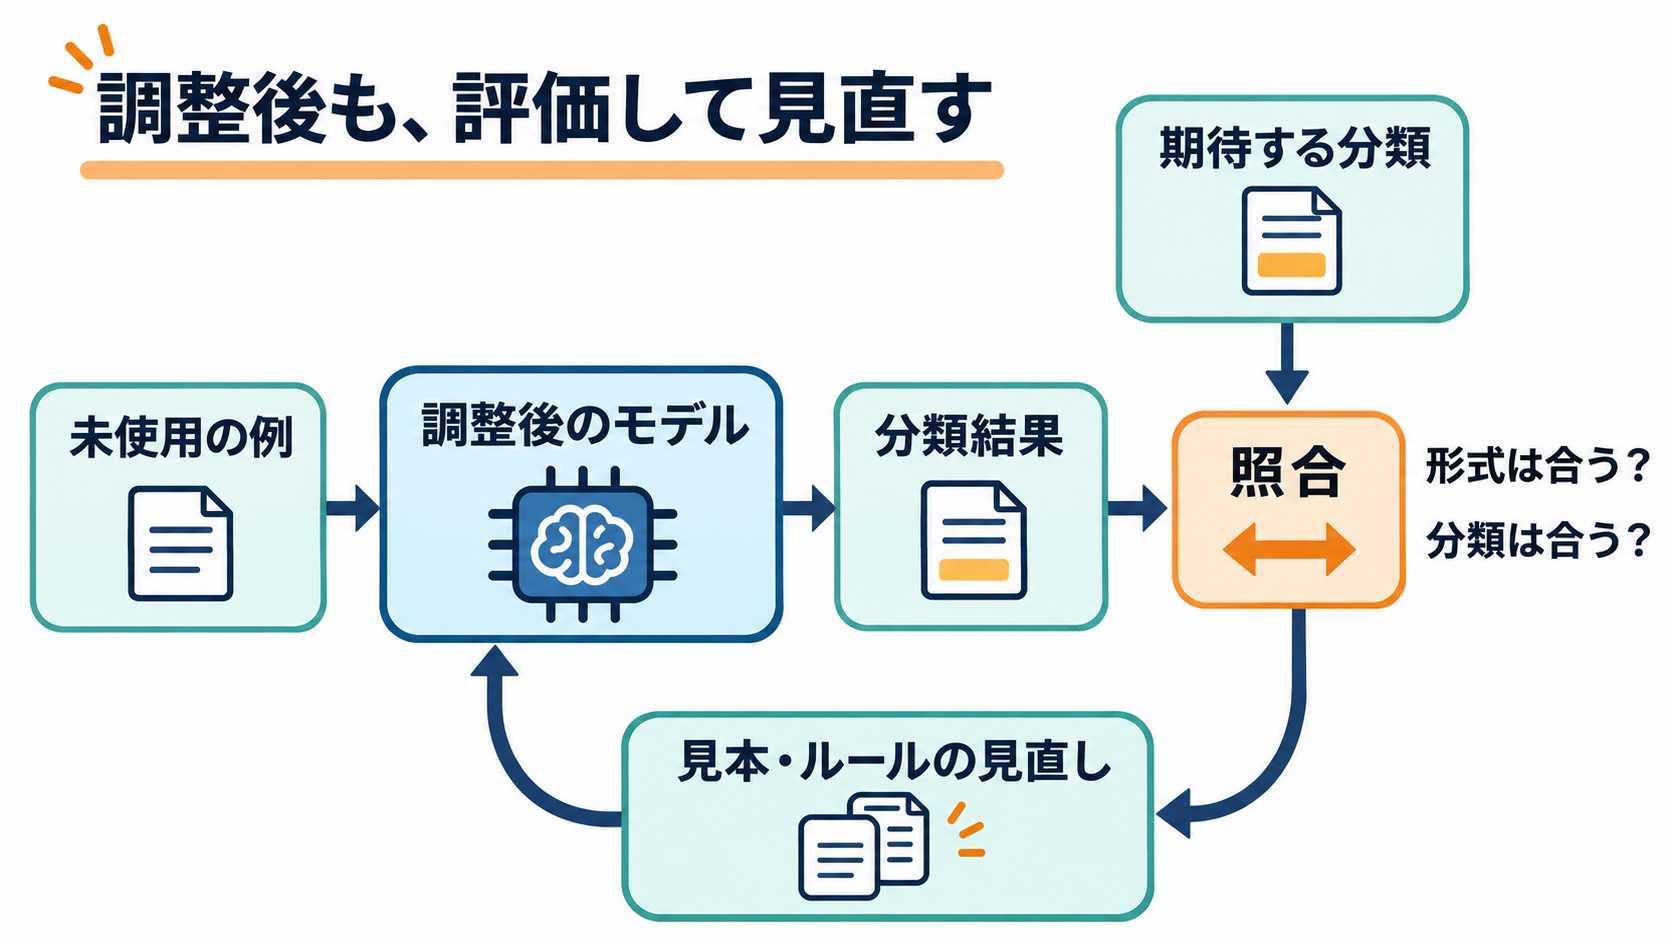
用途に合わせても、正しさの確認は残ります
「自分の仕事向けに学習させたモデルなら、安心して任せられますか」という疑問も自然です。ここで分けたいのは、用途に合った出力と、内容の正しさです。分類名を指定どおりの形で返せても、その分類が適切とは限りません。ファインチューニングをしたことだけを、個々の回答の正しさの根拠にはできません。
IBMの解説では、生成AIの運用の流れに、学習や調整だけでなく、生成結果の評価とさらなる調整が含まれています。Googleの公式用語集も、評価をモデルの品質の測定や比較として説明しています。調整を終えたことと、求める品質を確認できたことは、別の段階として扱う必要があります。(出典: IBM、Google Developers)
問い合わせ分類の架空の例なら、評価方法として、追加学習に使っていない文章を別に用意することを提案します。「荷物は届きましたが、請求額を確認したいです」という文では、配送に関する言葉が含まれていても、中心の用件は支払いです。単語が含まれているだけで分類していないかを確かめる材料になるでしょう。
「返品したいです。返送料はいくらですか」のように、複数の用件が重なる例も考えられます。この場合はモデルの結果を採点する前に、人の側で期待する扱いを決める必要があります。一つだけ選ぶのか、担当者による確認に回すのかで、よい出力の条件が変わるからです。
評価を考えるときは、成功例だけを眺めるより、間違いの影響にも目を向けたいところです。担当窓口の候補を出す用途と、顧客への案内をそのまま確定する用途では、必要な確認が異なります。どこまで自動で扱い、どこから人が確認するかを先に決めることも、導入を考える際の提案です。
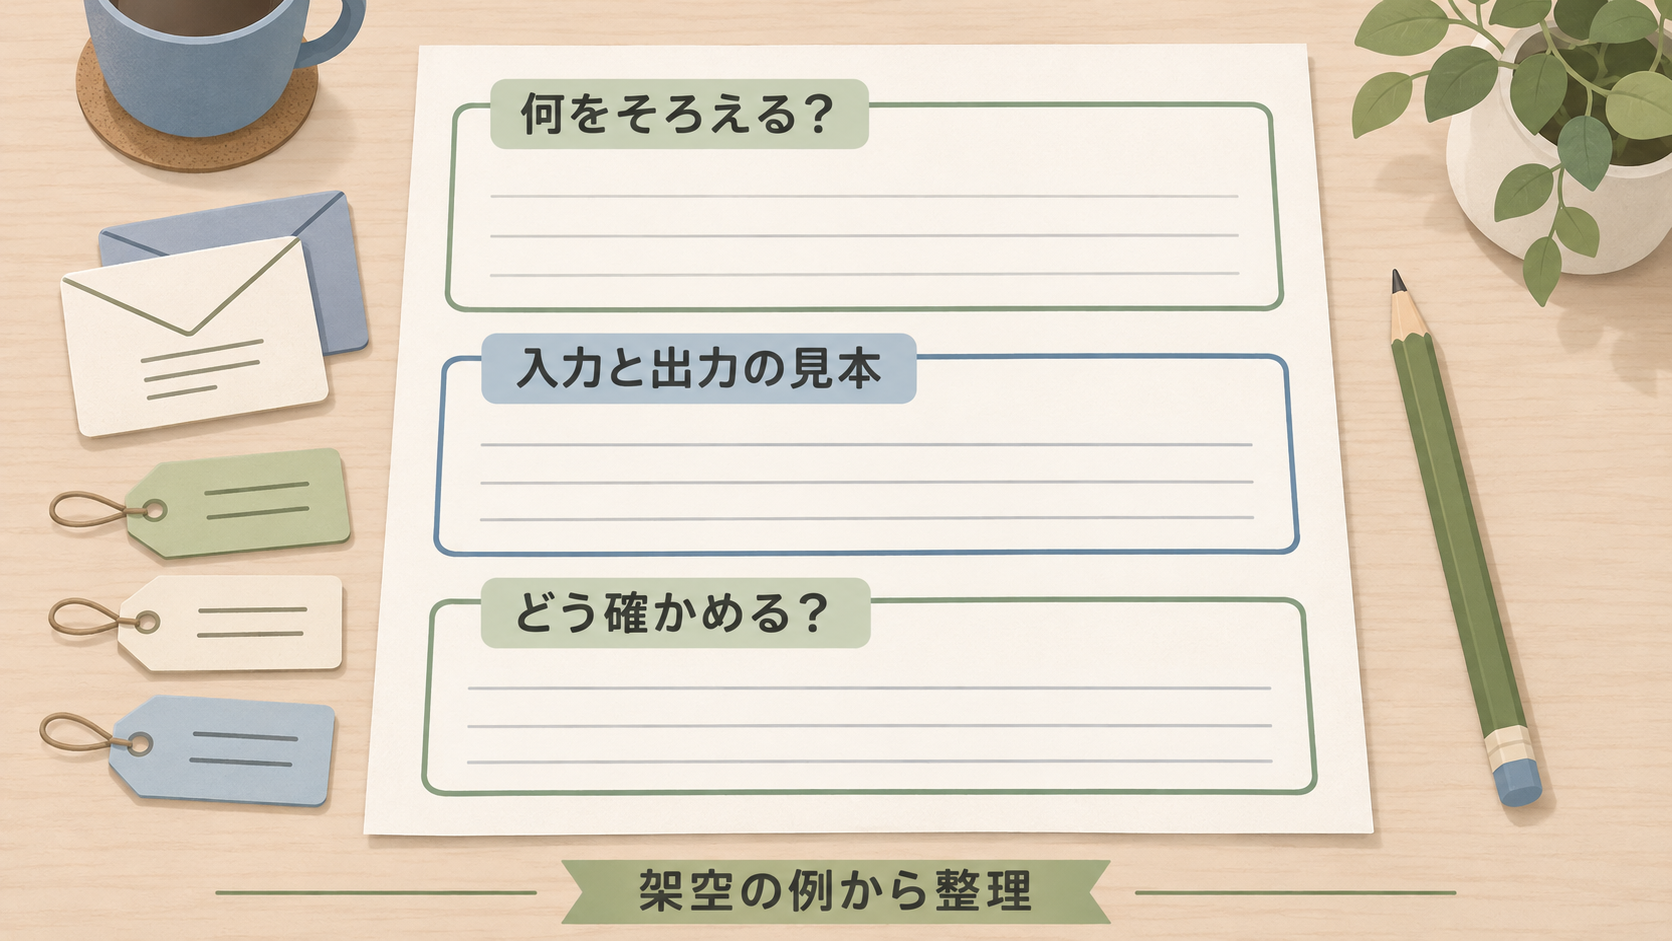
明日は「覚えさせたいこと」より「そろえたい出力」を書いてみる
ファインチューニングを理解すると、「AIにうちの仕事を覚えさせたい」という漠然とした希望を、もう少し具体的な問いに変えられます。問い合わせを正しい担当へ振り分けたいのか、回答の書式をそろえたいのか、文章の調子を用途に合わせたいのか。目的を言葉にすると、どんな見本が必要で、何を確かめるべきかも考えやすくなるでしょう。
IBMは、用途に応じたファインチューニングの材料として、想定される質問や依頼文と、望ましい形式の正しい回答を挙げています。Googleも、学習済みのモデルを特定の用途向けに追加学習で調整するものと説明しています。共通するのは、単に情報を渡すという発想だけではなく、入力に対して期待する出力を定める視点です。(出典: IBM、Google Developers)
明日できる一歩として、架空の問い合わせを三つ書き、それぞれに期待する分類と理由を添えてみることを提案します。ここでの三つは、学習に必要な件数を示すものではありません。自分が考える分類ルールを、短いメモで確かめるための出発点です。「荷物が遅れています」は配送、「返金の予定日を知りたいです」は支払い、と書いてみて、別の担当者も同じ判断になるかを考えてみてください。
判断が分かれるなら、先に整えるべきものは分類のルールかもしれません。ルールは一致していて、AIへの伝え方が曖昧なら、プロンプトと見本を見直す余地があるでしょう。同じ用途を繰り返し扱う仕組みとして追加学習を検討する場合にも、このメモは目的を説明する材料になります。
専門的な設定方法まで覚える必要はありません。「どんな入力に、どんな出力を返してほしいか」「それを何で確かめるか」を一組で書くことから始めてください。それが、ファインチューニングという言葉を、仕事の具体的な判断につなげる一歩になります。
参考情報
- What Is Artificial Intelligence (AI)? | IBM
- Machine Learning Glossary: Generative AI | Google Developers
資料の取得日時は2026年11月19日です。IBMの記事には公開日が2024年8月9日、更新日が2026年10月2日と記載されています。取得日は公開日とは異なり、本記事では基礎概念の説明に使用しています。