
2026/10/30
AIニュース
3B稼働モデルが金融調査でClaude超え――Samaya Sterlingが示す「モデルと実行基盤の共同設計」
金融調査AIの競争軸を変えるSamaya Sterling
金融調査AIの性能を上げるには、より大きなモデルを使い、推論時間と費用を増やすしかないのでしょうか。Samaya AIが発表した金融調査エージェント「Samaya Sterling」は、その前提に異なる答えを示しています。Sterlingは、NVIDIAのNemotron 3.5 Lightningを金融分野向けに追加学習したモデルです。総パラメータ数は300億ですが、処理時に使うのは30億パラメータに抑えられています。
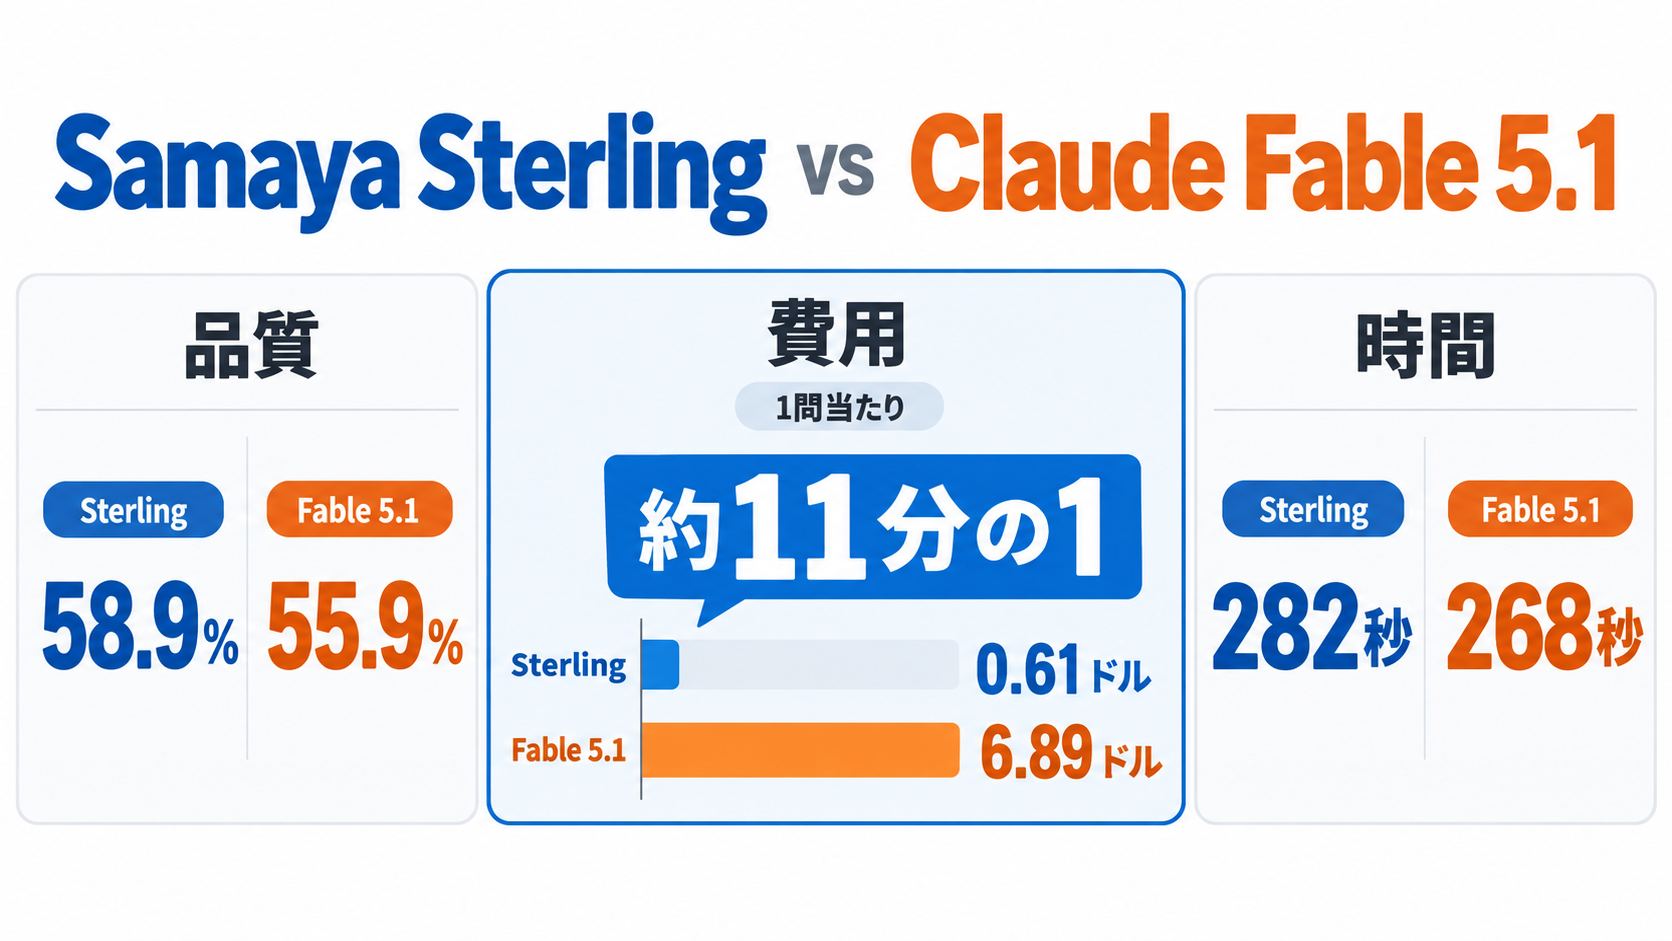
Samaya AIが運営する金融調査ベンチマーク「FrontierFinance」では、Sterlingが58.9%を記録しました。比較対象となったClaude Fable 5.1は55.9%です。1問当たりの費用はSterlingが0.61ドル、Fable 5.1が6.89ドルで、Samaya AIは約11分の1の費用で上回ったと説明しています。高負荷モードでは、Sterlingのスコアが60.6%まで上昇しました。
この発表で中心となる論点は、30億の有効パラメータだけではありません。Samaya AIは、モデルに接続するツール、コンテキストの整理方法、調査を打ち切る条件まで含めて、小型モデルが扱いやすい形へ作り直しました。モデルと実行基盤を別々に最適化するのではなく、一つのシステムとして学習・設計した点に特徴があります。
ただし、数値の受け止め方には注意が必要です。FrontierFinanceの結果はSamaya AI自身が公表したものであり、同社のベンチマーク上で測定されています。第三者による再現検証や、Sterlingの公開APIを使った比較結果は現時点では示されていません。今回の成果は幅広い業務での優位性を証明するものではなく、金融調査という限定された領域で、専用設計が費用対効果につながった事例として見るのが妥当です。
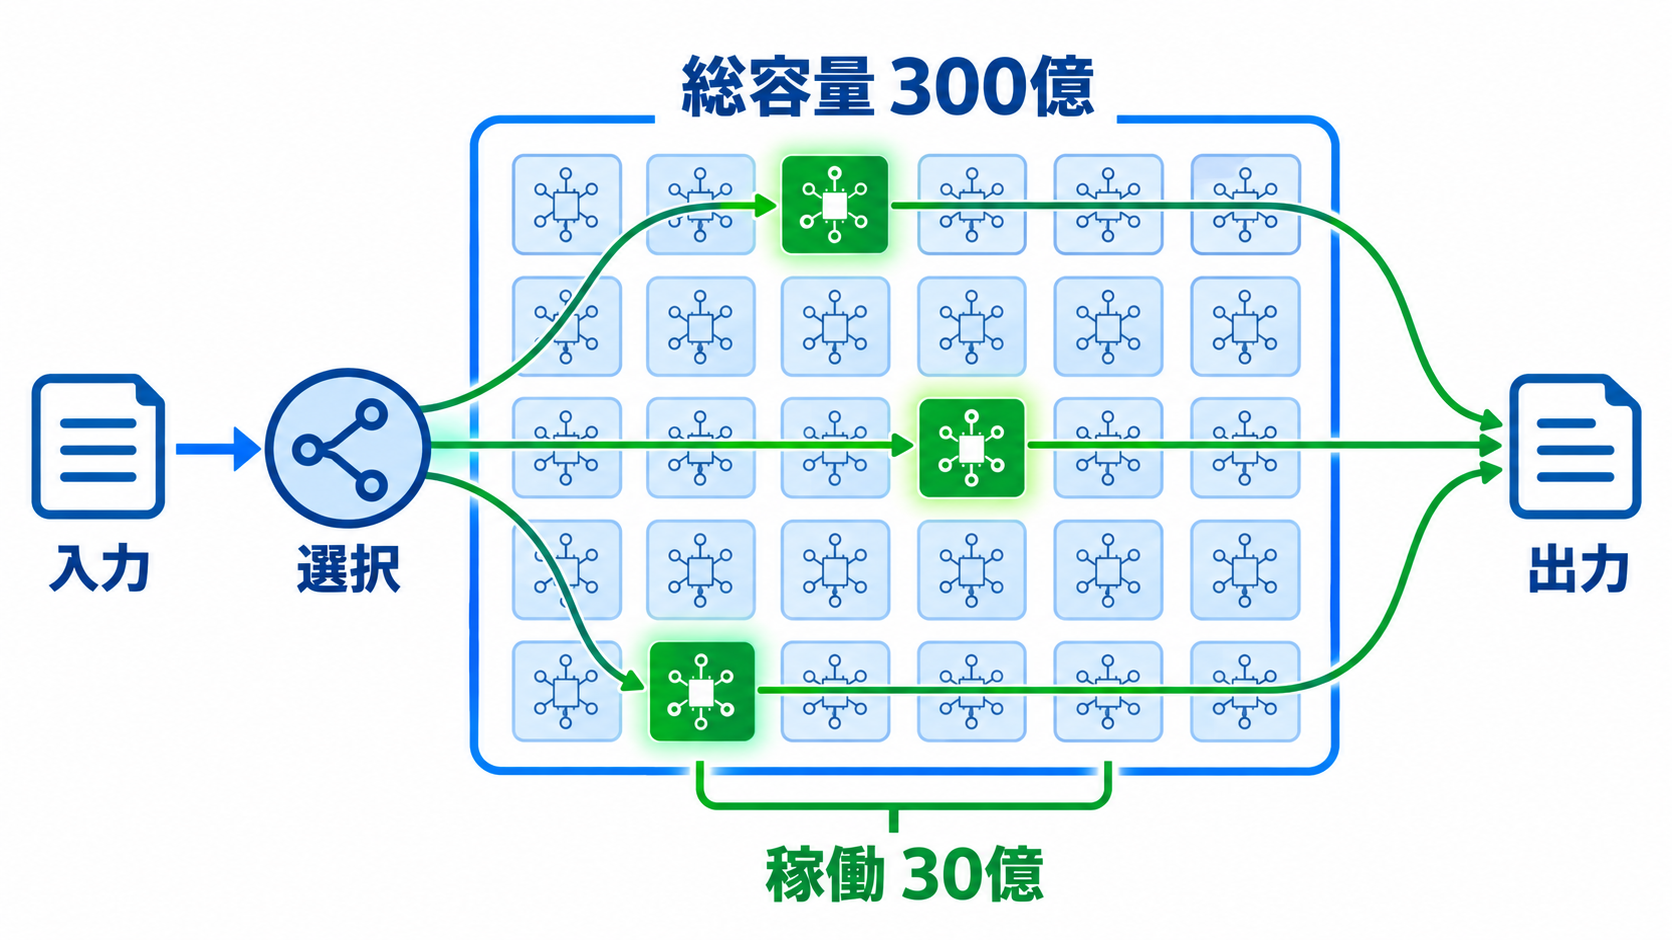
300億の総容量と30億の稼働部分を持つMoE
Sterlingの基盤となったNemotron 3.5 Lightningは、Mixture of Experts、略してMoEと呼ばれる構造を採用しています。MoEでは、用途の異なる複数の専門的な処理部分をモデル内に用意し、入力に応じて必要な部分だけを動かします。Sterlingの場合、モデル全体では300億パラメータを保持しながら、1回の処理で稼働するのは30億パラメータです。すべてのパラメータを毎回使う同規模モデルとは、計算量の性質が異なります。
「30億パラメータのモデル」と単純に表現すると、モデルが保持する知識容量まで30億であるかのように受け取られかねません。Sterlingは300億の総容量を持ち、その一部を選択的に使うモデルです。Samaya AIが強調している小ささは、主に推論時の有効パラメータ数を指しています。性能や運用費を比較するときは、総パラメータ数と有効パラメータ数を分けて確認する必要があります。
基盤モデルは最大100万トークンのコンテキストに対応し、25万6,000トークンの設定であれば、BF16形式で80GBのNVIDIA H100 GPU 1基に収まるとされています。ただし、この条件はNemotron 3.5 Lightningに関する情報です。Sterlingが実際に提供される際のコンテキスト長、使用ハードウェア、同時処理能力は明らかにされていません。基盤モデルの仕様を、そのまま製品の提供条件とみなすことはできません。
追加学習にはLoRAが使われました。LoRAは基盤モデルの重み全体を書き換えず、比較的小規模な追加パラメータを学習させる手法です。学習負荷を抑えながら、特定分野や作業形式へ適応させやすい利点があります。なお、Nemotron 3.5 Lightningはオープンウェイトとして提供されていますが、Sterlingについては公開ウェイトや一般向けAPIの提供が発表されていません。再現を検討する企業は、基盤モデルとSterlingの利用条件を混同しないことが大切です。
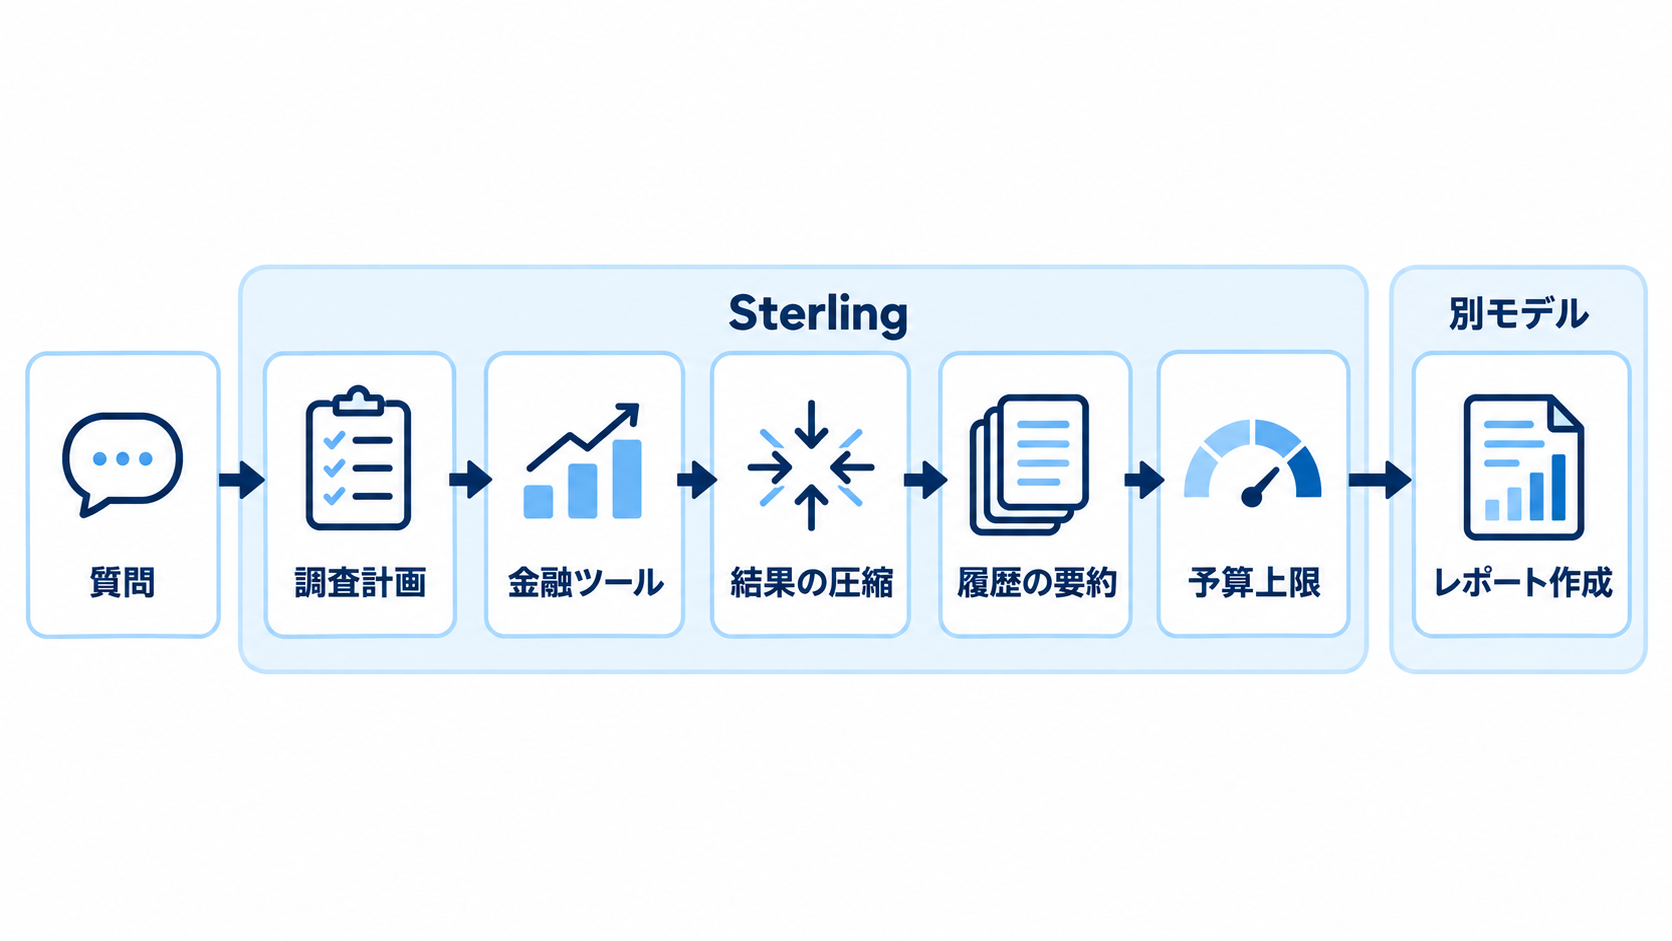
小型モデルを支える調査ハーネスの再設計
金融調査エージェントは、質問に対して文章を生成するだけのチャットボットではありません。調査計画を立て、金融関連のツールを呼び出し、得られた情報を整理しながら証拠を集めます。Sterlingはこの調査部分を担当し、収集した内容を別のレポート作成モデルへ引き渡します。調査と最終的な文章作成を分離することで、Sterlingは情報探索とツール操作に集中できる設計です。
Samaya AIは、本番環境で使っていた金融調査用ハーネスを、小型モデルに合わせて簡素化しました。ハーネスとは、モデルをツールや業務手順へ接続し、その動作を管理する周辺基盤を指します。詳細な指示をシステムプロンプトやツール説明へ大量に書く構成を見直し、似たツールを統合して、モデルが読む情報量と選択肢を減らしました。ツール数が多いだけでは、エージェントが賢くなるとは限りません。選択肢が複雑になれば、誤ったツールや引数を選ぶ余地も増えるためです。
長い調査過程を扱うため、コンテキスト管理には二つの補助モデルが使われています。「コンデンサー」はツールから返された長い結果を短縮し、「コンパクター」は調査履歴が増えるにつれて、それまでの経緯を要約します。モデル本体へすべての情報をそのまま渡さず、判断に必要な要素を残す役割です。基盤モデルが長いコンテキストに対応していても、無制限に情報を詰め込めば、処理費用や待ち時間が増えます。長い入力を扱える能力と、長い入力を毎回使うべきかどうかは別の問題です。
調査には予算上限も設定されています。決められた範囲まで調査すると、Sterlingは探索を終え、集めた情報をレポート作成側へ渡します。この上限は、回答の深さだけでなく、費用と所要時間を制御する仕組みでもあります。Samaya AIのMaithra Raghu氏による発表では、開発はエージェント構成の効率化を目指す2人の取り組みから始まったとされています。モデルの規模よりも、限られた計算予算をどこへ配分するかが設計の出発点だったことがうかがえます。
2段階のSFTと2段階のGRPOによる学習
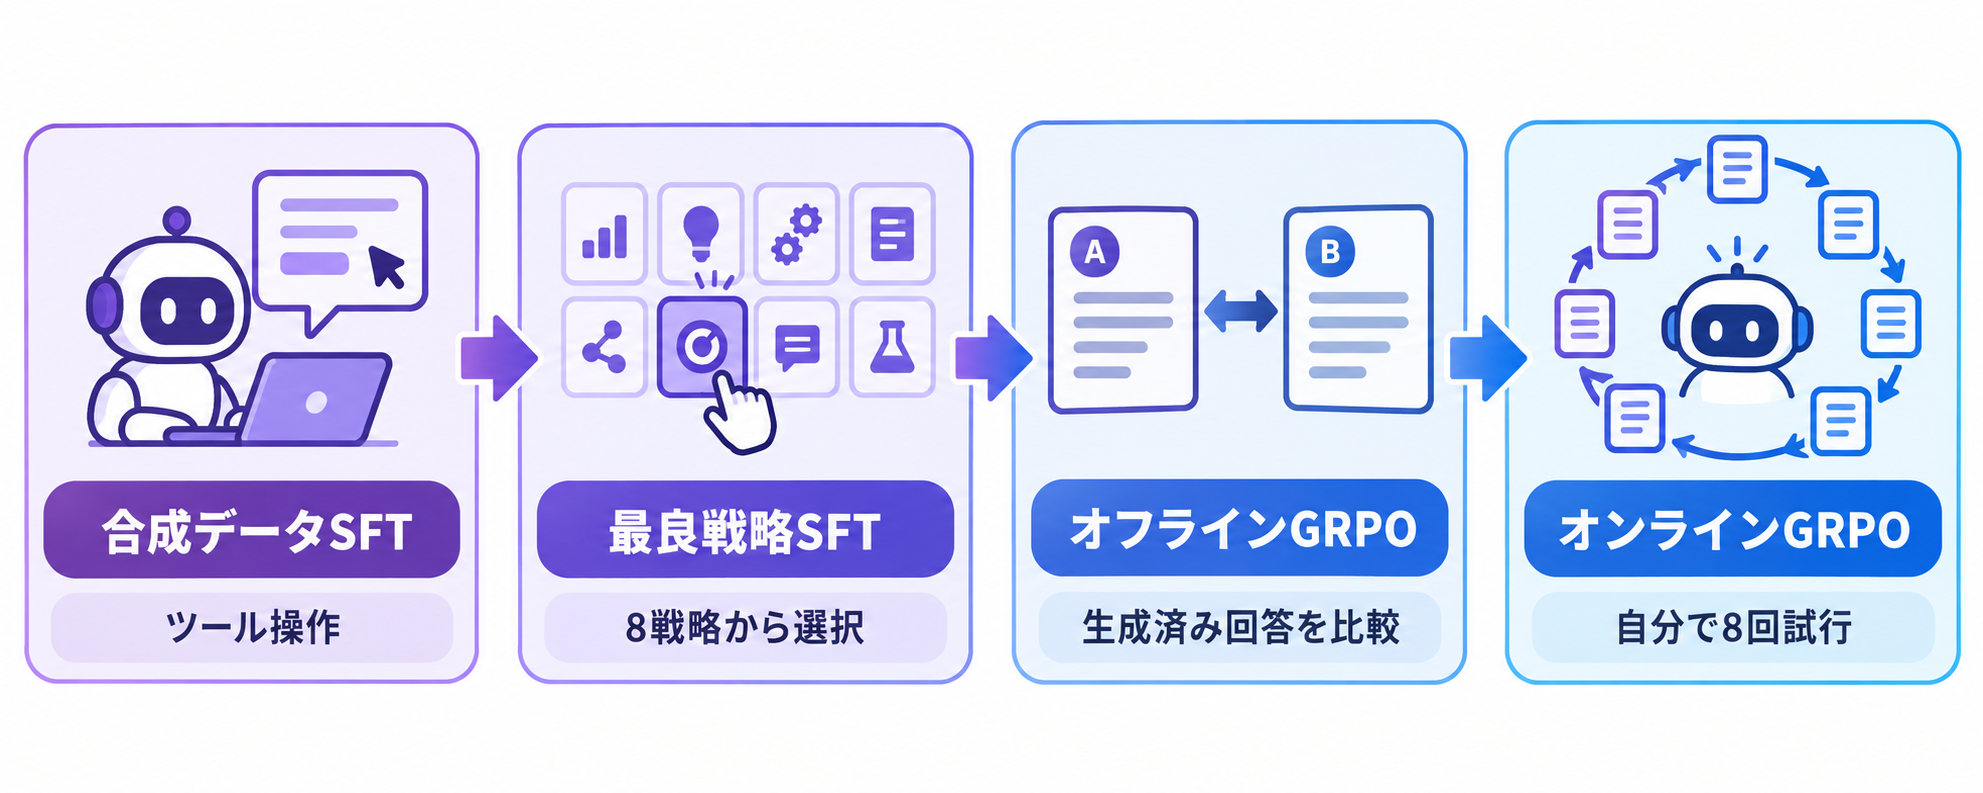
Sterlingの追加学習は、Thinking Machines Labが提供する学習API「Tinker」を利用し、4段階で進められました。前半の2段階は教師データの模範例を学ぶSFT、後半の2段階は複数の回答を比較しながら改善するGRPOです。単に金融知識を覚えさせるのではなく、調査方針の選択、ツールの呼び出し、引数の指定といった一連の行動を学習対象にしています。
第1段階では、968件の合成アナリスト質問が用意されました。教師モデルのKimi K3が各質問へ2回答ずつ作成し、別のLLMによる判定で良い方を選びます。Sterlingは、このデータを通じて37種類のツールを正しい引数で呼び出す方法を学びました。ここでは最終回答の内容だけでなく、業務ツールを壊さずに扱う基本動作を整えることが主眼です。
第2段階では、専門家が作成した1,819件の質問に対し、Kimi K3が8種類の調査戦略を使って回答しました。質問ごとに最も高く評価された回答を教師データとして採用し、品質確認後には1,157件が残っています。8戦略から選んだ回答は、評価基準で必須とされた項目の80%を満たしました。単一戦略のうち最良のものでは約66%だったため、複数の探索方法を試してから良い軌跡を選ぶことが、教師データの改善につながったとされています。
第3段階のオフラインGRPOでは、すでに生成済みの8回答を相互に比較して学習しました。新しい回答を毎回生成する必要がないため、学習ステップ当たりの費用を抑えられます。第4段階のオンラインGRPOでは、Sterling自身が質問ごとに8回答を生成し、その評価をもとに更新されました。MoEモデルのサンプリング時に生じる既知のずれへ対応するため、打ち切り付き重要度サンプリングも用いられています。
この工程から読み取れるのは、データ件数だけを増やしたわけではないという点です。どの調査戦略が評価基準を満たしたか、ツールを正しく操作できたか、モデル自身の試行が改善したかを段階ごとに分けています。企業が同様の手法を検討する場合も、完成した回答だけを学ばせるのではなく、調査経路とツール操作を評価可能な形で記録することが前提になるでしょう。
220問のFrontierFinanceで見えた改善の積み重ね
FrontierFinanceには、公開された220件の質問と、専門家が作成した採点基準が用意されています。回答の評価には3モデルで構成される判定パネルが使われます。Samaya AIは、ベンチマークの質問をSterlingの学習へ使用しておらず、学習途中のチェックポイント選定には別の社内検証用100問を使ったと説明しています。
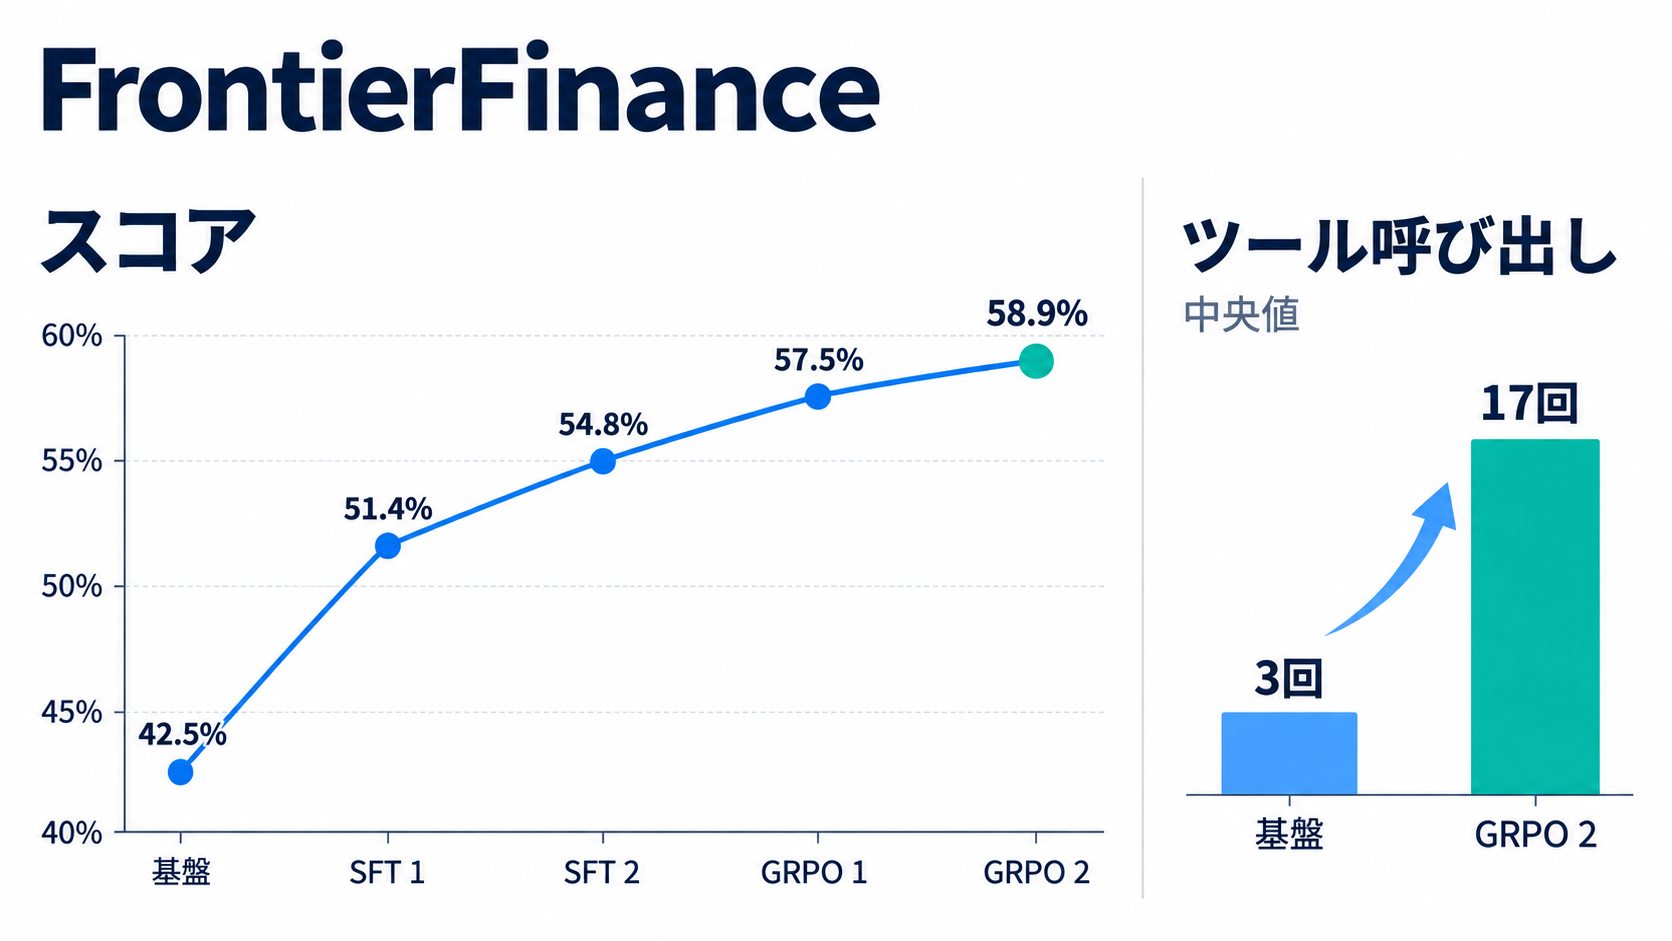
Sterlingのスコアは、基盤モデルの42.5%から、学習段階を経るごとに51.4%、54.8%、57.5%、58.9%へ伸びています。特定の一段階だけで急に性能が上がったのではなく、SFTとGRPOの各工程が改善を積み重ねた形です。ツール呼び出し回数の中央値も3回から17回へ増えました。これは、モデルがより多くの調査行動を取るようになったことを示しますが、呼び出し回数の多さ自体が品質を保証するわけではありません。重要なのは、追加された呼び出しが採点基準の充足に結び付いたかどうかです。
難度が高い上位3分の1の質問では、スコアが31.8%から45.2%へ上昇しました。通常設定の58.9%より低く、難しい金融調査が依然として課題であることも分かります。高負荷モードでは全体スコアが60.6%になりますが、1問当たりの費用は1.83ドル、所要時間は372秒まで増えます。品質を約1.7ポイント上げるために、費用と時間をどこまで許容するかという運用判断が必要です。
ベンチマークは、同一条件でシステムを比べるための有用な材料です。ただし、FrontierFinanceはSamaya AIが運営し、結果も同社による自己申告です。実際の企業調査では、対象市場、利用可能なデータ、社内用語、証拠の提示方法が異なります。58.9%という一つの数値を導入可否の根拠にするのではなく、自社の質問と採点基準を用意し、誤りの種類まで確認する必要があります。
1問0.61ドルを実現した費用配分
Sterlingの通常設定は、FrontierFinanceで58.9%、1問当たり0.61ドル、所要時間282秒でした。Claude Fable 5.1は55.9%、6.89ドル、268秒と報告されています。Sterlingは品質と費用の組み合わせで優位に立つ一方、処理時間は14秒長くなっています。短時間の会話応答ではなく、数分かけて資料を集める調査エージェントとして評価すべき特性です。
| システム | FrontierFinanceスコア | 1問当たり費用 | 1問当たり時間 |
| --- | --- | --- | --- |
| Samaya Sterling | 58.9% | 0.61ドル | 282秒 |
| Samaya Sterling高負荷 | 60.6% | 1.83ドル | 372秒 |
| Claude Fable 5.1 | 55.9% | 6.89ドル | 268秒 |
| Samaya高負荷システム | 56.0% | 1.81ドル | 278秒 |
| Nemotron 3.5 Lightning基盤モデル | 42.5% | 非公表 | 非公表 |
Sterlingのモデル推論そのものにかかる費用は、1問当たり0.04ドルとされています。0.61ドルとの差額は、金融ツールやコンテキストを管理する補助モデルなどに充てられます。この内訳は、エージェント型AIの費用を考えるうえで見落とせません。基盤モデルのトークン単価だけを比較しても、検索、外部API、再試行、要約、最終レポート作成を含む総費用は把握できないためです。
Samaya AIが従来運用していた高負荷システムは、1.81ドルで56.0%でした。Sterlingはその約3分の1の費用で2.9ポイント高い結果を出したことになります。高負荷版Sterlingも1.83ドルで60.6%に達しており、同程度の費用枠で品質を高めています。ここからは、安価なモデルへ単純に置き換えた効果というより、学習済みの調査行動と簡素化したハーネスの組み合わせが効いたと考えられます。
企業が費用を比較するときは、1問当たりの平均値に加え、失敗時の再実行、質問の難度によるばらつき、人による確認時間も含めるべきです。Sterlingの提供価格やAPI条件は公表されていないため、0.61ドルをそのまま将来の購入価格として予算化することはできません。現段階では、技術評価時のシステム原価として捉えるのが安全です。
日本企業が検証すべき「狭い領域での共同設計」
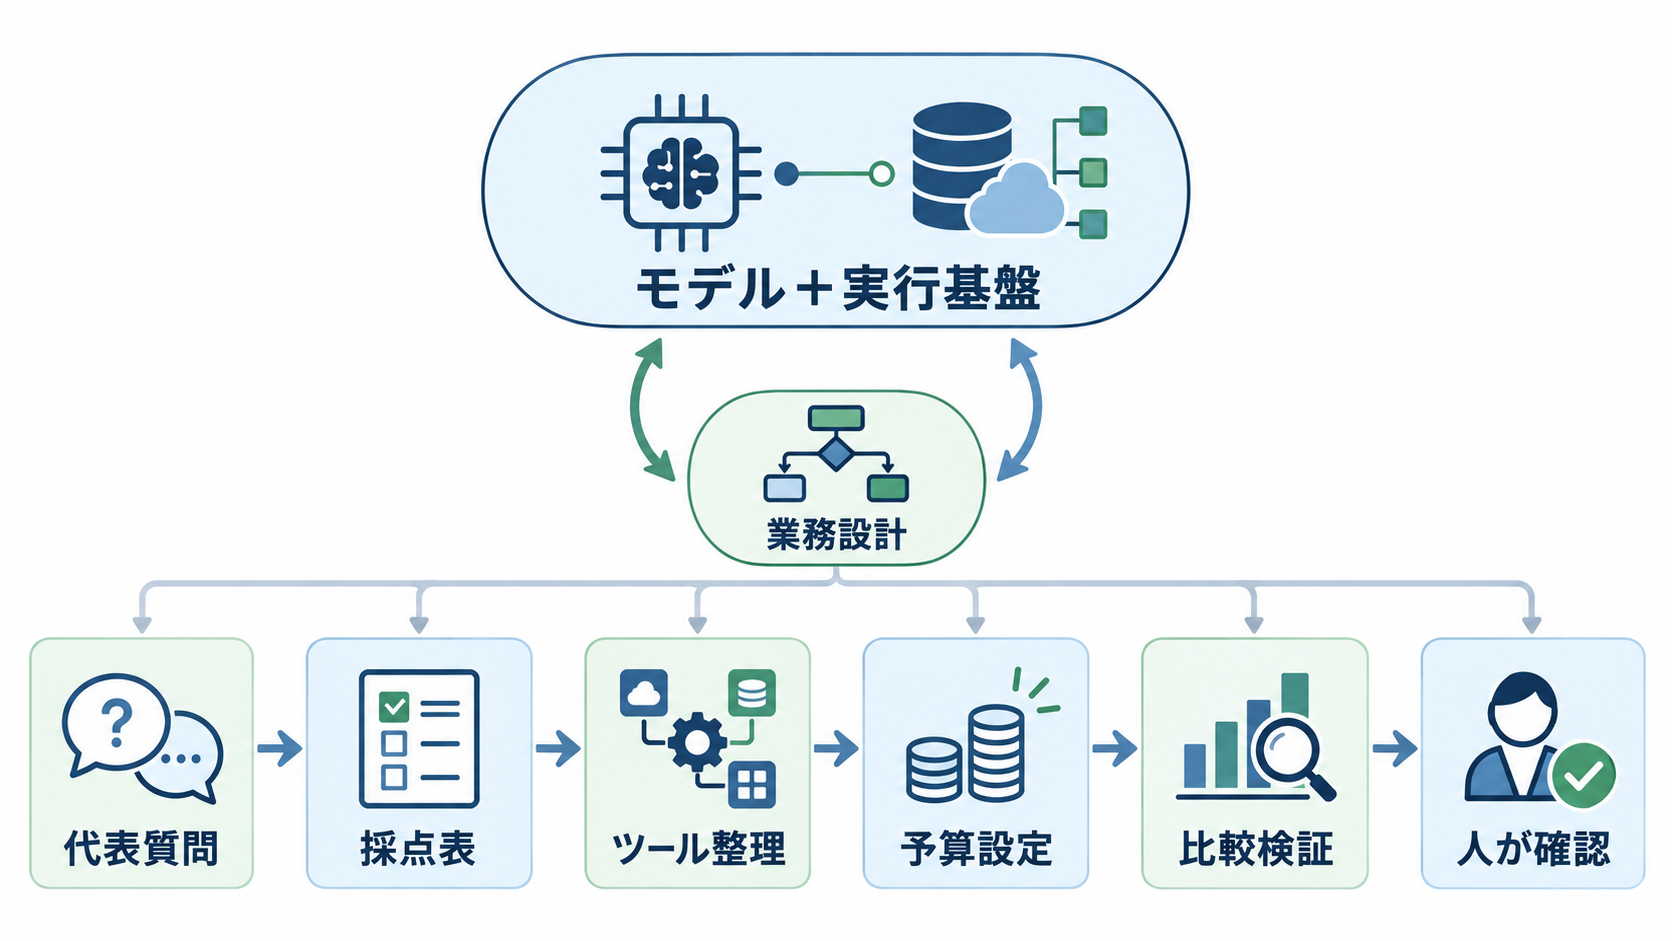
Sterlingが示した実務上の示唆は、汎用モデルをすべての業務へそのまま適用する方法だけが選択肢ではないことです。対象業務を狭く定め、質問、評価基準、ツール、調査予算を一体として設計すれば、有効パラメータの少ないモデルでも競争力を持つ可能性があります。特に、参照先や手順がある程度決まっており、成果物を採点できる調査業務とは相性を検討しやすいでしょう。
導入検討では、モデル選定より先に、自社で「良い調査」と呼べる条件を言語化する必要があります。回答へ含めるべき項目、使用を認める情報源、引用の要件、許容できない誤りを採点表にまとめます。そのうえで、代表的な質問を用意し、調査過程のツール呼び出しと最終回答を別々に評価します。Sterlingの学習工程でも、専門家の評価基準と調査軌跡が改善の土台になっていました。
ツール構成は、数を増やす前に役割の重複を点検した方がよいでしょう。似た検索機能が複数あれば統合し、モデルへ渡す説明を短くします。長い検索結果を圧縮する処理、過去の調査履歴を要約する処理、実行回数や費用を止める上限も設けます。これらは小型モデルのためだけの工夫ではありません。大規模モデルを使う場合でも、入力の肥大化や無制限なツール利用を抑える運用策になります。
金融分野では、スコアが高くても人の確認を省けるとは限りません。難問群でのSterlingのスコアは45.2%であり、採点基準を満たさない項目が残っています。社内利用を始めるなら、意思決定を自動化する前に、調査担当者が証拠とツール履歴を確認できる補助用途から試すのが現実的です。公開ウェイトやAPIがない現状では、Sterlingそのものの導入計画よりも、同社が示した共同設計の考え方を自社環境で検証する方が着手しやすいでしょう。
具体的な一歩は、実際の業務から20件程度の代表質問を選び、専門家が採点できる評価表を作ることです。モデル単体の回答と、検索ツールや予算管理を組み込んだ回答を同じ基準で比較すれば、追加コストがどの工程で品質へ変わったかを確認できます。Sterlingの事例を生かす鍵は、より大きなモデルを探すことではなく、自社の調査工程を測定可能な形へ分解することにあります。