
2026/10/30
今更聞けないAI知識
AIはなぜ会話の前提を見失う? コンテキストを「作業机」で理解する
さっき伝えた条件が抜ける理由
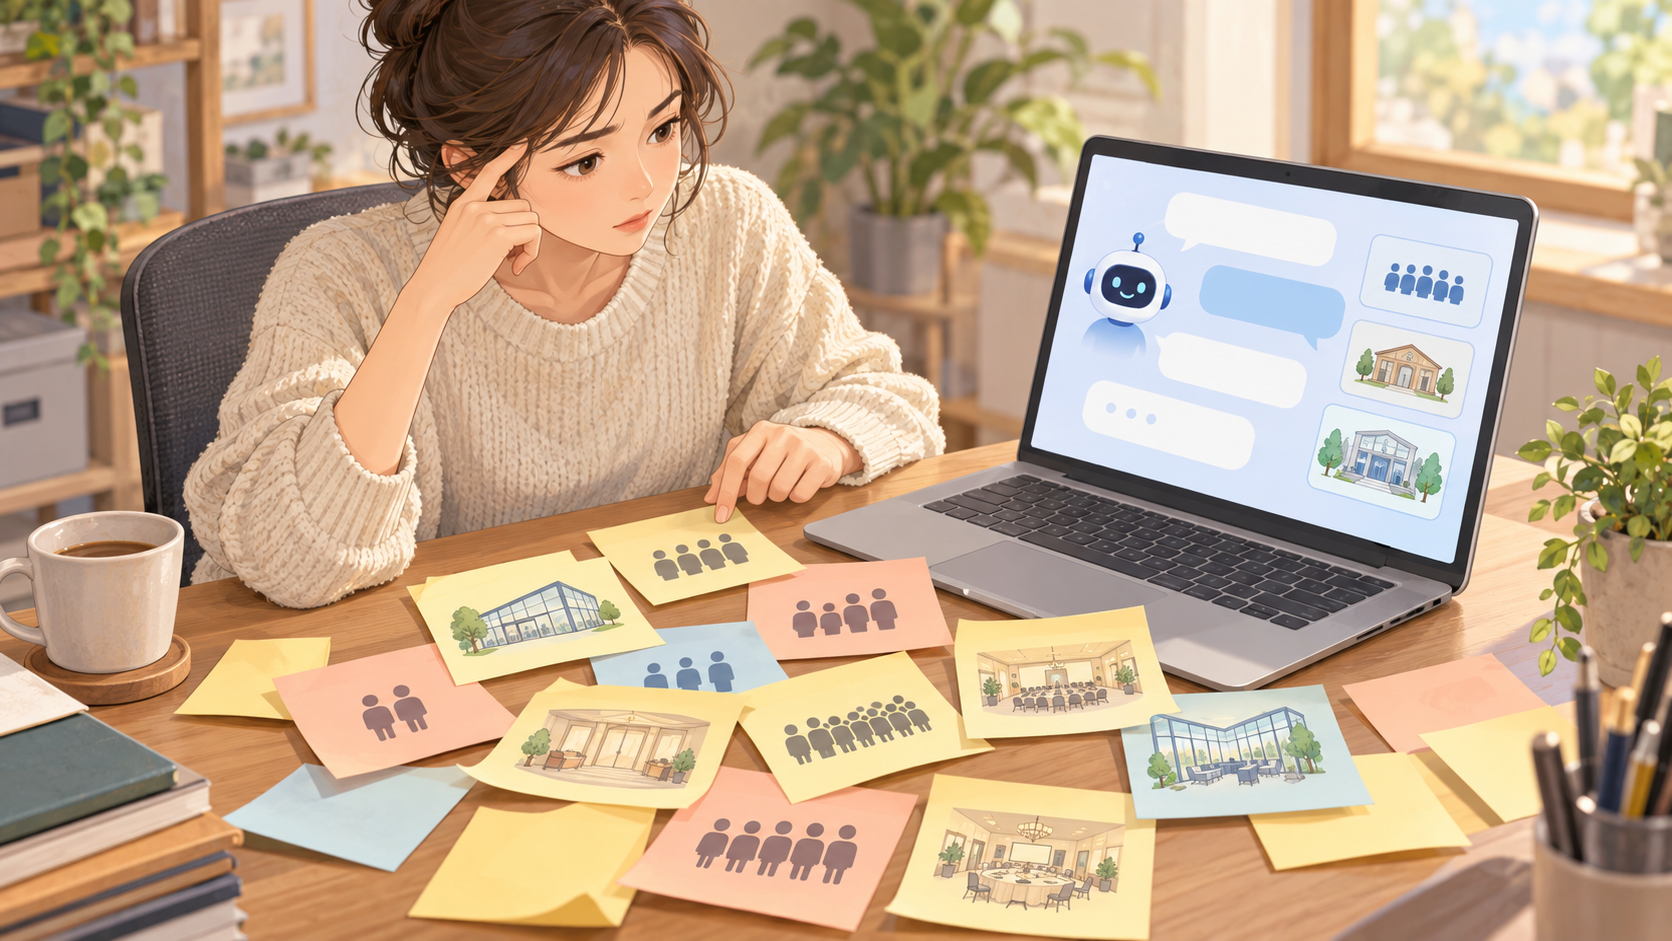
AIとイベントの相談を続けている場面を想像してください。参加人数を100人から80人に変更し、会場候補も駅前ホールから市民会館へ変えたのに、しばらく後の回答では古い条件が使われていました。「会話を覚えているはずなのに、なぜでしょう」と戸惑うのは自然なことです。
一言で答えるなら、AIは会話全体を人の思い出のように保持して振り返っているのではなく、その回答を作る時点で渡された情報を手掛かりにしているからです。文章を扱うAIの土台となる仕組みを、ここでは「モデル」と呼びます。モデルは、渡された指示や情報を使って回答を作ります(出典: Google for Developers)。画面に過去の発言が表示されていても、そのすべてが毎回同じ形でモデルへ渡され、同じ強さで参照されるとは限りません。どの情報が渡されるかは製品や会話の状態によって異なります。
ここで押さえたいのは、AIが意図的に約束を破ったわけでも、人のようにうっかり忘れたわけでもないという点です。チャットでは、以前の入力とAIの回答が後続のやり取りにおけるコンテキスト、つまり回答のために参照する情報になります(出典: Google for Developers)。ただし、参照できる範囲には限りがあり、長い会話では初期の条件が範囲から外れたり、要約されたりする場合があります(出典: IBM)。
条件が抜けた回答を見たときに、「AIは記憶力が低い」とだけ判断すると原因を見誤ります。古い条件と新しい条件が同時に残っていた、変更が確定事項なのか案なのか分かりにくかった、重要な指定が大量の文章に埋もれた、といった可能性もあるでしょう。必要なのはAIの人格を推測することではありません。回答時にどの前提を使ってほしいのか、人が確認できる形に整えることです。
コンテキストウィンドウという「作業机」
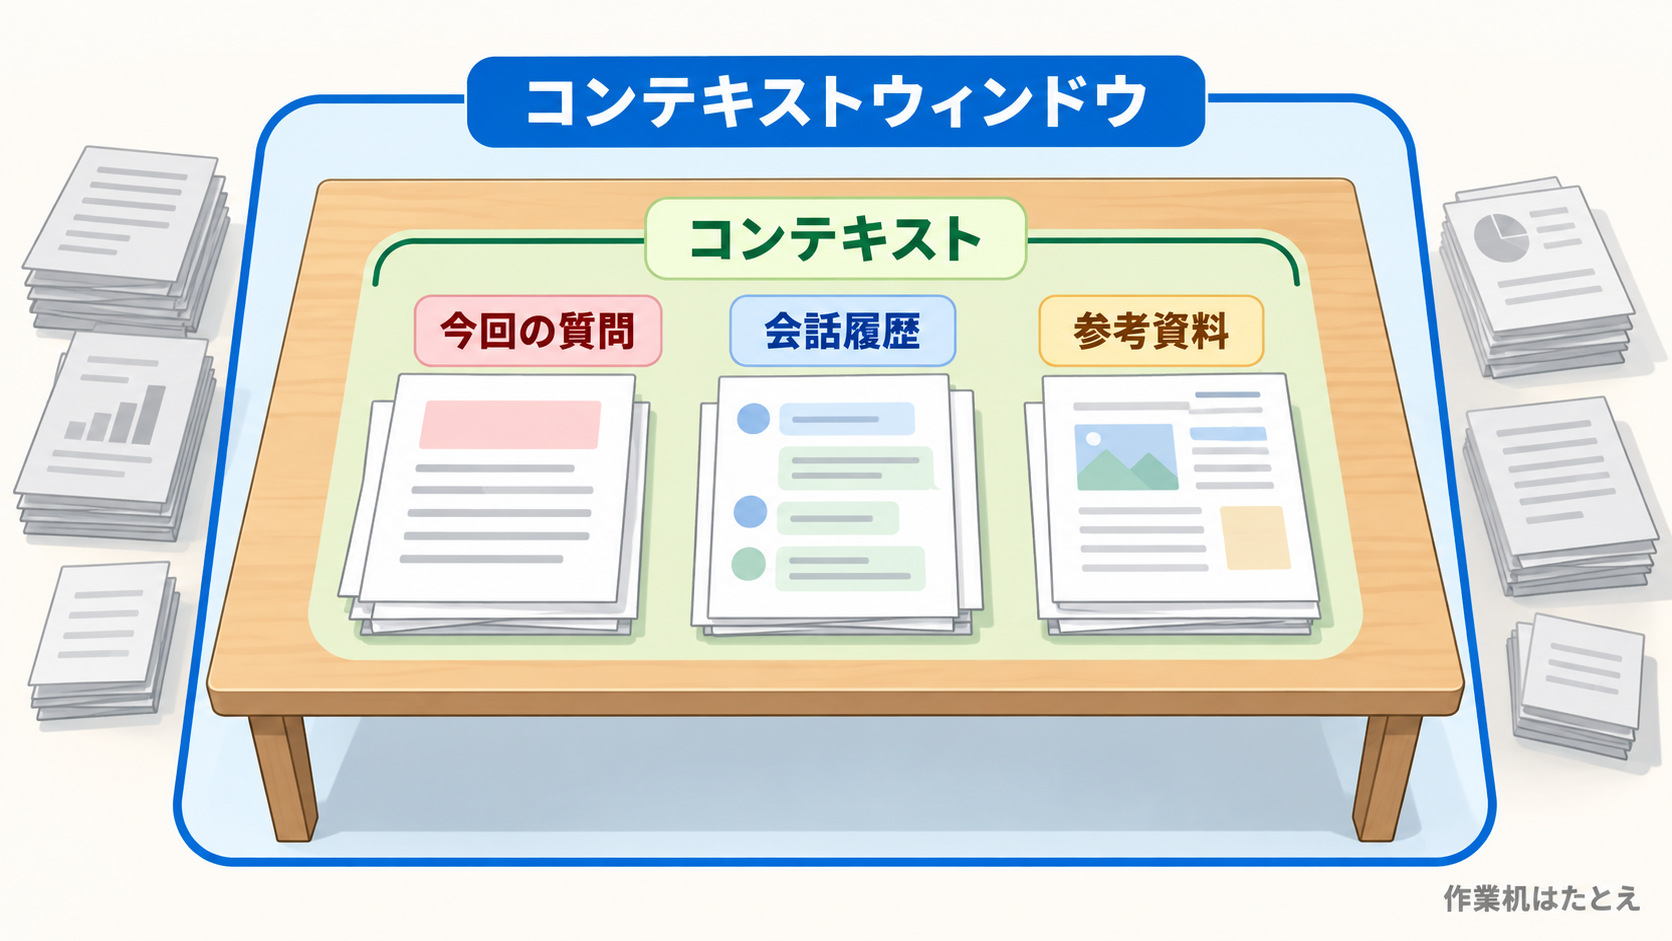
コンテキストは、AIが一つの回答を作るために参照する情報です。利用者が今入力した文章だけでなく、製品から渡された過去のやり取りや追加資料などが含まれる場合もあります。コンテキストウィンドウは、その情報を一度に扱える範囲を指します。大規模言語モデルでは、この範囲がトークンという単位で表されます(出典: IBM、Google for Developers)。
この関係は、机で資料を読みながら原稿を書く場面に置き換えると捉えやすくなります。机の上に広げられている依頼書、前回のメモ、参考資料がコンテキストです。机上に置いて扱える資料の範囲がコンテキストウィンドウに当たります。資料が机に載り切らなければ、古い紙を外したり、内容を短いメモへまとめたりしなければ作業を続けられません。実際に、入力や会話、文書がコンテキストウィンドウを超えた場合、処理を続けるために切り詰めや要約が必要になるとIBMは説明しています(出典: IBM)。
ただし、「作業机」は仕組みを理解するためのたとえにすぎません。モデルに人と同じ作業記憶や意識がある、という意味ではない点に注意が必要です。人なら机から外した資料の存在を思い出し、棚を探しに行けるかもしれません。AIが別の情報を自発的に探せるか、過去の情報を再び取り込めるかは、利用している製品の機能や設計に左右されます。
机が広ければ、より長い入力や多くの情報を一度に考慮できます。しかし、広い机に資料を無造作に積み上げれば、必要な一枚を見つけやすくなるとは限りません。IBMが紹介する研究でも、長い入力の中央にある関連情報をモデルが安定して利用できない場合があると報告されています(出典: IBM)。コンテキストウィンドウの広さは「入る量」の目安であり、「すべてを正確に理解して必ず使う」という保証ではありません。この違いが、長い会話を扱う際の大切な出発点です。
トークンは日本語の文字数と同じではない
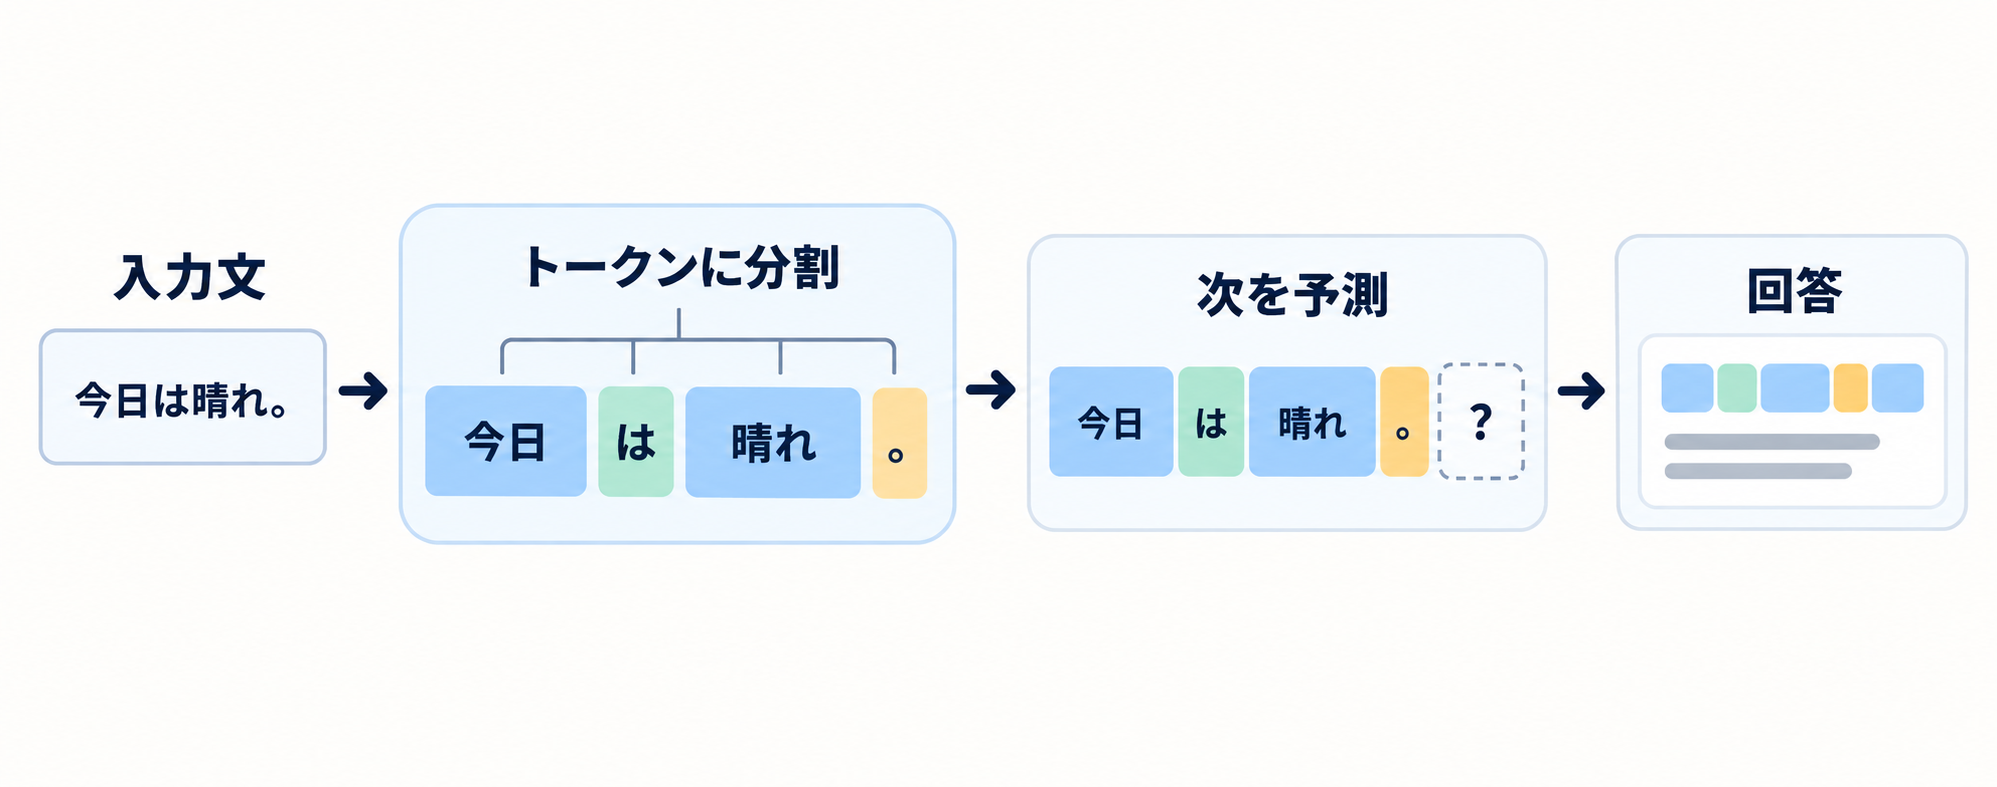
コンテキストウィンドウの説明で登場するトークンとは、モデルが文章を処理する際の文字のまとまりです。一文字だけが一つのトークンになる場合もあれば、単語の一部、単語全体、短い語句が一つとして扱われる場合もあります。同じ文章でも、モデルや文章を分割する仕組みによって区切り方が変わるため、文字数や単語数との固定した換算率はありません(出典: IBM)。日本語100文字なら必ず100トークンになる、とは考えないほうがよいでしょう。
仕事の場面で考えるなら、必要な条件だけを短いメモにまとめる場合と、検討中の案や雑談をすべて残す場合では、AIへ渡す情報の量が変わります。ただし、利用者が日本語の文字数だけを数えて、扱える範囲を正確に見積もることはできません。ここでは「AIは文章を細かい単位で扱うため、見た目の文字数と処理する量は同じではない」と理解できれば十分です。
コンテキストウィンドウを占めるのは、利用者が最後に入力した文章だけではありません。チャットでは会話履歴が含まれることがあり、製品側がモデルの振る舞いを指定するシステムプロンプトや、外部の情報源から取得した補足情報、改行などの書式も範囲の一部を使う場合があります(出典: IBM)。利用者から見える文章の長さだけを数えても、モデルが実際に受け取る情報量を正確には判断できません。
このため、具体的なモデルの上限値を暗記するより、「長いやり取りでは使える範囲を会話履歴と新しい入力が分け合っている」と捉えるほうが日常では役立ちます。製品やモデルが変われば上限や情報の組み立て方も変わり得るからです。長文を送ること自体が悪いわけではありませんが、背景説明、確定条件、未決事項が混ざった文章は、重要な情報を見つけにくくします。文字数を機械的に削るより、情報の役割を分ける工夫が先です。
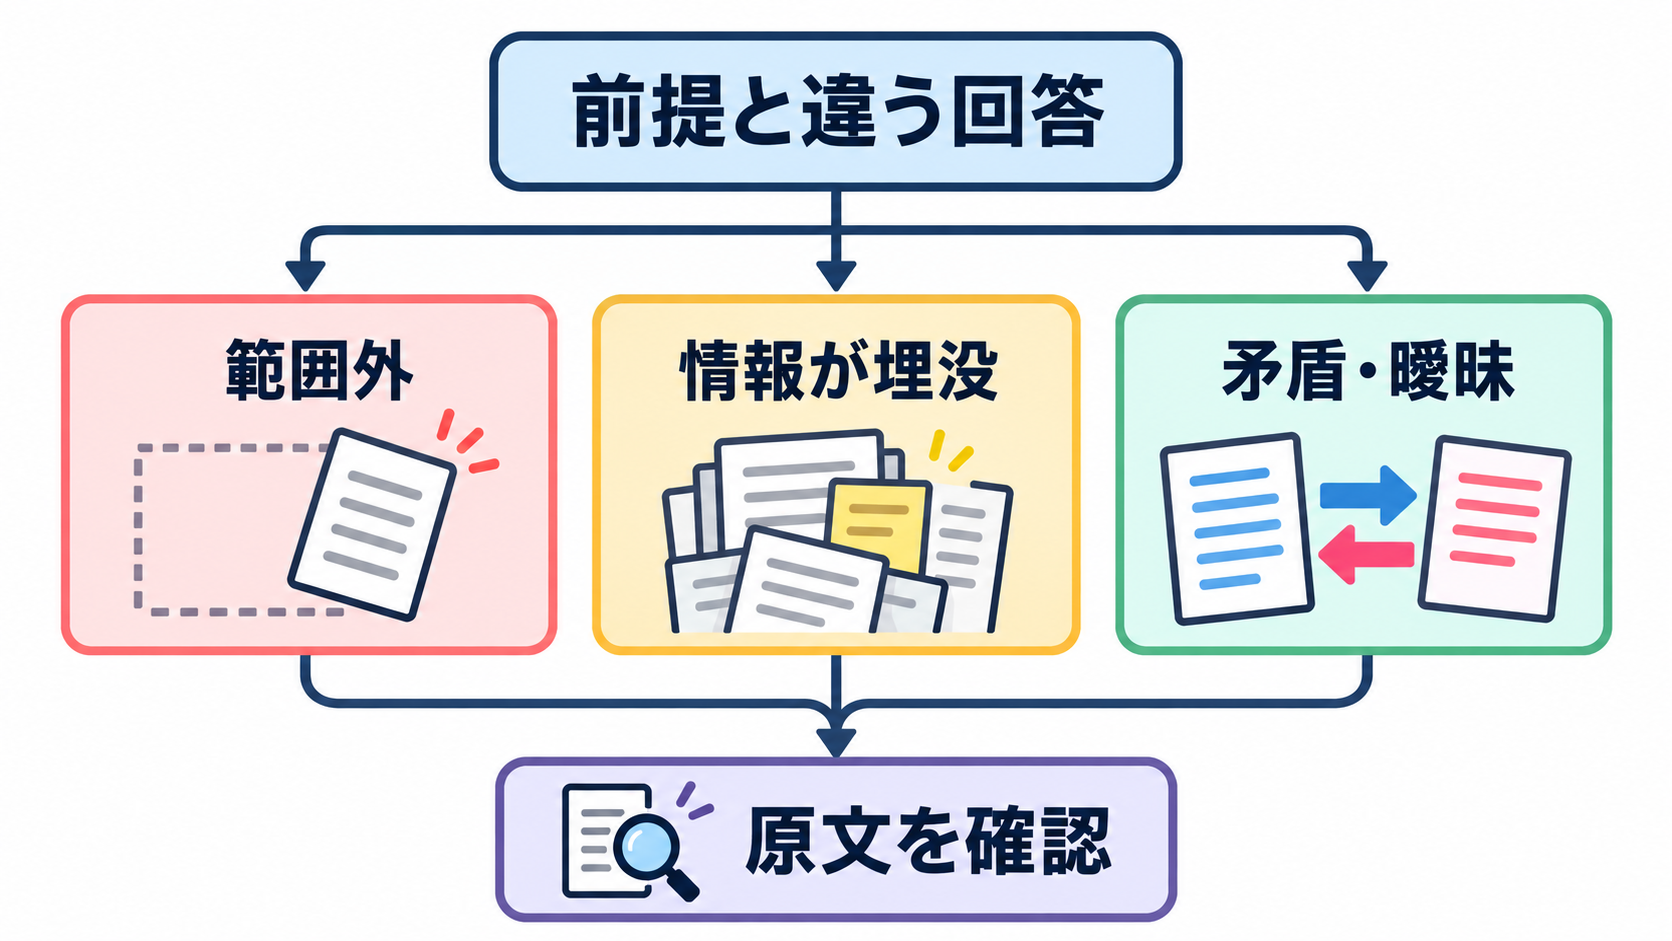
長い会話だけを原因にしない切り分け方
AIが前提と異なる回答をしたときは、少なくとも三つの可能性を分けて考えると状況を整理できます。一つ目は、必要な情報がコンテキストウィンドウの外へ出た可能性です。会話や文書が扱える範囲を超えると、古い部分が切り詰められたり要約されたりすることがあります(出典: IBM)。会話の冒頭に一度だけ書いた条件が後半で反映されない場合は、この可能性を疑えます。
二つ目は、情報が範囲内にあっても十分に使われなかった可能性です。コンテキストへ入っていることと、回答で正しく参照されることは同じではありません。長い入力の中央にある情報をモデルが利用しにくくなる場合があるという研究結果も紹介されています(出典: IBM)。大量の雑談や検討案の間に重要な締切だけを書けば、その一文が回答へ反映されないことも考えられます。
三つ目は、指示そのものの矛盾や曖昧さです。たとえば、会話の前半に「定員は100人」、後半に「80人案で見積もる」とあり、変更が確定したとは明記されていなければ、どちらを優先するか判然としません。「家族向けにする」と「内容は専門家向けにする」が並んでいる場合も、両立方法の確認が必要でしょう。これは単純な容量不足ではなく、判断に必要な優先順位や状態が示されていない問題です。
情報が見当たらない状態で、AIがもっともらしい会場名や締切を補ってしまうこともあり得ます。現実について述べているように見えながら実際には誤っている出力は、ハルシネーションと呼ばれます(出典: Google for Developers)。ただし、前提の不一致をすべてハルシネーションと呼ぶ必要はありません。古い条件を採用したのか、曖昧な指示を別の意味に解釈したのか、存在しない事実を作ったのかで対処が変わるためです。「どの条件を根拠にしましたか」「未確定の項目を推測せず示してください」と確認すれば、問題を見分けやすくなります。
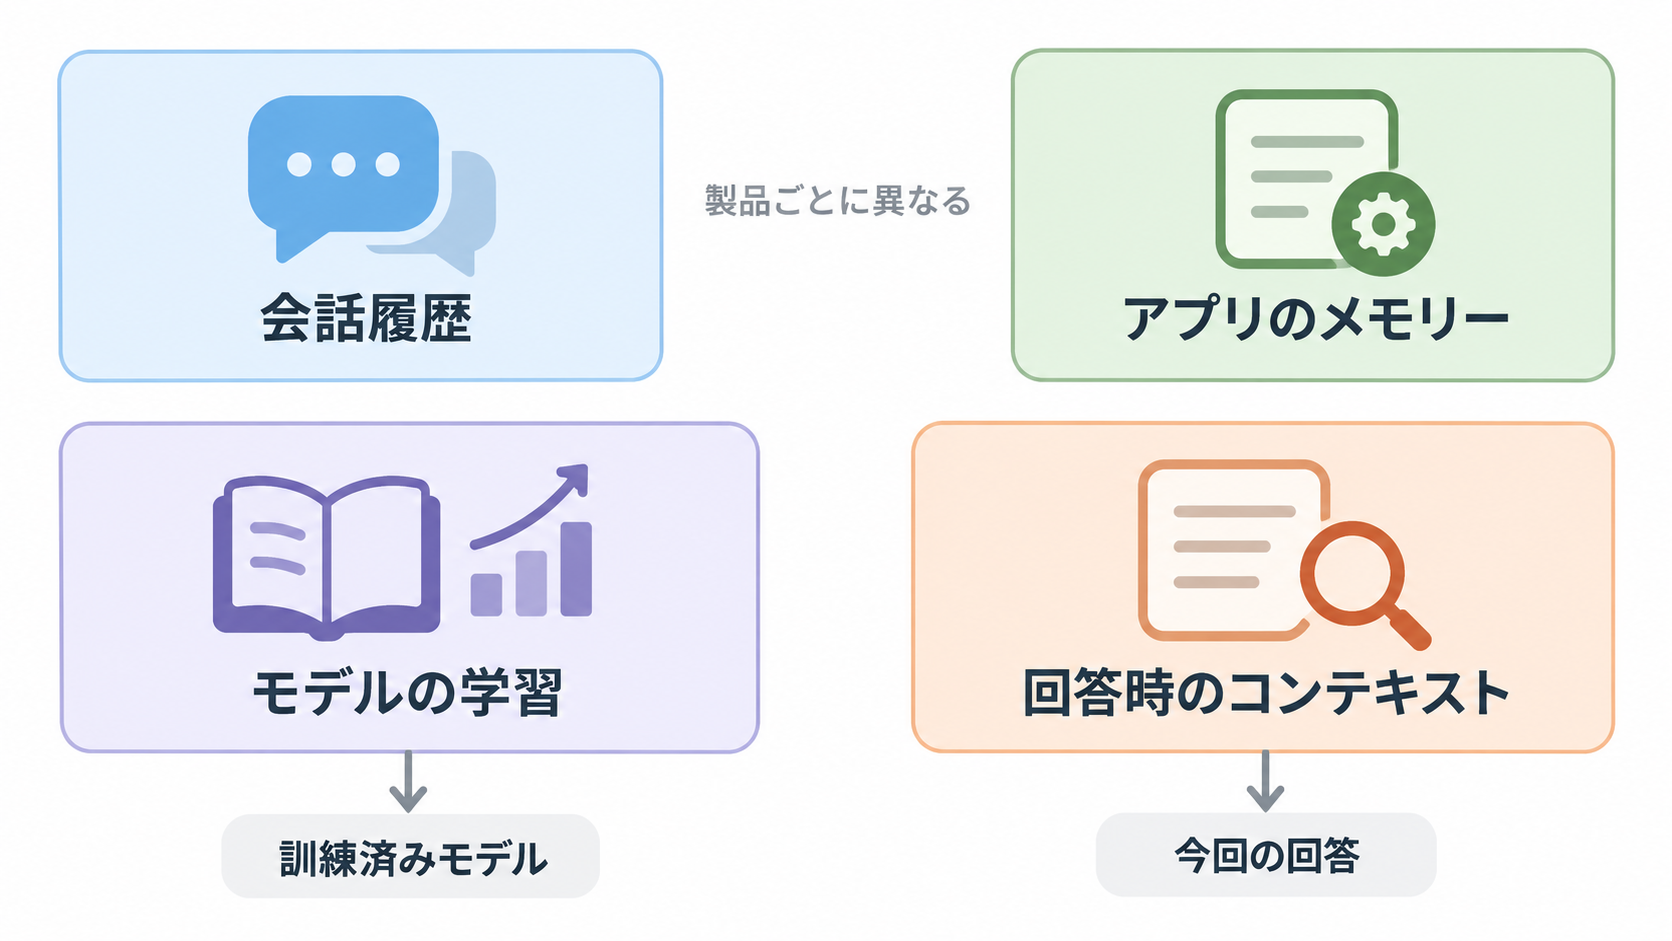
履歴・メモリー・学習・回答時の情報は別物
チャット画面に残る会話、アプリが備えるメモリー機能、モデルの学習、回答時のコンテキストは混同されがちです。しかし、これらは同じ仕組みではありません。Googleの用語集では、チャットの前回までのやり取りが後続部分のコンテキストになると説明されています(出典: Google for Developers)。その一方で、画面上の履歴をどこまでモデルへ渡すか、別のメモリー機能をどのように利用するかは、製品ごとの実装によって異なります。
| 区分 | 役割の捉え方 | 注意点 |
| --- | --- | --- |
| 会話履歴 | 画面や会話単位で過去のやり取りを扱うもの | 表示される全文が毎回答で同じように参照されるとは限りません |
| アプリのメモリー | 製品が利用者に関する情報を再利用するための機能 | 有無や保存方法、反映範囲は製品によって異なります |
| モデルの学習 | 大量のデータから言語のパターンなどをモデルへ反映する工程 | 一回の会話でモデル本体が自動的に再学習することと同義ではありません |
| 回答時のコンテキスト | その回答を生成するためにモデルへ渡される情報 | 扱える範囲があり、情報が含まれても正確な利用は保証されません |
モデルの学習と回答生成も区別が必要です。事前学習は大きなデータセットを使ってモデルを訓練する工程であり、推論は訓練済みのモデルを入力へ適用して回答を生成する工程です(出典: Google for Developers)。会話中に条件を伝える行為は、通常、その場の回答に使う情報を渡すこととして捉えるべきでしょう。「一度教えたからモデルが永久に学習した」とは判断できません。
新しい会話を開くことについても、二つの話を分けなければなりません。新しい会話では、前の会話の文章がそのまま前提として渡されない可能性があります。そのため、必要な条件を引き継ぎ直すことには意味があります。しかし、新しい会話へ移っただけで、過去の履歴や入力した秘密情報がサービスから削除されたとは限りません。保存、削除、メモリー、データ利用の扱いを知りたい場合は、利用中の製品が示す設定や規約を個別に確認する必要があります。機密情報は、消えることを期待して入力するのではなく、初めから必要最小限にとどめる姿勢が安全です。
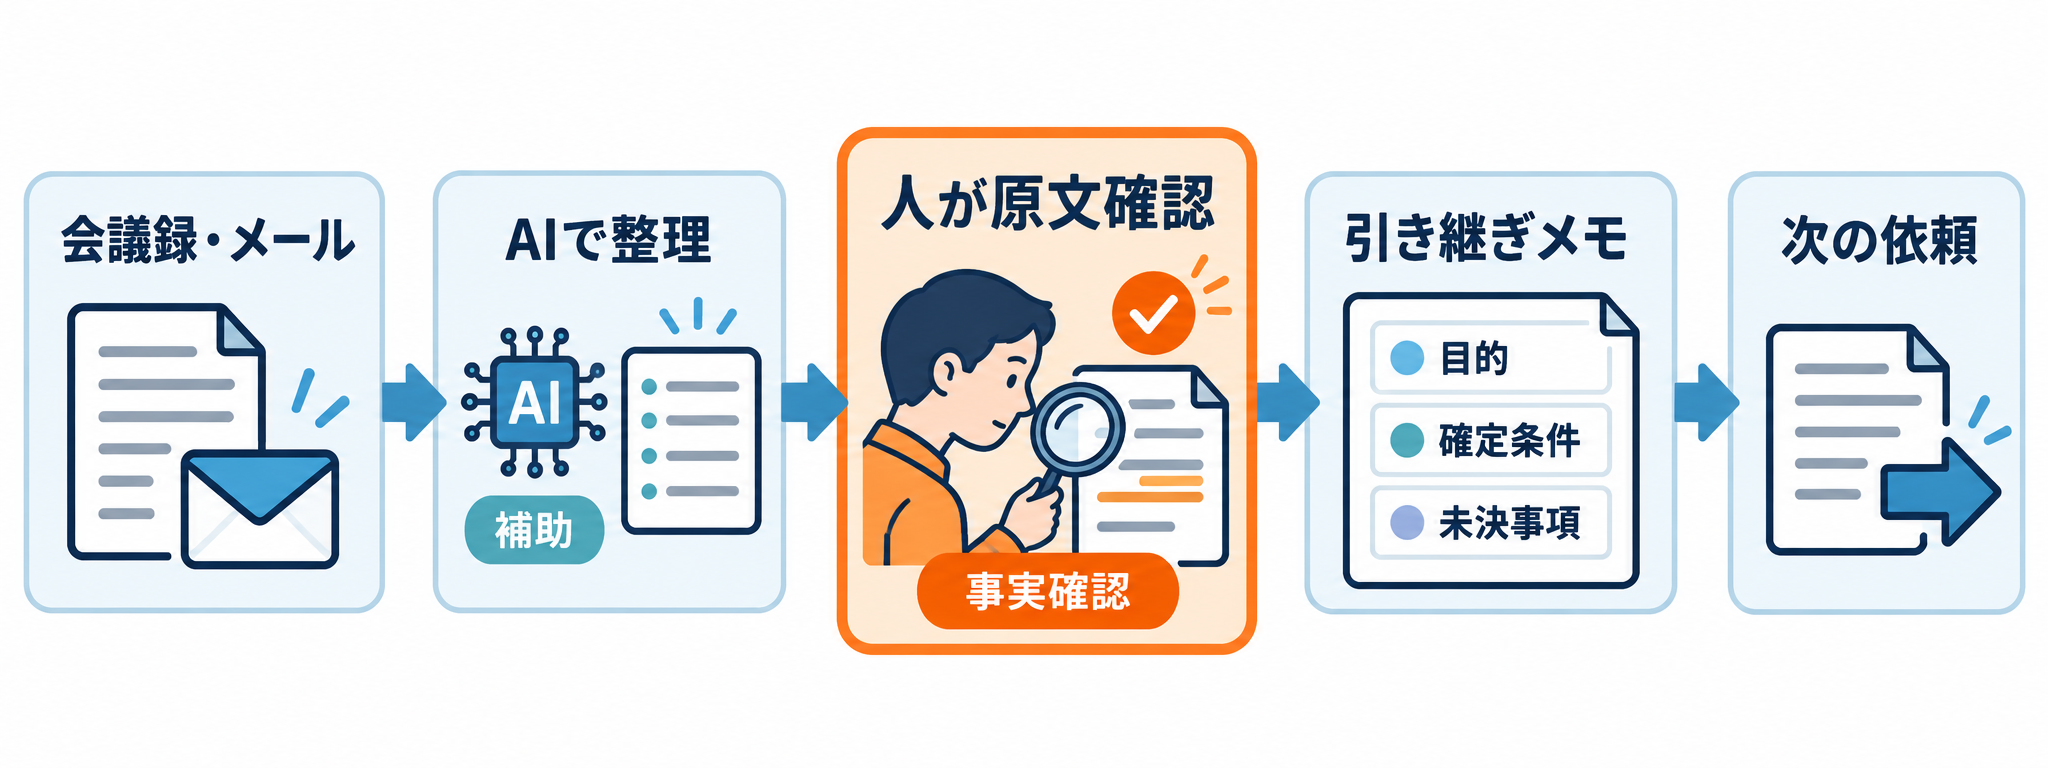
引き継ぎメモで「次の作業机」を整える
ここからは架空の例です。地域交流イベントを企画する担当者が、AIとの会話を使って案内文を検討しているとします。最初は参加者100人、駅前ホール、土曜日開催という案でした。その後の打ち合わせで、定員は80人へ変更され、会場は市民会館が有力になりました。ただし、開催日は土曜日と日曜日のどちらにするか未決定です。長い会話には、没になった企画、関係者の感想、複数の文章案も混ざっています。
AIを使わない場合、担当者は会議録やメールを読み返し、変更された条件を拾って新しい案内文へ反映します。AIには、散らばった記述から「目的」「確定条件」「未決事項」「使わない旧情報」を整理する補助を頼めるでしょう。ただし、AIが作った整理結果をそのまま確定情報として扱うのではなく、担当者が会議録や決定メールと照合します。人が担うのは、最終的な事実確認と判断です。
たとえば、現在の会話で次のように依頼する方法が考えられます。
この会話に出てきたイベント企画を、次の4項目で短い引き継ぎメモに整理してください。
・目的
・確定条件
・未決事項
・使わない旧情報
推測で内容を補わず、矛盾する記述があれば両方を示してください。
返ってきたメモに「定員80人」「市民会館が有力」「開催日は未決定」と書かれていても、そこで確認を終えてはいけません。担当者が原文を見て、80人への変更が正式決定なのか、市民会館は予約済みなのか、候補にすぎないのかを確かめます。確認後のメモでは、「確定」と「有力候補」を明確に分けるべきです。AIに読みやすく整理させることと、事実を承認することは別の作業になります。
確認済みの引き継ぎメモは、次の会話の冒頭で必要な作業と一緒に渡せます。新しい作業机へ、使う資料だけを載せ直すイメージです。ただし、会話を移す目的は秘密の削除ではなく、回答に必要な前提を明示することにあります。明日から試すなら、長い相談を続ける途中で一度だけ立ち止まり、「目的・確定条件・未決事項」の三つを書き出してください。それを原文と照合してから次の依頼へ添えるだけでも、前提がどこで変わったのかを人自身が判断しやすくなるでしょう。
参考情報
- What is a context window? — IBM、取得日:2026年10月30日
- Machine Learning Glossary: Generative AI — Google for Developers、取得日:2026年10月30日