
2026/10/30
AIニュース
AIエージェントの本番導入を左右するRBAC――モデル性能より先に整えるべきデータ権限
AIエージェント競争で浮かび上がった本当のボトルネック
高性能な生成AIモデルを選べば、AIエージェントをすぐ業務に投入できるのでしょうか。Clouderaの最高製品責任者であるレオ・ブルニック氏は、企業間の差を決めるのはモデルそのものではなく、各社が保有する独自データと業務プロセスだと指摘しています。ここでいう独自性には、顧客との関係、蓄積された取引情報、社内固有の判断基準といった、外部のモデルだけでは再現できない要素が含まれます。
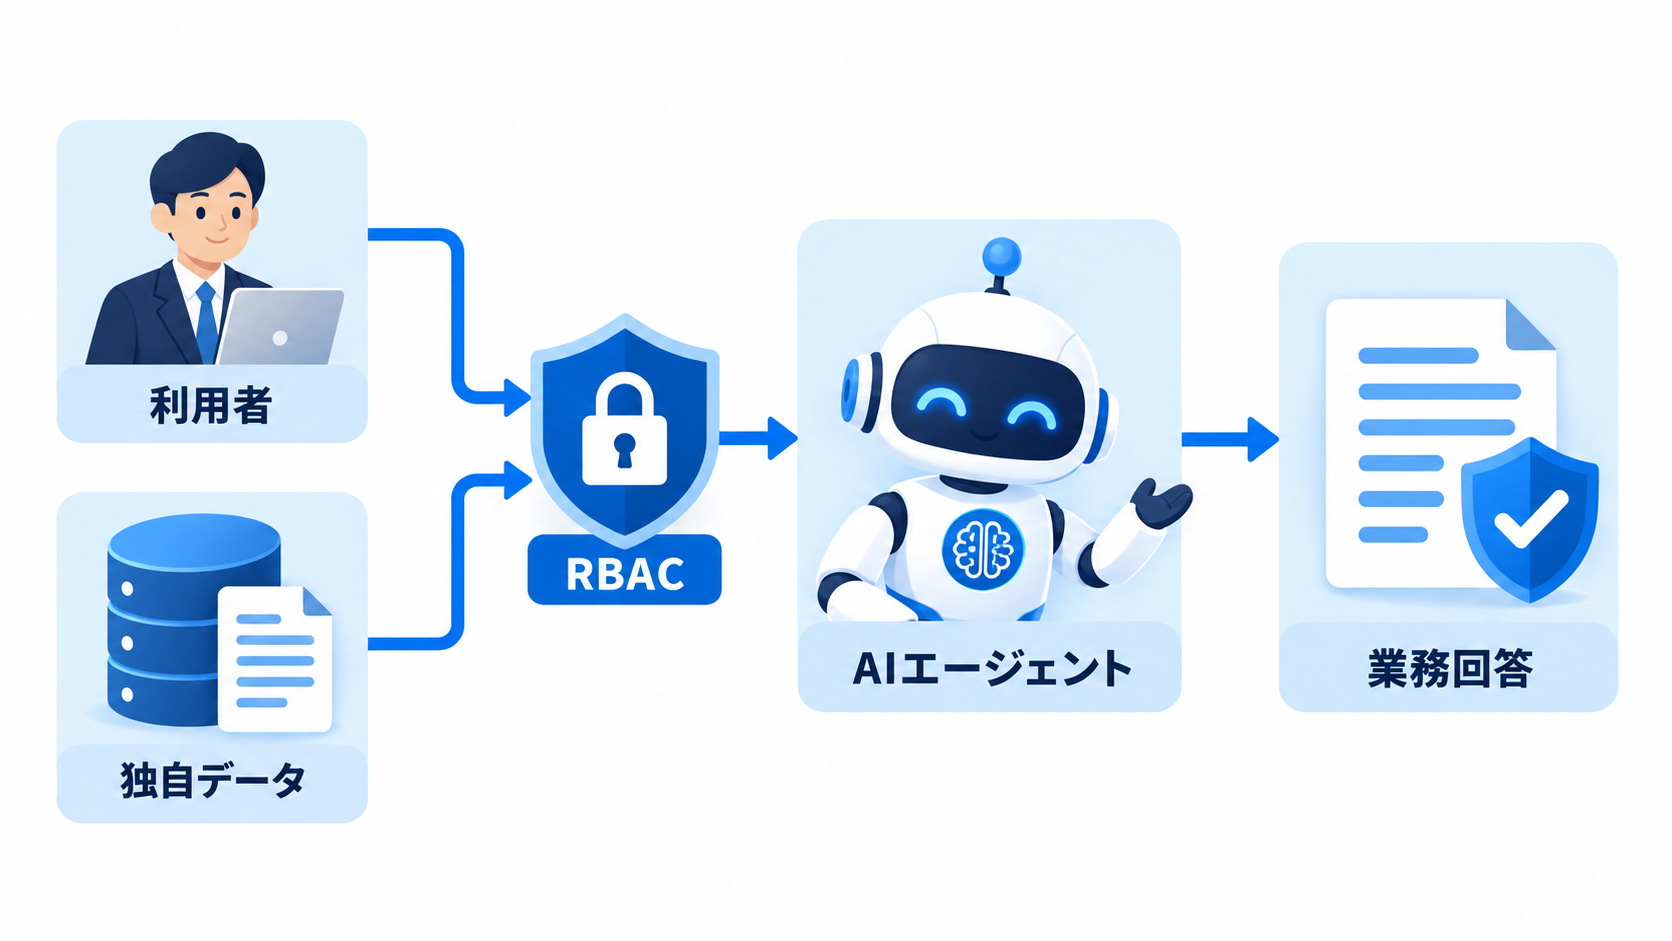
ただし、社内データをエージェントから広く参照できるようにすると、別の問題が生じます。利用者が本来閲覧できない情報まで、エージェントが回答に混ぜてしまうおそれがあるためです。営業担当者の質問に人事情報が表示されたり、特定部門だけに開示された計画が別部門へ伝わったりすれば、便利さよりも情報漏えいの危険が上回ります。
そこで本番導入の成否を握るのが、役割に基づいて閲覧範囲を制御するRBACです。エージェントが企業全体の情報に接続できるとしても、回答時には質問者の身元と権限を認識し、その人に許された範囲だけを扱わなければなりません。モデルの回答精度を競う段階から、誰の代理として何を見せるのかを制御する段階へ移ったことが、今回の論点の中心です。
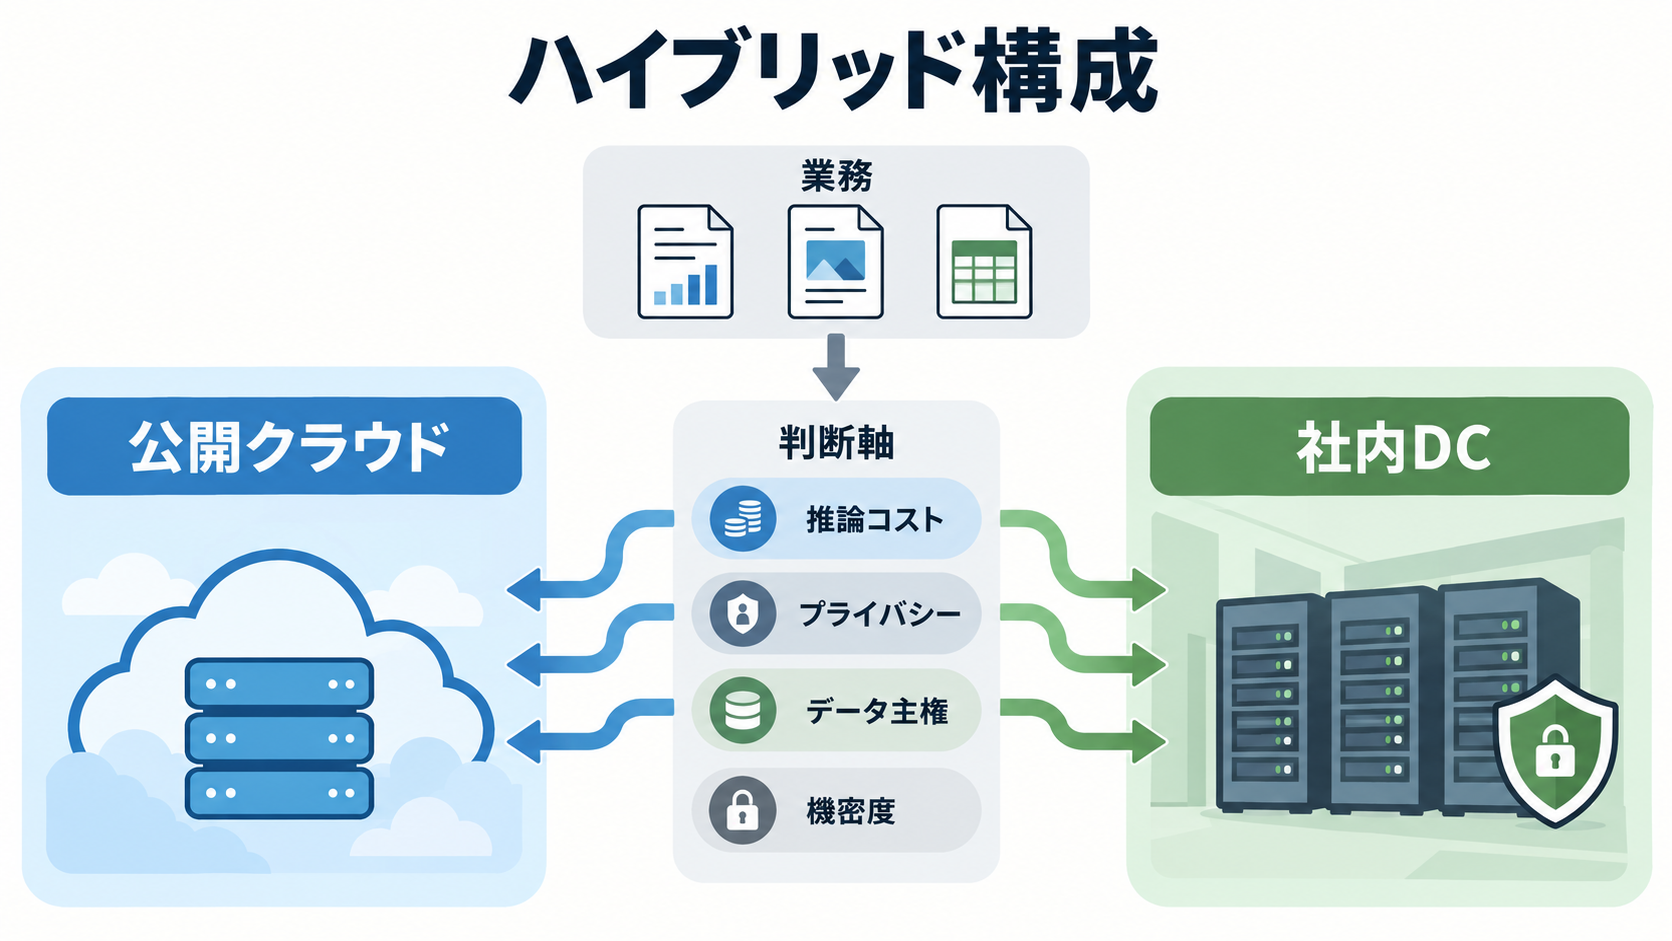
推論コストの上昇、プライバシーへの懸念、データ主権に関する要請も、この問題を複雑にしています。AI処理をすべて外部クラウドへ移すのではなく、社内データセンターを含む環境で運用したい企業が増えれば、モデル選定と同時にデータ配置や権限管理を設計する必要があるでしょう。AIエージェントは単体のソフトウェアではなく、企業のデータ統制を映す存在になりつつあります。
Cloudera Anywhere Cloudが狙うハイブリッド運用
Clouderaは、公開クラウドとオンプレミス環境をまたいでデータとAIを扱う基盤として、Cloudera Anywhere Cloudを打ち出しています。オンプレミスとは、企業が自社施設や管理下のデータセンターでシステムを運用する形態です。すべてをクラウドへ移せない企業でも、配置場所の異なるデータを統制しながらAIへ利用できる構成を目指しています。
Clouderaは、大規模な機密データを対象としたガバナンス、セキュリティ、拡張性を長年の強みとしてきました。ブルニック氏は、その反面として使いやすさに課題があったと認めており、新しい基盤ではこの隔たりを埋めようとしています。企業が求めているのは新しいプラットフォームを導入すること自体ではなく、不正検知などの具体的な課題を安全に解決することだからです。
同氏が独自データと独自プロセスを企業の「アルファ」と表現した点も、法人向けAIを考えるうえで示唆的です。金融分野などで使われるアルファは、市場平均を上回る付加価値を意味します。ここでは、競合他社が同じモデルを利用しても簡単には複製できない、企業固有の優位性を指しています。
この見方に立つと、ハイブリッド基盤の価値は、複数の場所でモデルを動かせることだけではありません。企業固有のデータを既存の管理方針から切り離さず、AIエージェントへ接続できるかどうかが問われます。操作性を高めても統制が弱まれば本番利用には進めず、統制を厳しくしすぎて利用者が扱えなければ導入効果は限定されます。Clouderaが埋めようとしているのは、技術基盤と業務利用の間に残るこの距離です。
RBACをAIエージェントへ引き継ぐ仕組み
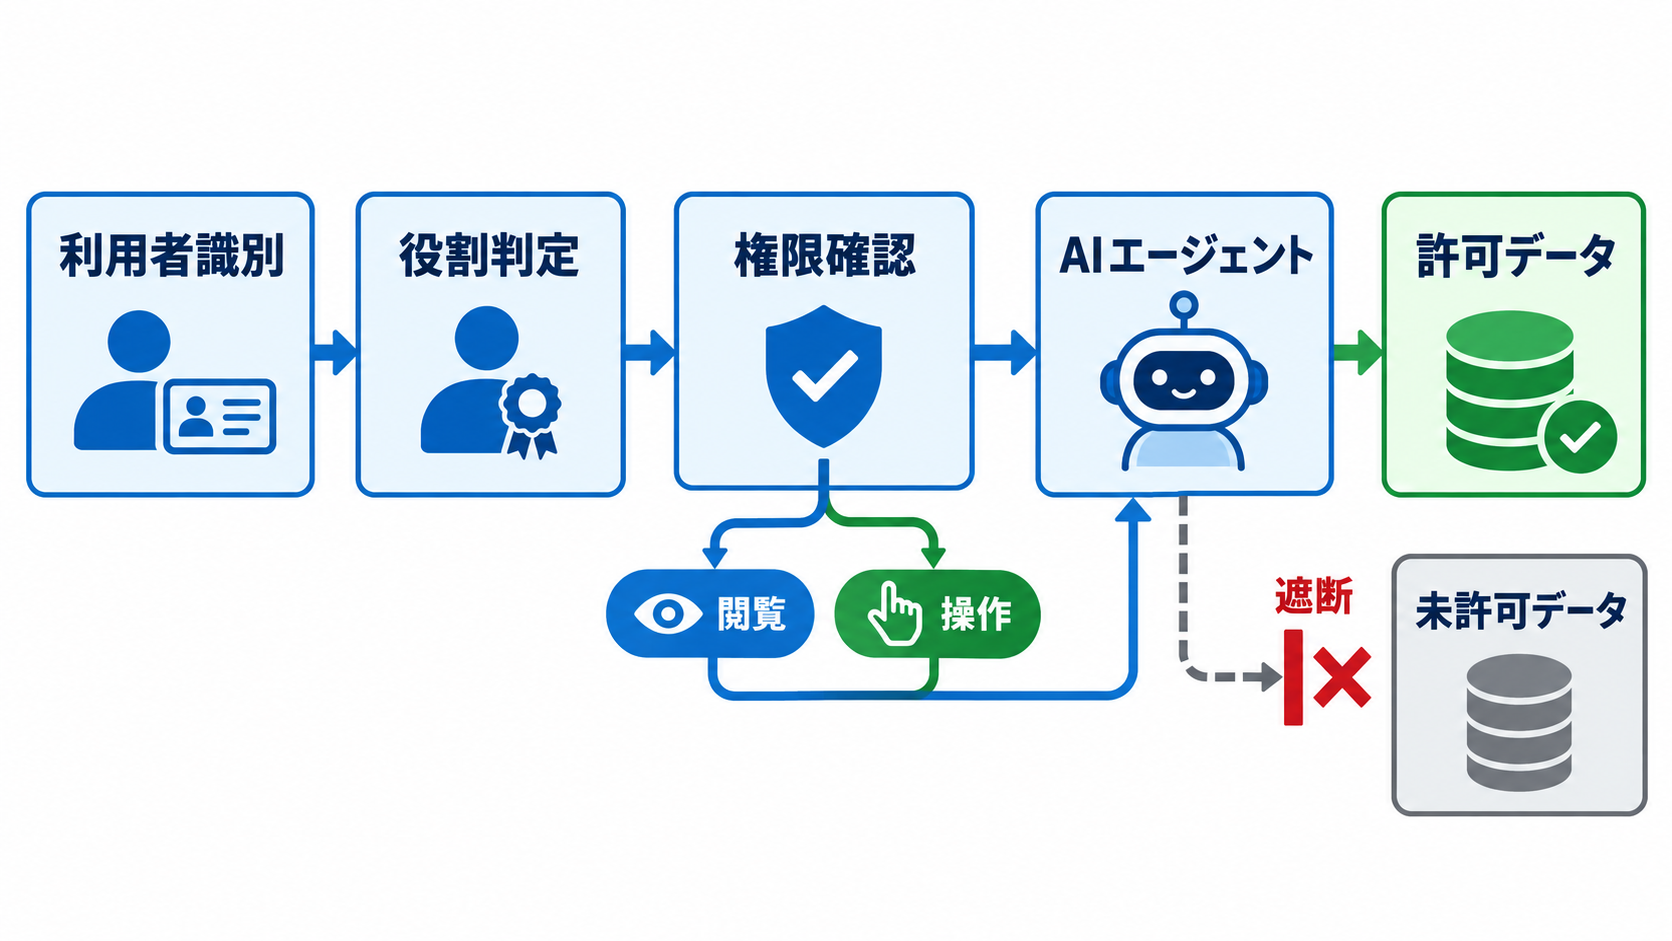
RBACはRole-Based Access Controlの略で、日本語では役割ベースのアクセス制御と呼ばれます。個人ごとに一件ずつ権限を設定するのではなく、営業、経理、管理者といった役割に閲覧・操作権限を割り当て、その役割を利用者へ適用する考え方です。多数の従業員とデータを管理する企業では、異動や退職に伴う権限変更を整理しやすくなります。
AIエージェントでは、利用者とデータの間にモデルや検索機能、外部ツールが加わります。エージェント自身が強力な共通権限で情報を取得し、最後に文章だけを調整する構成では不十分です。取得の時点から質問者の権限を反映し、許可されていないデータを処理対象へ含めない設計が求められます。ブルニック氏が、エージェントは利用者が誰で何を閲覧できるのかを知る必要があると強調したのは、このためです。
企業が確認すべき制御点は、次のように整理できます。
| 制御点 | 確認する内容 | 不備がある場合の懸念 |
| --- | --- | --- |
| 利用者識別 | 誰がエージェントを利用しているか | 他人の権限による情報取得 |
| 役割判定 | 利用者にどの役割が割り当てられているか | 異動前の権限が残る状態 |
| データ認可 | 対象データを閲覧できるか | 機密情報の回答への混入 |
| 操作認可 | 閲覧以外の処理を実行できるか | 未承認の更新や外部送信 |
| 利用記録 | 誰が何へアクセスしたか | 問題発生時の確認困難 |
エージェントが回答を生成するだけなら、閲覧権限が中心になります。しかし、取引の登録、ファイルの更新、メール送信などを代行する場合は、操作権限も利用者から適切に引き継がなければなりません。閲覧は許可されていても変更は認められていない、といった区別が必要です。RBACは既存の認証機能を追加するだけの話ではなく、エージェントが代理で行う一連の処理に権限を通す設計だと捉えるべきでしょう。
推論コスト、プライバシー、データ主権が促す社内回帰
AI処理を社内データセンターへ戻す動きには、複数の理由が重なっています。報告された要因は、推論コスト、プライバシーへの懸念、データ主権に関する要求です。推論とは、学習済みモデルへ入力を与えて回答を生成させる処理を指します。エージェントが継続的に動き、大量の検索や生成を繰り返せば、試験利用では目立たなかった実行費用が運用上の論点になります。
プライバシーの観点では、モデルへ送信する情報だけでなく、検索途中で読み込む文書や処理履歴も検討対象です。個人情報や取引情報を含む業務では、データがどの環境を通り、誰が管理できるのかを明確にする必要があります。データ主権は、情報の保管場所や適用される法域を管理したいという要求に関係します。国や地域、業界、契約によって条件が異なるため、単一の配置方法ですべてを満たせるとは限りません。
ただし、社内運用へ切り替えれば自動的に安全になるわけではありません。ハードウェア、モデル、データ、アクセス権限を自社側で管理する範囲が広がるほど、運用設計や監視の責任も増えます。公開クラウドには迅速に計算資源を確保しやすい利点があり、オンプレミスには配置場所や運用条件を管理しやすい場面があります。両者のどちらか一方へ統一するよりも、データの機密度や処理内容に応じて使い分ける考え方が現実的でしょう。
Cloudera Anywhere Cloudが想定するハイブリッド構成は、こうした選択を前提にしています。機密性の高いデータを管理下の環境に置きながら、必要に応じて公開クラウドも利用する形です。重要なのは、配置先が変わっても権限とガバナンスを分断しないことです。エージェントが複数環境のデータを横断する場合、最も統制の弱い接続部分が全体のリスクになり得るため、データの場所とアクセス方針を一体で設計する必要があります。
Mistral AI、Nvidia、Vast Dataとの協業が補うもの
ClouderaはMistral AI、Nvidia、Vast Dataとのパートナーシップを拡大し、不正検知などのプライベートAI用途へ向けた構成を提示しています。Mistral AIは、自社環境でも推論に利用しやすいオープンウェイトモデルを手がける企業です。オープンウェイトとは、学習済みモデルの重みを入手して所定の条件下で運用できる形態を指し、すべての構成要素が無条件に公開されるという意味ではありません。
NvidiaはAI計算基盤を広く提供し、Vast Dataは大規模データを扱う基盤を展開しています。今回示された協業は、それぞれの技術を個別に販売するだけでなく、企業が特定の課題へ取り組みやすい形にまとめる狙いがあります。ただし、各社の具体的な役割分担や提供条件のすべてが明らかにされているわけではないため、実際の採用時には構成と責任範囲を確認する必要があるでしょう。
ブルニック氏は、Clouderaには以前から必要な能力があったものの、AI企業としての認知や信頼が十分ではなかったと説明しています。Mistral AIとの連携は技術能力を補うだけでなく、市場からの見られ方を大きく変える効果があるという認識です。長年データ管理を担ってきた企業が、AIモデルを専門とする企業と組むことで、既存のガバナンス基盤と新しい推論技術を結び付けようとしています。
あらかじめ構成されたブループリントは、モデル、データ基盤、計算資源を一から組み合わせる負担を抑える手段になります。それでも、導入先企業の権限体系まで自動的に完成するわけではありません。不正検知を例に取れば、担当者、調査責任者、システム管理者では閲覧できる情報や実行できる操作が異なります。パッケージ化された構成を出発点にしつつ、自社の職務分掌とデータ分類を反映させる作業が、本番導入には欠かせません。
本番導入前に企業が確認すべき設計順序
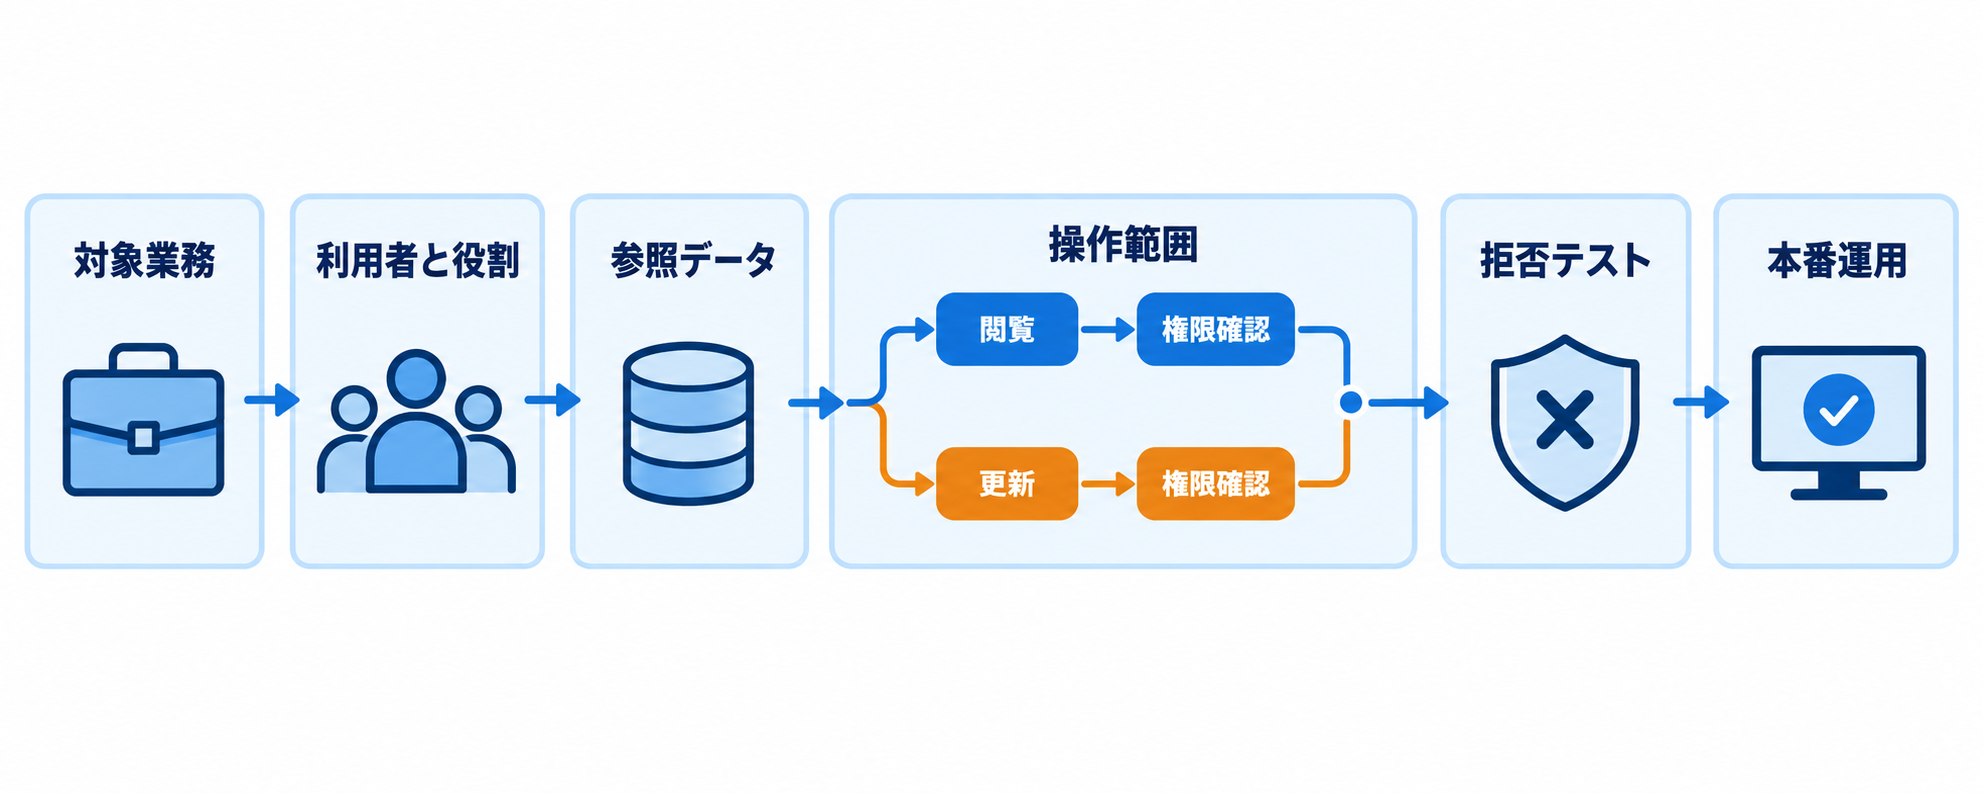
AIエージェントの検証では、回答の自然さや処理速度に目が向きがちです。しかし、業務利用を前提にするなら、モデル比較より先にエージェントが代理する利用者と参照対象を定義したほうがよいでしょう。誰が、どの業務で、どのデータを使い、どの操作まで任せるのかが曖昧なままでは、安全性を評価するための基準も定まりません。
着手時には、対象業務を一つに絞り、利用者の役割と必要なデータを対応付けます。続いて、エージェントが検索、要約、生成、更新のどこまで行うのかを分けて考えます。情報を読む権限と、業務システムへ変更を加える権限は同じではありません。最初の検証を閲覧中心に限定すれば、権限設計や回答内容を確認したうえで操作範囲を段階的に広げられます。
テストでは、正しい回答が得られるかだけでなく、権限のない質問へ適切に回答を拒否できるかも確認する必要があります。一般社員、管理職、管理者など複数の役割を用意し、同じ質問に対して参照範囲が変わるかを検証すると、権限継承の不備を見つけやすくなります。異動や退職、兼務、期間限定のプロジェクト参加といった権限変更も想定しなければなりません。
運用開始後には、モデルやデータ接続先の変更が権限へ及ぼす影響を継続的に点検します。新しいデータソースを追加すると、エージェントが扱える情報の範囲も変わります。モデルを更新した場合には、拒否すべき質問への反応が変化する可能性も検証対象になるでしょう。技術部門だけで完結させず、情報セキュリティ、データ管理者、対象業務の責任者が判断に参加できる体制を整えることが、実運用に沿った統制につながります。
日本企業がモデル選定より先に着手できること
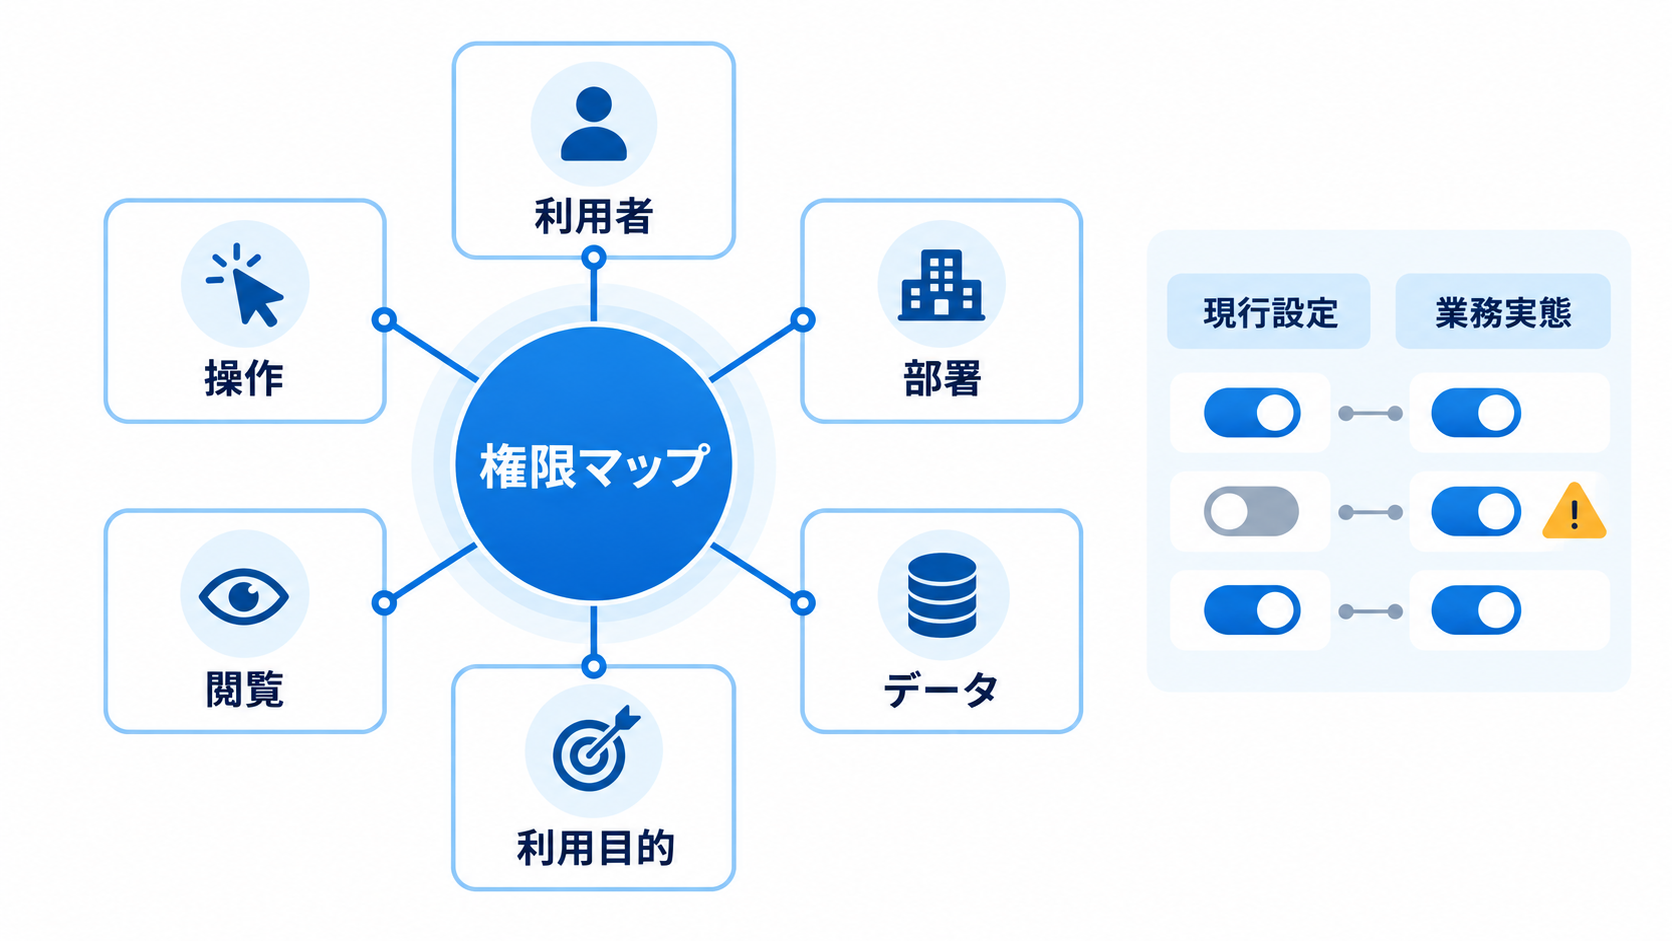
日本企業にとって最初の一歩は、新しいモデルの導入計画ではなく、既存のアクセス権限が業務実態と一致しているかを確認することです。部署異動や兼務が多い組織では、過去の権限が残っていたり、共有フォルダーが広い範囲へ公開されていたりする場合があります。人が検索する範囲では見過ごされていた問題でも、エージェントが複数の情報源を横断すれば、回答として表面化する可能性があります。
投資判断でも、モデルのベンチマークだけを比較するのは十分ではありません。自社のデータへ安全に接続できるか、既存の認証や役割を引き継げるか、公開クラウドと社内環境で一貫した管理ができるかを確認する必要があります。プライベートAIという名称だけで判断せず、どのデータがどこで処理され、誰の権限で取得されるのかを構成単位で把握することが求められます。
今回の発言は、モデルの性能が不要だという意味ではありません。同程度のモデルを複数社が利用できる状況では、企業固有のデータと業務プロセスを安全に活用できる能力が差になりやすい、という見方です。モデル選定を競争力の中心に置くのではなく、データ品質、権限管理、業務への組み込み方を含む運用全体で評価する必要があるでしょう。
導入を検討する企業は、候補となる業務を一つ選び、「誰が」「どの情報を」「何のために」参照できるのかを一枚の権限マップへ整理するところから始められます。その内容を現行システムの設定と照合すれば、AI導入以前から存在する権限のずれも確認できます。エージェントの試験環境を作る前にこの作業を済ませることが、本番移行時の手戻りと情報漏えいの危険を抑える具体的な準備になります。
参考情報
The race to deploy AI agents finds a familiar hurdle in data access
掲載媒体は、theCUBEがEVOLVE26の有償メディアパートナーであり、Clouderaがイベント取材のスポンサーであることを開示しています。また、スポンサーはtheCUBEおよびSiliconANGLEの掲載内容を編集できないと説明しています。