

2026/11/11
AIニュース
8億パラメータのBotPsy、端末内AIエージェントはどこまで業務を担えるか
この記事の要点
Tether AI Researchが、端末内でのツール利用を想定した8億パラメータのBotPsyを発表しました。開発チームの評価では、複数の操作指標で規模が2.5倍のモデルを上回っています。ただし、複雑な調査や安全性には課題が残り、日本語業務での品質も個別検証が必要です。企業導入では、範囲を絞った業務で操作精度と実行コストを確認することが出発点になります。
目次
大型AIへの依存を減らす、実行役としての小型モデル
予定を確認し、必要な情報を検索し、その結果を使って次の操作へ進む。こうした定型業務をAIに任せる際、毎回、大規模なクラウドモデルが必要なのでしょうか。Tether AI Researchが発表したBotPsyは、この問いに対して、外部ツールの操作に特化した小型モデルという選択肢を示しています。中心にあるのは、あらゆる質問に答える知識量ではなく、限られた仕事を適切な手順で進める能力です。
BotPsyは、Qwen3.5-0.8Bを基盤に追加学習した、8億パラメータの言語モデルです。パラメータはモデルが学習によって調整する内部の値で、規模を表す目安になります。開発チームは端末上での動作を想定し、検索、ファイル、カレンダー、メール、機器操作などにつながる、低難度から中難度のタスクを対象にしています。
ここでいうファンクションコーリングは、利用者の依頼を、ソフトウェアが扱える関数名や引数へ変換する仕組みです。例えば予定の確認なら、文章で返答するだけでなく、カレンダーを検索する処理に必要な情報を組み立てます。実際の操作には、その出力を受け取って実行するアプリケーション側の仕組みも必要です。モデルを置くだけで、社内システムを自動操作できるわけではありません。
開発チームは、クラウドモデルの運用費用や提供条件の変更、データ管理、用途に合わせた調整の難しさを開発の背景に挙げています。企業にとっての検討点は、最も高性能なモデルを選ぶことに加え、どの仕事なら小型モデルへ切り分けられるかを見極めることでしょう。ただし、BotPsyは誤りを起こすため、開発チーム自身も重大な結果を伴う用途を想定していません。
ベンチマークが示す強みは、知識量よりツール操作
Tether AI Researchの評価では、BotPsyはツール利用とエージェント能力を測る6つのベンチマークすべてで、比較対象の12億パラメータ以下のモデルを上回りました。対象には基盤モデルのQwen3.5-0.8B-Thinkに加え、LFM2.5-1.2B-ThinkとMiniCPM5-1B-Thinkが含まれます。「同規模で最高」という評価は、この比較対象と評価条件の範囲で受け止める必要があります。
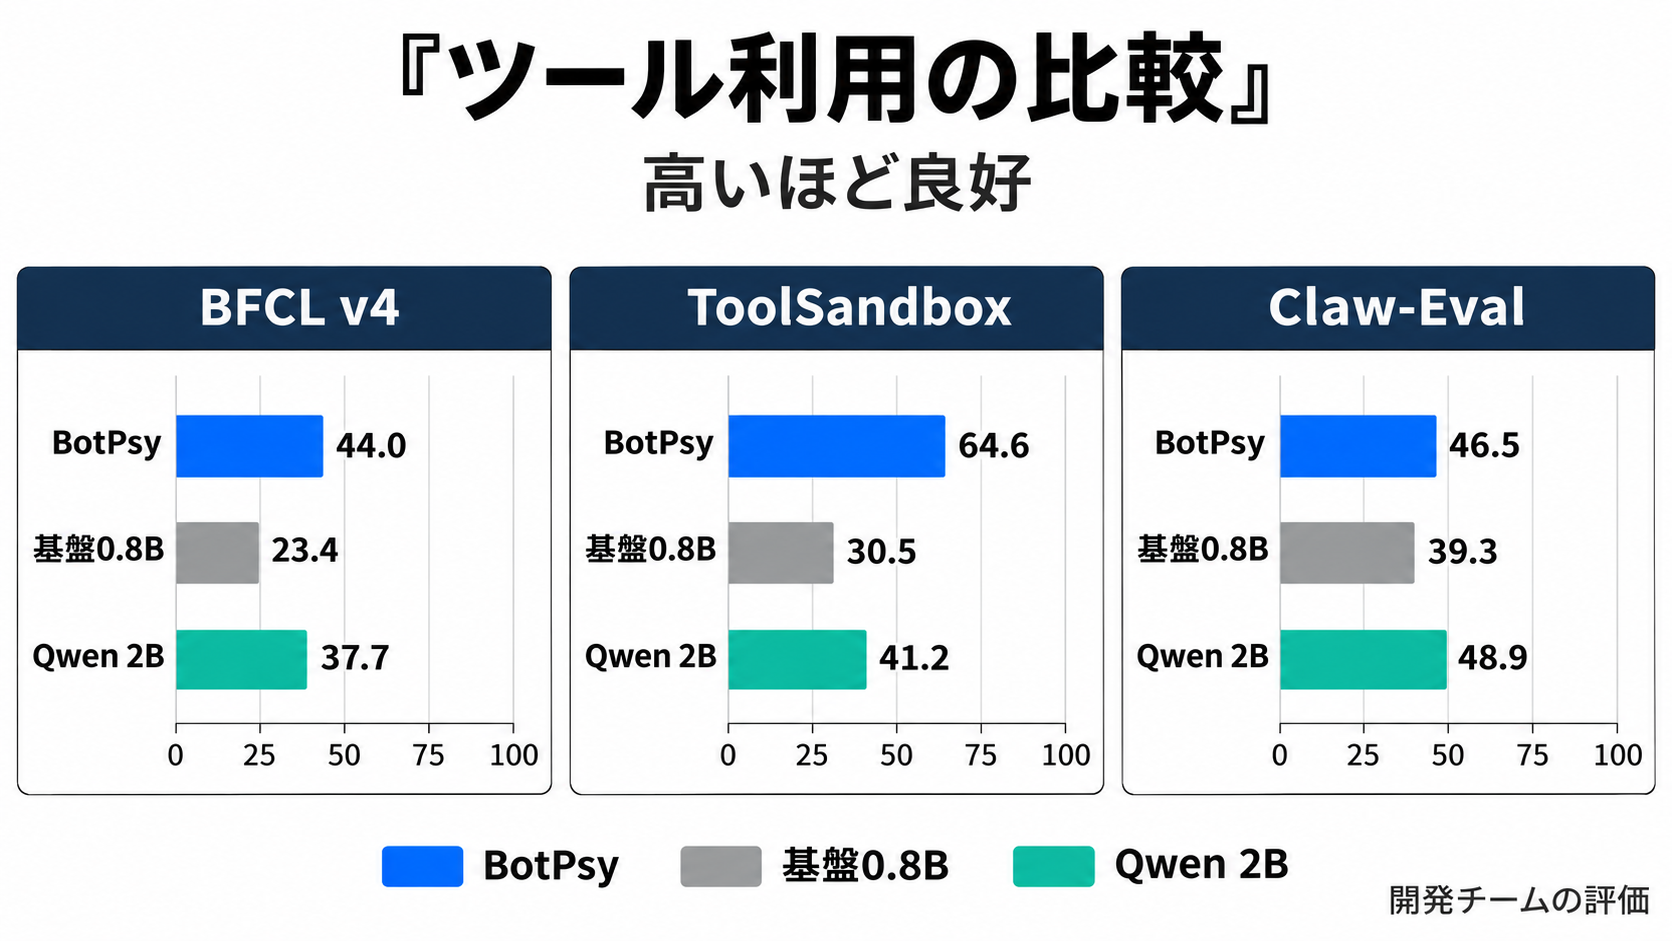
特に目立つのは、基盤モデルからの改善幅です。関数呼び出しを評価するBFCL v4は23.4から44.0へ、ACEBenchは30.1から58.7へ伸びています。小売・通信・銀行の各サブセットを平均したτ-benchのスコアも、23.2から51.5へ上昇しました。いずれも開発チームによる報告値であり、個別企業の業務成功率を直接表す数値ではありません。
| 評価指標 | BotPsy-0.8B | 基盤の0.8Bモデル | Qwen3.5-2B-Think |
| --- | --- | --- | --- |
| BFCL v4 | 44.0 | 23.4 | 37.7 |
| ACEBench | 58.7 | 30.1 | 55.4 |
| τ-bench | 51.5 | 23.2 | 46.5 |
| ToolSandbox | 64.6 | 30.5 | 41.2 |
| BrowseComp-Plus | 4.5 | 1.9 | 2.8 |
| Claw-Eval | 46.5 | 39.3 | 48.9 |
表のスコアは0〜100で、高いほど良い評価です。BotPsyは、パラメータ数が2.5倍のQwen3.5-2B-Thinkにも6指標中5指標で勝っています。ただし、Claw-Evalでは及びません。幅広い知識を問うGPQA DiamondやMMLU-Proでも、2Bモデルが明確に上回っています。
相対順位と実用水準の違いにも注意が必要です。検索能力を測るBrowseComp-Plusでは比較対象中で首位でも、スコアは4.5にとどまります。複数の情報源をたどる自由度の高い調査まで任せられると判断する根拠にはなりません。今回の結果は、小型モデルでもツール操作へ学習を集中させれば改善できることを示しますが、大型モデルの役割を全面的に置き換えるものではないでしょう。
操作を覚えた後に、知識と指示追従を立て直す学習設計
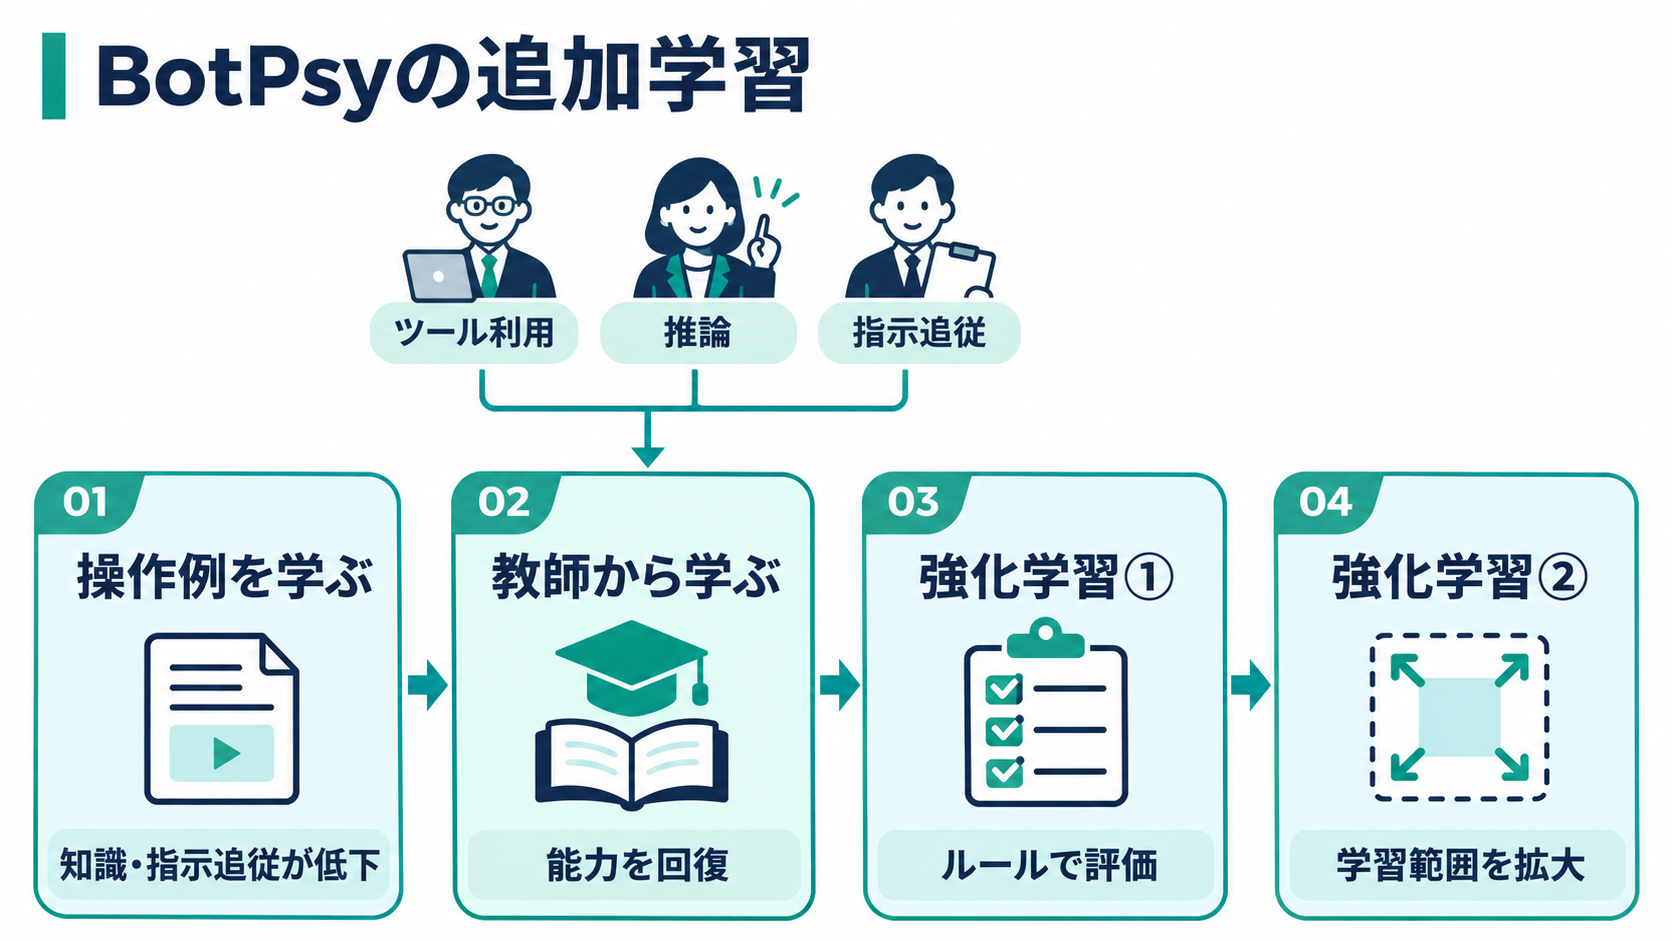
BotPsyの学習は、教師あり微調整、複数の教師モデルを使った蒸留、2回の強化学習という4段階で進められています。それぞれの段階は、直前の段階で最も良かったチェックポイントを出発点にします。操作例を覚えさせるだけで終わらず、知識や指示への対応力とのバランスを調整している点が特徴です。
最初の教師あり微調整では、ツールを利用する会話を学習します。単独の呼び出し、並列処理、複数の手順を踏む処理に加え、ツールを呼ぶべきではないケースも含めています。開発チームによると、この段階でツール利用能力は向上しましたが、一般知識と指示追従の評価は基盤モデルを下回りました。専門化すれば、ほかの能力も自然に伸びるとは限らないことが分かります。
続く蒸留では、生徒モデル自身が生成した応答に対して、より大きな教師モデルが細かく学習信号を与えます。教師はQwen3.5-4Bを基にした3種類で、ツール利用、一般的な推論、指示追従をそれぞれ専門としています。入力に応じて担当する教師を振り分け、微調整で落ち込んだ能力の回復を図りました。この段階では、ツール利用の評価も改善しています。
その後の強化学習では、ルールや検証器によって計算した報酬を使います。ツール呼び出しの正誤を一括で判定するだけでなく、関数名、引数名、引数の値を照合し、部分的な正しさも評価する設計です。後半では数学、コード、知識問題、構造化出力などへ学習対象を広げています。
企業がこの手法から読み取れるのは、用途への特化と基礎能力の維持を別々に確認する必要性です。自社向けの調整でも、特定操作の精度が上がった一方で、確認質問や出力形式への対応が悪化していないかを点検すべきでしょう。BotPsyの成果をそのまま再現できるとは限りませんが、評価を一つの業務指標だけに絞らないという考え方は参考になります。
端末内運用の効率を支える、短い推論と少ない反復
小型モデルを選ぶ理由は、保存するモデルの大きさだけではありません。同じ依頼を処理するまでにどれだけ長く推論し、何回やり取りするかも、待ち時間や計算資源の消費に関わります。BotPsyの開発チームは、学習を通じて推論効率も重視したと説明しています。端末内での運用を考える企業には、精度と合わせて確認したい部分です。
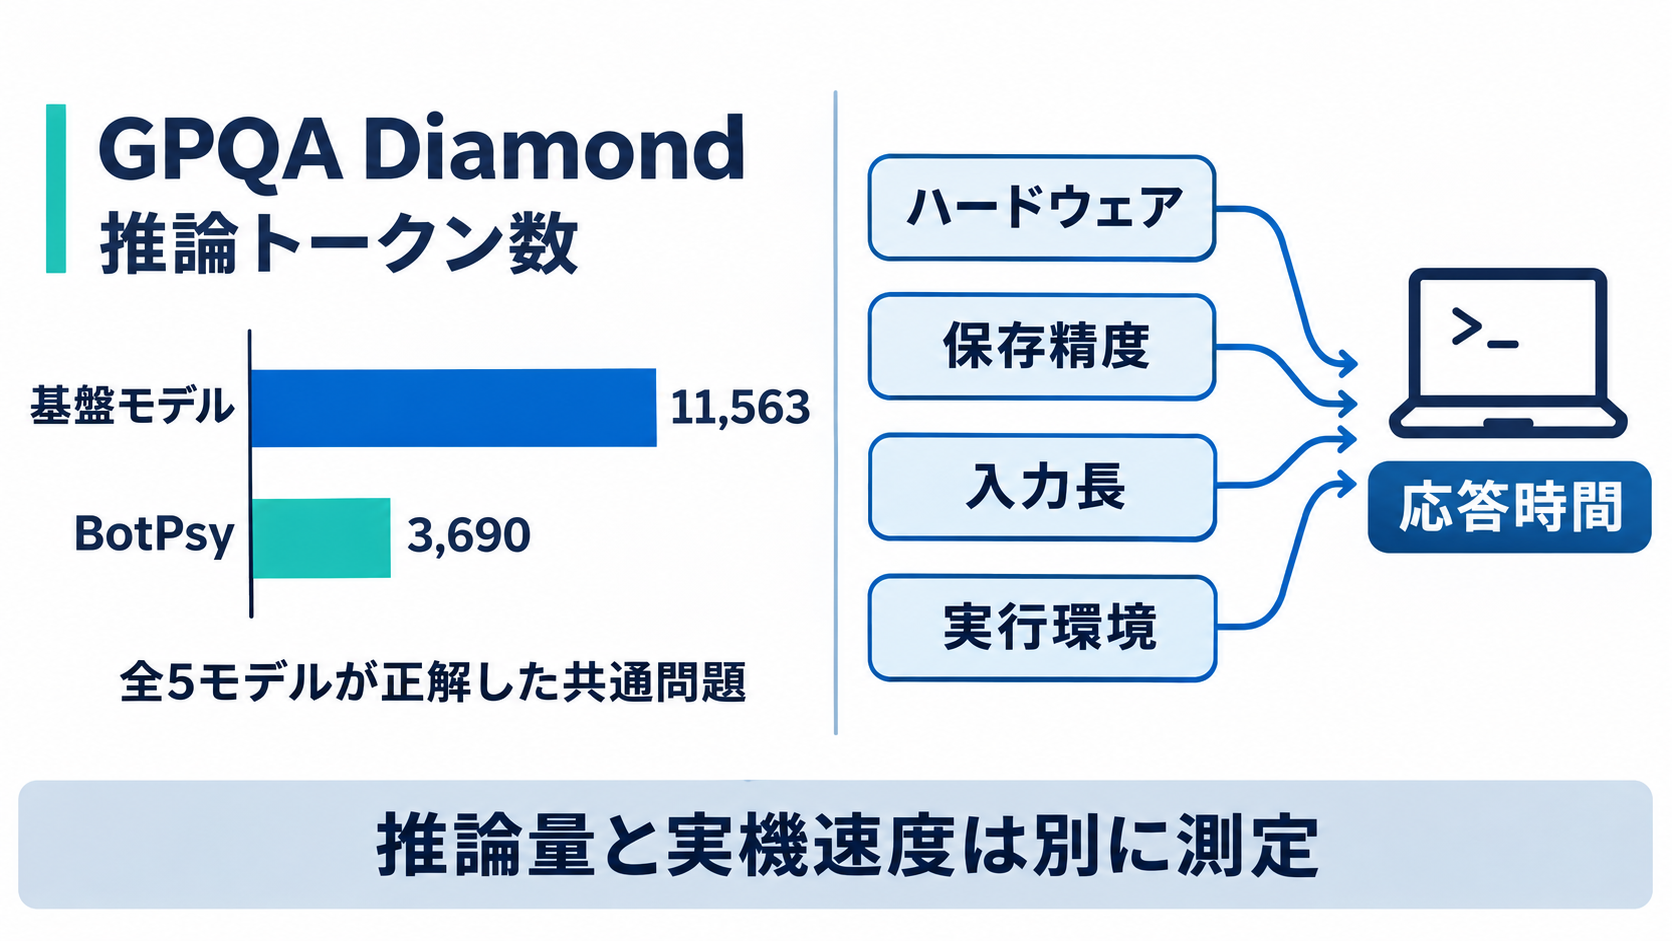
報告された比較では、5モデルすべてが正解した共通問題を対象に、正解までの推論トークン数を測っています。トークンはモデルが文章を処理する単位です。GPQA Diamondでは、BotPsyが3,690トークン、基盤モデルが11,563トークンでした。MMLU-Proでも1,912対5,105となり、BotPsyのほうが短い推論で正解に到達しています。
反復から抜け出せなくなる挙動も減っています。IFBenchの全試行では、同じような推論を繰り返す割合が22.9%から1.4%へ低下し、32,000トークンの上限に達した割合も28.3%から0.2%へ下がりました。処理が長引くケースを減らせれば、利用者が応答を待つ時間のばらつきを抑える効果が期待できます。
ただし、これらは端末ごとの実測速度や消費電力を保証する数字ではありません。推論トークンは各モデル固有のトークナイザーで数えており、実際の速度はハードウェア、実行ソフトウェア、モデルの保存精度、入力の長さにも左右されます。導入判断には、利用予定の機器での測定が欠かせません。
提供形式について、開発チームはbf16、Q8、Q4の精度と、safetensorsおよびGGUF形式での公開予定を説明しています。GGUFはllama.cppなどでの実行に使われるモデル形式です。低い精度で保存すればメモリ使用量を抑えやすくなりますが、用途ごとの品質確認は必要でしょう。研究・教育用途に言及しつつApache 2.0でのオープンウェイト公開を掲げているため、企業利用では実際の配布物と適用条件を確認することが出発点になります。
ローカル実行と安全な業務実行は、分けて評価が必要
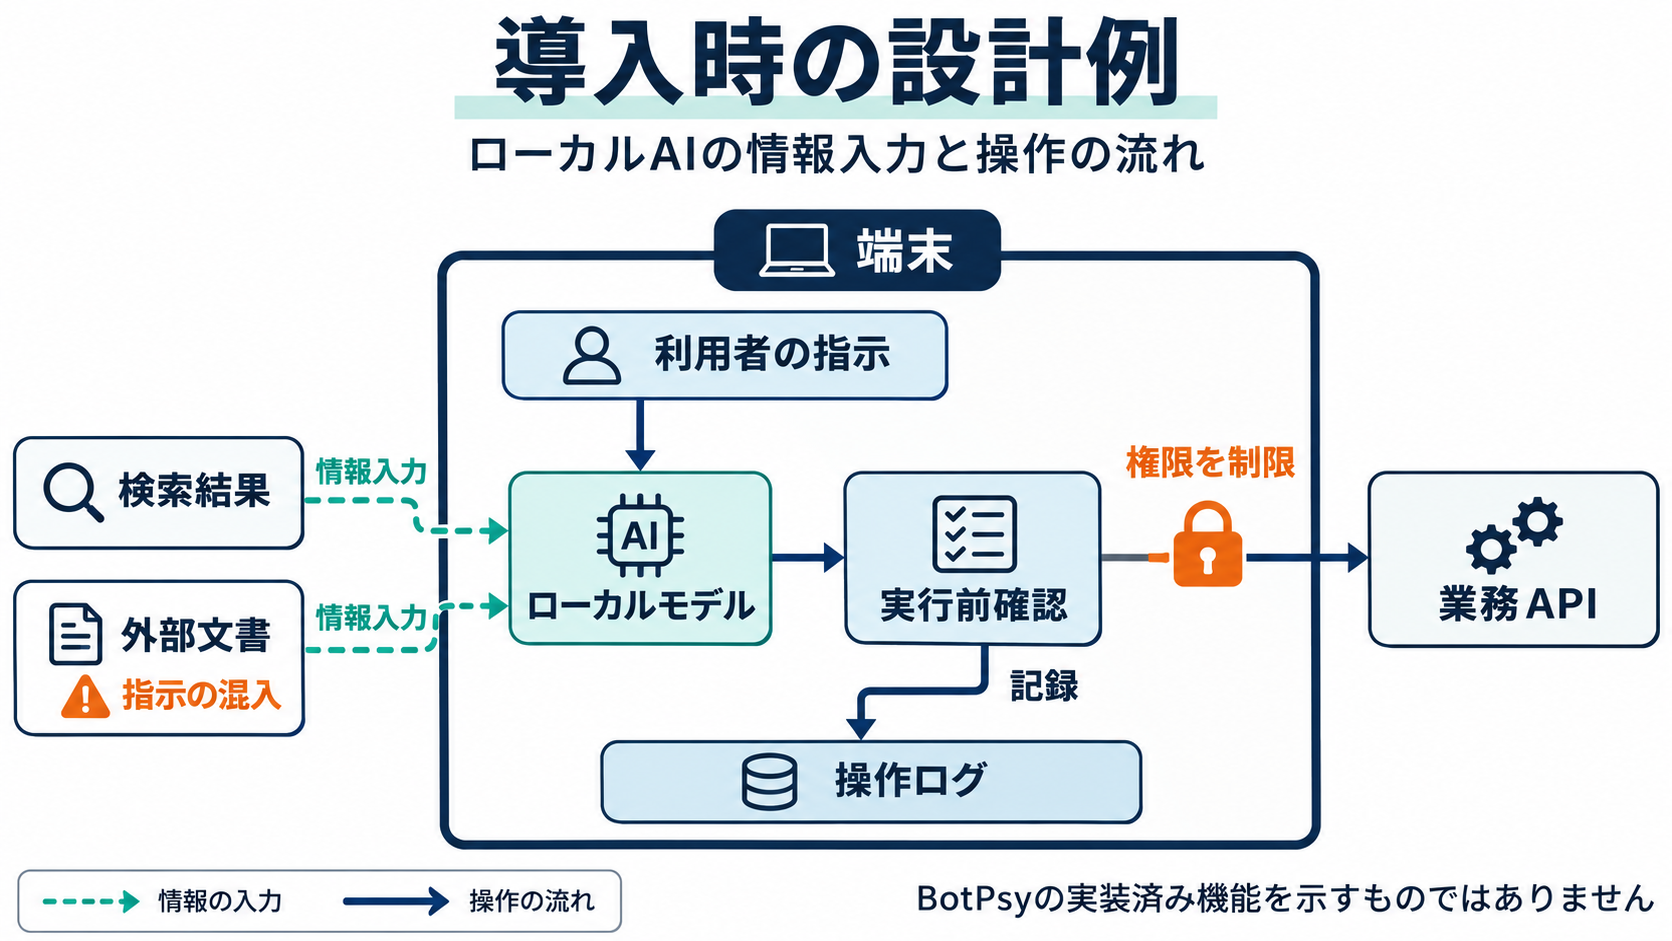
社外のクラウドへ入力を送らずにモデルを動かせることは、データの管理場所を選ぶうえで利点になります。ただし、モデルが端末内にあることと、業務上の操作が安全であることは別の問題です。検索、メール、社内APIなどを接続すれば、情報の送信先や操作できる範囲は、それぞれのツールの設計に依存します。
Tether AI Researchは、6種類の有害性カテゴリーを対象とした自動攻撃評価で、BotPsyが安全でない応答を返す割合は21%だったと報告しています。基盤モデルの36%から改善し、比較対象の12億パラメータ以下のモデルでも最も低い値でした。それでも、安全でない応答が残っている点を見落とすことはできません。
エージェントでは、外部の文章に紛れた指示へ従ってしまうプロンプトインジェクションも問題になります。例えば検索結果や取得した文書は、情報源として読む対象であり、操作権限を与える指示ではありません。開発チームの評価では、この攻撃下での安全でない応答の割合は、基盤モデルの46%から31%へ下がりました。改善は確認できますが、モデルだけで防ぎ切れる状態を示す数字ではないでしょう。
実務では、モデルに渡す権限を業務に必要な範囲へ絞り、外部コンテンツと利用者の指示を区別し、実行記録を残す設計が考えられます。送信、削除、購入など結果を取り消しにくい操作では、実行前に内容を確認する仕組みも有効です。これらは企業側の実装上の対応策であり、BotPsyに一式が備わっているという意味ではありません。
適切なツールがない場合に呼び出しを控えるBFCL v4の評価では、BotPsyは86.1を記録しました。この能力は、無理に操作を進めない設計を支える材料になります。それでも、不足情報を聞き返す場合や、実行を止める場合を自社の業務条件で確かめる必要があります。安全性は単一のスコアではなく、モデルと周辺システムを合わせて判断する課題です。
日本企業の試行は、日本語で範囲の狭い業務から
日本企業にとって、最初の確認事項は日本語の依頼をどこまで安定して扱えるかです。公開されたMulti-IFの結果には、英語、中国語、フランス語など8言語の評価が示されていますが、日本語は含まれていません。ほかの言語での成績や一般的な指示追従の高さだけから、日本語の業務でも同じ品質を得られるとは判断できません。
会話が長くなる場合にも課題が残ります。BotPsyのMulti-IFスコアは、1ターン目の84.3から3ターン目には51.0へ下がりました。また、複数手順を伴う情報検索・調査の用途別評価は15にとどまります。銀行業務を扱うτ³-bankingでは4.1で、比較対象もすべて5未満でした。得意な場面での改善と、複雑な実務を最後まで遂行する能力は切り分けて考えるべきでしょう。
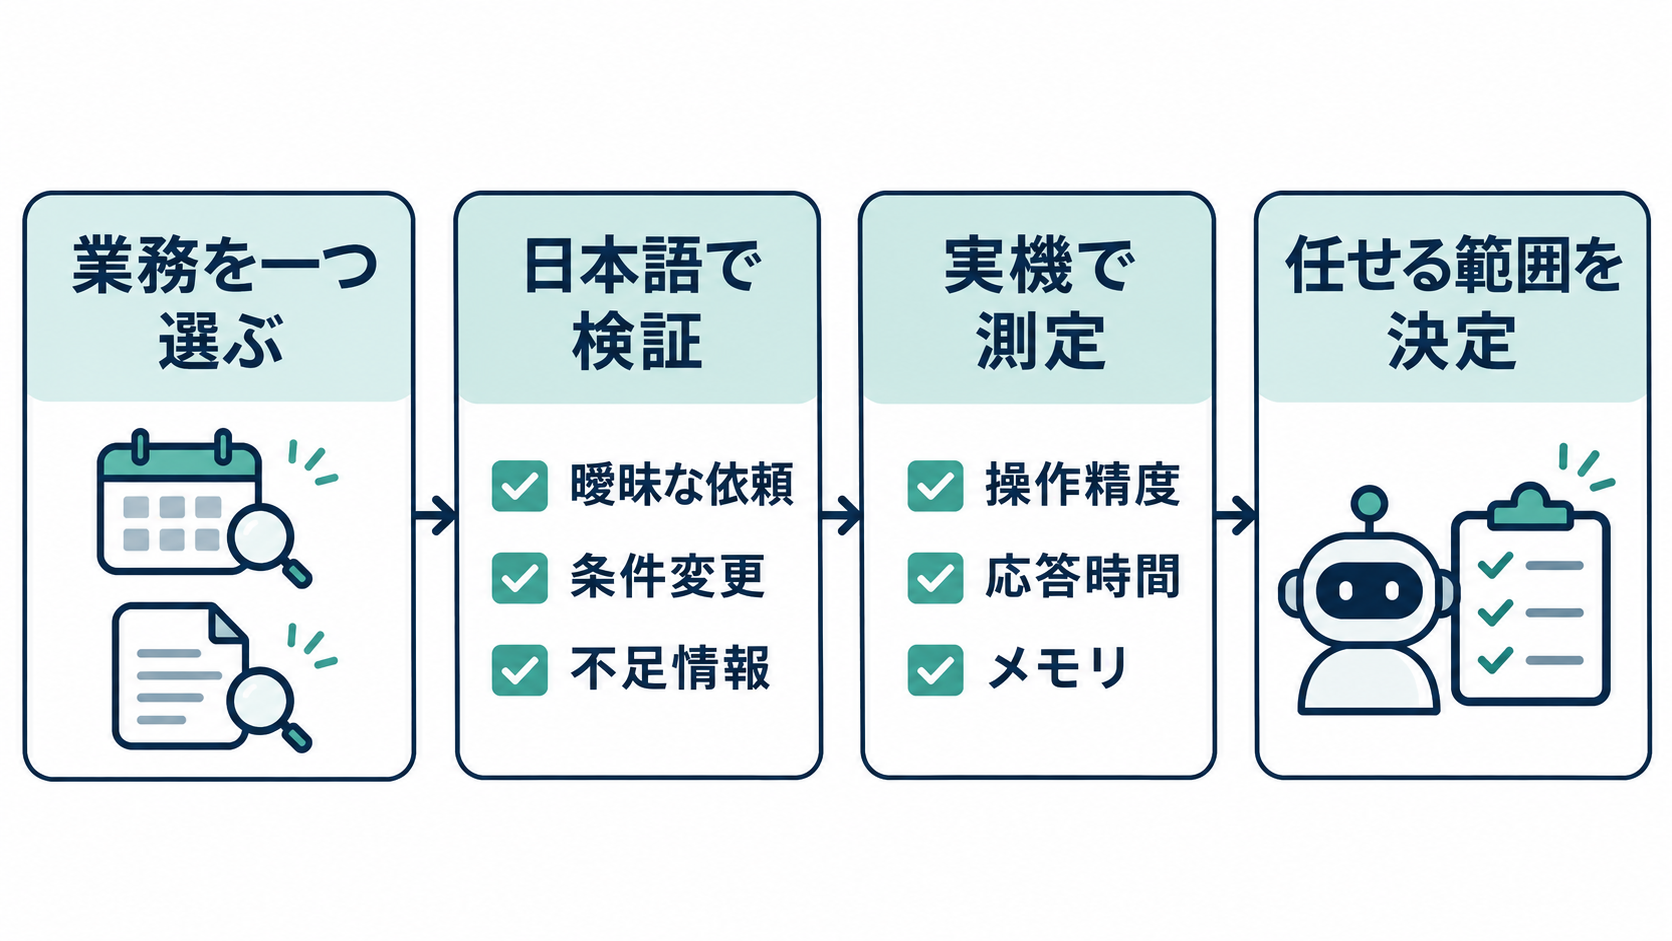
試行対象として考えやすいのは、入力と操作先が明確な、範囲の狭い仕事です。例えば検証用カレンダーから予定を検索する、指定フォルダー内の文書候補を探す、といった読み取り中心の処理が候補になります。これはBotPsyでの動作が確認された個別事例ではなく、導入時の評価範囲を限定するための提案です。曖昧な依頼、日付の変更、条件の追加も含めれば、単発の成功例では分からない弱点を探れます。
その際は、正しく操作できた割合に加え、不足情報を聞き返せたか、不要なツールを呼ばなかったか、途中で条件が変わっても守れたかを確認するとよいでしょう。実機での応答時間とメモリ使用量も測れば、モデルの小ささが自社環境でどの程度の利点になるかを判断できます。クラウド費用の削減幅についても、端末管理や運用の負担を含めた比較が必要です。
開発チームは将来構想として、対応する機器やローカルサービスの拡大、端末間での処理分担、ローカルでの追加学習などを挙げています。これらは今後の開発方針として捉える必要があります。企業が今できる一歩は、自社の定型業務を一つ選び、日本語の正常例と失敗しやすい例を用意して試すことです。そこで得た操作精度と実行コストを基に、任せる範囲を具体的に決められます。