

2026/11/12
AIニュース
IBM、520量子ビットのNighthawk r3を発表――企業が見るべき実機の高速化と2027年の接続計画
この記事の要点
IBMは、520量子ビットで1万回の量子操作を目指すNighthawk r3を発表し、2027年に2基を接続する計画を示しました。現在利用できるr2では回路実行の高速化が報告されています。企業の検証では、将来の設計目標と実機の実績を区別し、精度と前後処理を含む所要時間を確認する必要があります。
目次
520量子ビットの新設計と、すでに使える高速化
量子コンピューターを業務に役立てられるか検証するとき、量子ビットの数だけでは判断できません。同じ計算を何度も実行し、結果を集め、従来のコンピューターで分析するまでに、どれだけ時間がかかるかが問題になります。IBMが発表した超伝導量子プロセッサー「IBM Quantum Nighthawk r3」は、この実行効率と将来の規模拡大を分けて捉える必要があるニュースです。
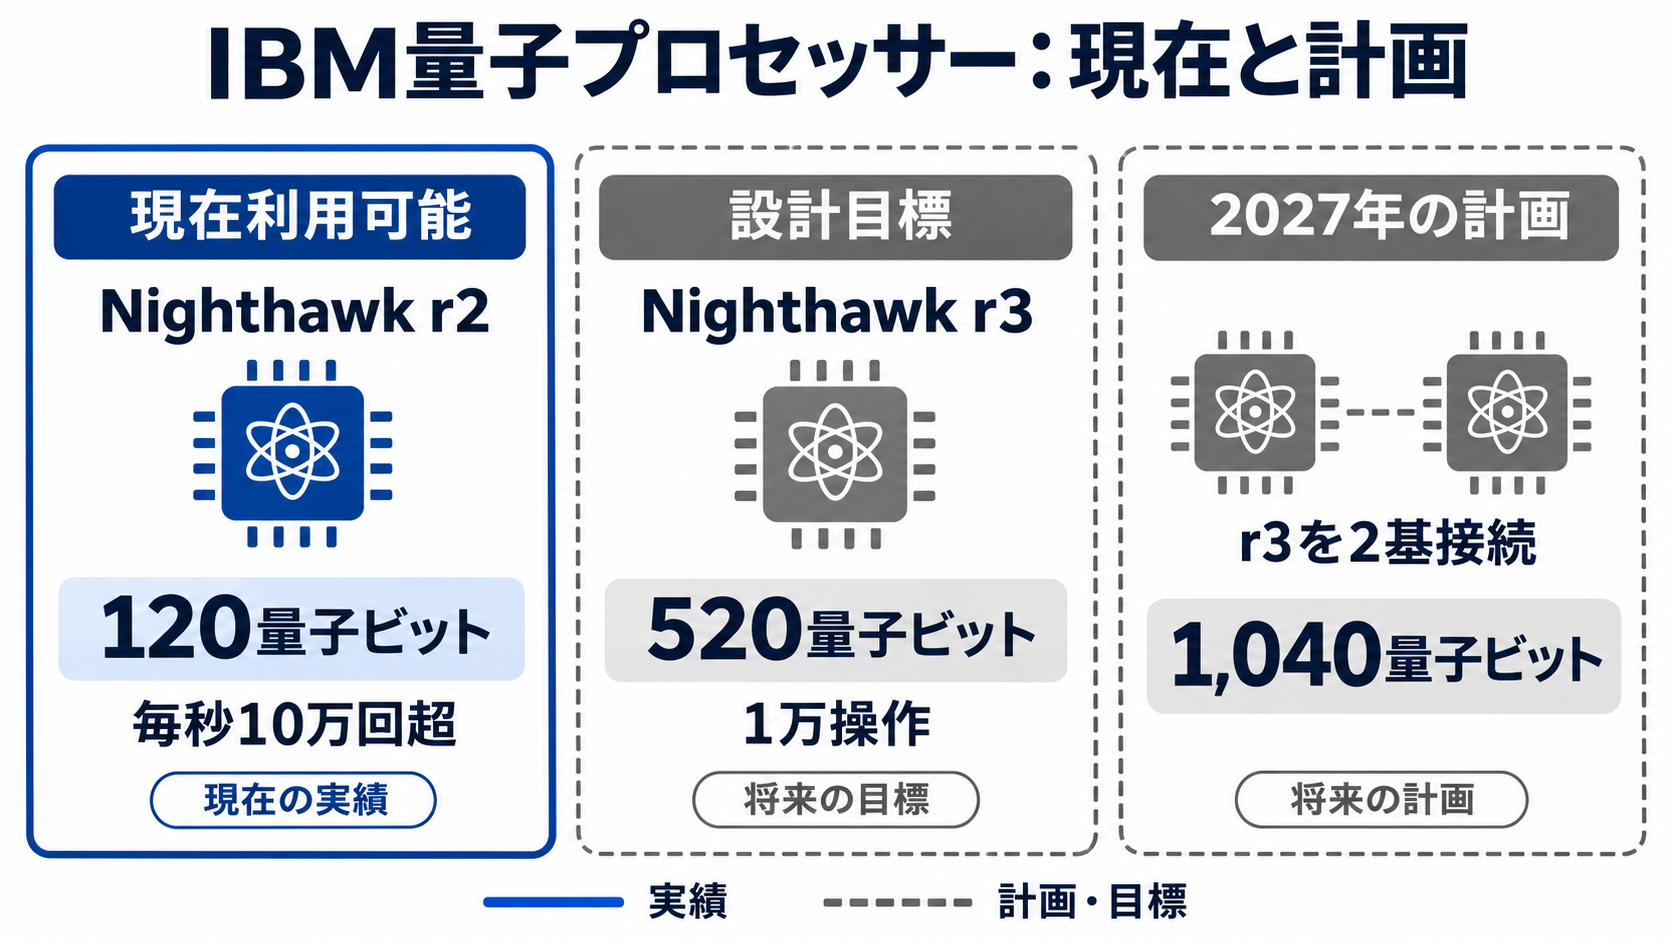
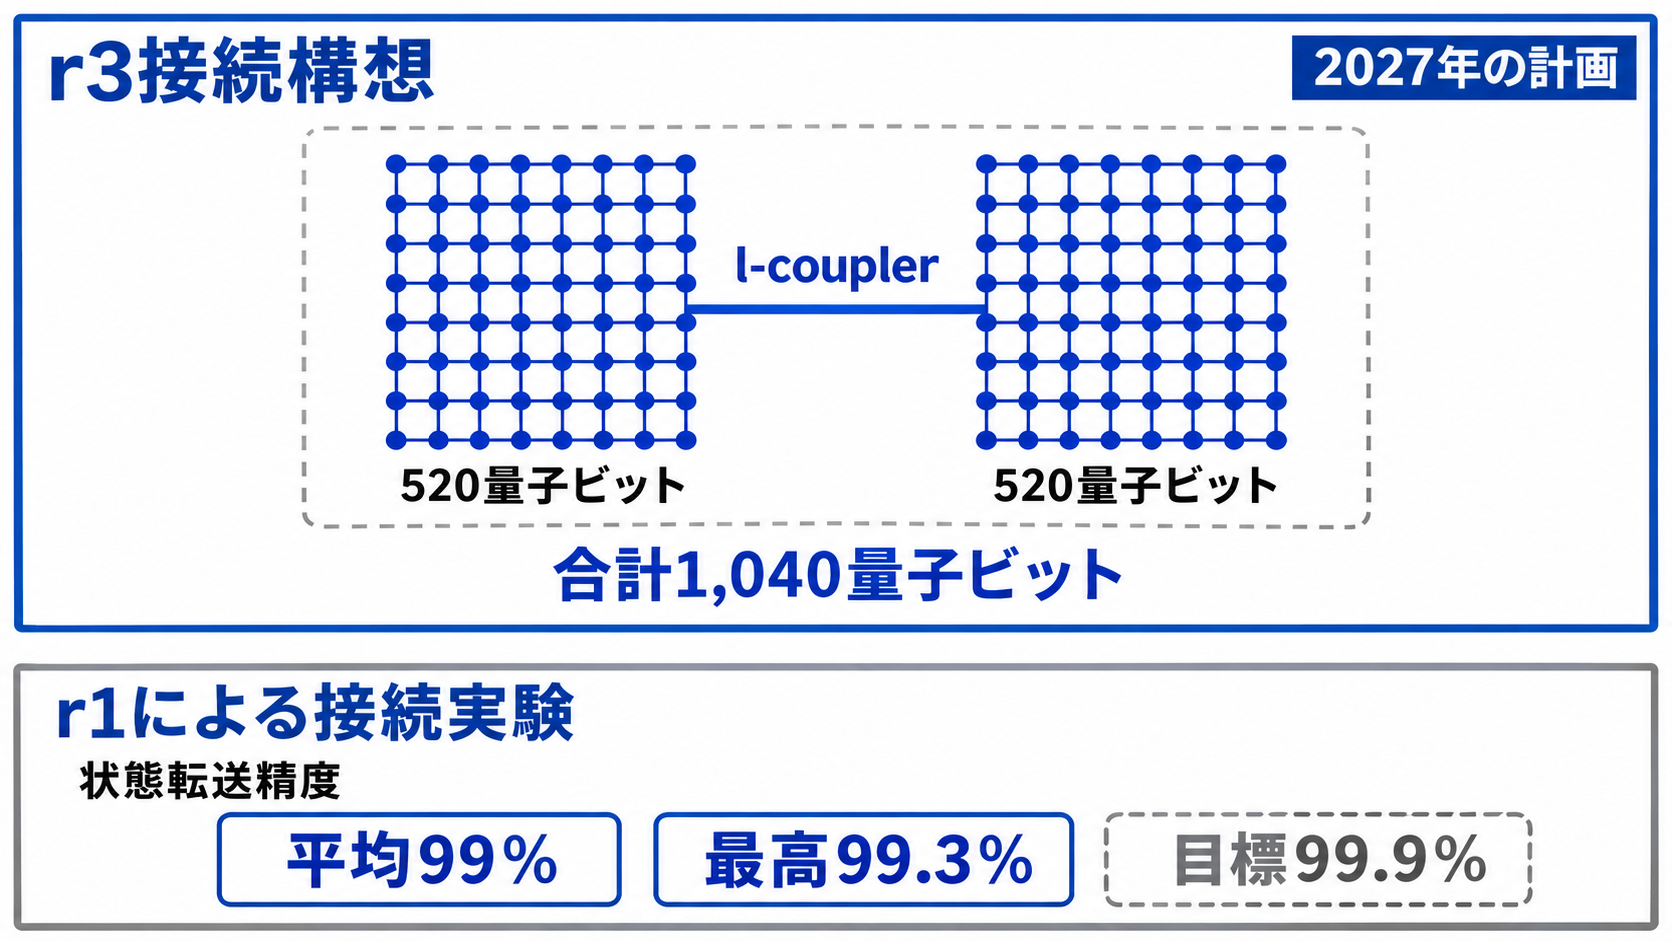
新設計のr3は、520個のプログラム可能な量子ビットを備え、1万回の量子操作を正確に実行することを目指しています。IBMは2027年にr3を2基接続し、1,040量子ビットのシステムを構築する計画も示しました。ただし、これらは設計と計画の段階です。520量子ビットでの目標達成や、2基を接続したシステムの稼働実績が示されたわけではありません。
企業の検証担当者にとって、現在の判断材料になるのは、すでにIBM Quantum Platformで利用できる「Nighthawk r2」の性能です。IBMによると、r2は毎秒10万回を超える量子回路の実行に対応し、従来のHeronと比べて約25倍の処理量を実現しています。提携先のワークロードでは、以前のIBM製プロセッサーに対して最大19倍の高速化も報告されています。
今回の発表は生成AIモデルの更新ではなく、量子計算基盤の進展です。生成AIの学習や推論がそのまま高速になるという説明はありません。企業が着目すべき中心は、将来の量子ビット数の大きさだけでなく、現在の実機で反復計算の待ち時間がどこまで短くなったかという点でしょう。
待ち時間を減らす量子ビットのリセット機構
量子計算では、回路を一度実行すれば必要な答えがすべて得られるとは限りません。測定結果には確率的なばらつきがあるため、同じ回路を繰り返し実行し、結果を集めて値を推定します。この一回ごとの実行を「ショット」と呼びます。各ショットの間に量子ビットを初期状態へ戻す時間が長いと、量子操作そのものが速くても、全体の処理量は伸びません。
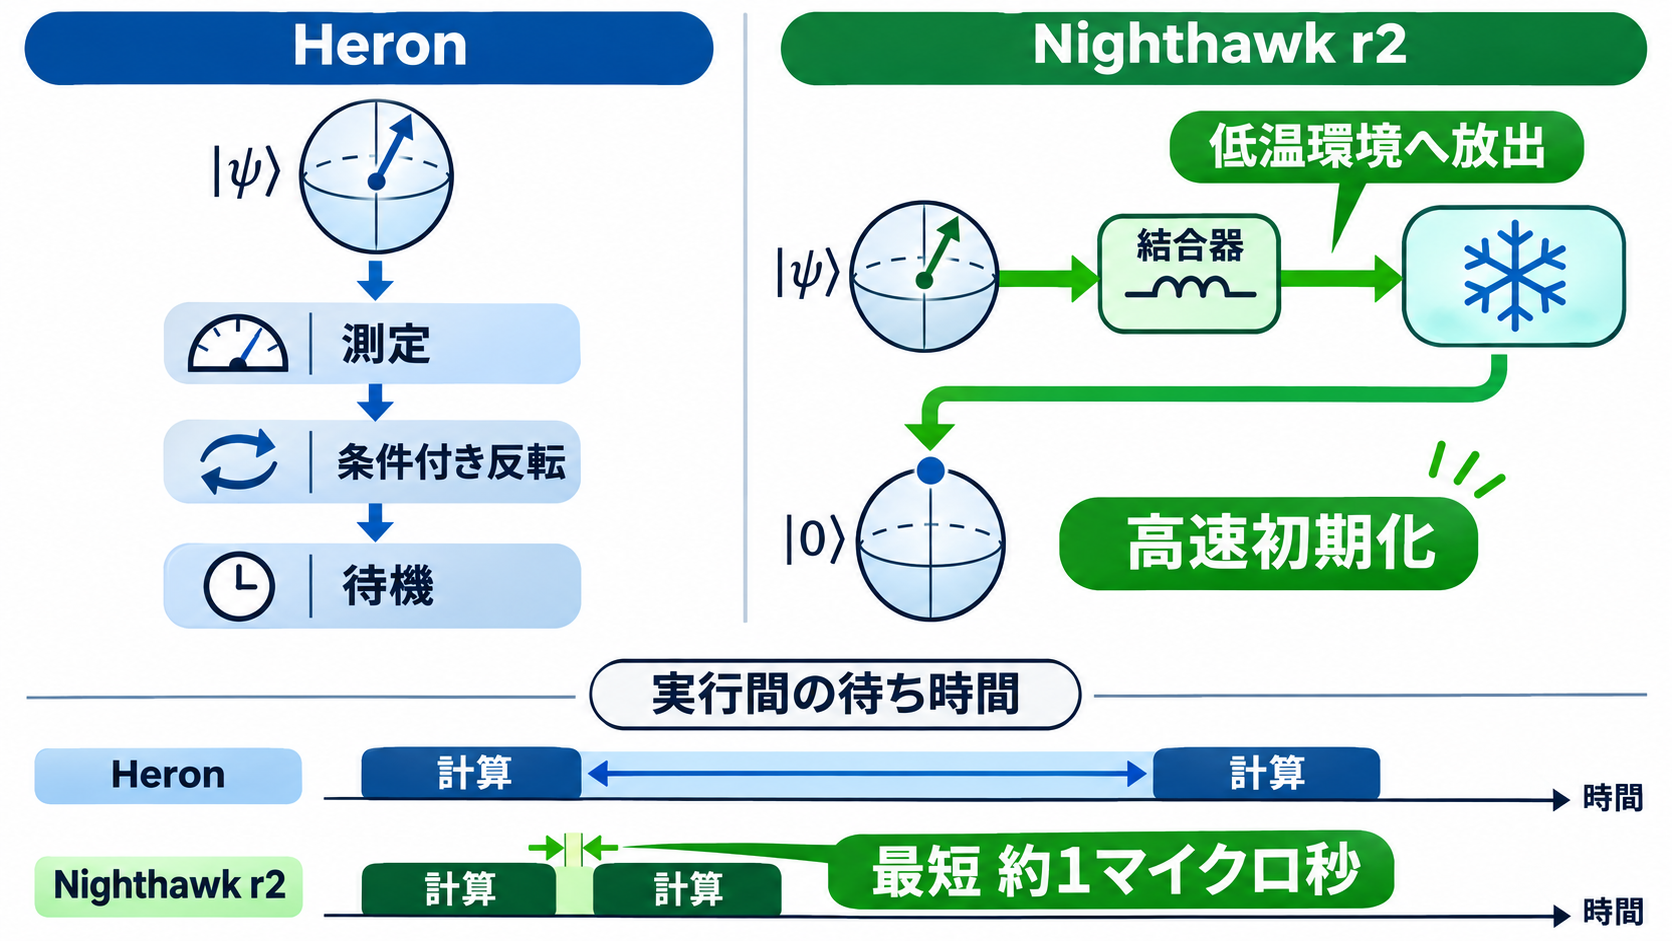
従来のHeronが採用する条件付きリセットは、量子ビットを測定し、励起状態にあれば状態を反転させる方式です。ただし、計算に使う状態の範囲から外れた「リーク状態」には、この方法だけでは対処できません。そのため、ショット間に数百マイクロ秒の待ち時間が必要になっていました。
Nighthawk r2は、各量子ビットに散逸型リセット機構を設けています。調整可能な結合器を通じて必要なときに低温の環境へ接続し、量子ビットのエネルギーを逃がす仕組みです。IBMの説明では、このリセット中の実効的なT1、つまりエネルギー緩和の時間尺度は、約200マイクロ秒から約25ナノ秒に短縮されました。実行間の待ち時間は最短で約1マイクロ秒になります。
ここでの短いT1は、量子情報を長く保持する性能の向上を意味するものではありません。初期化したいときに素早くエネルギーを抜けることが利点です。IBMは、隣接する量子ビットに影響を与えず、初期化エラーも約25分の1に低減したと報告しています。毎秒約4,000回だったHeronに対し、r2が毎秒10万回超の回路実行に達する背景には、こうした計算の合間の改善があります。
提携先の高速化実績をどう読むか
処理量が約25倍になったとしても、企業の業務全体が一律に25倍速くなるわけではありません。回路の構成、測定回数、結果の後処理などによって、最終的な所要時間は変わります。IBMと提携先が示した事例は、その違いを具体的に確認する材料になります。ただし、数値はいずれもIBMまたは提携先による報告として読む必要があります。
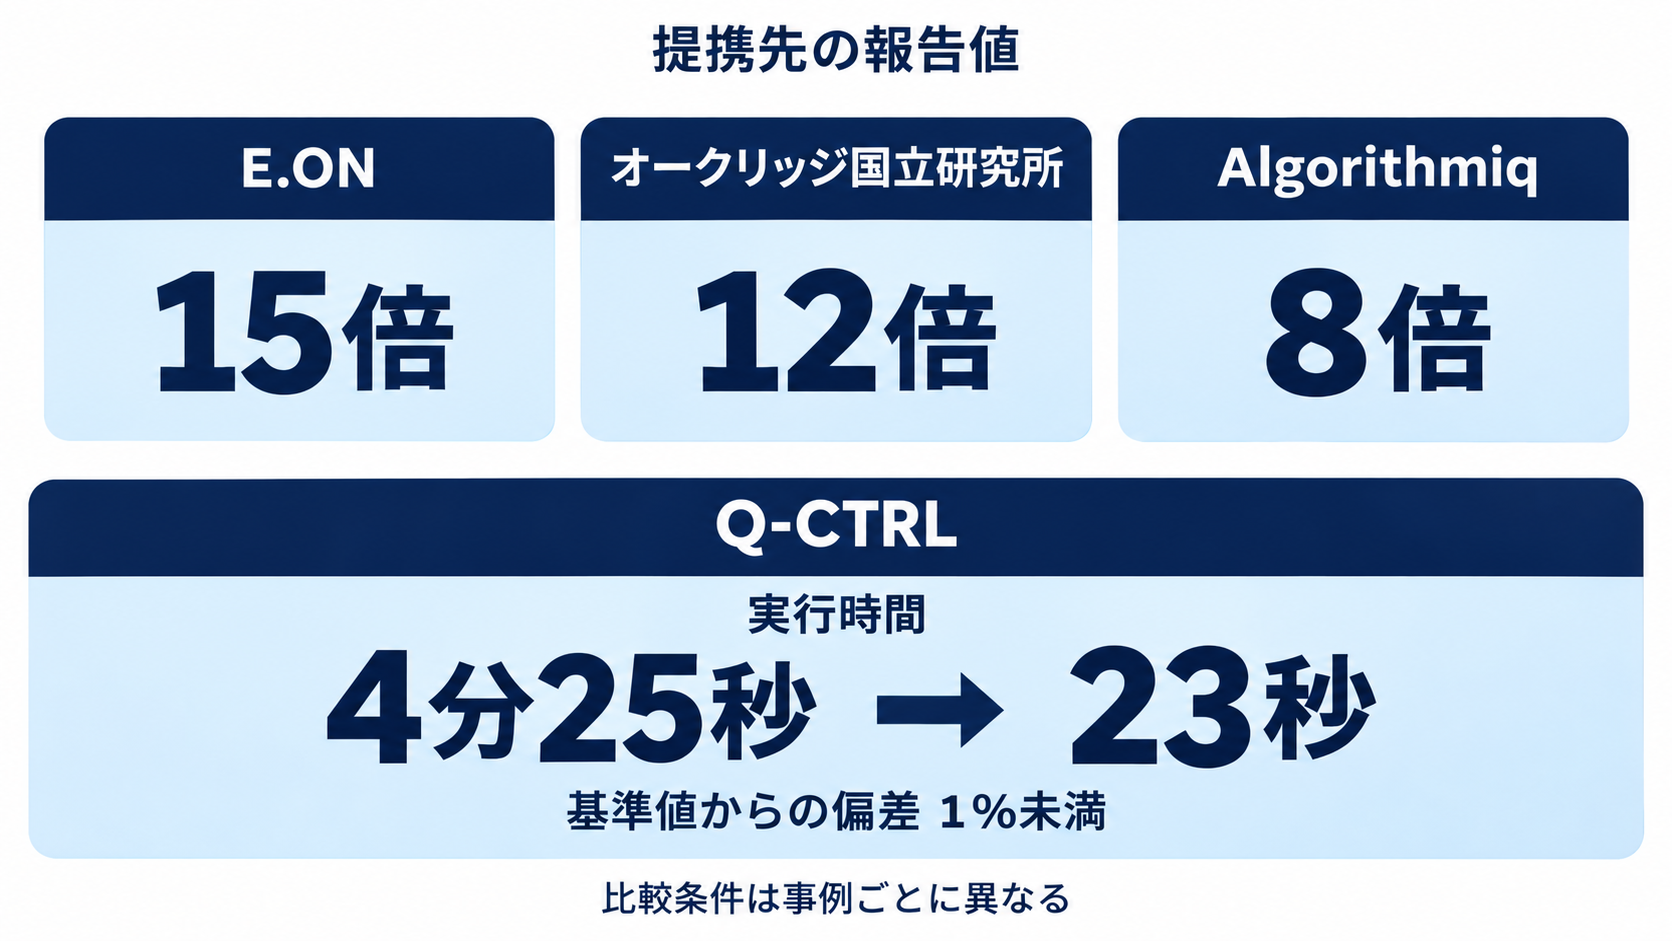
欧州のエネルギー企業E.ONは、電力網の最適化に関する量子機械学習で、Heronに対して15倍の高速化を報告しています。米国の研究機関であるオークリッジ国立研究所は、中性子散乱データと対応する磁性材料シミュレーションで12倍の高速化を示しました。量子アルゴリズムを開発するAlgorithmiqでは、以前のHeronを使った実験に比べ、回路の実行が8倍速くなっています。
量子制御技術を手がけるQ-CTRLの事例では、60量子ビットと4,497回の2量子ビットゲートを使うフェルミ粒子シミュレーションの実行時間が、4分25秒から23秒へ短縮されました。Heron r3による基準値からの偏差は1%未満に収まったとされています。時間短縮と結果の整合性を併せて示している点が、実用性を考えるうえで参考になります。
IBMによると、顧客がr2で実行した回路数は累計340億回に達しています。また、7,500回を超えるゲート操作を含む回路で、観測量を正確に推定したとも報告しています。とはいえ、これらの実績だけで従来型コンピューターに対する優位性が確定するわけではありません。導入判断では、自社に近い問題設定か、比較対象は何か、精度をそろえているかを確認することが欠かせません。
r3の規模拡大を支える接続と、残る精度の課題
Nighthawkシリーズは、量子ビットを正方格子状に配置する設計を採用しています。多くの量子ビットが近隣の4個と接続でき、以前の設計の2~3個から接続性を高めています。これは単なる配置の違いではありません。直接つながっていない量子ビット同士を操作するための入れ替え処理を減らし、複雑な相互作用を持つ回路を組みやすくする狙いがあります。
r2は120個のプログラム可能な量子ビットに加え、218個の結合器と120個のリセット素子を備えています。r3は正方格子と高速な操作を引き継ぎ、プログラム可能な量子ビットを520個へ増やす設計です。公表情報では物理量子ビット数として2,034個という数字も示されていますが、プログラム可能な520個とは区別して理解する必要があります。
複数チップの接続には「l-coupler」と呼ぶ接続機構を使い、r3には10個を搭載する予定です。IBMは先行するNighthawk r1を2基使い、各80センチメートルのケーブルを持つ4個のl-couplerで接続する実験を行いました。量子状態を転送する精度は最高99.3%、平均99%に達したと報告しています。
ただし、平均99%は目標の99.9%には届いていません。数値の差は小さく見えても、多数の操作を積み重ねる計算では、接続部分の誤差も全体の結果に関わります。IBMは2つの極低温モジュールを接続し、5日未満で15ミリケルビン未満まで冷却したとも説明しています。接続と冷却の進展は確認できますが、2027年の1,040量子ビット構想を評価するには、接続後の計算精度と運用性能を引き続き見る必要があるでしょう。
量子計算と従来型計算を一つの作業として扱う基盤
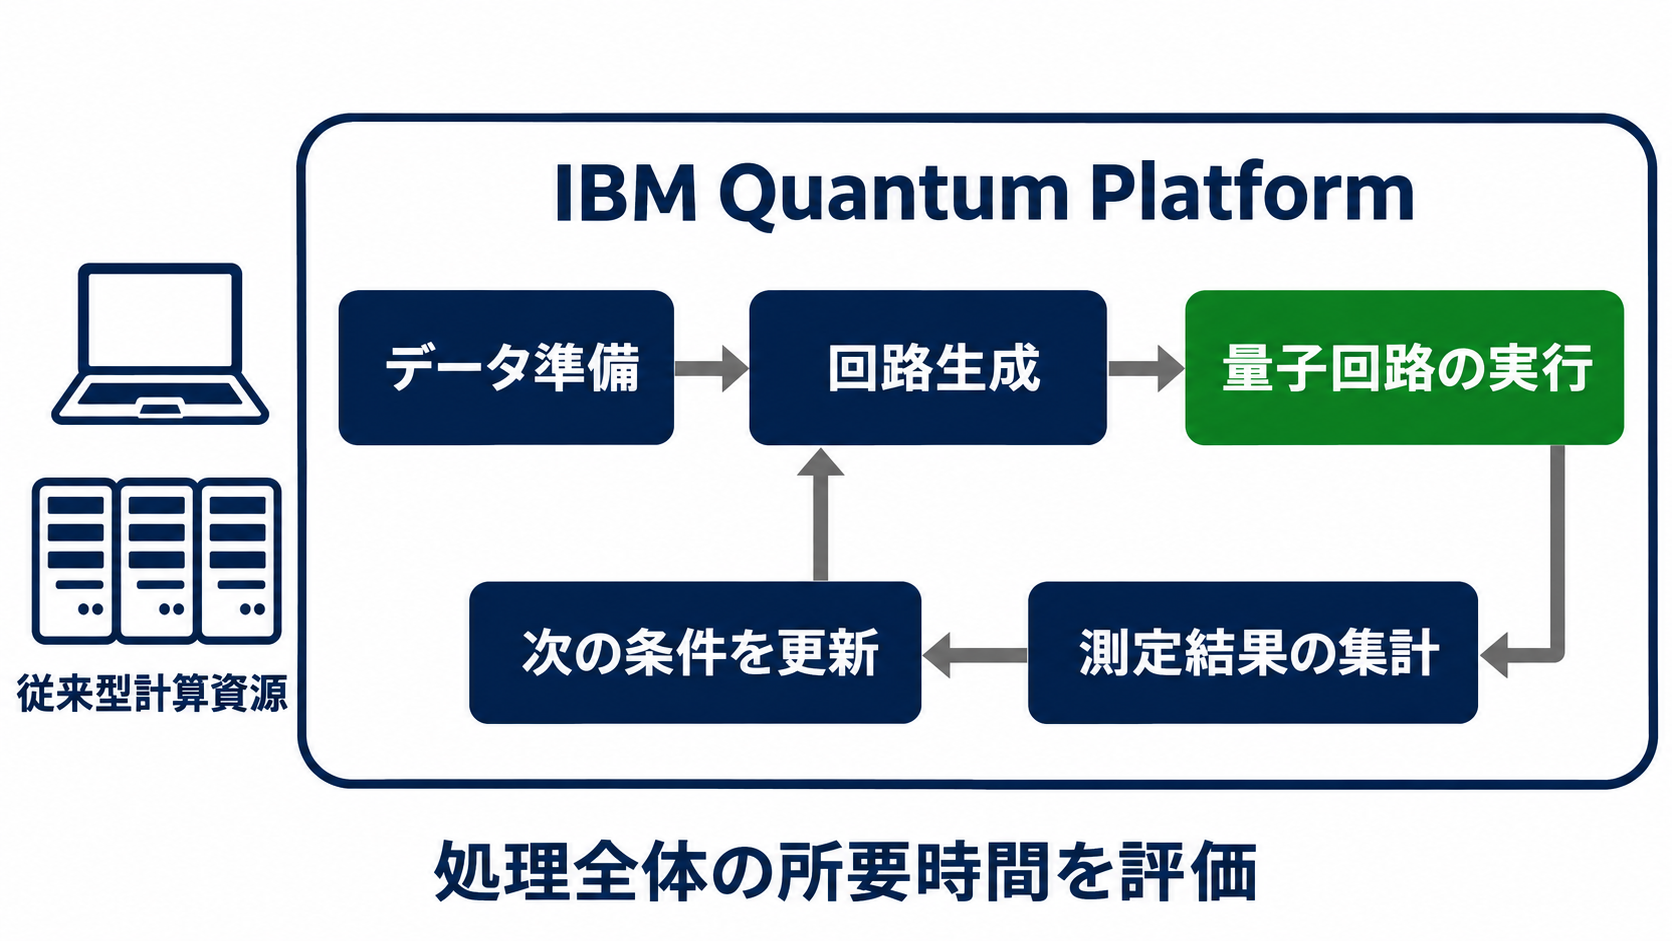
量子プロセッサーを使う仕事は、量子チップの内部だけで完結しません。入力データの準備、実行する回路の生成、測定結果の集計、次の計算条件の更新などには、従来型のコンピューターを使います。量子側の実行時間が短くなるほど、こうした前後の処理や、システム間で仕事を受け渡す時間も無視できなくなります。
IBM Quantum Platformは、高性能計算を意味するHPCと量子計算のジョブを、同じ管理環境で動かす仕組みを提供しています。利用者はノートパソコン、スーパーコンピューター、プラットフォーム側の計算資源を組み合わせられます。現在のr2は、このクラウド基盤で「ibm_phoenix」という名称で利用できます。
IBMと日本の理化学研究所は、量子計算で得たサンプルを利用する対角化処理のワークフローで、計算量を100倍に増やしながら約5倍の高速化を報告しています。また、米国の医療機関クリーブランド・クリニックと理化学研究所は、ワークフローの自動化により、6億800万件のサンプル処理を33倍高速化したとしています。ここでの倍率は、量子チップ単体の回路実行速度とは別の指標です。
企業にとっての示唆は、量子機器の仕様を比較するだけでは、実際の検証期間を見積もれないという点です。データを用意してから結果を評価するまでの流れを一つの作業として計測すれば、改善すべき場所を見つけやすくなります。IBMは誤り訂正研究向けにパルスレベルの制御も提供していますが、業務検証の担当者は、自社の目的に必要な制御範囲と運用の複雑さを照らし合わせるのが現実的です。
日本企業の検証は、量子ビット数より評価条件の整理から
今回の発表を受けて検証計画を立てるなら、「1,040量子ビットになるまで待つか」という問いだけでは十分ではありません。現在利用できるr2で、自社が想定する計算のどの部分を試せるかを整理するほうが、次の判断につながります。将来のr3に期待する性能と、現時点で測定できる性能を分けることで、実証の目的も明確になるでしょう。
検証候補には、電力網の最適化や材料シミュレーションなど、報告事例に近い領域が考えられます。ただし、同じ業界であっても問題の条件が異なれば、同じ高速化率は期待できません。量子機械学習という名称だけを理由に、生成AIへの効果を見込むことも避けるべきです。解きたい問題と、量子回路に落とし込める計算の対応を確認する必要があります。
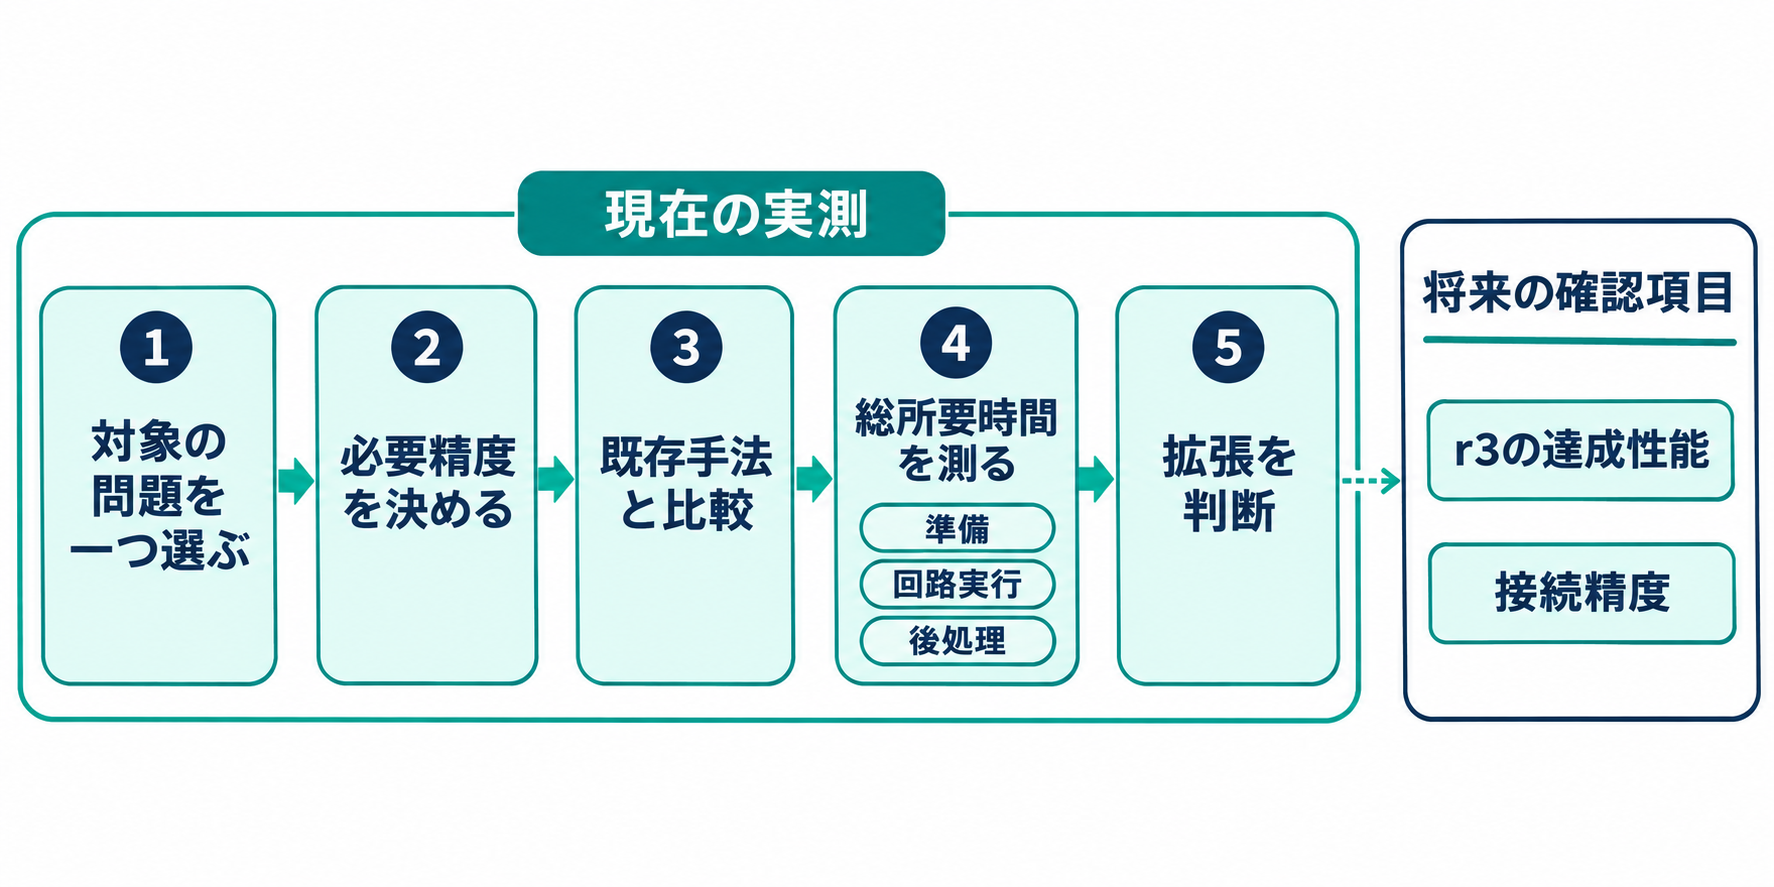
比較では、回路だけの実行時間と、データ準備や後処理を含めた総所要時間を分けて記録すると役立ちます。同じ精度を得るまでに何回の測定が必要か、従来型の計算手法ではどの程度の時間がかかるかも、そろえておきたい条件です。IBMの旧機種に対する高速化と、自社の既存手法に対する改善は、それぞれ別に評価しなければなりません。
担当者が最初に作るべきものは、用途候補を広く並べた一覧よりも、一つの問題に絞った評価シートです。必要な出力精度、許容時間、比較対象、前後処理の範囲を明記すれば、r2の実測値を採用判断へ結び付けやすくなります。そのうえで、r3の1万操作という目標やチップ間接続の精度が更新された際に、どの条件なら検証を拡張するかを決めておくとよいでしょう。