
AI LAB
2026/10/24
操作から映像まで230ミリ秒以下、Kyutai「CADRE」が変える世界モデルの設計基準
世界モデルの実用性を左右する「操作の遅れ」
ゲーム画面でキーを押したのに、映像が一拍遅れて動く。ロボットに指示を出しても、生成された次の状態がすぐに返ってこない。映像を生成しながら利用者の操作を受け付ける世界モデルでは、このわずかな遅延が体験を大きく左右します。フランスの非営利AI研究機関Kyutaiが公開した「CADRE」は、映像の見栄えだけでなく、操作に対する応答速度を中心に設計した動画オートエンコーダー群です。世界モデルとは、直前までの映像や操作を手掛かりに、その後の状態を生成するモデルを指します。多くのシステムは、テキストから動画を作る生成AI向けのオートエンコーダーを流用しています。しかし、複数フレームをひとまとめの潜在表現へ圧縮する方式では、そのまとまりが完成するまで次の処理へ進めません。圧縮効率が高くても、操作の反映が遅れれば、対話的な用途には使いにくくなります。
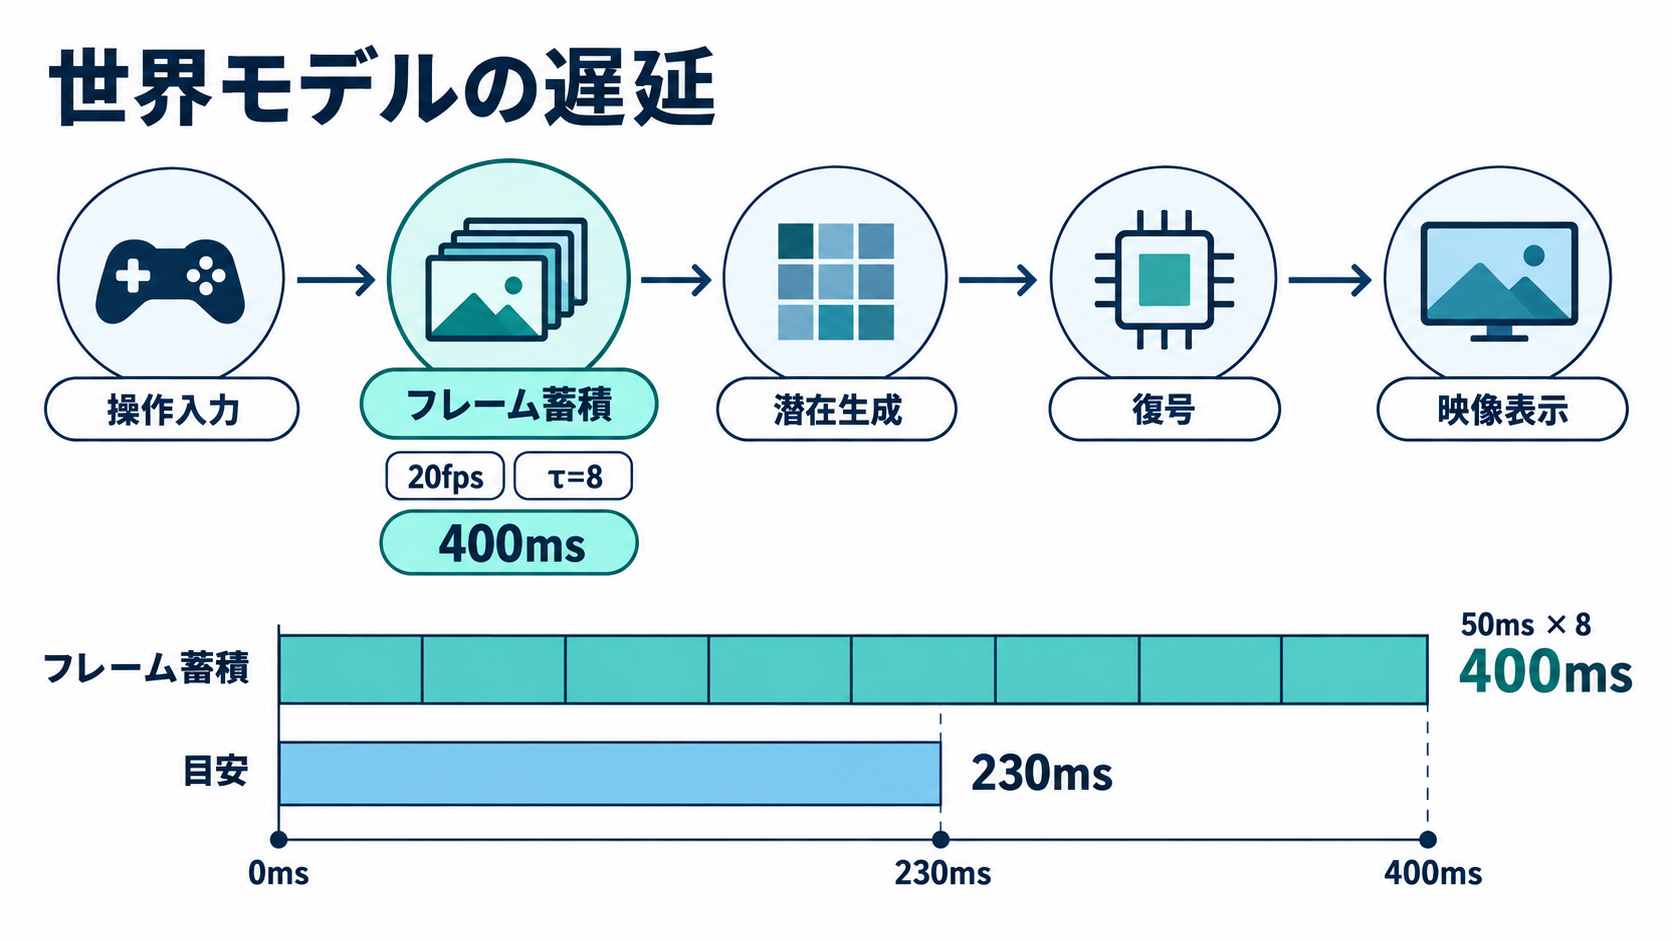
CADREでは圧縮率を「τ×s×s」で表します。τは一つの潜在表現にまとめるフレーム数、sは縦横方向の空間圧縮率です。遅延には、おおむね「τ÷フレームレート」に相当する時間に、潜在表現の生成と復号の処理時間が加わります。たとえば20fpsで8フレームをまとめれば、それだけで400ミリ秒分の映像を待つ計算です。研究では、自分の操作に約230ミリ秒を超える遅れがあると、人が違和感を覚えやすいという目安を置いています。
Kyutaiは、CADREを使った世界モデルがNVIDIA H100 GPU 1基で毎秒20フレーム級を処理し、230ミリ秒以内に反応できると報告しています。ここで中心となる論点は、最高画質を競うことではありません。圧縮による計算量の削減、動きの再現、操作追従性という三つの要素を、リアルタイムに近い応答時間の中でどう両立させるかです。
DINOv3と拡散デコーダーを組み合わせた内部構造
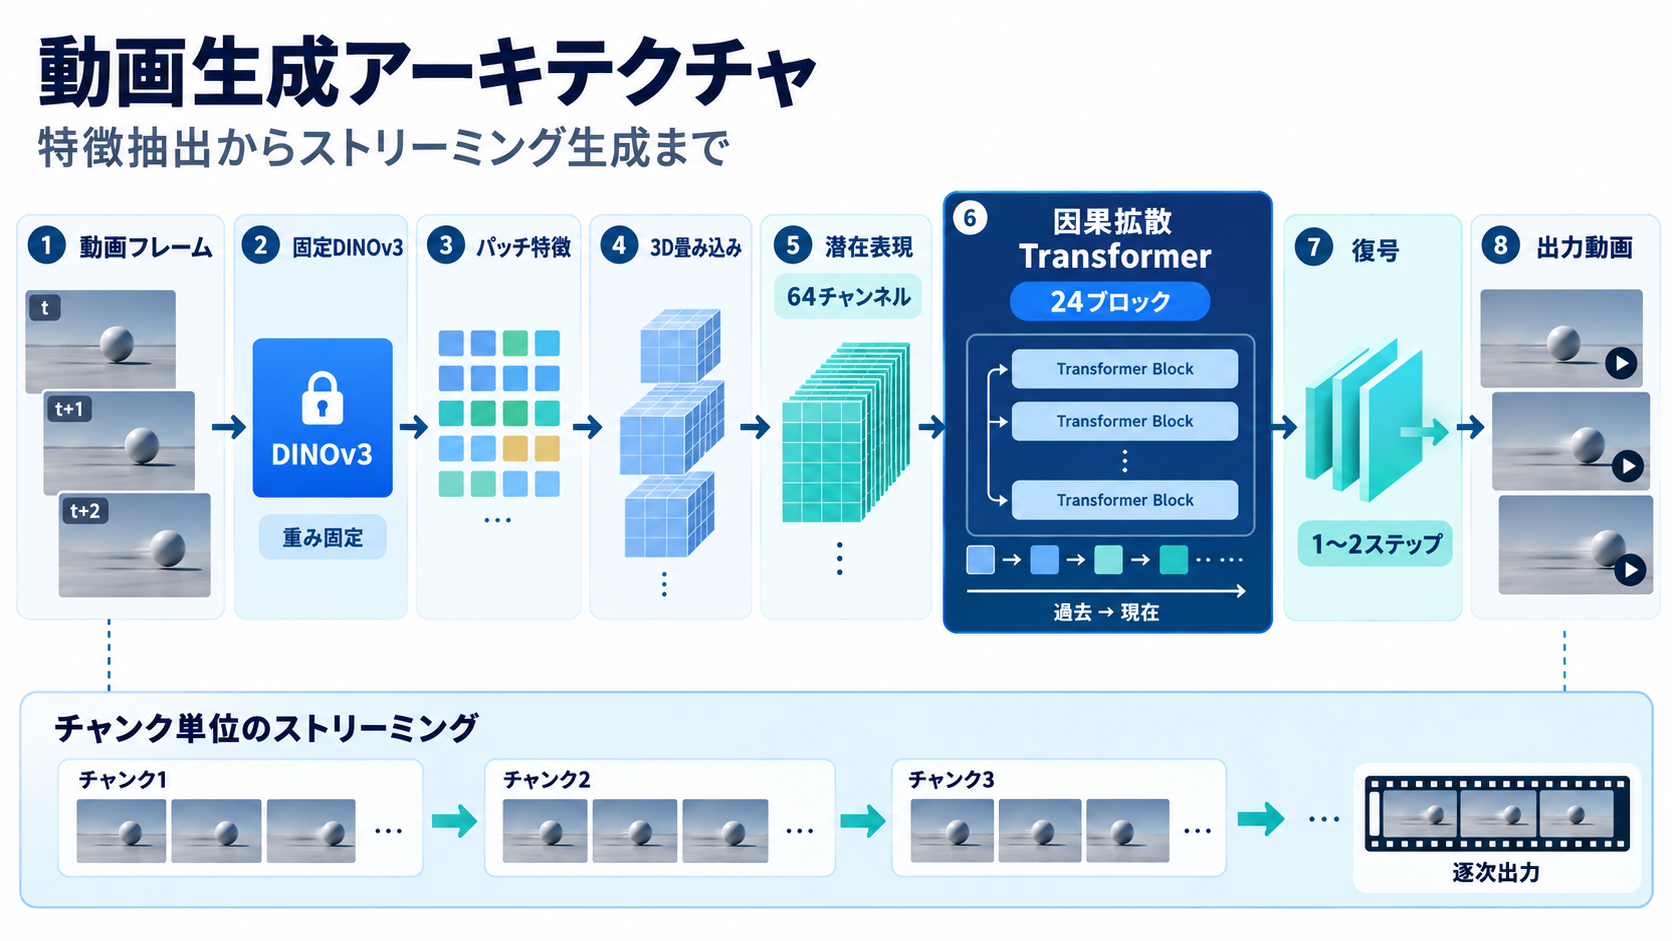
CADREは、圧縮率の異なる7種類の動画オートエンコーダーで構成されています。それぞれの学習対象パラメーターは約4億7,600万で、加えてMetaが開発した自己教師あり画像モデル「DINOv3」のViT-B/16、約8,600万パラメーターを固定した状態で利用します。世界モデル本体は12億パラメーターで、評価時の映像解像度は288×512ピクセルです。エンコーダーは、DINOv3を使って各フレームの小領域ごとに特徴を取り出します。その特徴を学習可能な一つの3次元畳み込み層へ渡し、64チャンネルの潜在表現に圧縮する構造です。7モデルの主な違いはこのボトルネック部分にあり、それ以外の条件をそろえることで、時間方向と空間方向の圧縮率が結果へ与える影響を比較しやすくしています。
復号側には、24ブロックからなる因果的な拡散Transformerを採用しています。「因果的」とは、未来のフレームを参照せず、すでに得られた情報を使って順次処理できる性質です。動画全体の完成を待たず、チャンク単位でストリーミング生成できるため、操作を受けながら映像を更新する用途と相性がよい設計になっています。
通常の拡散モデルは、ノイズから映像を復元するために複数回の反復計算を必要とします。CADREはプログレッシブ自己蒸留によって、復号を1回または2回のステップへ短縮しました。学習は敵対的損失を使わず、単一の学習段階で行われています。学習データは、ウェブ動画、ロボット操作、走行映像、ゲーム映像を含む23の公開動画ソースで、合計約7万6,000時間です。多様な映像を扱いながらも、設計の焦点はあくまで低遅延の潜在表現と高速な復号に置かれています。
1基のH100で確認された速度と生成品質
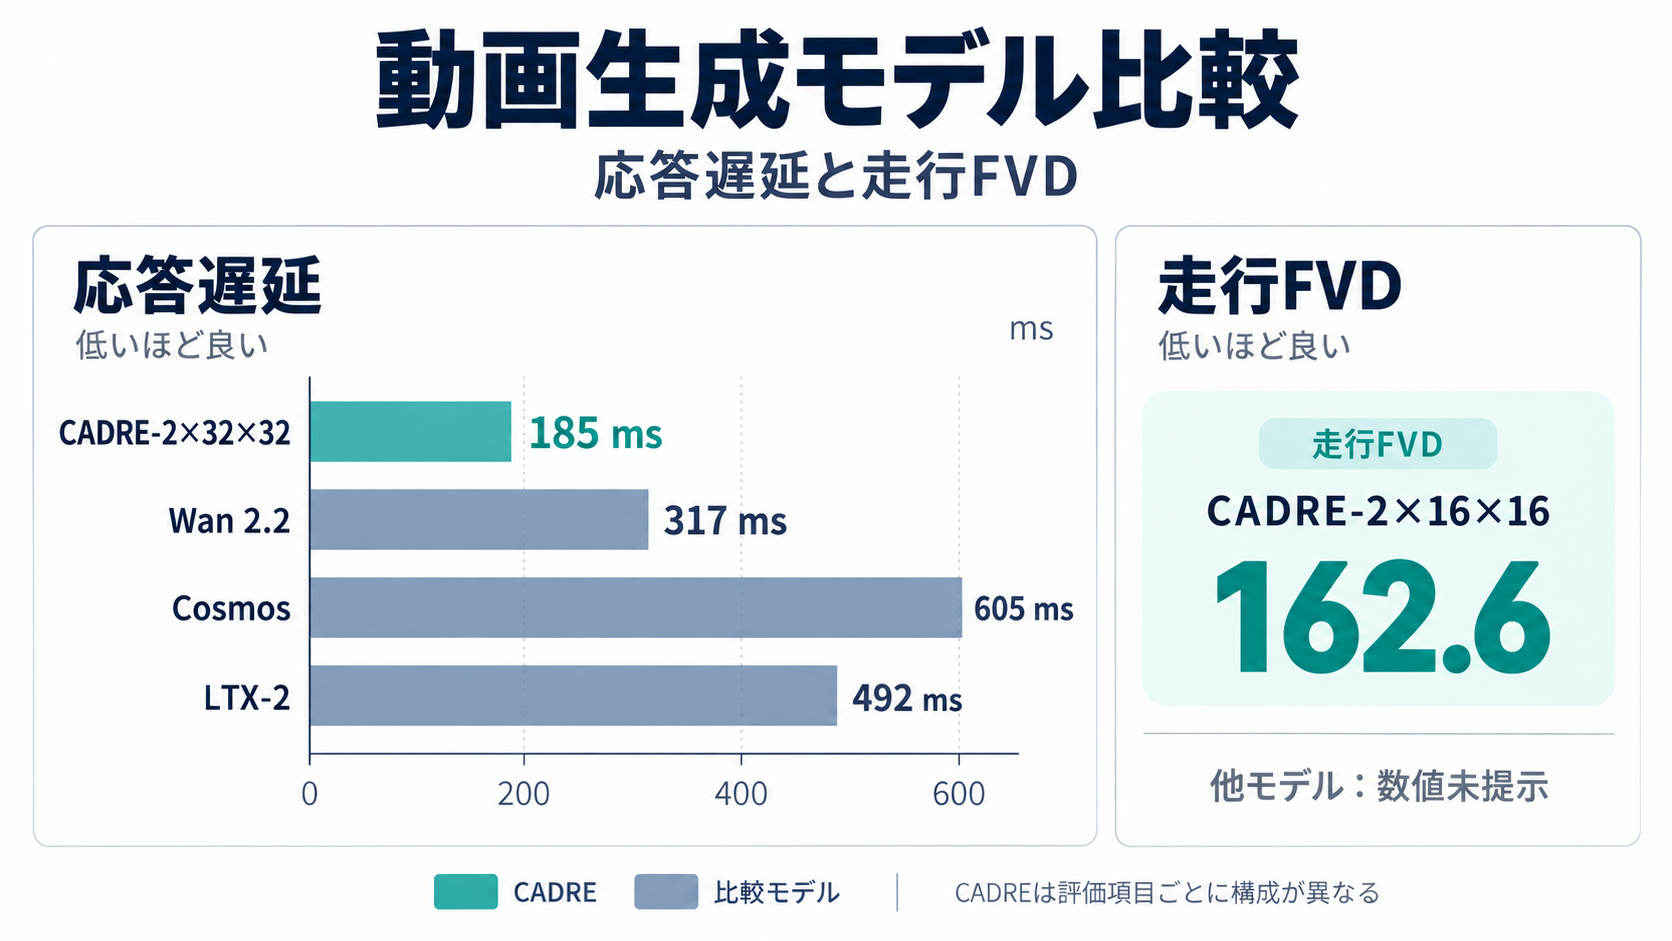
Kyutaiは各オートエンコーダーに対して、同じ構成の12億パラメーターの因果拡散Transformerを学習させました。比較対象となった環境は、ロボット操作のABC、一人称視点による人の操作を扱うEgoDex、自動運転向けのPhysicalAI AV、屋内映像のRealEstate10Kです。各モデルには最初の2秒間の実映像を与え、その後の4.8秒を生成させています。代表的なCADRE-2×32×32は、bf16、バッチサイズ1、復号1ステップという条件で、H100 1基あたり23.4fpsを維持しながら185ミリ秒で反応しました。同じ測定では、Wan 2.2が317ミリ秒、LTX-2が492ミリ秒、NVIDIAのCosmosが605ミリ秒です。DC-AEは118ミリ秒とCADREより高速でしたが、時間方向をまとめず、フレーム単位で処理する方式でした。なお、最大fpsだけを見るとWan 2.2やCosmos、LTX-2がCADREを上回る場合もあります。連続処理能力と、入力した操作が映像へ現れるまでの時間は、同じ指標ではありません。
映像の時間的な品質を測るFVDでは、低いほど良好とされます。走行映像でCADRE-2×16×16は162.6を記録し、Wan 2.2の599.7、Cosmosの452.5、LTX-2の913.3を下回りました。CADRE-2×32×32も171.3で、圧縮率を高めた構成としては良好な結果です。既存のMIRA方式による知覚回帰デコーダーと比べると、1ステップの拡散デコーダーはFVDを約1.4分の1から2.5分の1へ低減しました。
評価には静止画品質を見るFID、動画全体の動きや連続性を見るFVD、操作への追従度を測るARRが使われています。ARRは、映像から操作を推定する固定済みの逆動力学モデルによる指標で、1なら実映像と同等の追従性です。CADREは48件の比較のうち42件で、MIRA、Wan 2.2、Cosmos、LTX-2と同等以上の速度を保ちながら、より良い品質を示したとされています。ただし、これらはすべてKyutaiによる自己評価値であり、導入判断には第三者環境での再検証が欠かせません。
圧縮率の数字だけでは見えない四つの設計知見
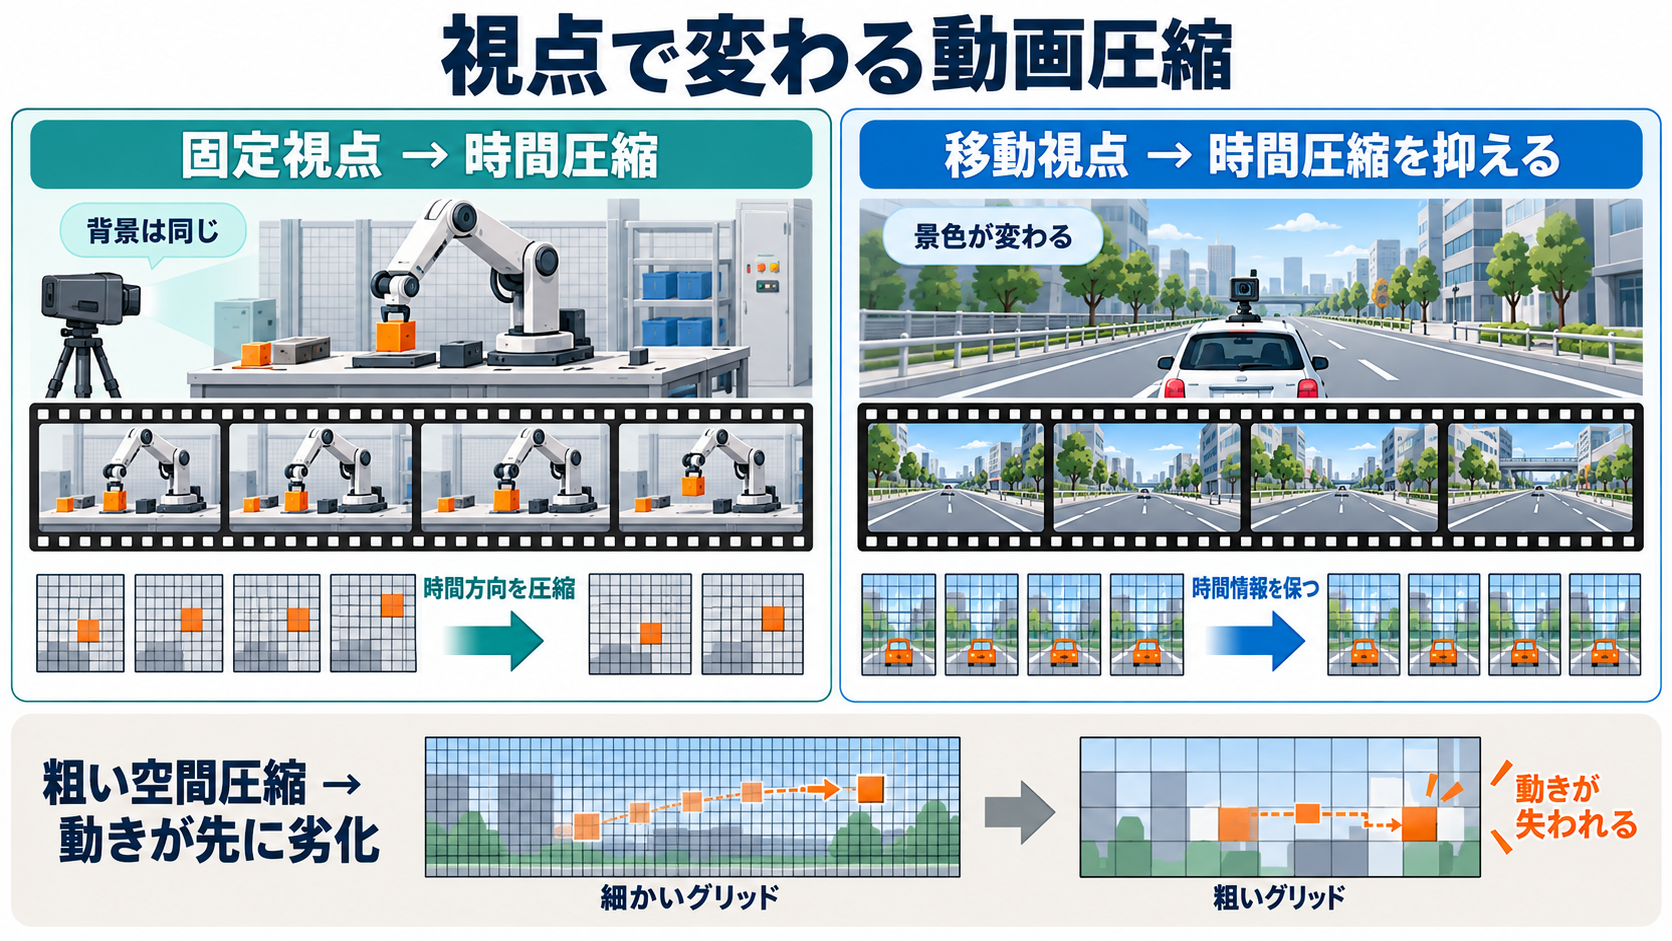
CADREの比較から読み取れるのは、単純に潜在トークンを減らせば速くなるわけではないという点です。どの方向へ圧縮するかによって、映像の鮮明さ、動きの整合性、操作への追従が異なる形で損なわれます。Kyutaiはボトルネック以外をそろえた7モデルを比較し、設計上の違いを四つに整理しています。一つ目は、強く圧縮した映像の復号には、知覚回帰より拡散方式が向いていることです。回帰型デコーダーは複数のあり得る映像を平均化しやすく、細部がぼやける傾向があります。拡散デコーダーは一つのもっともらしい映像をサンプリングするため、1ステップでも輪郭を保ちやすい結果になりました。
二つ目は、時間方向の圧縮を世界モデル内部のパッチ化に任せるより、オートエンコーダー側で担わせたほうが細部を残しやすいという知見です。8フレームを扱う条件では、世界モデル内でパッチ化した構成のARRが0.72から0.56へ低下しました。計算量が同程度でも、どの段階で情報をまとめるかによって操作追従性が変わります。
三つ目は、カメラの動きが適切な圧縮方法を左右することです。固定カメラの映像は背景の変化が少ないため、時間方向に複数フレームをまとめやすくなります。走行や屋内移動のように視点そのものが動く映像では、時間圧縮を抑え、空間方向を粗くする構成のほうが有利でした。
四つ目は、空間トークンを粗くした際、静止画の見た目より先に動きの品質が悪化することです。ロボット操作では、空間圧縮率を16倍から32倍にするとFVDが約2.4倍になった一方、FIDの変化は小幅でした。一枚のフレームだけを確認して「十分きれい」と判断しても、指や物体の軌跡、接触の瞬間といった時間的な情報が失われている可能性があります。
ベンチマーク上の弱点と評価指標の読み方
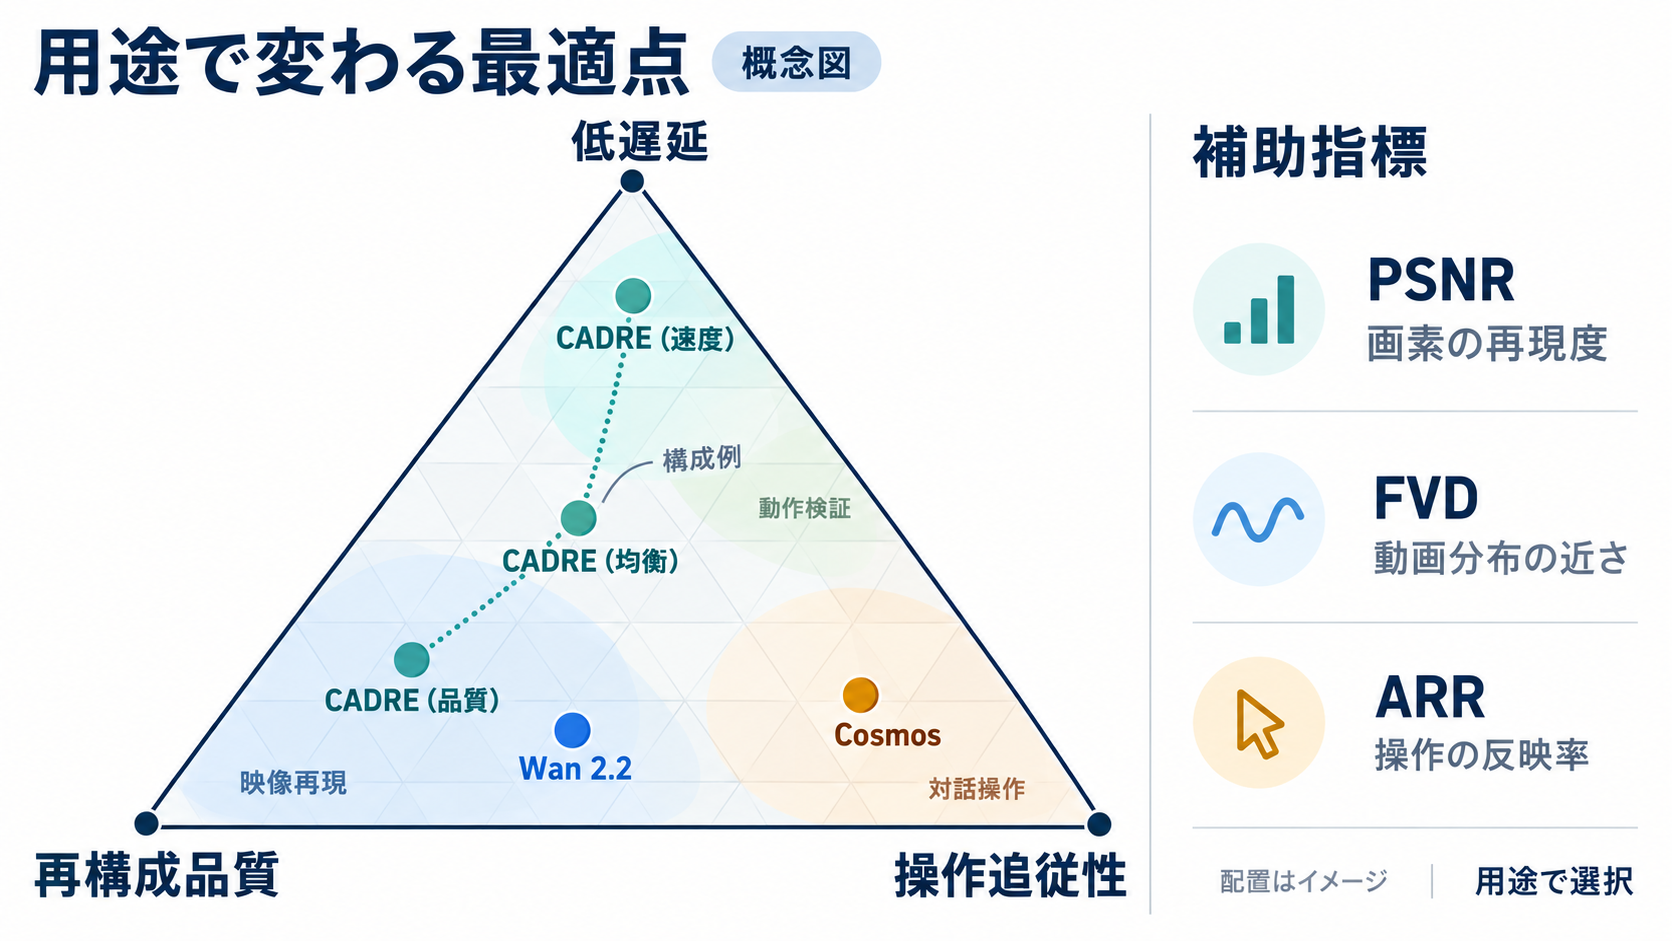
CADREはすべての条件で最良だったわけではありません。ロボット操作のFVDでは、Cosmosが39.5、CADREの最良構成であるCADRE-2×16×16が47.6、Wan 2.2が52.9でした。操作追従を示すARRでも、CADRE-2×32×32は0.45にとどまり、Wan 2.2の0.85やCosmosの0.78を下回っています。高い空間圧縮率によって得られる速度と引き換えに、精密な操作情報が失われる場面があると見たほうがよいでしょう。入力映像をどれだけ忠実に復元できるかを示すPSNRでも差があります。OpenVid-HDによる再構成評価では、CADRE-2×32×32が22.86dB、CADRE-2×16×16が25.12dBだったのに対し、Wan 2.2は35.02dBでした。Kyutaiは、再構成品質の高さが、世界モデルによる将来映像の生成品質をそのまま予測するわけではないと説明しています。実際、Wan 2.2は屋内環境のロールアウトFVDでは最下位でした。
ここでは「元映像の復元」と「操作後の未来を生成すること」を分けて考える必要があります。PSNRは画素単位の忠実さを測るのに向きますが、もっともらしい動きや操作との因果関係を直接評価する指標ではありません。FVDも映像全体の品質を見る指標であり、特定の操作が正確に反映されたかはARRなどと併せて確認しなければなりません。
時間方向に長い潜在表現を使う構成では、チャンクの境界に継ぎ目が見える問題も報告されています。τが8の構成では、環境をまたいで境界部分の誤差が1.6〜1.8まで増えました。また、評価された世界モデルは環境ごとに個別に学習され、解像度も288×512に限定されています。複数の環境や多様な操作を一つのモデルで扱う汎用世界モデルでも同じ傾向が成立するかは、現時点では確認されていません。
オープン公開でも商用利用には残るライセンス条件
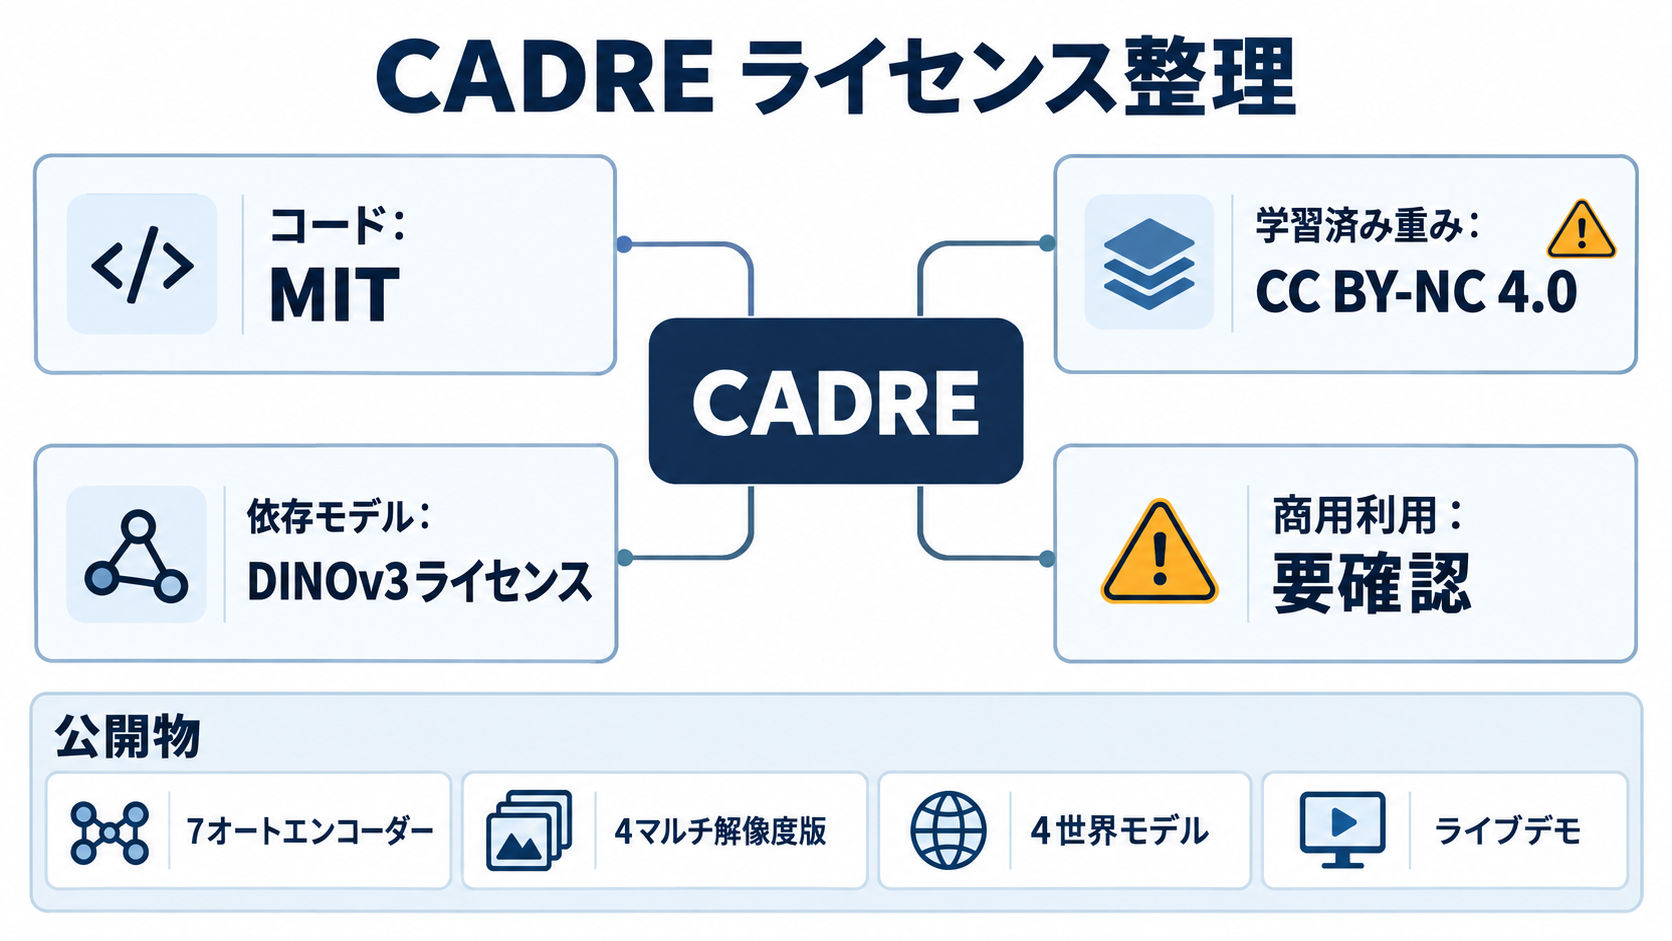
CADREの実装コードはMITライセンスで公開されていますが、学習済み重みはCC BY-NC 4.0です。「NC」は非営利を意味するため、企業がそのまま商用サービスや有償製品へ組み込める条件ではありません。DINOv3にも別のライセンス条件が適用されます。コードが広く利用できることと、公開済みモデルを商用利用できることは区別して確認する必要があります。公開範囲には7種類のオートエンコーダー、より長く学習された4種類のマルチ解像度版、CADRE-2×16×16を使う4種類の世界モデルが含まれます。キーボード操作で挙動を試せるライブデモも用意されており、低遅延生成がどのような体験になるかを確認できます。研究・検証用途であれば、圧縮率だけを変えたモデル群は、用途ごとのトレードオフを調べるための比較材料になるでしょう。
企業の技術検証では、公開重みを直ちに製品候補とみなすより、設計手法を評価するための研究資産として扱うのが現実的です。たとえば、自社データに必要な時間解像度と空間解像度を見極める実験や、回帰型デコーダーと少ステップ拡散デコーダーの比較に利用できます。商用展開を検討する段階では、重み、コード、依存モデル、学習データという層ごとに権利関係を整理しなければなりません。
量子化モデルについては詳細が明らかにされていません。公表された速度はH100、bf16、バッチサイズ1という条件に基づくため、異なるGPUや推論基盤で同じ応答時間が得られるとは限らない点にも注意が必要です。低遅延という見出しだけで判断せず、対象ハードウェア、入力解像度、復号ステップ数、利用可能なライセンスを一組の条件として確認することが求められます。
日本企業が検証時に置くべき三つの評価軸
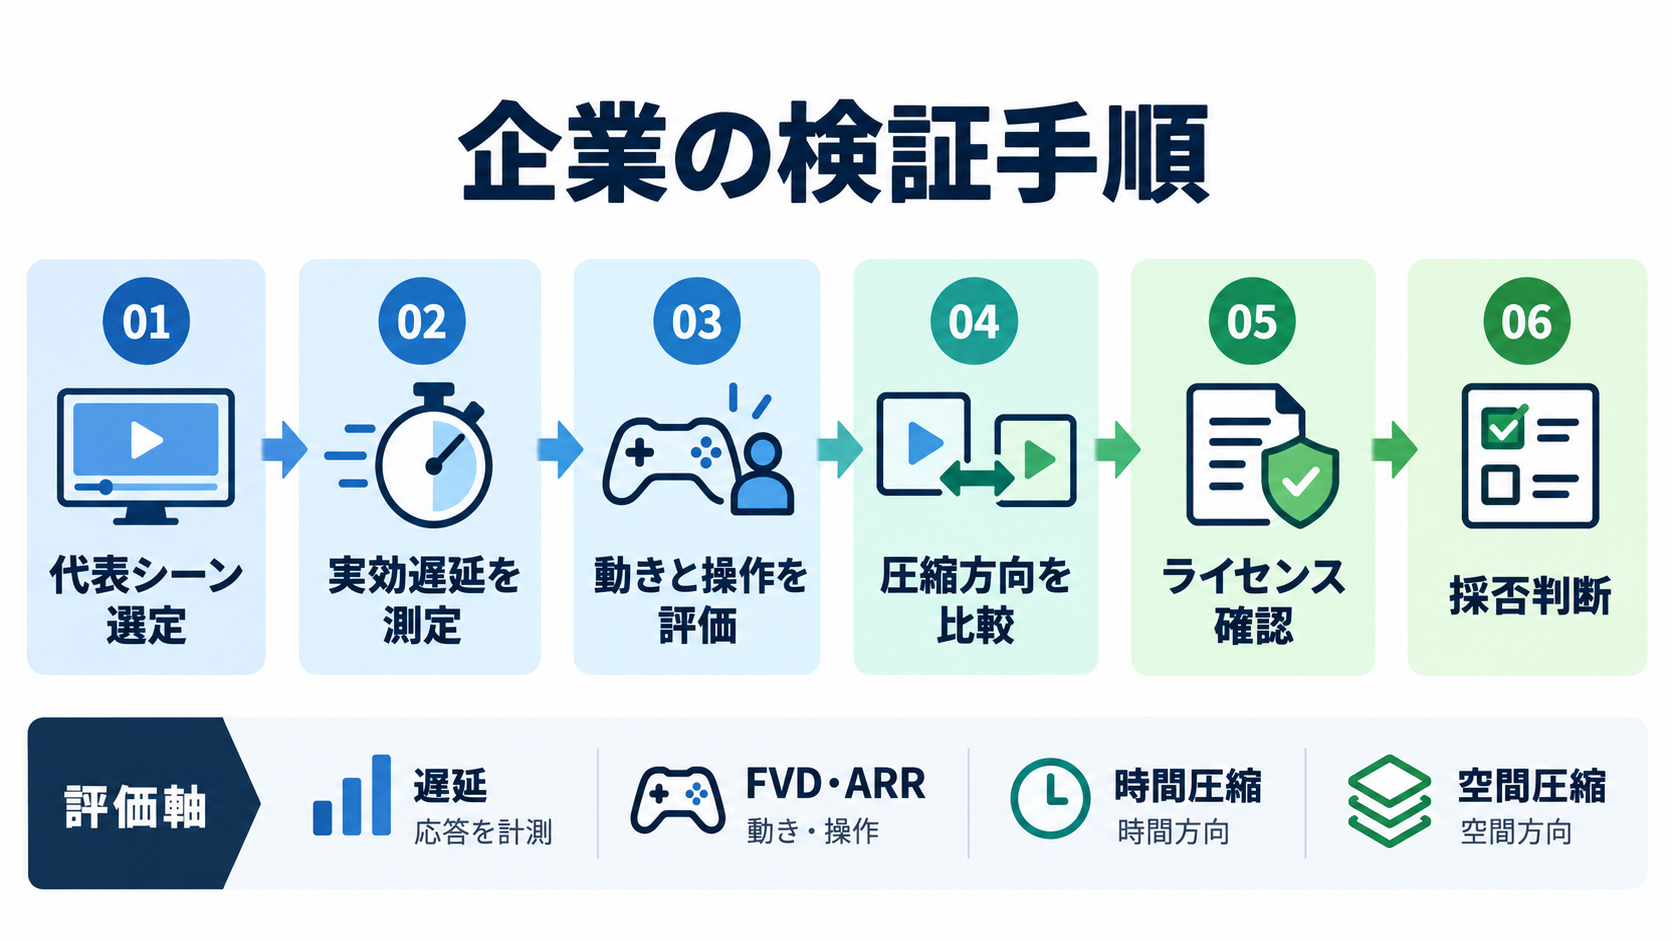
日本企業がCADREの知見を取り入れるなら、モデルの総合順位を決めるより、自社の操作環境に合う圧縮方法を探すことが出発点になります。遠隔操作、シミュレーション、ゲーム、運転支援の検証では、必要な映像品質も、許容できる反応時間も同じではありません。固定カメラで対象物を追う用途と、視点が絶えず移動する用途を一つの設定で評価すると、圧縮方式の長所を見誤るおそれがあります。評価軸の一つ目は、操作入力から生成映像が返るまでの実効遅延です。最大fpsが高くても、複数フレームがたまるまで処理を開始できなければ、利用者が感じる応答性は改善しません。CADREが示した「τ÷フレームレート」という考え方を使い、エンコード、世界モデルによる生成、復号を含む一連の時間を測る必要があります。
二つ目は、用途に即した動きの正確さです。画素の再構成指標だけでは、ロボットの把持、車両の旋回、人物の手元といった因果的な変化を十分に判断できません。FIDやPSNRに加え、FVDやARRのような時間的・操作的な評価を組み合わせ、自社で失ってはいけない動きを具体的なテスト場面へ落とし込むべきでしょう。
三つ目は、圧縮の方向です。固定カメラ中心なら時間方向の圧縮を試す余地がありますが、移動カメラでは少ないフレーム数をまとめ、空間方向の圧縮とのバランスを探るほうが有望です。CADRE-2×32×32とCADRE-2×16×16の差が示す通り、高速な構成と高品質な構成は必ずしも一致しません。
検証の最初の一歩としては、実運用を代表する短い映像と操作列を用意し、遅延、FVD相当の動画品質、操作成功率を同時に記録する方法が考えられます。そこで初めて、230ミリ秒という目安が自社の利用者にとって十分か、画質との交換条件を受け入れられるかを判断できます。CADREの価値は単独のスコアよりも、世界モデルのオートエンコーダーを「圧縮部品」ではなく「応答性を決める設計要素」として捉え直した点にあります。