

2026/11/11
AIニュース
PAN 2公開、行動計画を動画で検証する世界モデル──全手順の完遂率34%をどう読むか
この記事の要点
MBZUAIのIFMが、行動の結果を動画で予測する290億パラメータの世界モデルPAN 2を公開しました。IFMの評価では複数手順の計画完遂率が34.0%で比較対象を上回りましたが、失敗も多く残ります。企業での検証では、評価条件、GPU負荷、指示を整理するLLM、安全対策を含めて確認する必要があります。
目次
行動する前に結果を試す、PAN 2の狙い
ロボットに複数の作業を任せるとき、一つの動作ができることと、最後まで手順を守れることには隔たりがあります。途中で対象物の位置や周囲の状況が変われば、続く動作にも影響するためです。実行前に計画の結果を試せるなら、候補を比較する材料が増えるでしょう。アラブ首長国連邦のAI専門大学、MBZUAIの基盤モデル研究組織Institute of Foundation Models(IFM)が公開したPAN 2は、この用途を目指す世界モデルです。
世界モデルとは、観測した状況と行動をもとに、その後の環境の変化を予測するモデルを指します。PAN 2は場面とテキストによる行動指示を受け取り、結果を動画として生成します。IFMは2026年11月10日にXで発表しました。2025年11月に公開したPANの後継に当たり、モデルの重み、学習コード、推論コードをApache 2.0ライセンスで提供しています。
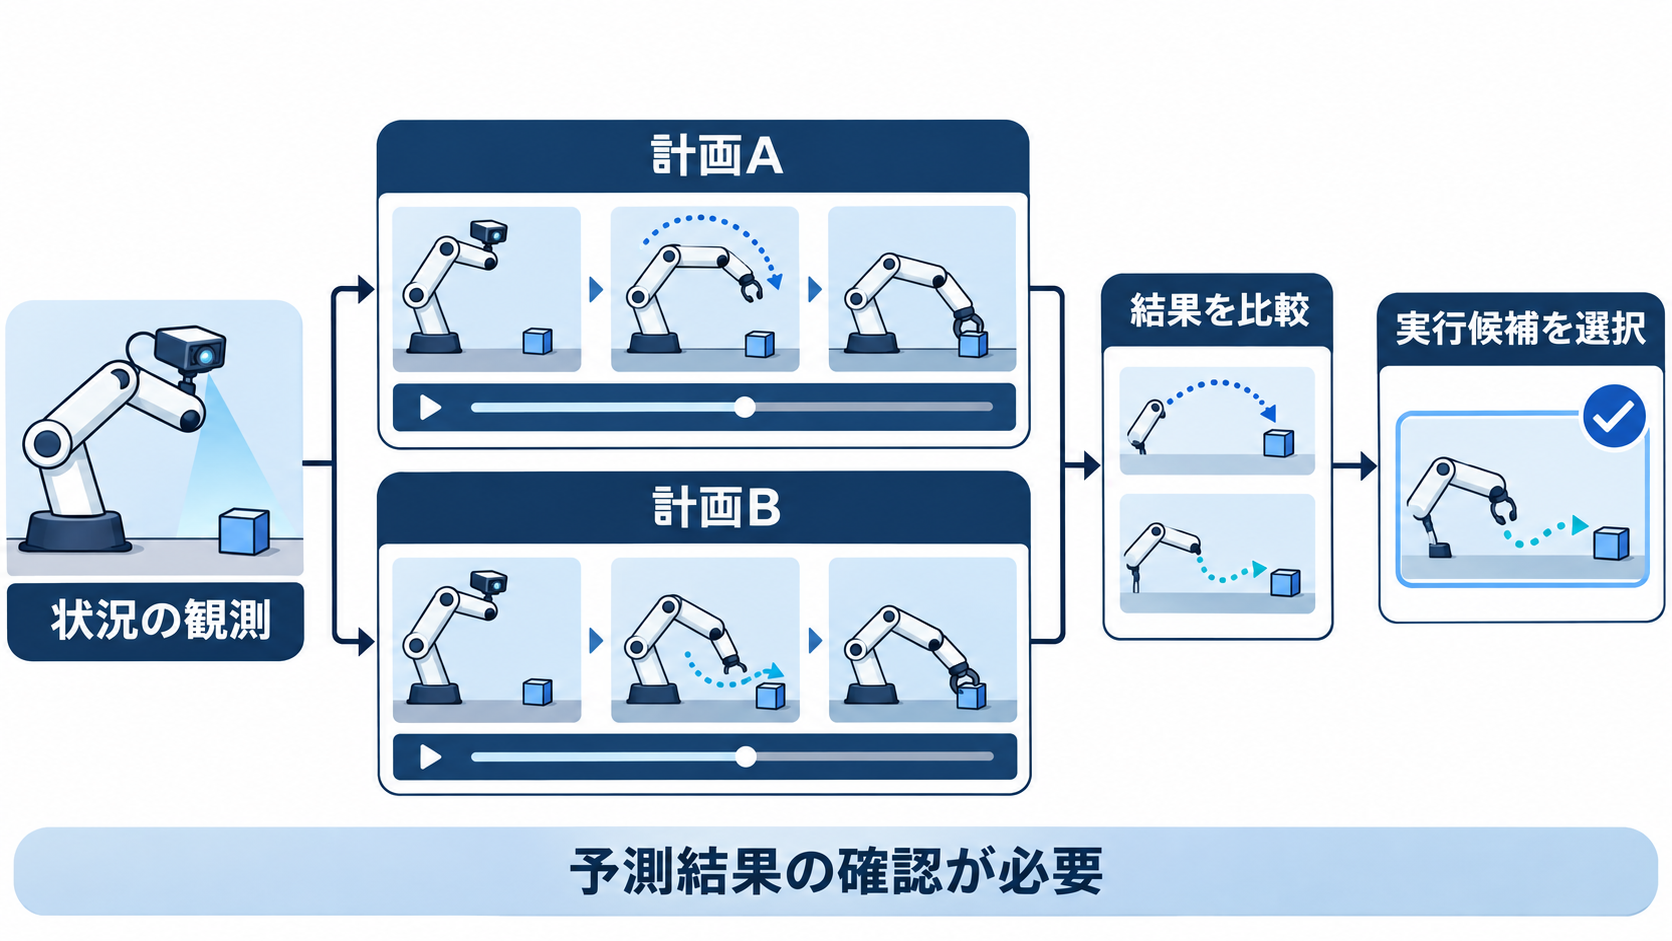
想定する使い方は、AIエージェントが計画を提案し、PAN 2がそれぞれの結果をシミュレーションし、その結果を踏まえて実行する計画を選ぶというものです。ここでいうエージェントは、目的に沿って行動を選ぶAIシステムを意味します。動画生成を、見せるためのコンテンツ制作に加えて、行動を検討するための道具として扱う発想です。
ただし、生成された映像が自然に見えることと、現実の結果を正しく予測できることは同じではありません。企業が注目すべき中心的な論点もここにあります。PAN 2は複数手順の評価で比較対象を上回りましたが、計画全体の完遂率は34.0%でした。実行判断への利用を考えるには、この成果と失敗の多さを一緒に捉える必要があります。
計画を整理するLLMと、映像を作るモデルの分業
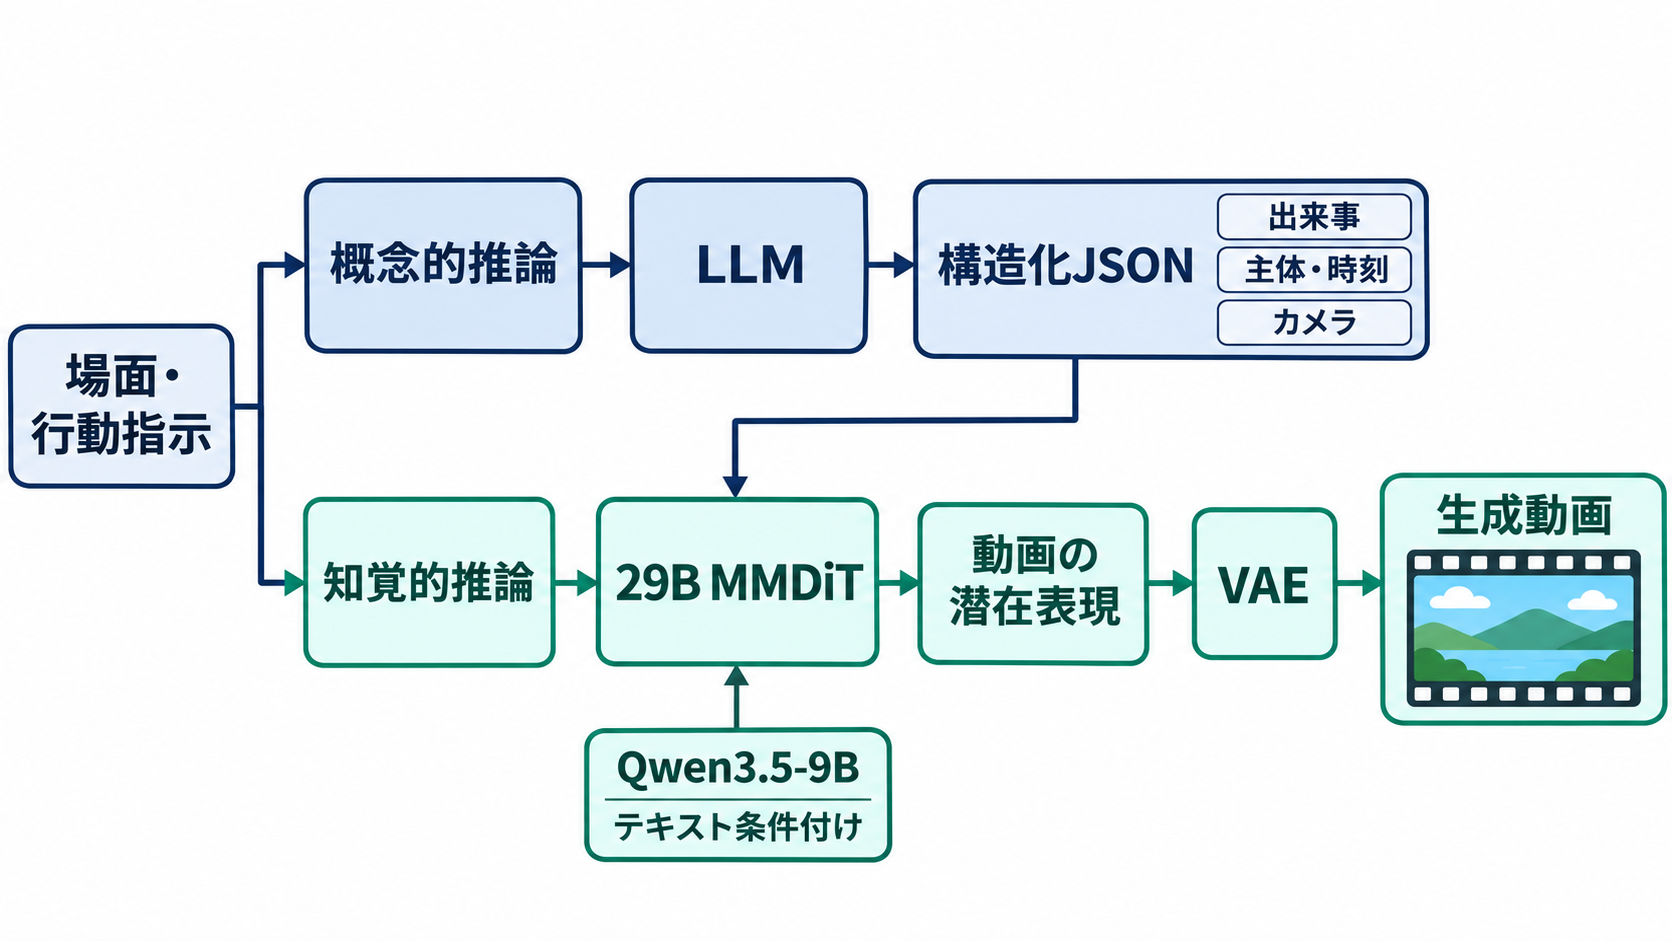
PAN 2の特徴は、行動の意味を整理する処理と、それを映像として表現する処理を分けている点です。IFMはこの構成をGenerative Latent Prediction(GLP)と呼んでいます。入力した指示をそのまま動画生成へ渡すだけでなく、途中に状況や行動を構造化する段階を設けています。
「概念的推論」を担うのは、大規模言語モデルであるLLMです。観測した状況と要求された行動を読み、次の世界の状態を構造化データのJSONとして記述します。内容には、起きる出来事、実行主体と結び付いた時間指定の行動、カメラの動きが含まれます。指示に従えるLLMであればこの役割を担え、IFMの報告ではKimi K3を標準として使用しています。
「知覚的推論」では、290億パラメータの拡散TransformerであるMMDiTが、動画の潜在表現を予測します。潜在表現は、映像を生成処理に適した形へ圧縮した内部表現です。IFMは注釈付きの数億本の動画を使い、このモデルをゼロから学習しました。テキストの条件付けには重みを固定したQwen3.5-9Bのエンコーダーを使い、最終的な映像フレームへの変換にはWan 2.2のVAEデコーダーを使用します。
この分業の意味は、構成要素を外した比較実験に表れています。概念的推論を使わない場合、計画全体の完遂率は34.0%から0.0%へ、手順単位の完了率は75.1%から8.7%へ下がりました。形式だけを書き換える処理では、計画全体の完遂率が27.8%まで戻っています。IFMの実験条件では、生成器の規模だけでなく、指示をどう整理して渡すかも結果に影響したと読み取れます。導入時には動画生成モデルと前段のLLMを、一つの処理系として評価する必要があるでしょう。
全計画の完遂率34%が示す成果と限界
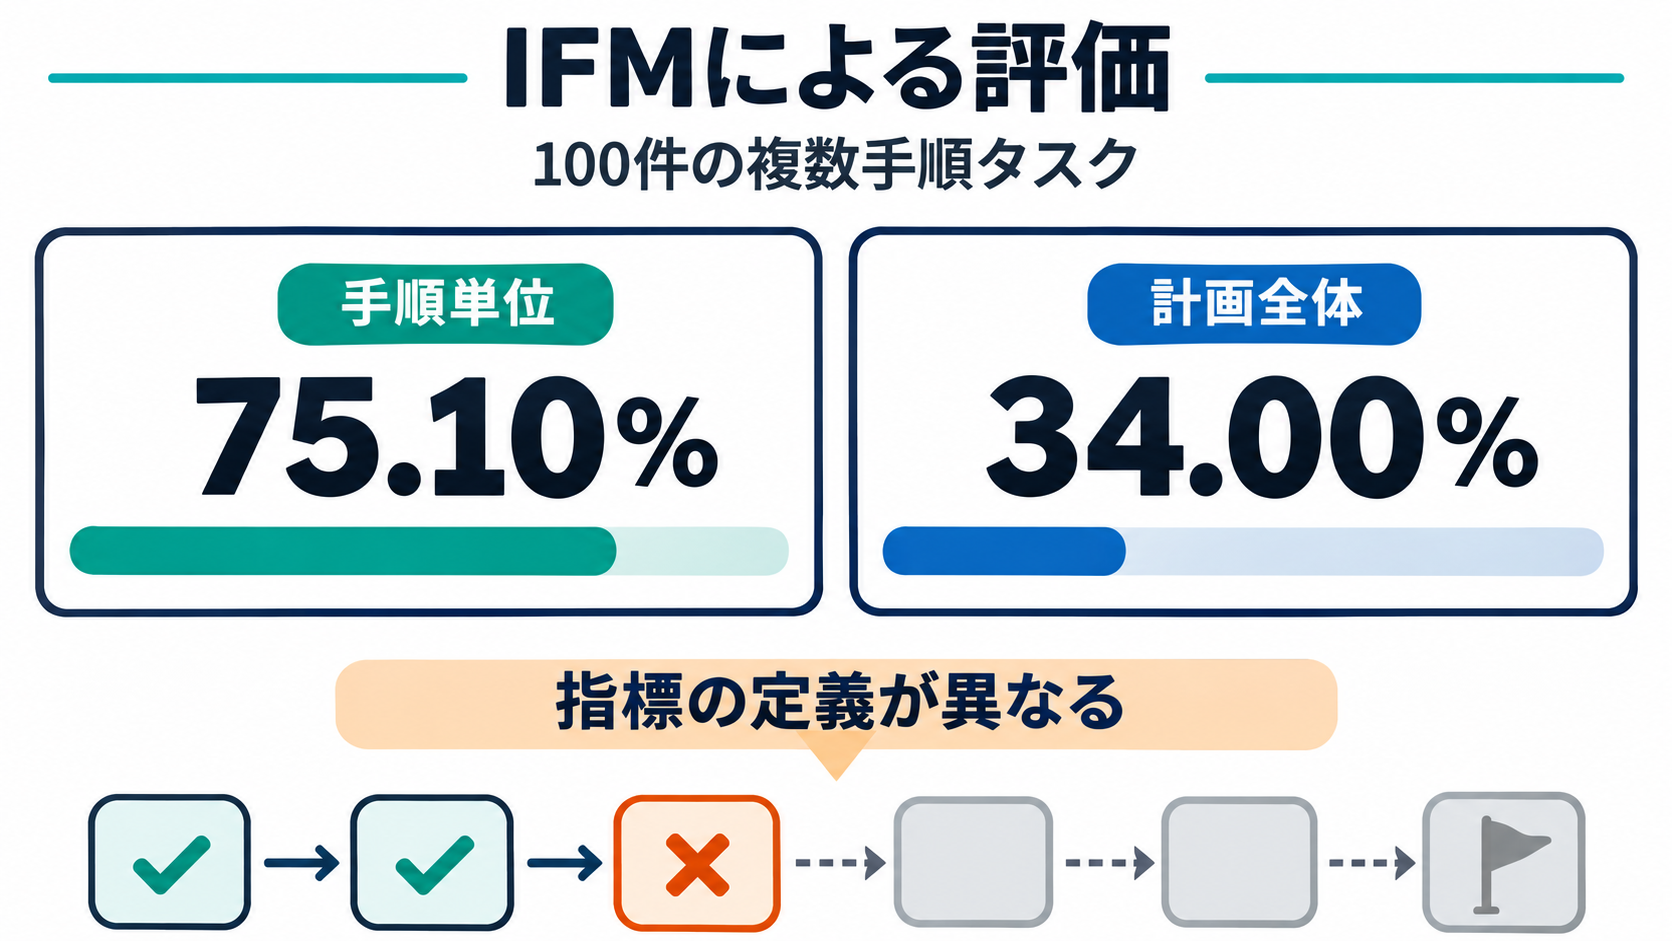
IFMの評価でPAN 2が強みを示したのは、複数の手順を含む計画を最後まで完了する能力です。100件の複数手順タスクを使った評価では、計画全体の完遂率が34.00%となり、比較した6モデルの中で最も高い結果でした。MiniMax-H3は32.50%、FLUX 3は26.77%、Seedance 2.5は24.49%と報告されています。これらはすべてIFMによる自己申告の評価値です。
手順単位では、PAN 2の完了率は75.10%で、MiniMax-H3の75.12%とほぼ同じでした。この数字だけを見ると多くの動作をこなせる印象を受けますが、計画全体では約3分の2が少なくとも一つの手順を完了できていません。個々の手順の成功と、一連の作業の成功を分けて確認する必要がある理由です。
複数手順の作業では、一つの失敗が後続の手順を成立させなくする場合があります。例えば、対象物を移動する段階で位置を取り違えれば、その後の操作が映像として自然でも、指定した計画を達成したことにはなりません。これは一般的な説明例ですが、業務評価で各動作の見栄えだけを確認しても十分でないことを示しています。順序、対象、最終状態まで含めた成功条件が欠かせません。
また、PAN 2とMiniMax-H3の計画全体の完遂率の差は1.5ポイントです。順位だけから、自社のタスクでも同じ優位性が続くとは判断できません。対象となる作業や指示の書き方が変われば、結果も変わり得ます。PAN 2の成果は、複数手順の検証に使う候補として試す理由になります。ただし、現実の作業を任せる際の信頼性まで、この数値だけで裏付けられるわけではありません。
評価条件をそろえないと、モデルの優劣は見えない
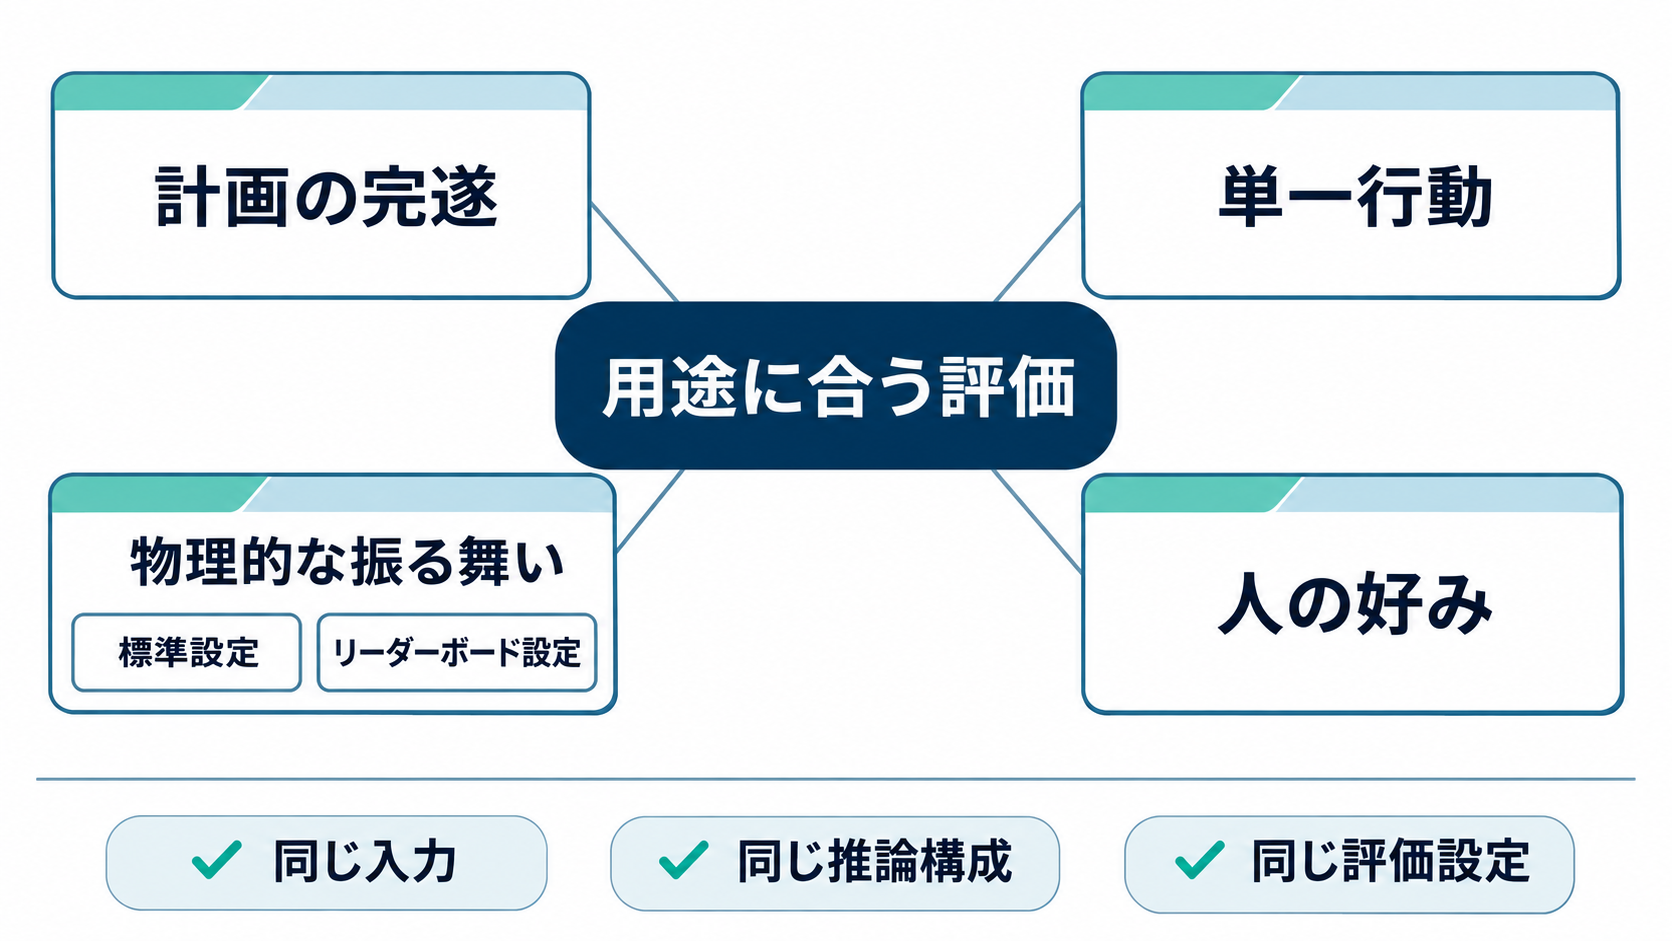
PAN 2は、すべての評価軸で首位になったわけではありません。IFMが300件の単一行動ケースで調べた6能力の総合値は84.48%で、MiniMax-H3の87.20%を下回りました。MiniMax-H3は6分類すべてで上回っています。複数手順の計画を完了する能力と、一つの行動を適切に表現する能力では、評価の結果が異なります。
物理的な振る舞いに関するPhysics-IQでも、設定の区別が必要です。PAN 2はVerifiedのリーダーボード設定で49.38を記録し、オープンモデルの中で首位と報告されています。同じ設定の非公開モデルFLUX 3は51.11でした。これに対し、システムの標準設定ではPAN 2が37.48、MiniMax-H3が42.91です。PAN 2の49.38と、別設定のMiniMax-H3の42.91を並べても、同じ条件の比較にはなりません。
RBenchでは、PAN 2が57.04、MiniMax-H3が56.16、Cosmos 3 Superが50.64でした。人による好みの評価をEloという相対的なレーティングで示した結果では、GPT-6 Astraを推論役に使ったPAN 2が1595、MiniMax-H3が1620です。前段のLLMが変わる場合には、動画生成モデルだけを比較しているとは限らない点にも注意が必要でしょう。
企業の選定では、順位を一つにまとめるより、用途に対応する評価軸を決める方が実務的です。作業手順の事前検討なら、指示の抜けや順序の誤りが問題になります。人に提示する映像なら、見た目の自然さや好みも判断材料になるでしょう。IFMの評価値は比較の出発点として使えますが、採用判断には同じ入力、同じ推論構成、同じ成功条件での検証が必要です。
公開コードを使えても、計算資源の見積もりは別問題
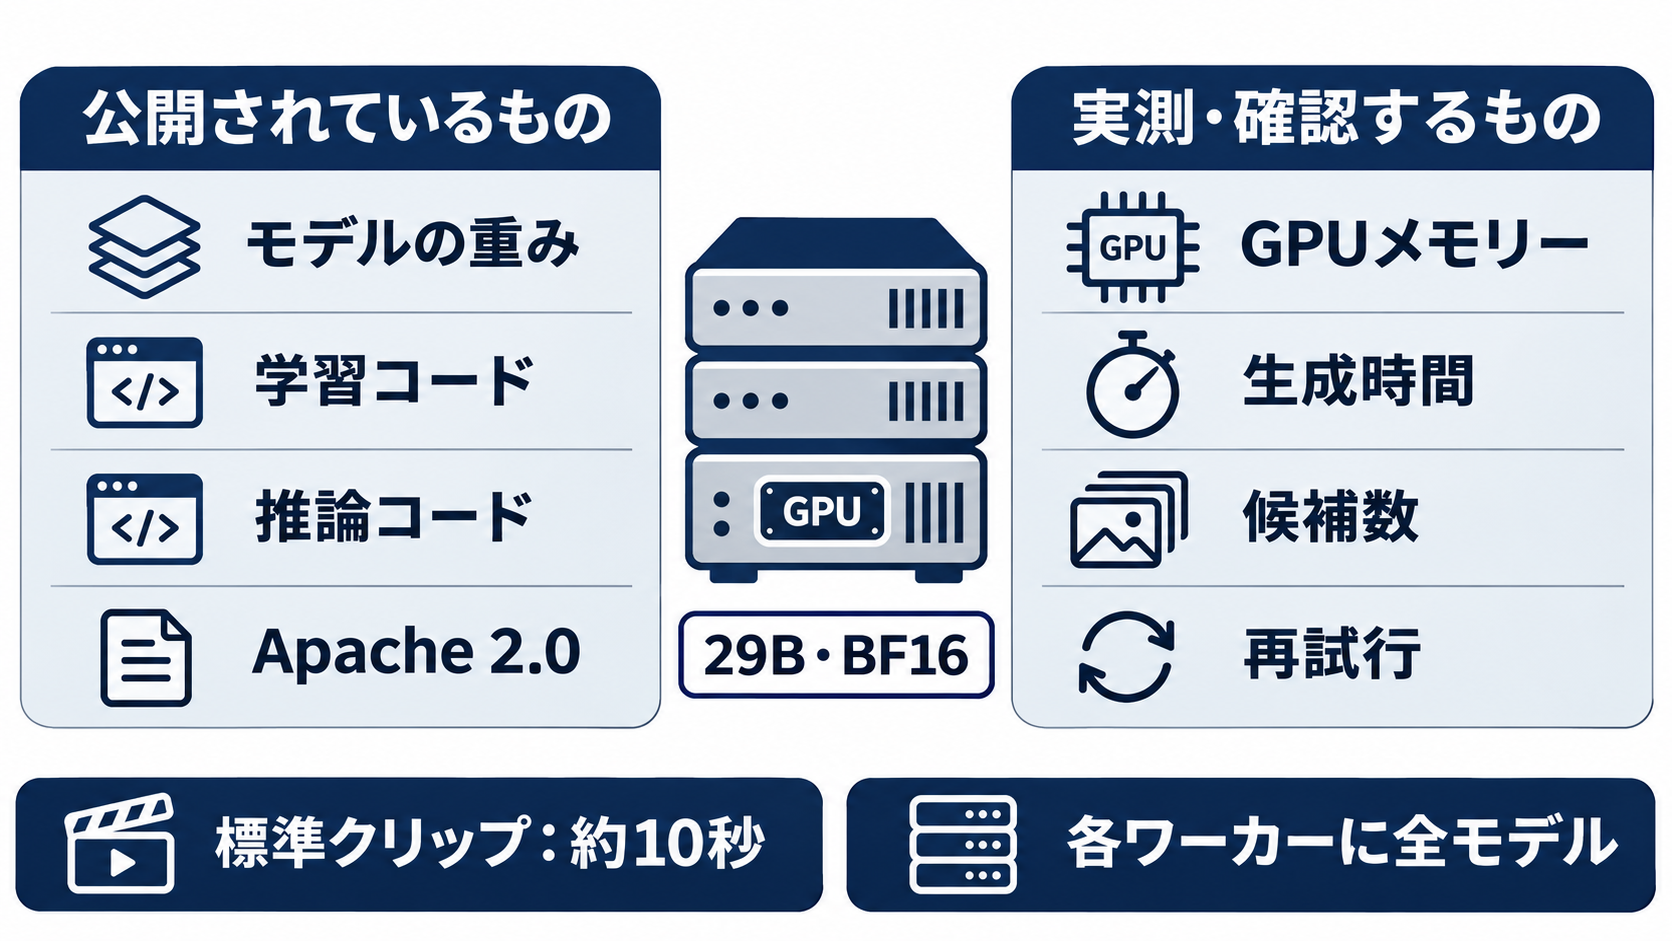
PAN 2はテキストからの動画生成と、画像を起点にした動画生成に対応しています。出力仕様は704×1248ピクセル、毎秒24フレーム、最大20秒です。Hugging Face Diffusers、vLLM、FastVideo、またはリポジトリのgenerate.pyから実行できるとされています。既存の生成AI基盤との接続方法を検討できる点は、開発部門にとって扱いやすい材料でしょう。
実行環境はデータセンター向けGPUを想定しています。各ワーカーは290億パラメータのモデル全体をBF16形式で読み込み、メモリーが厳しい場合には、モデルのブロックを必要に応じて移すオフロードが代替手段になります。BF16はモデルの重みや計算に使う数値形式です。IFMは必要なGPUメモリー容量と生成時間を公表しておらず、手元の設備で何本の動画を処理できるかは、仕様だけでは判断できません。
標準の生成設定は50ステップ、flow shiftが9、guidanceが2.5です。標準クリップは241フレームで、約10秒になります。これらは生成処理の条件を再現するための情報ですが、業務で必要な待ち時間や費用を直接示すものではありません。複数の計画を比較する構成では、候補ごとの動画生成が必要になるため、一本の処理時間が全体の応答時間にも関わります。
重みと学習・推論コードのApache 2.0での公開は、内部構造の確認や改変、自社環境での検証を進める足場になります。ただし、公開範囲の広さと運用費用の小ささは別の判断です。企業が試す際は、必要な映像の長さと計画候補数を決め、その条件でGPU使用量、待ち時間、再試行の頻度を測ると、導入後の負荷を具体化しやすくなります。
小さな検証で、指示の整理と安全対策まで確かめる
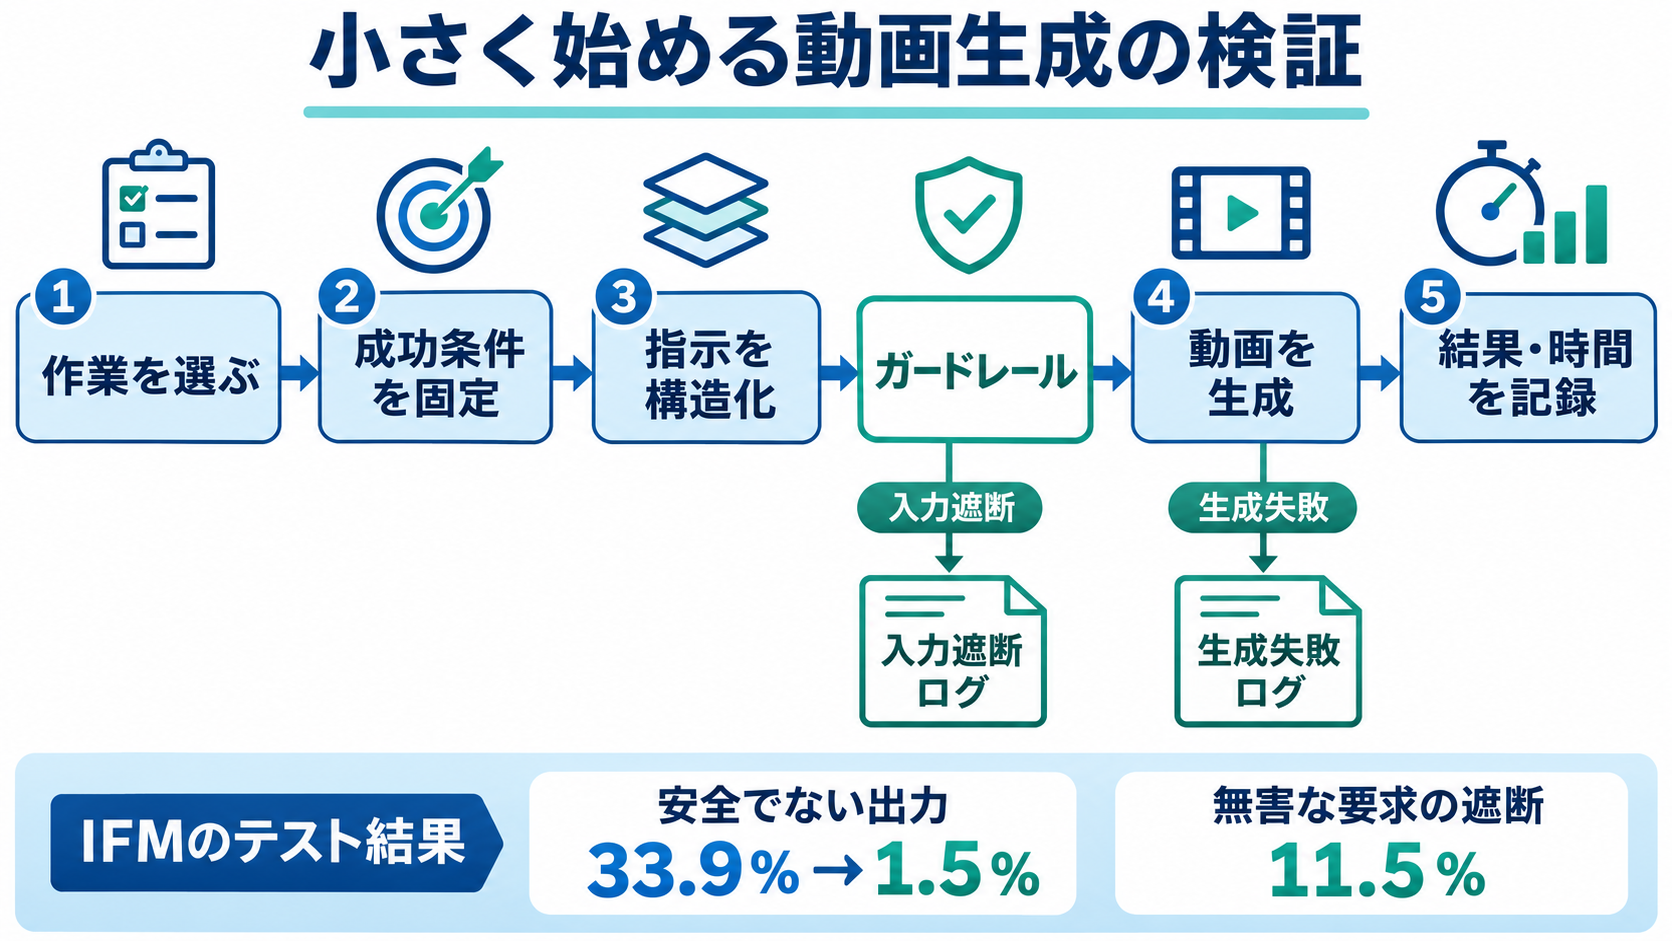
PAN 2を試す最初の対象には、成功と失敗を人が判定しやすい、範囲の狭い作業が適しています。複数の対象が登場する場合でも、何がどの順序で動き、最後にどの状態になるべきかを明確にする必要があります。生成動画を見てから成功条件を変えてしまうと、モデルが指示を満たしたのか、見栄えに納得しただけなのかが曖昧になってしまいます。
入力の作り方も検証対象です。IFMは構造化したキャプションが有効とし、自由文を書き換えるConceptual ReasonerスキルをClaude CodeとCodex向けに提供しています。キャプションの上限は1,536トークンです。トークンはモデルが文章を扱う際の単位で、日本語の文字数と同じではありません。情報を増やすだけでなく、実行主体、行動、順序を予算内で整理する工夫が求められます。
安全対策では、IFMが別提供のpan2-guardrailの利用を強く推奨しています。同組織のテストでは、有害なテキストから動画を生成する要求に対し、安全でない出力の割合が33.9%から1.5%へ低下しました。同時に、無害な要求の11.5%も遮断しています。安全性を高める効果と、正当な入力を止める影響の両方を、自社の用途で確認する必要があるでしょう。
検証結果には、計画全体の成功率に加えて、どの手順で失敗したか、指示の書き換えで結果がどう変わったかを残すと役立ちます。ガードレールによる遮断と動画生成の失敗も、改善する場所が異なるため分けて記録します。PAN 2の採用を判断する具体的な一歩は、自社の代表的な作業から少数の計画を選び、成功条件を先に固定して、生成結果と処理時間を測ることです。その結果から、計画の比較に使える範囲と、人の確認が必要な箇所を見定められます。