

2026/11/11
今更聞けないAI知識
AIの「マルチモーダル」とは?写真に質問を添える意味からわかります
この記事の要点
マルチモーダルとは、文字・画像・音声など複数の種類の情報を扱うことです。架空の家電の写真を例に、画像と質問文の役割、対応形式の確かめ方、回答を確認する際の見方を紹介します。
目次
写真を見せて質問することも、AIへの伝え方です
家電の操作パネルを前にして、「このマークは何でしょう」と迷った場面を想像してみてください。文字だけで質問するなら、ボタンの形や並び、周囲の表示を説明する必要があります。「右側に丸いボタンがあり、その上に波のような線があります」と書いても、どの部分を指しているのか伝わるか気になるでしょう。そこで、写真と質問文を一緒に渡す方法が候補になります。
このとき知っておきたい言葉が「マルチモーダル」です。一言で表すと、文字・画像・音声など、複数の種類の情報を扱うことです。Google Cloudの解説でも、マルチモーダルAIは文字、画像、動画、音声などの異なる情報を組み合わせて扱う能力として説明されています。難しい名前ですが、入口は「文章以外の情報も使える」という見方で十分です。(出典: Google Cloud)
ただし、「マルチモーダル」という言葉だけで、あらゆる写真や音声を受け付け、正確に答えられると判断することはできません。どんな情報を渡せるかと、渡した内容に正しく答えられるかは、分けて考える必要があります。写真を送れたことだけでは、細かな表示まで正確に扱えたとは確認できないためです。
この記事では、架空の家電の写真を例に、「写真があるのに、なぜ言葉も必要なのでしょう」という疑問をたどります。押さえたいのは専門的な内部構造ではありません。写真で伝える部分と言葉で補う部分を分けられると、AIに何を渡せばよいか考えやすくなります。身の回りの物を説明したいときにも使える、基本の見方です。
写真付きの説明書にたとえると、役割の違いが見えます
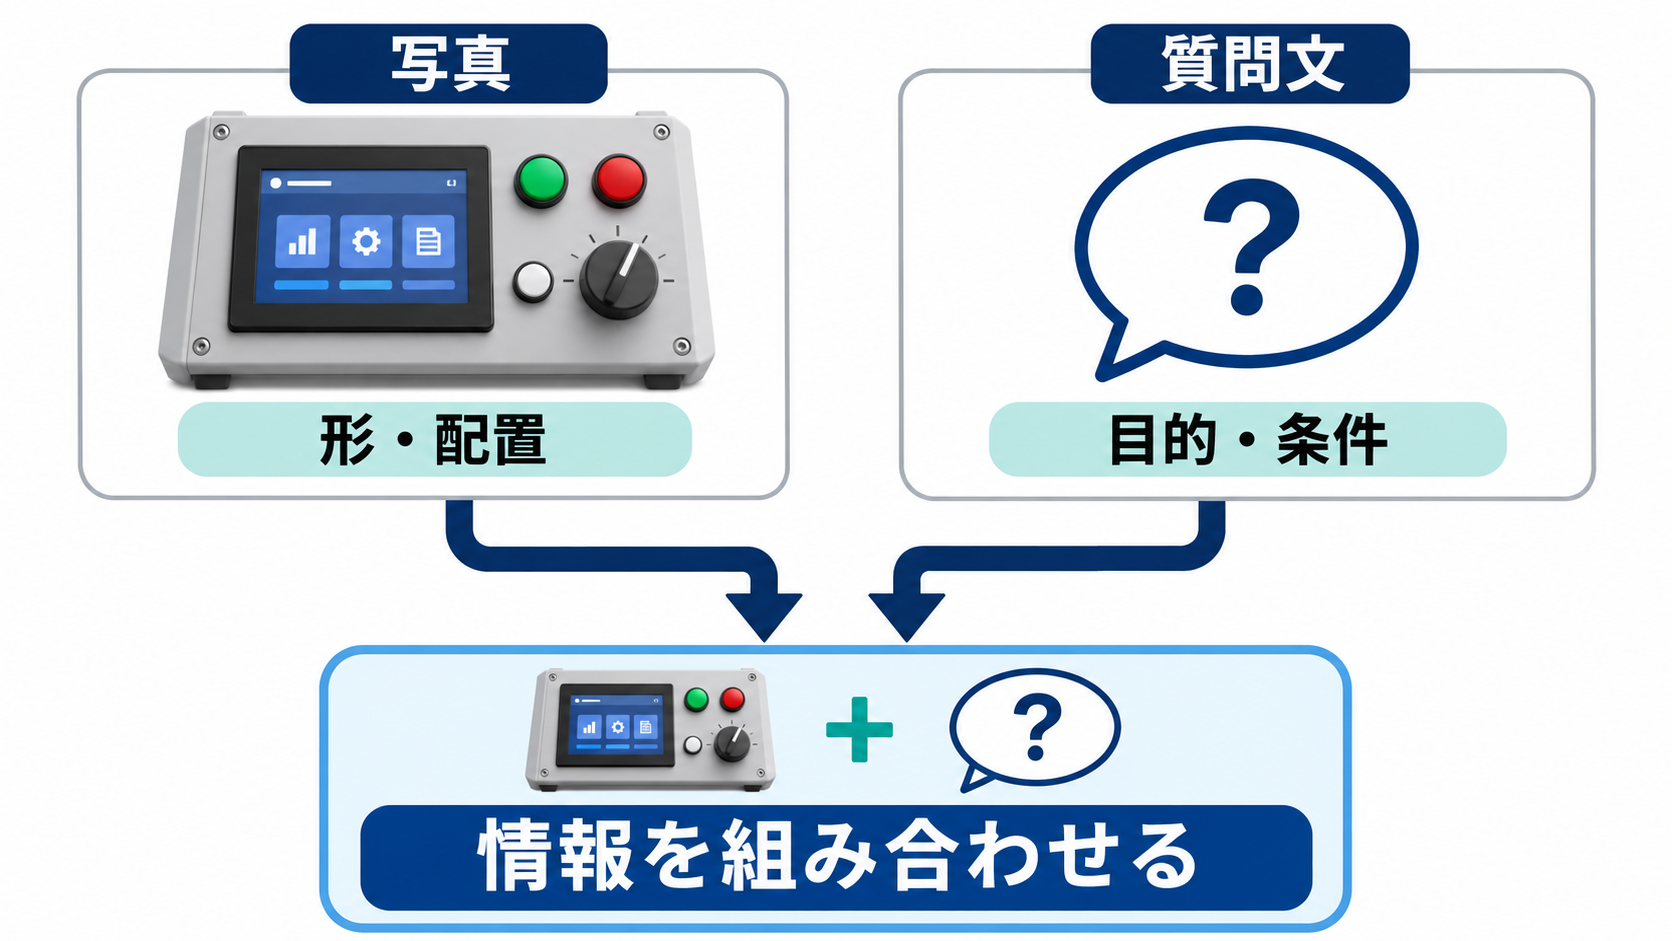
マルチモーダルを身近なものにたとえるなら、写真付きの説明書がよいでしょう。文章だけで「ふたの手前にあるつまみを回します」と書かれるより、つまみの写真が添えられているほうが、場所を確かめやすい場合があります。文章は動作や条件を伝え、写真は形や位置関係を示します。同じ対象でも、それぞれが受け持つ情報は少し違います。
AIに写真と質問文を渡す場合も、この役割分担が理解の手がかりになります。写真にはボタンの配置が写っていても、「表示の意味を知りたい」のか「説明文を作りたい」のかまでは写りません。質問文には目的を書けますが、複雑な形を文章だけで説明すると長くなることがあります。二つを組み合わせる意義は、一方だけでは伝えにくい部分を補えることにあります。
Google Cloudは、異なる種類のデータを統合して扱うことをマルチモーダルAIの特徴として挙げています。ただし、写真付きの説明書というたとえは、利用者にとっての情報の役割を説明するものです。AIの内部で、説明書のページがそのまま作られているという意味ではありません。(出典: Google Cloud)
この違いは、質問を考えるときに役立ちます。「写真を見れば目的もわかるはずです」と期待するより、「形は写真で示し、知りたいことは文章で指定します」と考えるほうが、依頼を具体化できます。逆に、知りたい内容が文章だけで十分に伝わるなら、必ず画像を足す必要はありません。情報の種類を増やすこと自体を目的にせず、何を補うために使うのかを考えるとよいでしょう。
仕組みの入口は、情報の種類と回答の形を分けることです
AIの説明に出てくる「モデル」は、ここでは学習した情報のパターンや関係を使って、入力に応じた出力を作る仕組みと捉えてください。IBMは、生成AIの土台となるモデルには文章向けだけでなく、画像、動画、音声などに関するものがあり、複数の種類の内容を支えるマルチモーダルなモデルもあると説明しています。(出典: IBM)
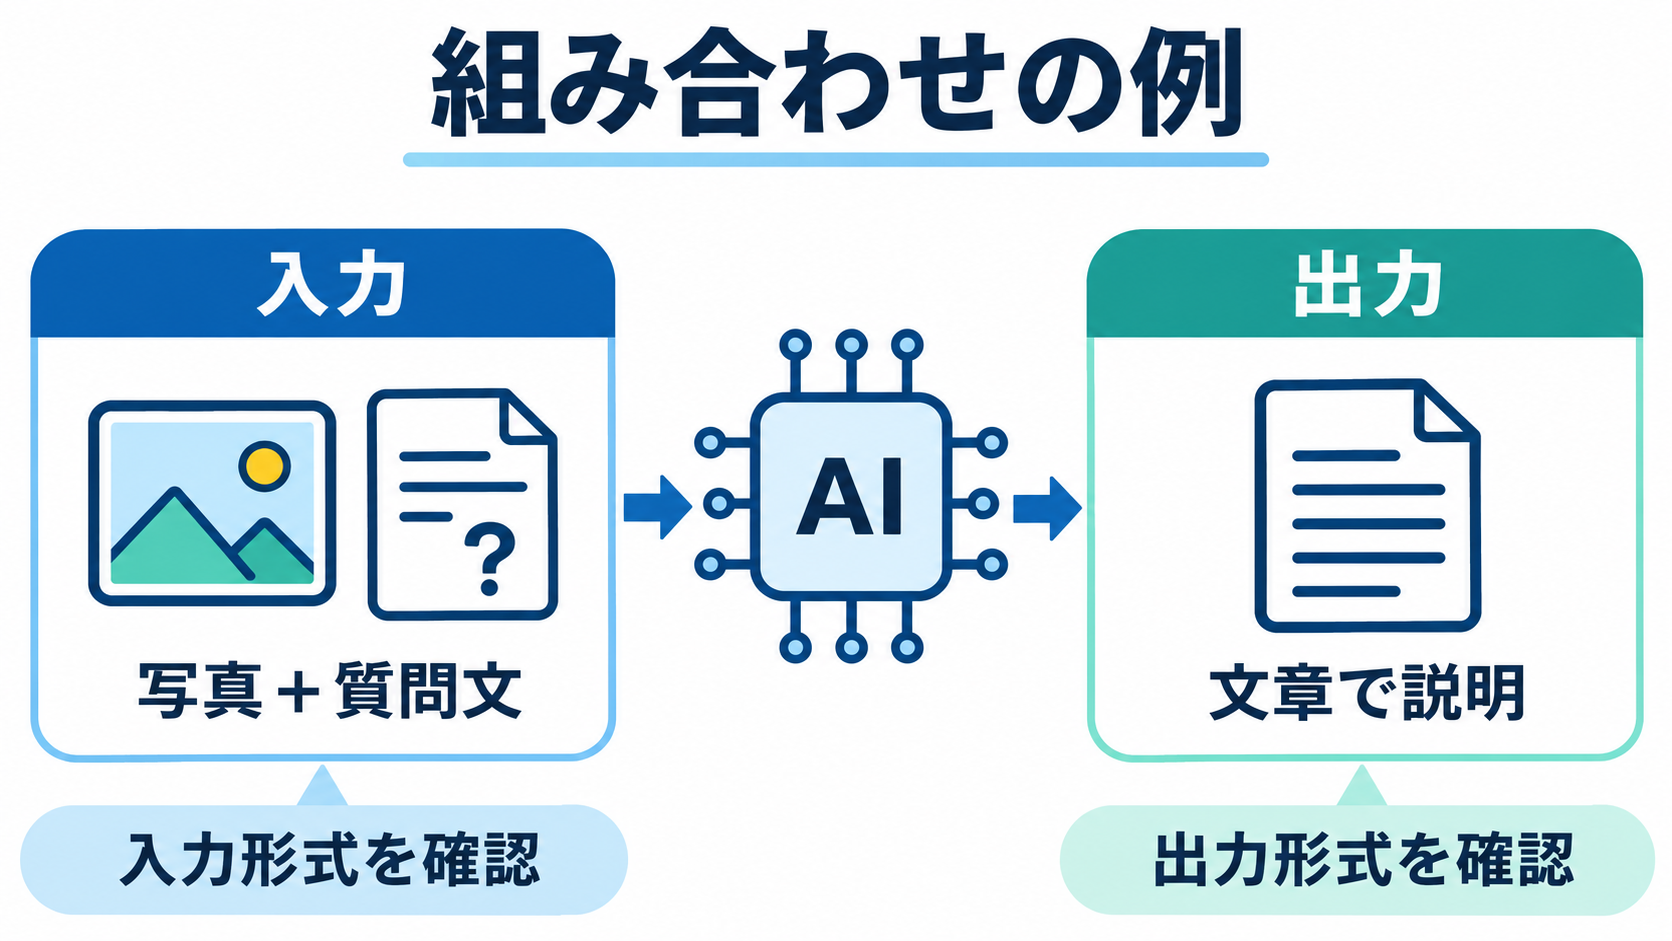
利用する側は、詳しい計算方法よりも、「何を受け取れるか」と「何を返せるか」を分けると整理しやすくなります。たとえば、写真と文章を受け取り、文章で説明を返すという組み合わせを考えてみましょう。この例では、入力に画像を使っていますが、回答として画像を作ることは依頼していません。画像を材料にすることと、画像を生成することは、別の確認事項です。
したがって、あるAIについて「画像に対応しています」という説明を見かけたら、その短い表現だけで用途を決めないほうがよいでしょう。写真を質問の材料として渡せるのか、文章から画像を作れるのか、自分が使いたい方向を確かめる必要があります。これは特定の製品の仕様ではなく、機能説明を読む際の確認の仕方としての提案です。
文字・画像・音声という種類の違いも、いったん分けて考えてください。写真を扱えるという情報だけでは、音声の扱いまで確認できたことにはなりません。「複数」という言葉を「全部」と読み替えないことが大切です。マルチモーダルという分類名を覚えるだけでなく、自分が渡したい材料と、受け取りたい回答の組み合わせを書き出してみると、利用前に調べるべき点がはっきりします。
架空の操作パネルなら、写真に「知りたい範囲」を添えます
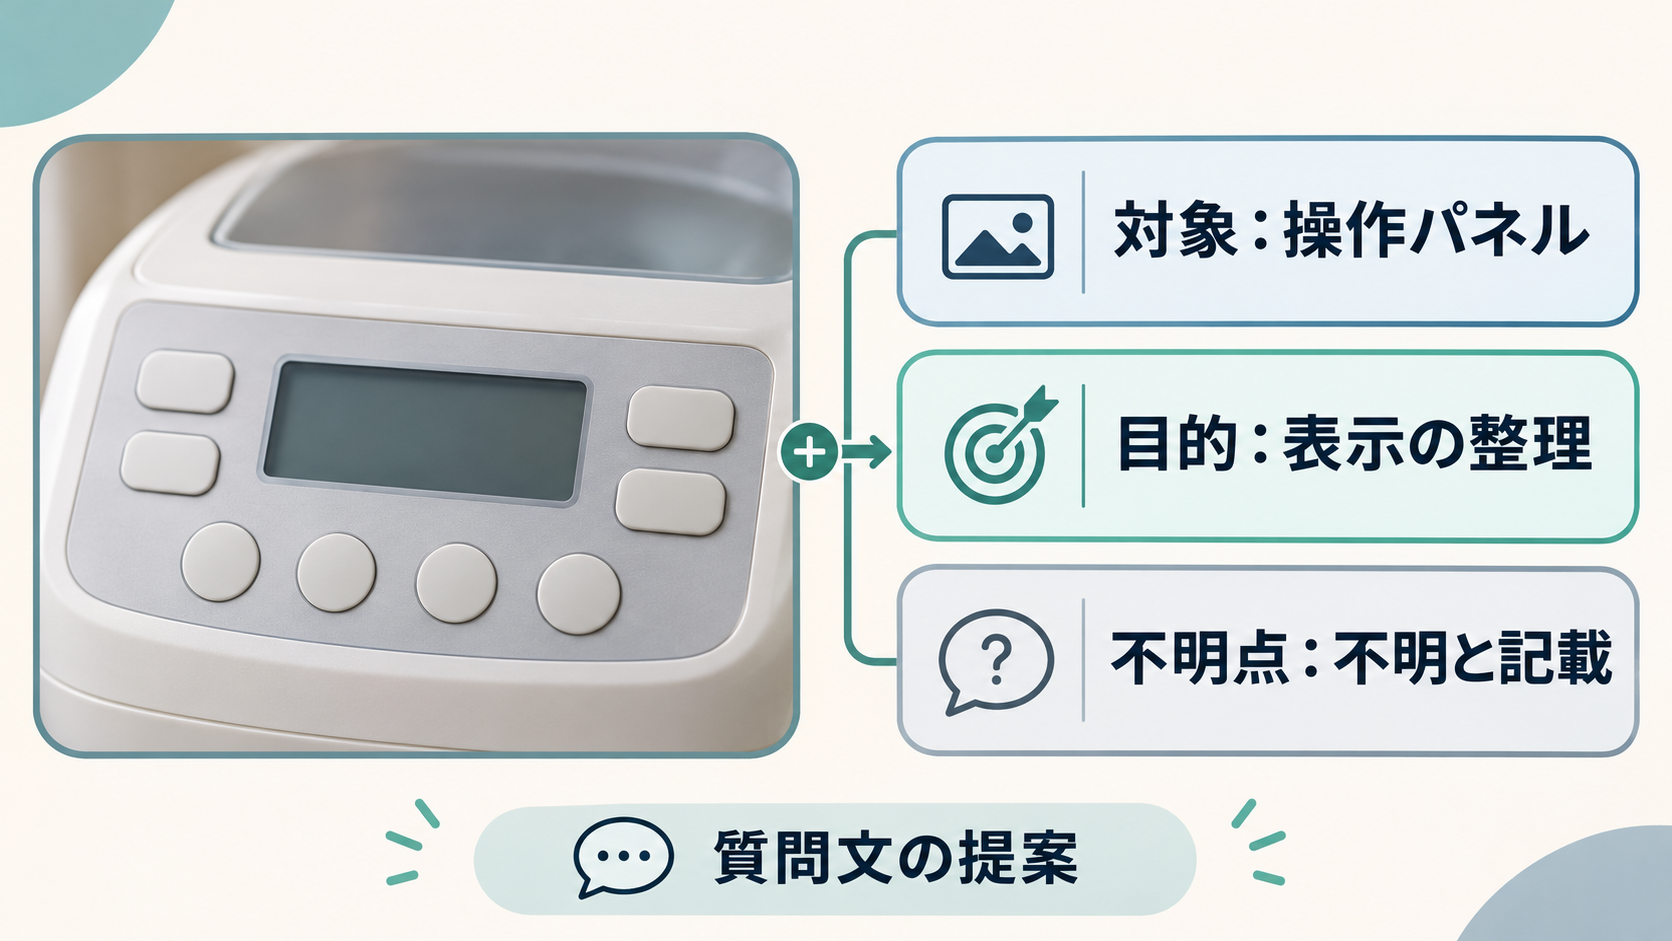
ここからは使い方の提案です。架空の家電の操作パネルを撮影し、並んでいる表示を説明する文章を作りたいとします。目的は実際に機器を動かすことではなく、写真から確認できる内容を整理することです。特定のAIで操作を検証した例ではなく、画像を入力できることを確認したうえでの質問文の例として読んでください。
「これは何ですか」だけでも質問にはなりますが、何を答えてほしいかには幅があります。製品の種類、ボタンの名前、表示の読み方など、求める回答が定まりません。そこで、対象と目的に加えて、確認できない部分の扱いも言葉で指定する方法を提案します。
たとえば、次のように依頼できます。「この写真は架空の家電の操作パネルです。パネルの説明文を作るために、写真で読める文字とボタンの位置を整理してください。文字が判別できない部分は、不明と記載してください。ボタンの機能は、写真で確認できる内容と推測を分けて説明してください」。ここでのポイントは、長い文章にすることではなく、回答してほしい範囲を決めることです。
この例では、写真が外見の材料を受け持ち、文章が作業の目的と回答の条件を受け持ちます。依頼文は「プロンプト」と呼ばれますが、まずはAIに渡す質問や指示という意味で理解すれば十分でしょう。IBMも、生成AIは利用者のプロンプトや依頼に応じて内容を生成すると説明しています。(出典: IBM)
ただし、「不明と書いてください」と頼めば、誤りがなくなるという保証にはなりません。回答を受け取った後は、写真に実際に見える文字と説明を照らし合わせてください。実在の機器の操作を知りたい場合には、この架空例の回答を手順として流用せず、その機器の説明書で確かめることが次の行動になります。
写真があっても、見えている内容と正しい説明は別です
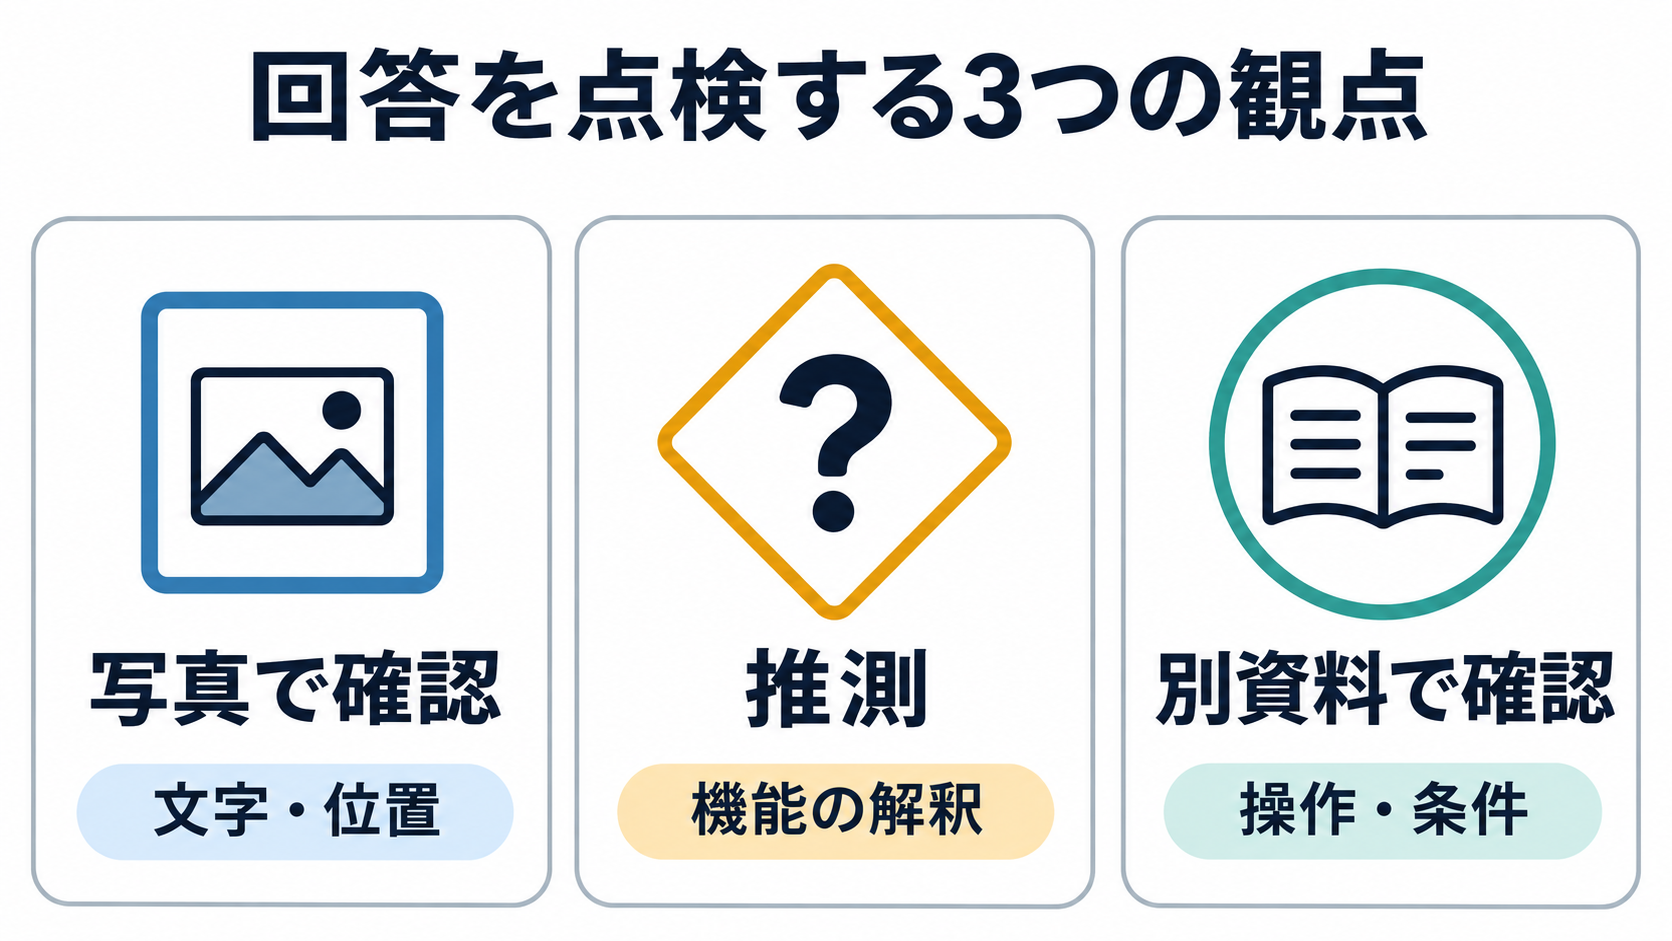
写真を添えた回答には、対象を直接確かめたような印象を持つかもしれません。しかし、回答に細かな説明が並んでいることと、その説明が写真や実物に合っていることは別です。たとえば、架空のパネルに似た形のボタンが並んでいたとして、「このボタンは予約用です」と文章が出ても、その機能を写真だけで確かめられるとは限りません。
ここでは、回答を三つの観点から読む方法を提案します。写真に写る文字や位置の説明、外見を手がかりにした解釈、写真にはない機能や条件の説明です。これらを区別すると、どこを写真と照合し、どこを説明書などで確認すべきか考えやすくなります。AIがこの区分を必ず守るという仕様の説明ではなく、利用者が回答を点検するための整理です。
IBMの説明では、生成AIは学習データの表現をもとに、新しい内容を生成します。この説明からも、生成された文章を、実物について確認済みの記録と同じように扱うことはできません。写真を材料に使った場合も、回答のどの部分に根拠があるかを確かめる必要があります。(出典: IBM)
写真だけでは、自分の事情を十分に伝えられない場合もあります。表示の意味を知りたいのか、説明資料に載せる短い文章が欲しいのかで、必要な答えは変わるでしょう。画像を追加することと、依頼を具体的にすることは、どちらか一方で済む関係ではありません。
特に区別したいのは、「読めない表示を説明してもらうこと」と「推測された機能に従って操作すること」です。前者の回答を得ても、後者の判断に必要な根拠がそろうとは限りません。わからない部分が残ったときは、質問を重ねるだけで埋めようとせず、説明書などの確認先へ戻る選択もできます。使える情報が増えた分だけ、根拠を見分ける姿勢も持っておきたいところです。
明日からは「材料・目的・確認先」をそろえます
マルチモーダルを知った後の一歩として、何でも写真に撮って送る必要はありません。自分が説明に困っているものを一つ選び、「文章では伝えにくい部分はどこでしょう」と考えてみてください。形や配置なら写真が候補になりますし、用件や希望なら文章で示すほうが直接的でしょう。どの情報に何を担わせるかを決めることが、準備の出発点です。
実際に試す前には、利用するAIの案内で、渡したい種類の情報に対応しているか確かめてください。特定のボタンや画面を探す手順は、ここで挙げた資料からは示せません。確認したいのは、自分が使いたい入力形式と回答の形式が合っているかという点です。マルチモーダルという名前だけで判断せず、具体的な対応内容を読むようにしましょう。
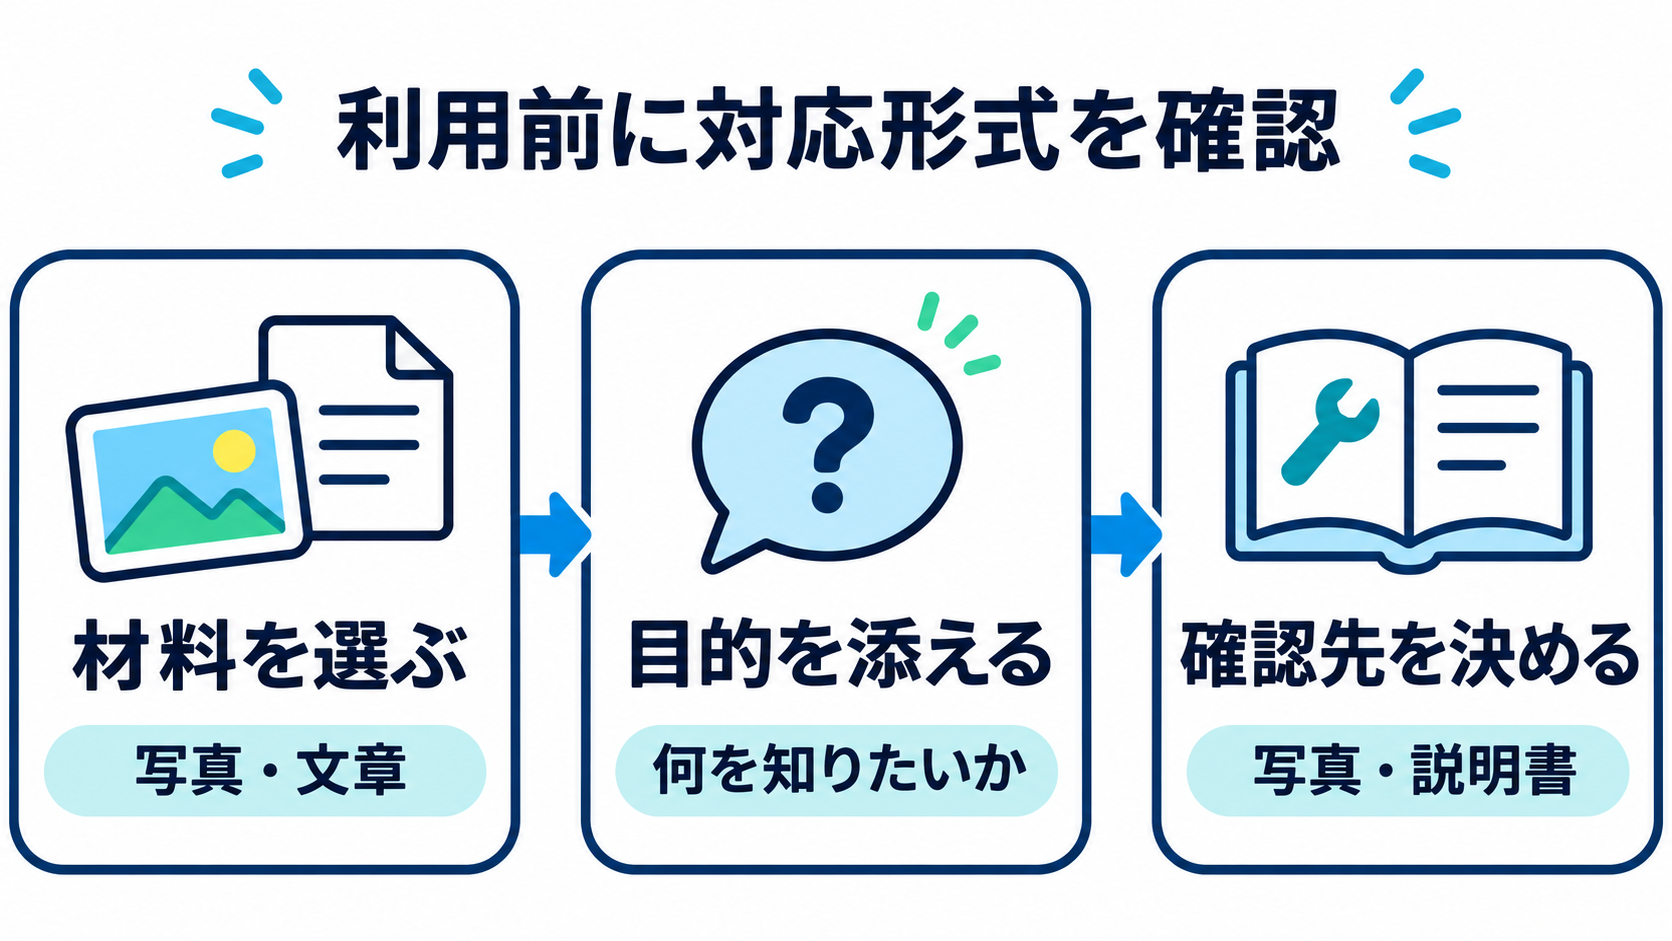
質問を用意するときの確認項目は、次の三つに絞れます。
- 材料として、写真や文章の何を渡す必要がありますか。
- 目的として、何を知り、どんな形の回答を受け取りたいですか。
- 確認先として、回答を何と照らし合わせられますか。
これは利用のための提案であり、特定のAIの機能や正確性を保証する手順ではありません。架空の操作パネルなら、写真を材料にし、読める表示の整理を目的にし、写真そのものと照合するところから試せます。実在の家電の機能まで知りたいなら、説明書も確認先に加える必要があるでしょう。
写真と文章を組み合わせる価値は、質問文を省略できることだけではありません。写真に任せる情報と言葉で補う情報を選べることにあります。次に身の回りの物をAIに説明したくなったら、送信前に「この画像の何を、何のために説明してほしいですか」と自分に問い直してみてください。その答えを一文添えることが、マルチモーダルを使う最初の練習になります。