
AI LAB
2026/10/21
Wikipediaを守るAI、揺らすAI――文章判定から「知識の信頼性」へ移る攻防
決まり文句から始まったAI文章の“清掃”
Wikipediaの記事に「豊かな文化遺産」や「〜の証しです」といった表現が繰り返し登場し、末尾には百科事典らしくない結論まで付いている――。2023年12月ごろ、複数の編集者が英語版Wikipediaで、このような不自然な記事を相次いで見つけました。文章には当時のChatGPTが生成する回答とよく似た特徴があり、人間が書いた既存の記事とは構成も語彙も異なっていました。こうした状況を受け、編集者のエリア・ルブルー氏らは2023年、ボランティア活動「WikiProject AI Cleanup」を立ち上げました。ルブルー氏は、フランスの国立デジタル科学技術研究機関Inriaに属するレンヌ大学の研究センターで、AI分野の博士号取得を目指す研究者でもあります。同プロジェクトの目的は、AIを使ったこと自体を一律に見抜くことではなく、Wikipediaの方針に反する機械生成コンテンツを発見し、修正または削除することです。
初期のAI文章は特徴が目立っていたため、経験のある編集者なら比較的容易に判別できました。しかし、問題の本質は文章の癖だけではありません。Wikipediaは、不特定多数の編集者が出典を積み重ね、内容を検証し続けることで成り立つ共同編集型の百科事典です。もっともらしい文章を大量に投入できる生成AIは、その検証に必要な時間だけを人間側へ押しつける可能性があります。
ここで生じているのは、単なる迷惑投稿との競争ではありません。誰が記述に責任を持ち、どの資料によって内容を確かめられるのかという、知識基盤そのものの問題です。見栄えのよい文章を作れることと、百科事典として信頼できることは同義ではありません。この区別が、WikiProject AI Cleanupの活動を理解する出発点になります。
語彙ではなく構造と行動を見る検出手法
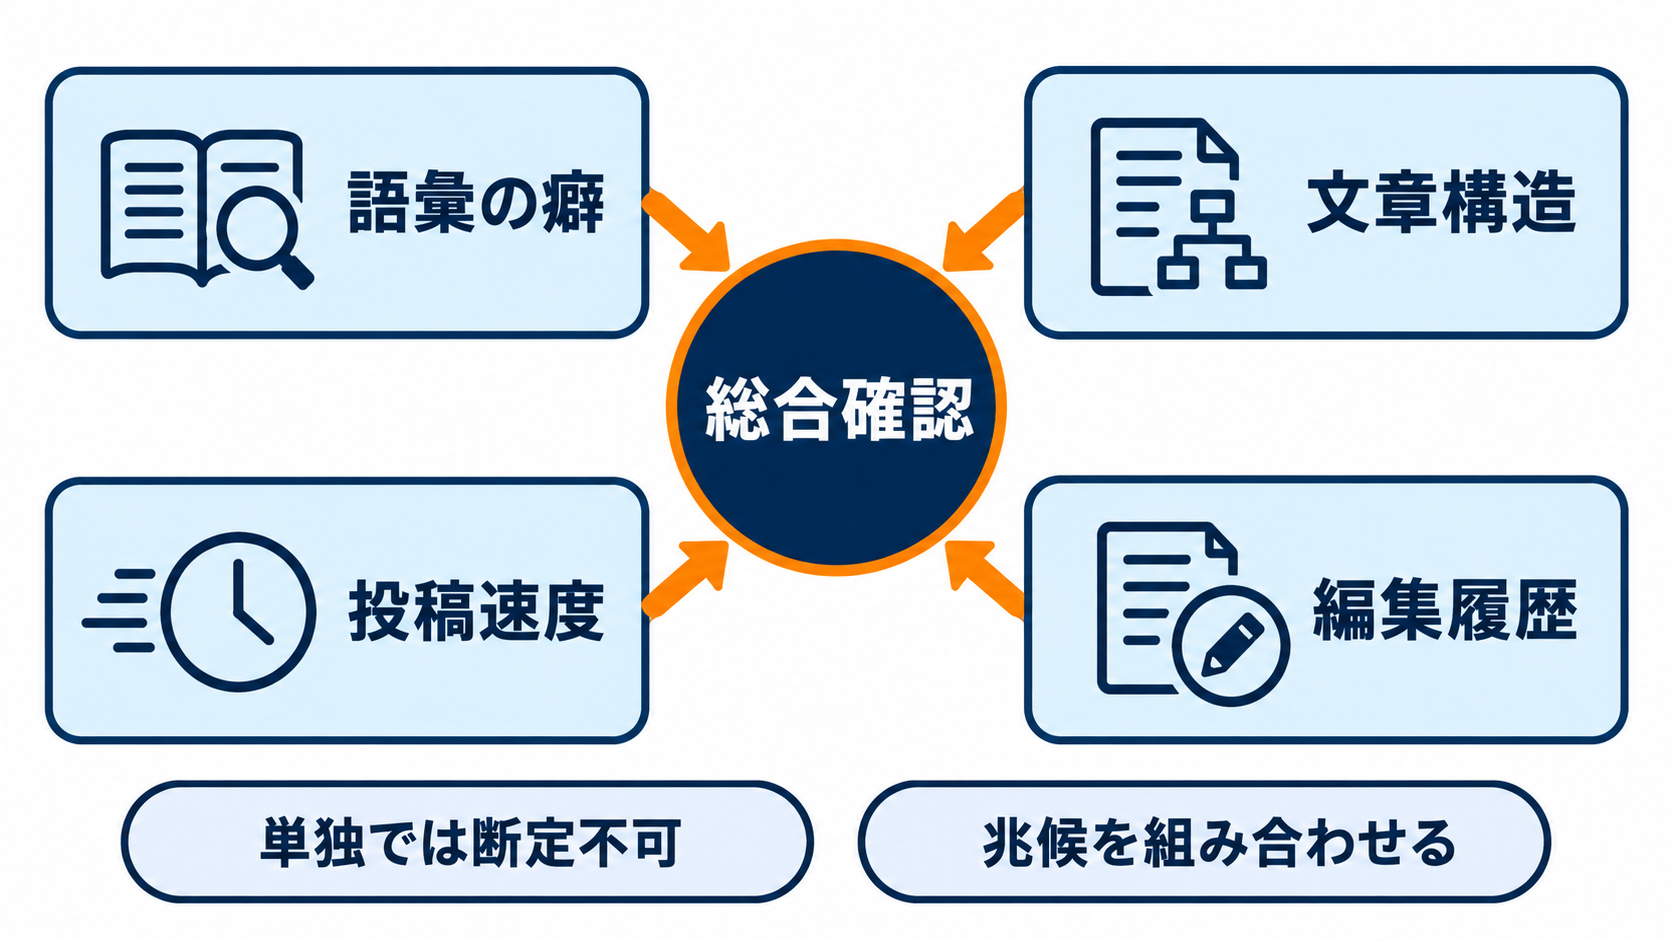
生成AIの文章が自然になるにつれ、「特定の表現を使っているからAI」と判断する方法は通用しにくくなりました。ルブルー氏によると、2025年ごろから兆候は細部や文章構造に移っています。三つの要素を並べて説得力を演出する「ルール・オブ・スリー」や、否定形を対照的に配置する構文などが、その一例です。ただし、これらは人間も使う一般的な修辞技法であり、一つ見つけただけでは証拠になりません。重要なのは、弱い兆候を複数組み合わせて見ることです。似た構文が不自然な頻度で現れる、各節が同じ型で展開される、百科事典には不要な総括が加わるといった特徴が重なれば、確認の優先度を上げられます。これはAI判定を即座に下す仕組みというより、限られた編集者の時間を、疑わしい投稿へ振り向けるためのスクリーニングと捉えるべきでしょう。
編集者は本文だけでなく、投稿者の行動も確認します。たとえば、数千語に及ぶ記事を5分間に5本投稿していれば、人間が調査と執筆を行った可能性には疑問が生じます。文章の特徴と編集履歴を併せて評価することで、単純なキーワード検出よりも実態に近い判断が可能になります。
この考え方は、企業が社内文書や顧客向けコンテンツを管理する際にも参考になります。AI検出器の点数だけで公開可否を決めると、人間の文章を誤判定するおそれがあり、逆に高度なAI文章を見逃すかもしれません。作成時間、改訂履歴、参照資料、承認者といったプロセス上の情報を合わせて確認するほうが、説明可能な運用になります。問うべきなのは「AIが書いたか」だけではなく、「内容を検証できる作業工程が残っているか」です。
本文より危うい「実在するが支えていない出典」
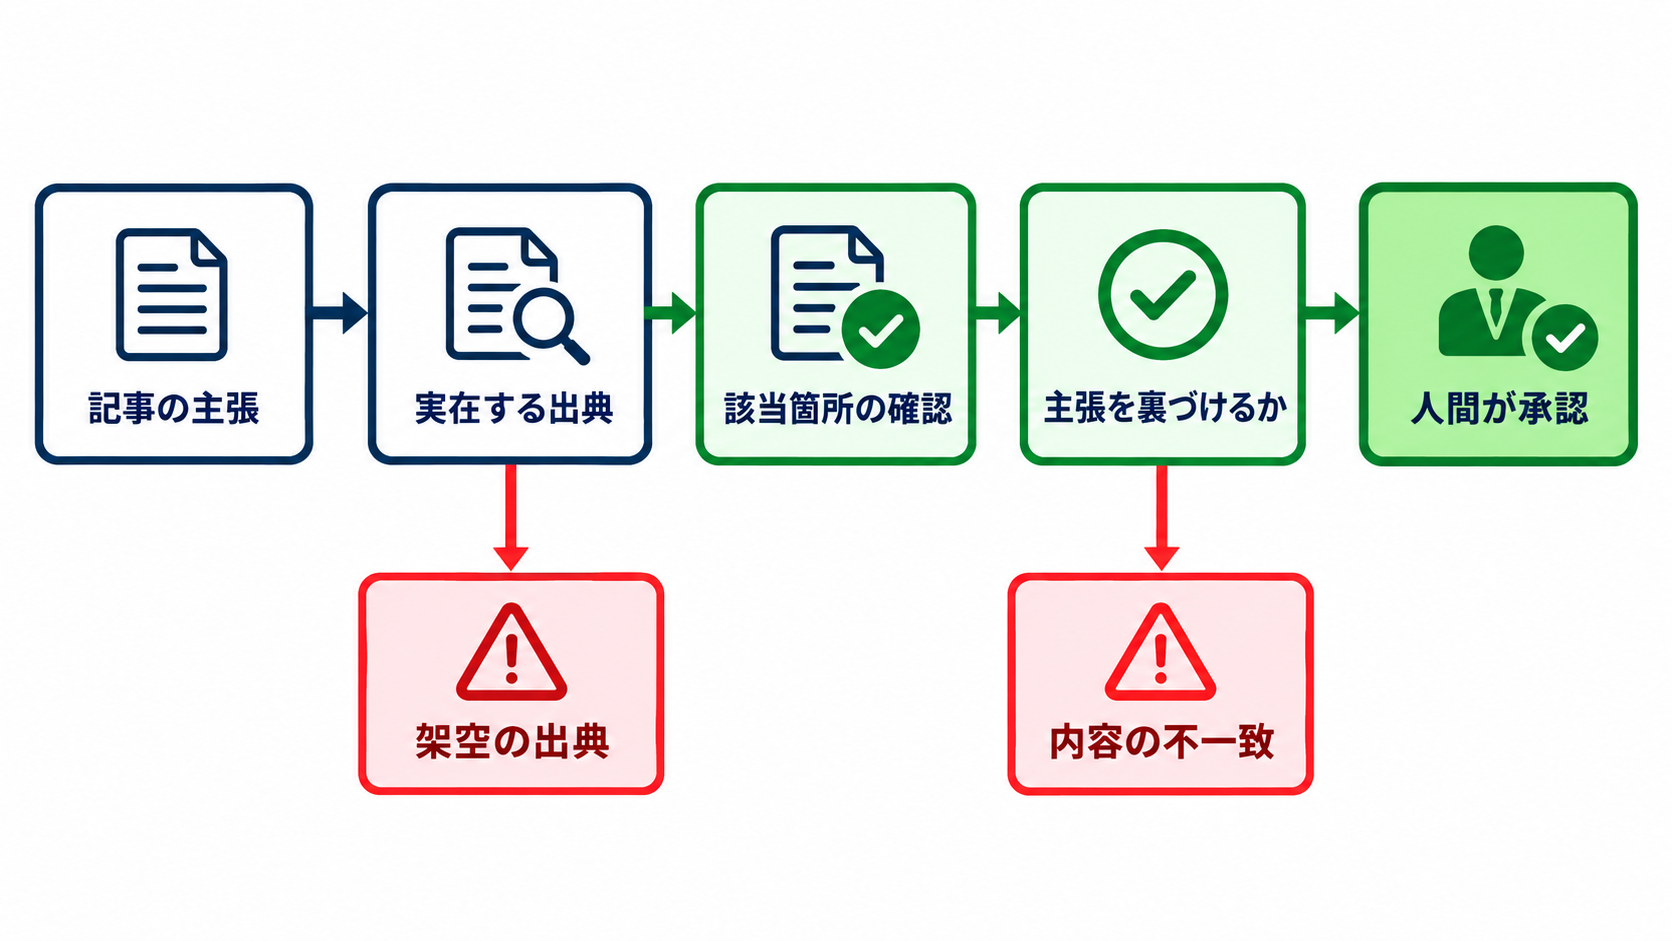
WikiProject AI Cleanupが強く警戒しているのが、引用と出典の問題です。生成AIが存在しない文献を作り出す、いわゆるハルシネーションは広く知られています。ただし、ルブルー氏によれば、現在は架空の資料を丸ごと示す事例よりも、実在する資料を見つけながら、その内容を誤って説明する事例が頻繁に確認されています。背景には、検索や外部データベースから情報を取り込み、回答に反映するRAGがあります。RAGは「検索拡張生成」と呼ばれる仕組みで、モデルが手元の学習内容だけに頼らず、取得した文書を参照できるようにします。これによって実在するリンクを提示しやすくなりますが、リンク先の主張を正確に理解したことまでは保証されません。資料の題名や概要が質問と近いだけで、本文には書かれていない結論をAIが結び付けることもあり得ます。
こうした誤りは、架空のURLより発見が難しくなります。リンクが実在し、著者名や発行元も正しければ、確認者は出典が付いているという外観だけで安心しがちです。しかし、百科事典で必要なのは出典の存在ではなく、記述された主張をその出典が実際に裏づけていることです。確認にはリンク先を開き、該当箇所を読み、断定の強さまで照合する作業が欠かせません。
企業のAI利用でも同じ落とし穴があります。市場調査、法務向けメモ、技術比較、経営会議資料では、出典欄が整っているほど内容が正しいように見えます。実務では、重要な主張ごとに資料との対応関係を残し、孫引きではなく一次的な発表や文書へ到達できる状態にする必要があります。AIによる引用生成は調査の入口には使えても、検証済みであることを示す証跡にはなりません。
新規投稿の15〜20%という推計をどう読むか
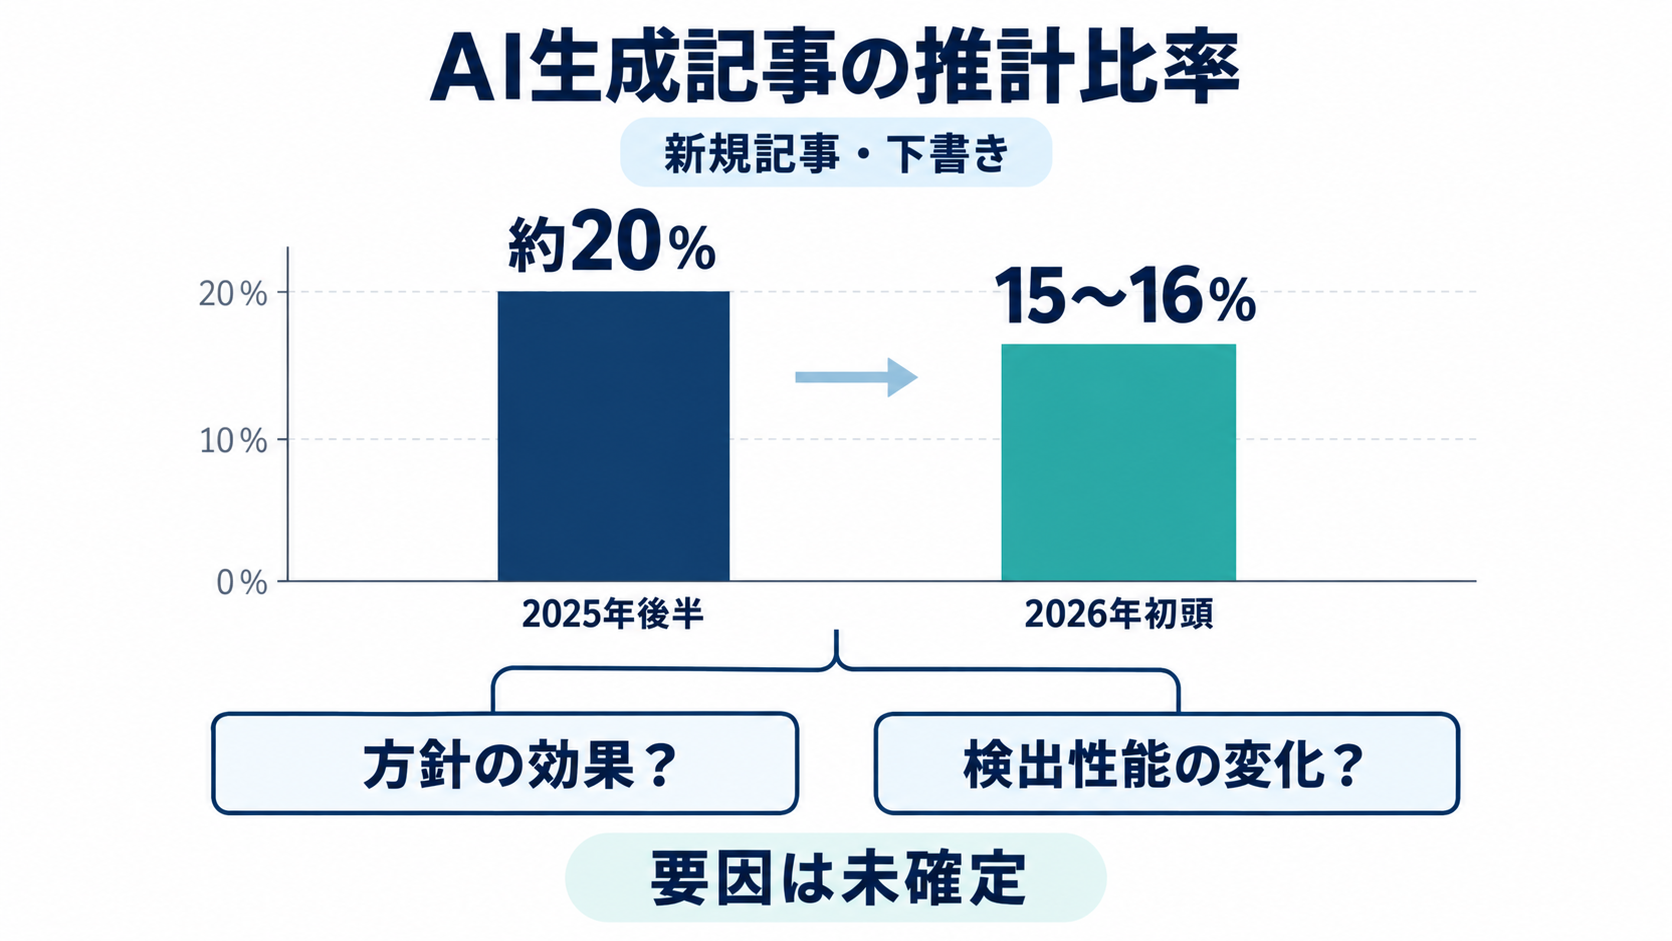
英語版Wikipediaは、編集者が大規模言語モデル(LLM)を使って記事を生成することを禁止しました。LLMとは、大量の文章から言語のパターンを学習し、指示に応じて文章を生成するモデルの総称です。ルブルー氏はAI検出企業Pangramと協力し、禁止後もどの程度のAI生成コンテンツが投稿されているかを推計しています。Pangramの検出器をChatGPT登場以前のWikipediaコンテンツで試した範囲では、誤検出は確認されませんでした。そのためルブルー氏は、この結果をAI利用率の控えめな下限として扱っています。検出結果によると、2025年後半には新規記事と下書きの約20%、2026年初頭には15〜16%ほどがAI生成とみられる状態でした。数値は低下していますが、これだけで禁止方針の効果が証明されたわけではありません。
考えられる説明は複数あります。注意表示や編集支援が初心者に届き、投稿を思いとどまらせた可能性があります。商用AIがWikipedia記事の生成依頼を拒否する例もあり、方針が間接的に働いたのかもしれません。その半面、生成モデルの文章が高度になり、検出器側の対応が追いついていない可能性も残ります。観測された比率の低下を、そのまま実態の改善と読むことはできないのです。
AI生成の投稿は初心者によるものが大半だとされるため、Wikipedia側は歓迎メッセージ、編集ヘルプ、助言の中で禁止ルールを目立たせる取り組みを進めています。ここから得られる教訓は、規則を作るだけでは行動は変わらないという点です。企業でも、AI利用方針を社内ポータルに置くだけでなく、執筆画面、研修、承認フローなど、利用者が判断する瞬間に提示する必要があります。効果測定では検出率だけを追わず、違反の種類、修正負担、再発状況も併せて見るべきでしょう。
AIでAIをふるいにかける現実的な役割分担
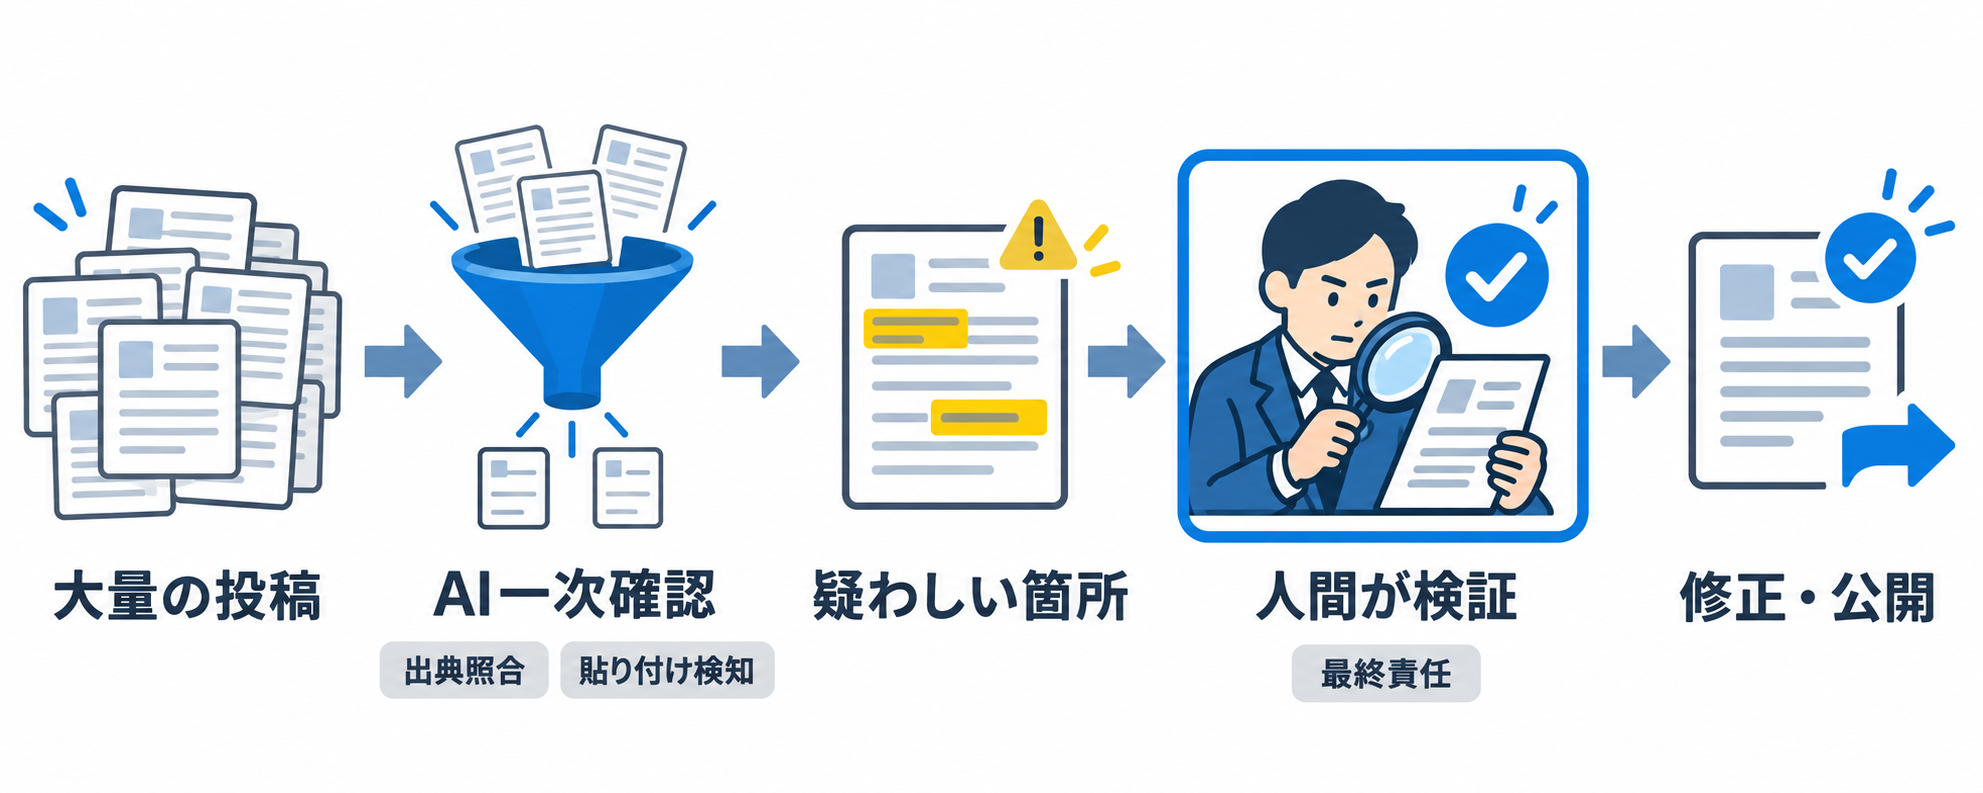
大量の投稿を人間だけで精査するには限界があります。そこでWikiProject AI Cleanupでは、AIを排除対象として扱うだけでなく、検証作業を支援する道具としても利用しています。プロジェクトの編集者が開発したAIベースの出典検証ツールは、ページ内の主張と参照先を確認し、両者が対応しているかを調べます。このツール自体もAIモデルであるため、判定が常に正しいとは限りません。役割は最終判断ではなく、明白な不一致を大規模にふるい分けることです。大量の候補から確認すべき箇所を絞り、人間の編集者が出典を読み直せるようにするなら、不確実なモデルにも実用上の価値があります。判定結果をそのまま削除命令に変えず、調査の優先順位として扱う設計が鍵になります。
Wikipediaを運営・支援するWikimedia Foundationも、「Paste Check」というツールを開発しています。これは、一部のAIチャットボットから直接貼り付けられた文章を検知することを目指すものです。また、Anthropicの対話AI Claudeが、Wikipediaの方針に反するとして記事生成を拒む場合も確認されています。主要なAI企業が同様の拒否機能を実装すれば、技術に詳しくない利用者による安易な投稿を減らす助けにはなります。
ただし、制限を変更できるオープンウェイトモデルも存在するため、提供企業側の拒否機能だけでは問題をなくせません。現実的な対策は、入力時の警告、機械による一次確認、人間の検証、修正履歴の保存を重ねることです。企業が同様の仕組みを導入する場合も、AIを監視役に据えるだけでは足りません。誤判定を誰が再確認するのか、異議をどう扱うのか、公開後の訂正をどこまで追跡するのかまで決めておく必要があります。
人間が書く百科事典という希少性
AIが将来、正確で信頼できるWikipedia記事を書けるようになった場合、禁止方針を維持すべきかという問いが残ります。現行のガイドラインは、AI生成コンテンツが急増する一方、十分な検査ツールがなかったという実務上の事情から成立しました。しかし、ルブルー氏によれば、議論は次第にWikipediaの存在意義へ広がっています。Wikipediaは、利用者が比較的信頼できるインターネット上の場所として語られてきました。AIによる粗製コンテンツから距離を置き、人間が執筆する百科事典であることも、そのアイデンティティーの一部になりつつあります。AI企業にとっても、人間が記述・編集した大規模な文章集合は価値を持ちます。機械生成物がウェブ上に増えるほど、人間の判断過程を経た資料の希少性は高まると考えられます。
それでも、読者や編集者が網羅性を高めるためにAIの参加を望む可能性はあります。ルブルー氏は、人間が書いた知識集合としてのWikipediaを維持しながら、別途AI支援型の選択肢を提供する構想にも触れています。人間執筆かAI生成かを一つに決めるのではなく、両者を区別できる形で併存させる発想です。
この論点は企業のナレッジ管理にも直結します。AIで文書作成を高速化しても、どの部分が人間の確認を経たのか分からなければ、学習データや意思決定資料として再利用しにくくなります。AI利用の有無、確認者、参照資料、更新日時を記録しておけば、人間作成の情報資産とAI支援コンテンツを目的に応じて使い分けられます。効率だけでなく、将来の再検証に耐えられるデータとして残す視点が必要です。
「Google Zero」が変えるWikipediaへの入口
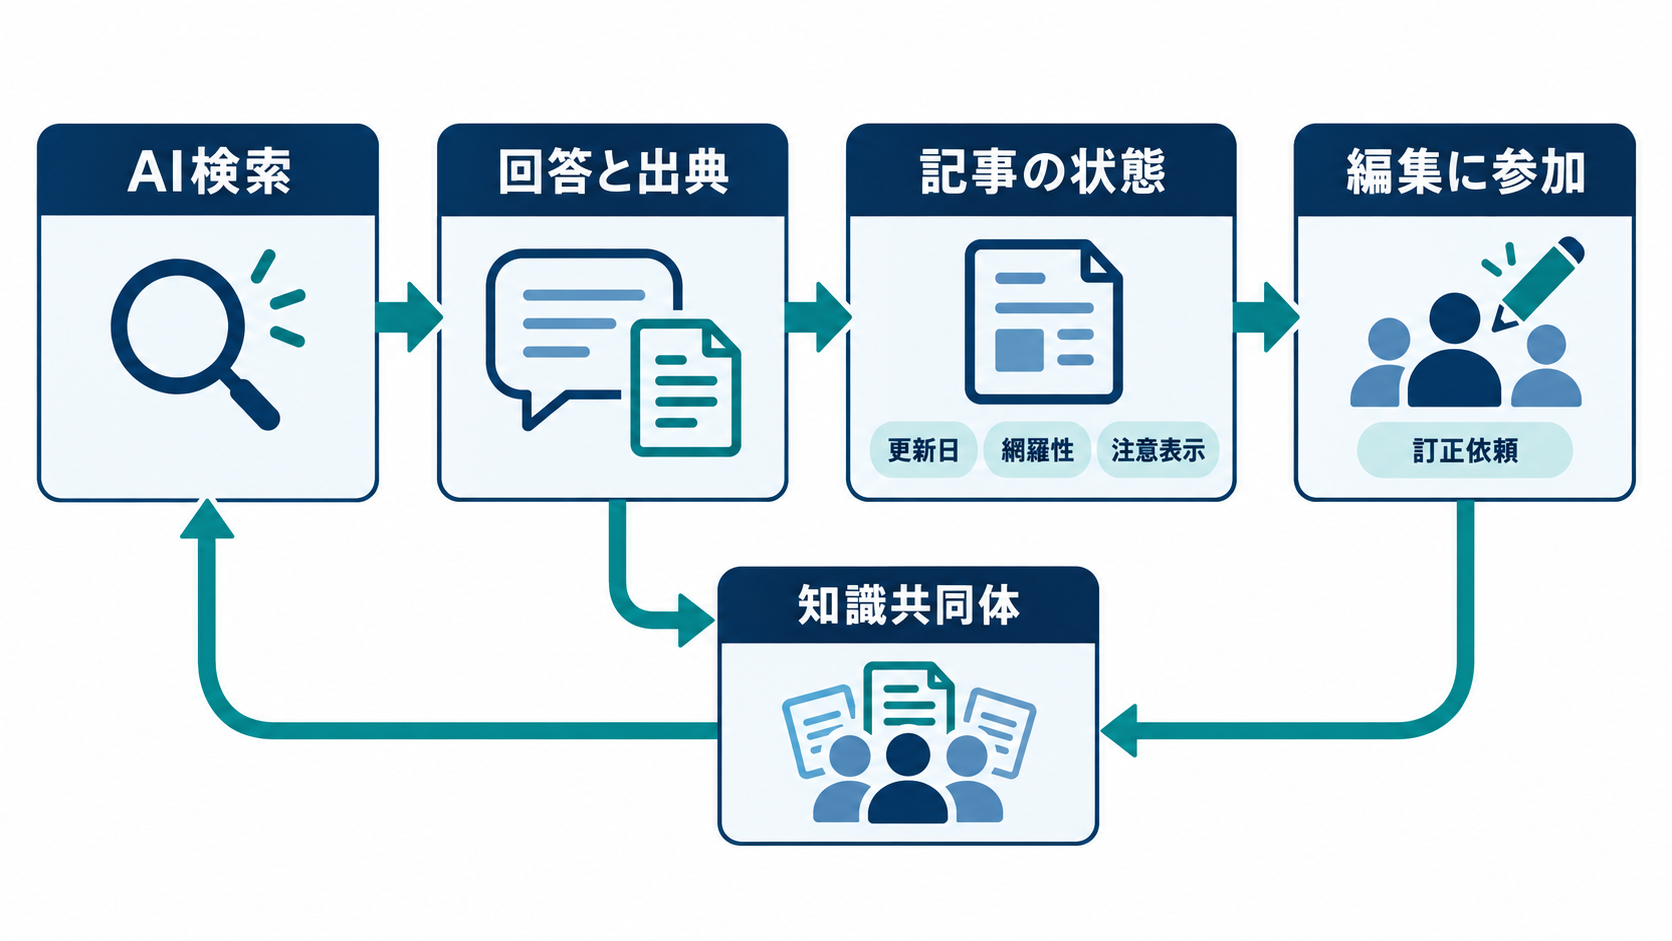
検索結果からウェブサイトへ人が移動せず、AIが回答を完結させる未来は「Google Zero」と呼ばれています。WikipediaはGoogleのAI Overviewsで頻繁に参照されますが、利用者が目にするのはWikipediaを出典として示したAI回答だけかもしれません。その場合、背後にあるページへ移動せず、誰でも編集や議論に参加できるプロジェクトだと気づかない可能性があります。これは閲覧数だけの問題ではありません。Wikipediaは、読者の一部が誤りを見つけ、編集者や情報提供者になる循環によって維持されています。AI検索が内容だけを切り出して提示すると、知識は消費されても、その知識を修正する共同体への入口が見えにくくなります。出典名が表示されることと、出典の状態や参加方法まで伝わることには大きな差があります。
Wikimedia Foundationは、AI利用者へ記事の状態を詳しく伝える帰属表示の枠組みを検討しています。最終編集日、内容の網羅性、編集者から問題を指摘されているかといった情報に加え、参加を促す案も挙げられています。将来は、AIが引用したWikipediaの誤りに気づいた利用者が、別の資料を添えて編集依頼を送るような経路も考えられます。
WikipediaとAIの関係は、排除か受容かという二択では捉えきれません。AIは削除すべき投稿を生み出す存在であると同時に、検証を支援し、新しい読者を共同編集へつなぐ窓口にもなり得ます。企業が自社情報をAI検索時代へ適応させる際にも、回答への引用を獲得するだけでは不十分です。更新日、責任主体、根拠、訂正窓口を機械にも人間にも伝わる形で整えることが、信頼と参加経路を保つ具体的な一歩になります。