

2026/11/16
今更聞けないAI知識
AIは質問のたびに学習するの?「会話で伝えること」と「モデルを変えること」の違い
この記事の要点
AIの回答が変わっても、その場でモデルが追加学習したとは限りません。学習はモデルを調整する工程、回答はモデルと入力を使って内容を作る工程です。架空の案内文を例に、会話の文脈と追加学習の違い、入力データの利用条件を別に確認する考え方を説明します。
目次
答えを直せたら、そのAIは学習したのでしょうか
AIに案内文を頼み、続けて「もっと短くしてください」と伝えると、短い文章が返ってくることがあります。この変化を見ると、「今のやり取りで、AIが私の好みを学習したのかな」と感じるかもしれません。けれども、目の前の回答が変わることと、AIの土台が学習によって変わることは、分けて考える必要があります。
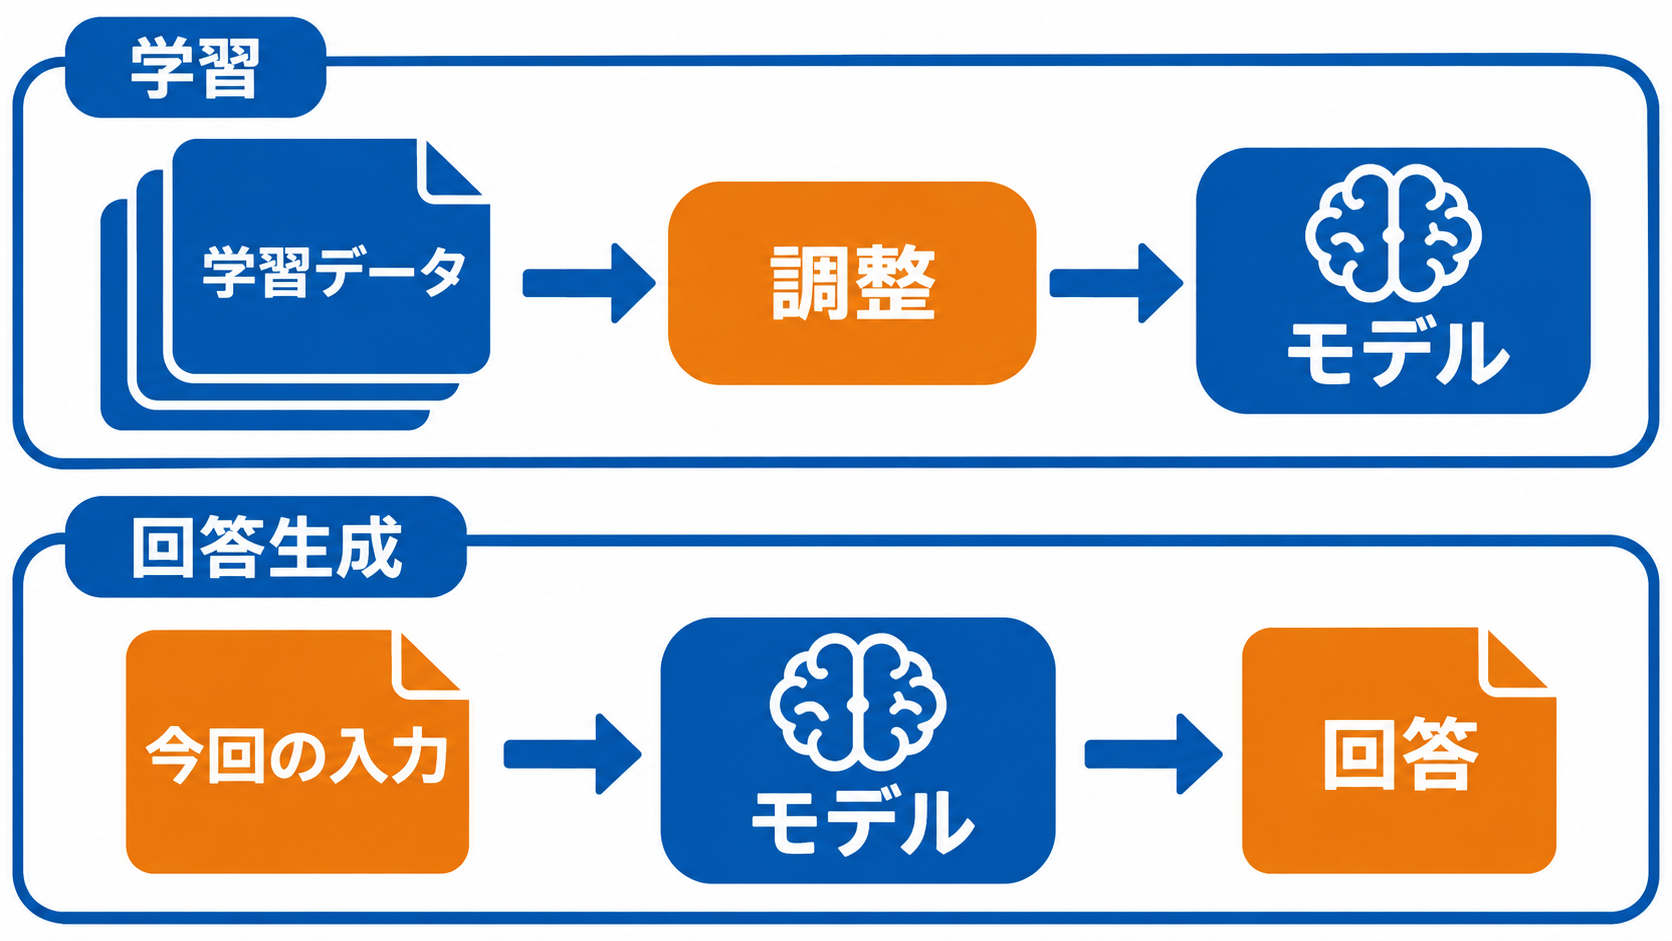
一言で答えるなら、学習はデータからモデルを調整する工程で、回答はそのモデルを使って入力を処理する工程です。ここでいう「モデル」とは、学習によって得られた、入力から出力を導くための仕組みを指します。Google Cloudの説明でも、機械学習のモデルは、学習用データに対して学習の手順を実行した結果として位置づけられています。(出典: Google Cloud)
文章を作る生成AIでは、依頼を受け取った後に、その入力に応じた文章を生成します。IBMの解説も、モデルを作る学習と、用途に合わせた調整、文章などの生成を区別しています。「返答が変わった」という観察だけでは、モデルそのものの学習が行われたとは判断できません。(出典: IBM)
この区別を知ると、AIへの頼み方も整理しやすくなります。今回の案内文を短くしたいのであれば、その条件を入力で伝えればよいでしょう。しかし、別の機会にも同じ条件が自動で引き継がれるかどうかは、今回うまく書き直せたことだけでは分かりません。「この回答に使えた情報」と「今後にも残る情報」を同じものとして扱わないことが、最初の手がかりになります。
「練習」と「本番」で考える学習と回答
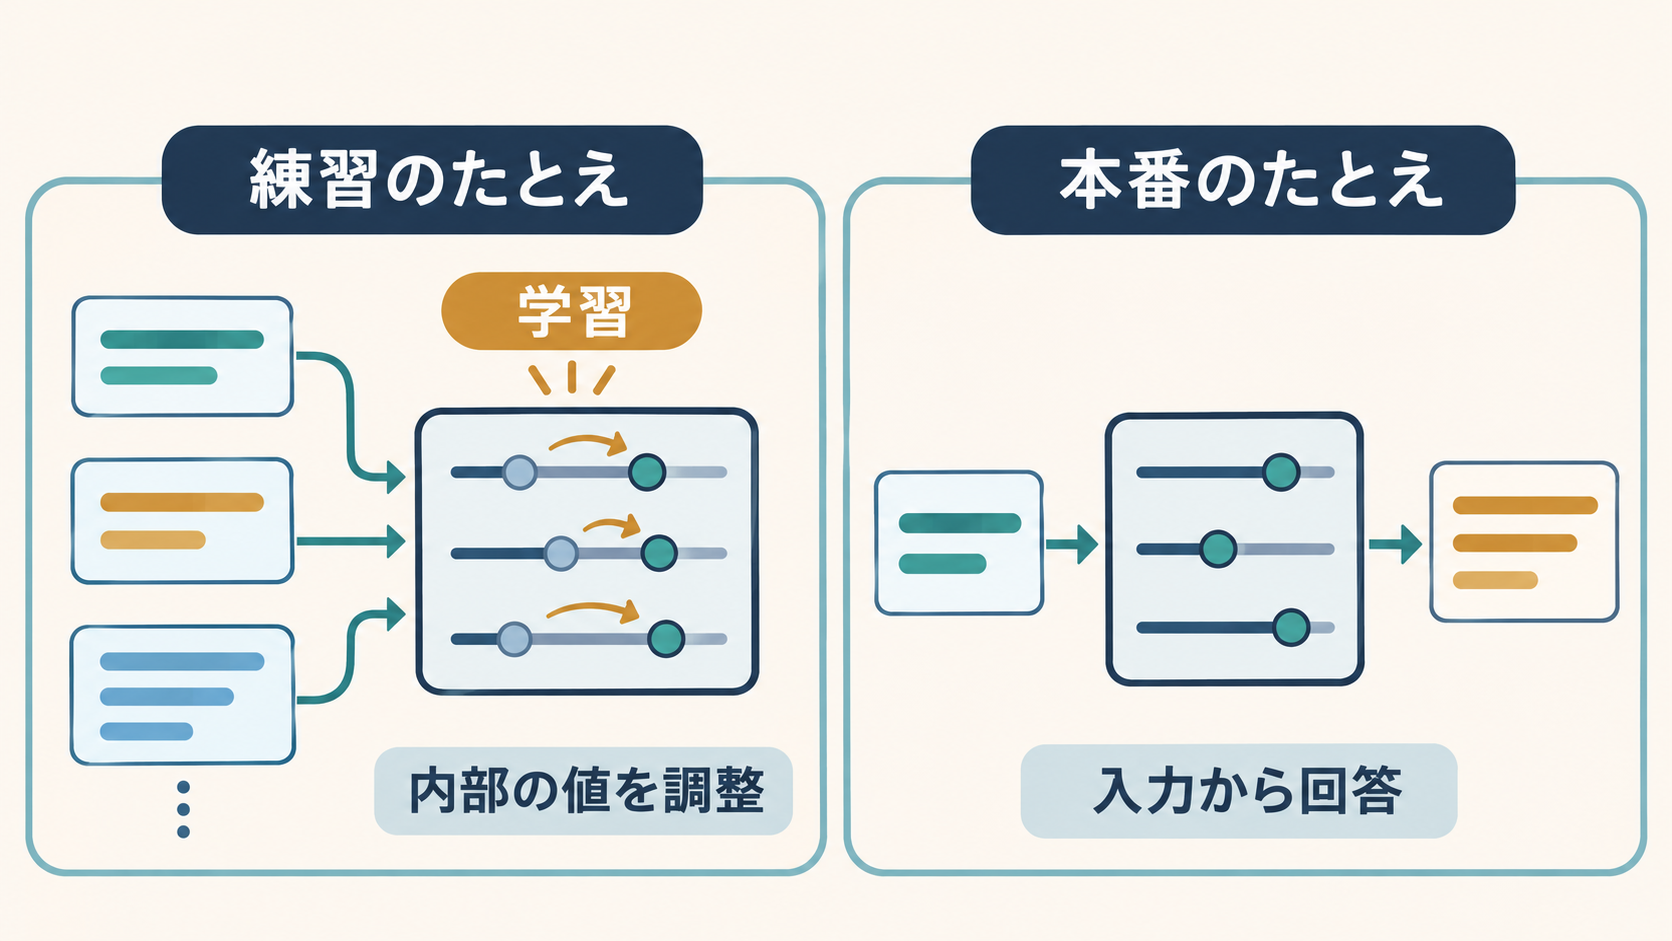
学習と回答の関係は、たとえとして「練習」と「本番」に置き換えると捉えやすくなります。さまざまな例を使って、入力と出力の関係を調整する工程が練習です。その結果としてできた仕組みを使い、新しい依頼に対応する工程が本番に当たります。これは工程の違いを説明するたとえであり、AIに人と同じ経験や意識があるという意味ではありません。
IBMによると、生成AIのモデルは、学習データに含まれるパターンや関係を表現し、それをもとに新しい内容を生成すると説明されています。したがって、学習を「回答の文章を一つずつ丸暗記して、質問が来たら取り出す作業」とだけ考えると、仕組みを捉えきれません。表現や関係のパターンを扱うための調整として見るほうが、この説明に沿っています。(出典: IBM)
モデルには「パラメーター」という、学習によって調整される内部の値があります。初心者のうちは、出力の傾向に関わる多数の調整値と捉えれば十分です。Googleの用語集では、ファインチューニングという追加の学習について、学習済みモデルのパラメーターを特定の用途に合わせて調整する工程だと説明されています。(出典: Google for Developers)
本番の依頼に「丁寧な文章にしてください」と条件を付けることと、練習の工程で内部の値を調整することは異なります。同じモデルを使っていても、与える材料や条件が違えば、回答の内容は変わり得ます。回答が変わったときは、すぐに「学習した」と捉えるのではなく、「今回の入力が変わったからではないか」と考えてみると、二つの工程を混同しにくくなるでしょう。
架空の案内文で見る、入力が回答を変える流れ
ここからは、町内の清掃活動を知らせる案内文を作る架空の例で考えます。実際にサービスを操作して得た結果ではなく、学習と回答の違いを理解するための例示です。日時や場所も説明用に設定しています。最初の依頼として、「清掃活動の案内を書いてください」とだけ入力した場合、読み手や開催条件について伝えた情報はほとんどありません。
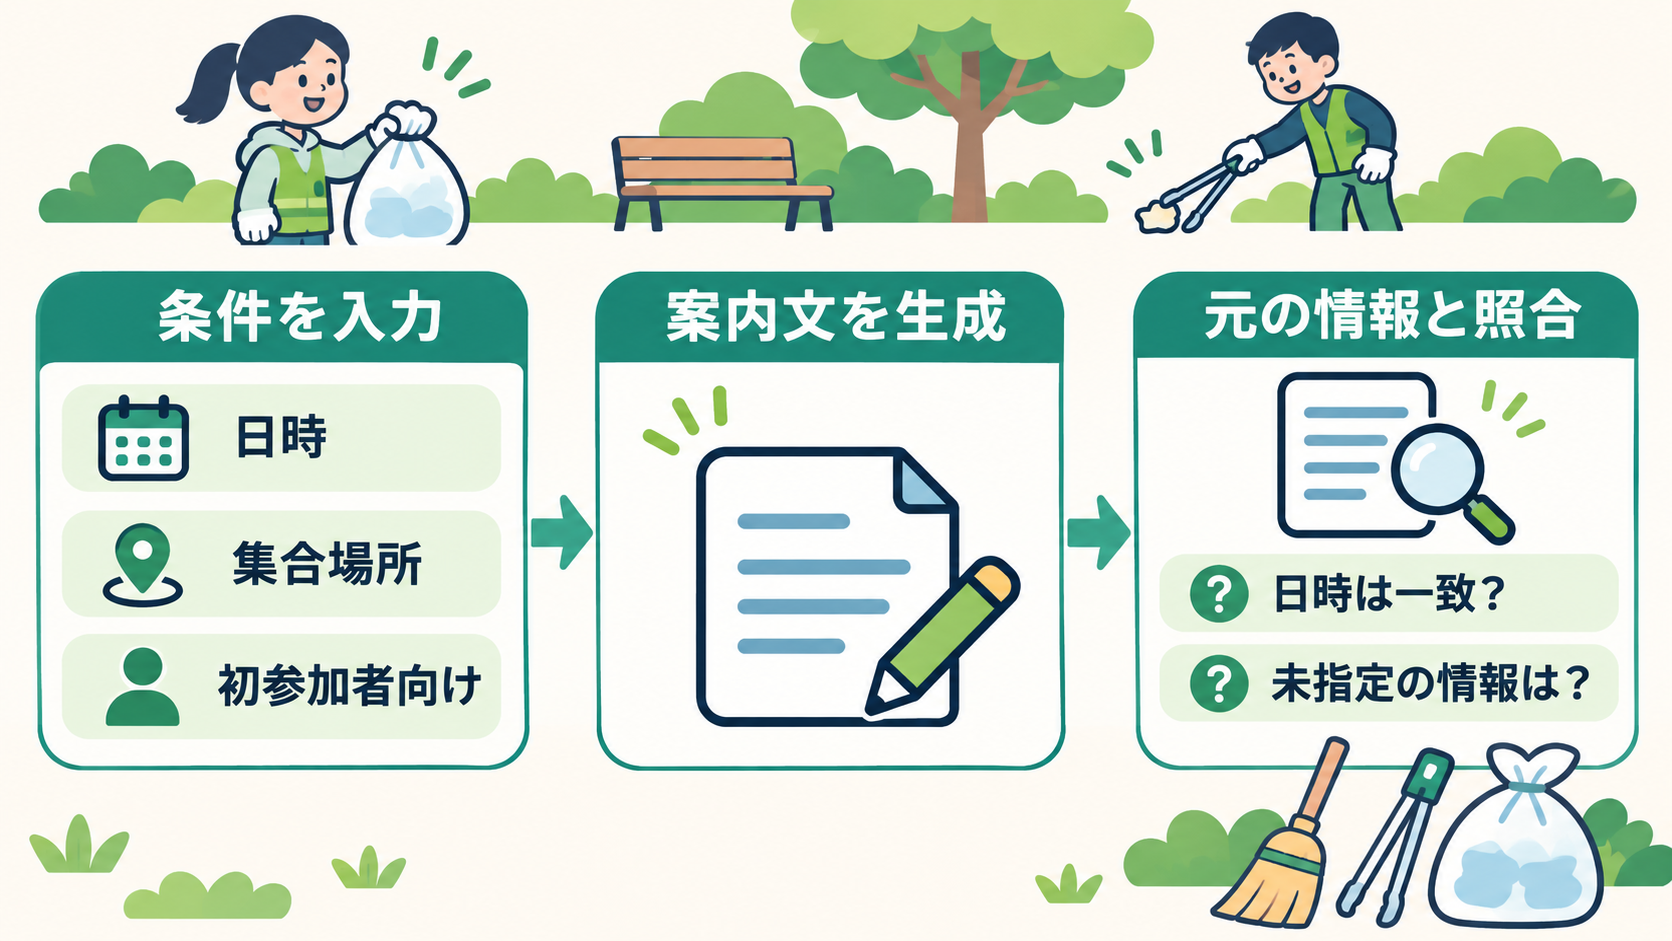
そこで、入力を次のように具体化することを提案します。「架空の案内文を作ってください。清掃活動は12月6日の午前9時から、集合場所は中央公園の入口です。初めて参加する人向けに、短く丁寧に書いてください。持ち物など、ここにない情報は補わないでください」。このようにAIへ渡す依頼や材料を「プロンプト」と呼びます。IBMも、生成AIを、利用者のプロンプトや依頼に応じて文章などを作るモデルとして説明しています。(出典: IBM)
続けて「日時と集合場所を冒頭にまとめてください」と伝える場面を想像してみてください。書き直した案内文で情報の順番が変わっても、それだけでモデルの追加学習が起きた証拠にはなりません。今回の依頼に、文章の並べ方という条件を加えたと整理できます。Googleの用語集では、チャットでの過去の入力や応答は、後に続くやり取りの文脈になると説明されています。(出典: Google for Developers)
確認する側にも、見るべき点が生まれます。指定した日時と集合場所が合っているか、伝えていない持ち物が加わっていないかを照らし合わせるとよいでしょう。「文章が自然だから完成」とするのではなく、渡した材料と回答を比べる使い方です。ここで扱っているのは、モデルの育成ではなく、一つの依頼に必要な条件を整える作業になります。
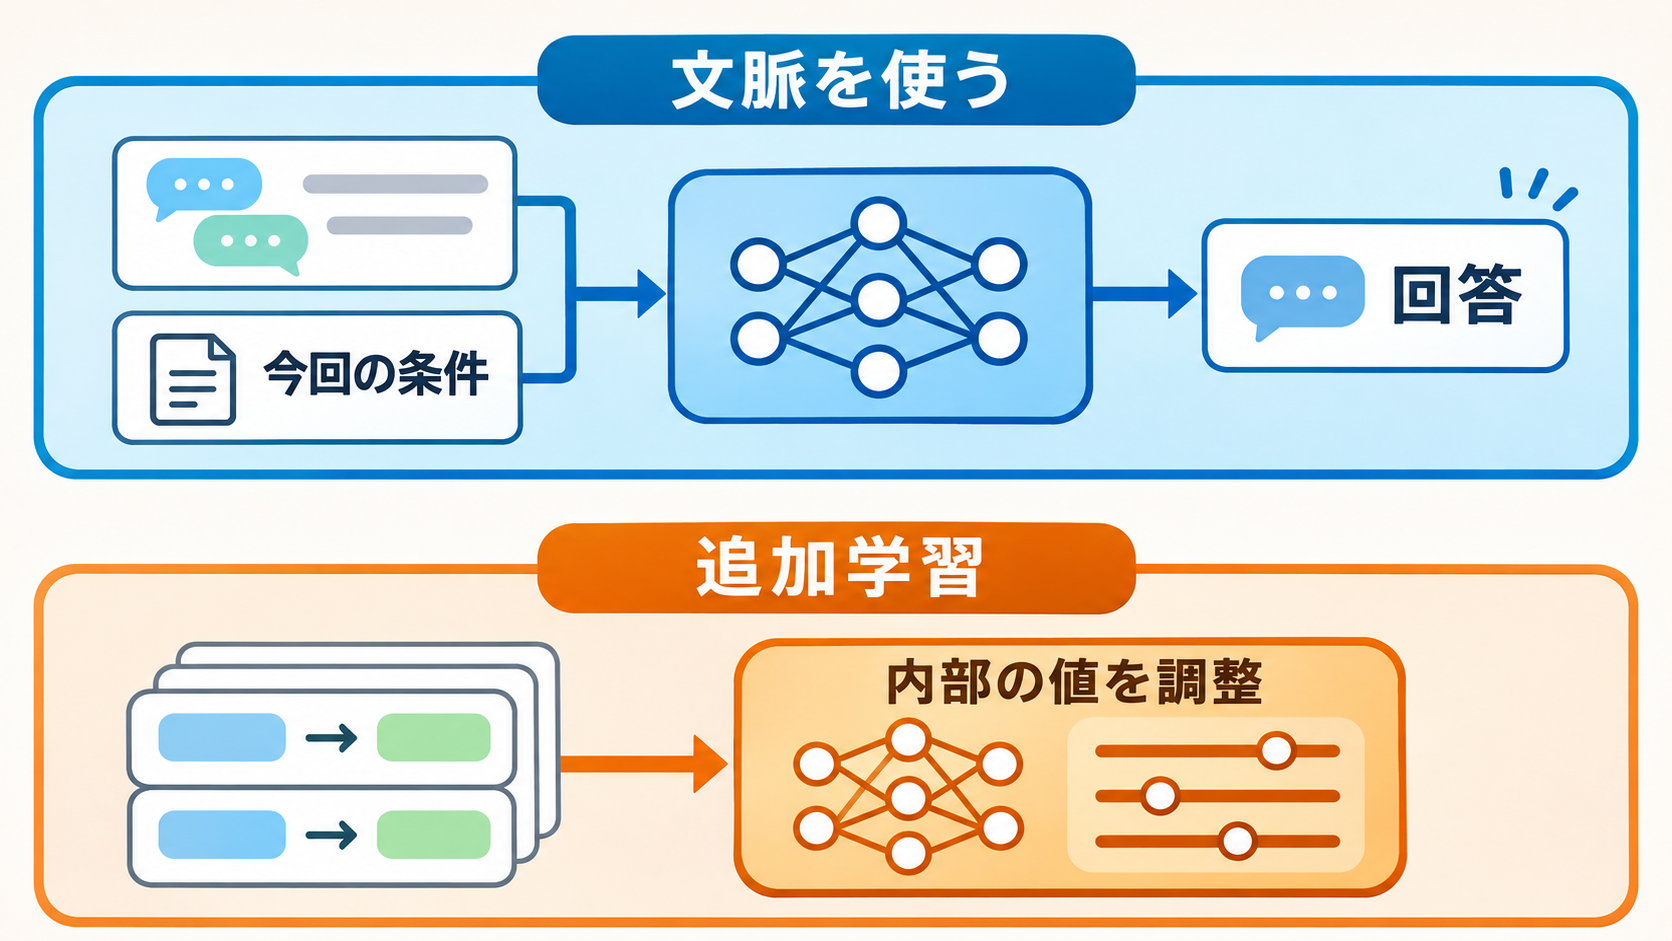
会話の文脈を使うことと、追加学習は別です
同じ会話の中で「先ほどの案内をもう少し柔らかくしてください」と頼めると、AIが前の内容を覚えたように見えるかもしれません。仕組みを考えるうえでは、まず「文脈」という言葉に置き換えてみましょう。文脈とは、この場合、今回の回答を作る際に手がかりとなる、それまでの入力や応答などの情報です。
Googleの用語集では、チャットの過去のやり取りが、その後のやり取りの文脈になると説明されています。また、「コンテキストウィンドウ」は、モデルが一つの入力で処理できる情報量に関わる概念として紹介されています。文脈を利用できることと、あらゆる過去の会話を無制限に参照できることは同じではありません。(出典: Google for Developers)
たとえるなら、手元のメモを見ながら文章を書くことと、練習によって文章の作り方を身につけることの違いです。メモに「初参加者向け」とあれば、それを今回の文章に反映できます。しかし、その場でメモを参照できたからといって、別の機会にも同じ条件が必ず使われるとは限りません。このたとえでも、注目するのは情報を使う場所の違いです。
追加学習については、Googleの用語集が、学習済みモデルに対する用途別の学習工程として説明しています。会話の材料を参照する処理とは、区別して理解する必要があります。(出典: Google for Developers)
実用上は、重要な条件を「前に伝えたはず」で済ませないことを提案します。案内文を改めて依頼するときは、日時、対象者、文体など、欠かせない条件を依頼に含めると確認しやすくなるでしょう。「ずっと覚えているか」を推測するよりも、「今回使ってほしい条件を渡せているか」に目を向ける考え方です。
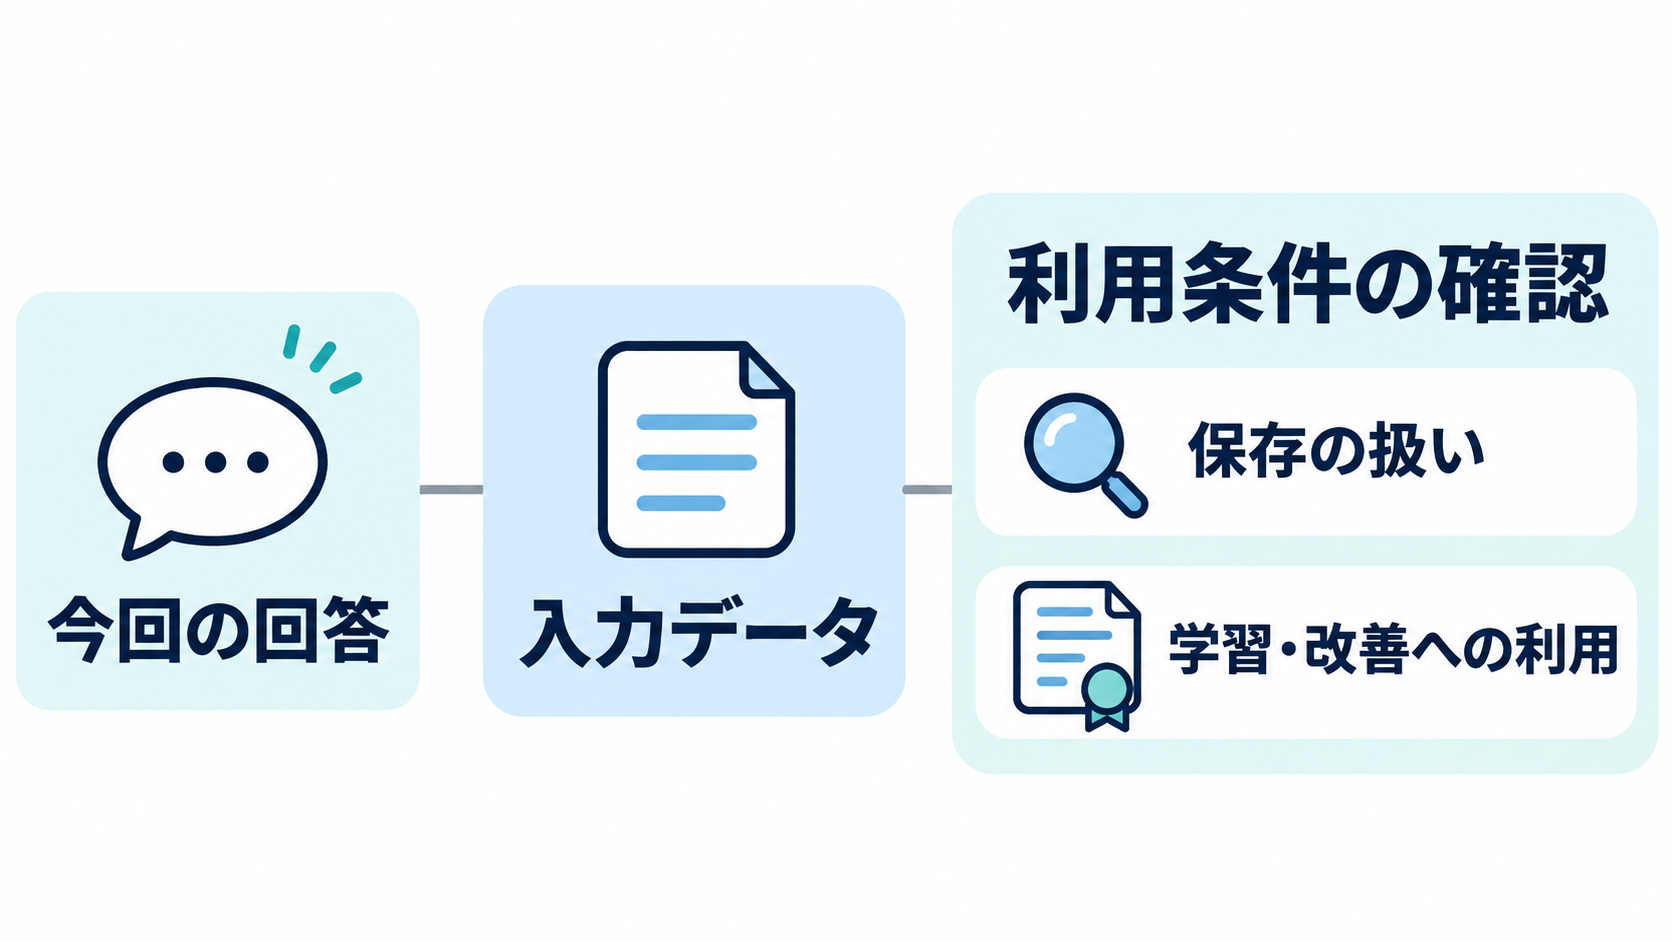
入力が将来の学習に使われるかは、別に確認します
「会話への反映は追加学習と別です」と聞くと、「それなら、入力した内容が将来の学習に使われることもないのでしょうか」という疑問が残ります。ここでは、もう一度、問いを分ける必要があります。今回の回答がどの情報を使って作られたかという問いと、サービス側が入力データを後からどう利用するかという問いは、それぞれ別の確認事項です。
提示された公式資料からは、学習、モデルの調整、生成という工程の違いや、チャットのやり取りが文脈になることを確認できます。ただし、特定のサービスに入力した文章が保存されるか、将来の学習に使われるか、利用者がどの条件を選べるかについて、この資料だけで一律に判断することはできません。工程の一般的な説明を、個別サービスのデータ利用条件へそのまま当てはめないようにしましょう。(出典: IBM、Google for Developers)
確認するときは、使うサービスの公式なデータ利用説明やプライバシーに関する案内を読むことを提案します。その際は、「回答を作るための利用」「保存の扱い」「モデルの学習や改善への利用」を分けて探すと、知りたい条件を整理しやすくなります。これは確認の観点の提案であり、特定のサービスに同名の設定項目や操作画面があるという説明ではありません。
職場の資料を使う場合は、所属先が定めた利用ルールとも照らし合わせてください。たとえば案内文の練習であれば、実在する参加者の氏名を入れず、架空の日時や場所だけで試す進め方も選べます。AIが目の前の指示に対応したかどうかを確かめるために、必ずしも実際の個人情報を使う必要はありません。入力前に確認する対象を決めておけば、「学習」という言葉だけを頼りに判断せずに済むでしょう。
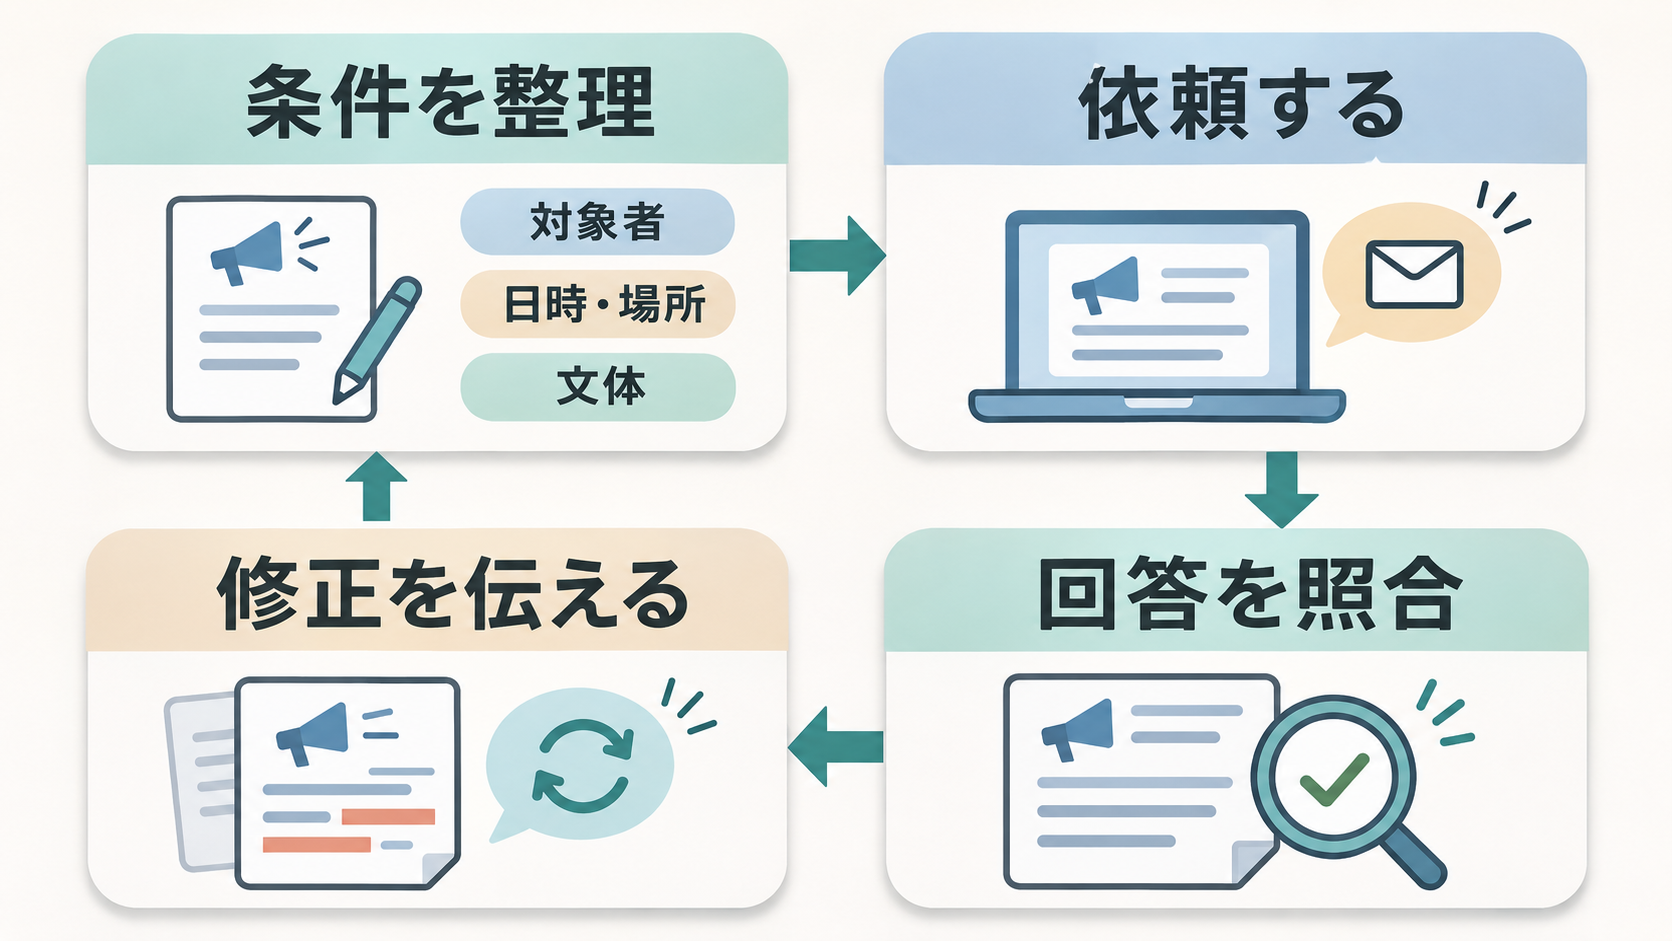
明日からは「学習させる」より、今回の条件を整えます
案内文の依頼に戻ると、明日から試せる一歩は具体的です。「AIに自分の好みを学習させよう」と考える前に、今回ほしい文章の条件を書き出してみてください。誰に届けるのか、必ず入れる事実は何か、どんな長さや文体にするのかを整理する方法です。これはモデルを調整する作業ではなく、回答の材料となる入力を整えるための提案になります。
たとえば、架空の清掃活動の案内なら、「初参加者向け」「日時と集合場所を先に記載」「短く丁寧に」「未指定の情報を加えない」という条件を用意できます。回答を受け取った後も、「何となく違う」ではなく、「集合場所を最初の段落へ移してください」のように、直したい箇所を伝えると、依頼と確認の対応が分かりやすくなるでしょう。ただし、この頼み方が必ず正しい回答を生むという意味ではありません。
考え方の土台は、学習で作られたモデルを使い、入力に応じて内容を生成するという区別です。IBMの解説は、生成AIの学習と生成を別の段階として説明しています。また、Googleの用語集では、過去の会話が後の回答の文脈になることが示されています。こうした説明から、会話中の改善を理解する際には、モデルの変化だけでなく、渡した条件や文脈の変化を見る必要があると整理できます。(出典: IBM、Google for Developers)
最初の練習には、個人情報を含まない短い架空の案内文が向いているでしょう。依頼文と回答を並べ、指定した条件がどこに反映されたか、反映されなかった点はどこかを一つずつ確認してみてください。そこで見るのは、AIが自分をどれだけ覚えたかではありません。今回の材料で何が出力され、どこを人が確かめる必要があるかです。その見方があれば、次に伝える指示も具体的になります。
参考情報
以下は本記事で使用した公式資料です。資料の取得日時は2026年11月16日です。IBMの記事には公開日が2024年8月9日、更新日が2026年10月2日と記載されており、取得日とは区別しています。本記事は基礎概念を説明するもので、取得日に新機能が発表されたという紹介ではありません。
- What Is Artificial Intelligence (AI)? | IBM
- AI vs. Machine Learning: How Do They Differ? | Google Cloud
- Glossar für maschinelles Lernen: Generative KI | Google for Developers