

2026/11/12
AIニュース
GoogleのOpenRL、強化学習をKubernetesのワークロードへ――実験と基盤運用を切り分ける狙い
この記事の要点
GoogleのOpenRLは、強化学習の実験とKubernetes上の計算基盤管理を切り分ける仕組みです。開発の背景とサンドボックスの役割を整理し、企業が導入前に定めたい評価条件を考察します。
目次
強化学習で膨らむ、モデル開発以外の仕事
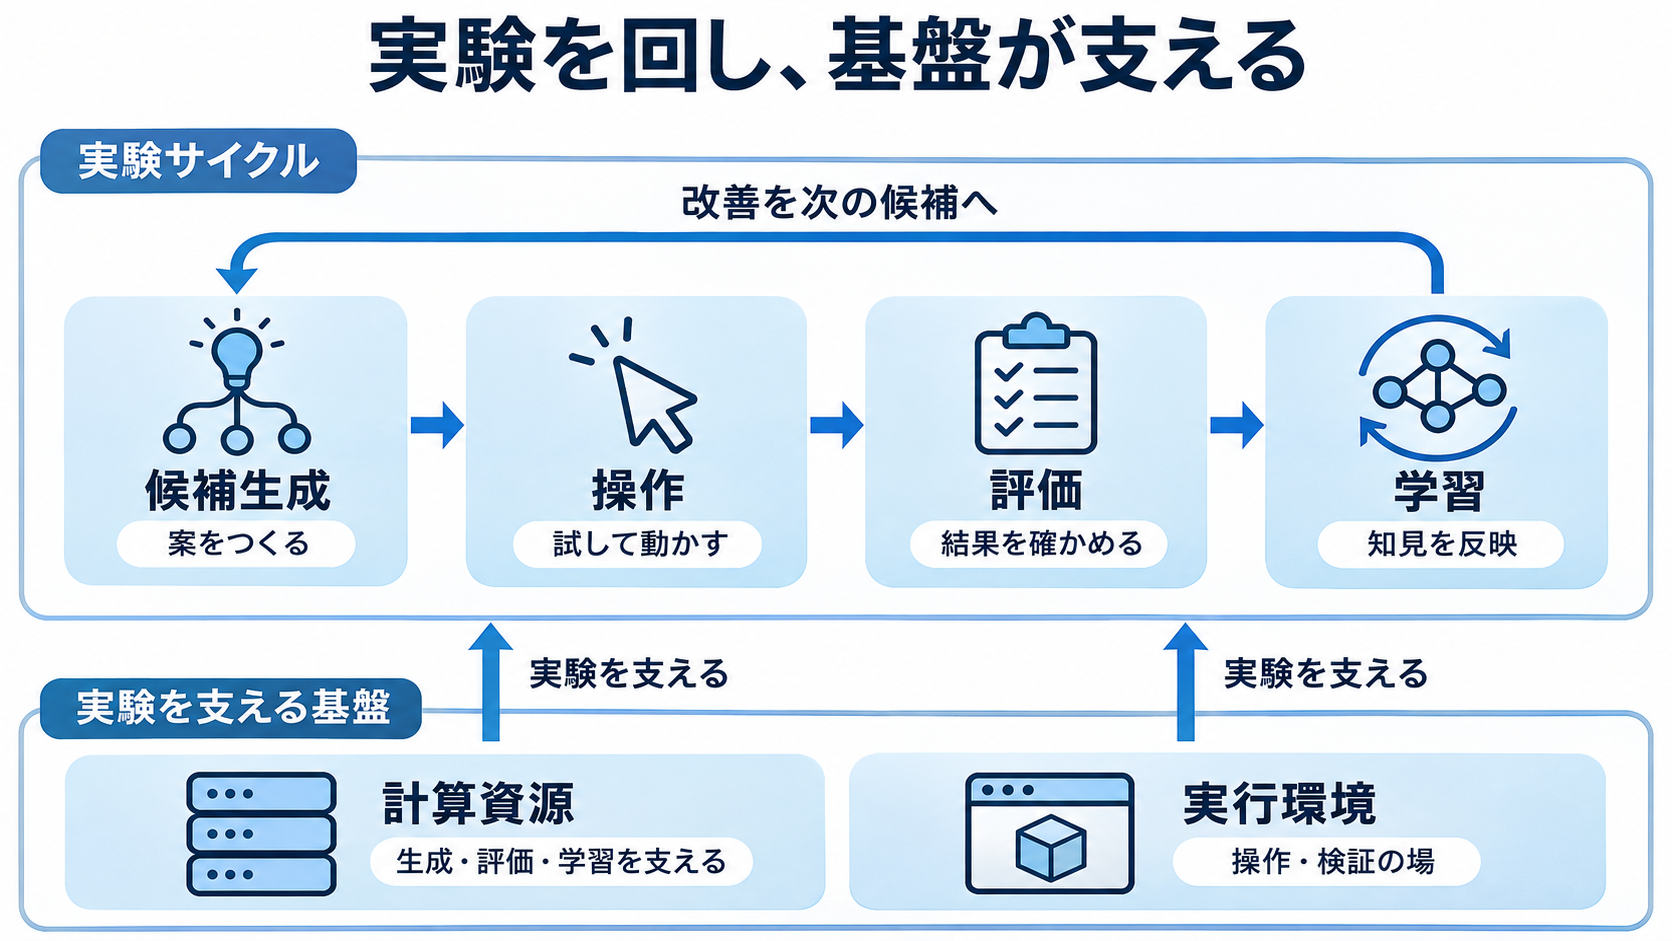
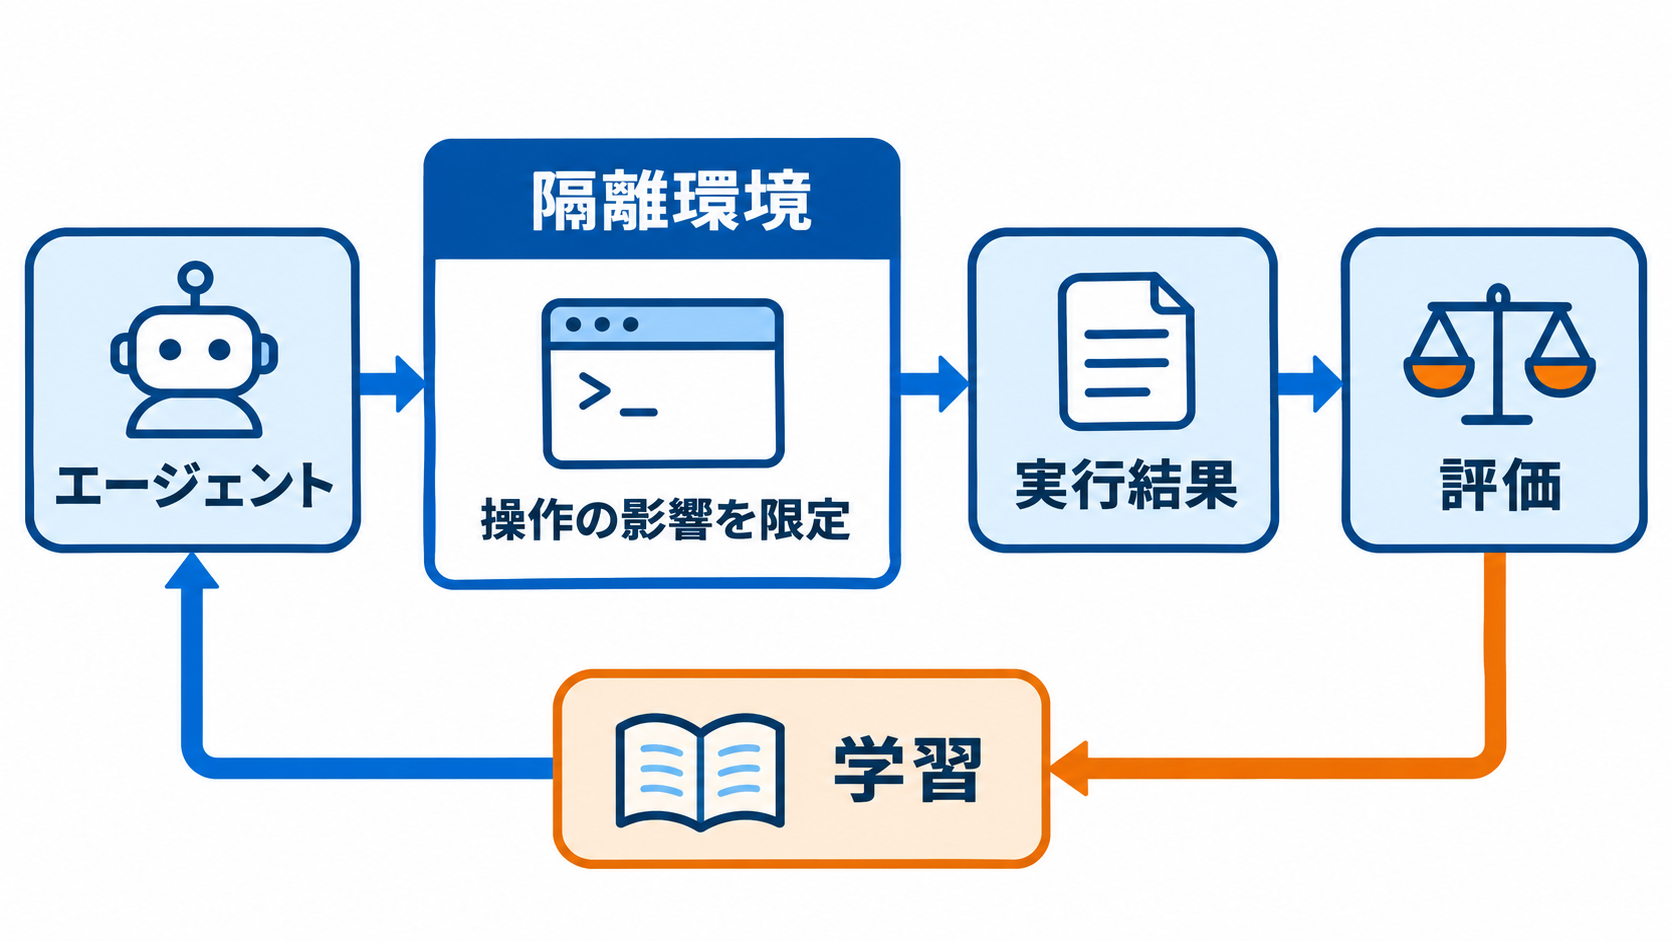
AIエージェントを業務に合わせて調整しようとすると、モデルを学習させるだけでは済みません。回答や行動の候補を生成し、隔離された環境で実行し、その結果を評価して学習へ戻す必要があります。GoogleのGKE Labsが取り組んでいるのは、この一連の処理を支える基盤の問題です。中心となるOpenRLは、強化学習の実験と計算資源の運用を切り分け、企業が自社のKubernetesクラスタで学習を進めるための仕組みとして紹介されています。
Kubernetesは、コンテナ化したアプリケーションの配置や稼働を管理する基盤です。ただし、その上で強化学習を動かせば、研究と運用の境界が自然に整理されるわけではありません。Google Cloudのシニアソフトウェアエンジニア、Sunil Arora氏は、研究用コードと、その下で動くシステムが絡み合いやすい点を課題として挙げています。実験を変えるたびに基盤側の調整まで必要になれば、モデル改善に集中しにくくなるでしょう。
Arora氏が強化学習をAIの「スーパーアプリ」のように捉える理由も、処理の多様さにあります。学習、サンプリング、エージェントによる操作、結果の評価が同じループに含まれるためです。生成AIの基盤を考える際には、モデル単体の性能だけでなく、異なる処理をどう連携させるかが問われます。OpenRLの狙いを理解するうえでも、注目したいのは学習手法そのものの新しさより、実験を支える仕事の分担です。
Kubernetes向けエージェントから生まれたOpenRL
OpenRLの出発点は、強化学習基盤を単独で設計することではありませんでした。GoogleのKubernetesエンジニアリング部門は、Kubernetesの作業を行うAIエージェントを開発し、その仕事をモデルがどれだけ適切にこなせるかを測るベンチマークへと取り組みを広げたと説明しています。実際に作業させ、結果を測ろうとする過程で、学習や評価を支える仕組みが必要になった流れです。
この経緯は、企業がAIエージェントを導入する場合にも参考になります。自然な文章を返せることと、運用作業を正しく完了できることは同じではありません。作業の対象、成功の条件、実行後の状態を定めなければ、モデル同士を比較する基準も曖昧になります。Googleの取り組みでは、エージェントの開発に続いて評価のためのベンチマークが必要になった点が、基盤整備の背景として読み取れます。
GKE Labsは、実験段階のプロジェクトを早期に利用者へ届ける取り組みとして紹介されています。OpenRLは2026年6月にリサーチプレビューとして登場し、11月11日付の報道では、GoogleがCloud Native Computing Foundationへ寄贈したと伝えられています。同財団は、Kubernetesをはじめとするクラウドネイティブ技術のプロジェクトを支える組織です。ただし、寄贈の事実だけで、企業向けの運用保証や製品としての成熟度まで判断することはできません。検討時には、実験的な取り組みとしての位置づけと、自社が求める運用条件を分けて確認する必要があります。
学習APIが切り分ける、研究とインフラの責任
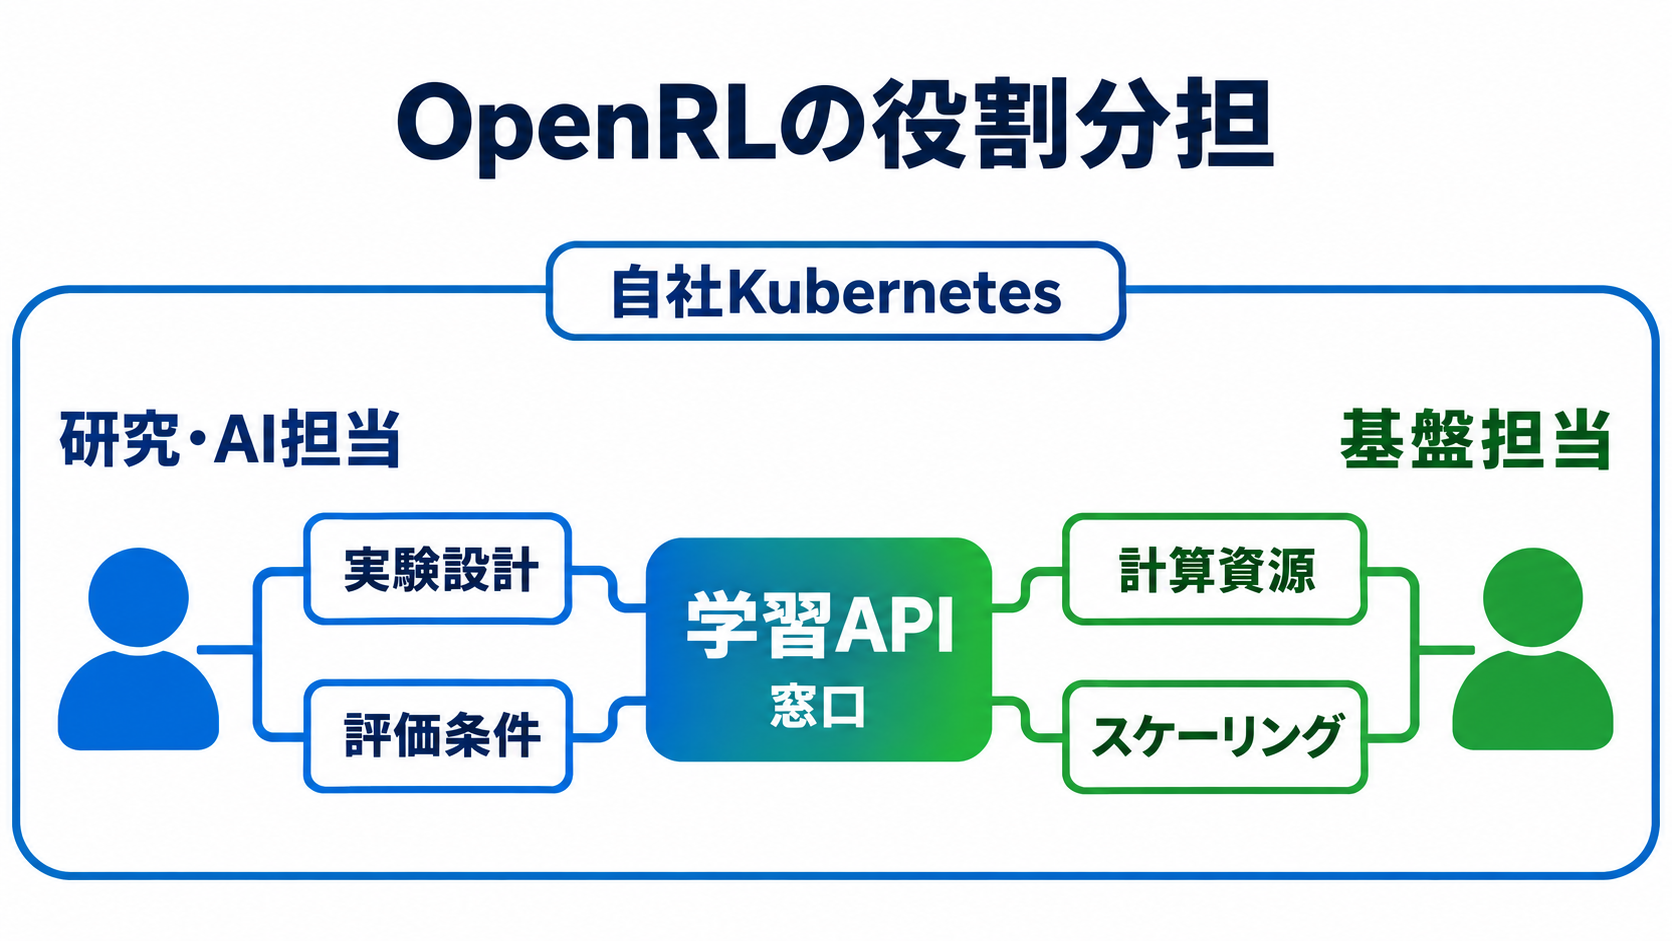
OpenRLは、企業自身のKubernetesクラスタ上で利用する、セルフホスト型の学習APIを提供すると説明されています。セルフホストとは、利用者側で実行環境を用意して運用する形態です。ここでの要点は、強化学習のループと、その実行を支える計算資源の管理を分離する設計にあります。Arora氏によると、研究者やAIエンジニアは実験を制御し、インフラエンジニアはスケーリングを担当するという役割分担を目指しています。
APIは、ソフトウェア同士が処理を依頼し、結果を受け取るための窓口です。学習に必要な基盤機能を共通の窓口から扱えるようにすれば、実験コードが個別の運用手順を抱え込む範囲を減らせると考えられます。たとえば、何を成功と評価するかを変える作業と、実行に必要な計算資源を増減する作業では、判断する内容も担当者の専門性も異なるでしょう。両者の接点を整理することが、OpenRLの設計意図です。
ただし、基盤を抽象化することは、運用の責任がなくなることを意味しません。企業が自らクラスタを運用するなら、利用可能な資源や権限、障害時の対応といった条件は引き続き検討対象になります。今回紹介された情報だけでは、これらをOpenRLがどこまで扱うかは明らかではありません。導入判断では、APIの使いやすさに加え、実験の変更が基盤担当者へどのような作業を発生させるかを見ると、役割分担が実際に改善するかを評価しやすくなるはずです。
サンドボックスが、行動するAIの評価を支える
AIエージェントの学習では、出力した文章を読むだけでは結果を評価できない場合があります。コマンドを実行するエージェントなら、実際に操作させ、その後の状態を確かめる工程が必要になるためです。Arora氏は、報酬の計算に数百万回規模の隔離されたコマンド実行が伴う場合があると説明しています。これはOpenRLの実測処理件数として示された数字ではなく、強化学習基盤が扱う負荷の性質を説明するものです。
ここで使われるサンドボックスは、操作の影響を限定するための隔離環境です。Googleの開発者Justin Santa Barbara氏は、Kubernetesを操作するAIツールのkubectl-aiを開発した際、理論上はハードディスクを初期化するような操作も起こり得ると考えたと話しています。同氏が求めたのは、仮にそのような操作が行われても、影響をサンドボックスの中にとどめられる環境でした。これは事故の発生報告ではなく、実行環境を隔離する必要性を示す説明です。
サンドボックスは、安全性のための付加機能であると同時に、学習を繰り返すための実行単位でもあります。試行回数が増えるほど、隔離環境を限られた計算資源でどれだけ効率よく動かせるかが問題になるでしょう。GoogleのAgent Substrateは、より多くのサンドボックスを限られた計算資源に収容するための仕組みとして紹介されています。ただし、具体的な収容数や削減率は示されていません。効率の向上という方向性と、その効果を裏づける数値は分けて受け止める必要があります。
基盤の価値は、学習だけでなく試行全体で測る
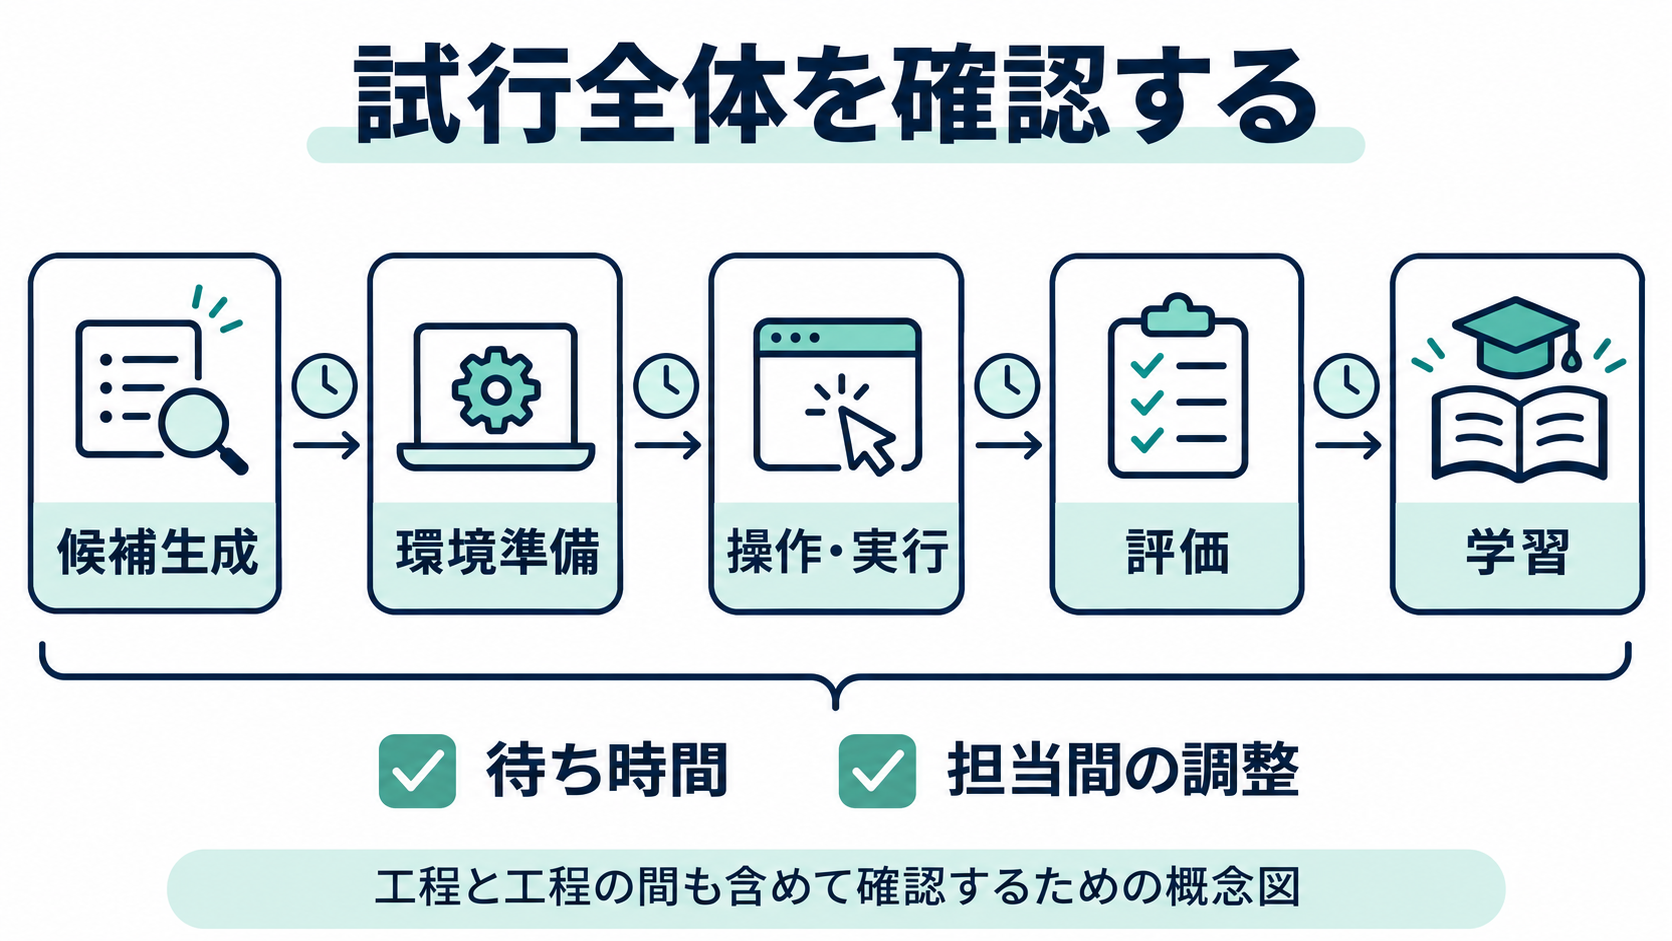
OpenRLの取り組みから見えてくるのは、強化学習の効率を、学習処理だけで評価する難しさです。モデルが候補を生成しても、実行環境の準備や結果の評価が追いつかなければ、次の学習へ進めません。逆に、多数の試行を実行できても、評価基準が適切でなければ、目的とするモデル改善につながるとは限らないでしょう。これは特定製品の性能を示す主張ではなく、複数の工程を組み合わせる仕組みとして捉えた場合の考察です。
企業の投資判断でも、計算資源の性能や単価だけでは見えない作業があります。実験のたびに環境を調整する時間、失敗した試行を調べる手間、担当チーム間で条件をすり合わせる負担などです。OpenRLが掲げる研究と基盤の分離は、こうした接点を整理する方向と理解できます。ただし、導入すれば必ず開発期間や費用を削減できるとまでは、公開された説明から判断できません。
比較する際には、学習、候補生成、隔離環境での実行、評価という工程ごとに、処理時間と担当範囲を整理する方法が考えられます。どこで待ちが生じ、どの変更に誰の対応が必要なのかが分かれば、共通基盤に求める条件も具体化するはずです。OpenRLは、強化学習をKubernetes上のワークロードとして扱う方向を示しています。その実務上の価値は、既存の運用体制に組み込んだとき、実験を繰り返す際の負担をどこまで減らせるかで評価するのが適切です。
日本企業は、学習基盤より先に「成功の条件」を決める
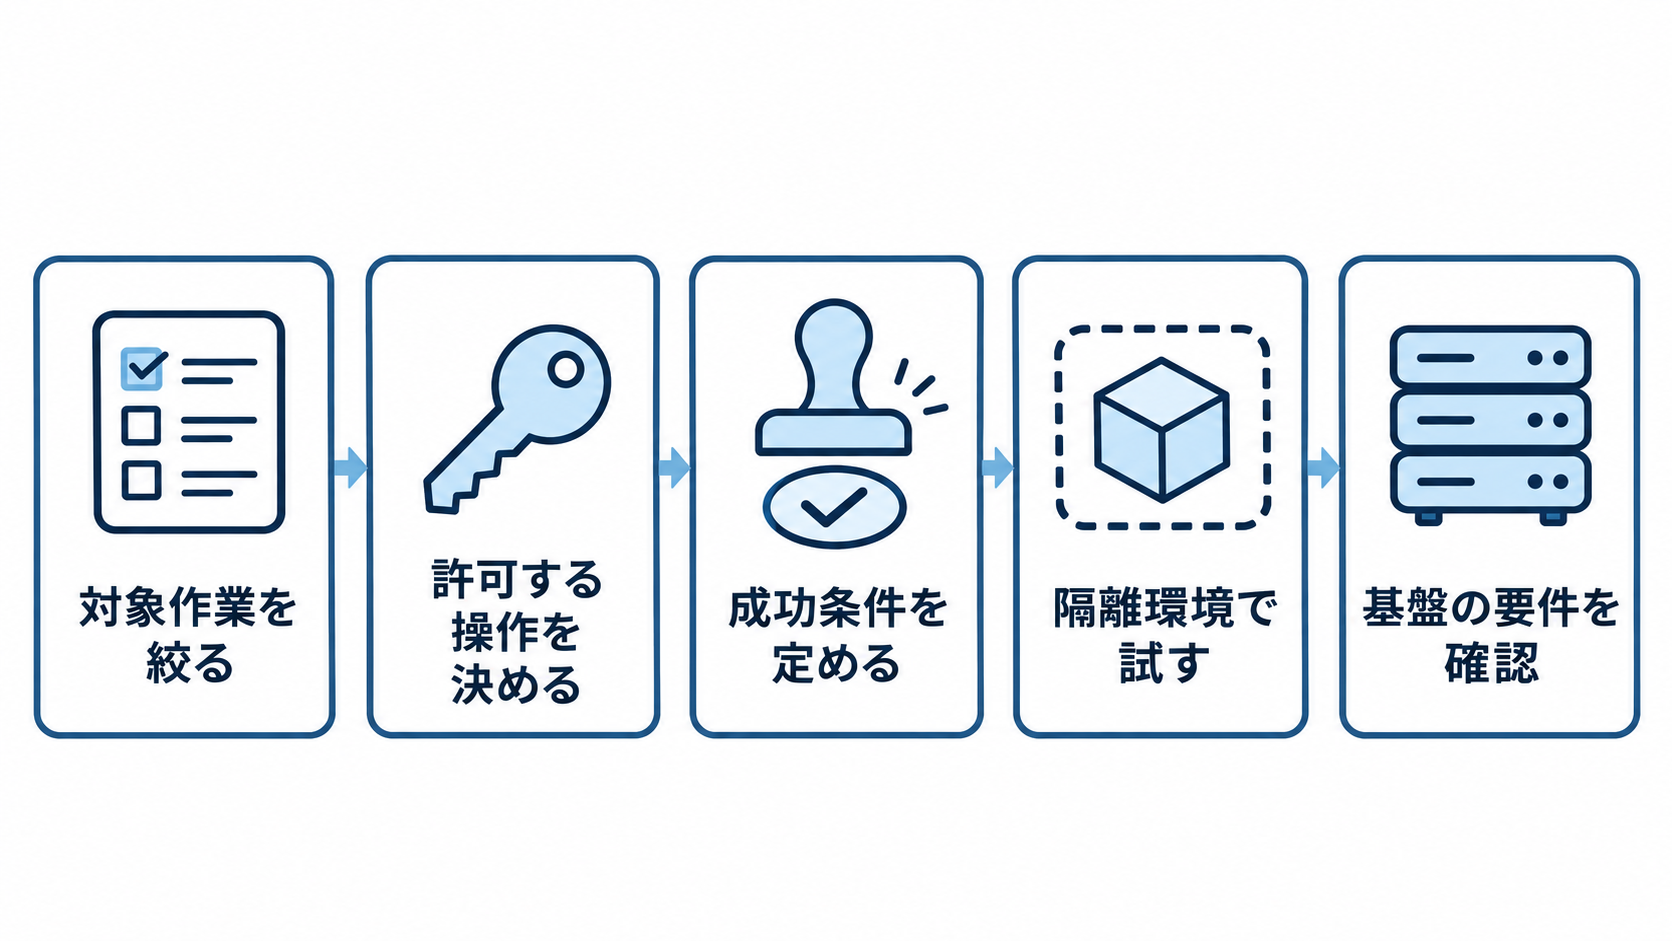
日本企業がこの取り組みを参考にするなら、最初の検討対象は、エージェントに任せたい作業と、その成功をどう確認するかです。たとえば、Kubernetesの運用支援を想定する場合でも、状態を調べる作業と、設定を変更する作業では必要な権限や確認方法が異なります。これは導入を考えるための例であり、Googleが公開した具体的な業務手順ではありません。対象を絞ることで、評価用の環境に何を再現すべきかを考えやすくなるでしょう。
強化学習における報酬は、モデルの行動や結果に対して与える評価です。そのため、望ましい結果を曖昧にしたまま試行回数を増やしても、業務上求める改善が得られるとは限りません。作業が完了したかだけでなく、許可された範囲で実行したか、結果を確認できるかといった観点を、対象業務に応じて決める必要があります。Googleがエージェント開発からベンチマークへ進んだ経緯は、評価の設計が基盤選びと切り離せないことを考える手がかりになります。
着手するなら、一つの限定した作業について、入力、許可する操作、成功条件、失敗時に確認する記録を書き出すところから始められます。そのうえで、隔離環境を何度も用意する負担や、実験担当者と基盤担当者の調整が課題になっているかを確認するとよいでしょう。OpenRLのような仕組みを検討する理由が、自社の作業と結びつきます。なお、今回の取材番組はGoogle Cloudの協賛で制作されており、SiliconANGLEは協賛企業に編集権はないと明記しています。紹介された設計意図を手がかりにしつつ、自社で確かめたい運用条件を先に定めることが、具体的な次の一歩になります。