
AI LAB
2026/10/21
AI推論の「遅い」を分解する――TorchNeuronの計測で見えたカーネル融合の効果
高速化の出発点は、処理時間の所在を突き止めること
AIモデルの推論が遅いとき、演算精度を下げる、ハードウェアを増やす、コードを書き換えるといった対策をすぐに試したくなります。しかし、待ち時間がCPU側の処理、アクセラレーター上の演算、データ転送、実行スケジュールのどこで発生しているのかを把握しなければ、変更の効果を正しく評価できません。高速化の前に必要なのは、推測ではなく計測です。Amazonの技術解説では、深層学習向けAIチップのAWS Trainiumと、そのPyTorchバックエンドであるTorchNeuronを使い、推論処理を体系的にプロファイリングしています。題材はRMSNormという比較的小さな演算です。同じ計算を素朴なPyTorchコード、組み込みの融合演算、`torch.compile`でコンパイルしたコードの3通りで実行し、CPUとNeuronCoreの両面から処理時間を追跡しています。
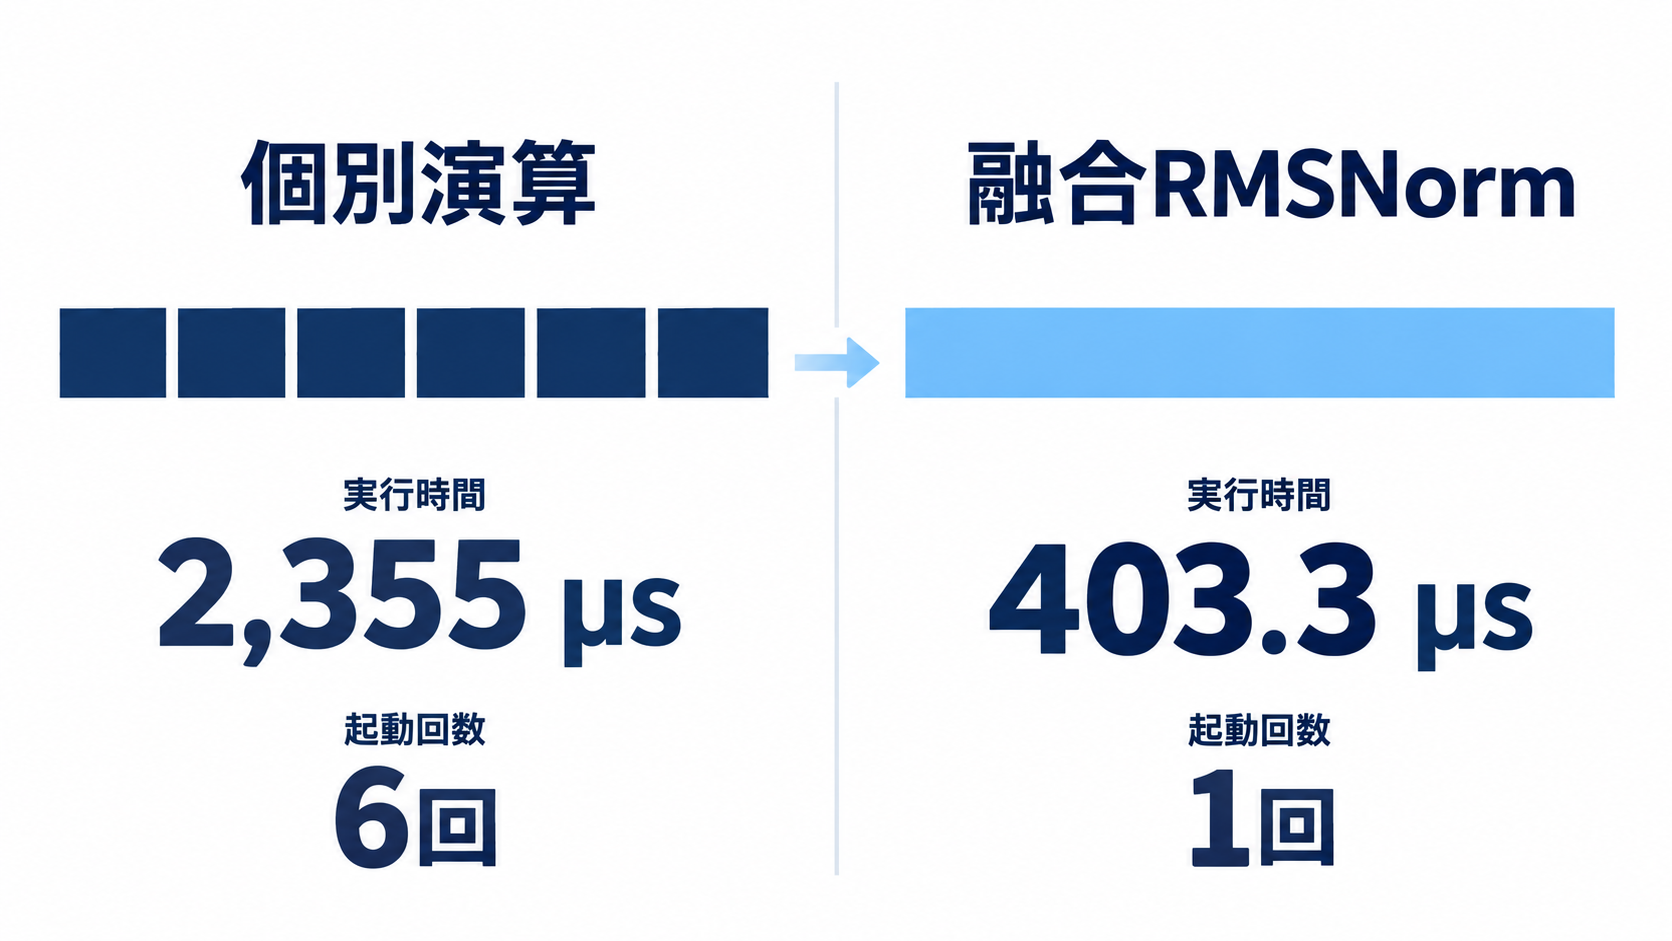
測定では、個別の演算を順番に実行した実装がNeuronデバイス上で2,355マイクロ秒を要したのに対し、組み込みの`torch.rms_norm`は403.3マイクロ秒、`torch.compile`版は375.5マイクロ秒でした。後者の2方式は、どちらも処理を1回のハードウェア実行へまとめています。単に演算回数が減ったのではなく、実行要求を何度も受け渡す負担や、中間値を個別に生成する処理が抑えられた点が重要です。
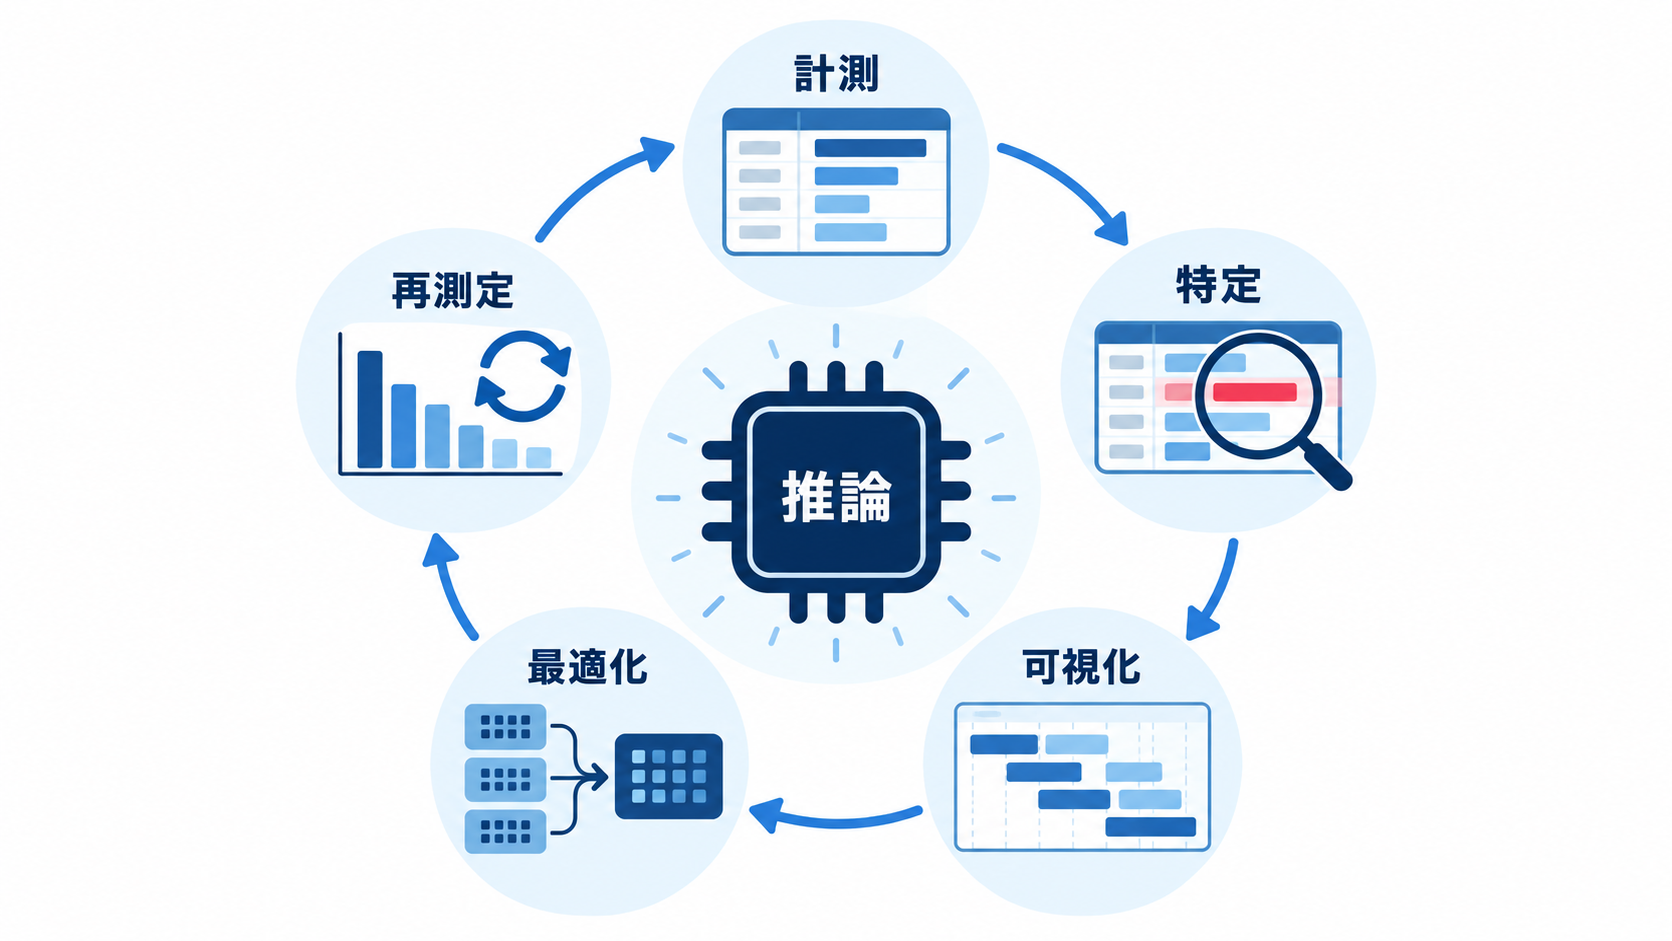
これらは特定の入力と実行環境で得られた測定値であり、あらゆるモデルに同じ倍率が当てはまるわけではありません。それでも、「どの演算が遅いか」を表で絞り込み、「なぜ遅いか」をタイムラインで確認し、融合やコンパイルの効果を再測定する流れは、より大きな生成AIモデルにも応用できるでしょう。
PyTorchからNeuronCoreへ届くまでの仕組み
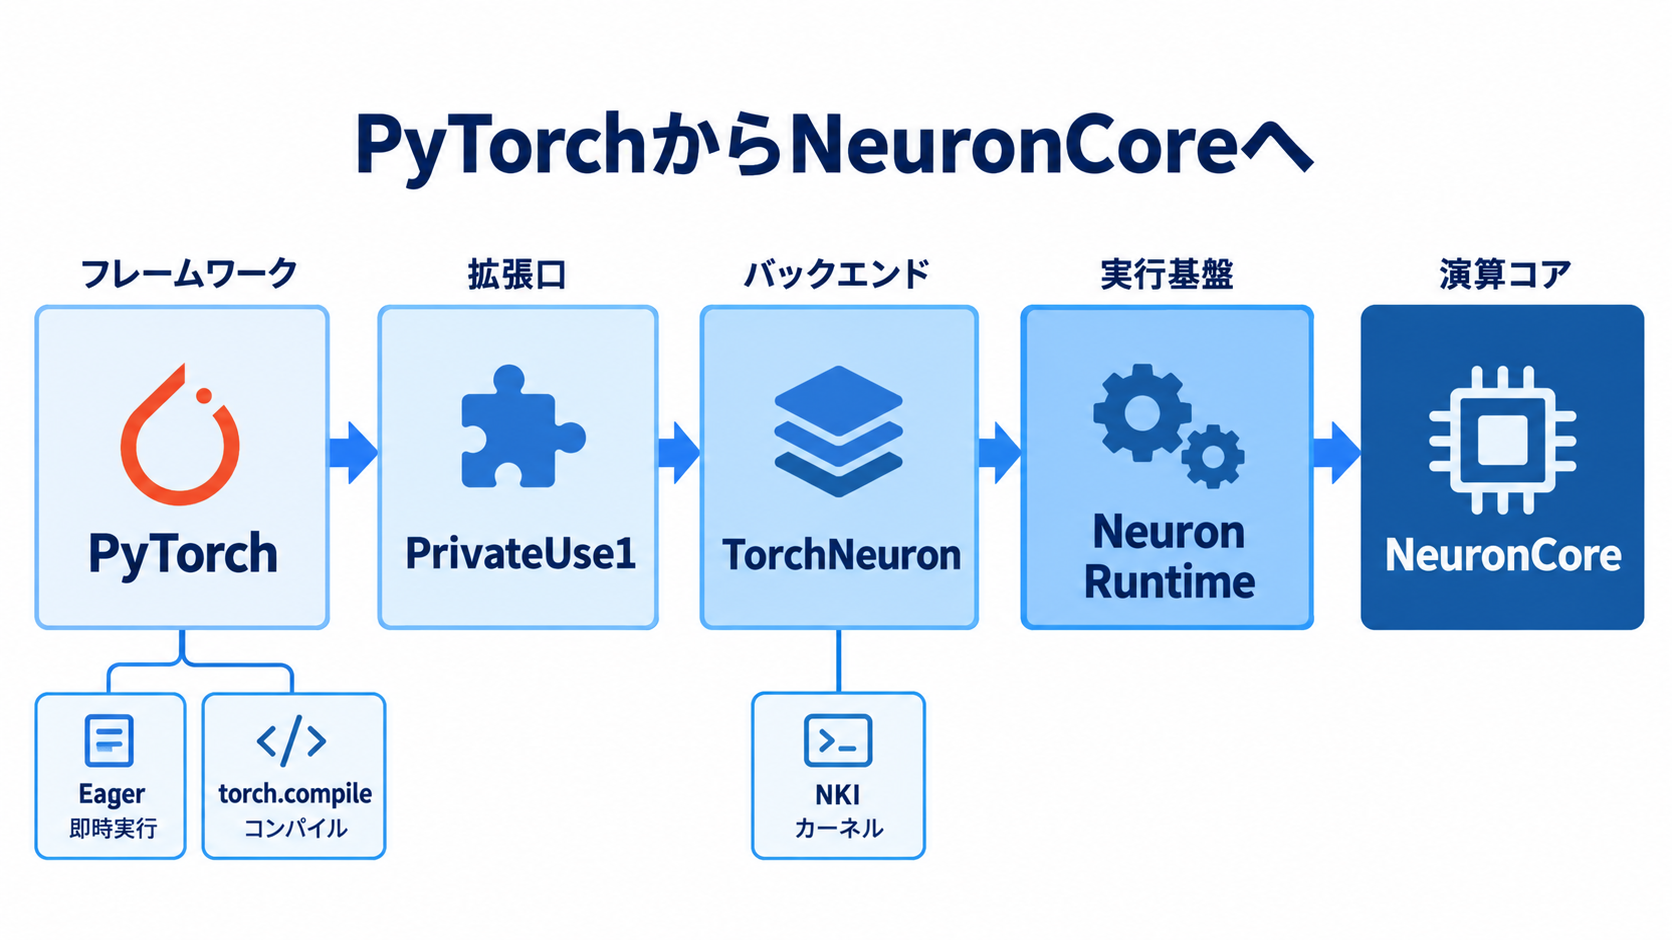
TorchNeuronは、標準PyTorchが備える`PrivateUse1`という拡張ポイントを利用してTrainiumをバックエンドとして登録します。CUDAのような専用のディスパッチキーをPyTorch本体へ追加しなくても、外部のアクセラレーターをフレームワークへ統合できる仕組みです。`torch_neuronx`パッケージを導入すると、通常のPyTorch APIやEager実行、`torch.compile`を大きく書き換えずにNeuronデバイスへ接続できます。アプリケーションから呼ばれた演算は、PyTorchのフレームワーク層、Neuron Runtimeのスケジューリング、NeuronCore上のハードウェア実行という複数の段階を通過します。コード上では1行に見える処理でも、その背後では演算のディスパッチ、実行準備、デバイスへの投入が行われます。この階層を意識すると、CPU時間とデバイス時間が異なる理由や、演算間に空白時間が生じる理由を理解しやすくなります。
TorchNeuronはNeuron Kernel Interface(NKI)とも統合されています。NKIは、Trainium向けのカスタム演算やハードウェアを意識した最適化を行うためのインターフェースです。ただし、最初からカスタムカーネルへ進む必要はありません。既存の融合演算やコンパイラによる最適化でボトルネックを解消できる可能性があるため、計測結果に応じて手段を選ぶのが合理的です。
企業で生成AI基盤を運用する場合、この構造は責任範囲の整理にも役立ちます。モデル実装に由来する問題なのか、ランタイムで待たされているのか、ハードウェア上の演算そのものが重いのかによって、担当者と対策が変わるからです。プロファイルは性能改善の資料であると同時に、アプリケーション、ML基盤、インフラの各チームが共通の事実を見ながら判断するための材料になります。
CPU時間とデバイス時間を同時に記録する設定
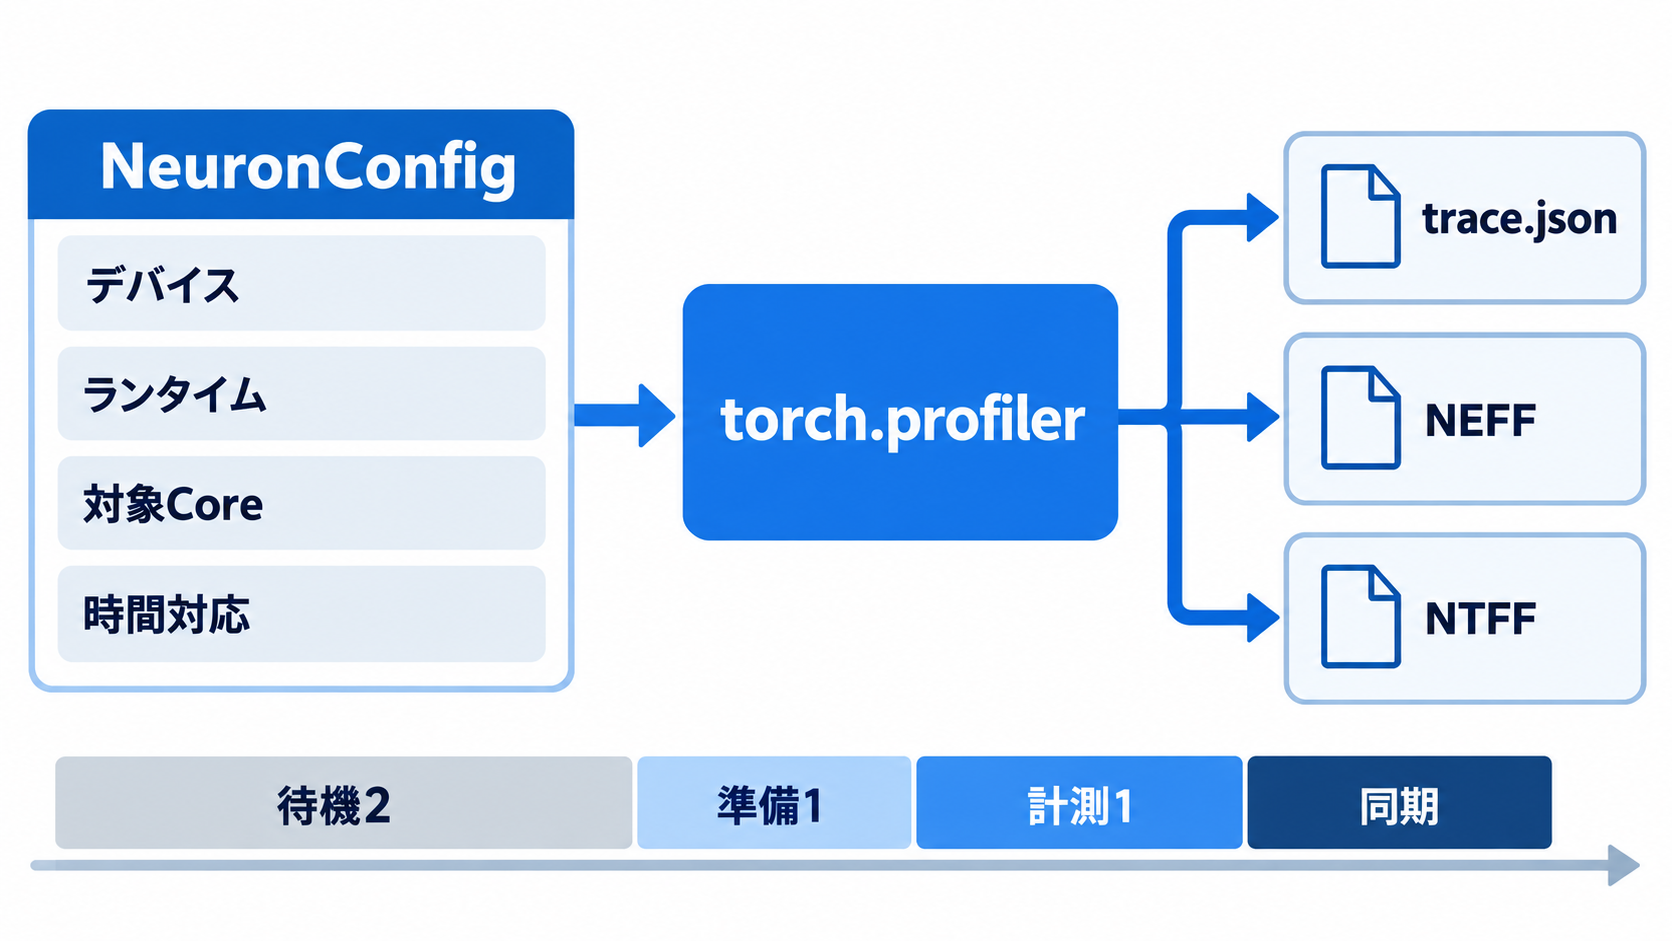
Neuronワークロードの計測では、`NeuronConfig`と`NeuronProfiler`という2つのオブジェクトを使います。`NeuronConfig`は、記録するデータの種類、対象とするNeuronCore、出力先などを指定する設定です。`NeuronProfiler`はその設定を受け取り、PyTorchのフレームワークトレースとNeuronのシステムトレースを書き出すコールバックを提供します。今回の設定では、`modes`にデバイス命令とランタイムの記録を指定し、`capture_enabled_for_nc='0'`で対象のNeuronCoreを選択しています。`correlate_device_time=True`も重要です。この指定により、デバイス側の実行時間がPyTorchの`key_averages()`へ反映され、CPU時間とNeuron時間を同じ表で比較できるようになります。
PyTorch側では、計測対象の`activities`にCPUと`ProfilerActivity.PrivateUse1`を含め、`NeuronConfig`を`experimental_config`として渡します。PrivateUse1を指定しなければ、Neuronデバイス上の活動を収集できません。計測コードが問題なく動いていても、必要な活動種別が欠けていれば、ボトルネックの判断に使えるトレースにはならない点に注意が必要です。
スケジュールは`wait=2`、`warmup=1`、`active=1`に設定され、4回の`prof.step()`のうち1回だけを本計測に使っています。初期化などの一時的な負荷を避け、ウォームアップ後の実行を記録するためです。各反復では`torch.neuron.synchronize()`も呼び出します。デバイス処理は非同期に進むため、同期しないままプロファイルを出力すると、処理完了前に記録が閉じられ、Neuron時間の列が空になる可能性があります。
再現性のある比較には、3方式で入力、スケジュール、設定をそろえることも欠かせません。プロファイラーの数字だけを比較するのではなく、ウォームアップ回数や同期位置、入力形状まで測定条件として管理すれば、コード変更による差と計測方法による揺れを切り分けやすくなるでしょう。
素朴なRMSNormで見えた6回の個別実行
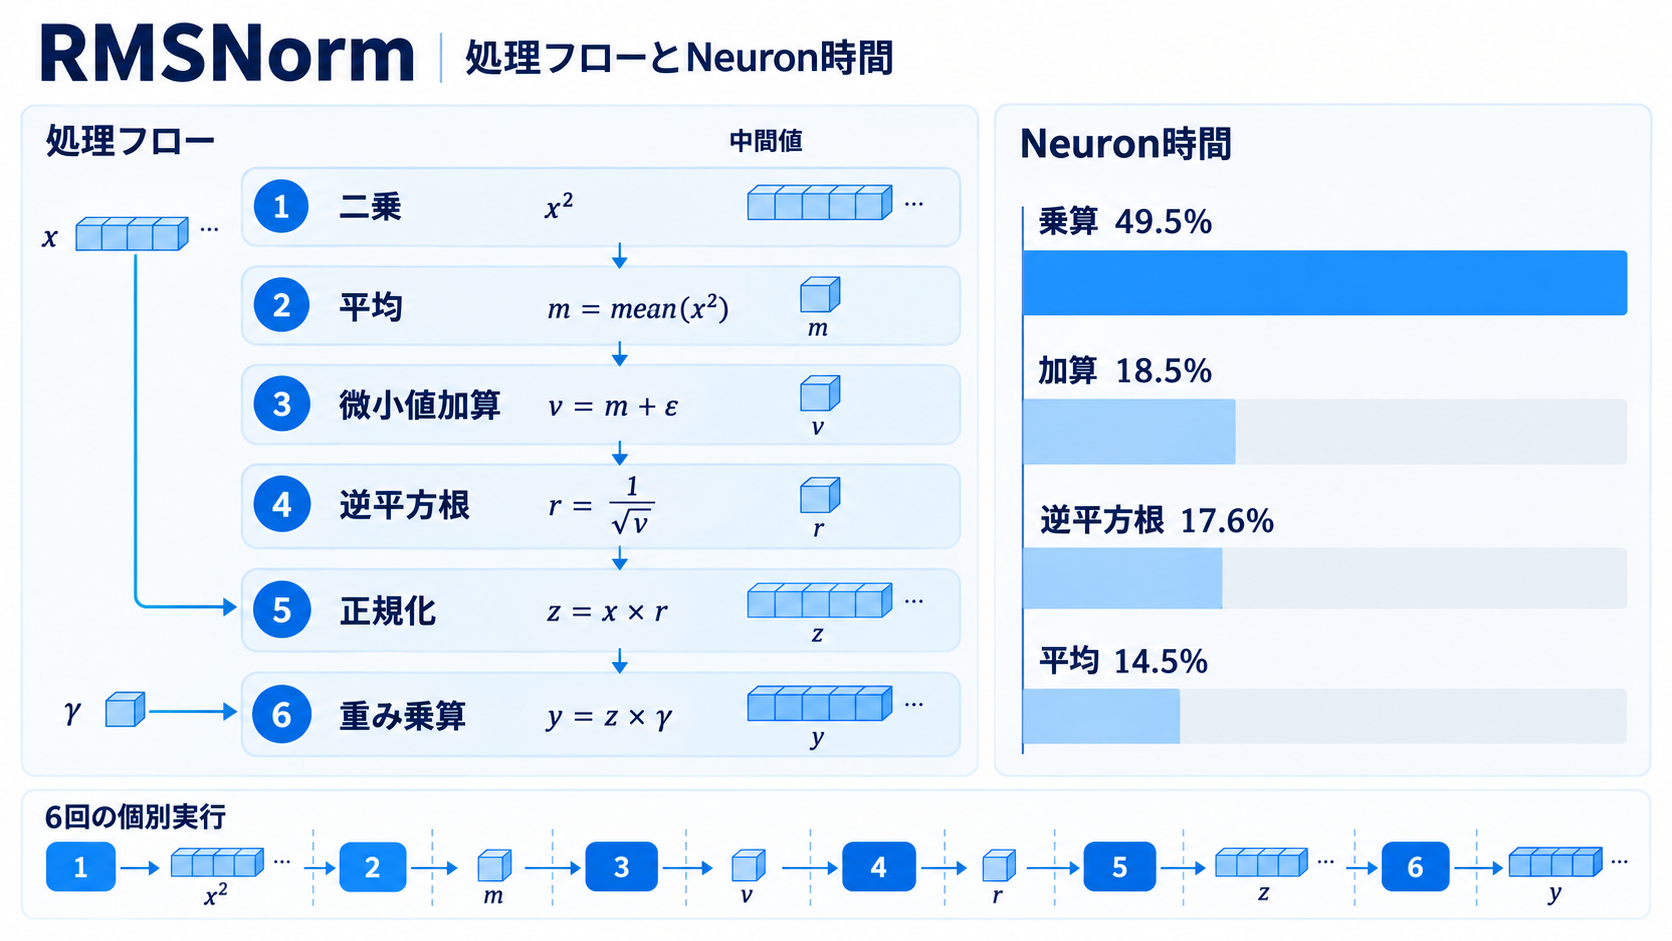
RMSNormは、入力値の二乗、その平均、微小値の加算、平方根の逆数、正規化、重みの乗算という流れで計算します。ここでは形状が`4 × 512`、データ型が`bfloat16`の入力と、長さ512の重みを使用しています。素朴な実装では、これらを`multiply`、`mean`、`add`、`rsqrt`などの個別のPyTorch演算として記述しています。`key_averages()`を`self_privateuse1_time_total`で並べ替えると、Neuronデバイス時間を多く消費した演算から確認できます。結果は次の通りでした。
| 演算 | 呼び出し回数 | Self CPU | Self NEURON | NEURON比率 |
|---|---:|---:|---:|---:|
| `aten::mul` | 3 | 60.9 µs | 1,164.5 µs | 49.5% |
| `aten::add` | 1 | 26.6 µs | 434.6 µs | 18.5% |
| `aten::rsqrt` | 1 | 15.6 µs | 415.0 µs | 17.6% |
| `aten::mean` | 1 | 21.1 µs | 340.8 µs | 14.5% |
Neuronデバイス時間の合計は2.355ミリ秒です。`aten::mul`が3回あるのは、入力の二乗、正規化時の乗算、重みによるスケーリングに対応します。`aten::mean`は最後の次元を縮約し、`aten::rsqrt`は平均二乗値から平方根の逆数を求めます。微小値を足す`aten::add`では、CPU上にあるスカラー値に起因するホストからデバイスへのコピーも発生しています。
注目すべきなのは、各演算の計算量だけではありません。Eager実行では6個のATen演算が独立してディスパッチされ、それぞれがフレームワークからランタイム、ハードウェアへ進みます。小さな処理が分散すると、個々の実行要求や演算間の待ち時間が積み重なります。また、`x_sq`や`mean_sq`のような途中結果を演算間で受け渡す必要も生じます。
表を見れば、最も大きなデバイス時間を占めるのが乗算群だと分かります。ただし、3回の乗算のうち一つだけを局所的に書き換えるより、RMSNorm全体を一つの処理としてまとめられるかを検討したほうが、ディスパッチ回数と中間値の両方へ働きかけられます。ここでプロファイリングが、単なる順位表ではなく最適化方針を選ぶ手掛かりになります。
Neuron Explorerで追う一つの演算の生涯
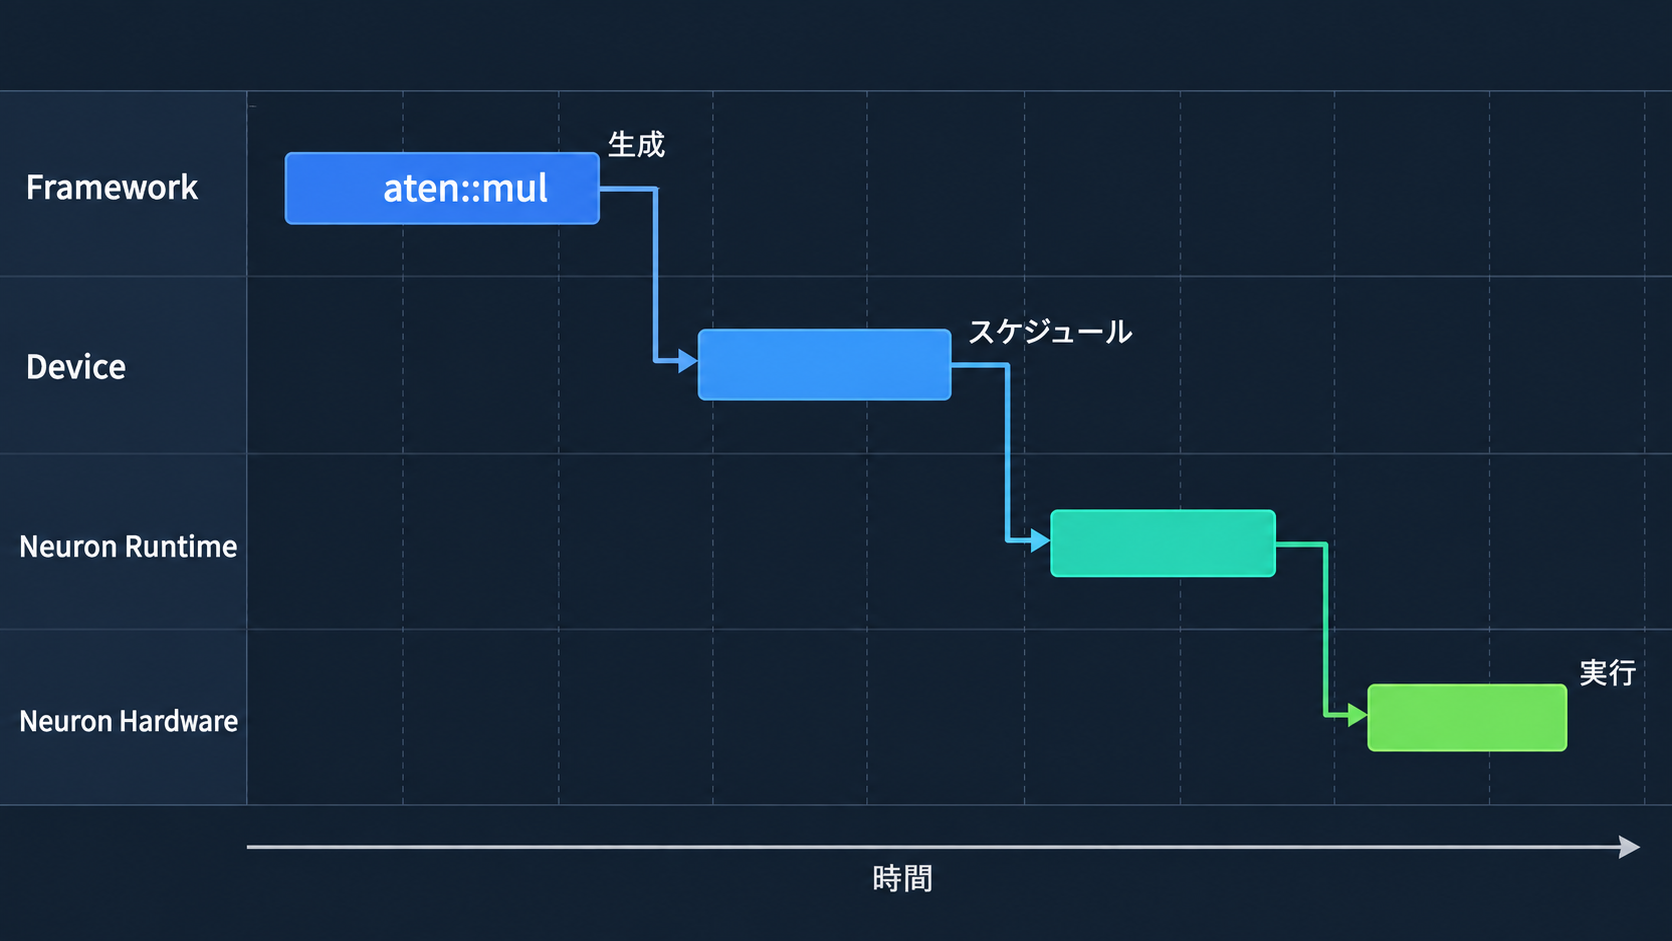
数値表だけでは、演算と演算の間で何が起きているのかまでは分かりません。Neuron Explorerは、システムトレース、デバイスのタイムライン、エンジン別の内訳をブラウザ上で確認するためのビューアーです。SSHトンネルまたはVisual Studio Code拡張機能を通じて利用し、`key_averages()`で見つけた負荷を視覚的なトレースと照合できます。Explorerでは、時間が左から右へ進み、処理のライフサイクルが上から下へ並びます。主なレーンと役割は次のように整理できます。
| レーン | 表示内容 |
|---|---|
| Framework dispatch | スレッドごとに整理された演算のディスパッチ |
| Framework device | ストリームごとのデバイス操作 |
| Neuron Runtime | 論理NeuronCore単位のランタイムAPI呼び出し |
| Neuron Hardware | 物理NeuronCore上のハードウェア実行 |
一つの`aten::mul.Tensor`を選ぶと、フレームワークで生成され、ランタイム上の`nrta_execute_schedule`としてスケジュールされ、ハードウェアレーンの`nc_exec_running`として実行されるまでを依存関係チェーンで追えます。Eager実行では、この一連の経路が演算ごとに繰り返されます。演算時間だけでなく、その間に生じる空白も確認できるため、融合によって何が省かれるのかを具体的に捉えられます。
計測後の出力先にはシステムトレースが保存され、デバイス情報も取得した場合は、対応するNEFFファイルとNTFFファイルが生成されます。NEFFはコンパイル済みのNeuron実行形式、NTFFはそのハードウェア命令トレースです。両者は同じ数値ハッシュを持つ組として管理されます。システムプロファイルまたは複合プロファイルでは出力ディレクトリ全体を、デバイス専用プロファイルでは対応するNEFFとNTFFをExplorerへ読み込ませます。
表が「どの演算に時間がかかったか」を示すのに対し、タイムラインは「その時間がどの経路で発生したか」を示します。両者を組み合わせることで、演算自体が重いのか、細かなディスパッチが連続しているのかを区別できるようになります。
組み込み融合演算が消した実行間の空白
2つ目の実装では、個別の算術演算を`torch.rms_norm`へ置き換えています。TorchNeuronはこの呼び出しを、RMSNorm全体を処理する一つの融合カーネルへ変換します。Pythonコード上の記述が短くなること以上に、複数の演算が別々にNeuronCoreへ投入されなくなる点が性能差につながっています。`key_averages()`には`aten::_fused_rms_norm`が1回だけ現れ、Self NEURON時間は403.3マイクロ秒、Self CPU時間は47.6マイクロ秒でした。素朴な実装の2,355マイクロ秒と比べると、この測定ではデバイス時間が約6分の1になっています。Neuron時間の100%が一つの融合演算に集約されるため、処理の境界も明確です。
Explorer上でも、フレームワークからランタイム、ハードウェアへ向かう経路は一つになります。個別実装にあった各算術演算間の空白がなくなり、`x_sq`や`mean_sq`などの中間値を独立した演算結果として具体化する必要も抑えられます。RMSNormの数学的な処理内容を変えず、実行単位の設計によって待ち時間とメモリアクセスをまとめた形です。
利用できる融合演算がある場合は、独自の低レベル最適化より先に検討する価値があります。実装量を増やさずにディスパッチ構造を変えられるためです。ただし、企業システムへ導入するときは、対象モデルの入力形状、データ型、数値誤差の許容範囲で同じ効果と出力が得られるかを実測する必要があります。今回の数値は、融合という方針の有効性を示す例であり、別の演算やモデルに対する性能保証ではありません。
torch.compileが既存コードから見つける融合機会
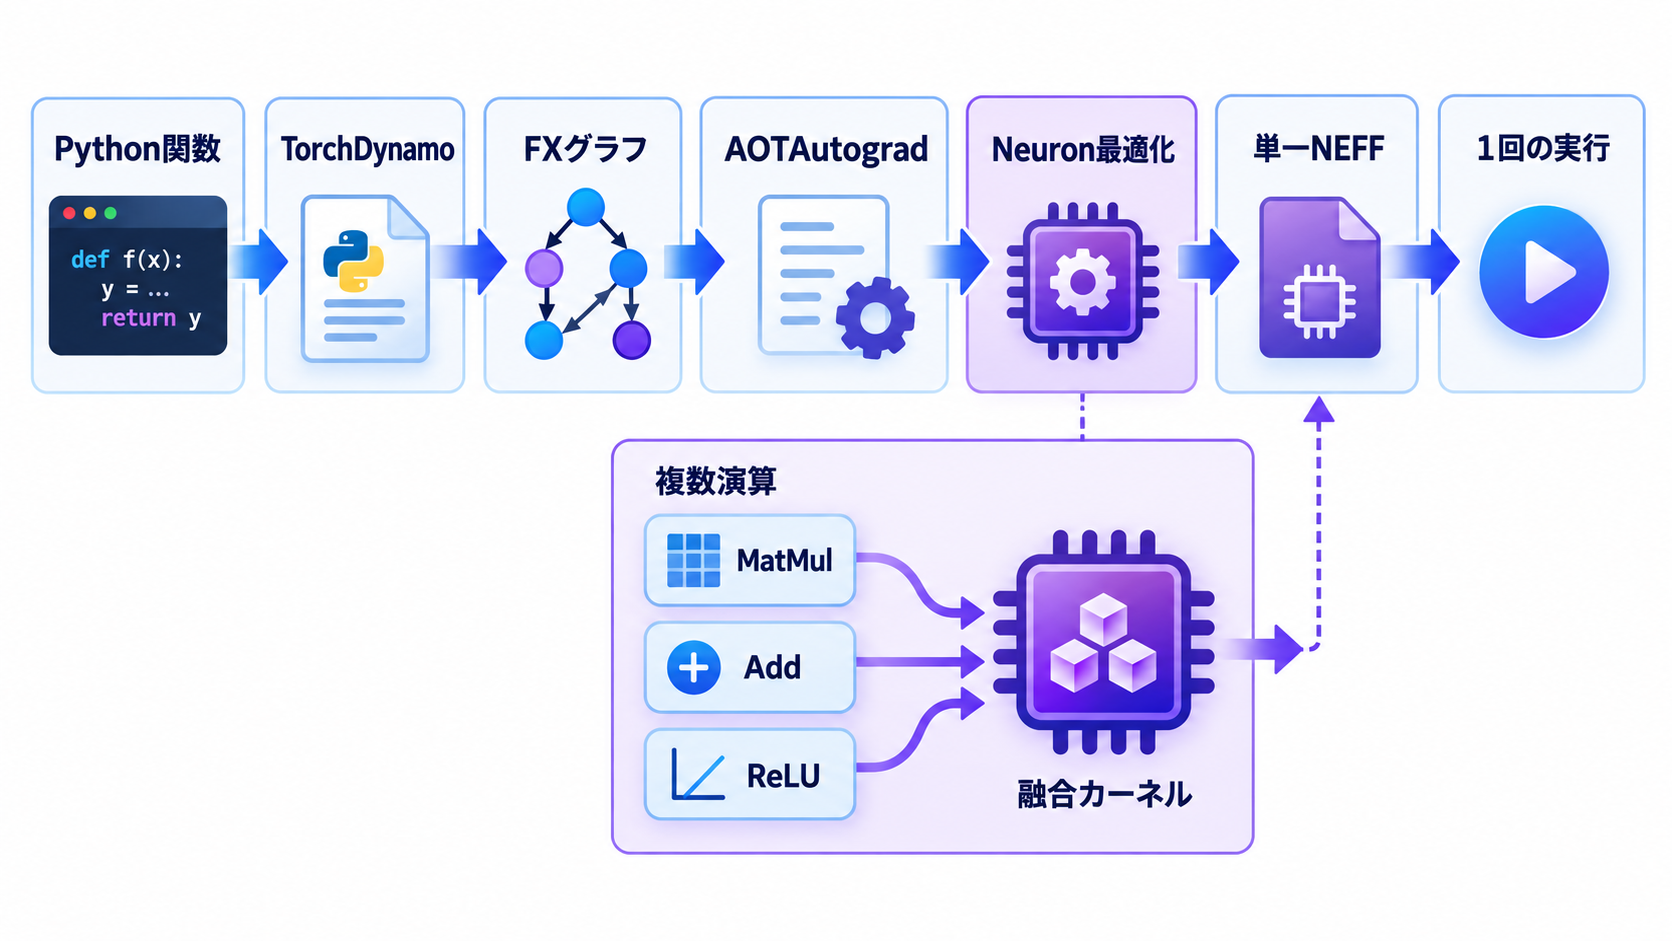
3つ目の実装では、個別演算で書かれたRMSNorm関数へ`@torch.compile(backend='neuron', fullgraph=True)`を付けています。開発者が融合演算へ手作業で置き換えるのではなく、コンパイラに一連の計算グラフを渡して最適化させる方法です。既存の関数構造を保ちながら実行単位をまとめられる点に、組み込み演算とは異なる利点があります。この経路では、TorchDynamoがPythonバイトコードをFXグラフとして取得し、AOTAutogradがATen演算へ変換します。Neuronバックエンドは個々の演算ではなくグラフ全体を受け取り、演算融合とメモリアクセスの最適化を行ったうえで、一つのNEFF成果物へコンパイルします。実行時には、この成果物が1回のハードウェアディスパッチとして処理されます。
計測表には`Torch-Compiled Region: 0/0`が1回だけ表示されました。Self NEURON時間は375.5マイクロ秒、Self CPU時間は98.4マイクロ秒です。組み込みの`torch.rms_norm`が403.3マイクロ秒だったため、今回の条件では両者のデバイス時間は近い範囲にあります。素朴な実装と比べれば、どちらもおよそ6分の1です。
同程度の結果に至っていても、最適化の経路は異なります。`torch.rms_norm`は用途が定められた融合演算を明示的に呼び出します。`torch.compile`は、複数のPyTorch演算からなる関数をグラフとして捉え、融合できる範囲をコンパイラが見つけます。後者は既存実装を維持しやすい可能性がありますが、コンパイル可能なグラフかどうか、実際に一つの実行へまとまったかどうかはプロファイルで確認しなければなりません。
また、今回のCPU時間は組み込み演算が47.6マイクロ秒、コンパイル版が98.4マイクロ秒でした。デバイス時間だけを見て方式を決めるのではなく、ホスト側の負荷、コンパイルや運用の条件、コードの保守性を含めて評価する必要があります。目的は常に最小の単独数値を選ぶことではなく、サービス全体の遅延と運用負担の釣り合いを取ることです。
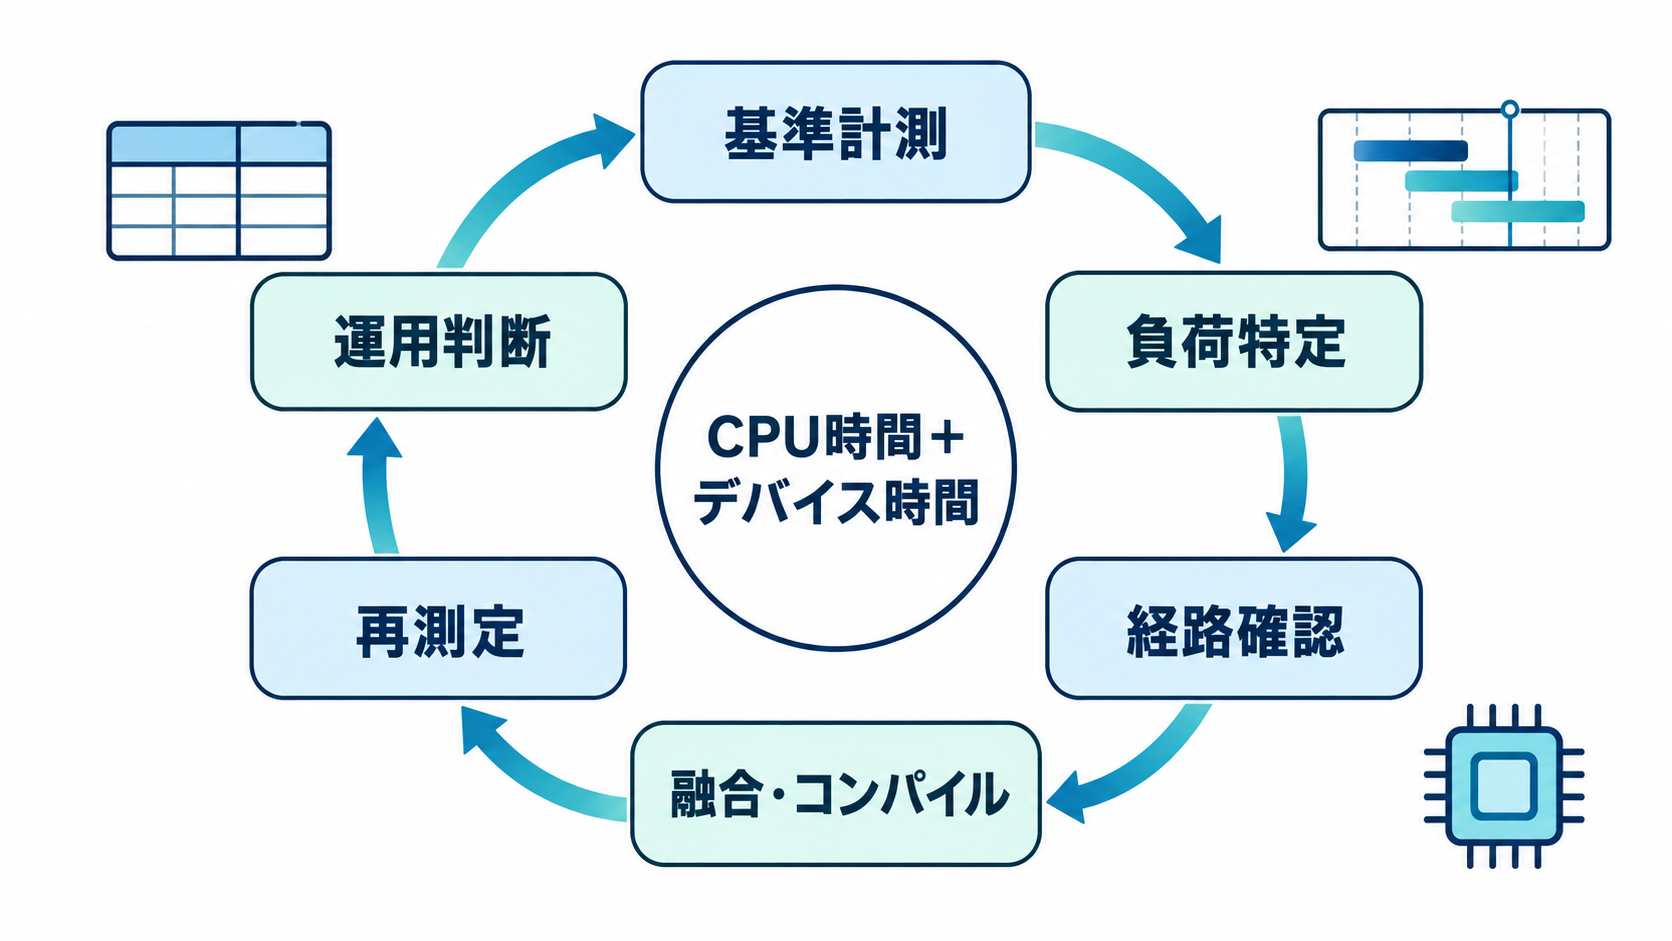
生成AI基盤で繰り返せる性能改善の進め方
生成AIサービスでは、モデルが大きくなるほど処理経路も複雑になります。それでも、今回使われた調査手順は変わりません。表から負荷の集中箇所を見つけ、トレース上で実行経路を確認し、候補となる最適化を適用した後、同じ条件で再測定します。経験則だけに頼らず、改善前後を追跡できることが企業利用では特に重要です。実務では、次の順序で調査記録を残すと判断しやすくなります。
1. 入力形状、データ型、ウォームアップ、同期位置を固定し、基準となるプロファイルを取得します。
2. `key_averages()`でデバイス時間とCPU時間を分け、上位の演算を特定します。
3. Neuron Explorerでディスパッチ、ランタイム、ハードウェア実行の依存関係と空白時間を確認します。
4. 組み込み融合演算または`torch.compile`を試し、同一条件で効果を再測定します。
5. 数値の改善だけでなく、出力の妥当性と運用上の扱いやすさも確認します。
今回のRMSNormでは、個別演算の計算速度を一つずつ調整するより、6回のディスパッチを1回へまとめる方法が明確な差を生みました。別のモデルでも、短い演算が多数並んでいる箇所では、同じ観点が有効かもしれません。反対に、一つのカーネルへ融合した後も遅い場合は、ディスパッチ数だけでは説明できず、演算器の利用状況やメモリ転送をさらに詳しく調べる必要があります。
その段階では、NEFFを開き、TensorEngine、VectorEngine、DMA(Direct Memory Access)の内訳を確認するデバイスレベルの分析へ進みます。演算強度とハードウェア性能の関係を見るルーフライン分析を使えば、対象カーネルが計算能力に制約されているのか、メモリ帯域に制約されているのかを検討できます。ただし、低レベル分析へ進む前に、フレームワーク側で不要な分割が残っていないかを確かめるのが順序として自然です。
導入の最初の一歩は、代表的な推論リクエストを一つ選び、CPU時間とNeuron時間が対応するプロファイルを保存することです。その記録を基準にすれば、融合演算やコンパイルの採用を感覚ではなく数値で判断でき、モデル更新後の性能回帰も追いやすくなります。