
AI LAB
2026/10/24
3兆パラメータでも動かすのは一部――Moonshot AI「Kimi K3.1 Pro」が示す企業向けAI競争の新局面
Kimi K3.1 Proで注目すべき「規模以外」の進化
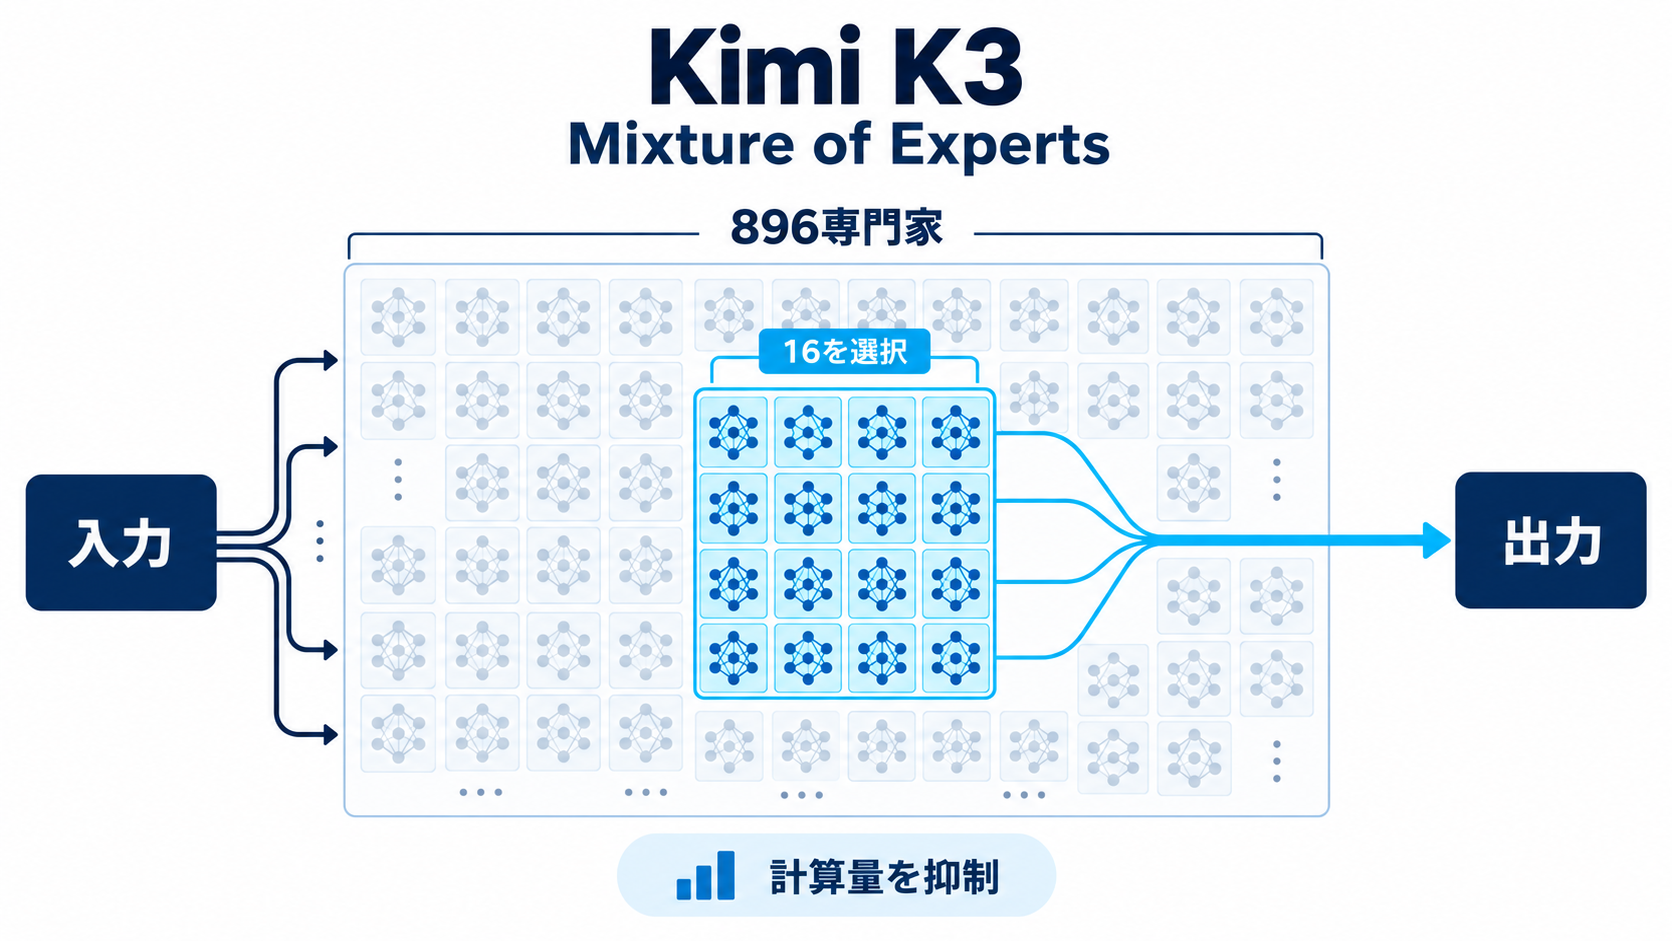
中国のAI企業Moonshot AIが2026年10月23日に発表した「Kimi K3.1 Pro」は、3兆パラメータという大きさだけで評価すべきモデルではありません。企業利用の観点でより注目したいのは、巨大なモデルを現実的な推論コストで動かす設計と、学習済みモデルを実務向けに磨き込むポストトレーニングへ重点を置いている点です。Kimi K3.1 Proは、Moonshot AIが同年7月に公開したKimi K3を強化したモデルです。Kimi K3は896個の個別ニューラルネットワークから構成され、処理時にはそのうち16個だけを有効化します。すべてのパラメータを毎回使わず、入力に応じて必要な部分を選ぶことで、モデル全体の容量を増やしながら推論時の計算量を抑える設計です。
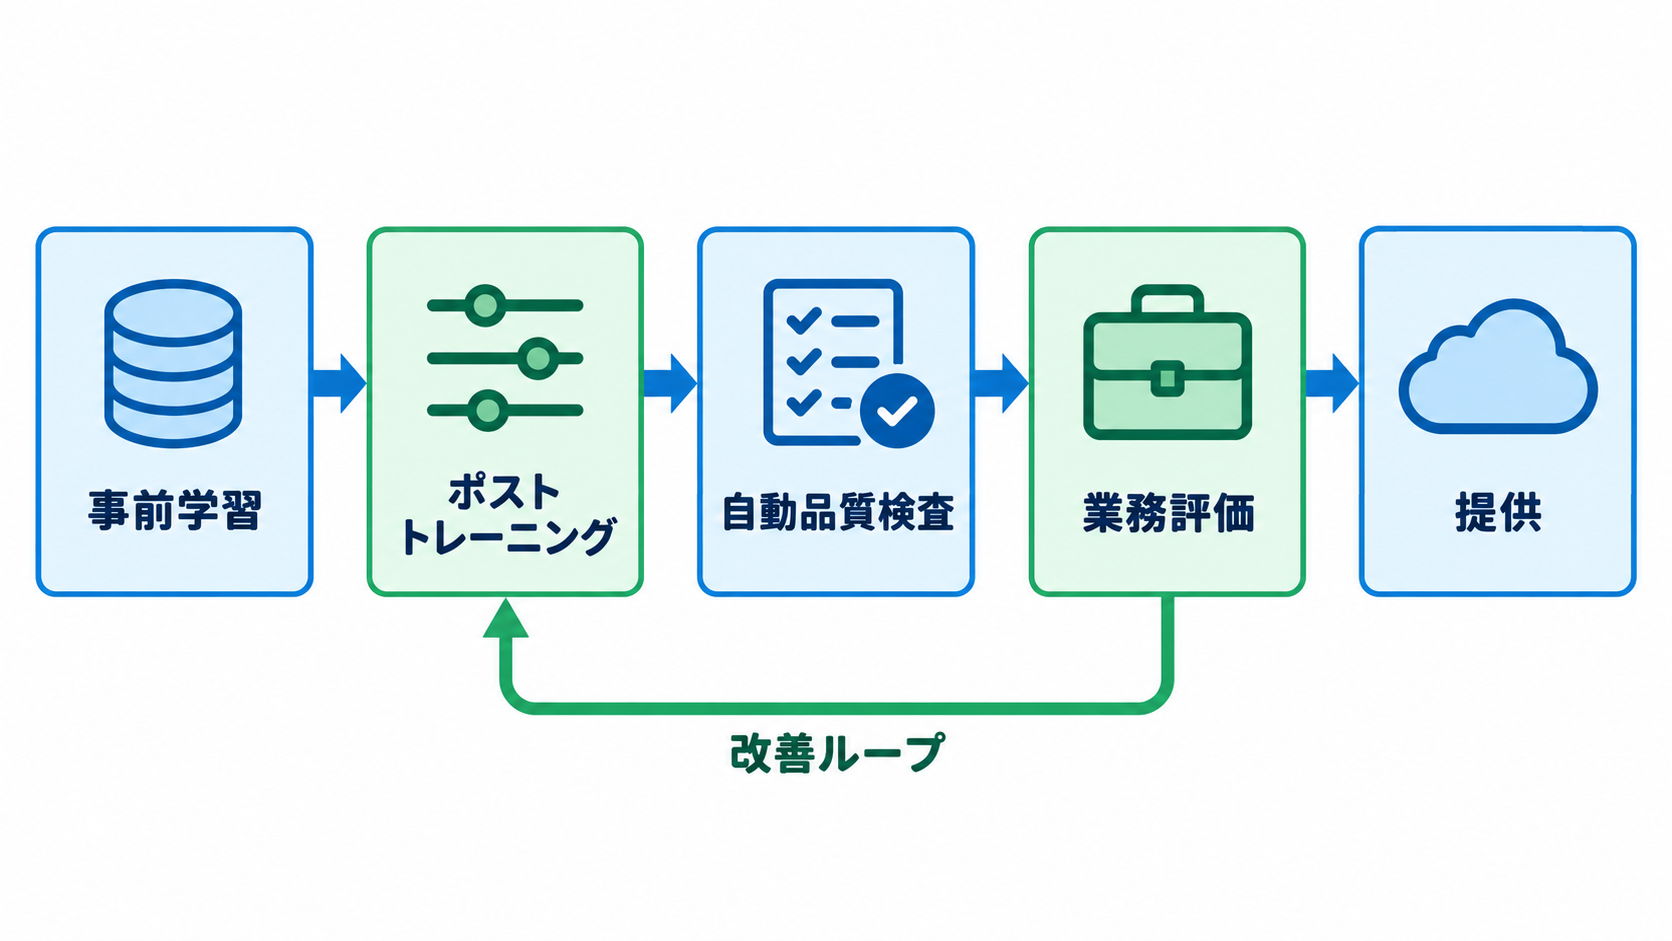
新モデルのポストトレーニングには、同社が過去に実施した同種の工程よりも大幅に多くの計算資源が投入されています。基盤となる処理環境も更新され、自動品質検査の追加とインフラ効率の改善が行われました。単純にモデルを大型化するのではなく、回答品質を評価しながら用途別の能力を調整する工程へ投資していることが分かります。
発表された評価では、3Dモデル生成、ソフトウェア開発、財務分析で競争力を示しました。ただし、すべての領域で一律に優れているわけではありません。サイバーセキュリティ分野では、安全上の判断から関連データを意図的に減らしており、他の有力モデルに後れを取っています。Kimi K3.1 Proの特徴は、万能性よりも、設計上の選択と用途ごとの強弱が明確なことにあります。
3兆パラメータを現実的に動かすMoEの仕組み
「3兆パラメータ」と聞くと、利用のたびに膨大な計算が発生するように見えます。しかしKimi K3系では、896個のニューラルネットワークすべてを同時に動かすのではなく、入力ごとに16個を選択します。この方式は一般にMixture of Experts、略してMoEと呼ばれます。複数の専門家を用意し、質問に合う専門家だけへ仕事を割り振る考え方です。パラメータ総数は、モデルが内部に保持できる表現力の目安にはなりますが、実行時の負荷をそのまま表す数字ではありません。Kimi K3の場合、有効化されるネットワークが限定されるため、密な構造の3兆パラメータモデルと比べて計算量を抑えられます。ただし、巨大な重みを保存する容量や、複数の計算装置へデータを配置するための仕組みは必要です。総パラメータ数だけでコストや速度を判断すると、実態を見誤る可能性があります。
Kimi K3には、注意機構が使用するメモリーを削減する「Kimi Delta Attention」も採用されています。これはGated DeltaNetと呼ばれる技術を独自に実装したもので、長い入力を解釈する際のRAM消費を減らす狙いがあります。Kimi K3.1 Proにも引き継がれたとみられていますが、今回確認できた情報だけでは搭載を断定できません。
企業がモデルを比較する際は、パラメータ総数に加えて、1回の処理で実際に使われるパラメータ、必要なメモリー、応答時間、同時利用時の処理能力を見る必要があります。MoEは巨大モデルの運用を現実的にする一つの方法ですが、構成が複雑になるため、導入先のインフラや提供形態まで含めた評価が欠かせないでしょう。
3Dモデルを「描く」のではなくコードで組み立てる能力
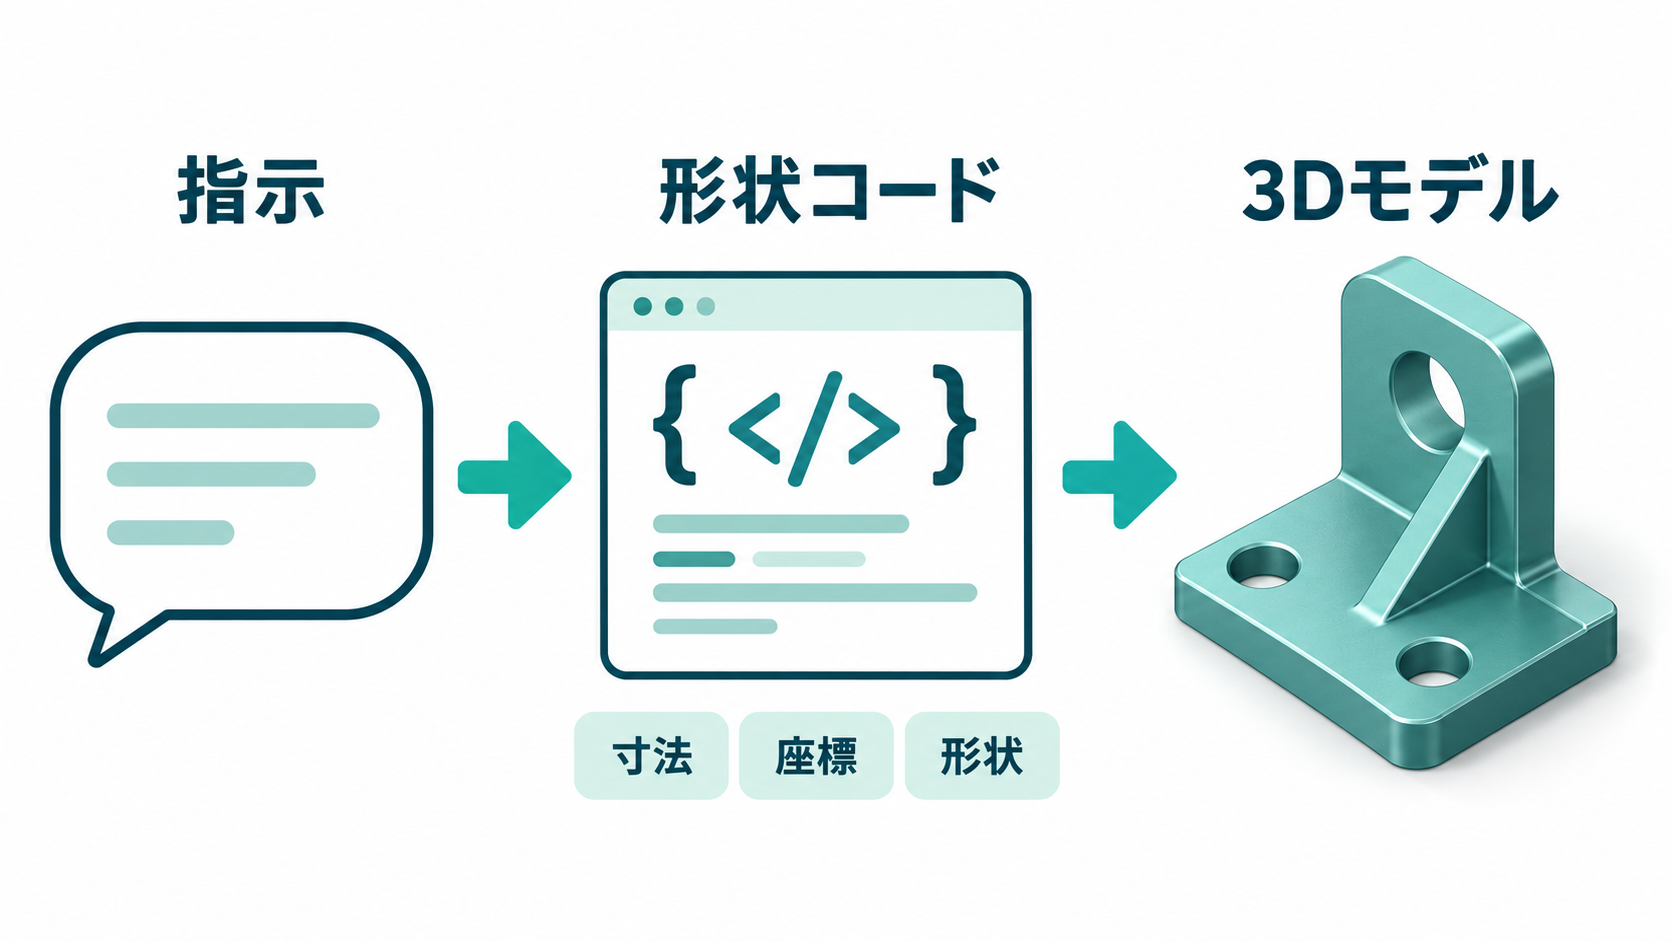
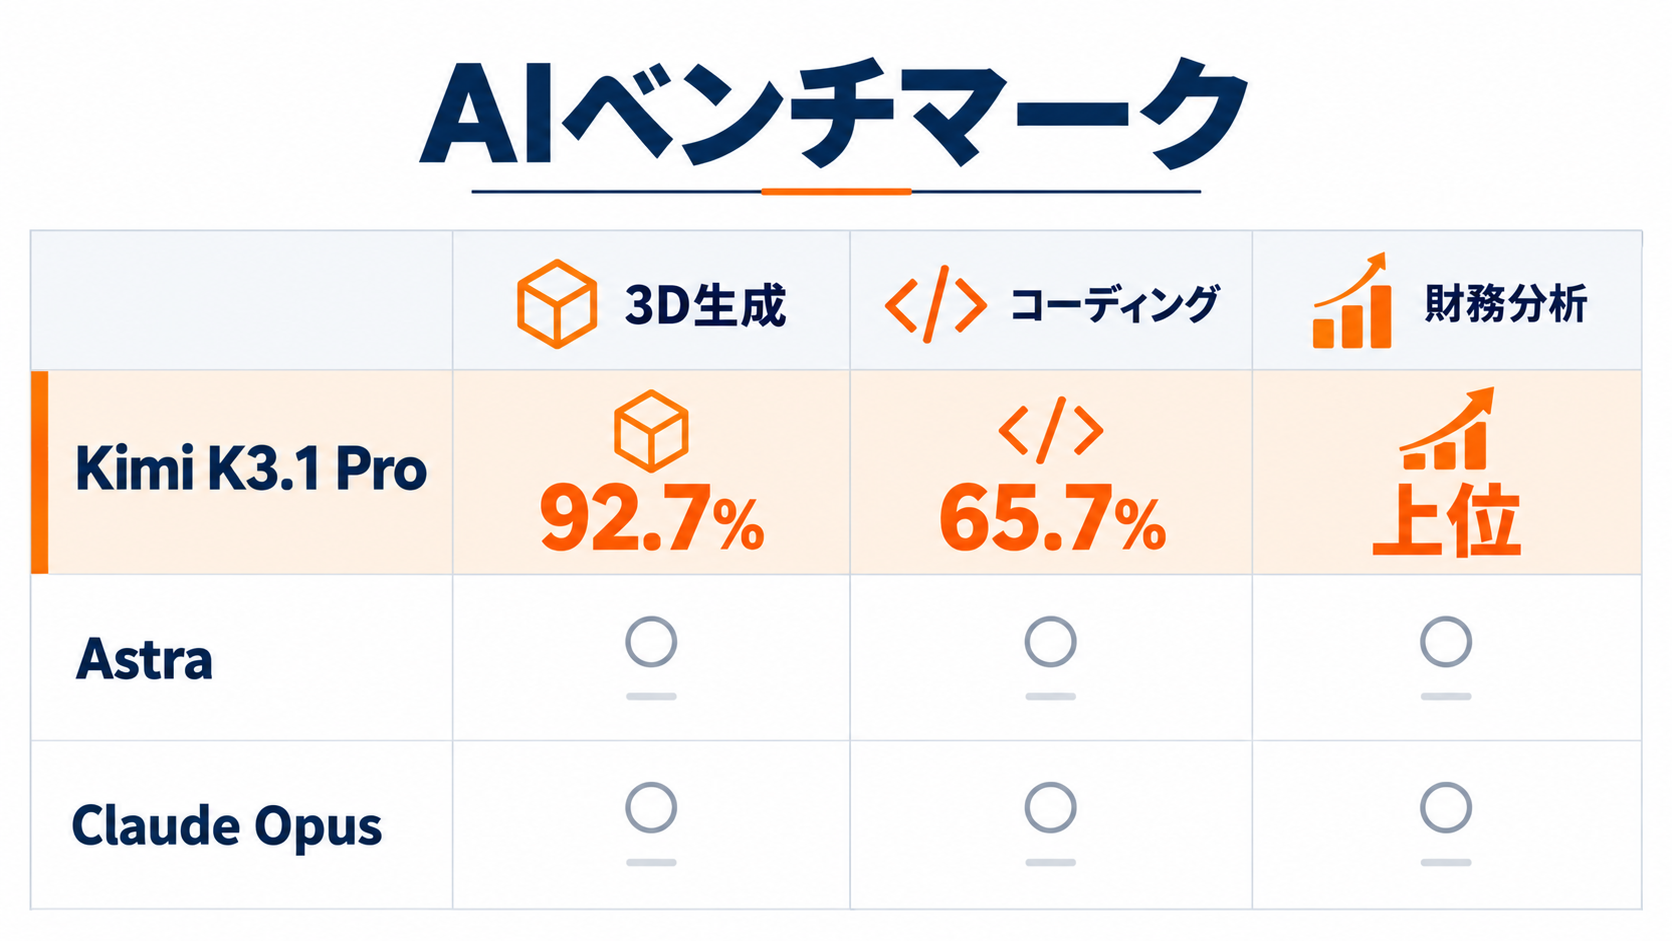
Kimi K3.1 Proが特に競争力を示したのは、3Dモデリングです。3Dモデルの作成方法には、制作ソフト上で形状を直接描く方法と、位置や寸法などの幾何学情報をコードで指定する方法があります。同モデルが得意とするのは後者で、自然言語による指示を、形状を定義するコードへ変換します。3Dモデル用コードの評価指標であるBenchCADでは、92.7%を記録しました。比較対象となったGPT-6 AstraおよびClaude Opus 5.5との差は4ポイント以内です。この結果は、少なくとも同ベンチマークの条件下では、最上位クラスの競合モデルに近い精度で幾何学的なコードを作成できることを示しています。ただし、ベンチマークの得点だけでは、複雑な実製品の設計や製造要件への適合性まで保証されません。
Moonshot AIは静止した形状だけでなく、動きを伴う3Dコンテンツも試しています。社内評価では人間の動作を再現するアニメーションや、複数の3Dゲームを生成しました。ゲームはプログラムの規模が大きく、描画、入力、物理挙動などの要素が連動します。小さな不具合でも全体が停止し得るため、長いコードの整合性を保つ能力を確かめる題材になります。
企業での応用を考えるなら、設計者を完全に置き換える用途よりも、初期案の作成や反復作業の短縮から検証する方が現実的です。たとえば概念モデルのたたき台をコードで生成し、人が寸法、耐久性、権利関係などを確認する流れです。評価時には見た目の完成度だけでなく、生成コードを修正できるか、既存ツールへ取り込めるか、同じ指示から安定した結果を得られるかも確認する必要があります。
コーディングと財務分析で見えた得意領域
ソフトウェア開発能力を測るTerminal-Bench 4.0で、Kimi K3.1 Proは65.7%を記録しました。Moonshot AIが示した比較ではGPT-6 Astraを7ポイント超上回り、Claude Opus 5.5にはわずかに届いていません。端末を使った作業を対象とする評価で高い得点を得たことから、単発のコード補完だけでなく、複数の操作を伴う開発課題への対応力がうかがえます。財務分析能力を測るOfficeQA Pro v2では、Kimi K3.1 ProがAstraとClaude Opus 5.5の双方を上回りました。この評価は複雑な金融分析タスクを対象としており、表や文書に含まれる情報を読み取り、計算や推論を組み合わせる能力を測ります。企業の管理部門や金融業務では関心を集めやすい結果ですが、実際の意思決定へ利用する場合は、計算過程と参照情報を人が検証できる仕組みが必要です。
ベンチマークには、モデルの特徴を同じ条件で比べやすいという利点があります。その一方で、企業固有のデータ形式、アクセス権限、社内用語、古いシステムとの連携までは再現できません。65.7%という数字も、残る課題で誤り得ることを意味します。高得点だから監督なしで業務を任せられる、と解釈するのは適切ではないでしょう。
導入候補として評価するなら、自社の代表的なタスクを小規模な検証セットにまとめる方法が有効です。正答率に加え、処理時間、再実行時の安定性、誤答を発見しやすいか、修正にどれほど人手がかかるかを測ります。公開ベンチマークは候補を絞り込む材料として使い、最終判断は自社データによる検証へつなげるのが妥当です。
サイバーセキュリティ性能を意図的に抑えた理由
Kimi K3.1 Proは、一般的なサイバーセキュリティ関連ベンチマークでGPT-6 AstraとClaude Opus 5.5を大きく下回っています。Moonshot AIによると、これは単なる学習不足ではなく、安全上のリスクへ対応するためにポストトレーニング用データからセキュリティ関連情報を意図的に除外した結果です。能力を高めることと、悪用可能性を抑えることの間で明確な選択を行った形です。脆弱性を見つける能力は、防御側にとって有用です。コードレビューや設定ミスの発見を支援できれば、担当者の作業を効率化できます。同じ能力は、攻撃対象の探索や侵入手順の作成にも転用されかねません。モデル提供者には、どの能力を学習させるかだけでなく、誰が、どの環境で、どこまで利用できるようにするかという設計も求められます。
Moonshot AIは、将来のモデルにより高度な脆弱性分析機能を持たせる計画を示しています。ただし、実装時期や利用制限、監視方法などの詳細は明らかにされていません。現行モデルの弱点を将来版で補う意向は読み取れますが、安全策を含めた提供方法を確認するまでは、企業のセキュリティ業務へ適用できる範囲を慎重に見極める必要があります。
企業側も、セキュリティ分野の得点が低いことを安全性の高さと同一視すべきではありません。関連知識が少ないモデルでも、不正確なコードや危険な設定を生成する可能性は残ります。利用範囲の制限、出力のレビュー、操作記録の保存、機密情報を入力しない運用など、モデルの能力とは別の統制が欠かせません。
ポストトレーニングがモデルの実用性を左右する理由
大規模言語モデルの開発では、大量のデータから言語やコードのパターンを学ぶ事前学習の後に、回答の正確さ、指示への従いやすさ、安全性などを調整するポストトレーニングが行われます。Kimi K3.1 Proは、Kimi K3を土台としてこの後半工程を強化したモデルです。名称に含まれる「Pro」も、基盤を一から作り直すというより、利用時の能力を磨いた位置付けとして理解できます。Moonshot AIは今回、過去の同種プロジェクトより大幅に多くの計算資源をポストトレーニングへ投入しました。処理基盤も更新し、自動品質検査を追加したほか、インフラの効率を改善しています。モデルの規模だけで差をつけるのではなく、生成結果を評価して修正する反復工程の量と質を競争力に変えようとしていると考えられます。
このアプローチは、企業がAI製品を選ぶ際の見方にも関係します。同じ基盤モデルを使っていても、追加学習、評価データ、ツール連携、安全調整の違いによって、実務での使い勝手は変わります。仕様表に載るパラメータ数より、対象業務でどの程度指示を守るか、失敗時に予測可能な挙動をするか、更新後も品質を維持できるかが運用品質を左右するでしょう。
自社モデルを開発しない企業にとっても、ポストトレーニングの考え方は参考になります。導入後に業務固有の評価項目を設け、期待する出力例と避けたい出力例を蓄積すれば、モデル更新時の比較に利用できます。ベンダーの評価結果を受け取るだけでなく、自社側にも継続的な品質確認の仕組みを持つことが、生成AIを安定して運用する土台になります。
有料クラウドとモデル公開をどう評価するか
Kimi K3.1 Proは発表時点からMoonshot AIの有料クラウドサービスで利用できます。同社は11月4日までにモデルの重みをオープンソースとして公開する計画も示しています。クラウド経由で試した後、公開された重みを使った運用可能性を検討できるなら、企業にとっては選択肢が広がります。ただし、ライセンス条件や必要な計算資源などは、実際の公開内容を確認して判断する必要があります。クラウドサービスは、設備を用意せずに性能を検証しやすく、保守作業も提供者へ委ねられます。反面、データの保存場所、ログの扱い、サービス停止時の影響、料金体系を確認しなければなりません。モデルの重みを自社環境で動かす方式では制御範囲を広げられますが、3兆パラメータ級のモデルを扱うための保存容量、計算基盤、分散処理の技術が必要になると考えられます。
日本企業が初期評価を行う際は、日本語の指示理解と出力品質も独立して検証すべきです。今回示されたBenchCAD、Terminal-Bench 4.0、OfficeQA Pro v2の結果は有力な手掛かりですが、日本語の社内文書や国内特有の会計・業務表現への適合性までは分かりません。機密性の低いサンプルを用意し、品質、コスト、応答速度、監査のしやすさを既存モデルと比較する進め方が適しています。
Kimi K3.1 Proの発表から得られる実務的な示唆は、最大規模のモデルを選ぶことではありません。自社が必要とする能力に計算資源が配分されているか、安全上の制限が業務と整合するか、提供形態を含めて継続運用できるかを見極めることです。検討を始めるなら、3D生成、開発支援、財務分析のうち自社で効果を測りやすい一業務を選び、人による確認を残した小規模な比較試験から着手するのがよいでしょう。