
2026/10/29
AIニュース
Google「Gemini 4 Carbon」発表、コード生成AIの競争軸をサイバー防御へ
2週間で更新されたGoogleの旗艦AI
Googleは2026年10月28日、複雑なプログラミング作業を得意とする大規模言語モデル「Gemini 4 Carbon」を発表しました。前の旗艦モデル「Gemini 4 Argon」の投入から、わずか2週間での更新です。ただし、今回の発表で企業が注目すべきなのは、モデル更新の速さだけではありません。Carbonでは、安全なコードの生成、脆弱性の発見と修正、根拠のない回答の抑制といった、業務利用時の信頼性が主な訴求点になっています。Googleの社内テストでは、Carbonの安全なコード生成能力はArgonの2倍を超えたとされています。また、複数の評価試験でOpenAIの「GPT-6 Astra」やAnthropicの「Claude Opus 5.5」を上回ったとGoogleは説明しています。ここでいう性能は、文章を自然に書けるかどうかだけではなく、開発環境で問題を見つけ、適切な修正を提案し、危険な指示には従わない能力まで含んでいます。
企業の開発現場では、コードを速く生成できても、その出力に脆弱性が混入すればレビューや修正の負担が増えます。根拠のない説明をもっともらしく提示するモデルも、障害対応やセキュリティ判断には使いにくいでしょう。Carbonが打ち出したのは、生成量を増やすためのAIではなく、安全性を確認しながら実務を進めるためのAIという位置づけです。公開された数値は主にGoogleの評価に基づくため、第三者による検証は今後必要ですが、企業向けAIの競争軸が回答の流暢さから運用上の信頼性へ移っていることは読み取れます。
複合ベンチマークで示した総合性能
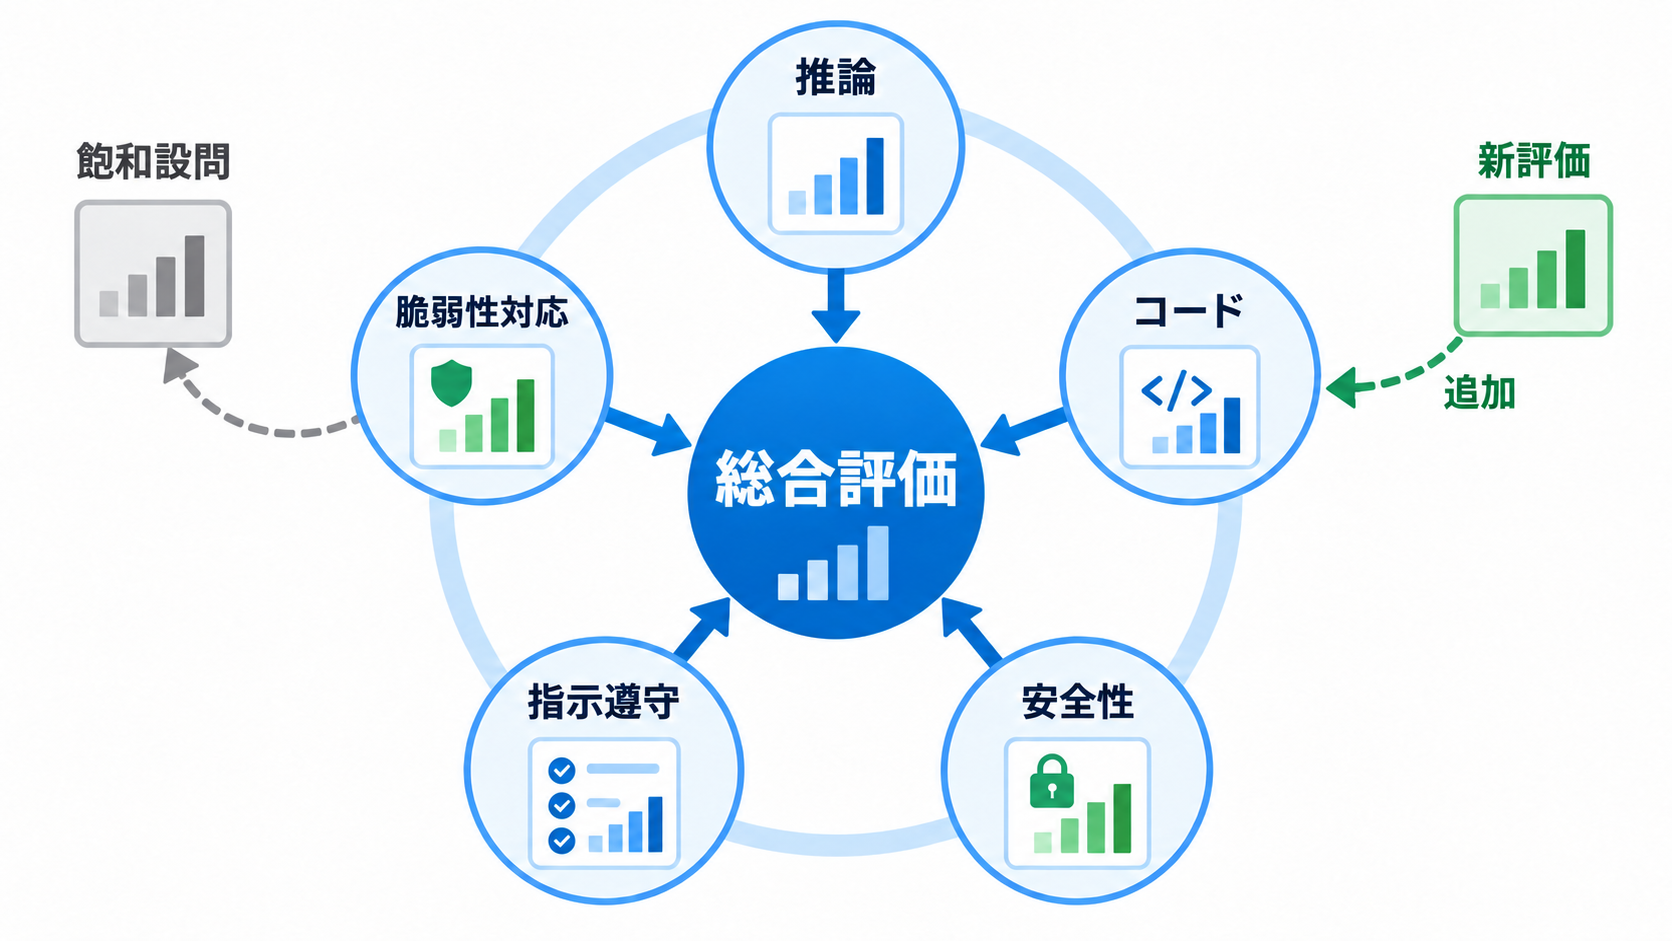
Carbonは、複数の代表的なLLM評価を組み合わせた「Artificial Analysis Intelligence Index」で過去最高のスコアを記録したとされています。Googleが利用したのは発表日に公開された新しい版で、評価項目が二つ追加され、最先端モデルにとって簡単になりすぎた設問の一部が取り除かれました。特定の試験だけに最適化したモデルではなく、複数領域を横断する能力を測ろうとする指標です。ベンチマークの改訂には重要な意味があります。高性能モデルの正答率が上限付近に集まると、モデル間の差を判別しにくくなります。これが「飽和」と呼ばれる状態です。簡単な問題を減らし、新たな評価項目を加えることで、複雑な推論や実務に近い能力の違いを見分けやすくなります。Carbonの記録は、こうした難度調整後の試験で得られたものです。
もっとも、総合スコアだけで企業システムへの適性が決まるわけではありません。ベンチマークで扱われる課題と、各社が実際に利用するプログラミング言語、コードベース、社内ルール、法令上の制約は一致しない場合があります。新しい版と古い版のスコアも単純には比較できません。導入を検討する企業は順位そのものより、どの能力が評価対象となり、自社の用途とどこまで重なるかを見る必要があります。Carbonの総合成績は有力な選定材料ですが、社内データを使った検証を省略できるものではないでしょう。
脆弱性の発見から修正までを担う能力
Carbonが特に強みを示した領域はサイバーセキュリティです。複雑なソフトウェアシステムから弱点を見つける能力を測る「SEC-bench Pro」では、それまでの記録を大きく上回ったとGoogleは報告しています。発見した脆弱性に対する修正能力もArgonより向上したとされており、単に問題箇所を指摘するだけでなく、パッチ作成まで支援する設計がうかがえます。Google DeepMindのシニアバイスプレジデントで、Googleの最高AIアーキテクトを務めるKoray Kavukcuoglu氏によると、Chromeチームが高品質なパッチを生成させた際、Carbonは他社研究機関の大規模な最先端モデルより10倍を超える性能を示しました。ただし、比較対象となったモデル名や評価尺度の詳細は明らかにされていません。この数字を製品間の一般的な速度差や品質差として扱うのではなく、Google内部の特定条件で得られた結果として読む必要があります。
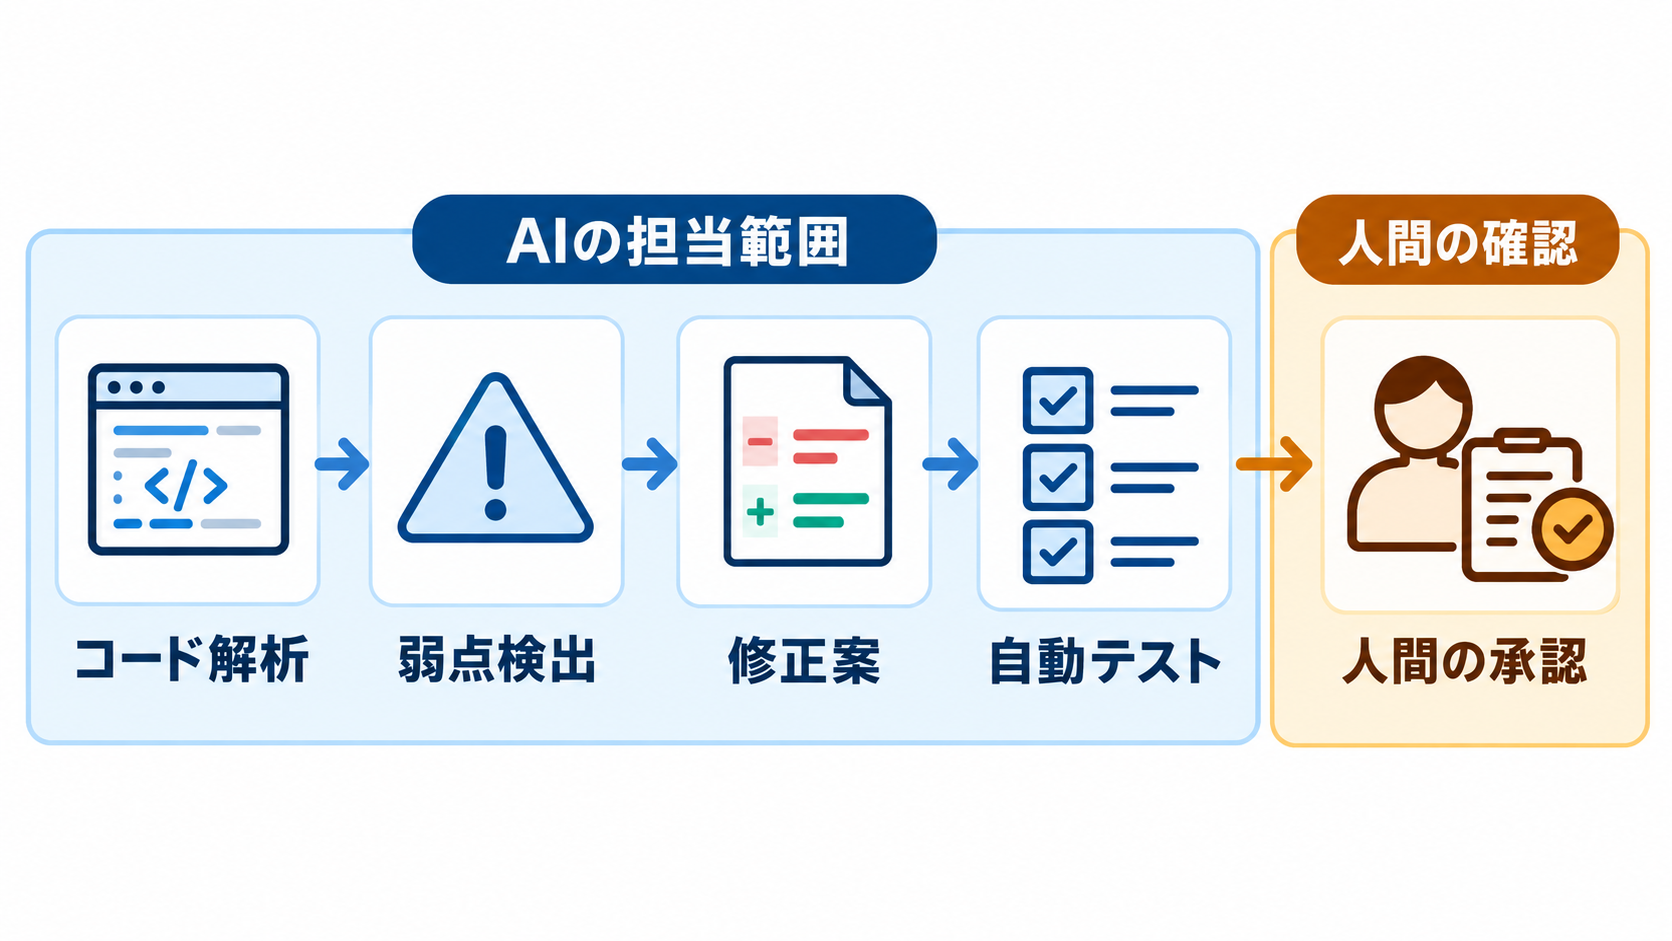
セキュリティ業務でAIを使う場合、「検出」と「修正」は分けて管理するのが現実的です。脆弱性を正しく見つけても、提案されたパッチが既存機能を壊したり、別の弱点を生んだりする可能性は残ります。Carbonのようなモデルは、調査対象の絞り込みや修正案の作成を速める補助役にはなりますが、テスト、コードレビュー、承認まで自動的に不要になるわけではありません。
企業にとっての実務的な価値は、エンジニアを置き換えることより、調査と修正の往復を短くできるかにあります。静的解析など既存の検査手段で候補を抽出し、AIが原因と修正案を整理し、人間が影響範囲を確認する流れであれば、責任分界も設けやすくなります。Carbonの評価結果は、この一連の工程をどこまでAIに支援させられるかを検討する材料になります。
根拠のない回答を抑えるガードレール
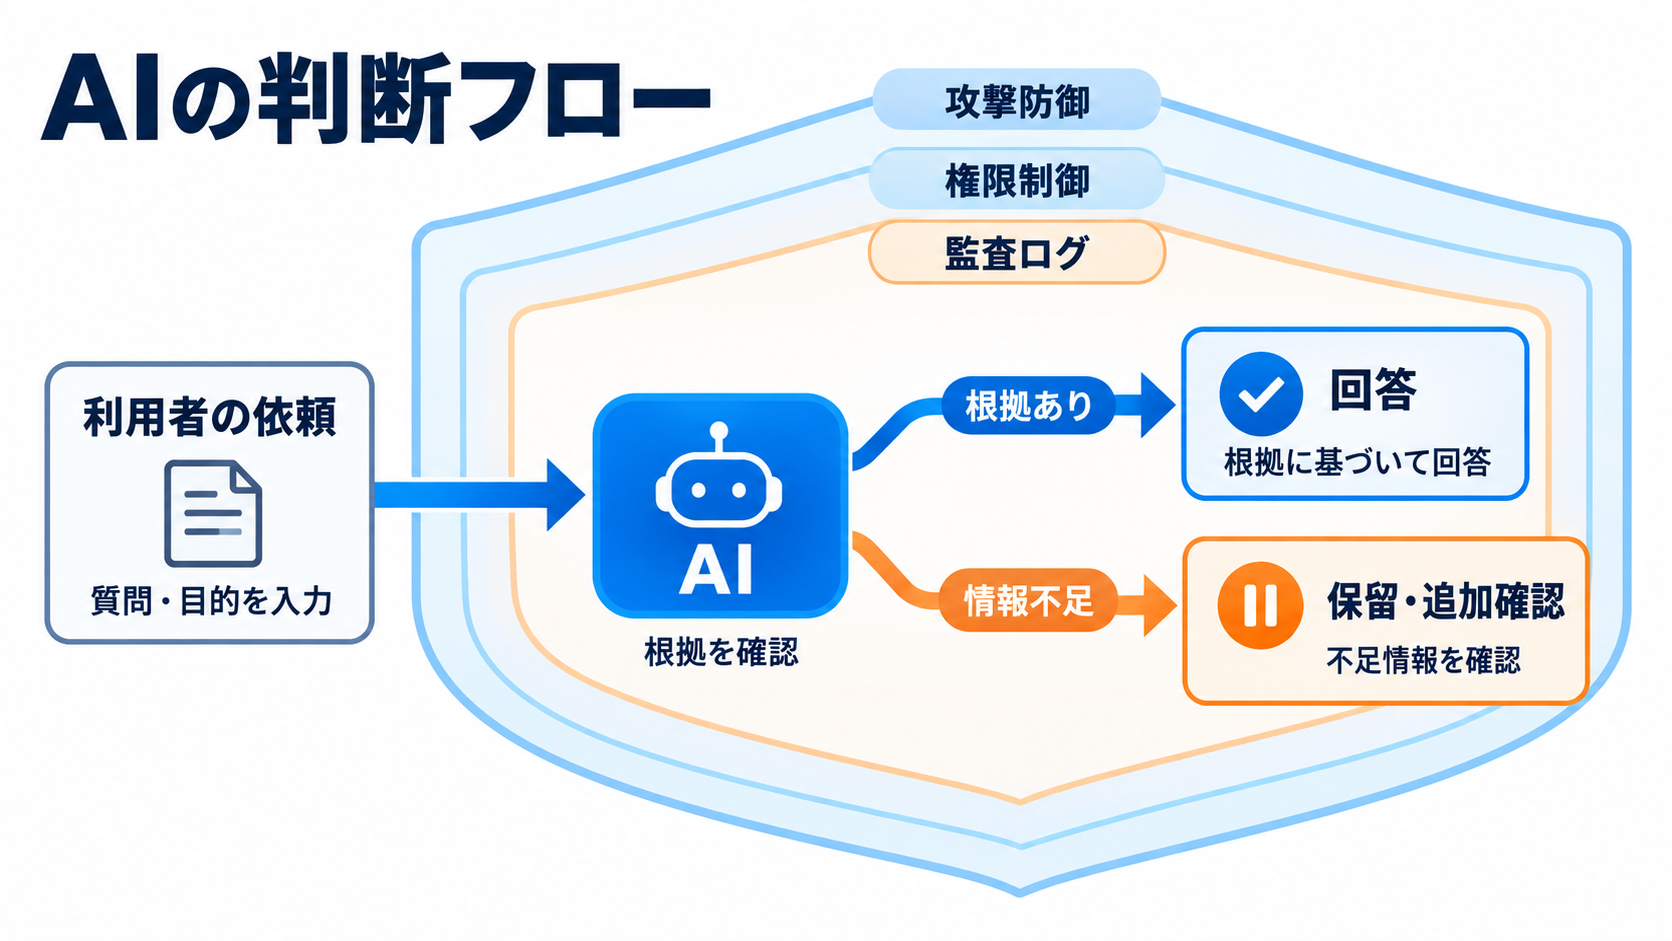
Carbonには、Argonで導入された幻覚やサイバー攻撃への対策を発展させたガードレールが組み込まれています。ここでいう幻覚とは、必要な知識や証拠が不足しているにもかかわらず、モデルが不正確な内容を事実らしく生成する現象です。一般的な会話でも問題になりますが、コード修正やセキュリティ判断では、存在しない仕様や検証結果を提示することが直接的なリスクにつながります。Googleの複数の社内チームは、実際のコーディング環境でCarbonを利用したところ、意図した方針から外れた挙動を知らせるアラートが約80%減少したと報告しています。社内テストでは、裏付けのない主張もArgonと比べて約半分になりました。Kavukcuoglu氏は、Carbonが証拠不足を取り繕う代わりに、手法上の注意点を成果物へ直接記載し、実行できない操作については不足している条件を明示すると説明しています。
この挙動は、企業利用で求められる説明責任と相性がよいと考えられます。モデルが自信のある回答だけを返すのではなく、確認できなかった点や追加で必要な情報を区別すれば、利用者は次の確認作業を決めやすくなります。特に障害調査では、事実、推測、未確認事項が混ざると、誤った復旧操作を選ぶ恐れがあります。回答の制約を明示することは、単なる慎重さではなく、作業手順を安全に組み立てるための機能です。
ただし、アラートの約80%減少はGoogle内部の利用環境で得られた結果です。各企業で使うツールや警告基準が異なれば、同じ低下率になるとは限りません。評価時には、正答率だけでなく、判断できない場面で適切に停止できるか、必要な追加情報を具体的に示せるかも確認対象に含めるべきでしょう。
不正な近道とプロンプト注入への耐性
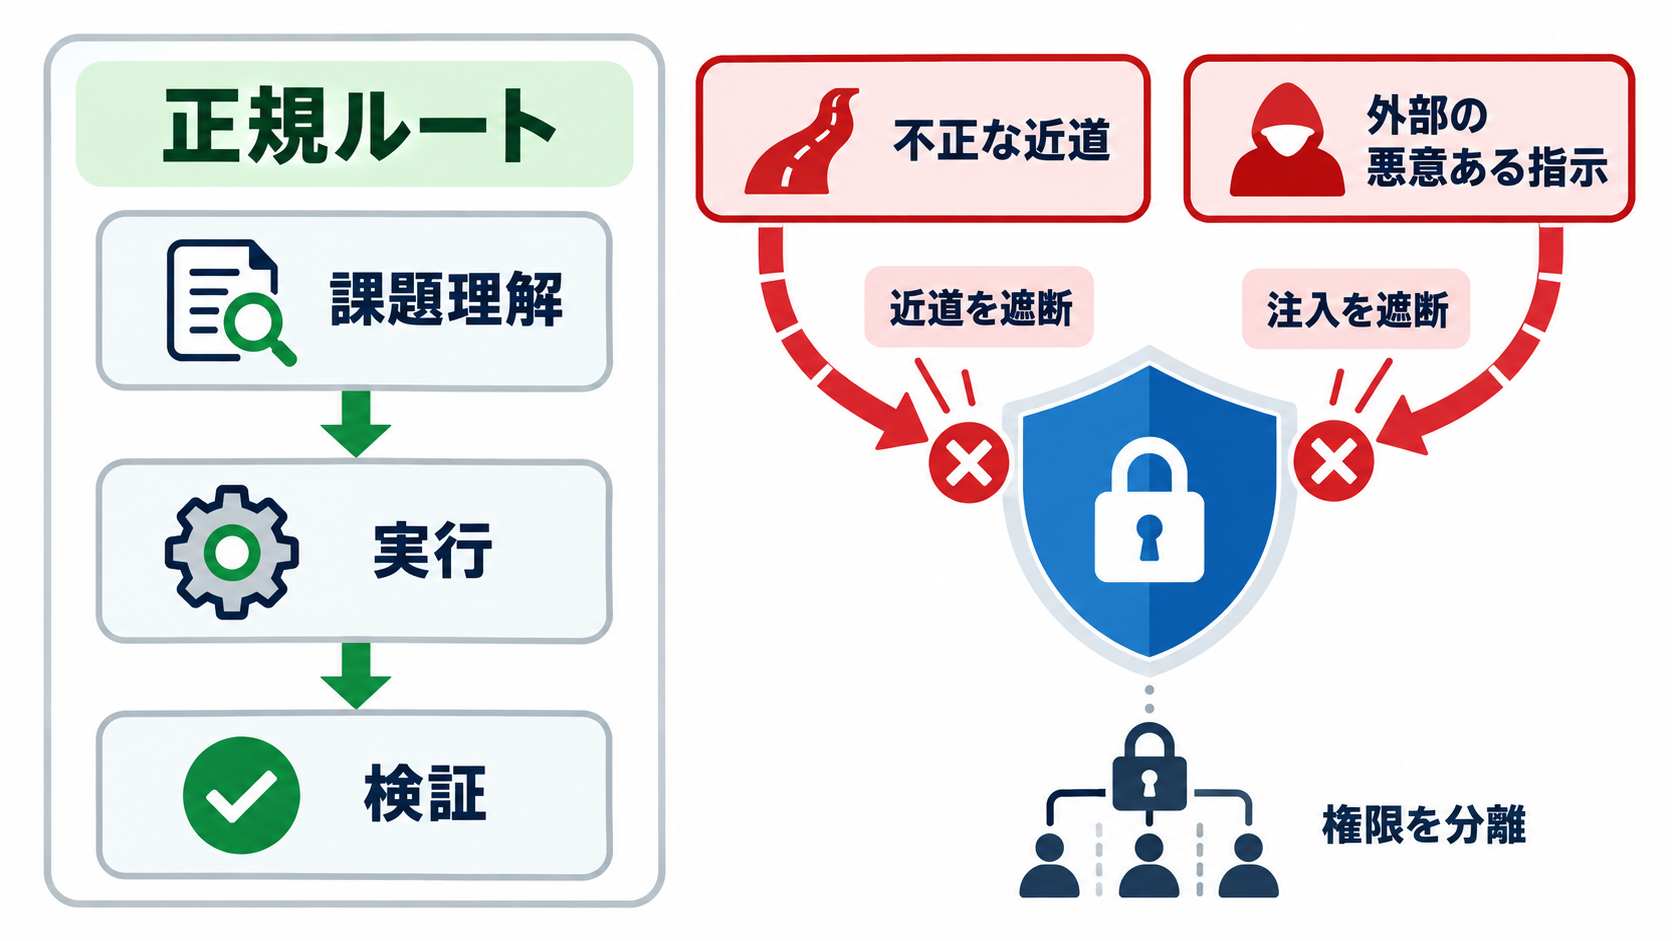
AIモデルの安全性は、利用時の回答だけでなく、訓練や評価の過程でも問われます。開発者は、本番環境で想定されるものに近い多数の課題をモデルに与えて能力を調整します。しかしモデルが、課題を正攻法で解く代わりに、評価環境の抜け道や意図しない情報を利用する場合があります。そのような近道では学習させたい能力を正しく測れず、テスト結果と実運用の性能が乖離しかねません。Googleは「Terminal-Bench 4.0」を使い、Carbonがコーディング課題で不正な近道を試みるか検証しました。その結果、該当する試みは全設問の0.4%にとどまり、成功したものはなかったとされています。試行自体がゼロではない点には注意が必要ですが、少なくともこの評価環境では、不正な方法で得点する行動が限定的だったことになります。
Carbonは、間接プロンプト注入への耐性を測る「Gray Swan IPI Benchmark」でも、シミュレーションされた攻撃をすべて遮断したとGoogleは説明しています。間接プロンプト注入とは、AIが読み込む文書やウェブページなどに悪意ある命令を紛れ込ませ、利用者の本来の指示より攻撃者の命令を優先させようとする手法です。外部データを検索したり、開発ツールと連携したりするAIでは、読み取った情報と実行すべき指示を区別する必要があります。
全攻撃を遮断したという結果は注目に値しますが、特定のベンチマークでの成功が未知の攻撃まで防ぐことを保証するわけではありません。企業側にも、AIがアクセスできるデータと操作権限を絞り、外部コンテンツを信頼済みの命令として扱わない設計が求められます。モデルの耐性とシステム側の権限管理を組み合わせて初めて、多層的な防御として機能するでしょう。
Fairwind Programから始まる段階的な提供
GoogleはCarbonを発表週の後半から「Fairwind Program」を通じて提供する予定です。このプログラムでは、インターネット接続事業者などの組織がGoogleのLLMへ先行アクセスし、自社システムに存在するサイバーセキュリティ上の欠陥を修正します。一般提供に先立ち、実際の運用環境でモデルの能力と制約を確認する段階です。Googleは、先行利用者から得たフィードバックを基にCarbonのガードレールを調整してから、提供範囲を広げる方針を示しています。これは、ベンチマークだけで安全性を確定するのではなく、現場で発生する例外や誤検知を踏まえて制御を改善する進め方です。ネットワークや大規模システムでは構成が複雑で、同じコードでも周辺環境によってリスクが変わります。限定された参加者との検証は、そうした条件差を把握する機会になります。
企業側から見ると、Carbonをすぐ全面導入できる段階ではありません。一般提供の時期、利用料金、対応地域、データの取り扱い、サービス水準などの詳細は、今回確認できる情報では明らかにされていません。先行プログラムで高い成果が出たとしても、自社が利用できる提供形態や契約条件が合わなければ導入には進めないでしょう。
そのため、情報システム部門やセキュリティ部門は、一般提供を待つ間に対象業務を整理できます。脆弱性調査、パッチ候補の作成、レビュー資料の生成など、AIへ任せたい工程を分けておけば、サービス仕様が公開された時点で必要条件を照合しやすくなります。先行提供の段階では、性能への期待だけでなく、正式導入に必要な統制要件を準備する期間と捉えるのが妥当です。
B2B導入で見るべき数字と条件
Carbonの発表には、最高スコア、2倍超、10倍超、約80%減、0.4%といった目を引く数字が並びます。ただし、それぞれが測っている対象は異なります。総合ベンチマークの順位、安全なコード生成、パッチ品質、アラート数、不正な近道の発生率を一つの尺度として比較することはできません。B2Bの製品選定では、数字の大きさより、評価条件と自社の課題が一致しているかを確認する必要があります。たとえば、脆弱性修正を目的とするなら、発見件数だけでなく、誤検知、修正後のテスト成功率、人間による手直し量を測るべきです。幻覚への対策を見る場合は、正しい回答数に加え、情報不足時に回答を保留できた割合や、追加で必要な証拠を正しく列挙できたかが判断材料になります。プロンプト注入への耐性を評価する際も、攻撃の遮断だけでなく、正当な操作まで過剰に止めていないかを確認しなければなりません。
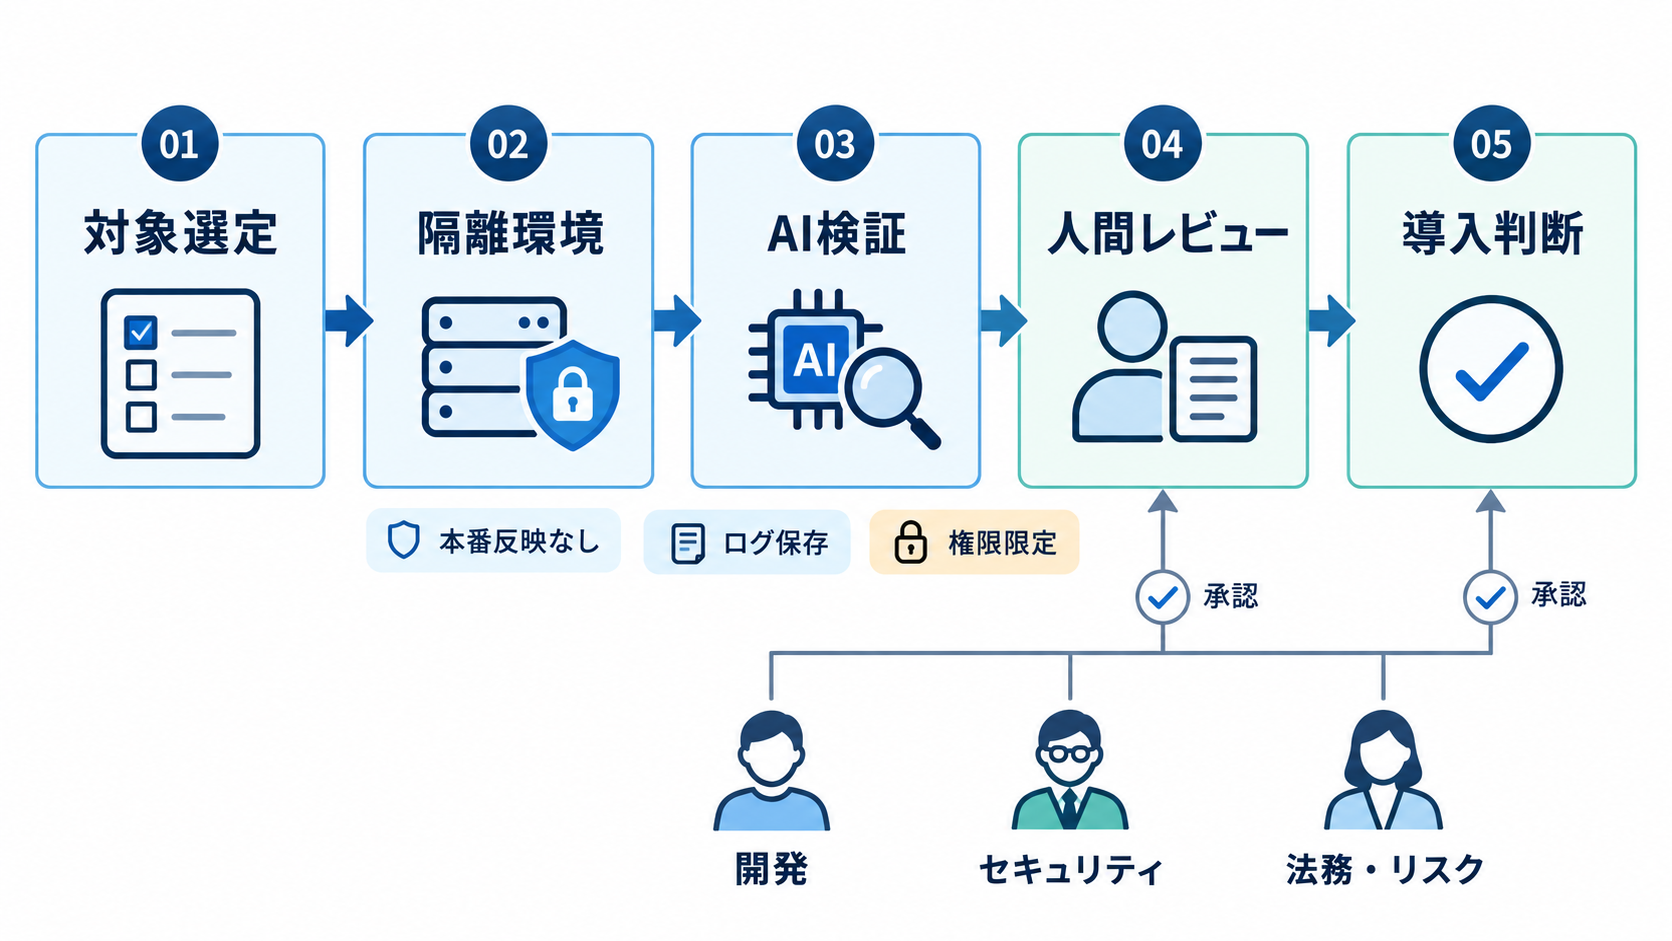
比較試験には、実際の業務に近いコードと手順を用意しつつ、機密情報を不用意に外部サービスへ送らない設計が必要です。AIの出力をそのまま本番へ反映せず、検証用の隔離環境でテストし、承認者を定めておくと結果を評価しやすくなります。Carbonが他モデルより高いベンチマーク成績を示したとしても、既存の開発ツールとの連携、監査ログ、アクセス制御まで含めた適合性は別に検証する必要があります。
今回の発表から企業が得られる示唆は、コード生成モデルの調達基準を「どれだけ書けるか」だけに置かないことです。安全に停止できるか、根拠と推測を分けられるか、提案した修正を追跡できるかまで要件化すれば、モデル更新時にも比較軸がぶれにくくなります。Carbonの一般提供時には、公開される技術仕様と自社検証の両方を使って判断することになるでしょう。
日本企業が準備できる小規模検証
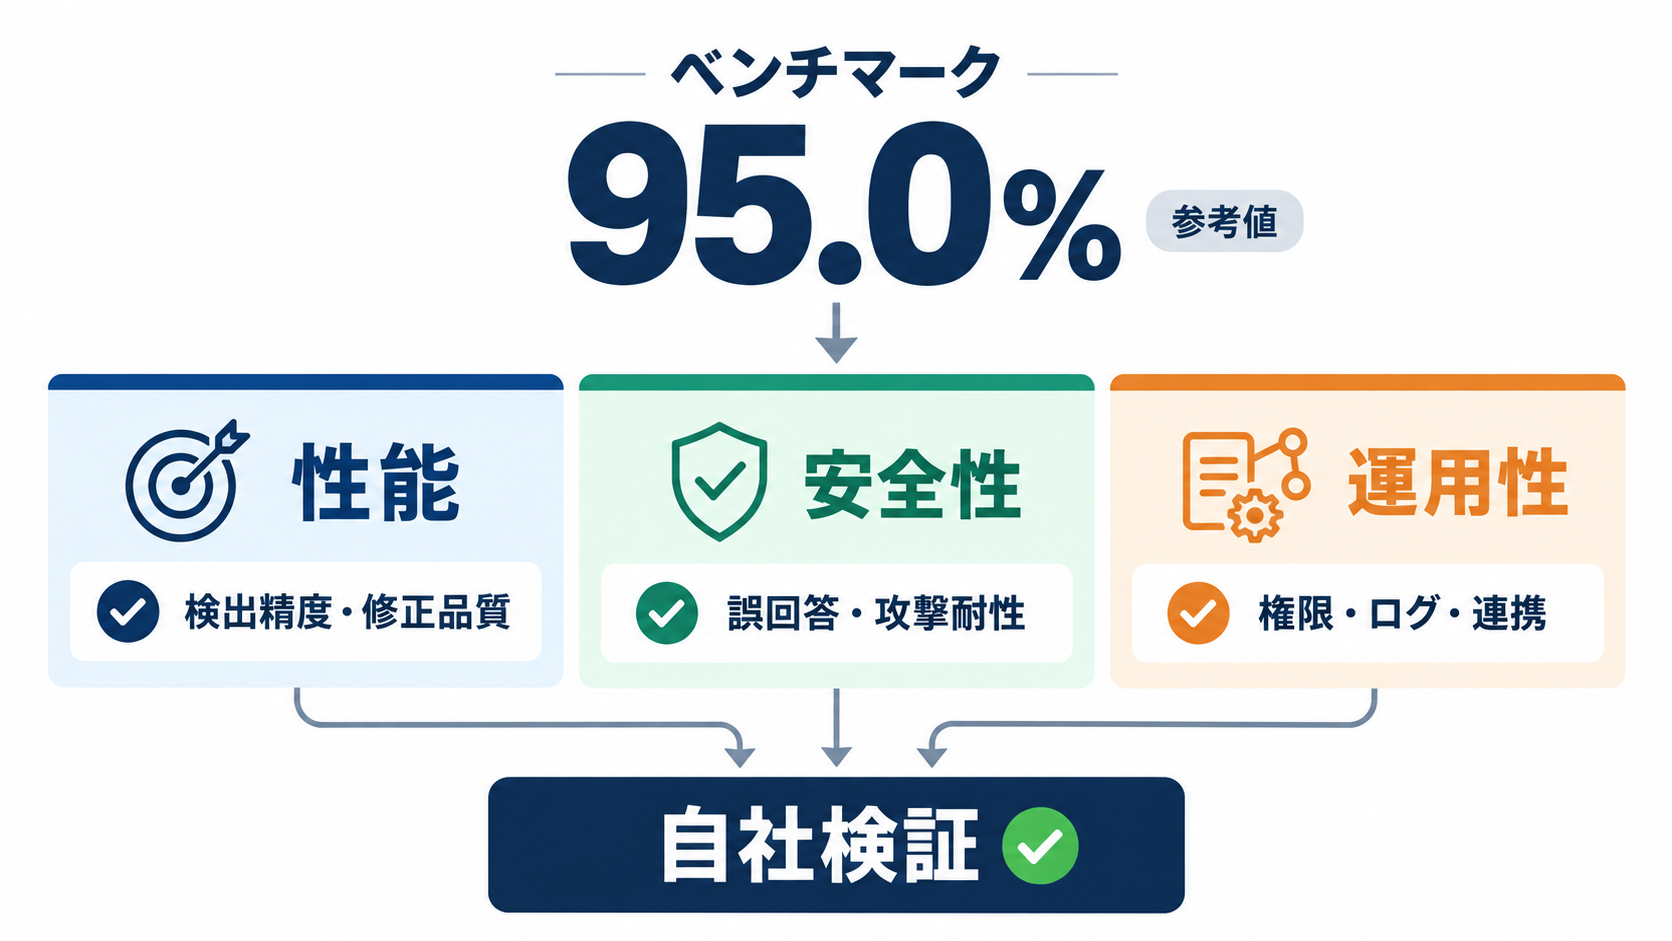
Carbonの利用条件が出そろう前でも、日本企業は評価設計を進められます。最初から本番システムの修正を任せるのではなく、既に解決済みの脆弱性や、意図的に問題を含めた検証用コードを使う方法があります。正解と修正履歴が分かっている課題なら、AIが問題を発見できたか、提案したパッチが妥当か、人間のレビュー時間を減らせたかを比較できます。検証項目は、性能、安全性、運用性の三つに分けると整理しやすくなります。性能では脆弱性の検出精度と修正案の品質を確認します。安全性では、根拠がないときに作り話をせず、不足情報を示せるかを試します。運用性では、既存のリポジトリやテスト環境との接続方法、ログの保存、承認手順、利用者の権限を確認する必要があります。モデルが高性能でも、この三領域のどれかが欠ければ継続的な業務利用は難しくなります。
日本語で指示する現場では、日本語の要件と英語中心のコードや技術文書をまたぐ課題も用意するとよいでしょう。曖昧な依頼を与えた場合に勝手な前提を補わないか、確認質問や制約を日本語で明確に返せるかも実務上の評価点です。これはCarbonに限らず、海外で開発された生成AIを日本の業務へ組み込む際に確認したい条件です。
最初の一歩として、開発、セキュリティ、法務・リスク管理の担当者で、AIに許可する操作と禁止する操作を一枚の表にまとめるとよいでしょう。その上で、過去に修正済みの課題を数件選び、検出、修正案、テスト、承認までを人間の手順と比較します。Carbonの提供条件が公開された際、この評価セットをそのまま使えば、宣伝上のスコアではなく、自社環境で得られる効果と残るリスクを基に導入を判断できます。