
AI LAB
2026/10/21
データベースをそのまま予測に使う、NVIDIA Kumo Relationalが変える企業AI開発
個別の機械学習プロジェクトから「予測クエリ」への転換
「どの顧客が解約しそうか」「来月どの商品が売れるか」「不正の疑いが強い取引はどれか」。企業が知りたい答えの多くは、すでに顧客、注文、商品、決済などのデータベースに眠っています。ところが、従来の機械学習では、問いが一つ増えるたびに学習データを作り、特徴量を設計し、専用モデルを訓練する作業が必要でした。試験導入までは進んでも、用途ごとのパイプラインを保守しきれず、利用部門を広げられないケースも珍しくありません。NVIDIA Kumo Relationalは、この開発単位をモデルではなく「予測したい問い」へ移そうとするリレーショナル基盤モデルです。データベースを接続して予測対象を指定すると、最大1万件の過去事例を推論時の文脈として読み込み、単一のフォワードパスで結果を返します。タスクごとの訓練や手作業の特徴量設計、複数テーブルを一枚の表へ平坦化する処理は必須ではありません。
ここで中心となる変化は、万能な精度を約束することではなく、新しい予測業務を試すまでの準備を減らせる点です。一つの事前学習済みモデルを解約、需要、不正検知などに使えれば、採算が合わず見送られていた小規模な用途も検証しやすくなります。NVIDIAは、人が利用する分析環境に加え、AIエージェントから呼び出す構成も想定しています。企業にとってはモデル単体の性能だけでなく、予測テーマを追加するたびに発生していた開発・運用負担をどこまで圧縮できるかが、導入判断の軸になるでしょう。
一枚の表への加工で失われていた関係性
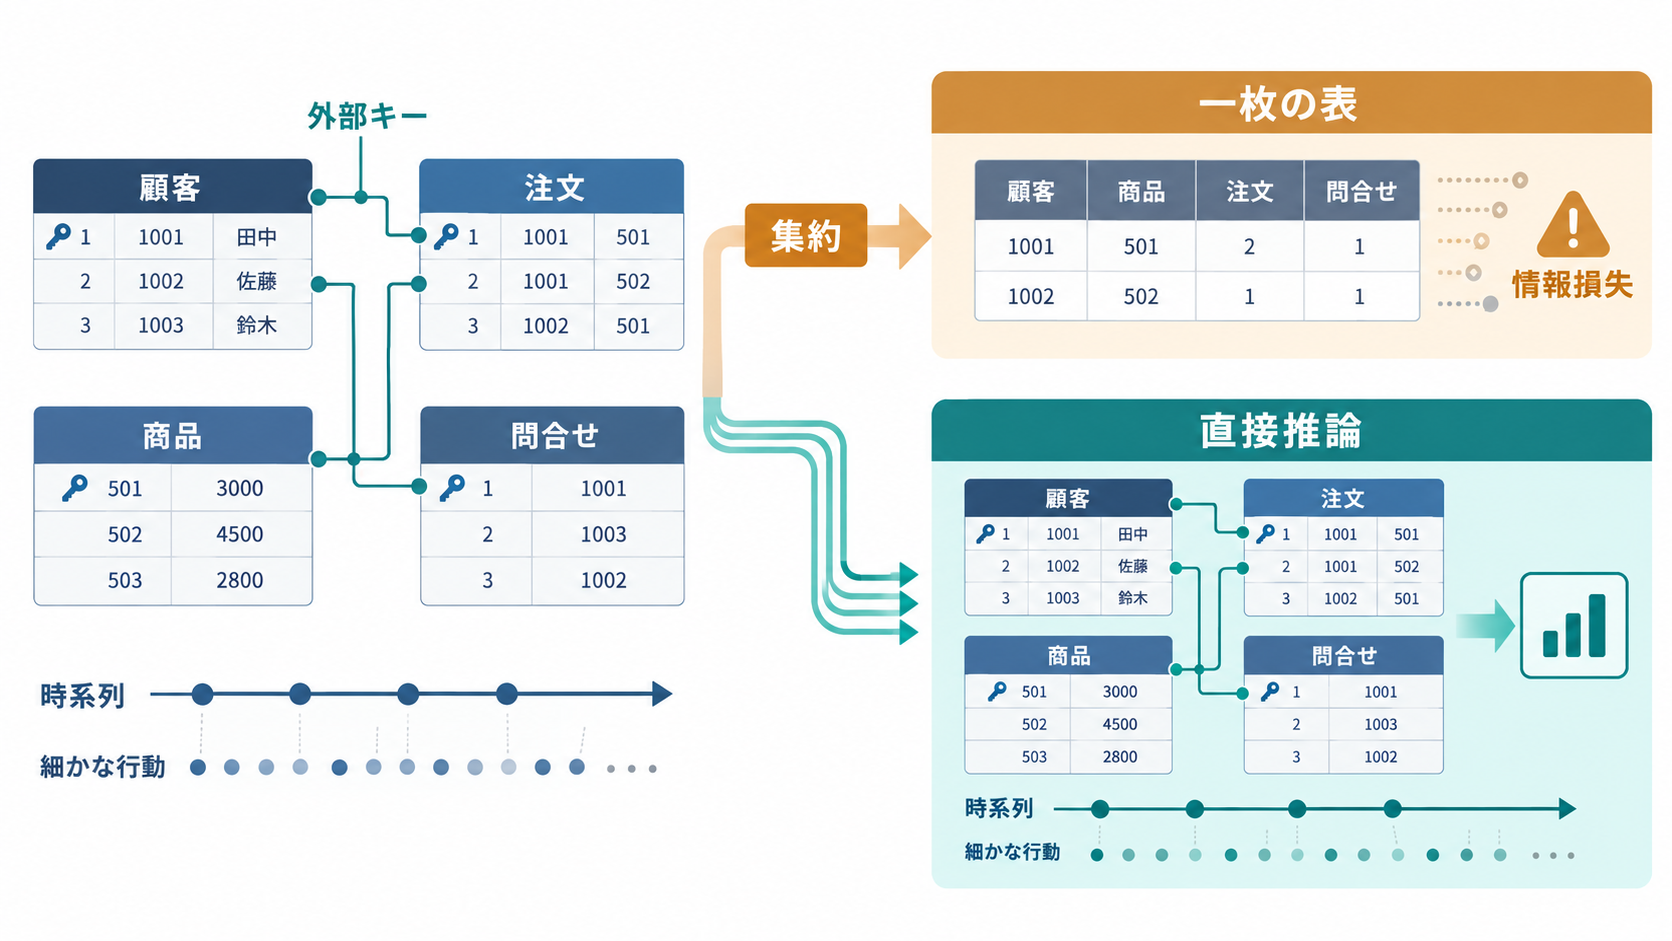
一般的な表形式モデルは、一行に一つの顧客や商品を置き、その横に年齢、購入回数、平均単価といった列を並べます。しかし実際の業務データは、顧客テーブルと注文テーブル、注文明細、商品、問い合わせ履歴などに分かれ、主キーと外部キーで結ばれています。時間情報も欠かせません。予測時点より後に発生した出来事を誤って特徴量へ混ぜれば、運用時には得られない情報を使う「データ漏洩」が起き、検証結果だけが不自然に高くなります。従来は、こうしたデータをモデルへ渡すため、「直近30日間の平均注文額」や「過去90日間の問い合わせ回数」のような集約値を人が設計していました。業務知識を反映できる利点はあるものの、集約方法を決めた時点で、個々の取引順序や商品同士のつながりといった細かな信号が薄れる可能性があります。予測テーマが変われば、期間や集約単位も作り直さなければなりません。
Kumo Relationalは、テーブル構造、外部キー、タイムスタンプを保ったまま処理します。顧客を予測する場合には、その顧客を中心とする局所的なサブグラフを組み立て、関連する注文や商品などを参照します。固定された集約式に頼らず、現在の問いに役立つ行や列、テーブル間の接続をモデル側で選別する設計です。
この違いは、データ加工が全面的に不要になるという意味ではありません。キーの不整合や時刻の欠落、業務上の意味が曖昧な列まで自動的に解決できるわけではないからです。価値が変わるのは、データを信頼できる状態に整えた後、予測テーマごとに大量の特徴量を作る工程です。データ基盤の整備は引き続き必要ですが、その上に載せる機械学習開発を軽くできる可能性があります。
表の内部とテーブル間を分けて推論する仕組み
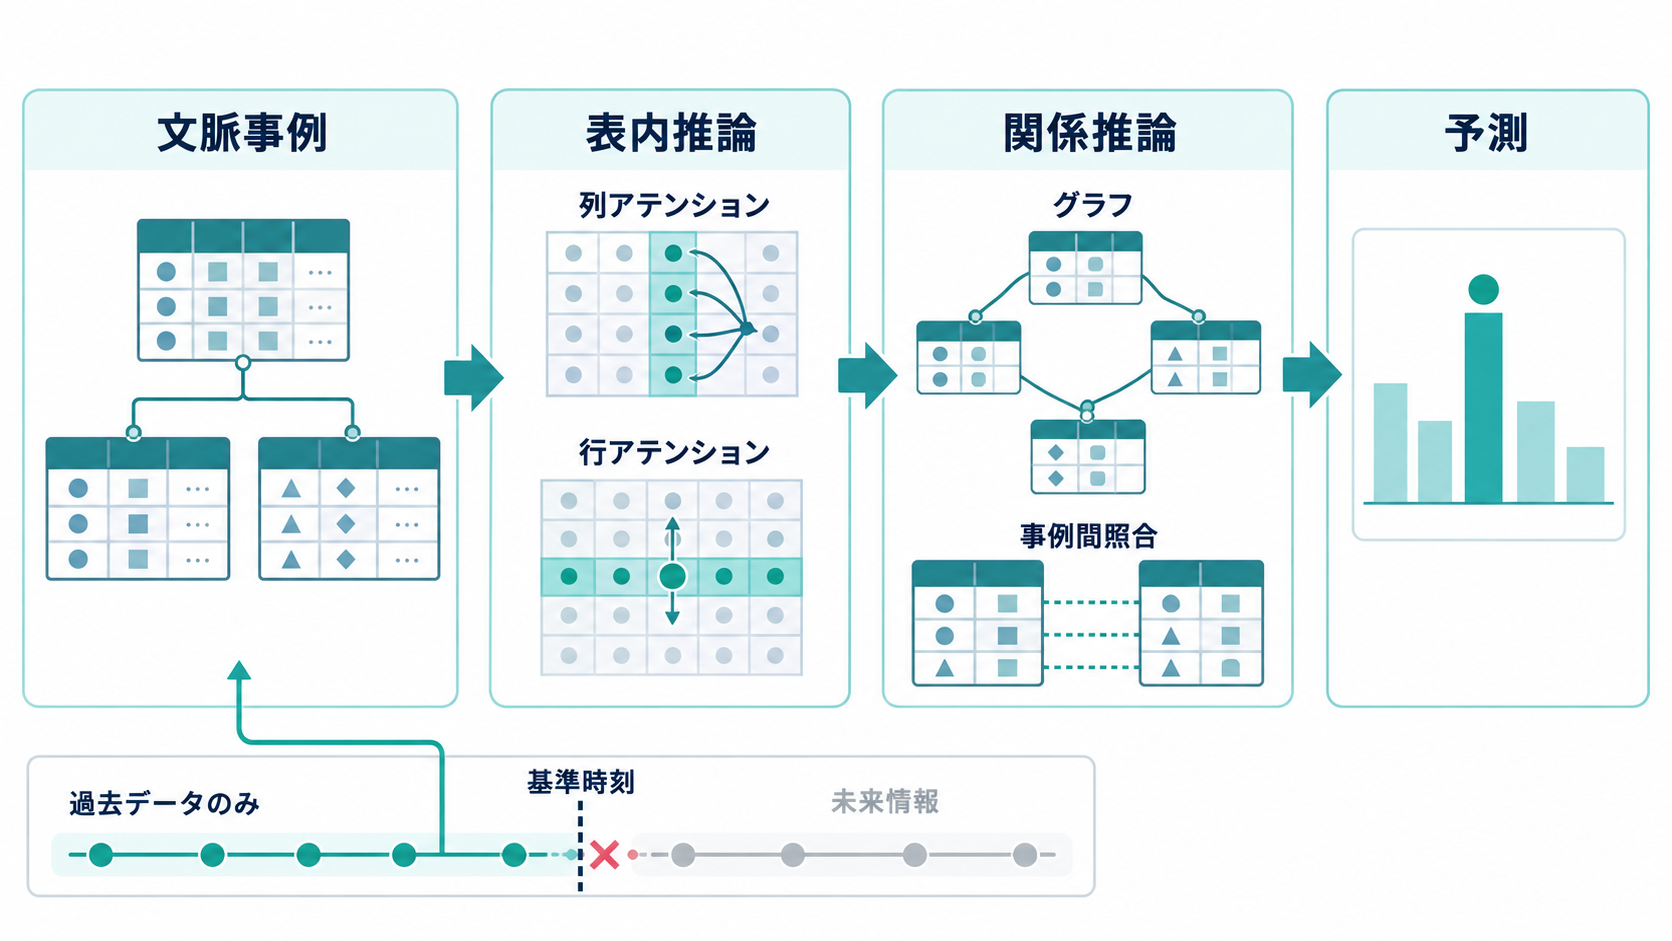
Kumo Relationalは、新しい予測に対して最大1万件の既知事例を文脈として利用します。それぞれの事例は、ある時点の顧客や商品を中心とした局所サブグラフと、その後に判明した正解値の組み合わせです。解約予測なら「この時点までに観測できた顧客情報」と「その後に解約したかどうか」を対にします。未知の対象については、似た構造を持つ既知事例を踏まえて結果を推定します。時間を伴うタスクでは、過去のデータベース状態を再現します。基準時刻より前の情報だけをモデルへ渡し、正解値は基準時刻より後の出来事から計算するため、将来情報の混入を抑えられます。この文脈生成は、何を予測するかを宣言するPredictive Query Language、略してPQLを起点に自動化されます。
モデル内部では、処理が大きく二段階に分かれます。各テーブル内では、列方向のアテンションで同じ項目の値を関係付け、行方向のアテンションで一レコード内の特徴を結び付けます。ここでは、予測に関係しにくい行や列を絞り、後段へ伝わるノイズを減らします。
テーブル間では、主キーと外部キーが作るグラフに沿って行の埋め込み表現を伝播させます。同時に、既知の文脈事例同士と予測対象を照合するクロスサンプル・アテンションも用いられます。すべてのセルを互いに比較するのではなく、表内で整理した行表現を使うため、計算量の急増を避けながら深い関係をたどれる設計です。表形式モデルとグラフモデル、インコンテキスト学習を一つの予測処理に組み合わせた点が、Kumo Relationalの技術的な特徴となっています。
公開データ不足を補う合成データでの事前学習
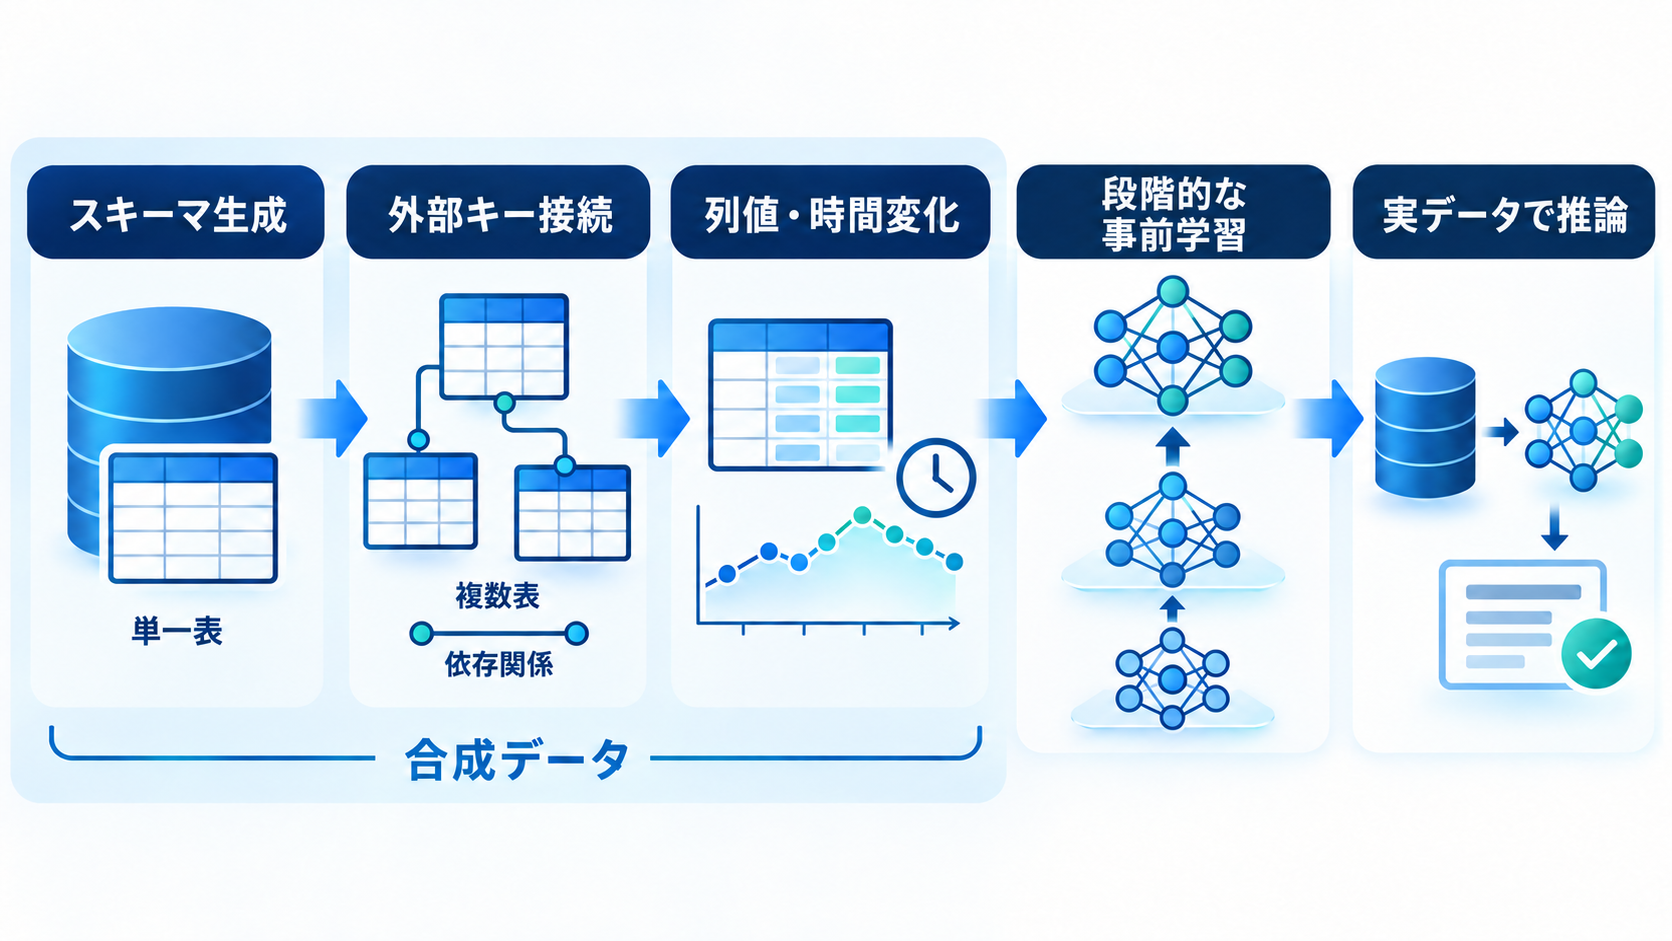
企業のリレーショナルデータベースには、顧客情報や取引履歴などの機密データが含まれます。言語モデルが公開テキストを大量に集められるのとは異なり、構造と正解ラベルを備えた実在の企業データベースを、事前学習用として幅広く収集することは容易ではありません。Kumo Relationalは、この制約に対して、事前学習をすべて合成リレーショナルデータで行う方法を採用しています。合成データの生成には、単一テーブル向けの生成手法を複数テーブルへ拡張したPluRelの考え方が使われています。生成処理では、テーブルや列からなるスキーマを作成し、実データに見られるまとまりを意識して行同士を外部キーで接続します。その後、時間的な傾向やテーブルをまたぐ依存関係を含む列値を、構造的因果モデルに基づいて生成します。事前学習は単一テーブルから始まり、段階的に複雑な関係構造へ進みます。
この方法でモデルが学ぶのは、特定企業の顧客像や商品知識ではありません。複数の表から必要な情報を絞り、関連付け、集約して予測へつなげる汎用的な処理です。生成が比較的軽量であるため、異なるスキーマや依存関係を持つデータベースを増やしやすく、PluRelの研究では、合成データベースの追加に伴う学習損失の変化と実データへの効果が報告されています。
ただし、合成データだけで各社固有の業務慣行まで再現できるとは限りません。特殊な商流や例外処理、観測されにくい偏りが予測に強く影響する用途では、汎用モデルの出力を実データで検証する必要があります。精度を優先する場合には、特定のデータセットとタスクを使ったファインチューニングも用意されています。合成データによる事前学習は出発点を共通化する仕組みであり、個別検証を省略する仕組みではありません。
41タスクで示された精度と処理効率
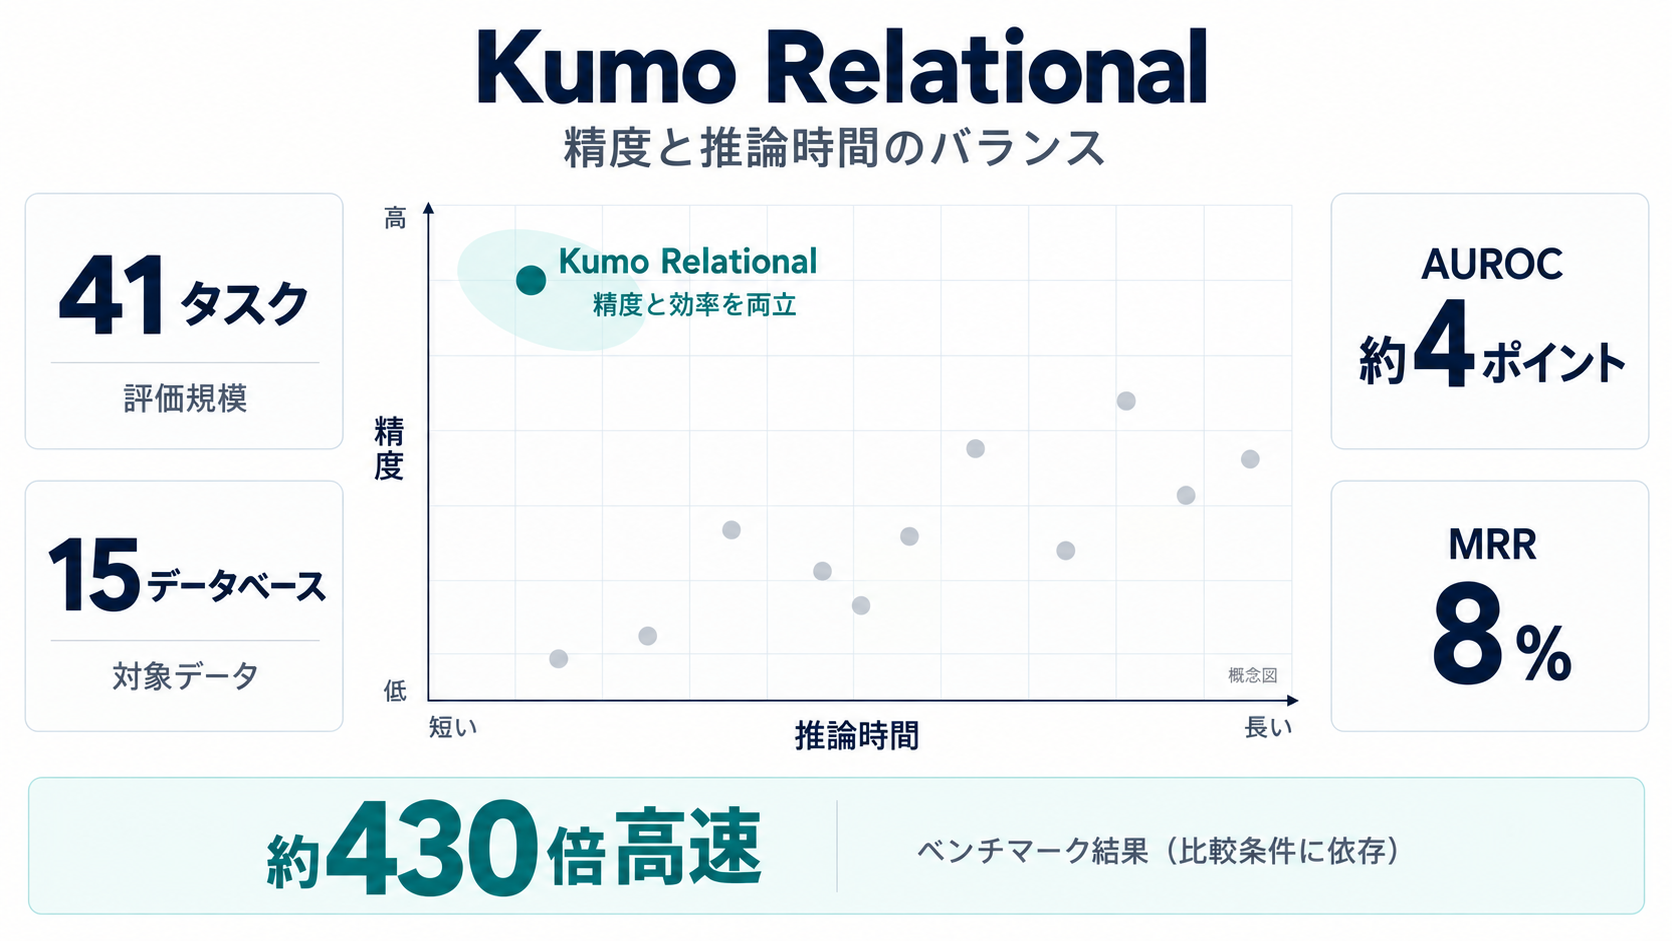
Kumo Relationalは、RelBench V1・V2、SAP SALT、4DBInferに含まれる15のリレーショナルデータベース、計41タスクで評価されています。対象分野は電子商取引、医療、企業活動、ソーシャル、学術にまたがり、これらの評価用データは事前学習には使われていません。分類と回帰の両方で、教師ありのリレーショナル深層学習モデルや、専門家が特徴量を設計した表形式モデルを上回ったと報告されています。RelBench V1の分類タスクでは、専門家が作った特徴量を使う勾配ブースティング木に対し、AUROCの平均で約4ポイント高い結果となりました。AUROCは、陽性と陰性をどの程度適切に順位付けできるかを見る指標で、値が高いほど識別性能が良いことを示します。SAP SALTでは、大規模なAutoGluonアンサンブルを平均逆順位、MRRで8%上回り、ファインチューニング後には差が16%へ広がったとされています。MRRは、正しい候補がランキングの上位に現れるほど高くなる指標です。
精度だけでなく、処理効率も評価されています。RelArena-αでは、Kumo Relationalが精度と推論時間のパレート前線に位置し、最も高得点だった別の構成に近い精度を保ちながら、1,000件当たりの推論が約430倍高速だったと報告されました。文脈に使える学習データが全体の0.2%しかない条件や、外部キー接続の最大75%を取り除いた条件、多数のノイズ列を加えた条件でも、性能が大きく崩れにくい傾向が確認されています。
これらは共通ベンチマーク上の結果であり、個別企業のデータでも同じ差が出るとは限りません。ラベル定義、時間範囲、欠損、クラスの偏り、既存パイプラインの成熟度によって比較結果は変わります。数値の大きさだけで採用を決めず、既存モデルと同じデータ分割、同じ運用制約、同じ業務指標で並行評価することが妥当でしょう。
高精度を引き出しやすい条件と限界
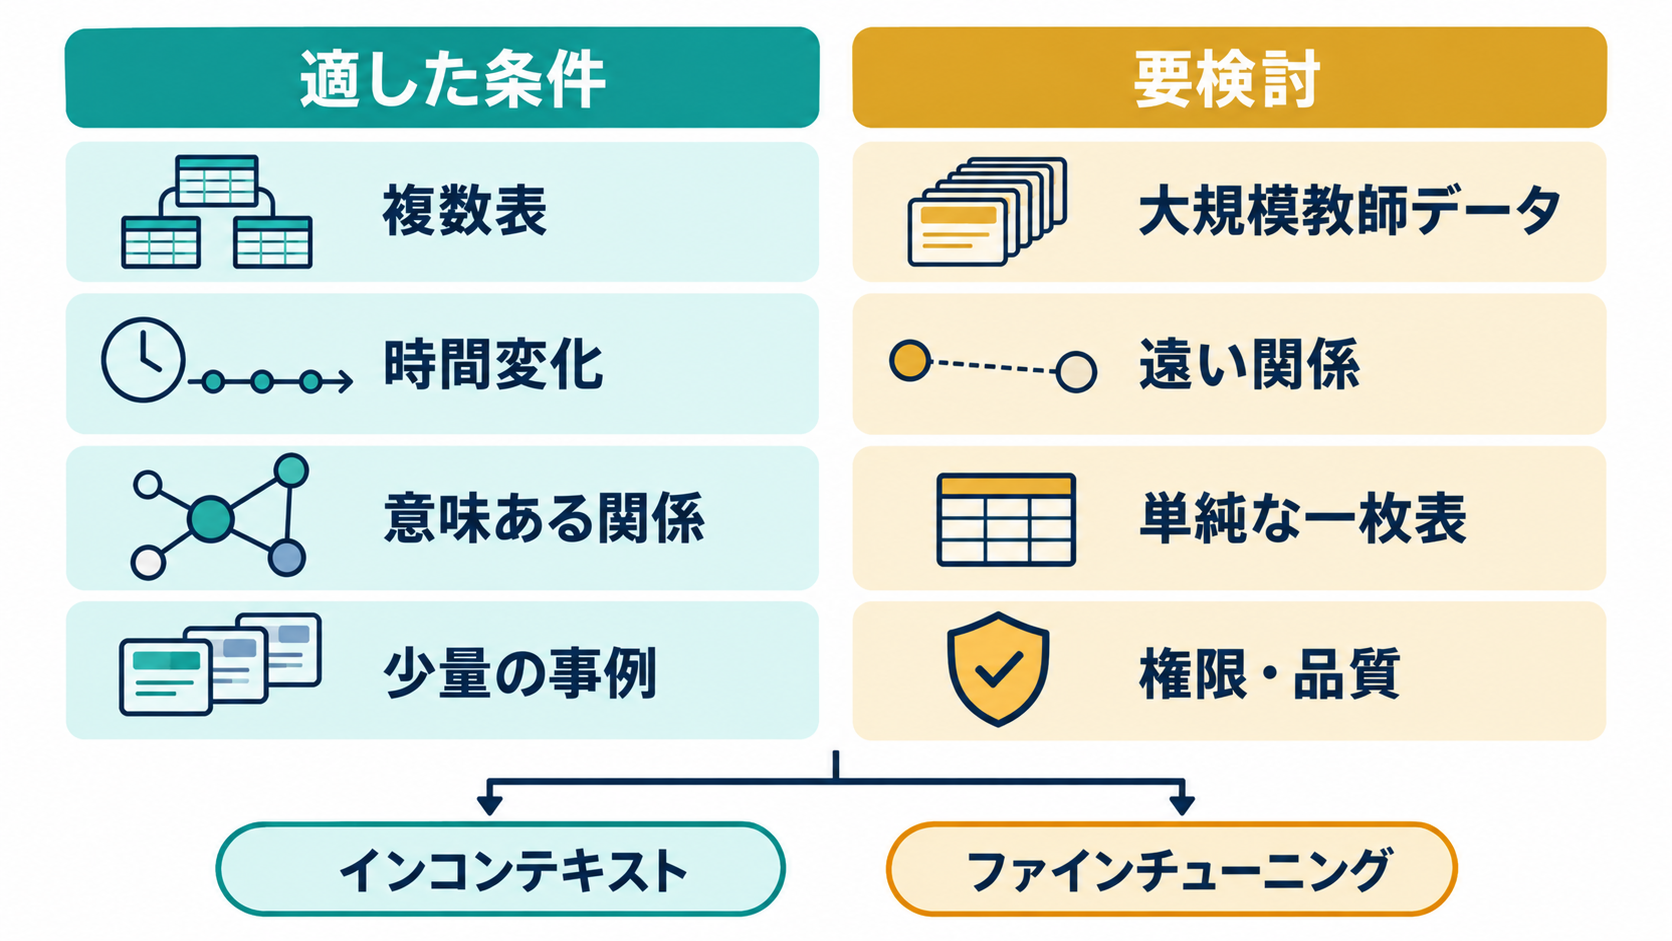
Kumo Relationalが力を発揮しやすいのは、テーブル間に意味のある関係があり、行動が時間とともに変化するデータです。顧客と注文、商品と販売履歴のように、対象の周囲に予測材料となる出来事が蓄積されている場合が該当します。反対に、単一テーブル内の少数項目だけで答えが決まるタスクでは、リレーショナル推論の利点が小さくなる可能性があります。インコンテキスト推論で参照する既知事例は、評価時点では最大1万件です。大規模なラベル付き学習データがあり、そのタスク専用に十分調整された教師ありモデルは、汎用モデルのインコンテキスト予測を上回る場合があります。NVIDIAは、そのような用途にファインチューニングを位置付けています。汎用モデルと専用モデルを排他的に選ぶのではなく、迅速な初期検証には前者を使い、事業価値とデータ量が大きいテーマでは後者へ進む運用が考えられます。
予測信号は、対象から限られたホップ数で到達できる範囲に存在する必要もあります。最初から社内の全テーブルを接続するより、対象と直接関係する数表で問いを定義し、必要に応じて探索範囲を広げる方が扱いやすいでしょう。無関係な接続を増やすほど、計算負荷だけでなく、予測根拠やアクセス権限の確認も複雑になります。
運用面では、データ品質、権限管理、個人情報の取り扱い、予測誤りによる影響も確認しなければなりません。コードはApache 2.0ライセンスで公開されていますが、モデルの重みにはOpenMDW License Agreement 1.1が適用されます。両者を同一条件とみなさず、想定する配布方法や商用利用が各条件に適合するかを確認する必要があります。業界規制や社内審査が関わる用途では、精度試験と並行して法務・セキュリティ部門を含む評価体制を整えるのが現実的です。
AIエージェントに予測能力を組み込むPQL
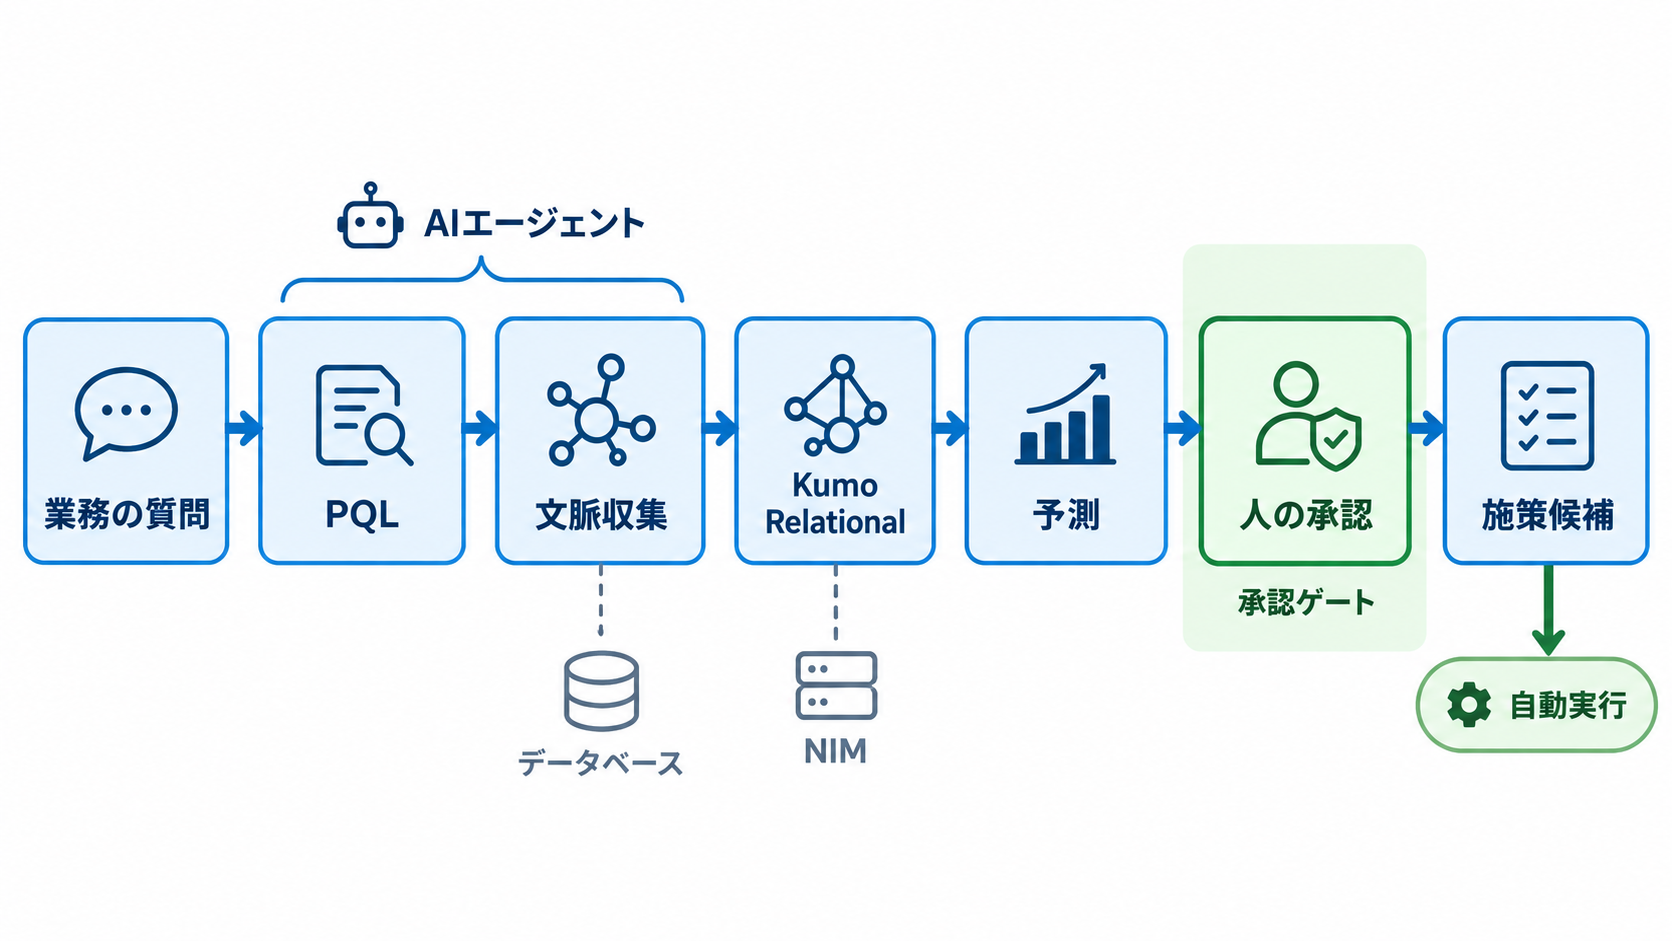
大規模言語モデルを使うAIエージェントは、文書の検索や要約、システムへの入力といった作業を扱えます。しかし、データベースに記録された関係と時間変化から「次に何が起きそうか」を推定するには、別の予測モデルや分析基盤が必要でした。Kumo Relationalは、エージェントから呼び出せるリレーショナル予測機能として設計されており、その接点となるのがPQLです。PQLでは、処理手順ではなく予測したい対象を宣言します。たとえば、利用者ごとに今後30日間の注文数を予測する問いを記述すると、クライアント側が文脈事例と関連テーブルを収集し、モデルへ送信します。自然言語による依頼をPQLへ変換する構成も想定されているため、エージェントは用途別の学習パイプラインを直接操作せずに予測を要求できます。
提供形態には、オープンソースのGPUネイティブライブラリ「structured-data-models」と、独立したサービスとして展開できるNVIDIA NIMがあります。ライブラリは初回利用時にHugging Face Hubからモデルの重みを取得し、GPUを備えたノートブックなどで利用できます。データベースやデータウェアハウスとのコネクターに加え、メモリマップI/Oを用いて5,000億行超を扱い、最大毎秒5GBで読み出すカスタムグラフエンジンも示されています。
ただし、予測できることと、業務判断を自動化してよいことは別です。解約防止施策や不正取引の保留には、顧客体験や金銭的な影響が伴います。エージェントに接続する場合は、予測値の利用範囲、承認が必要な操作、失敗時の停止条件を明示するべきでしょう。PQLによって問い合わせが簡単になるほど、誰がどのデータを用いて何を予測できるかという統制が重要になります。
日本企業が試すなら一業務・数表から
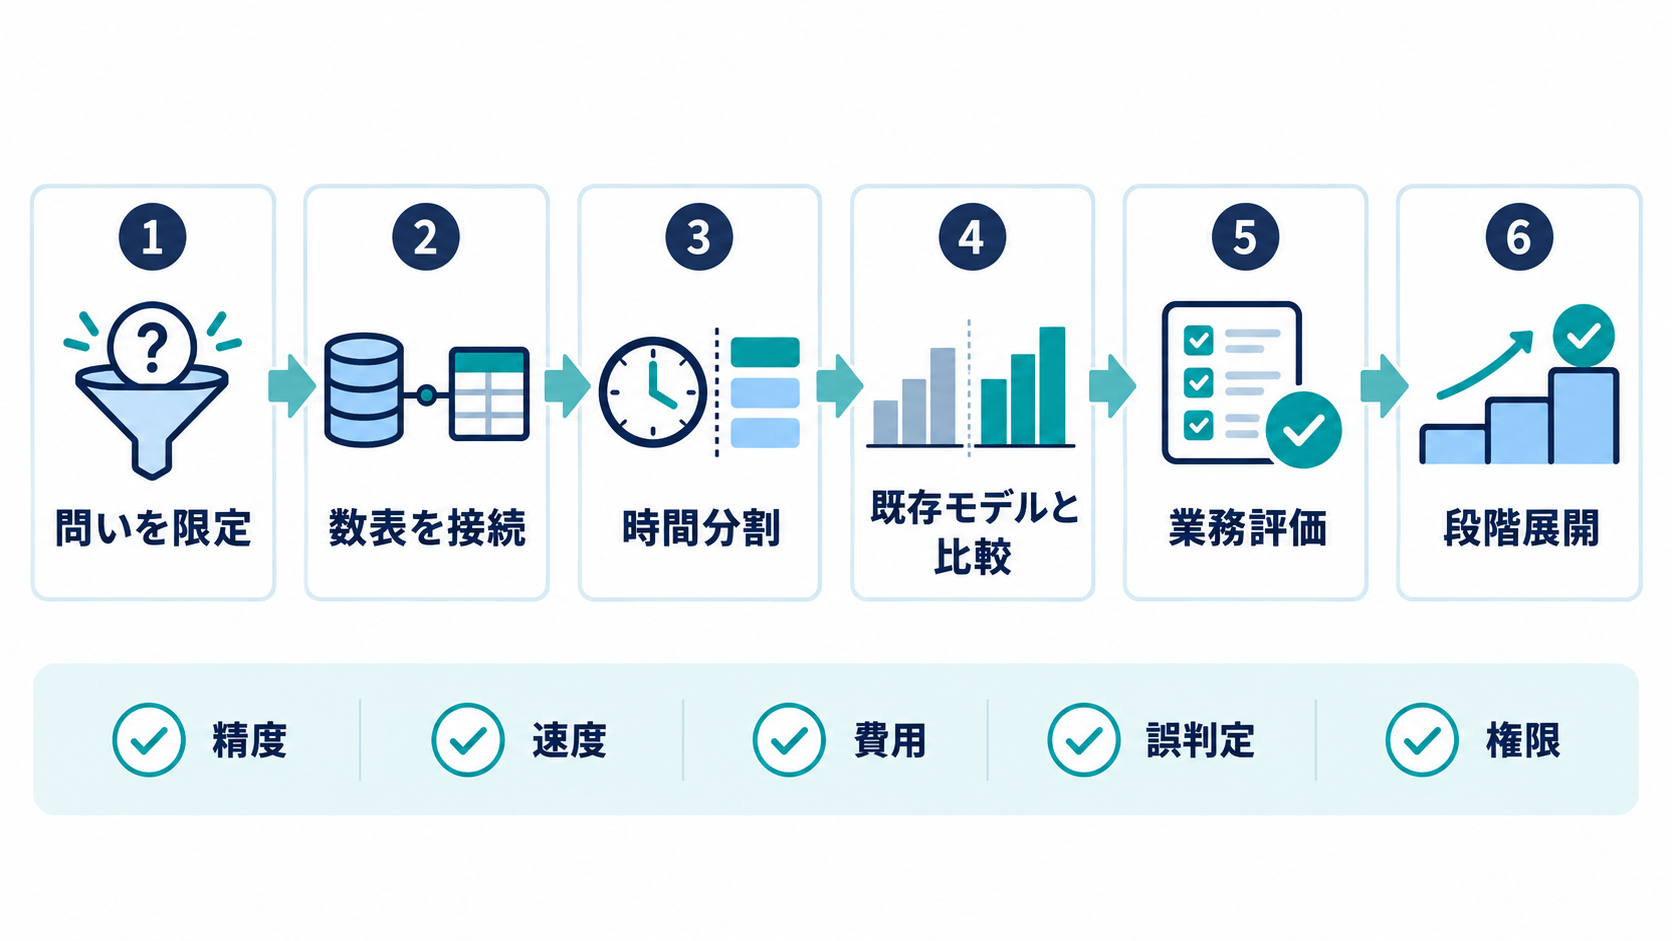
導入の出発点として適しているのは、すでに正解結果が蓄積され、既存手法との比較ができる業務です。顧客離反や需要、不正検知といった名称だけで選ぶのではなく、予測時点、対象単位、結果を利用する部門、誤判定の影響を具体化します。「月末時点の契約者について、翌30日間の解約を予測する」といった形まで問いを絞れば、未来情報の混入を防ぐための時間分割も設計しやすくなります。接続するテーブルは、対象を表すマスタと、時間付きの主要イベント、必要最小限の関連マスタから始めるのが扱いやすいでしょう。主キーと外部キーが一貫しているか、タイムスタンプが実際の発生時刻を表すか、予測時点で利用可能だった列だけを渡しているかを確認します。モデルを動かす前のこの点検が不十分であれば、高い検証値が得られても業務では再現できません。
評価では、Kumo Relationalのインコンテキスト推論、既存のXGBoostなどのモデル、単純なルールや平均値を同一条件で比較します。見るべきなのは統計指標だけではありません。予測一件当たりの処理時間、更新頻度、GPU費用、誤判定による業務コスト、モデル変更時の保守負担も含める必要があります。高精度な既存モデルがある場合でも、新しい予測テーマを追加するまでの期間を短縮できるなら、共通基盤としての価値が生まれるかもしれません。
小規模検証で優位性が確認できた後に、接続テーブルや対象部門を増やします。大量の教師データがある重要業務ではファインチューニングも比較対象に含め、エージェント連携は承認付きの提案用途から始めると管理しやすくなります。最初の一歩は全社データの一括接続ではなく、既存モデルの評価履歴が残る一業務を選び、数表と明確な基準時刻で再現可能な比較試験を組むことです。