

2026/11/16
AIニュース
MetaのJiTTests、変更前にバグを示すAIテストを本番導入——プライバシー関連の重大障害74件を未然検知と報告
この記事の要点
Metaは、レビュー中のコード変更に不具合があれば失敗するテストをLLMで生成するJiTTestsを本番導入しました。2026年上半期にプライバシー関連の重大障害74件を変更審査段階で検知したと報告しています。検出候補と確認済みバグの違いを整理し、日本企業が試行する際の評価方法を考えます。
目次
AIの指摘を、実行できるバグの証拠へ
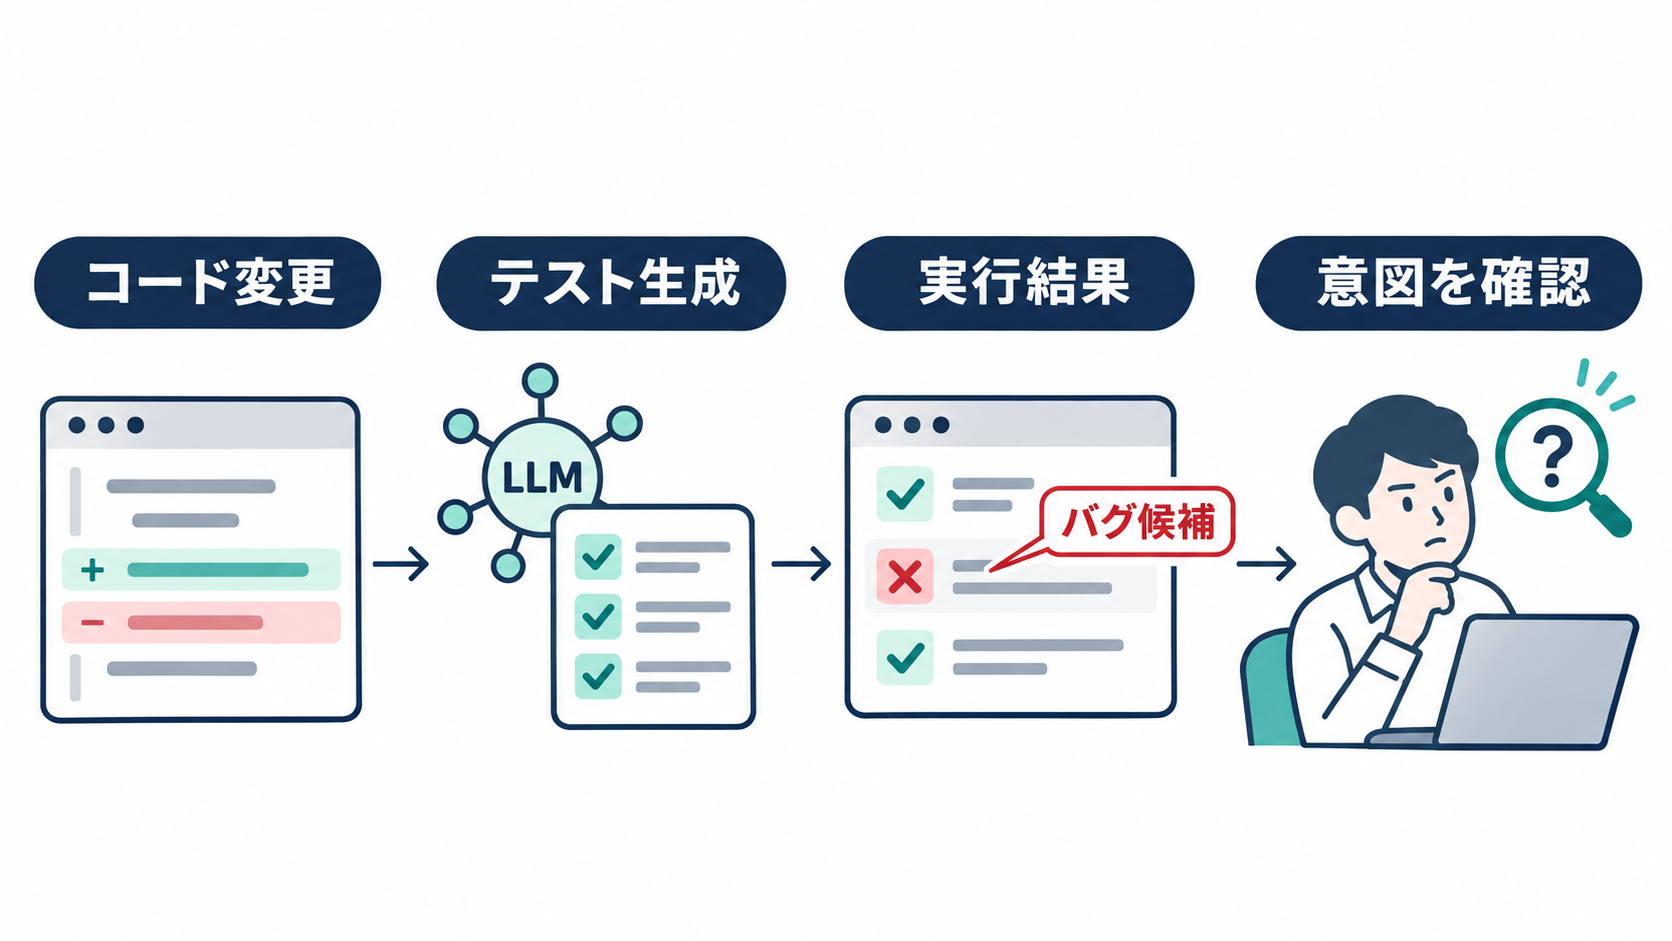
コードレビューでAIから「この変更には問題がありそうです」と指摘されても、開発者はその妥当性を確かめる必要があります。懸念が具体的な不具合につながるのか、それとも意図した仕様変更なのか。説明を読み解き、必要に応じて再現条件を探す作業が残ります。Metaが本番インフラに導入したJiTTestsは、この確認を、実行可能なテストによって支援する仕組みです。
JiTTestsは、大規模言語モデルであるLLMを使い、レビュー中のコード変更に不具合が含まれていれば失敗するテストを生成します。AIが文章で疑わしい箇所を挙げるだけでなく、コードを実際に動かして挙動の違いを示す点が特徴です。開発者は、抽象的な警告よりも具体的な材料をもとに、修正が必要かどうかを判断できます。
Metaの報告によると、JiTTestsは2026年上半期に、プライバシーに関わる重大障害として扱われるSEVを、コード変更の審査段階で74件検知しました。同じ期間に、プライバシー関連SEVの発生は全体で20%減少したとしています。ただし、この減少分のすべてがJiTTestsによる効果だと判断できる情報は示されていません。検知実績と障害発生の変化は、分けて受け止める必要があります。
企業の開発現場にとって注目したいのは、AIがレビュー担当者のようにコメントする段階から、検証に使える成果物を提出する段階へ進んでいる点です。ただし、テストの失敗だけでバグが確定するわけではありません。JiTTestsの価値は、確認すべき挙動を具体化し、人が判断するための根拠を用意するところにあります。
既存テストの補強と、変更中のバグ検出は目的が異なります
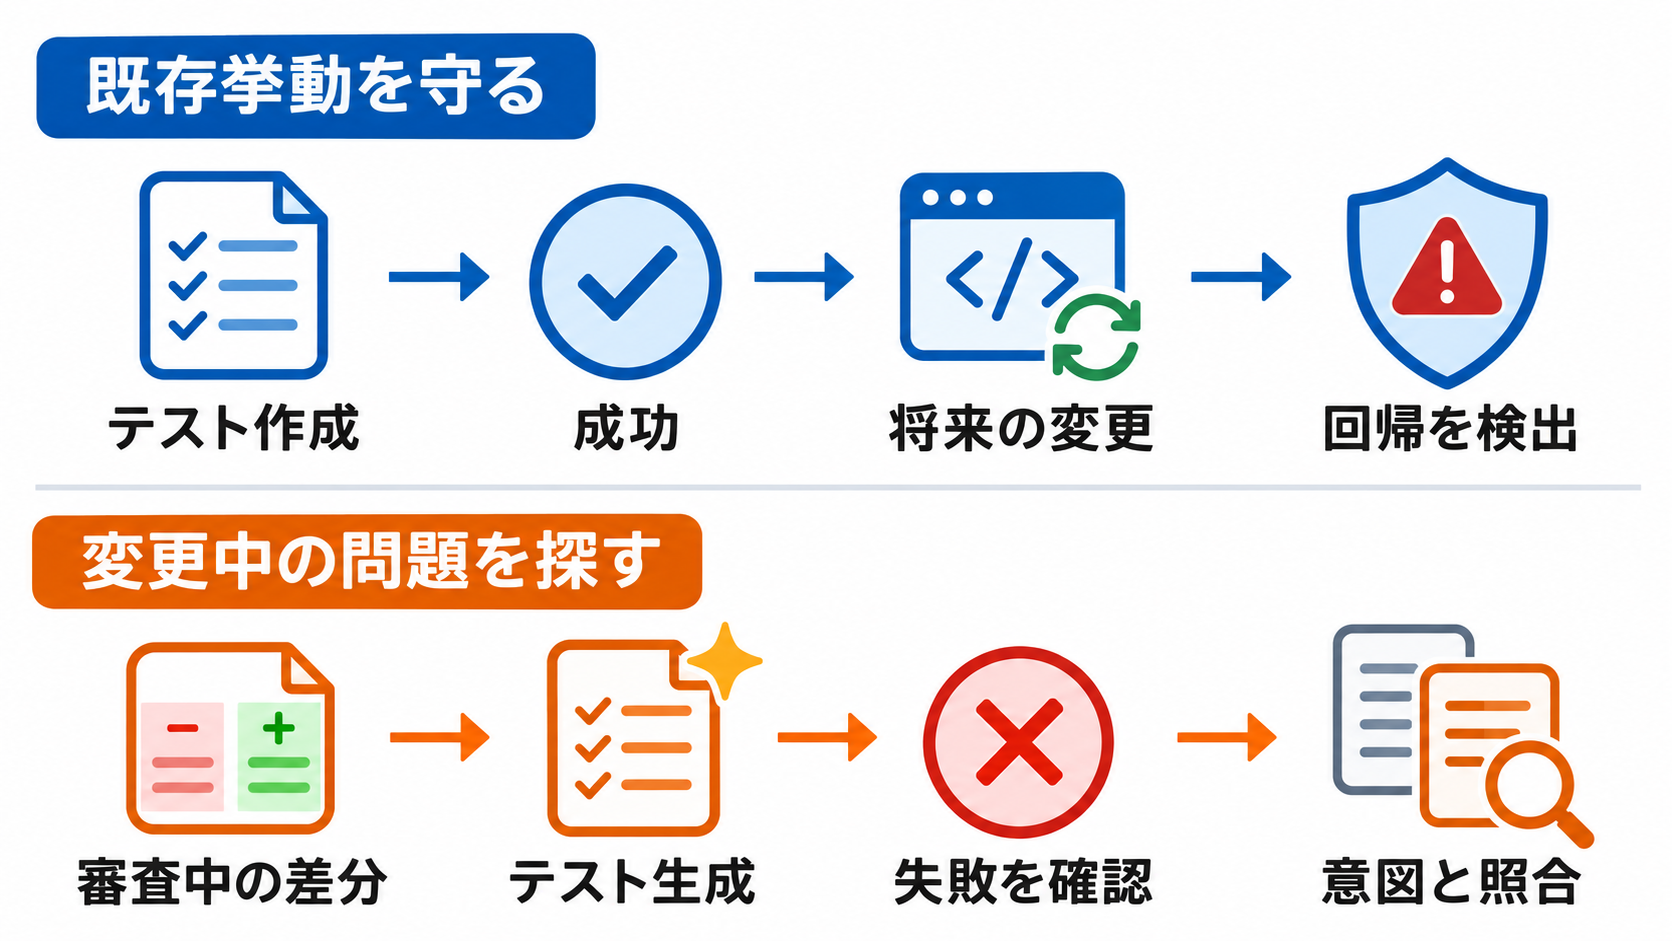
一般的な回帰テストは、正しいと確認した挙動を記録し、将来の変更でそれが壊れていないかを調べます。作成した時点ではテストが成功し、その後の変更でも成功し続けることを期待します。Metaが「hardening」と呼ぶテストの補強も、この方向に位置づけられます。テストを増やしてコードを守るという、開発現場でなじみのある考え方です。
JiTTestsの「catching」は、これとは狙いが異なります。対象は将来の変更ではなく、いまレビューしている差分です。差分とは、変更前後で書き換えられたコードのまとまりを指します。その変更によって問題が起きるなら、変更後のコードで失敗するテストを用意し、取り込む前に問題を見つけようとします。Metaは、この区別を2025年の研究「Harden and Catch」で整理しています。
ここで注意したいのは、「変更前後で結果が違うこと」と「変更後にバグがあること」は同じではない点です。機能追加や仕様修正でも、コードの挙動は変わります。変更前には成功し、変更後には失敗するテストが得られても、そのテストが古い仕様に固執しているだけかもしれません。検出した違いを、変更の目的と照らし合わせる工程が欠かせません。
この性質から、JiTTestsは既存のテスト群を置き換える仕組みとは考えにくいでしょう。既存テストは守るべき挙動を継続的に確認し、JiTTestsは個別の変更に潜む問題を探します。企業がAIによるテスト生成を評価する際も、テスト件数やカバレッジだけで成果を測ると、この違いを見落とします。目的が品質保証の土台を厚くすることなのか、特定の差分から不具合を発見することなのかを、先に明確にする必要があります。
夜間の生成から通知まで、五つの工程で候補を絞ります
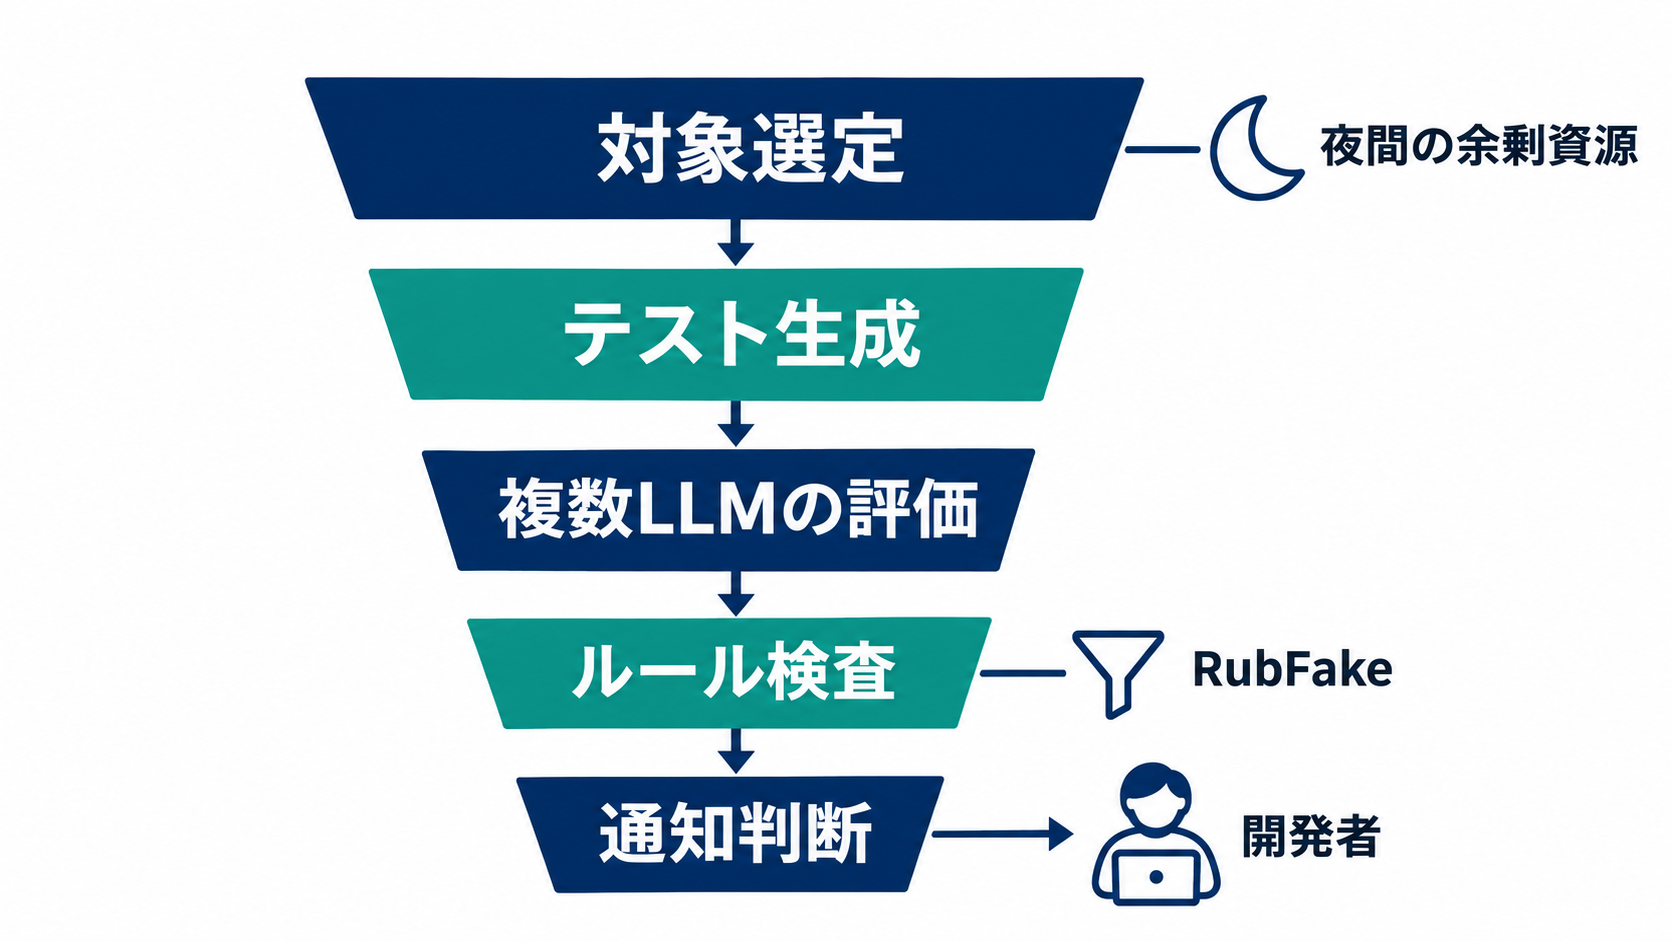
Metaの本番パイプラインは、対象の選定、テスト生成、LLMによる評価、ルールによる誤検知の除外、開発者への連絡判断という五つの工程で構成されます。対象となるのは、数億行規模のバックエンドコードです。前日の変更からリスクの高い差分を選び、夜間の余剰計算資源で処理します。対象選定には、MetaのDiff Risk Scoreに似た仕組みを使うと説明されています。
選ばれた差分には、変更内容を考慮する二つの生成方式を適用します。そこで得られた失敗テストは、そのまま開発者へ送られるわけではありません。複数のLLMが判定役となり、テストコード、失敗時の実行情報、差分、推定した変更意図を材料に評価します。研究で判定役として挙げられているモデルは、Llama 3.3-70B、Gemini 3 Pro、Claude Sonnet 4です。
LLMの評価に加え、「RubFake」と呼ぶルールベースの仕組みも使います。ここでは、プログラム内部の構造を調べるリフレクションの利用、テスト用の代替部品であるモックの不備、未実装を示す例外など、誤検知につながるパターンを確認します。柔軟な意味判断をLLMに任せつつ、明示できる問題は決まったルールで除外する構成です。
最後に、評価結果を組み合わせた順位づけに基づき、開発者へ連絡するかどうかを判断します。生成能力と同じくらい、通知を絞る仕組みが重視されている点が実務上のポイントでしょう。怪しい候補を大量に届けても、確認の負担が増えれば継続利用は難しくなります。Metaは、ルールとLLMによる評価によって人のレビュー負荷を70%削減したと報告しています。ただし、コードの実行を伴うため、コメント中心のAIレビューより多くの計算工程が必要になることも認めています。
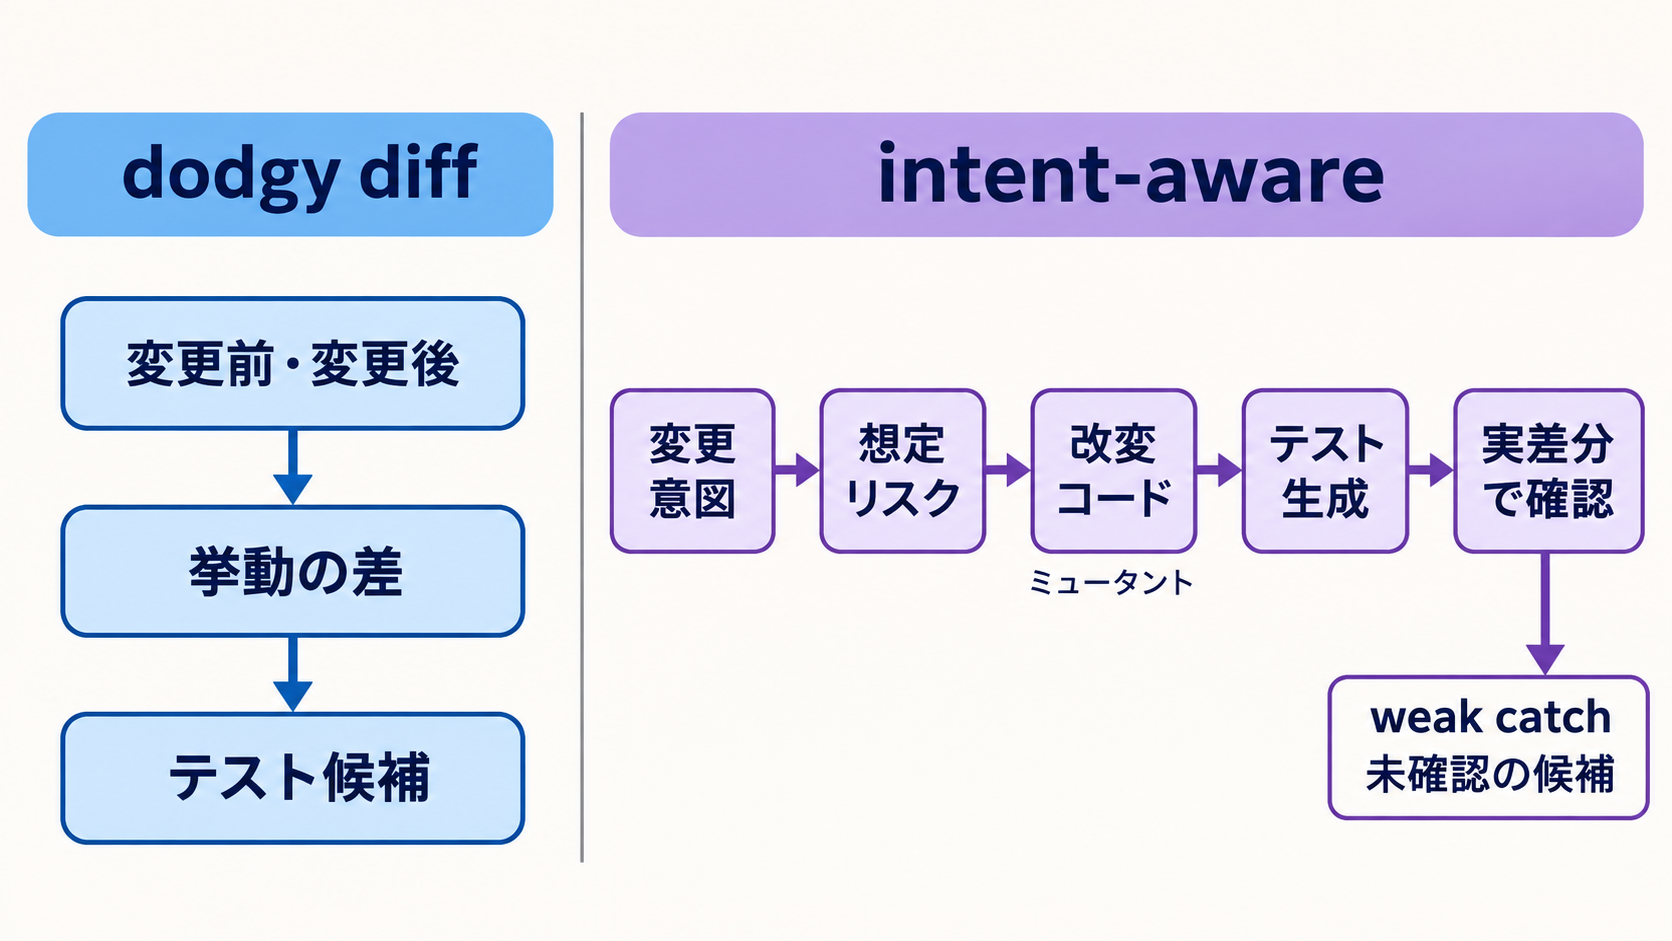
変更の違いを探す方式と、変更の意図からリスクを探す方式
JiTTestsのテスト生成には、「dodgy diff」と「intent-aware」という二つの方式があります。dodgy diffは、すべての差分にバグがあると仮定して探索します。変更後のコードを、変更前のコードに改変を加えたものとして扱い、両者を区別できるテストを生成します。狙いは挙動の違いをあぶり出すことであり、この仮定自体が個々の変更の誤りを意味するわけではありません。
intent-awareは、変更が何を実現しようとしているのかを先に推定します。手がかりはコードだけでなく、差分のタイトルや要約です。推定した目的からリスクを洗い出し、それぞれのリスクに対応する意図的な改変コードを作ります。この改変コードは「ミュータント」と呼ばれ、テストが想定した問題を検出できるか調べるために使われます。
intent-awareでは、ミュータントを検出できるテストを作ったうえで、実際の差分でもそのテストが失敗するかを確認します。実際の差分でも失敗した候補を、研究では「weak catch」と呼びます。これは、想定したリスクに関連する問題が存在する可能性を示しますが、確認済みのバグを意味しません。テスト側の誤解や、意図した挙動変更の可能性が残るためです。
この方式が企業に示すのは、変更意図の説明がAIによる検証の入力にもなるという点です。コードだけでは、何を維持し、何を変えたいのかを十分に判断できない場合があります。たとえば、変更の目的や期待する挙動がレビュー資料に明記されていれば、人もAIも確認の焦点を定めやすくなると考えられます。ただし、説明を詳しくすれば検出精度がどの程度改善するかという効果までは、今回の数値から判断できません。意図を使う設計と、その効果の検証は分けて考えるべきでしょう。
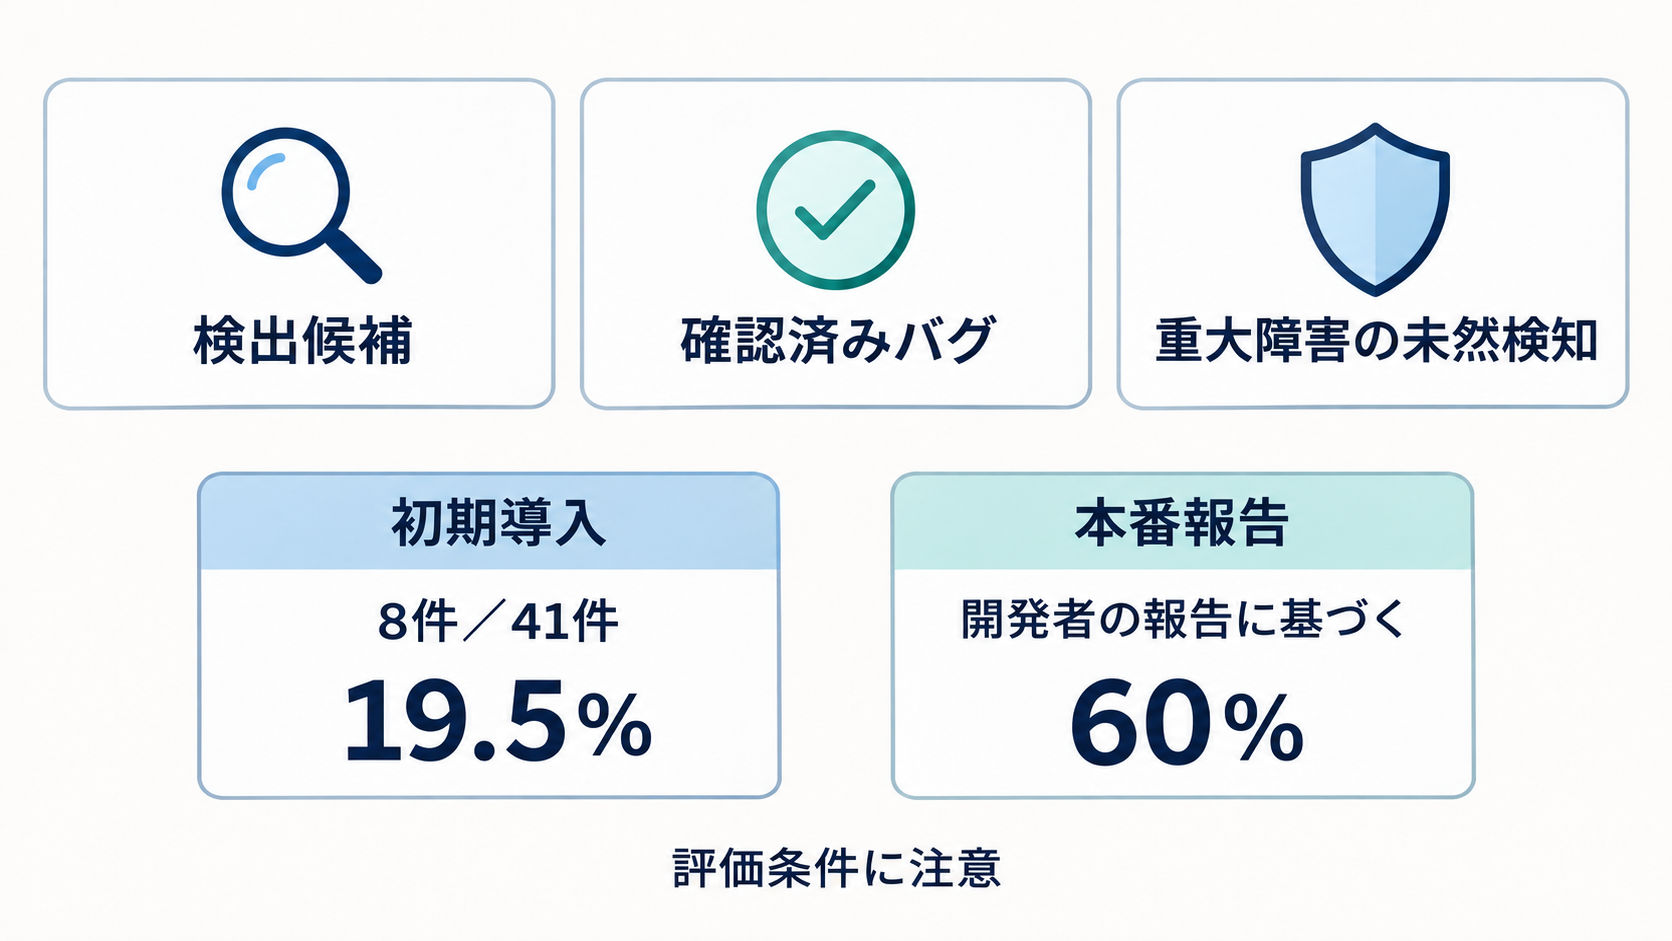
候補の検出率と、確認済みバグの割合を混同しない読み方
研究チームは、生成された2万2,126件のテストを分析しています。差分を考慮した方式は、コードを補強するhardening型のテストと比べて4倍、偶然失敗したテストと比べて20倍の検出候補を生んだと報告されています。ここで比較しているのは候補の得られやすさです。そのまま、本番障害を防いだ件数の倍率として読むことはできません。
方式別では、intent-awareのweak catchはテスト単位で6.4%、差分単位で7.9%でした。dodgy diffはそれぞれ2.5%と4.0%、Metaの従来方式であるACHのミューテーション誘導型hardeningは0.8%と1.6%です。テスト単位の割合は生成物のうち候補がどれだけ得られたかを、差分単位の割合は対象変更のうち候補が見つかったものがどれだけあったかを示します。
本番運用の評価では、別の指標にも目を向ける必要があります。初期導入時は、開発者に報告した41件の候補のうち、実際に問題として確認されたのは8件で、真陽性率は19.5%でした。その8件には、本番環境で深刻な障害を引き起こす可能性があった4件が含まれます。候補の多くが確認済みバグにならなかった一方、重大な問題を含む候補も得られていたことになります。
2026年10月のMetaの技術発信では、連絡を受けた開発者の64%に当たる589人がJiTTestsに関与し、開発者からの報告に基づく真陽性率は60%とされています。初期の19.5%より高い数字ですが、評価対象や確認方法が同一とは限らず、その差だけで改善幅を厳密には測れません。いずれもMetaの環境における自己報告です。自社で評価する場合は、候補数、確認済みバグ数、確認に要した時間を別々に記録すると、検出能力と運用負荷を見分けやすくなります。
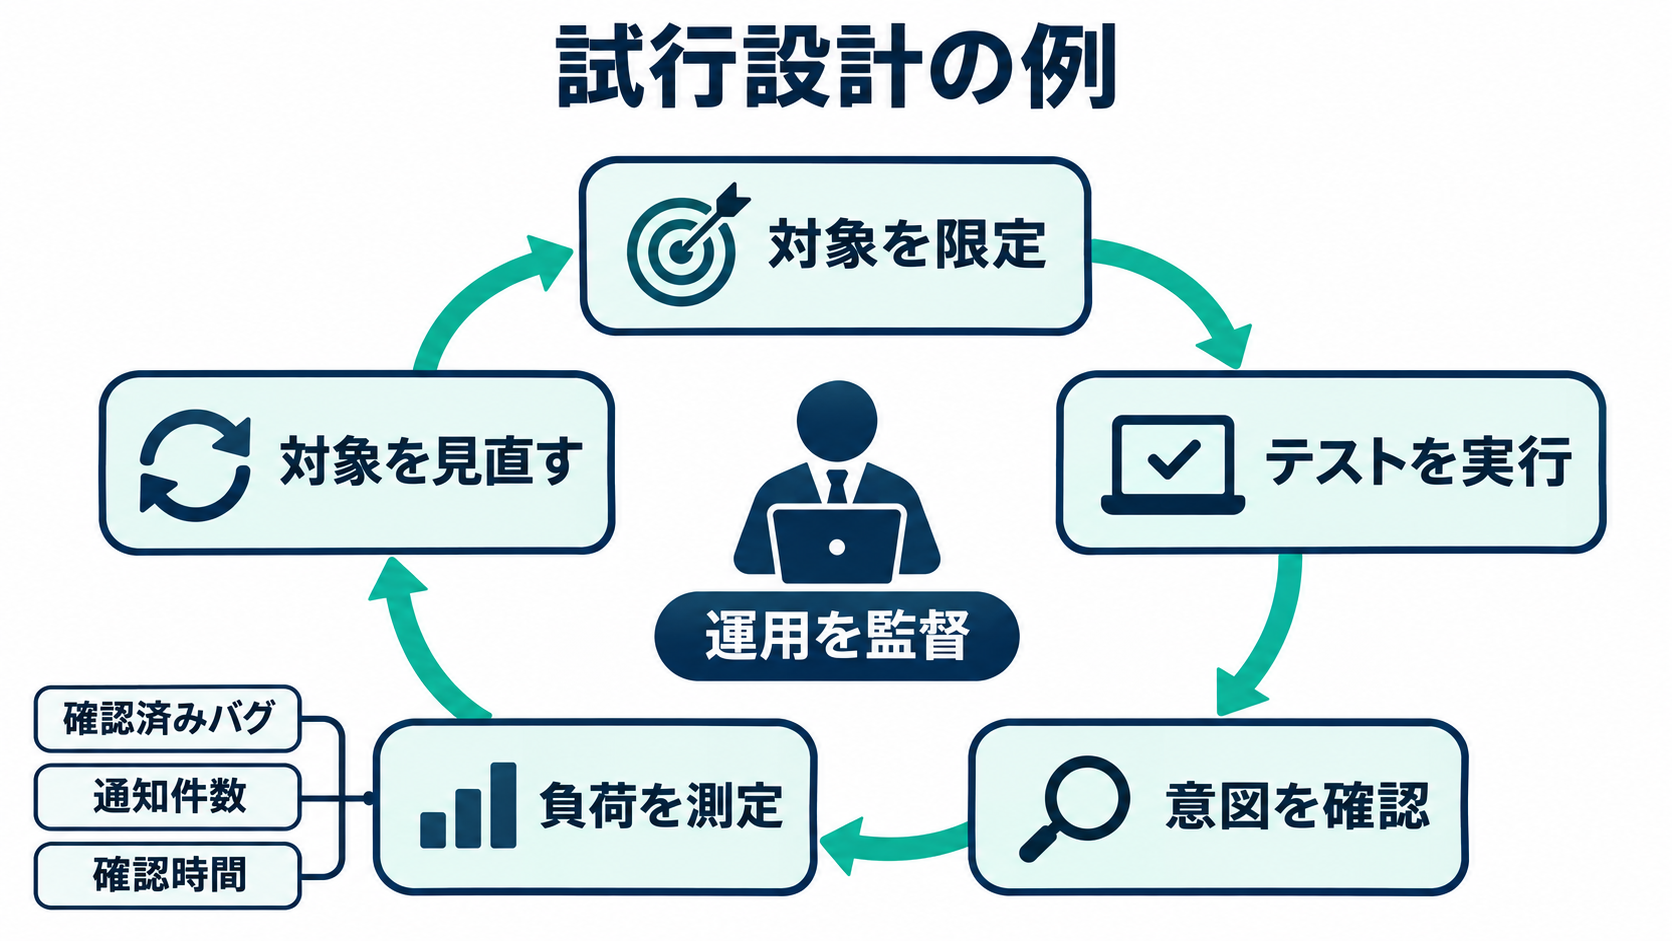
日本企業が試すなら、通知の量と判断の負担から設計します
JiTTestsはMetaの内部インフラで動作する仕組みであり、公開サービスとして利用することはできません。コード、モデル、APIも公開されていません。そのため、日本企業がすぐに同じ製品を導入するという話ではなく、差分を考慮したテスト生成、複数LLMによる評価、決定的なルール検査、人による運用監督という設計をどう応用するかが検討の対象になります。
Metaは人の関わり方を「human-on-the-loop」と説明しています。すべての出力を人が逐一確認するhuman-in-the-loopに対し、基準を設定し、全体の結果を監視しながら必要に応じて介入する考え方です。Metaによると、担当者がテストコードを読む必要は少なく、観測された挙動の変化が意図したものかを確認する役割が中心です。人の判断をなくすのではなく、判断する対象を絞っています。
自社で小規模に試すなら、対象コードと検出したい不具合を限定する方法が考えられます。たとえば、権限に関わる変更を対象にする場合も、AIが作ったテストを実行できる環境と、期待する挙動を確認できる担当者が必要でしょう。これは導入の考え方を示す例であり、Metaが同じ条件で効果を測定したという意味ではありません。モデルの選定だけでなく、実行環境やレビュー体制まで含めて設計する必要があります。
最初の判断材料には、生成したテストの総数よりも、一件の確認済みバグを得るために何件の通知を確認したか、どれだけの時間を使ったかが役立ちます。候補が多くても、確認に時間がかかりすぎれば開発を圧迫します。JiTTestsの報告から着手点を一つ選ぶなら、レビュー中の差分を限って、AIの指摘を実行可能な再現テストに変える試行です。その結果を、見つかった問題と確認負荷の両面で評価し、対象を広げるか判断するのが現実的でしょう。