

2026/11/11
AIニュース
Google DeepMindのAlphaGenome 2、DNA変異の影響を細胞種ごとに予測するAIへ
この記事の要点
Google DeepMindのAlphaGenome 2は、約100万塩基対のDNAと細胞状態を入力し、変異の影響を細胞種ごとに予測します。開発元の評価では、適合率90%で原因変異の再現率が16%から30%へ改善しました。新しい単一細胞データを追加学習なしで扱える点が特徴ですが、利用は現時点でAPIが中心で、非商用研究向けです。企業では利用条件を確認し、既知の実験結果と照合しながら候補選定への有効性を検証することが求められます。
目次
同じDNA変異でも、どの細胞で働くかを問い直す
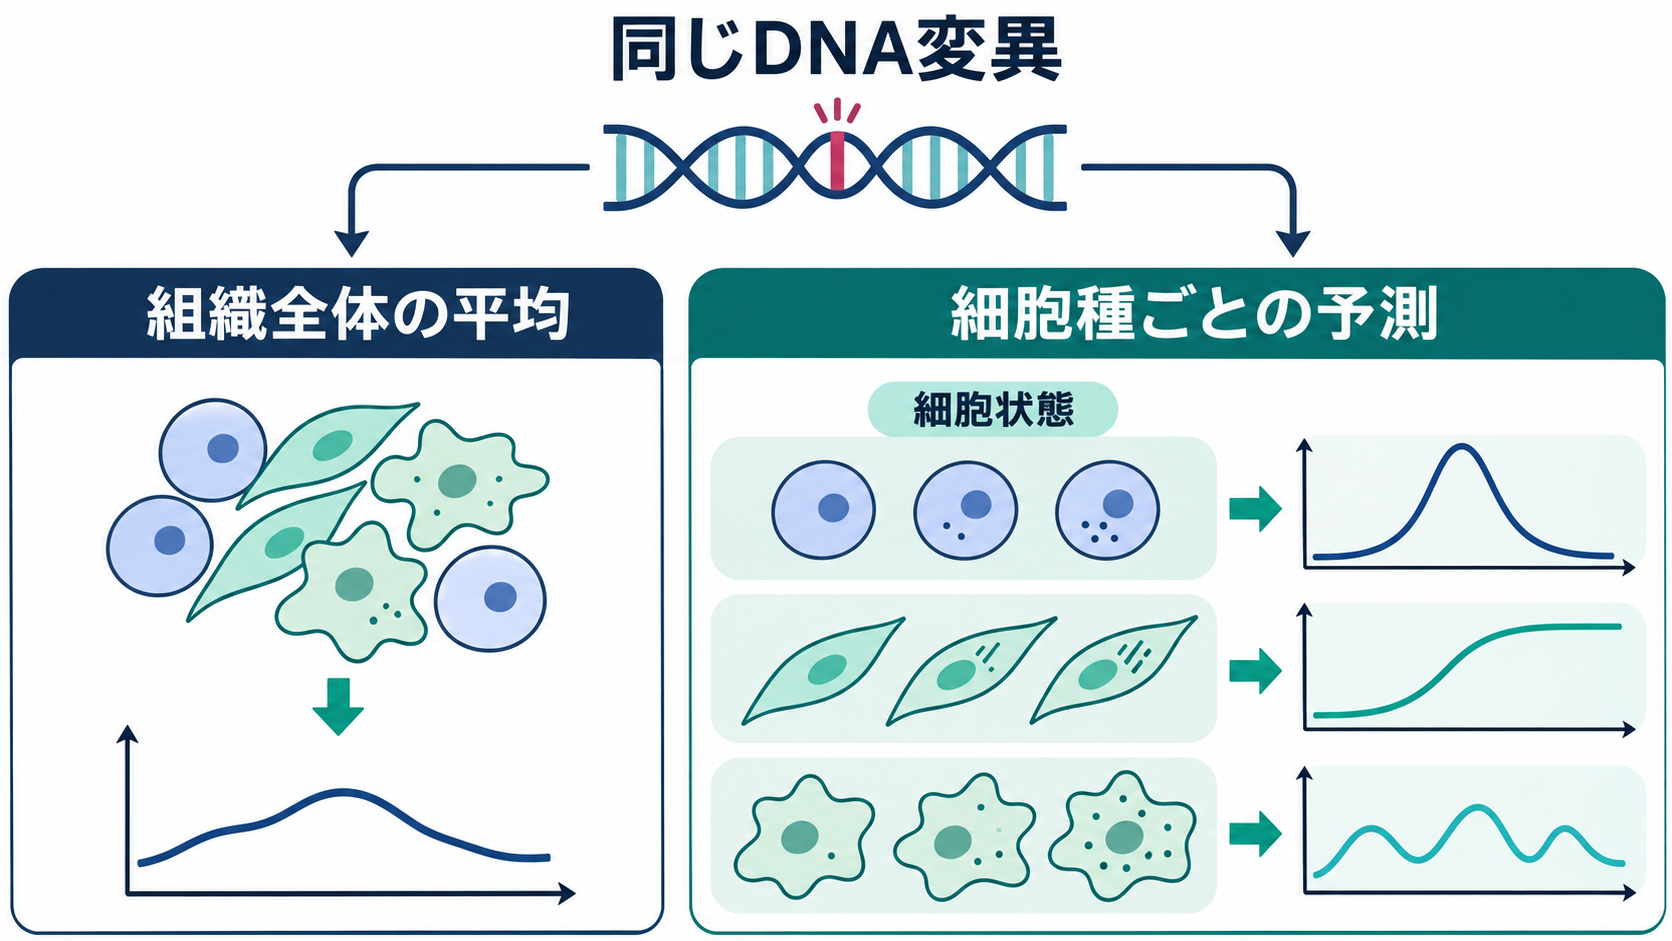
あるDNA変異が遺伝子の働きを変えるとして、その影響はどの細胞で現れるのでしょうか。創薬や疾患研究では、変異の位置を特定するだけでなく、影響が生じる細胞の種類や状態まで絞り込む必要があります。Google DeepMindが公開した「AlphaGenome 2」は、この問いに対応するDNA解析モデルです。DNA配列に加えて対象の細胞状態を入力し、その条件下で変異が遺伝子の働きに及ぼす影響を予測します。
入力する配列の長さは、人またはマウスのDNA約100万塩基対、正確には1,048,576塩基対です。前世代が主に組織全体をまとめたデータを扱っていたのに対し、AlphaGenome 2は近縁の細胞種の違いを捉えることを目指しています。組織には複数の細胞種が混在するため、全体の平均からは特定の細胞だけで起きる変化が見えにくくなる場合があります。細胞種を条件として指定する仕組みは、その見落としを減らすための設計です。
企業の研究開発担当者が注目すべき点は、予測精度の上昇だけではありません。未知の単一細胞データセットについても、モデルを追加学習することなく条件を与えられる点が特徴です。研究対象が変わるたびに専用モデルを調整する負担を抑えられる可能性があります。ただし、あらゆる細胞状態で同じ性能を保証するものではなく、対象データでの検証は欠かせません。
生成AIの技術動向として読む際には、用途の違いにも注意が必要です。AlphaGenome 2の中心的な役割は、DNA配列から生物学的な機能や変異の影響を推定することです。文章や画像を生成するサービスとは評価軸が異なり、研究上の仮説や実験候補をどれだけ適切に絞り込めるかが実用性を左右します。
細胞状態をモデル内部へ伝える条件付けの仕組み
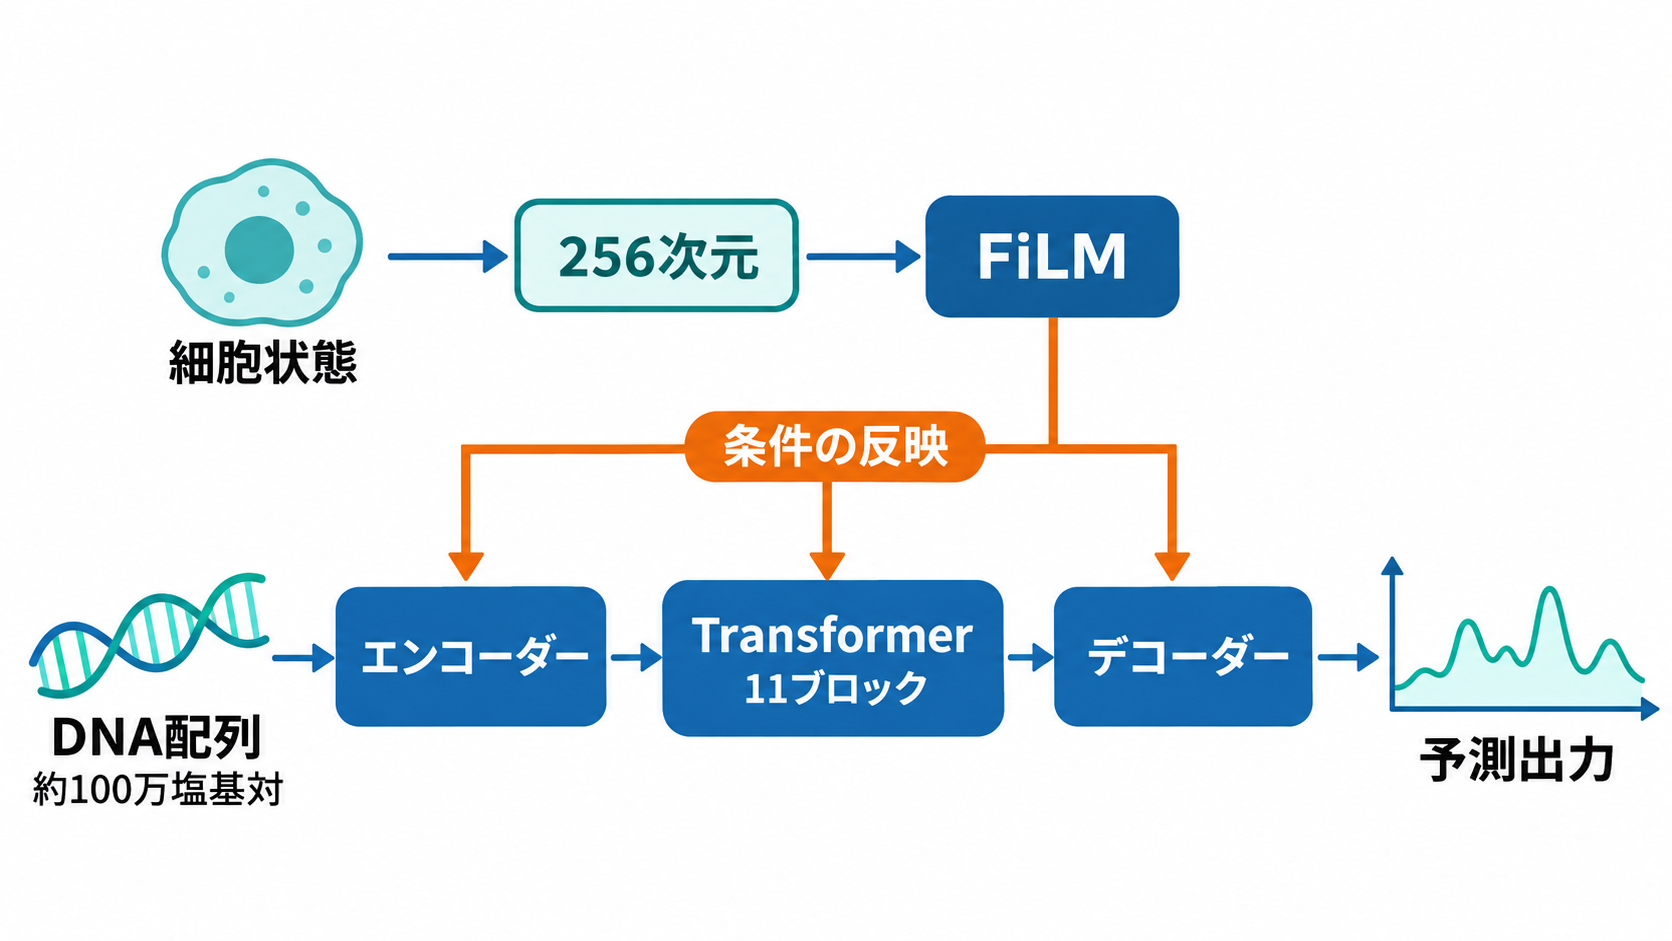
AlphaGenome 2は、DNA配列を読み取る処理に、対象の細胞状態を表す情報を組み合わせます。基盤となるのは、畳み込み処理を使うエンコーダー、11ブロックのTransformer、デコーダーを備えたU-Net型の構造です。大まかには、配列の特徴を抽出し、広い範囲の関係を処理したうえで、各種の生物学的な出力へ変換する構成と捉えられます。
細胞状態は256次元の数値表現に変換され、FiLMと呼ばれる層を通じてモデル内部の処理を調整します。重要なのは、最終的な出力部分だけを切り替える設計ではないことです。DeepMindの評価では、デコーダーや出力層だけに条件を与えた場合の改善は限定的で、エンコーダーとTransformerにも条件を反映させることで、改善の多くが得られたと説明されています。
この違いは、細胞種を単なる出力ラベルとして扱うのではなく、配列をどう読み解くかに関わる情報として使っていることを示します。同じ配列でも細胞状態に応じて予測を変えるには、途中の特徴抽出や情報の統合にも条件を行き渡らせる必要がある、という設計上の示唆が読み取れます。
出力対象には、RNAのカバレッジ、転写開始の状況を調べるCAGE、RNAのつなぎ合わせに関わるスプライシング、クロマチンのアクセスしやすさ、ヒストン修飾、転写因子の結合、DNA領域間の接触マップなどが含まれます。CpGメチル化も新たに加わりました。これらは遺伝子の働きを異なる側面から捉える指標です。前世代が固定された多数の出力トラックを並列に予測していたのに対し、AlphaGenome 2は1回の呼び出しで一つの条件を扱うため、利用時にはどの細胞条件を調べるかを明確にすることが求められます。
未知の細胞状態を、追加学習なしで指定する方法
AlphaGenome 2の学習は四つの段階で構成されています。事前学習では、組織全体を測定したデータに加え、36件の研究に由来する3,977本の単一細胞RNA・ATACの擬似バルクトラックを利用します。擬似バルクとは、単一細胞データを細胞群ごとにまとめて扱う方法です。ATACは、DNAが周囲のタンパク質からどの程度アクセスしやすい状態にあるかを調べる測定を指します。
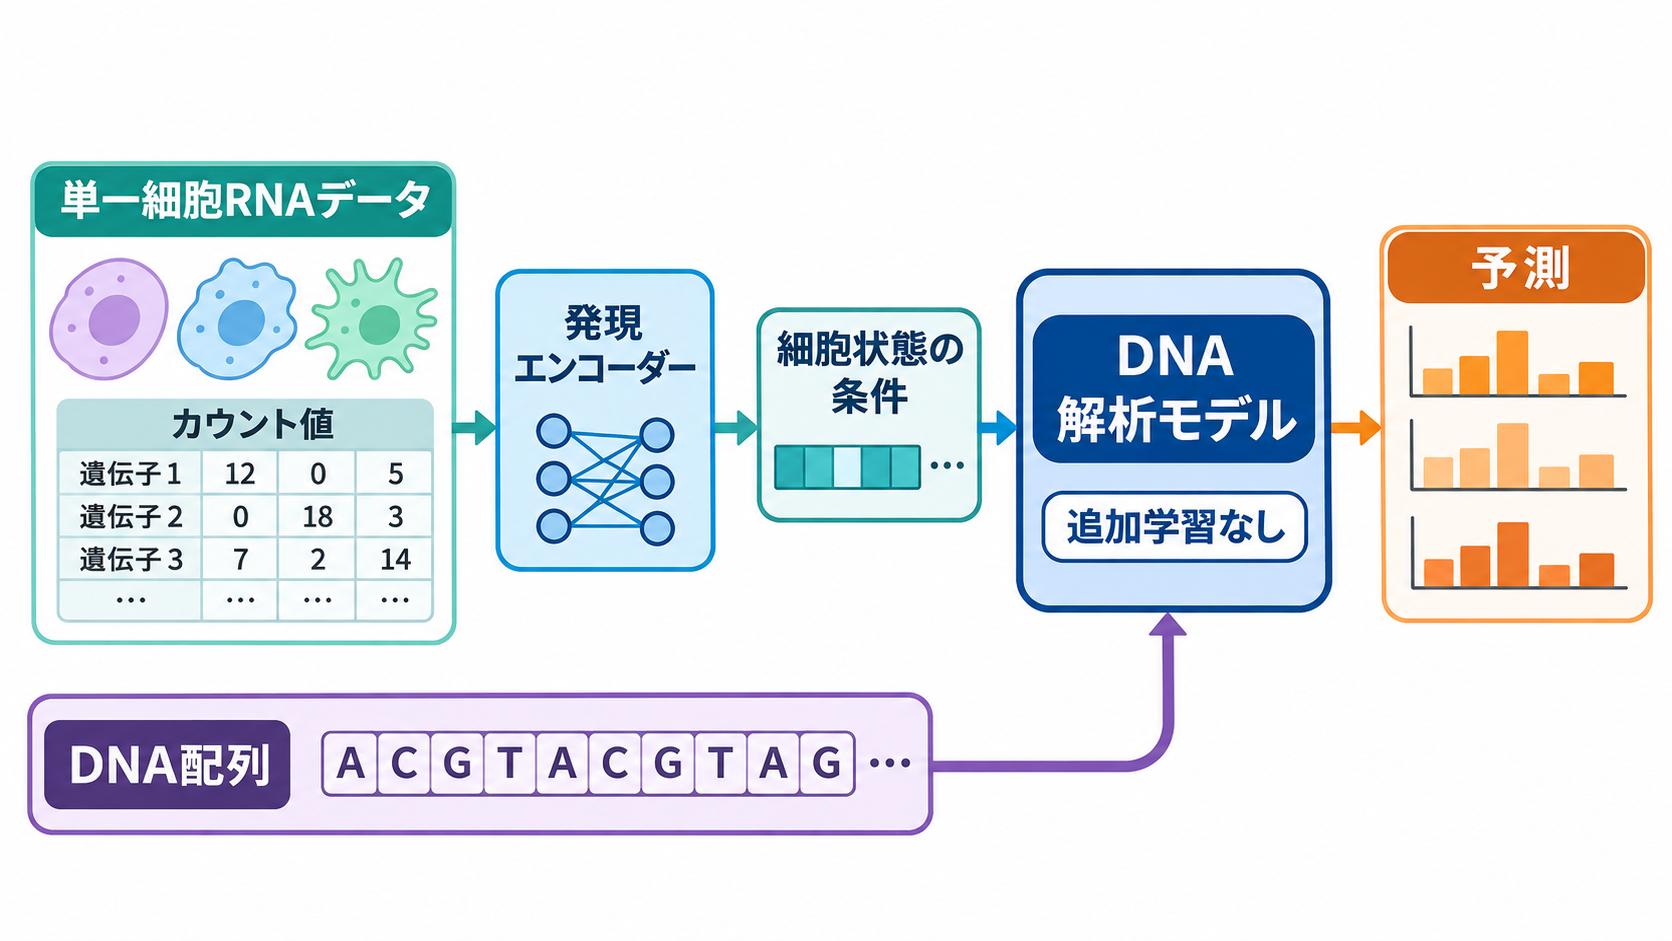
その後、細胞条件を表す埋め込みとFiLM層だけを調整する条件の精緻化を行い、八つの教師モデルの予測を一つの生徒モデルへ移す蒸留へ進みます。蒸留には変異を加えた入力配列を使います。最後の段階では、単一細胞の遺伝子発現データを処理するエンコーダーを、固定済みモデルの条件表現へ対応付けます。こうして、細胞の測定データから予測条件を作る経路を整えています。
この発現エンコーダーは、主に単一細胞データの公開基盤であるCELLxGENEに由来する、1億件超のヒト単一細胞RNA-seqプロファイルで学習されています。RNA-seqは、細胞内のRNAを測定して遺伝子の発現状態を調べる手法です。研究者は生のカウントデータを渡すことで条件表現を取得でき、案内されている上限は1回の呼び出しにつき256細胞です。
実務上は、新しい研究データを使うたびにモデル全体を追加学習する工程を省ける可能性があります。ただし、「追加学習なし」と「入力準備なし」は同じではありません。どの細胞を対象にするか、データの品質をどう確かめるか、比較する細胞群をどう定義するかといった研究上の判断は残ります。APIへ渡せることだけで利用可否を決めず、手元の測定データが調べたい細胞状態を適切に表しているかを確認する必要があります。
評価結果は、候補の回収率と予測方向を分けて読む
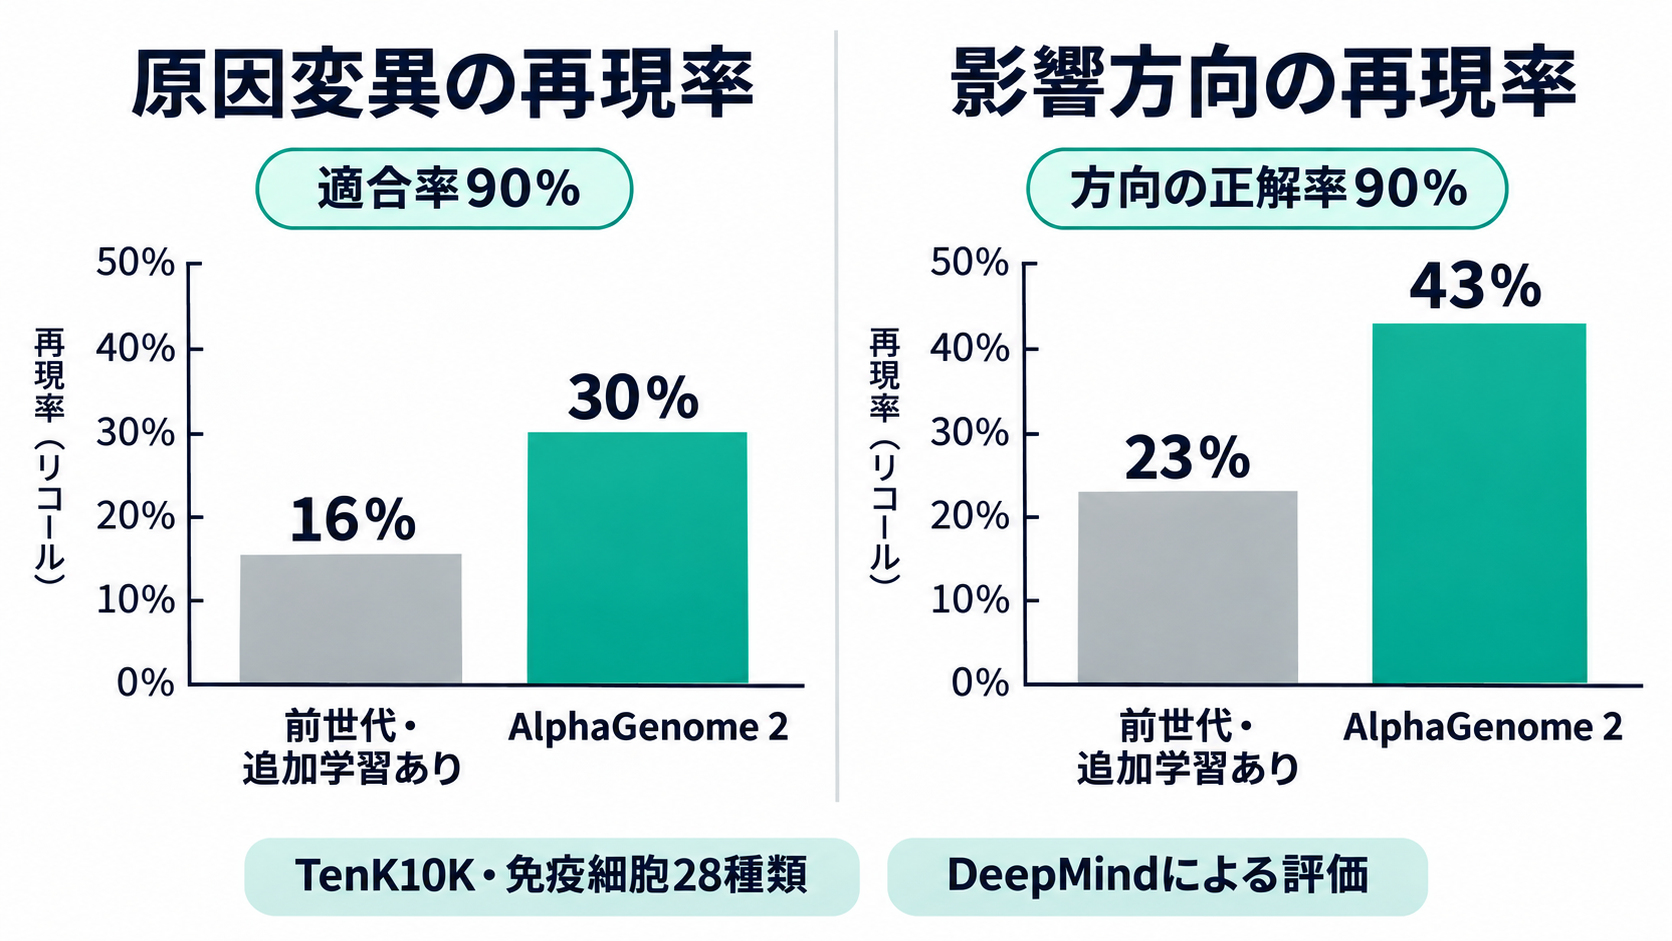
性能評価で中心となるのは、28種類の免疫細胞を対象としたTenK10Kの単一細胞eQTLデータです。eQTLは、DNA配列の違いと遺伝子発現量の違いの関係を捉える指標です。DeepMindの評価では、適合率90%の条件で、原因となる変異の再現率が前世代の追加学習モデルの16%から30%へ上昇しました。候補を高い確度で絞り込む設定を保ちながら、拾い上げられる対象が増えたという結果です。
別の評価では、発現量を増やすか減らすかという影響方向について、正解率90%の条件で再現率が23%から43%へ改善しています。この43%は、あらゆる変異に対する総合的な正解率を意味しません。「どの変異が原因か」と「影響がどちら向きか」は異なる問いであり、数値を研究計画へ使う際には指標と条件をセットで読む必要があります。
遺伝子の働きを調節するDNA領域であるエンハンサーと、標的遺伝子との関係を調べる評価でも改善が報告されています。学習に使わないENCODE-rE2GのCRISPRiデータでは、適合率と再現率の関係をまとめるAUPRCが0.78となり、AlphaGenome 1の0.73、Borzoiの4モデルによるアンサンブルの0.61を上回りました。ただし、これらはDeepMindによる評価結果であり、企業ごとの研究対象で同じ差が得られるとは限りません。
限界を示す数値もあります。アクセスしやすいクロマチンの領域外では、影響方向を予測するAUROCが0.63にとどまっています。未見のパーキンソン病コホートでは再現率41%が報告されていますが、これを診断性能と読み替えることも適切ではありません。導入判断では、全体の平均値以上に、自社が調べたい領域や細胞条件で予測がどこまで機能するかを見極めるべきでしょう。
APIで試せる範囲と、商用研究に残る条件
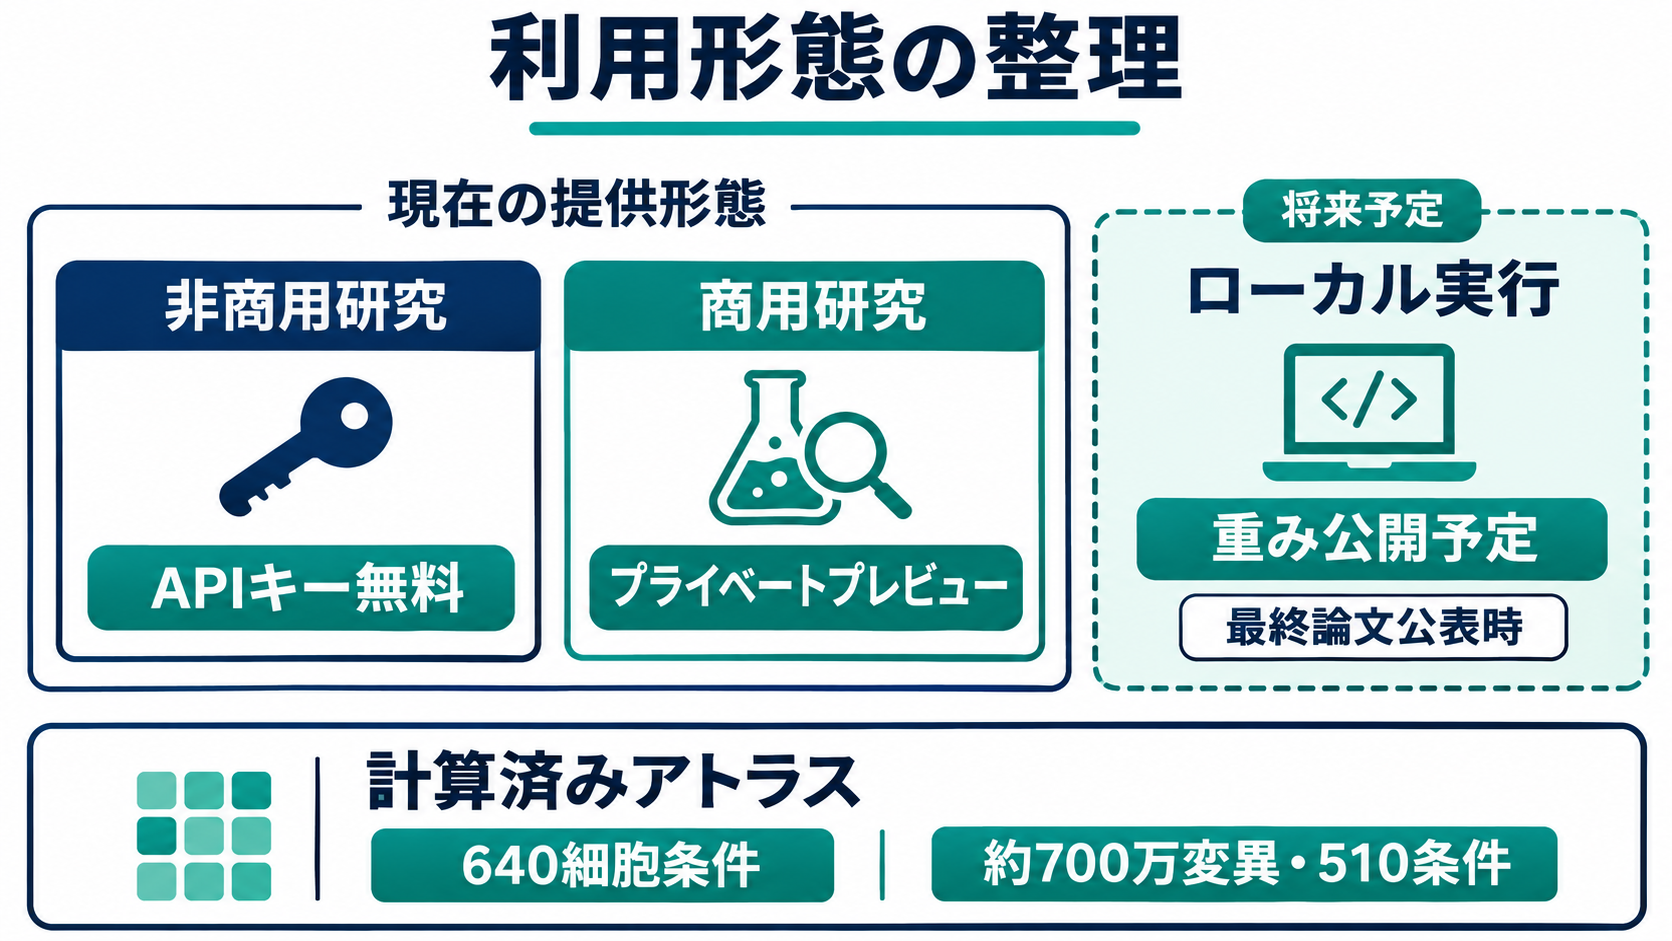
AlphaGenome 2は、現時点ではホスト型APIを通じて利用する形です。非商用研究向けには無料のAPIキーが提供され、Colabのチュートリアルも用意されています。Pythonパッケージでは、alphagenome.models.v2からモデルを利用できます。商用研究はプライベートプレビューの段階とされているため、企業が事業目的で自由に使える一般公開サービスとして扱うことはできません。
モデルの重みは最終的な論文公表時に提供する予定とされており、現在の利用形態はローカル実行を前提としていません。学習には2,048基のTPU v4が使われていますが、この数値は学習時の計算規模です。API利用者が同じ計算資源を準備するという意味ではなく、手元の研究環境での推論コストを直接示すものでもありません。公開されている計算規模と、自社で必要になる費用や運用条件は分けて考える必要があります。
API以外の入口として、計算済みのアトラスも公開されています。一つは640種類の初代細胞条件にわたるエンハンサーと遺伝子の関連情報です。もう一つは、約700万の一般的な変異およびゲノムワイド関連解析、いわゆるGWASで扱われる変異について、510条件でスコアを付けたデータです。対象の変異や細胞条件が含まれていれば、独自のAPI処理を組む前に既存の予測情報を確認できるでしょう。
国内企業が評価を進める場合は、研究目的が利用条件に合うか、外部APIへ送るデータを社内規定上扱えるか、必要な細胞条件がそろうかを確かめることが出発点になります。無料という説明だけでは、商用利用の可否やデータの扱いまで判断できません。研究部門だけで完結させず、契約と情報管理の担当者が同じ利用想定を共有することが、検証を途中で止めないための準備になります。
日本企業の検証は、実験候補を絞る一問から
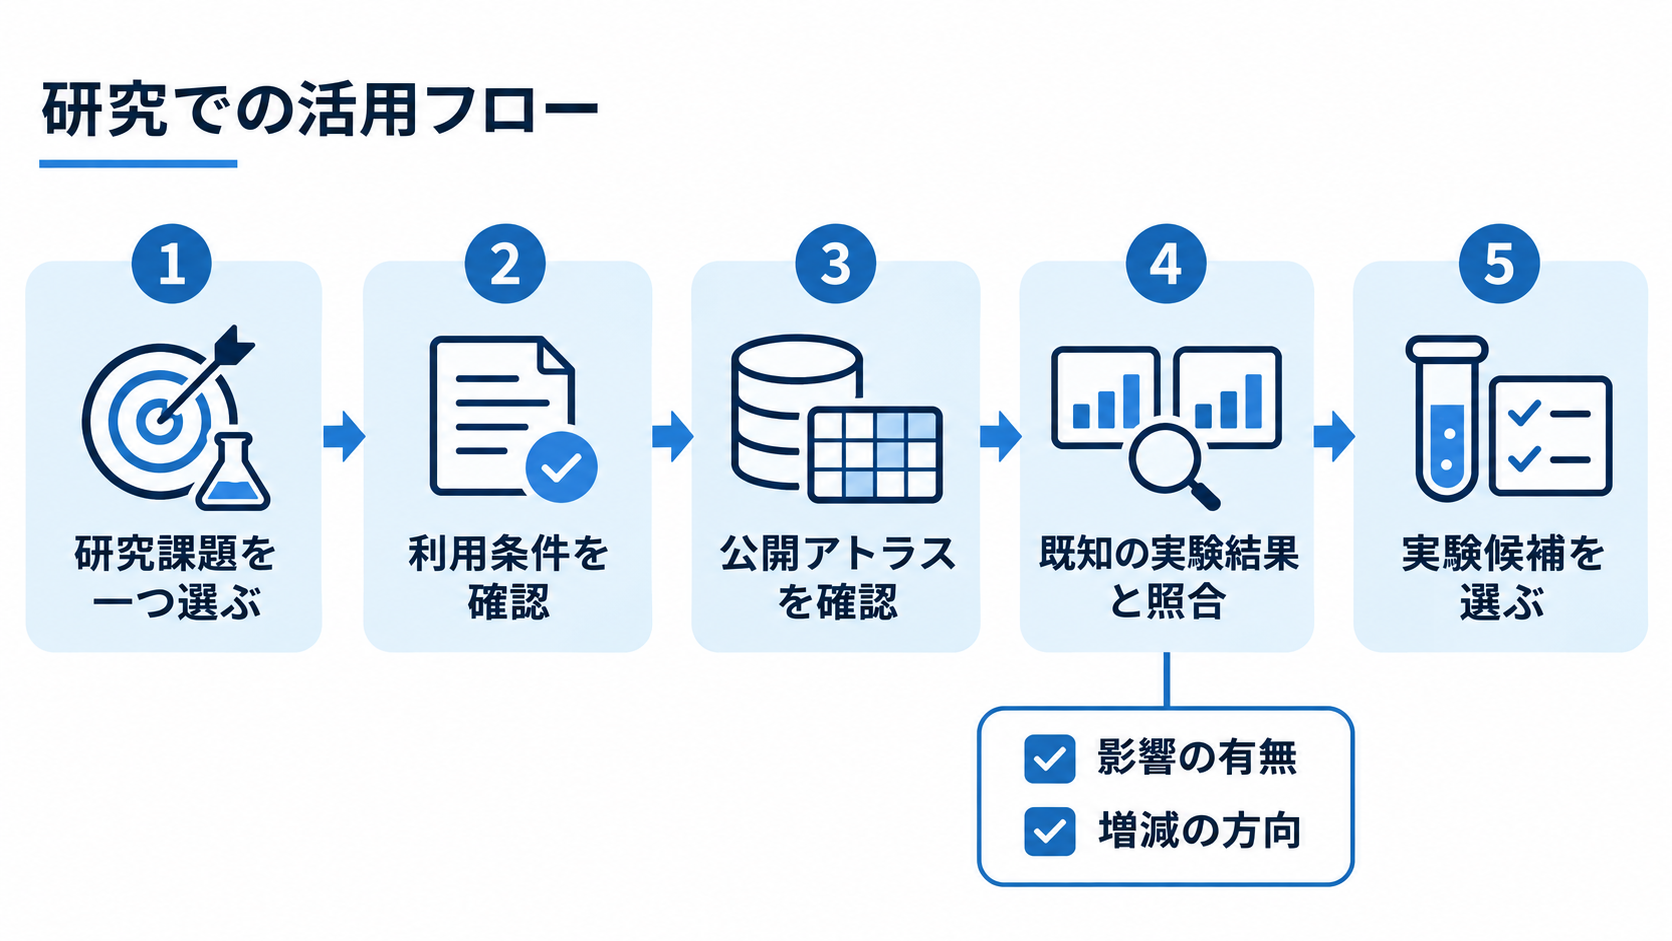
AlphaGenome 2を企業の研究開発へ取り入れるなら、最初に「どの実験判断を助けたいか」を一つに絞ると評価しやすくなります。例えば、ある変異が複数の免疫細胞のうちどこで作用しそうかを調べたいのか、候補エンハンサーと遺伝子の関係を優先順位付けしたいのかで、必要な出力も比較対象も変わります。多種類の予測が可能であることと、そのすべてが個々の研究に役立つことは別の問題です。
このモデルの利用価値は、実験前に候補の順番を付ける用途で検討しやすいでしょう。対象となる変異と細胞条件を定め、予測の高い候補だけでなく低い候補も含めて、既存の実験結果と照合します。その際、影響の有無と増減の方向を分ければ、どちらの判断を補助できているかが見えやすくなります。評価を一つの総合点にまとめすぎないことが、研究現場で使える範囲を明確にします。
解釈の面では、予測スコアをそのまま疾患の原因や治療標的の確定と受け取らない姿勢が必要です。DNA配列から得られる予測は、生物学的な関係を検討する材料になりますが、実験で機能を確認したこととは同義ではありません。とくに公開評価で性能が弱かった領域を扱う場合には、予測の順位が安定しているか、独立した測定結果と整合するかを丁寧に確認する必要があるでしょう。
追加学習なしで新しい細胞状態を指定できる仕組みは、研究テーマの切り替えに伴うモデル開発の負担を減らす可能性があります。その効果を確かめるには、精度だけでなく入力準備や結果の確認に要する作業も含めて評価することが有効です。次の一歩としては、自社が既に実験結果を持つ一つの研究課題を選び、利用条件を確認したうえで、対象の変異と細胞条件が公開アトラスに含まれるかを調べるとよいでしょう。