

2026/11/19
AI活用
CodexでCSV出力のメモリ不足を直す――分割取得から回帰テストまでの進め方
対象読者:上級者向け
この記事の要点
Codexを使い、大量のCSV出力で発生するメモリ不足の調査・修正・回帰テストを進める実践案です。分割取得と逐次出力を検討し、出力互換性や同時更新時の整合性を人が確認します。準備やレビューを含む効果の確かめ方も示します。
目次
月末のCSV出力が止まる場面から、修正の条件を決めます
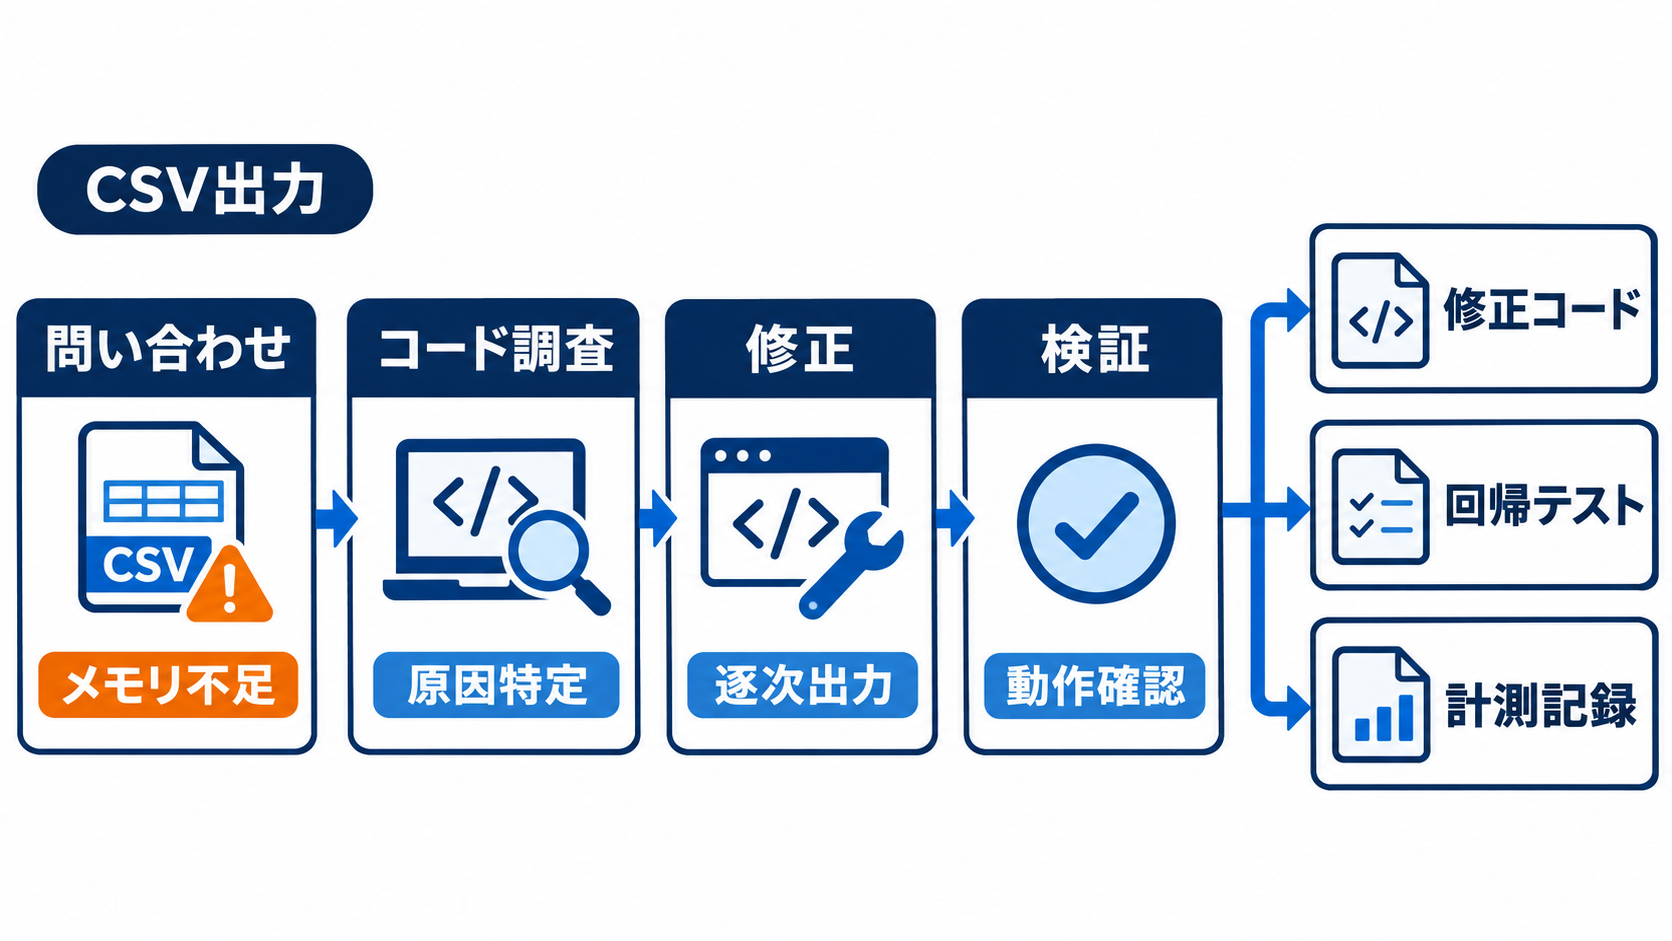
月末に営業管理システムから受注明細をCSVで出そうとすると、対象期間が長い場合だけ処理が止まります。保守担当の開発者は、問い合わせに記載された検索条件を確認し、ログと既存コードを照合して、メモリ不足が起きる経路を調べます。ここでは、この架空の業務アプリを例に、Codexを使って調査・修正案・テスト作成を進める方法を提案します。目的は、大量の明細を出力できるようにしながら、利用者が受け取るCSVの仕様を守ることです。
AIを使わない場合も、担当者はエディターの検索、デバッガー、既存のテスト、メモリ計測の道具を使えます。出力処理の入口を探し、検索条件がDB取得処理へ渡る経路を追い、取得結果がCSVへ変換されるまでを確認する流れです。修正後は同じデータで出力し、件数や列の内容を照合します。手間が集中するのは、複数のファイルを行き来して処理のつながりを把握する工程と、仕様を保つための検証条件をそろえる工程でしょう。
この記事ではCodexを、リポジトリ内の情報を調べ、変更の計画と検証を補助する道具として使います。OpenAIの公式資料では、任意のAGENTS.mdにコーディング規約、テスト基準、作業範囲などをまとめる方法が紹介されています。計画や段階別の記録を残す構成も示されていますが、そのファイル構成すべてがCodexの必須要件ではありません。(出典: OpenAI Developers)
実践には、既存コードを読めることに加え、SQL、DBのトランザクション、アプリのテスト環境を扱う知識が必要です。成果物は修正コードだけでなく、回帰テストと比較計測の記録までとします。なお、参照資料の取得日は2026年11月19日です。この日付を機能の公開日とは扱わず、以下の業務例も実測済みの導入事例ではなく実践案として説明します。
手間を分解すると、Codexに渡す調査範囲が見えます
調査を始める前に、「大量データだからメモリ不足になります」という説明を一段掘り下げます。今回の架空例では、DBの取得結果をすべて配列に保持し、その後でCSV全体を文字列に組み立てている可能性を調査対象にします。ただし、これは原因の仮説です。コードを読む前から分割取得への変更を決めると、実際には別の場所で起きている問題を見落としかねません。
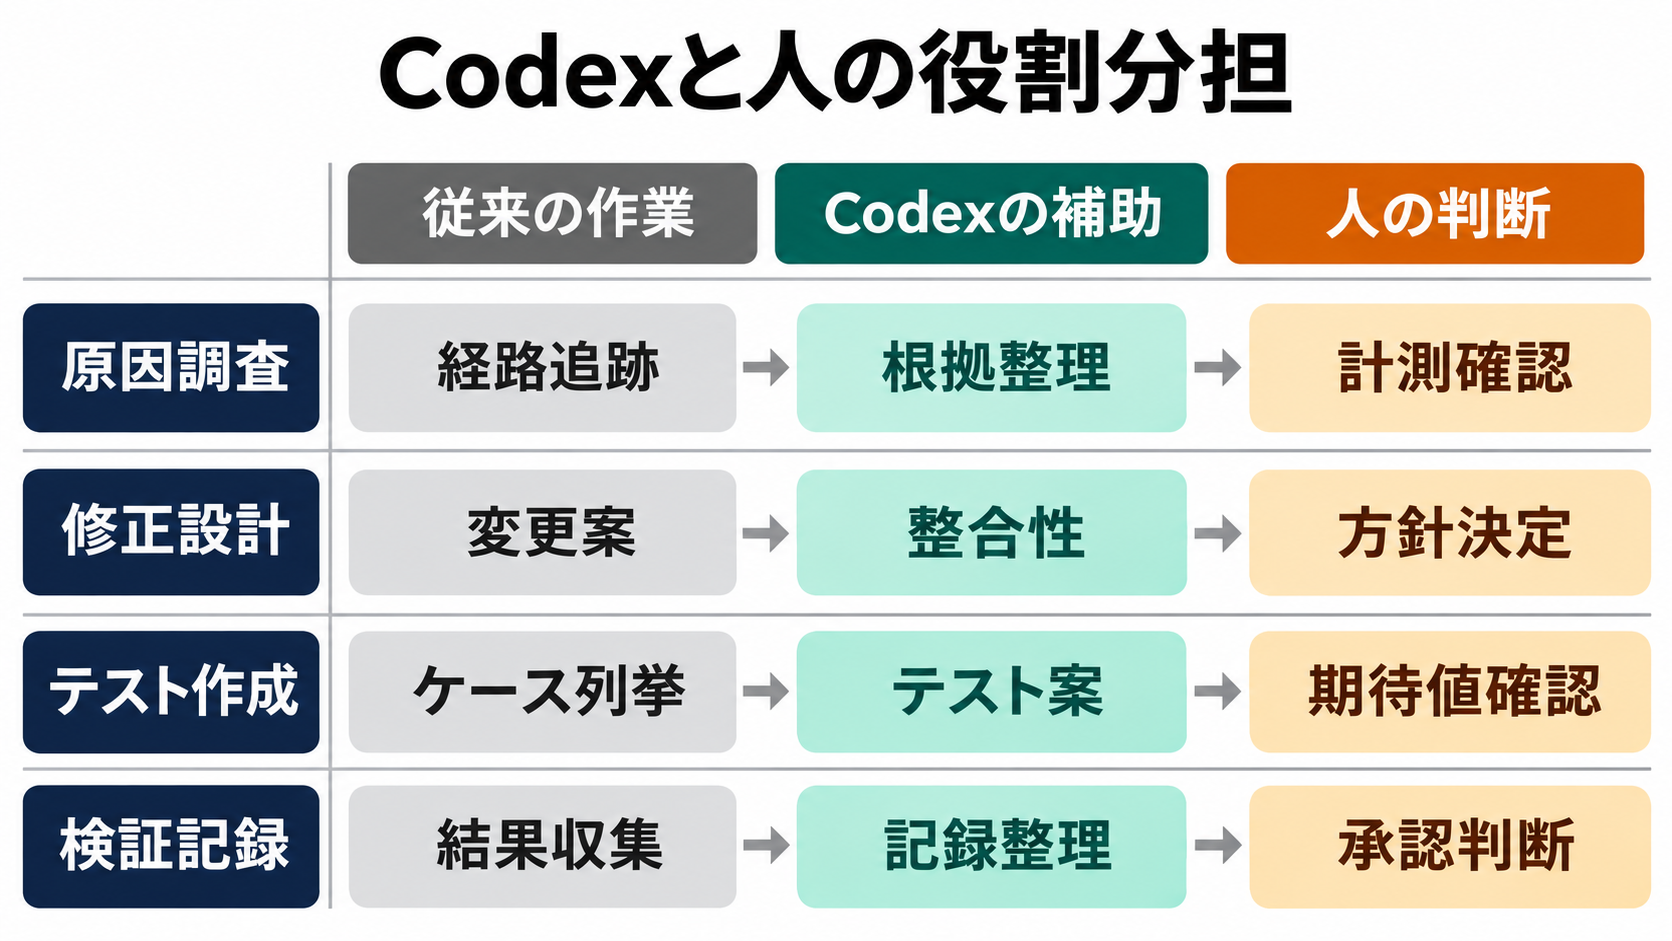
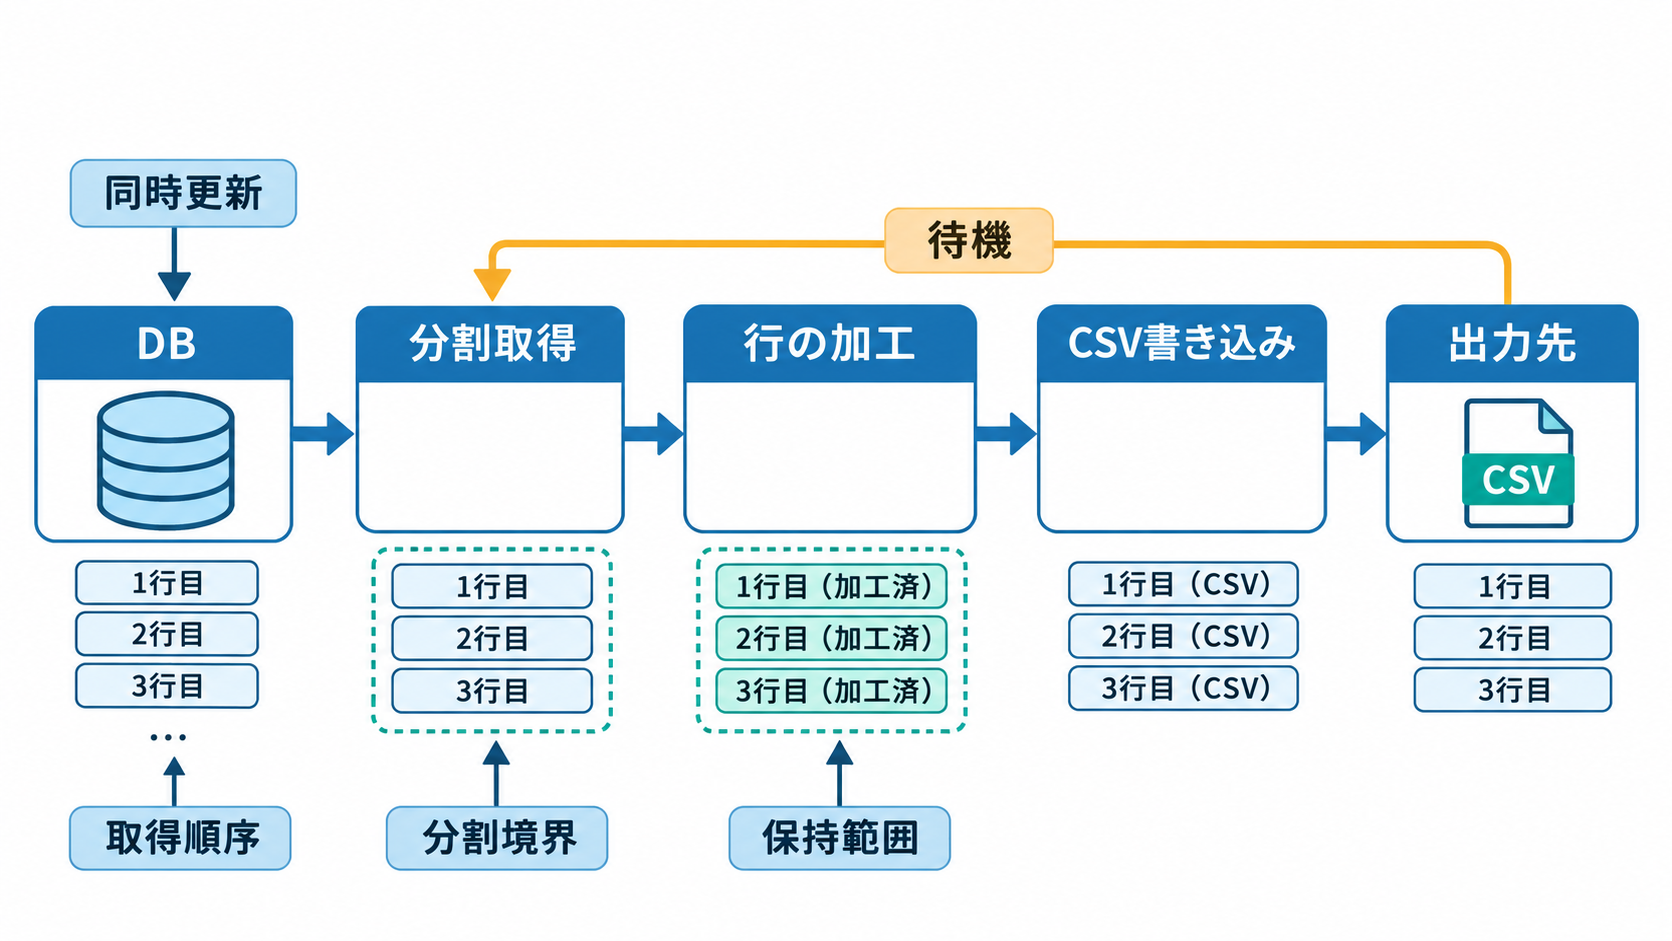
担当者が確認する工程は、検索条件の解釈、DBからの取得、行の加工、CSVへの変換、出力先への受け渡しです。Codexには、それぞれの実装箇所とデータの保持方法を対応付けてもらいます。取得関数だけを見るのではなく、呼び出し元で結果を再び配列へ集めていないか、出力先が完成した文字列を要求していないかまで調査範囲に含める提案です。
| 工程 | AIを使わない場合の作業 | Codexに任せる補助 | 人が残す判断 |
| --- | --- | --- | --- |
| 原因調査 | 呼び出し経路と保持データを追跡します | 関連箇所と原因候補を整理します | 仮説を計測で確かめます |
| 修正設計 | 取得方法と出力方法を検討します | 変更案と影響範囲をまとめます | 整合性と運用条件を決めます |
| テスト作成 | 既存仕様から確認項目を起こします | 既存形式に沿うテスト案を作ります | 期待値の妥当性を確認します |
| 検証記録 | 差分と実行結果を整理します | 根拠と未確認事項をまとめます | 採用とリリースを承認します |
比較に使う入力、成果物、品質条件はそろえます。検索期間や対象レコードを変えて出力が成功しても、元の問題を解決できた証拠にはなりません。件数、列順、並び順、文字コードなどを保ったまま、どの工程のデータ保持を変えられるかが修正の中心です。
Codexによる補助でまとめたいのは、ファイル間の往復や検証案の書き起こしです。原因の確定、業務仕様の選択、測定結果の解釈まで自動的に済むわけではありません。公式資料で紹介されている作業範囲や成功条件の明文化を、この調査にも応用します。(出典: OpenAI Developers)
架空データと出力契約を準備し、読み取り調査から始めます
作業場所には、本番から切り離した開発用リポジトリとDBを用意します。Codexを利用できる環境は設定済みとし、料金や導入画面、起動コマンドはこの記事の対象に含めません。既存のAGENTS.mdがある場合は内容を確認し、適用される規約と作業範囲を共有します。公式資料でもAGENTS.mdは任意の継続的なリポジトリ指針として説明されています。(出典: OpenAI Developers)
架空の受注明細には、受注日時、一意な明細ID、商品名、数量、備考を持たせます。商品名や備考には、日本語、カンマ、二重引用符、改行、空文字を含む値を用意する提案です。分割境界を検証できるよう、取得単位に満たない件数、境界と一致する件数、境界を越える件数も準備します。これらは検証用の設計例であり、実際の顧客情報や社外秘のデータを入力する必要はありません。
同時に、既存の出力仕様を短い文書へまとめます。ヘッダーと列順、検索条件、並び順、文字コード、改行、空値の扱いを記載し、根拠となるテストや仕様書も示します。不明な項目は未決定として残してください。現行コードの挙動が業務仕様として正しいかどうかは、人が確認する必要があります。
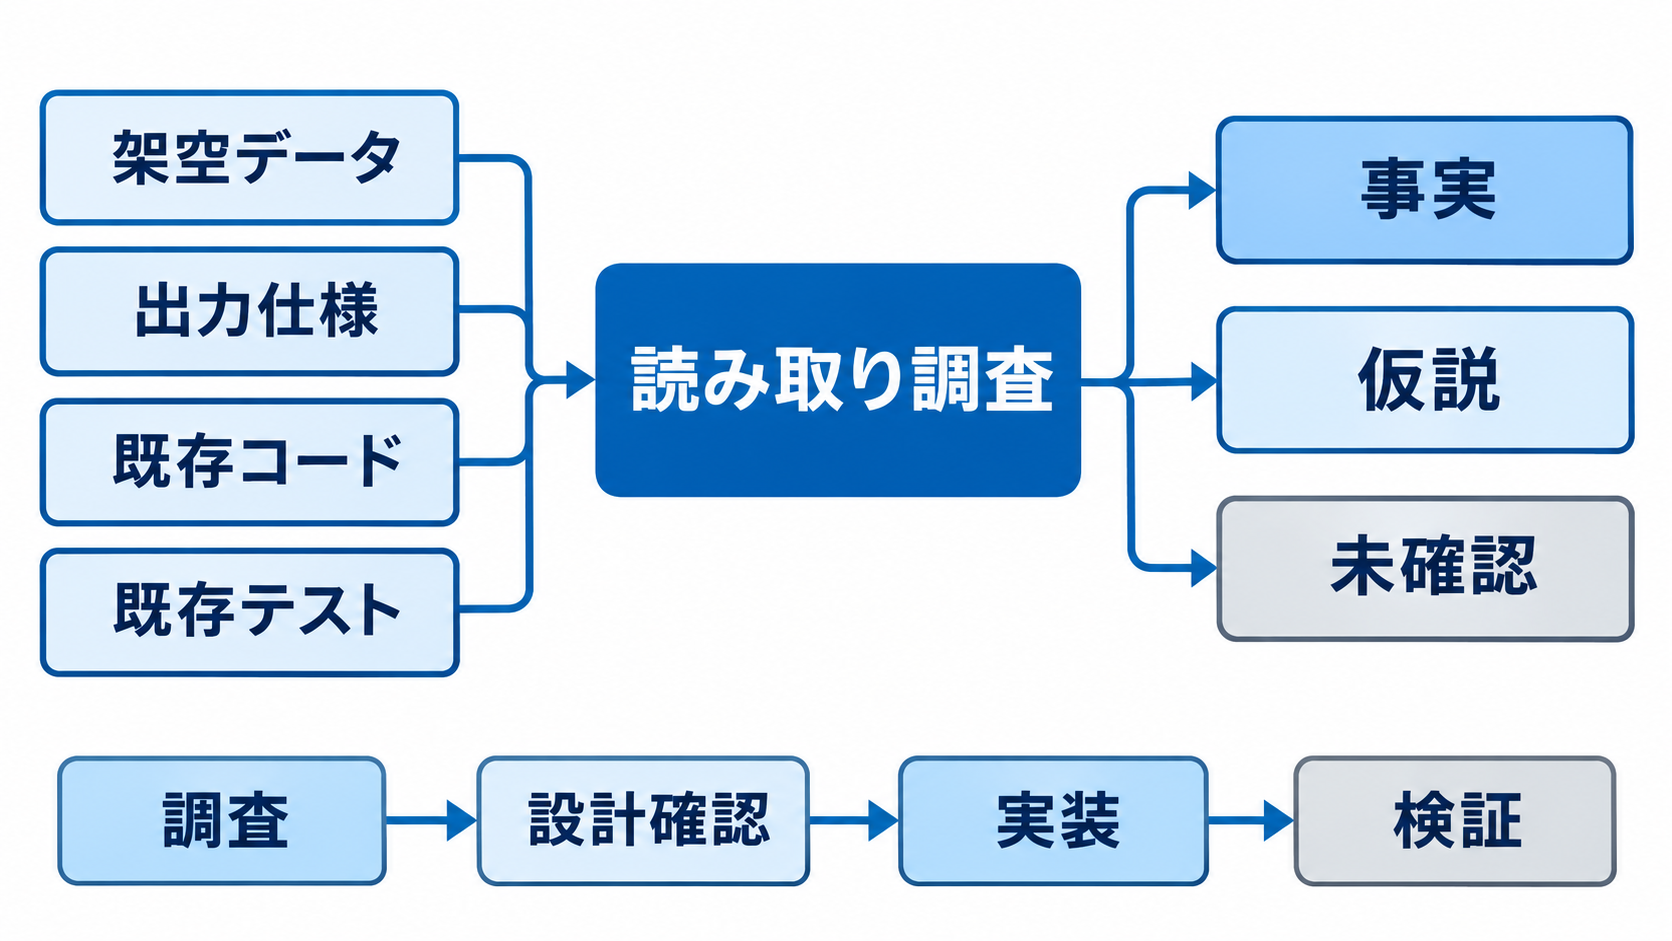
操作は、調査、設計確認、実装、検証の4段階に分けると扱いやすくなります。最初はコードを変えず、調査結果を受け取ります。次のお願い文の「出力仕様メモ」は、自分の環境で用意した資料の名称へ置き換えてください。
コピーして使うお願い文の例です。
適用されるAGENTS.md、出力仕様メモ、既存のCSV出力コード、
関連するDB取得処理とテストを読み、変更せずに調査してください。

CSV出力の入口から出力先までの経路を示してください。
全件を保持する可能性がある箇所を、ファイル名と根拠付きで挙げてください。
確定した事実、原因の仮説、追加計測が必要な点を分けてください。
既存のテスト・計測手順はリポジトリから確認し、
不明なコマンドや仕様は推測せず、未確認として報告してください。
回答を受け取ったら、列挙された箇所を実際のコードで照合します。この段階で調査対象を絞ると、後続の修正で無関係な整理や依存関係の変更が混ざることを防ぎやすくなるでしょう。
分割取得と逐次出力を、一つの処理経路として設計します
調査で全件保持が原因候補として裏付けられたら、DBから一定量ずつ取得し、取得した分を順にCSVへ書き出す設計を検討します。ここで示すのは実装方針の提案です。利用中の言語、DB、ドライバー、CSVライブラリによって使う方法が異なるため、存在を確認していないAPIや設定名を指定しないことが前提になります。
設計レビューでは、取得・加工・書き込みの各段階で何を保持するかを説明してもらいます。分割取得へ変えても、加工済みの行を最後まで蓄積するなら、目的に合う変更とはいえません。出力先への書き込みが遅い場合に、未処理のデータを無制限にためない設計も確認対象にします。DB側の実行計画や接続の保持時間も含め、アプリのメモリだけで判断しない姿勢が必要です。
並び順と同時更新時の扱いは、人が決める設計条件です。たとえば受注日時が同じ明細を含む場合、日時だけで順序を指定してよいかを検討します。一意な明細IDを組み合わせる案なら、複数列の順序と続きの取得条件が対応しているかを確認してください。開始時点のデータを出したい場合も、上限IDを固定するだけで既存行の更新まで固定できると考えず、DBの分離レベルやスナップショットの条件を別途確認します。
設計を確認してから渡す、実装依頼の例です。
確認した調査結果と出力仕様に基づき、CSV出力の修正を進めてください。
対象はDB取得、CSV書き込み、それらの回帰テストに限定します。

全件配列とCSV全体の文字列を保持しない構成を目指してください。
既存のライブラリと規約を優先し、依存追加が必要なら理由を示してください。
取得順序、分割境界、同時更新時の扱いは確認済みの設計に従ってください。
仕様が未決定の箇所は独断で補完せず、判断事項として残してください。

現行の問題を示すテストまたは再現手順を用意し、修正後に検証してください。
実行した検証と未実行の検証、変更ファイル、残る懸念を報告してください。
コミット、プッシュ、デプロイは行わないでください。
成果物の報告には、「取得結果の保持箇所を変更しました」「出力互換性は確認できました」「同時更新の検証は未実行です」といった区別を求めます。これは回答形式の例であり、この記事で変更や検証を実施した結果ではありません。
件数一致だけで終えず、出力内容と失敗時の挙動を確かめます
レビューでは、修正コード、テストの期待値、実行記録を別々に確認します。Codexがコードとテストを同時に作ると、同じ誤解が両方に入る可能性があります。既存の仕様書や、人が内容を確認した小さな正解データを比較の基準として残してください。公式資料でも、工程の成功条件や検証の証拠を明確にする進め方が紹介されています。(出典: OpenAI Developers)
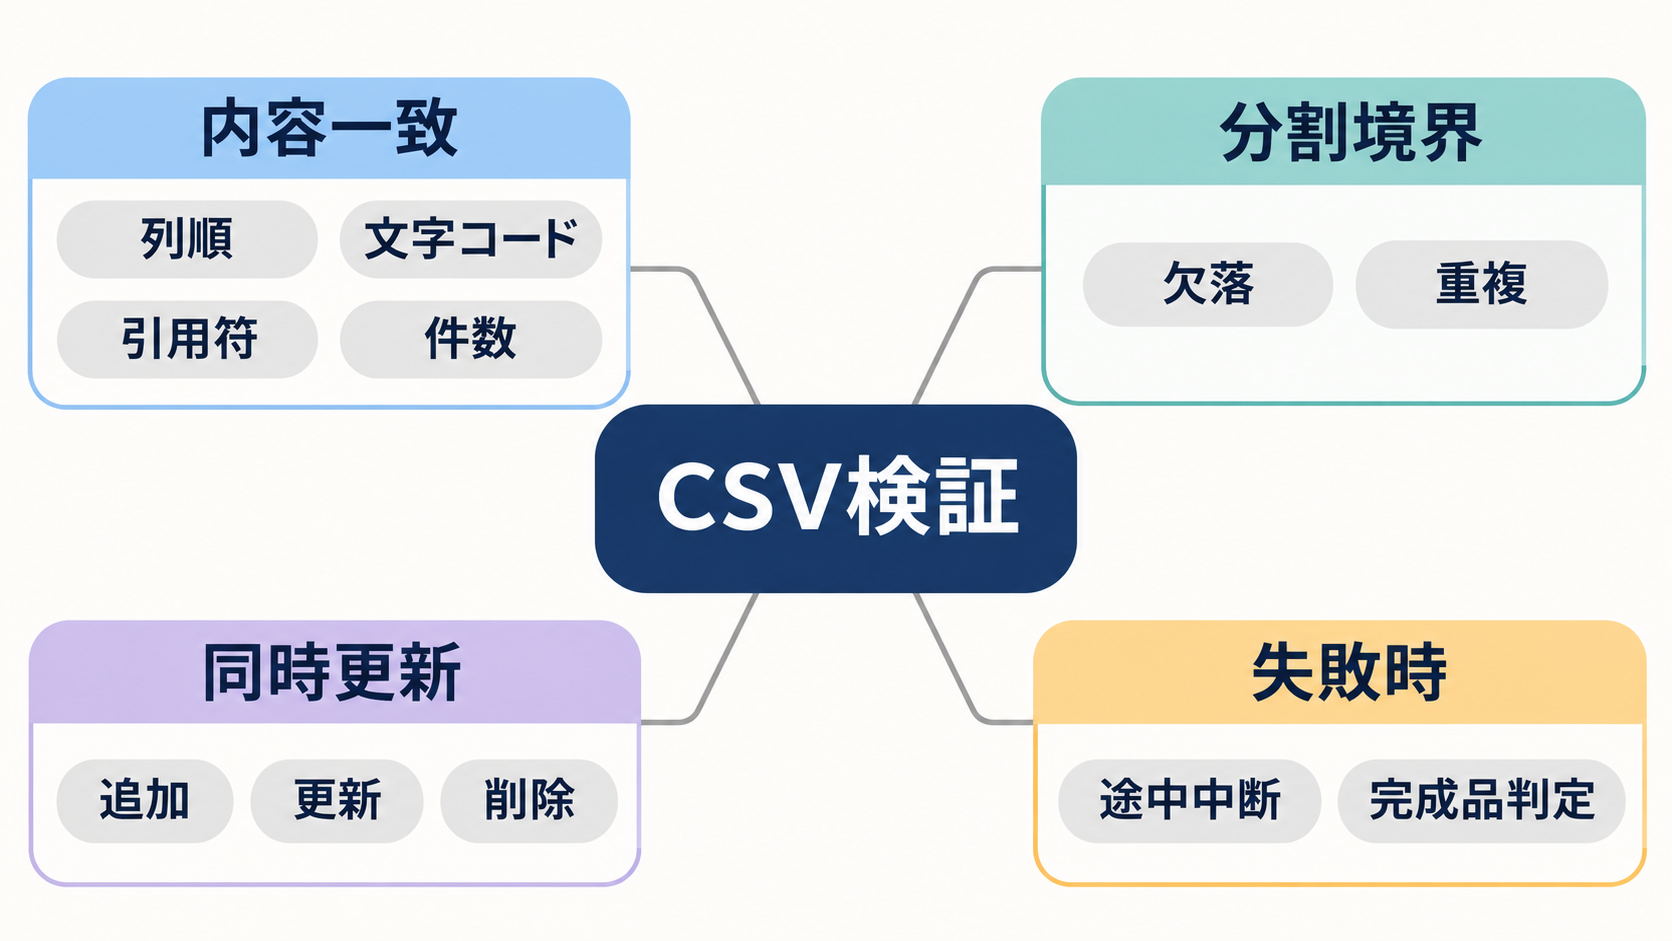
内容確認は、固定した架空データを使って修正前後を比較するところから始めます。CSVを行単位の文字列として扱うだけでなく、フィールド内の改行や引用符を解釈できる方法で読み戻し、列数、各値、レコードの順序を照合する提案です。出力先の要件でバイト列の一致も必要なら、文字コード、BOMの有無、改行コードまで確認します。ヘッダーを含めるかどうかをそろえて、対象件数と出力レコード数を比較しましょう。
分割境界では、件数が一致するだけでは十分ではありません。一意な明細IDの並びを比較し、欠落と重複を調べます。同じ日時を持つ明細、最終の取得分だけが少ない場合、対象がゼロ件の場合も含めると、境界条件の判断に役立ちます。数値や日付の書式についても、既存の利用者や後続システムが期待する形式を基準にしてください。
同時更新の検証は、固定データでの比較とは分けます。出力途中に追加・更新・削除を発生させ、事前に選んだ整合性の条件を満たすかを確かめる手順です。期待結果を決められていないまま「異常が出ませんでした」と記録しても、仕様を満たした判断材料にはなりません。長いトランザクションによる影響も、運用担当者と確認する必要があるでしょう。
最後に、書き込み失敗や途中中断で、壊れたCSVが完成品として扱われないかを調べます。作業用ファイルから完成品へ切り替える案などは、既存構成に応じて検討します。修正担当者とは別の確認者が、仕様の維持、テストの妥当性、未確認事項を見たうえで承認する流れにすると、採用判断の根拠が残ります。
メモリ改善と開発作業の変化を、別々に記録します
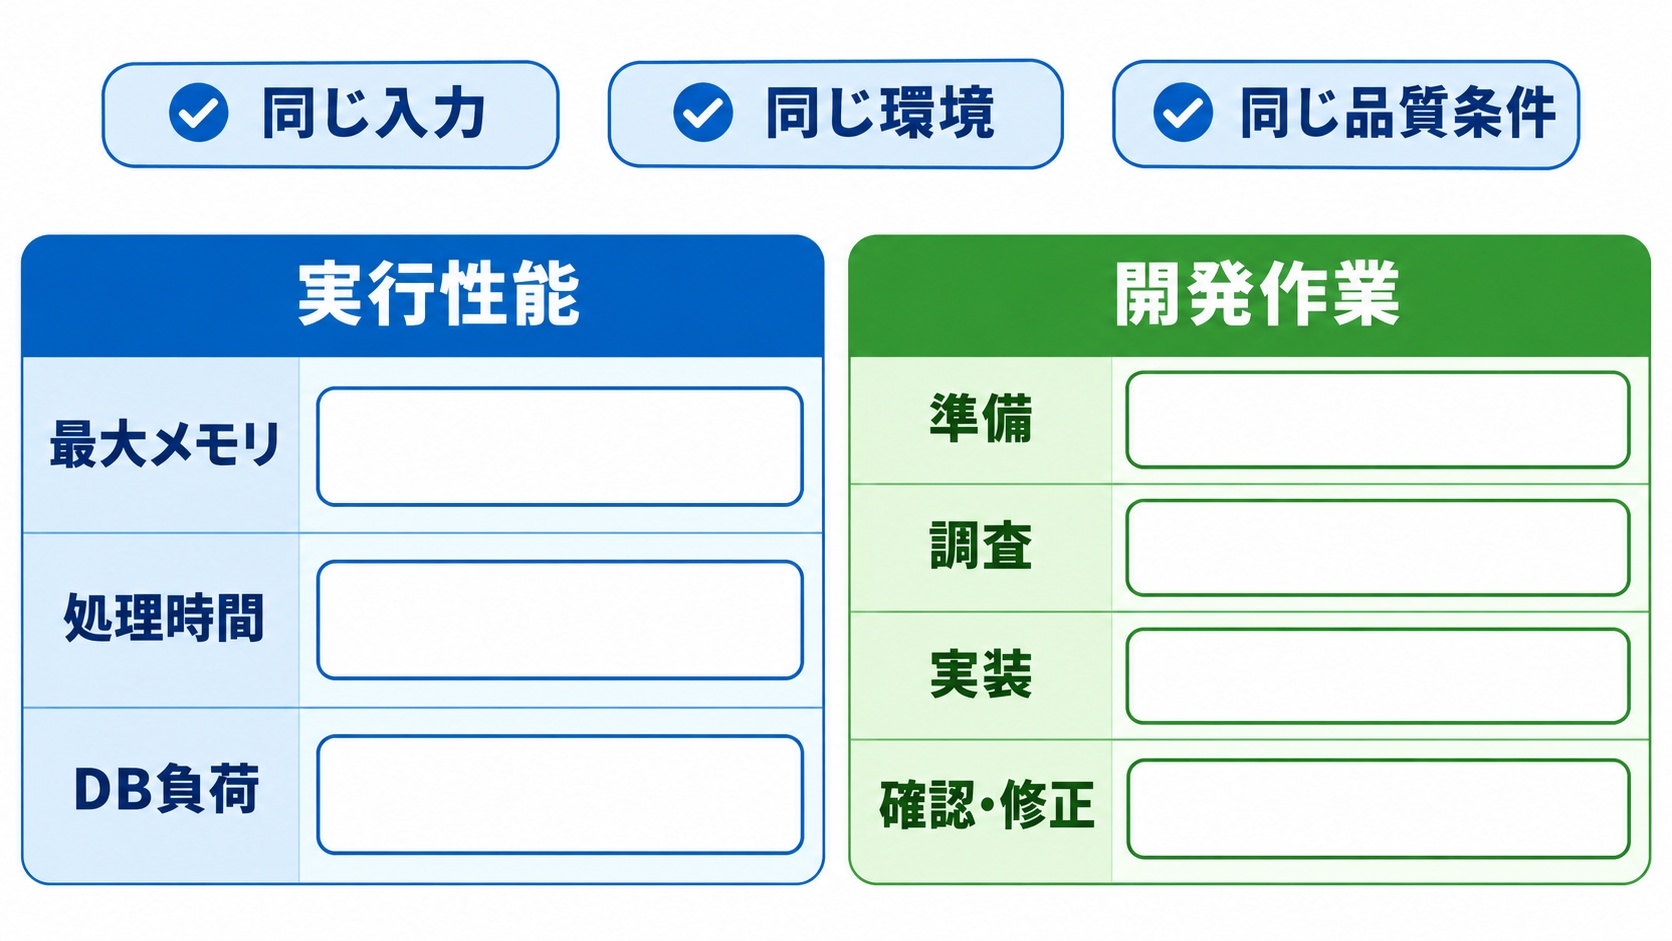
修正の効果は、出力処理の動作と開発作業の負担を分けて確かめます。前者では、同じデータ、検索条件、出力先、実行環境を使い、修正前後の最大メモリ使用量と処理時間を記録します。計測対象がアプリのプロセスなのか、子プロセスやコンテナ全体も含むのかを明記してください。DB側の負荷や接続時間も見ると、負担が別の場所へ移っていないかを判断しやすくなります。
計測は、既存環境で確認できた手段を用います。小規模データで出力互換性を確認してから、再現に必要な規模へ増やす進め方が現実的でしょう。件数だけでなく、長い備考などの行サイズ、並列実行数、取得単位も記録します。比較を繰り返す場合はキャッシュや他の処理の影響を残し、一回の成功だけで改善を断定しないことが大切です。この記事では計測していないため、削減率や完了時間は示しません。
開発作業については、環境準備、原因調査、指示文の作成、設計レビュー、実装、テスト、追加修正にかかった時間を分けて記録する提案です。Codexへの依頼後に短時間で差分が返っても、確認と修正に手間がかかれば、業務全体の負担は減らないかもしれません。同じ修正を人とAIで二重に実施する必要はなく、普段の類似作業の記録を参考にしつつ、案件の難しさの違いも併記します。
期待できる変化は、関連コードの探索結果やテスト候補をまとめて受け取り、人が原因の判断と仕様確認へ集中しやすくなることです。ただし、仕様やテストが乏しいリポジトリでは、それらを整える準備が先に必要になります。今回整理した出力契約と回帰テストが残れば、次の変更時にも確認の起点として使えるでしょう。
最初の一歩は、CSV出力を一つ選び、固定した架空データで現状の出力とメモリ使用量を記録することです。そのうえで、読み取り調査のお願い文をCodexへ渡してください。原因候補の根拠、守るべき出力仕様、未決定の整合性条件がそろった段階で修正へ進めば、生成されたコードを採用するかどうかを具体的に判断できます。